Tag: Vercel AI SDK

  • Self-healing code en agentes TypeScript: el bucle que sí corrige

    Self-healing code en agentes TypeScript: el bucle que sí corrige

    El self-healing code en agentes de TypeScript es un patrón sencillo de describir y fácil de implementar mal. Te cuento primero cómo me enteré.

    Un agente mío se pasó tres minutos razonando una tarea, escribió ochenta líneas de TypeScript, llamó a la API interna y devolvió el objeto con userId donde el schema pedía id.

    Una palabra.

    El pipeline hizo lo que hacen todos: lanzó la excepción, abortó con código de salida 1 y me mandó un aviso para que abriera el editor y cambiara esa palabra a mano.

    Lo absurdo es que Zod ya sabía exactamente qué había fallado. Sabía el campo, el tipo recibido, el tipo esperado y la ruta dentro del objeto. Tenía el diagnóstico completo escrito en una estructura de datos. Y con todo eso en la mano, el sistema decidió despertar a un humano.

    Así que monté el bucle de autocorrección. Y durante dos semanas no funcionó, gastando el doble de llamadas al modelo, por un motivo que no vi hasta que abrí el objeto de error con el debugger.

    Resumen rápido:

    • El self-healing convierte el diagnóstico de un verificador determinista en el contexto del siguiente intento, en vez de escalar a un humano.
    • Si usas generateObject del Vercel AI SDK, el detalle del fallo no está en error.message — está en error.cause. Ese es el error que arruina la mayoría de implementaciones.
    • Techo de dos intentos totales, y cuenta intentos, no reintentos.
    • No todos los errores son curables: los de tipos y schema sí, los de credenciales o herramienta caída no.

    Qué es el self-healing code (y qué no es)

    El self-healing code es un patrón en el que el sistema que genera —código o datos estructurados— ejecuta un verificador determinista, captura el diagnóstico exacto del fallo y lo reinyecta como contexto en un reintento acotado, en lugar de tratar el fallo como terminal.

    La idea de fondo: el validador es el mejor prompt que vas a escribir en tu vida, porque es el único que describe el fallo con precisión de campo y sin ambigüedad.

    El bucle tiene cinco pasos:

    1. Generar. El modelo produce el objeto o el código.
    2. Verificar. Zod, tsc o el test runner dictaminan. Sin intervención humana y sin LLM de por medio: determinista.
    3. Extraer el diagnóstico real. Campo, ruta, tipo esperado, tipo recibido. Aquí es donde falla casi todo el mundo.
    4. Reinyectar. El diagnóstico vuelve como turno nuevo de la conversación, junto a la salida anterior.
    5. Acotar. Techo de intentos y salida limpia cuando se agota.

    Conviene separarlo de dos patrones vecinos con los que se confunde.

    No es un retry con backoff. El backoff reintenta lo mismo esperando que el mundo cambie: que se descongestione la red, que el proveedor se recupere. El self-healing reintenta algo distinto, porque le has añadido información que antes no estaba. Si reintentas idéntico un fallo de validación, el modelo suele reproducir el mismo error.

    No es un circuit breaker. El breaker existe para dejar de insistir cuando una herramienta externa lleva minutos caída; lo conté en circuit breaker para agentes IA. Son capas distintas: el breaker mira la salud de un servicio externo, el self-healing mira la forma de lo que devuelve el modelo. En un agente serio acaban conviviendo.

    Y una frontera más: este post va del bucle. De cómo validar y tipar la respuesta en sí ya escribí en cómo tipar las respuestas de una LLM con Zod y TypeScript. Si no tienes esa parte montada, empieza por ahí y vuelve.


    El error que hace que tu bucle de autocorrección no sirva de nada

    Aquí está lo que me costó dos semanas.

    Cuando usas generateObject del Vercel AI SDK y el modelo devuelve algo que no valida, el SDK lanza un NoObjectGeneratedError. La reacción natural es esta:

    catch (error: any) {
      prompt = `Tu respuesta anterior falló con este error: ${error.message}`;
    }
    

    Ese código se ejecuta sin romperse, el bucle gira, gastas otra llamada al modelo y parece que el patrón funciona.

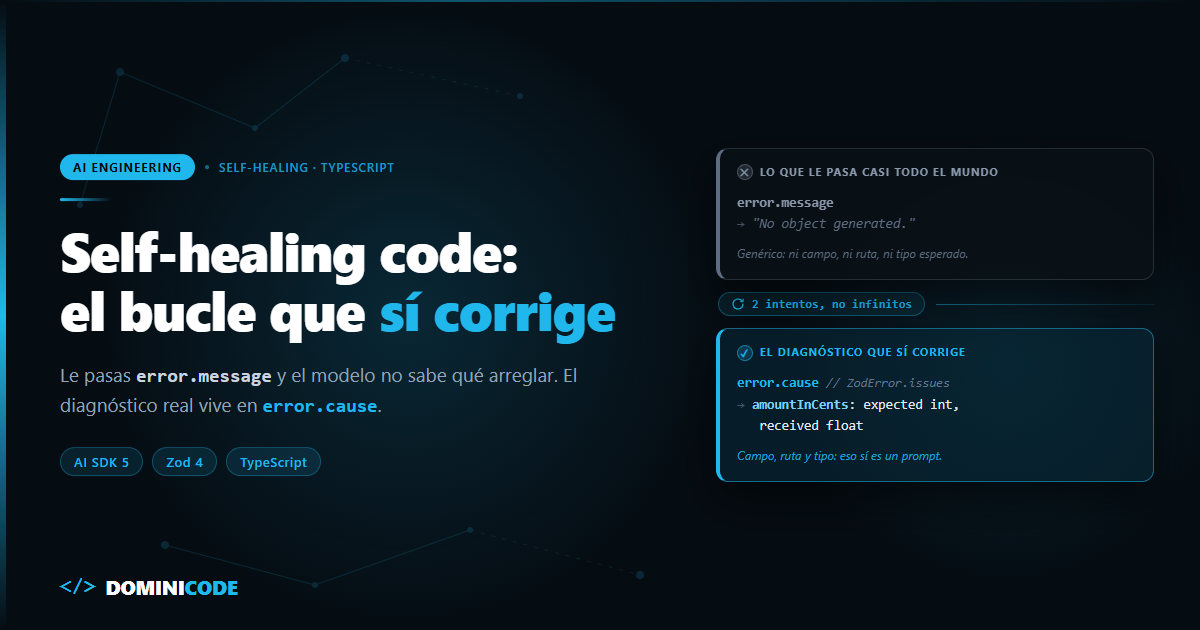
    No funciona. El message de un NoObjectGeneratedError es genérico —del tipo "No object generated"— y no lleva el campo, ni el tipo esperado, ni la ruta. Le estás diciendo al modelo "lo has hecho mal" y esperando que adivine el qué.

    El detalle está en otras propiedades del error, documentadas en el propio AI SDK:

    • error.cause — el error subyacente real: el ZodError con sus issues, o el fallo de parseo de JSON.
    • error.text — el texto crudo que el modelo llegó a generar, que le permite ver su propia salida y compararla con el diagnóstico.
    • error.finishReason — si vale 'length', el JSON no es inválido por confusión del modelo: está truncado porque se acabaron los tokens. Reintentar con el mismo límite es tirar dinero; ahí toca subirlo o partir el schema.

    Ese último matiz es la diferencia entre un bucle que corrige y un bucle que solo encarece la factura.

    Hay un segundo fallo igual de común, y es de contexto. Si en el reintento reasignas el prompt en vez de acumular la conversación, el modelo recibe "tu respuesta anterior falló, corrígela" sin la tarea original y sin su propia salida. generateObject no guarda historial: cada llamada es independiente. El modelo no sabe qué tenía que generar ni qué generó. No hay nada que corregir.


    Implementación del bucle en TypeScript

    Con eso claro, el bucle queda así. Versiones: AI SDK 5 y Zod 4.

    import { generateObject, NoObjectGeneratedError } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    
    const PaymentConfigSchema = z.object({
      customerId: z.string().min(5).describe("ID del cliente, prefijo cus_"),
      amountInCents: z.number().int().positive().describe("Importe en céntimos, nunca decimal"),
      currency: z.enum(["EUR", "USD"]),
      maxPaymentRetries: z.number().int().min(1).max(5),
    });
    
    type PaymentConfig = z.infer<typeof PaymentConfigSchema>;
    
    // Intentos TOTALES, no reintentos: 2 = la primera llamada y una corrección.
    const MAX_ATTEMPTS = 2;
    
    export async function generateSelfHealingConfig(
      userRequirement: string,
    ): Promise<PaymentConfig> {
      const messages: Array<{ role: "user" | "assistant"; content: string }> = [
        { role: "user", content: `Genera la configuración de pago para: "${userRequirement}"` },
      ];
    
      for (let attempt = 1; attempt <= MAX_ATTEMPTS; attempt++) {
        try {
          const { object } = await generateObject({
            model: anthropic("claude-opus-5"),
            schema: PaymentConfigSchema,
            messages,
            // Clave: el maxRetries del SDK son reintentos de TRANSPORTE (429, 5xx)
            // y vale 2 por defecto. Sin ponerlo a 0, cada vuelta de este bucle
            // puede disparar hasta 3 peticiones HTTP: 6 llamadas en el peor caso.
            maxRetries: 0,
          });
          return object;
        } catch (error) {
          if (!NoObjectGeneratedError.isInstance(error)) throw error; // 401, red, bugs propios
    
          // Truncado por tokens: reintentar igual no arregla nada.
          if (error.finishReason === "length") {
            throw new Error(
              "[SELF-HEALING] Respuesta truncada por límite de tokens: súbelo o parte el schema.",
            );
          }
    
          if (attempt === MAX_ATTEMPTS) {
            throw new Error(
              `[SELF-HEALING] Sin corregir tras ${MAX_ATTEMPTS} intentos:\n${formatIssues(error.cause)}`,
            );
          }
    
          // El feedback útil: su salida + el diagnóstico concreto, como turno nuevo.
          messages.push({ role: "assistant", content: error.text ?? "(sin salida)" });
          messages.push({
            role: "user",
            content:
              `Tu respuesta no cumple el schema:\n${formatIssues(error.cause)}\n\n` +
              `Corrige ÚNICAMENTE esos campos y devuelve el objeto completo.`,
          });
        }
      }
    
      throw new Error("[SELF-HEALING] Bucle terminado sin resultado");
    }
    
    // El diagnóstico en tres líneas, no el volcado entero.
    function formatIssues(cause: unknown): string {
      if (cause instanceof z.ZodError) {
        return cause.issues
          .map((i) => `· ${i.path.join(".") || "(raíz)"}: ${i.message}`)
          .join("\n");
      }
      return cause instanceof Error ? cause.message : String(cause);
    }
    

    Tres decisiones que no son cosméticas.

    maxRetries: 0. Es la que más gente se salta. El maxRetries del AI SDK vale 2 por defecto y cubre fallos de transporte —408, 409, 429 y 5xx— con backoff exponencial. Son compatibles con este bucle, pero se multiplican: dos vueltas tuyas por tres peticiones suyas son seis llamadas donde creías tener dos. Si quieres backoff de red, ponlo tú fuera y controla el total.

    El error vuelve como turno de conversación. Al empujar la salida fallida como mensaje assistant y la corrección como user, el modelo ve su propio intento enfrentado al diagnóstico. Reasignar el prompt original pierde ese contraste — es el segundo fallo que veíamos arriba.

    formatIssues recorta. Un ZodError serializado entero son cientos de caracteres de ruido que pagas en cada vuelta. Las issues mapeadas a ruta: mensaje son las tres líneas que importan.

    Si quieres exprimir la parte del schema —.describe(), uniones discriminadas, enums en vez de strings abiertos— es lo que trabajo en el curso de Zod para TypeScript. Un schema bien diseñado reduce cuántas veces entras en este bucle, que sigue siendo el mejor ahorro disponible.


    Las tres reglas para que esto no se convierta en un bucle infinito caro

    1. Pásale el diagnóstico, no el volcado

    Cinco mil caracteres de stack trace con trazas internas de Node entierran la señal en ruido, y encima los pagas en cada vuelta. Ruta, mensaje y tipo esperado. Nada más.

    2. Techo estricto, y cuenta intentos, no esperanzas

    Dos intentos totales. Si un modelo actual no arregla un fallo de forma teniendo delante el error exacto, el problema casi nunca es el modelo: es un schema que pide algo que el contexto no contiene. El tercer intento no corrige, factura.

    El fallo más común es contar mal. Un for (let i = 1; i <= maxRetries; i++) con maxRetries = 2 da dos intentos totales, es decir, un solo reintento. Si querías dos correcciones, el bucle se te queda corto y no te enteras. Por eso arriba la constante se llama MAX_ATTEMPTS.

    Este techo vive dentro del límite global de pasos del agente, no lo sustituye: sobre eso escribí en el agentic loop en producción.

    3. Corrección quirúrgica, no regeneración

    Pide explícitamente que corrija solo los campos señalados. Si dejas que regenere el objeto entero, es habitual que arregle el campo roto y rompa otro que ya estaba bien — y con techo de dos intentos te quedas sin margen.


    Un oráculo por cada tipo de error

    Zod valida la forma de los datos en runtime. Es la primera capa, no la única: el patrón es idéntico cambiando quién emite el diagnóstico.

    Oráculo Qué detecta Qué le pasas al modelo
    Zod Salida estructurada que no cumple el schema issues mapeadas a ruta: mensaje
    tsc --noEmit Errores de tipos en el código generado Código de error, archivo, línea, tipo esperado vs recibido
    Vitest / Jest Errores de lógica de negocio Nombre del test y el diff esperado/recibido
    ESLint Estilo y patrones prohibidos Nada: esto se arregla con --fix, no con el modelo

    El compilador. Cuando el agente escribe código en vez de devolver datos, tsc --noEmit da diagnósticos con archivo, línea y tipos enfrentados. Un Type '{ userId: string }' is not assignable to type '{ id: string }' es la misma señal que un ZodError: precisa, accionable y gratis. Pásale las líneas del diagnóstico, no la salida completa del compilador — en un proyecto mediano son cientos de líneas y un solo error de tipos suele arrastrar diez mensajes derivados del mismo origen.

    Los tests. El compilador y Zod atrapan errores de forma; los tests atrapan errores de fondo. Un agente que ejecuta la suite, lee qué aserción falló y corrige antes de enseñarte nada es la versión completa del patrón. Es también donde el techo se vuelve innegociable: un agente iterando contra una suite en rojo sin límite es la forma más rápida que conozco de quemar presupuesto. Y hay una trampa propia de esta capa: ejecuta la suite entera antes de aceptar el parche, no solo el test que fallaba. Arreglar el test A rompiendo el B es un resultado muy común y, si solo miras A, lo das por bueno.

    Para montar el entorno donde ese ciclo corre aislado, escribí sobre el test harness para desarrollo con agentes. Y ese salto —de validar datos a montar el ciclo entero de generar, verificar y corregir— es el hilo del curso Construye con IA: de la idea al producto con Claude Code.

    Un apunte de arquitectura: el bucle queda más limpio si los fallos ya viajan como datos tipados en lugar de excepciones sueltas, algo que conté en cómo manejar errores en agentes de IA con TypeScript.


    Qué errores son curables y cuáles no

    Aplicar el bucle a todo es peor que no tenerlo. Esta es la tabla que uso para decidir:

    Tipo de fallo ¿Self-healing? Qué hacer
    Error de tipos (tsc) Sí Reinyectar diagnóstico, 1 reintento
    Schema de salida inválido Sí Reinyectar error.cause + la tarea original
    Aserción de test fallida Sí, con cuidado Reinyectar el diff y correr la suite completa
    Respuesta truncada (finishReason: 'length') No Subir el límite de salida o partir el schema
    Lint y formato No Determinista: --fix
    Tool externa 5xx o timeout No Circuit breaker, no reintento
    Credenciales, 401 No Abortar y escalar
    Requisito ambiguo No Humano en el bucle
    Operación con efectos ya aplicados No Idempotencia o compensación

    Ese último merece un párrafo. Si el primer intento escribió en base de datos o llamó a un endpoint de cobro, reintentar no es autocorregir: es duplicar. El bucle solo es seguro mientras la operación no haya salido de tu proceso. Valida primero, ejecuta después.

    Y hay un coste que conviene tener presente: cada vuelta añade la latencia completa de una llamada al modelo y paga de nuevo los tokens del contexto acumulado, que ahora incluye la salida fallida y el diagnóstico. En un flujo interactivo, a veces es mejor devolver el fallo rápido que hacer esperar el doble para acertar. Si quieres saber en qué se te va de verdad el presupuesto, medir el consumo de tokens del agente es el paso previo.


    Cuando el segundo intento también falla

    El techo implica que existe un camino de salida, y ese camino no puede ser una excepción sin contexto que alguien encuentre en un log tres días después.

    Lo que funciona: registrar el fallo con las cuatro piezas que lo hacen reproducible —la tarea original, la salida del modelo, el diagnóstico del verificador y el número de intentos consumidos— y encolarlo. Ese registro sirve para dos cosas distintas. La inmediata, que alguien lo resuelva. La útil a medio plazo, que la cola se convierte en tu mejor fuente de mejoras del schema: cuando ves tres fallos seguidos sobre el mismo campo, el problema no era el modelo.


    Por dónde empezar mañana

    Coge el punto de tu agente donde hoy salta una excepción de validación. Uno solo.

    Añade tres cosas: extrae el error real (error.cause, no error.message), formatéalo a ruta y mensaje, y devuélvelo como turno nuevo con techo de dos intentos y maxRetries: 0. Loguea cuántas veces entra en la segunda vuelta y cuántas sale con éxito.

    Ese ratio es el diagnóstico del diagnóstico. Si entra a menudo y se corrige, tienes un schema mejorable pero un bucle sano. Si entra mucho y no se corrige, tienes un schema imposible: le estás pidiendo al modelo un campo que nadie podría rellenar con el contexto que le das. Y si no entra casi nunca, enhorabuena — tu schema ya hace el trabajo y el bucle es solo la red.

    En Dominicode Labs es donde vamos rodando estos patrones sobre proyectos reales, con las métricas puestas.

    Los sistemas agénticos que aguantan en producción no son los que no se equivocan. Son los que tienen el diagnóstico a mano y saben devolvérselo al modelo antes de despertar a nadie.


    Preguntas frecuentes

    ¿Por qué mi agente no se corrige aunque le paso el error?

    La causa más común es pasar error.message en vez de error.cause. En un NoObjectGeneratedError del Vercel AI SDK, message es un texto genérico que no nombra el campo ni el tipo esperado; el diagnóstico útil vive en error.cause —el ZodError con sus issues— y la salida cruda del modelo en error.text. Con solo message, el bucle gasta llamadas sin darle al modelo nada con lo que corregir.

    ¿En qué se diferencia el self-healing code de un retry con backoff?

    En qué cambia entre un intento y el siguiente. El backoff reintenta la misma petición esperando que se recupere algo externo —red, proveedor, rate limit— y por eso funciona con fallos transitorios. El self-healing modifica la entrada: añade al contexto el diagnóstico que provocó el fallo. Ante un error de schema, el backoff solo repite el mismo error más despacio.

    ¿No reintenta ya generateObject por su cuenta con maxRetries?

    No de esta forma, y conviene ponerlo a 0. La opción maxRetries del AI SDK vale 2 por defecto y cubre fallos de transporte: errores de red y respuestas de API reintentables (408, 409, 429, 5xx) con backoff exponencial. Un fallo de validación de schema no entra ahí, se propaga como NoObjectGeneratedError. Si lo dejas por defecto, cada vuelta de tu bucle puede disparar hasta tres peticiones HTTP.

    ¿Cuántos intentos debería permitir?

    Dos totales: la llamada inicial y una corrección. Con el error exacto delante, un modelo actual corrige los fallos de forma en el primer reintento o no los corrige. Un tercero rara vez cambia el resultado y multiplica coste y latencia. Y cuenta intentos, no reintentos: un bucle i <= 2 da una sola corrección, y es donde más gente se equivoca al implementarlo.

    ¿Se puede hacer self-healing solo con el compilador, sin Zod?

    Sí, y son capas complementarias. tsc --noEmit cubre el código que el agente escribe; Zod cubre la salida estructurada que el modelo devuelve. Si tu agente genera archivos, el compilador es tu oráculo principal. Si devuelve objetos que tu aplicación consume, lo es Zod. Muchos agentes acaban usando los dos en puntos distintos del flujo.

    ¿Sirve para errores de lógica o solo para errores de tipos?

    Sirve para los de lógica, pero cambiando el oráculo: ahí el que dictamina es el test runner, y el diagnóstico que reinyectas es la aserción fallida con su diff esperado/recibido. La diferencia práctica es el riesgo. Un error de tipos tiene una única corrección posible; un test rojo admite varias, y alguna rompe otra cosa. Por eso en esta capa se ejecuta la suite completa antes de aceptar el parche.

    ¿Qué hago si el agente rompe otro test al arreglar el primero?

    Tratarlo como un fallo del intento, no como un éxito parcial. Si el criterio de aceptación es solo el test que fallaba, el bucle acepta parches que degradan el código. El criterio tiene que ser la suite entera en verde; si el parche pone A en verde y B en rojo, se descarta y se consume intento. Con techo de dos, eso normalmente significa escalar — que es la respuesta correcta.

    ¿Es seguro autocorregir una operación que ya escribió en base de datos?

    No. Si el intento fallido tuvo efectos externos, el reintento los duplica. El bucle es seguro mientras la operación no haya salido de tu proceso: valida primero, ejecuta después. Si el efecto ya ocurrió, lo que necesitas es idempotencia o compensación, no autocorrección.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Diseñar schemas Zod para LLM: tu schema ya es el prompt

    Diseñar schemas Zod para LLM: tu schema ya es el prompt

    Hace unas semanas revisé el pipeline de extracción de facturas de un cliente. Fallaba en uno de cada seis documentos.

    El equipo ya había subido los reintentos a tres, puesto temperature: 0 y cambiado a un modelo más caro. Seguía fallando.

    Miré el schema de Zod: 31 campos, ninguno con .describe(), ocho z.string() donde solo cabían cuatro valores posibles y cuatro .optional() colocados ahí porque "a veces la factura no lo trae".

    El problema no era el modelo. Era el schema. Diseñar schemas Zod para LLM no consiste en describir la forma de tus datos: consiste en escribir instrucciones que el modelo lee antes de responder.

    Y esa es la parte que casi nadie aprovecha.


    El schema de Zod no espera al final: se envía al LLM dentro del prompt

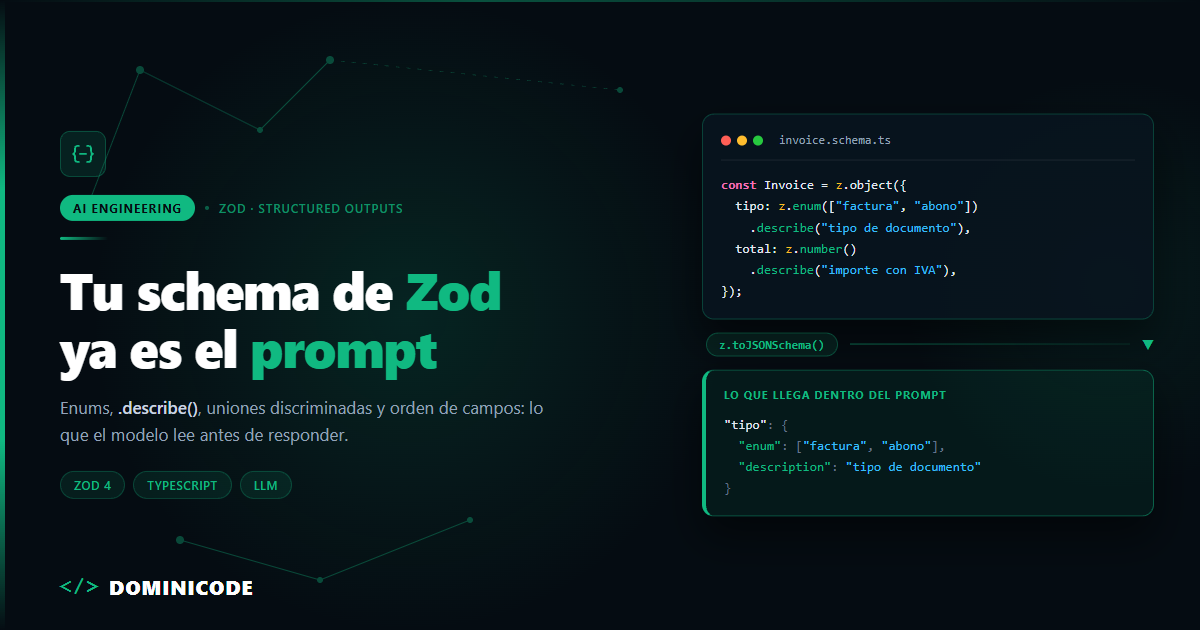
    Cuando usas structured outputs o tool calling, tu schema de Zod no se queda esperando en el servidor a que llegue el JSON. Se convierte a JSON Schema y se envía al modelo en la misma petición.

    En Zod 4 puedes ver exactamente lo que sale de tu código:

    import * as z from "zod";
    
    const Factura = z.object({
      esValida: z.boolean(),
      tipo: z.string(),
      importe: z.number(),
    });
    
    console.log(z.toJSONSchema(Factura));
    

    Eso es literalmente lo que viaja. Y en el caso de Anthropic la documentación del system prompt de tool use lo enseña sin rodeos: cuando llamas a la API con el parámetro tools, el sistema construye un system prompt que incluye tus definiciones tal cual.

    In this environment you have access to a set of tools you can use to answer the user's question.
    ...
    Here are the functions available in JSONSchema format:
    {{ TOOL DEFINITIONS IN JSON SCHEMA }}
    

    Tus nombres de campo, tus tipos, tus descripciones: todo eso son tokens de entrada que el modelo lee antes de generar el primer carácter. Es la misma idea que ya expliqué al hablar de function calling tipado en TypeScript, pero llevada al extremo.

    Si el schema es texto en el prompt, entonces un schema mal escrito es un prompt mal escrito. Y no hay reintento que arregle eso.


    z.string() es un campo abierto. z.enum() es una pregunta cerrada

    Cambiar z.string() por z.enum() es el ajuste con mejor relación esfuerzo/resultado de toda la lista: z.string() deja el espacio de respuesta abierto y z.enum() lo cierra a una lista finita de valores. Es lo primero que toco cuando un pipeline de extracción falla.

    // El modelo puede escribir lo que le dé la gana
    tipoDocumento: z.string(),
    
    // El modelo solo puede elegir
    tipoDocumento: z.enum(["factura", "abono", "recibo", "presupuesto"]),
    

    La diferencia en el JSON Schema generado es esta:

    { "type": "string", "enum": ["factura", "abono", "recibo", "presupuesto"] }
    

    Con z.string() le pides al modelo que invente una etiqueta. Va a devolver "Factura", "FACTURA", "factura simplificada" y "invoice" según el día. Tu Zod lo aceptará todo, porque son strings válidos, y el error aparecerá tres capas más abajo cuando alguien haga un switch.

    Con z.enum() el espacio de respuesta está cerrado. Además, cuando el proveedor aplica el modo estricto, el enum se traduce en una restricción real de decodificación: el modelo no puede emitir un valor fuera de la lista.

    Regla práctica: si en tu cabeza el campo tiene una lista de valores, escríbela en el schema. Si te da pereza escribirla, es que tampoco la tenías clara tú.


    .describe(): el campo que casi nadie usa y que sí llega al modelo

    .describe() es el método de Zod que más impacto tiene en la precisión de un LLM y el que casi nadie usa: el texto que le pasas acaba en la clave description del JSON Schema que recibe el modelo, no se queda en tu editor.

    fechaVencimientoISO: z
      .string()
      .describe(
        "Fecha límite de pago en formato ISO 8601 (YYYY-MM-DD). " +
        "Es la fecha de vencimiento, NO la de emisión. " +
        "Si el documento dice 'pago a 30 días', súmalos a la fecha de emisión."
      ),
    

    No es decorativo. Compruébalo con z.toJSONSchema():

    {
      "type": "string",
      "description": "Fecha límite de pago en formato ISO 8601 (YYYY-MM-DD). Es la fecha de vencimiento, NO la de emisión. Si el documento dice 'pago a 30 días', súmalos a la fecha de emisión."
    }
    

    Ese description viaja con el schema. En Zod 4, .describe("texto") es equivalente a .meta({ description: "texto" }) y todos los metadatos se copian al JSON Schema resultante.

    La documentación de Anthropic sobre definición de herramientas es tajante al respecto: "Provide extremely detailed descriptions. This is by far the most important factor in tool performance". No es un detalle de estilo. Es el sitio donde metes las reglas de negocio que el nombre del campo no puede expresar.

    Dos avisos prácticos:

    1. La documentación del Vercel AI SDK recomienda encadenar .describe() o .meta() al final de la cadena, porque la mayoría de métodos de Zod devuelven una instancia nueva que no hereda los metadatos. En mis pruebas con z.toJSONSchema() y Zod 4.5.4 (agosto de 2026) la descripción sobrevivía también antes de .optional(), pero son dos caminos de código distintos y seguir la recomendación no cuesta nada.
    2. Cada descripción son tokens que pagas en cada llamada. Describe los campos ambiguos, no los obvios: nombreCliente no necesita párrafo.

    Si quieres dominar la parte de Zod que no es "poner z.string() y seguir", en mi curso de Zod para validación y transformación de datos en TypeScript trabajo esto con schemas reales de producción.


    .optional() es un agujero negro. Dale una salida explícita

    .optional() es el error que más alucinaciones fabrica en un schema pensado para un LLM: saca el campo de required sin dejar ninguna señal de cuándo debe omitirse, y el modelo rellena el hueco.

    Piensa qué ve el modelo cuando marcas un campo como opcional. Este schema:

    z.object({
      importeEUR: z.number().nullable(),
      nota: z.string().optional(),
    });
    

    produce esto:

    {
      "type": "object",
      "properties": {
        "importeEUR": { "type": ["number", "null"] },
        "nota": { "type": "string" }
      },
      "required": ["importeEUR"],
      "additionalProperties": false
    }
    

    Fíjate en nota. Desaparece de required y no queda ninguna otra señal. El modelo no recibe ninguna pista sobre cuándo debe omitirlo ni qué significa su ausencia. Tú sabes que "ausente" quiere decir "no aplica", pero eso está en tu cabeza, no en el prompt.

    importeEUR, en cambio, sigue siendo obligatorio y declara null como valor legítimo. El modelo tiene un camino explícito para decir "esto no está".

    Esto además encaja con cómo funcionan los structured outputs estrictos de OpenAI, donde todos los campos deben ir en required y la forma documentada de emular un opcional es un tipo unión con null manteniendo el campo obligatorio.

    Y hay una versión todavía mejor cuando el "no lo sé" tiene matices:

    // Mal: el modelo se inventa una fecha para rellenar el hueco
    fechaVencimientoISO: z.string(),
    
    // Regular: puede omitirlo, pero no sabe cuándo
    fechaVencimientoISO: z.string().optional(),
    
    // Bien: el "no sé" es una respuesta válida y tipada
    vencimiento: z.discriminatedUnion("estado", [
      z.object({ estado: z.literal("presente"), fechaISO: z.string() }),
      z.object({ estado: z.literal("no_aplica") }),
      z.object({ estado: z.literal("ilegible") }),
    ]),
    

    Un modelo obligado a rellenar un campo que no puede saber rellena igual. Eso no es un bug del modelo, es la consecuencia directa de por qué la IA se inventa cosas: si el schema no ofrece una salida honesta, la salida más probable es una plausible. Diséñale la puerta de "no lo sé" y la usará.


    Uniones discriminadas en Zod: dale un mapa al modelo, no un test de opción múltiple

    Con z.union(), el JSON Schema resultante es un anyOf de objetos sin nada que los distinga:

    // salida recortada de z.toJSONSchema()
    { "anyOf": [ { "properties": { "importeEUR": ... } }, { "properties": { "motivo": ... } } ] }
    

    El modelo tiene que deducir cuál encaja comparando formas. Es una decisión difusa.

    Con z.discriminatedUnion() cambia la estructura:

    const Movimiento = z.discriminatedUnion("tipo", [
      z.object({ tipo: z.literal("pago"), importeEUR: z.number() }),
      z.object({ tipo: z.literal("reembolso"), motivo: z.string() }),
    ]);
    

    Sale un oneOf en el que cada rama lleva { "type": "string", "const": "pago" } en el discriminador. El modelo primero elige una etiqueta —decisión de un token, con opciones cerradas— y a partir de ahí la forma del resto del objeto queda determinada.

    Es la misma razón por la que las uniones discriminadas nos gustan en TypeScript: convierten una inferencia estructural en una decisión explícita. Solo que aquí quien se beneficia del narrowing no es el compilador, es el modelo.

    Un aviso importante antes de que lo copies: en el modo estricto de OpenAI la raíz del schema tiene que ser un objeto, y la documentación es explícita en que un objeto raíz no puede ser del tipo anyOf. Así que no mandes la unión suelta como en el ejemplo de arriba: anídala dentro de un objeto raíz, como el campo vencimiento de la sección anterior.

    Y un detalle más: z.toJSONSchema() emite oneOf para las uniones discriminadas, mientras que la lista de tipos soportados de OpenAI habla de anyOf. Si vas contra structured outputs, pasa por el helper de su propio SDK (zodResponseFormat de openai/helpers/zod) en lugar de por z.toJSONSchema() directo. Contra tool use de Anthropic no tienes esta restricción.


    El orden de los campos no es cosmética

    Un LLM genera tokens en orden. Si el primer campo de tu objeto es la conclusión, la conclusión se escribe antes de que exista ningún razonamiento en el contexto.

    Y el orden lo pones tú. La documentación de structured outputs es explícita: la salida se produce en el mismo orden en que están las claves del schema que envías. Si quieres cambiar el orden, cambias el schema.

    // Mal: decide primero y justifica después
    const TriajeMal = z.object({
      prioridad: z.enum(["alta", "media", "baja"]),
      evidencia: z.string(),
    });
    
    // Bien: reúne evidencia, luego concluye
    const TriajeBien = z.object({
      evidencia: z
        .string()
        .describe("Cita literal del ticket que justifica la prioridad."),
      senalesRiesgo: z.array(z.enum(["caida_servicio", "perdida_datos", "cliente_enterprise"])),
      prioridad: z.enum(["alta", "media", "baja"]),
    });
    

    No es una teoría mía. El ejemplo canónico de razonamiento matemático de la propia documentación de OpenAI pone steps antes de final_answer. El schema es la plantilla del razonamiento, no solo del resultado.

    Lo mismo aplica a los nombres. date no dice nada; fechaVencimientoISO dice qué fecha es y en qué formato la quieres. El nombre del campo es contexto gratis: no lo desperdicies en abreviaturas.

    Y sobre la profundidad: los schemas planos aciertan más. El modo estricto de OpenAI admite hasta 5.000 propiedades por schema, así que el límite técnico no te va a frenar nunca. El que importa es otro: mucho antes de acercarte a esa cifra ya notarás que un objeto de cuatro niveles produce más fallos que dos llamadas con dos schemas planos.


    Dónde termina el diseño del schema y empieza la validación con Zod

    Nada de esto elimina la validación. Un schema bien diseñado reduce los fallos en origen; no los lleva a cero, y sigues necesitando safeParse, reintentos y logging.

    Esa es exactamente la frontera: este post va de lo que ocurre antes de la llamada. Lo que ocurre después —parseo seguro, limpieza defensiva, reintentos con contexto del error— lo tienes desarrollado en cómo tipar las respuestas de una LLM con Zod y TypeScript.

    Ni siquiera tienen que ser el mismo schema. Manda al modelo uno plano y con enums, y transfórmalo después a tu modelo de dominio con las utilidades genéricas de tus wrappers.


    Resumen: qué lee el modelo en cada caso

    Lo que escribes en Zod Lo que lee el modelo Cuándo usarlo
    z.string() campo de texto libre, sin restricción solo texto genuinamente libre
    z.enum([...]) "enum": ["a","b"] — lista cerrada cualquier campo con valores finitos
    .describe("...") "description": "..." — instrucción del campo campos ambiguos o con regla de negocio
    .optional() el campo desaparece de required, sin más señal casi nunca en schemas para LLM
    .nullable() "type": ["string","null"] y sigue en required cuando "no hay dato" es respuesta válida
    z.discriminatedUnion() oneOf con const en el discriminador cuando el "no lo sé" tiene matices

    Qué puedes cambiar hoy

    Abre el schema que tengas en producción y haz estas cinco pasadas. Te llevará veinte minutos:

    1. Ejecuta z.toJSONSchema(tuSchema) y lee la salida. Ese texto es tu prompt. Si te resulta ambiguo a ti, imagina al modelo.
    2. Convierte a z.enum() todo z.string() que tenga una lista finita de valores.
    3. Añade .describe() solo a los campos ambiguos, con la regla de negocio y el formato exacto.
    4. Sustituye cada .optional() por .nullable() o por una rama explícita de "desconocido" en una unión discriminada.
    5. Mueve la conclusión al final y pon delante los campos de evidencia.

    En el pipeline de facturas del principio no hizo falta tocar el modelo ni subir más los reintentos: el campo que más fallaba era una fecha obligatoria que el documento a veces no traía, y pasó de inventarse valores a declarar ilegible en cuanto dejó de ser un string a secas.

    Si además estás montando el pipeline entero —schema, llamada, validación y reintentos— eso es justo lo que construimos paso a paso en el curso Construye con IA: de la idea al producto, y en Dominicode Labs revisamos schemas reales de proyectos de la comunidad.

    La conclusión que quiero que te lleves es una sola: deja de tratar el schema como un portero que revisa la salida del modelo y empieza a tratarlo como la última instrucción que el modelo lee antes de contestar. Cambia el diseño y dejarás de necesitar tantos reintentos.


    Preguntas frecuentes

    ¿El modelo lee de verdad el .describe() de mis campos?

    Sí. .describe() se traduce a la clave description del JSON Schema, y ese JSON Schema es lo que se envía al proveedor junto con la petición. En el caso de Anthropic, la documentación muestra que las definiciones de herramientas se insertan en el system prompt en formato JSON Schema. Puedes comprobar exactamente qué se envía ejecutando z.toJSONSchema() sobre tu schema.

    ¿Usar .optional() está mal siempre?

    No, pero casi nunca es lo que quieres cuando el schema va a un modelo. .optional() hace que el campo desaparezca de required sin dejar ninguna señal sobre cuándo omitirlo. Con .nullable() el campo sigue siendo obligatorio y null es una respuesta explícita. Además, el modo estricto de structured outputs de OpenAI exige que todos los campos estén en required y documenta la unión con null como la forma de emular un opcional.

    ¿Structured Outputs elige el valor correcto o solo el formato correcto?

    Garantiza que la estructura encaje con el schema, no que el contenido sea correcto. Un modelo puede devolver una fecha con formato válido y valor inventado, o elegir el enum equivocado. Diseñar bien el schema mejora el acierto semántico; validar después sigue siendo obligatorio.

    ¿Cuántos campos debería tener un schema para un LLM?

    Menos de los que crees. El modo estricto de OpenAI admite hasta 5.000 propiedades por schema, así que el límite que importa no es el técnico sino el de acierto: la degradación empieza muchísimo antes. Si tu schema pasa de veinte campos o de dos niveles, casi siempre sale mejor partirlo en dos llamadas con schemas planos que insistir en una sola extracción gigante.

    ¿Esto aplica igual con el Vercel AI SDK?

    Sí. generateObject y las definiciones de tools convierten internamente tu schema de Zod a JSON Schema con el helper zodSchema, así que las mismas reglas de diseño aplican. La documentación del SDK recomienda además encadenar .describe() o .meta() al final de la cadena para asegurar que los metadatos acaben en el JSON Schema generado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Un martes por la tarde, la API de búsqueda de un cliente empezó a devolver 500. Un despliegue suyo mal hecho: tres minutos de caída.

    El agente que consumía esa API estuvo cuarenta minutos haciendo tonterías caras.

    Primero reintentó. Normal. Luego, al ver que la herramienta seguía fallando, hizo lo que hacen los modelos cuando se les cierra una puerta: buscar otra. Llamó a una tool que no tocaba, cambió los parámetros "por si acaso" y en el paso 14 se inventó tres productos con sus precios.

    Faltaba un circuit breaker para agentes IA. El patrón es viejo — Michael Nygard lo describió en Release It! en 2007 para microservicios y Martin Fowler lo popularizó después — pero cuando en medio del reintento hay un LLM, cambia una pieza fundamental. Y esa pieza es la que casi nadie implementa.


    Qué es un circuit breaker para agentes IA

    Un circuit breaker para agentes IA es una máquina de estados que envuelve la ejecución de cada tool: cuenta los fallos de infraestructura dentro de una ventana de tiempo y, al superar un umbral, deja de llamar a la API y devuelve al modelo un resultado estructurado que le dice que esa herramienta no está disponible y qué debe hacer en su lugar.

    La diferencia con el circuit breaker clásico de microservicios está en quién recibe el corte. Allí el consumidor es código, que obedece un 503 y ejecuta su rama de fallback. Aquí el consumidor es un LLM, que interpreta el error y decide por su cuenta. Y si no se lo dices tú, lo que decide es reintentar o inventarse el dato.


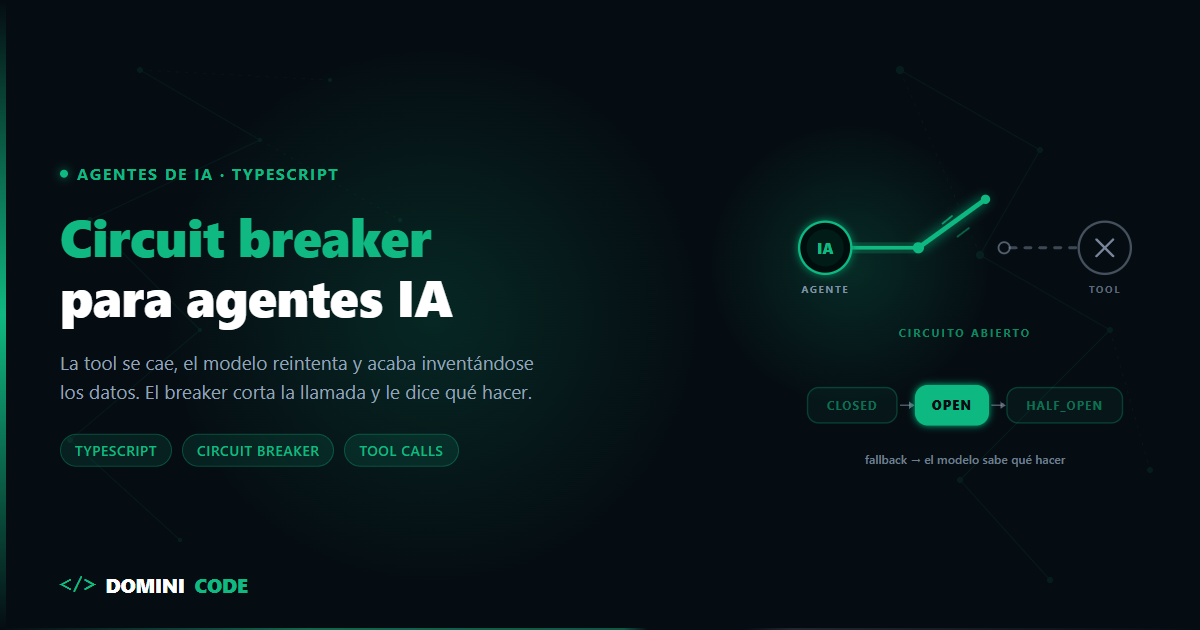
    Los tres estados del circuit breaker en un agente

    El breaker es una máquina de estados que envuelve la ejecución de una herramienta.

    CLOSED. Todo pasa. Vas contando fallos en una ventana de tiempo. Si en los últimos 60 segundos hay 4 fallos de infraestructura, abres.

    OPEN. Rechazas sin llamar a la API. Esto es lo importante: el execute de la tool ni siquiera hace fetch. Devuelve en microsegundos. No hay timeout de 30 segundos, no hay latencia, no hay una API agonizante recibiendo más carga de la que ya no puede atender.

    HALF_OPEN. Pasado el tiempo de reset, dejas pasar una sola llamada de prueba. Si funciona, vuelves a CLOSED. Si falla, vuelves a OPEN y el contador de espera empieza otra vez. Ojo con esto en un agente: si dejas pasar todas las llamadas de un turno en half-open, el modelo puede lanzar tres tool calls en paralelo y le acabas metiendo tres peticiones a un servicio que se está levantando.

    Hasta aquí es idéntico a un microservicio. La diferencia empieza en lo que devuelves cuando el circuito está abierto.


    Qué devolver al modelo cuando el circuito está abierto

    Cuando un servicio A tiene el circuito abierto contra el servicio B, devuelve un 503 y quien lo consume es código. El código no negocia: ve el 503 y ejecuta la rama de fallback que escribiste.

    En un agente, quien recibe la respuesta de la tool es un modelo de lenguaje. Y un modelo de lenguaje sí negocia.

    Si le devuelves esto:

    { "error": "request failed" }
    

    El modelo va a reintentar. No porque sea tonto, sino porque no tiene ninguna forma de saber que existe un circuito y que está abierto. Desde su punto de vista una llamada ha fallado, y lo razonable ante una llamada que falla es intentarlo otra vez, quizá con otros parámetros.

    Has puesto un breaker que ahorra la petición HTTP pero no ahorra ni una sola iteración del loop ni un solo token. El agente sigue quemando pasos hasta agotar el presupuesto que le pusiste en stopWhen — si es que se lo pusiste, que de eso hablo en el post del agentic loop.

    El resultado de una tool es un canal de comunicación con el modelo. Es prompt. Úsalo como tal.

    {
      "ok": false,
      "toolUnavailable": true,
      "retryAfterSeconds": 27,
      "instruction": "La herramienta \"searchCatalog\" está fuera de servicio por fallos repetidos del proveedor. No vuelvas a llamarla durante los próximos 27 segundos: cualquier intento se rechazará sin llegar a la API. Usa \"searchCatalogSnapshot\" (catálogo cacheado de hace unas horas) y avisa en tu respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía stock en tiempo real, dile que ese dato no está disponible ahora. No lo estimes ni lo inventes."
    }
    

    Cuatro cosas, y las cuatro hacen falta:

    1. Qué herramienta está caída, por su nombre exacto — el mismo que ve en la definición de tools.
    2. Cuánto tiempo, en segundos concretos. Un "temporalmente" no le dice nada.
    3. La prohibición explícita de reintentar, con el motivo: no es que vaya a fallar, es que ni siquiera va a salir de tu servidor.
    4. Qué hacer en su lugar, en concreto. Y la orden de no inventarse lo que la API le habría dado, que es exactamente lo que hizo el agente de mi cliente en el paso 14.

    Y la alternativa que le ofreces tiene que existir de verdad en el toolset. Mandar al modelo a una herramienta que no le has dado es pedirle justo lo que intentas evitar: que se la invente.

    Añade también una línea al system prompt explicando el protocolo: "si una tool devuelve toolUnavailable: true, esa herramienta no está disponible en este turno; sigue las instrucciones del campo instruction y no la vuelvas a llamar". El modelo cumple bastante bien cuando la instrucción es específica y llega en el sitio donde toma la decisión.


    Qué errores abren el circuito de una tool (y cuáles no)

    Aquí es donde la mayoría de implementaciones se rompen, y se rompen hacia el lado peligroso: abriendo el circuito de una API que funciona perfectamente.

    Los 5xx cuentan. Los timeouts cuentan. Los errores de red cuentan. Los 429 cuentan también, porque cuando un servicio te dice que vas demasiado rápido, lo correcto es dejar de llamarlo un rato.

    Los 4xx de validación no cuentan nunca. Si el modelo manda { query: 42 } donde había que mandar un string, la API devuelve un 400 y eso no significa que la API esté rota. Significa que el modelo la está llamando mal. Si sumas ese 400 al contador, un modelo torpe con los argumentos te abre el circuito de un servicio sano — y a partir de ahí has convertido un problema de prompt en una caída de herramienta.

    Distinguir "la herramienta está rota" de "el modelo la está llamando mal" es la diferencia entre un breaker que te salva y uno que sabotea al agente.

    Error ¿Cuenta para abrir? Por qué
    5xx Sí El servicio está roto
    429 Sí Saturado: lo correcto es dejar de llamarlo un rato
    Timeout / AbortError Sí Sin timeout no hay fallo que contar, solo un agente esperando
    ECONNREFUSED, ECONNRESET, ENOTFOUND Sí La API no está ahí
    400, 422 Nunca El modelo mandó argumentos mal formados
    404 Nunca El recurso no existe; la API respondió bien
    409 Nunca Conflicto de estado, no caída
    Error desconocido No Ante la duda no penalizas: un falso positivo tumba una herramienta sana
    // tool-errors.ts
    export class ToolHttpError extends Error {
      constructor(readonly status: number, message: string) {
        super(message);
        this.name = "ToolHttpError";
      }
    }
    
    const NETWORK_ERRORS = /ECONNREFUSED|ECONNRESET|ETIMEDOUT|ENOTFOUND|EAI_AGAIN|fetch failed/i;
    
    export function isInfrastructureFailure(error: unknown): boolean {
      if (error instanceof ToolHttpError) {
        // 5xx: el servicio está roto. 429: saturado, y lo correcto es dejar de llamar.
        // 400, 404, 409, 422: los argumentos venían mal. Eso es el modelo, no la API.
        return error.status >= 500 || error.status === 429;
      }
    
      // AbortSignal.timeout() lanza un AbortError / TimeoutError
      if (error instanceof Error && (error.name === "AbortError" || error.name === "TimeoutError")) {
        return true;
      }
    
      if (error instanceof Error) {
        // Ojo con el runtime: en Bun el código de red viaja en error.cause.code,
        // no en el mensaje. Mirar solo message deja pasar un ECONNREFUSED.
        const code = (error as { cause?: { code?: string } }).cause?.code;
        if (code && NETWORK_ERRORS.test(code)) return true;
        return NETWORK_ERRORS.test(error.message);
      }
    
      // Ante la duda, no penalizas: un falso positivo tumba una herramienta sana
      return false;
    }
    

    La política de "ante la duda no cuenta" es deliberada. Un breaker que no abre cuando debía te cuesta unos reintentos. Un breaker que abre cuando no debía te deja al agente sin una herramienta buena durante medio minuto, y el modelo se pone creativo.

    La mitad de estos 4xx los evitas antes de que ocurran con schemas estrictos en la definición de la tool. Es el mismo trabajo de blindaje que vemos en el curso de Zod para TypeScript: si el argumento no valida, ni siquiera llega a salir una petición.


    Cómo implementar un circuit breaker en TypeScript

    Factory con estado en cierre, sin dependencias. Umbral de fallos, ventana deslizante, timeout de reset y una única prueba en half-open.

    // circuit-breaker.ts
    export type BreakerState = "CLOSED" | "OPEN" | "HALF_OPEN";
    
    export class CircuitOpenError extends Error {
      constructor(readonly toolName: string, readonly retryAfterMs: number) {
        super(`Circuito abierto para la herramienta "${toolName}"`);
        this.name = "CircuitOpenError";
      }
    }
    
    export interface BreakerOptions {
      name: string;
      failureThreshold?: number;
      windowMs?: number;
      resetTimeoutMs?: number;
      isFailure?: (error: unknown) => boolean;
      onStateChange?: (from: BreakerState, to: BreakerState) => void;
    }
    
    export function createCircuitBreaker({
      name,
      failureThreshold = 4,
      windowMs = 60_000,
      resetTimeoutMs = 30_000,
      isFailure = () => true, // ¡ojo! sobrescríbelo siempre con isInfrastructureFailure
      onStateChange = () => {},
    }: BreakerOptions) {
      let state: BreakerState = "CLOSED";
      let failures: number[] = [];
      let openedAt = 0;
      let probeInFlight = false;
    
      const transition = (next: BreakerState) => {
        if (next === state) return;
        onStateChange(state, next);
        state = next;
      };
    
      const currentState = (now: number): BreakerState => {
        if (state === "OPEN" && now - openedAt >= resetTimeoutMs) {
          transition("HALF_OPEN");
        }
        return state;
      };
    
      return {
        name,
        // getState() no es puro: dispara la transición OPEN -> HALF_OPEN. Si lo
        // polleas desde un exportador de métricas, la transición la provoca la
        // observabilidad y no el tráfico real.
        getState: () => currentState(Date.now()),
        getRetryAfterMs: () => Math.max(0, resetTimeoutMs - (Date.now() - openedAt)),
    
        async execute<T>(fn: () => Promise<T>): Promise<T> {
          const now = Date.now();
          const phase = currentState(now);
    
          if (phase === "OPEN") {
            throw new CircuitOpenError(name, resetTimeoutMs - (now - openedAt));
          }
    
          // En half-open solo pasa una petición: las demás siguen rechazadas
          if (phase === "HALF_OPEN" && probeInFlight) {
            // Espera corta a propósito: si la prueba en vuelo cierra el circuito, no
            // quieres haberle dicho al modelo que abandone la tool medio minuto
            throw new CircuitOpenError(name, 1_000);
          }
          if (phase === "HALF_OPEN") probeInFlight = true;
    
          try {
            const result = await fn();
            if (phase === "HALF_OPEN") {
              probeInFlight = false;
              failures = [];
              transition("CLOSED");
            }
            return result;
          } catch (error) {
            if (!isFailure(error)) {
              // No es culpa de la herramienta: no toca el contador
              if (phase === "HALF_OPEN") probeInFlight = false;
              throw error;
            }
    
            const failedAt = Date.now();
            failures = failures.filter((t) => failedAt - t < windowMs); // ventana deslizante
            failures.push(failedAt);
    
            if (phase === "HALF_OPEN" || failures.length >= failureThreshold) {
              openedAt = failedAt;
              probeInFlight = false;
              failures = [];
              transition("OPEN");
            }
            throw error;
          }
        },
      };
    }
    
    export type CircuitBreaker = ReturnType<typeof createCircuitBreaker>;
    

    Un fallo en half-open reabre directamente, sin esperar a acumular el umbral. Es intencionado: si la prueba falla, el servicio sigue caído y no hay nada que discutir.

    Ahora el wrapper que convierte la excepción en un resultado que el modelo entiende, integrado con la definición de tools del Vercel AI SDK:

    // with-breaker.ts
    import { tool } from "ai";
    import { z } from "zod";
    import { createCircuitBreaker, CircuitOpenError, type CircuitBreaker } from "./circuit-breaker";
    import { ToolHttpError, isInfrastructureFailure } from "./tool-errors";
    
    interface UnavailableInfo {
      toolName: string;
      retryAfterSeconds: number;
    }
    
    export function withBreaker<TArgs, TResult>(
      breaker: CircuitBreaker,
      onOpen: (info: UnavailableInfo) => Record<string, unknown>,
      execute: (args: TArgs) => Promise<TResult>,
    ) {
      return async (args: TArgs) => {
        try {
          return { ok: true, data: await breaker.execute(() => execute(args)) };
        } catch (error) {
          if (error instanceof CircuitOpenError) {
            return onOpen({
              toolName: error.toolName,
              retryAfterSeconds: Math.max(1, Math.ceil(error.retryAfterMs / 1000)),
            });
          }
          // Este fallo puede ser justo el que acaba de abrir el circuito: el modelo
          // tiene que enterarse ahora, no en la siguiente iteración
          if (breaker.getState() === "OPEN") {
            return onOpen({
              toolName: breaker.name,
              retryAfterSeconds: Math.max(1, Math.ceil(breaker.getRetryAfterMs() / 1000)),
            });
          }
    
          // Fallo puntual con el circuito cerrado: el modelo aún puede reintentar,
          // pero necesita saber qué falló para no repetir la misma llamada
          return { ok: false, error: error instanceof Error ? error.message : "Error desconocido" };
        }
      };
    }
    
    const searchBreaker = createCircuitBreaker({
      name: "searchCatalog",
      failureThreshold: 4,
      windowMs: 60_000,
      resetTimeoutMs: 30_000,
      isFailure: isInfrastructureFailure,
    });
    
    export const searchCatalog = tool({
      description: "Busca productos en el catálogo en tiempo real",
      inputSchema: z.object({ query: z.string().min(2) }),
      execute: withBreaker(
        searchBreaker,
        ({ toolName, retryAfterSeconds }) => ({
          ok: false,
          toolUnavailable: true,
          retryAfterSeconds,
          instruction:
            `La herramienta "${toolName}" está fuera de servicio por fallos repetidos del proveedor. ` +
            `No vuelvas a llamarla durante los próximos ${retryAfterSeconds} segundos: cualquier ` +
            `intento se rechazará sin llegar a la API. Usa "searchCatalogSnapshot" y avisa en tu ` +
            `respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía ` +
            `stock en tiempo real, dile que ese dato no está disponible ahora. No lo inventes.`,
        }),
        async ({ query }: { query: string }) => {
          const res = await fetch(`${process.env.CATALOG_API}/search?q=${encodeURIComponent(query)}`, {
            signal: AbortSignal.timeout(4_000),
          });
          if (!res.ok) throw new ToolHttpError(res.status, `Búsqueda falló con ${res.status}`);
          return res.json();
        },
      ),
    });
    

    Fíjate en el segundo if del catch: el fallo que abre el circuito también tiene que hablarle al modelo. Si esperas a la siguiente llamada para avisarle, has regalado una iteración entera del loop justo en el peor momento, el momento en que acabas de decidir que la herramienta está muerta.

    El ejemplo va sobre el AI SDK de Vercel 7, donde el schema de la tool se declara en inputSchema. Ese nombre existe desde la 5: si sigues en la 4.x el campo se llama parameters y el resto del wrapper no cambia.

    Fíjate también en el AbortSignal.timeout(4_000). Sin timeout explícito no hay breaker que valga: una petición colgada no genera un fallo que contar, genera un agente esperando. El timeout es lo que convierte "lento" en "fallido", y sin eso el patrón entero no arranca. Es el tipo de detalle que trato en programación defensiva en TypeScript.


    Un breaker por herramienta, nunca uno global

    Si la API de búsqueda está caída, la base de datos sigue respondiendo perfectamente. Un breaker global convierte un fallo parcial en una caída total del agente: pierdes cuatro herramientas sanas por culpa de una rota.

    Un registro por nombre de tool y listo:

    const breakers = new Map<string, CircuitBreaker>();
    
    export const breakerFor = (name: string, options: Partial<BreakerOptions> = {}): CircuitBreaker => {
      const existing = breakers.get(name);
      if (existing) return existing;
    
      const created = createCircuitBreaker({ name, isFailure: isInfrastructureFailure, ...options });
      breakers.set(name, created);
      return created;
    };
    

    Y una advertencia que cuesta una tarde de depuración: el estado del breaker tiene que vivir fuera de la petición. Si creas el breaker dentro del handler del chat, cada conversación arranca con el contador a cero y el patrón no protege absolutamente nada. Ámbito de módulo como mínimo. Si corres en serverless con varias instancias, el estado compartido va a Redis o cada instancia aprenderá por su cuenta que la API está caída — y pagarás el aprendizaje N veces.

    Y los umbrales no son iguales para todas: una API de pagos crítica aguanta 6 fallos antes de abrir, un scraper de enriquecimiento prescindible abre a los 2.


    El fallback: qué le das al modelo cuando no hay datos

    Tienes tres opciones, y elegir mal aquí desperdicia el breaker.

    Respuesta cacheada. El último snapshot bueno. Sirve para catálogos, listados y configuración. Obligatorio decirle al modelo que los datos son viejos y de cuándo son, para que lo declare en su respuesta.

    Herramienta degradada. Búsqueda local en vez de búsqueda semántica remota. Peor resultado, cero dependencia externa.

    Seguir sin el dato, declarándolo. La opción más honesta y la más infravalorada. El agente termina la tarea con la información que tiene y dice explícitamente qué no pudo comprobar. Mucho mejor que un dato inventado con toda la confianza del mundo.

    Y una cuarta que a veces es la correcta: parar y escalar al humano. Si la herramienta caída era imprescindible para la tarea, seguir es peor que rendirse. Igual que con los guardrails de ejecución, la decisión de frenar es parte del diseño, no un fallo.


    Cómo saber si tu breaker está bien calibrado

    Un breaker sin métricas es un valor mágico que alguien puso hace seis meses. Registra el cambio de estado con onStateChange y mira tres números:

    Aperturas por hora y por herramienta. Si una tool abre 5 veces por hora contra una API que su proveedor jura estar sana, tu umbral es demasiado bajo o estás contando 4xx que no deberías. Revisa el clasificador antes que el umbral.

    Tiempo total en OPEN. Es tu indisponibilidad real de esa capacidad. Si una herramienta pasa el 20% del día en OPEN, el problema ya no es el breaker: es el proveedor, y toca renegociarlo o buscar alternativa.

    Ratio de half-open que vuelven a abrir. El indicador de flapping. Por encima del 70% significa que tu resetTimeoutMs es demasiado corto y estás probando un servicio que aún no se ha levantado, gastando una llamada de tool en cada intento. Alarga el backoff de forma progresiva: 30s, 60s, 2 min. La versión de arriba usa un resetTimeoutMs fijo; para escalarlo, multiplícalo por el número de aperturas consecutivas antes de asignar openedAt.

    Y una cuarta que solo existe en agentes: qué hizo el modelo después de recibir el fallback. Loguea la siguiente tool call tras un toolUnavailable. Si el modelo vuelve a llamar a la herramienta caída, tu mensaje no está siendo lo bastante claro y toca reescribirlo. Los pasos que se ahorra el agente los ves directamente en el consumo de tokens por tarea.


    Por dónde empezar con el circuit breaker en tu agente

    Coge tu agente. Mira la tool que llama al servicio externo menos fiable — todos tenemos una. Ponle un timeout explícito, un breaker propio con isFailure que ignore los 4xx de validación, y un mensaje de fallback escrito para el modelo y no para tu log.

    Esa única herramienta es el 80% del beneficio. El resto es replicar el patrón.

    La idea de fondo: en un agente, cualquier mecanismo de defensa que no le hable al modelo se queda a medias. Puedes cortar la petición HTTP, pero si no le explicas al LLM qué ha pasado y qué esperas de él, el modelo rellenará el hueco con lo que se le ocurra. Y lo que se le ocurre suele ser caro.

    Esta forma de pensar la arquitectura — decidir antes de escribir código qué hace el sistema cuando algo falla — es exactamente el enfoque del curso Construye con IA: de la idea al producto. Y si quieres ver estos patrones montados sobre proyectos reales, con las métricas puestas y funcionando, en Dominicode Labs es donde los estamos rodando.


    Preguntas frecuentes

    ¿Qué diferencia hay entre un circuit breaker y un simple retry con backoff?

    El retry insiste; el breaker deja de insistir. Son complementarios: el backoff resuelve el fallo puntual dentro de una misma llamada, y el breaker resuelve el fallo sostenido a lo largo de muchas llamadas. Sin breaker, tu retry con backoff se ejecuta entero en cada una de las 14 iteraciones del agente contra un servicio que lleva minutos caído.

    ¿Cuántos fallos deben abrir el circuito de una tool?

    Entre 3 y 5 dentro de una ventana de 60 segundos funciona bien como punto de partida. Con umbral 1 o 2 abres por un pico transitorio; por encima de 8 el agente ya habrá gastado medio presupuesto de pasos antes de que el breaker reaccione. Ajústalo por criticidad: más tolerancia en herramientas imprescindibles, menos en las prescindibles.

    ¿Debe contar un error 400 de una tool para abrir el circuito?

    No. Un 400, un 404 o un 422 casi siempre significan que el modelo mandó argumentos mal formados, no que la API esté rota. Si los cuentas, acabas abriendo el circuito de un servicio sano por culpa del LLM y dejando al agente sin una herramienta que funcionaba. Cuentan los 5xx, los timeouts, los errores de red y los 429.

    ¿Dónde guardo el estado del breaker si mi agente corre en serverless?

    En un almacén compartido tipo Redis, con el nombre de la herramienta como clave. Si lo dejas en memoria de proceso, cada instancia fría descubre por su cuenta que el proveedor está caído y pagas ese descubrimiento tantas veces como instancias tengas. Para un servidor de larga vida, el ámbito de módulo basta.

    ¿El circuit breaker sustituye al límite de pasos del agente?

    No, resuelven cosas distintas. El límite de pasos acota cuánto puede trabajar el agente en total; el breaker impide que una herramienta rota consuma esos pasos sin aportar nada. Van juntos: el breaker devuelve el control rápido y con instrucciones, y el límite de pasos sigue siendo la red de seguridad final.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Human in the loop: tu agente no puede esperar en un await

    Human in the loop: tu agente no puede esperar en un await

    El mensaje llegó a Slack a las 19:42: «El agente quiere reembolsar 38 pagos por 4.120 €. ¿Apruebas?».

    La responsable de soporte de mi cliente, Marta, lo leyó a las 23:10, desde el sofá, y pulsó el botón verde. No pasó nada.

    Bueno, esa noche no pasó nada. Al día siguiente pasó tres veces de más.

    El human in the loop de aquel agente eran catorce líneas: una llamada a Slack y un await esperando la respuesta. En local funcionaba precioso. En producción, la función serverless se había muerto tres horas antes de que nadie pulsara nada, con la conversación entera en memoria.

    El arreglo de urgencia fue relanzar el agente con «el usuario ya aprobó los reembolsos» metido en el prompt. El modelo volvió a planificar desde cero, esta vez encontró 41 pagos fallidos en vez de 38 — habían entrado tres nuevos por la noche — y reembolsó los 41.

    El humano había aprobado 38. El agente ejecutó 41. Y nadie podía decir qué se aprobó exactamente, porque la propuesta solo había existido en la RAM de un proceso muerto.

    Eso no es un bug. Es lo que pasa cuando tratas la aprobación humana como un if.


    Qué es el human in the loop: la aprobación es asíncrona, tu loop no

    El human in the loop (HITL) en un agente de IA es el patrón por el que el agente detiene su ejecución antes de una acción irreversible —mover dinero, enviar emails, borrar datos, desplegar— y solo continúa cuando una persona la aprueba, la edita o la rechaza. La diferencia entre que funcione y que no está en dónde ocurre esa pausa: no dentro del bucle, sino al final de una ejecución que termina y de otra que la retoma.

    El agentic loop es una función: el modelo piensa, pide una herramienta, tú la ejecutas, le devuelves el resultado, repites. Todo dentro de la misma llamada, con el array de mensajes creciendo en memoria.

    Meter una aprobación humana ahí parece trivial. Un if antes de ejecutar, una notificación, y esperas.

    El problema es lo que hay al otro lado de esa espera: una persona. Y en lo que llevo medido, una persona tarda entre cuarenta segundos y dos días. Tu proceso no aguanta ni lo primero.

    Se muere por el timeout de la función serverless. Se muere porque despliegas. Se muere por un reinicio del contenedor, por un OOM, porque el usuario cerró la pestaña y tu handler se canceló. Un await de seis horas no es una espera: es una apuesta a que nada se reinicie en seis horas.

    Y en el caso improbable de que sobreviva, tienes un proceso vivo con la conversación completa en memoria, sin hacer absolutamente nada, ocupando RAM y una conexión abierta. Multiplícalo por doscientas aprobaciones pendientes un lunes por la mañana.

    Hay un tercer problema, y es el que acaba en una reunión incómoda: si el estado vive en memoria, no existe. Nadie puede responder a «¿qué aprobó exactamente Marta el jueves a las 23:10?».

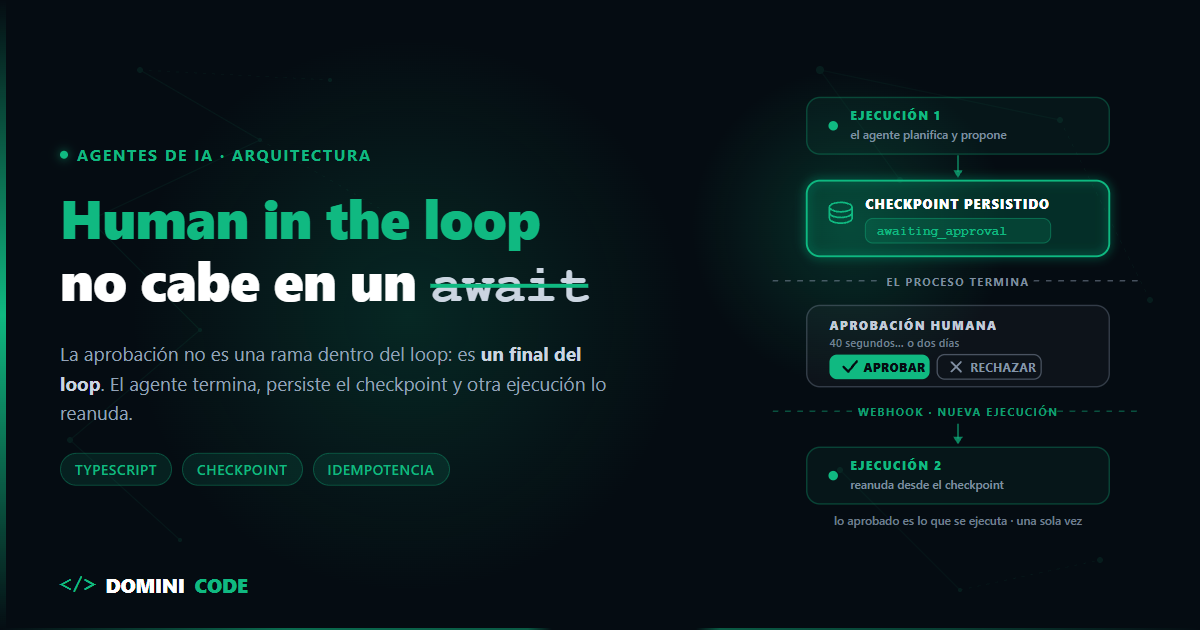
    Así que la regla de diseño es esta: la aprobación humana no es una rama dentro del loop, es un final del loop. El agente termina su ejecución devolviendo un estado «esperando decisión». Una ejecución nueva y distinta, disparada por el webhook de aprobación, lo retoma donde se quedó.

    Un punto de aprobación es una frontera de proceso. Todo lo demás sale de ahí.


    Qué acciones necesitan aprobación humana: los tres niveles de riesgo

    Antes de suspender nada hay que decidir qué merece suspenderse. Y aquí casi todo el mundo se pasa de frenada.

    Un agente que pregunta cuarenta veces al día se desactiva solo. Peor todavía: no se desactiva, y el humano aprende a pulsar «Aprobar» sin leer. Un botón que se pulsa siempre no es un control, es un ritual.

    Clasifica cada herramienta en tres niveles:

    Nivel Ejemplos ¿Aprobación?
    Read-only Buscar pedidos, leer un fichero, consultar saldo Nunca. Ni una sola vez
    Reversible Crear un borrador, etiquetar, abrir un PR, escribir en staging No, pero deja rastro y ten un deshacer
    Irreversible Reembolsar, enviar email, borrar registros, desplegar, publicar Sí, salvo por debajo de un umbral

    El matiz que lo cambia todo: el riesgo no está en la herramienta, está en los argumentos. sendEmail a un destinatario es soporte normal; a doce mil, es una campaña que nadie autorizó. refundPayments de 3 € es ruido; de 4.120 € es una conversación.

    Y el lote es una decisión, no treinta y ocho. Si tu tool reembolsa de uno en uno, el agente pedirá permiso treinta y ocho veces y habrás construido el autoclick con tus propias manos. La herramienta que se aprueba recibe el lote entero y el umbral se calcula sobre el total.

    Por eso la política de aprobación es una función del input, no un booleano en la definición de la tool:

    // tool-policy.ts
    export type RiskLevel = "read_only" | "reversible" | "irreversible";
    export type ApprovalMode = "auto" | "human";
    
    export interface ToolPolicy<TInput> {
      risk: RiskLevel;
      approval: (input: TInput) => ApprovalMode;
    }
    
    const definePolicy = <TInput>(policy: ToolPolicy<TInput>): ToolPolicy<TInput> => policy;
    
    export const toolPolicies = {
      searchOrders: definePolicy<{ status: string }>({
        risk: "read_only",
        approval: () => "auto",
      }),
      draftRefundReport: definePolicy<{ orderIds: string[] }>({
        risk: "reversible",
        approval: () => "auto",
      }),
      refundPayments: definePolicy<{ orderIds: string[]; totalCents: number }>({
        risk: "irreversible",
        // El umbral mira el lote entero, no el pago suelto.
        approval: ({ orderIds, totalCents }) =>
          totalCents > 5_000 || orderIds.length > 1 ? "human" : "auto",
      }),
      sendEmail: definePolicy<{ to: string[]; subject: string }>({
        risk: "irreversible",
        approval: ({ to }) => (to.length > 1 ? "human" : "auto"),
      }),
      deleteCustomers: definePolicy<{ ids: string[] }>({
        risk: "irreversible",
        approval: () => "human",
      }),
    } as const;
    
    export function approvalModeFor(toolName: string, input: unknown): ApprovalMode {
      const policy = toolPolicies[toolName as keyof typeof toolPolicies];
      // Fail-closed: una tool que no está en el mapa NO se ejecuta sola.
      // El día que alguien añada una herramienta y olvide la política, el
      // agente preguntará de más. Ese es el fallo barato.
      if (!policy) return "human";
      return (policy.approval as (input: unknown) => ApprovalMode)(input);
    }
    

    El cast de la última línea es el precio de tener un mapa heterogéneo. Lo pago en un único punto del sistema y no en cada herramienta, que es justo el reparto que quiero.

    Los umbrales no son constantes de por vida. Empieza pidiendo aprobación de todo lo irreversible, y a las tres semanas, con el registro de decisiones delante, súbelos donde el humano lleve treinta aprobaciones seguidas sin rechazar ni una. Si un umbral nunca se ha movido, es que nadie está mirando.

    Y si al terminar la clasificación resulta que todo requiere aprobación, no tienes un agente: tienes un formulario caro. Eso significa que le has dado herramientas que no debía tener, y el arreglo está antes, en el perímetro de ejecución, como conté en guardrails para agentes con acceso a terminal y base de datos.

    Esta tabla, además, se escribe antes que el código. Qué es irreversible en tu dominio es una decisión de producto, no de implementación, y va en la spec junto al resto de reglas del sistema — es literalmente uno de los apartados que defiendo en el libro de Spec-Driven Development.


    Cómo interrumpir y reanudar un agente de IA sin perder el estado

    Ahora el núcleo. El loop tiene que poder terminar a mitad de un turno y volver a arrancar horas después como si nada.

    Declaro las herramientas sin función de ejecución: el modelo puede pedirlas, pero quien decide si se ejecutan soy yo, en mi código. Ese es el punto de control.

    // agent-run.ts
    import { generateText, type ModelMessage, type JSONValue } from "ai";
    import { approvalModeFor } from "./tool-policy";
    import { buildPreview, type ApprovalPreview } from "./preview";
    import { checkpoints } from "./checkpoints";
    import { executeTool } from "./execute-tool";
    // model, SYSTEM_PROMPT y toolSchemas salen de tu configuración del agente.
    // executeTool: (call: PendingCall, opts?: { idempotencyKey?: string }) => Promise<JSONValue>
    import { model, SYSTEM_PROMPT, toolSchemas } from "./config";
    
    export interface PendingCall {
      toolCallId: string;
      toolName: string;
      input: unknown;
    }
    
    export interface PendingApproval extends PendingCall {
      approvalId: string;
      preview: ApprovalPreview;
      requestedAt: string;
      expiresAt: string;
    }
    
    export type AgentOutcome =
      | { status: "completed"; text: string }
      | { status: "awaiting_approval"; runId: string; approval: PendingApproval }
      | { status: "already_resolved" }
      | { status: "exhausted"; stepsUsed: number };
    
    const MAX_STEPS = 12;
    
    // El shape exacto del resultado de tool depende de tu SDK.
    // Este es el de AI SDK 5+; en 4.x era { type: "tool-result", result }.
    export const toolResult = (call: PendingCall, value: JSONValue) => ({
      type: "tool-result" as const,
      toolCallId: call.toolCallId,
      toolName: call.toolName,
      output: { type: "json" as const, value },
    });
    
    export async function runAgent(
      runId: string,
      initial: ModelMessage[],
      stepsUsed = 0,
    ): Promise<AgentOutcome> {
      const messages = [...initial];
    
      for (let step = stepsUsed; step < MAX_STEPS; step++) {
        const turn = await generateText({ model, system: SYSTEM_PROMPT, messages, tools: toolSchemas });
        messages.push(...turn.response.messages);
    
        if (turn.toolCalls.length === 0) return { status: "completed", text: turn.text };
    
        const results: ReturnType<typeof toolResult>[] = [];
    
        for (const [index, call] of turn.toolCalls.entries()) {
          // En AI SDK 4.x los argumentos viajan en call.args, no en call.input
          if (approvalModeFor(call.toolName, call.input) === "auto") {
            results.push(toolResult(call, await executeTool(call)));
            continue;
          }
    
          // Hay una llamada que necesita un humano. El turno se acaba aquí.
          // Las llamadas que quedaban detrás NO se ejecutan, pero necesitan
          // un resultado: el protocolo exige responder a todas las tool calls.
          const deferred = turn.toolCalls.slice(index + 1).map((rest) =>
            toolResult(rest, {
              ok: false,
              deferred: true,
              instruction:
                "No se ejecutó: el turno se detuvo esperando una aprobación humana. " +
                "Si sigue siendo necesaria, vuelve a pedirla después.",
            }),
          );
    
          const approval: PendingApproval = {
            ...call,
            approvalId: crypto.randomUUID(),
            preview: await buildPreview(call),
            requestedAt: new Date().toISOString(),
            expiresAt: new Date(Date.now() + 24 * 60 * 60 * 1000).toISOString(),
          };
    
          await checkpoints.save({
            runId,
            messages,
            partialResults: [...results, ...deferred],
            approval,
            stepsUsed: step + 1, // el presupuesto no se reinicia al reanudar
          });
    
          return { status: "awaiting_approval", runId, approval };
        }
    
        messages.push({ role: "tool", content: results });
      }
    
      return { status: "exhausted", stepsUsed: MAX_STEPS };
    }
    

    Fíjate en el bloque deferred, que es la parte que casi nadie ve venir. Cuando el modelo pide tres herramientas en el mismo turno y la segunda necesita aprobación, no puedes limitarte a guardar y salir: los proveedores exigen que cada tool call tenga su resultado antes de continuar la conversación. Si dejas una huérfana, al reanudar te comes un 400 y no entiendes por qué — el AI SDK tiene hasta un error con nombre propio para esto, MissingToolResultsError.

    El checkpoint guarda tres cosas y las tres hacen falta: los mensajes hasta ese punto, los resultados parciales del turno a medias, y la llamada pendiente con su preview. Eso es todo el agente, serializado. En Postgres, en una tabla con run_id, approval_id, status y un jsonb.

    El resto de la función que expone esto por HTTP es aburrido a propósito: si el status es awaiting_approval, mandas la notificación y devuelves un 202. La petición termina. El proceso puede morirse tranquilo. Y el presupuesto de pasos sigue siendo tuyo, exactamente igual que en el agentic loop en producción.

    Esto es, con otros nombres, lo que hacen los frameworks. LangGraph lo llama interrupts: la función interrupt() congela el grafo, el checkpointer persiste el estado y se reanuda con new Command({ resume }) sobre el mismo thread_id.

    El AI SDK trae tool approvals, y aquí hay que fijarse en dos cosas. La primera, dónde se declara: toolApproval no va dentro de la tool, va como opción de generateText, streamText o del ToolLoopAgent, en un mapa indexado por nombre de herramienta. Cada política recibe el input tipado y devuelve 'user-approval', undefined si no aplica, o un { type: 'denied', reason }. La segunda, la versión: esa API llegó en la v7 y no existe en la 5, que es contra la que está escrito el código de este post.

    Enfoque Cómo se pausa Dónde vive el estado Qué te sigue tocando a ti
    Propio (este post) El loop devuelve awaiting_approval y la API un 202 Tabla agent_runs en Postgres, columna jsonb Todo, pero sin sorpresas
    LangGraph interrupt() congela el grafo en el nodo Checkpointer (memoria, Postgres, SQLite) Caducidad, idempotencia y el mensaje de rechazo
    AI SDK v7 toolApproval deja la tool pendiente Lo persistes tú Dónde guardas los mensajes y qué haces al reanudar

    Úsalos si te encajan — pero ninguno responde por ti dónde vive el checkpoint, quién limpia los que nadie aprobó y qué le cuentas al modelo cuando la respuesta es que no. Si prefieres modelar todo esto como estados explícitos, el enfoque de grafo de estados frente al loop clásico resuelve bastante bien la parte de la máquina de estados.

    Los ejemplos de este post están escritos y verificados en septiembre de 2026 contra AI SDK 5 y LangGraph JS; si estás en AI SDK 4.x, los argumentos viajan en call.args y el resultado en result en vez de output.


    Qué debe ver el humano: sin datos, la aprobación es una firma

    «El agente quiere borrar 1.204 clientes. ¿Apruebas?» no es una pregunta. Es un trámite.

    Nadie puede aprobar eso de verdad, porque no hay nada que evaluar. Y si no hay nada que evaluar, el humano no está decidiendo: está firmando.

    El payload de aprobación tiene que llevar lo suficiente para decir que no:

    // preview.ts
    export interface ApprovalPreview {
      title: string;          // "Reembolsar 38 pagos — 4.120,00 €"
      rationale: string;      // por qué el agente cree que hay que hacerlo
      impact: string[];       // efectos concretos, contados
      payload: unknown;       // exactamente lo que se va a ejecutar, sin resumir
      sample: unknown[];      // 5 filas afectadas, para oler el error
      reversible: boolean;
      precondition: { name: string; value: string | number }; // se revalida al reanudar
    }
    

    Cuatro reglas, y la primera es innegociable.

    El preview lo genera tu código, no el modelo. Si el resumen que lee el humano lo escribe el mismo LLM cuya acción estás supervisando, has montado un control donde el vigilado redacta el informe. Y si esa tool call llegó por una inyección de prompt en un email que el agente leyó, el resumen viene envenenado igual — el mismo problema que trato en tácticas defensivas contra inyección de prompts. El texto lo compone tu función a partir de los argumentos y de una consulta real a tu base de datos.

    Números, no adverbios. «Varios registros» no se puede aprobar. «1.204 registros, de los cuales 6 tienen facturas emitidas este trimestre» se aprueba o se rechaza en cuatro segundos.

    Una muestra. Cinco filas de las que van a cambiar. Es donde el humano detecta que el filtro estaba mal, y le cuesta una consulta barata a tu API.

    Una precondición y una caducidad. Guarda el número que justificaba la acción — 38 pagos fallidos — y vuelve a comprobarlo al reanudar. Una aprobación de hace seis horas puede estar aprobando un mundo que ya no existe: si ahora hay 41, no ejecutas, vuelves a preguntar. Exactamente el fallo que le costó tres reembolsos de más a mi cliente.


    Idempotencia: reanudar el agente sin ejecutar la acción dos veces

    Persistir el estado abre la puerta al segundo problema del día: el botón se puede pulsar dos veces. Y se pulsa. El humano da doble clic, el webhook de Slack reintenta porque tu 200 tardó, alguien reenvía el enlace por WhatsApp.

    Necesitas dos capas, porque cada una tapa un agujero distinto.

    La primera es un compare-and-swap en la base de datos. No leas el checkpoint y luego lo actualices: reclámalo en una sola sentencia atómica.

    UPDATE agent_runs
       SET status = 'resuming', resolved_at = now()
     WHERE run_id = $1
       AND approval_id = $2
       AND status = 'awaiting_approval'
    RETURNING checkpoint;
    

    Si devuelve cero filas, alguien te ganó la carrera. No es un error: es el sistema funcionando. Devuelves un 200 idempotente y te callas.

    Y ponle un timeout también al estado resuming: si el proceso se muere justo después de reclamar el checkpoint, esa fila se queda ahí para siempre y el job de caducidad, que solo mira awaiting_approval, no la va a rescatar nunca.

    // resume.ts
    export type Decision =
      | { type: "approved"; approvedBy: string }
      | { type: "approved_with_changes"; approvedBy: string; input: unknown }
      | { type: "rejected"; approvedBy: string; reason: string };
    
    export async function resumeRun(
      runId: string,
      approvalId: string,
      decision: Decision,
    ): Promise<AgentOutcome> {
      const claimed = await checkpoints.claim(runId, approvalId);
      if (!claimed) return { status: "already_resolved" };
    
      const { messages, partialResults, approval, stepsUsed } = claimed;
    
      if (decision.type === "rejected") {
        const denial = toolResult(approval, buildDenialResult(approval, decision));
        return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, denial] }], stepsUsed);
      }
    
      const input =
        decision.type === "approved_with_changes" ? decision.input : approval.input;
    
      // El payload lleva horas en la base de datos y vuelve a entrar por la puerta.
      // Se valida otra vez contra el schema de la tool, como si viniera de fuera.
      const parsed = toolSchemas[approval.toolName as keyof typeof toolSchemas].inputSchema.parse(input);
    
      // La precondición que vio el humano tiene que seguir siendo verdad
      const still = await checkPrecondition(approval.preview.precondition);
      if (!still.ok) return requestApprovalAgain(runId, approval, still.current);
    
      // idempotencyKey = approvalId: si esto se ejecuta dos veces, el proveedor
      // devuelve el mismo resultado en lugar de mover el dinero otra vez
      const output = await executeTool({ ...approval, input: parsed }, { idempotencyKey: approvalId });
    
      const result = toolResult(approval, {
        ok: true,
        approvedBy: decision.approvedBy,
        executedInput: parsed, // lo que se ejecutó de verdad, no lo que se pidió
        data: output,
      });
    
      return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, result] }], stepsUsed);
    }
    

    La segunda capa es la idempotencia aguas abajo. El compare-and-swap te protege del doble clic, pero no del proceso que se cae justo entre mover el dinero y escribir en la base de datos que lo movió. Para eso la acción tiene que ser idempotente en el otro extremo: la clave de idempotencia de Stripe, una restricción única en la tabla de efectos, un INSERT ... ON CONFLICT DO NOTHING. Usa el approvalId como clave y el reintento devuelve el mismo resultado en lugar de un segundo reembolso. Y no es casualidad que el expiresAt de la aprobación sean 24 horas: Stripe purga las claves de idempotencia a partir de las 24 horas de antigüedad, así que una aprobación que sobreviviera a esa ventana perdería justo la red que la protegía.

    Y ojo con el parse de esa función, que parece decorativo y no lo es. Ese payload salió de tu proceso hace ocho horas, ha dormido en una base de datos y vuelve por un endpoint público. Tratarlo como dato de confianza porque «lo generamos nosotros» es el tipo de suposición que valido siempre en frontera, con el enfoque de schemas del curso de Zod para TypeScript.


    Qué le devuelves al modelo cuando el humano dice que no

    Aquí es donde se cae la mitad de las implementaciones que he revisado.

    Devuelven esto:

    { "error": "denied" }
    

    Y el modelo hace lo que hace un modelo ante una puerta cerrada: buscar otra. Reintenta con parámetros distintos, parte el borrado en dos llamadas de 600 registros, o directamente redacta una respuesta final diciendo que los reembolsos se han procesado correctamente. Un rechazo que parece un fallo técnico se lee como un fallo técnico.

    El resultado de una tool es prompt. Escríbelo como tal:

    {
      "ok": false,
      "approvalDenied": true,
      "toolName": "refundPayments",
      "deniedBy": "marta@cliente.com",
      "reason": "12 de los 38 pagos son de un lote que ya se reembolsó manualmente el viernes.",
      "instruction": "Un humano ha rechazado esta acción. No vuelvas a llamar a \"refundPayments\" en esta conversación, ni con otros parámetros, ni en lotes más pequeños, ni a través de otra herramienta. No intentes conseguir el mismo efecto por otra vía. Explica al usuario qué ibas a hacer, cuál fue el motivo del rechazo, y termina el turno sin ejecutar nada más."
    }
    

    Cuatro ingredientes y los cuatro son necesarios:

    1. Que fue una persona, no un error de red. Cambia por completo la interpretación.
    2. El motivo en lenguaje humano. Es información nueva y real que el modelo no tenía.
    3. La prohibición de buscar rutas alternativas, dicha de forma explícita. Sin esta línea, el modelo trocea la acción y lo vuelve a intentar.
    4. Qué hacer ahora. Terminar y reportar. Si no le das salida, se inventa una.

    Y existe un tercer estado que casi nadie modela: aprobado con cambios. El humano no rechaza, edita — baja el reembolso a 26 pagos y aprueba. En ese caso, el resultado que devuelves debe llevar el executedInput real, porque si el modelo cree que se ejecutaron 38 va a escribirle al usuario que se reembolsaron 38. La verdad de lo que pasó viaja en el resultado de la tool o no viaja.

    Añade también una línea al system prompt describiendo el protocolo: «si el resultado de una herramienta trae approvalDenied: true, esa acción está vetada para el resto de la conversación; sigue el campo instruction y no busques alternativas». El modelo obedece bastante bien cuando la instrucción es específica y llega en el momento en que toma la decisión.


    Cómo implementar human in the loop hoy en tu agente

    No montes el sistema entero. Coge la herramienta más peligrosa de tu agente — todos sabemos cuál es — y hazle tres cosas esta tarde.

    Sácala del execute automático. Haz que tu loop, al llegar a ella, guarde los mensajes y la llamada pendiente en una tabla y devuelva un 202. Y escribe el resultado de rechazo como si fuera un prompt, porque lo es.

    Con eso ya tienes lo importante: un agente que puede quedarse esperando sin estar vivo.

    La idea de fondo es la misma que con cualquier mecanismo de defensa en un agente: si no le hablas al modelo, no lo estás controlando, solo lo estás frenando. Y un modelo frenado sin explicaciones busca la puerta de al lado.

    Decidir todo esto antes de escribir el código — qué es irreversible, quién aprueba, qué pasa cuando la respuesta es no — es el método que enseño en el curso Construye con IA: de la idea al producto.

    Y si prefieres verlo funcionando antes que leerlo, en Dominicode Labs estamos rodando estos checkpoints sobre proyectos reales, con la tabla de aprobaciones y el audit trail puestos.


    Preguntas frecuentes

    ¿Qué es human in the loop en un agente de IA?

    Human in the loop (HITL) es el patrón por el que un agente de IA detiene su ejecución antes de realizar una acción irreversible y solo continúa cuando una persona la aprueba, la edita o la rechaza. En una implementación correcta la pausa no es un await: el agente termina su ejecución guardando un checkpoint con los mensajes y la llamada pendiente, y una ejecución nueva, disparada por la decisión del humano, lo reanuda desde ahí. Aplica a mover dinero, enviar emails masivos, borrar registros, desplegar y publicar.

    ¿Puedo implementar human in the loop con un simple await hasta que el humano responda?

    Solo si el humano contesta en segundos y tu proceso es de larga vida. En cuanto la aprobación puede tardar minutos, el await deja de ser una espera y pasa a ser una apuesta: un despliegue, un timeout de la función serverless o un reinicio del contenedor se llevan por delante todo el estado del agente. Además pagas RAM y una conexión abierta por cada aprobación pendiente. La alternativa correcta es terminar la ejecución, persistir el checkpoint y reanudar con una ejecución nueva.

    ¿Qué acciones de un agente deben requerir aprobación humana?

    Las irreversibles, y dentro de ellas solo las que superan un umbral. Todo lo de solo lectura va sin aprobación siempre; lo reversible va sin aprobación pero con registro y con una forma de deshacer; lo irreversible — mover dinero, enviar emails, borrar, desplegar, publicar — pide permiso. El umbral se calcula sobre los argumentos, no sobre la herramienta: un reembolso de 3 € y uno de 4.000 € usan la misma tool y no tienen el mismo riesgo.

    ¿Dónde guardo el estado del agente mientras espera la aprobación?

    En un almacén duradero fuera del proceso: una tabla en Postgres con run_id, approval_id, status y una columna jsonb con los mensajes, los resultados parciales del turno y la llamada pendiente. Redis sirve si tiene persistencia y si el TTL es mayor que el tiempo máximo de aprobación, pero para acciones que mueven dinero quieres una tabla auditable donde consultar meses después quién aprobó qué.

    ¿Qué pasa si nadie aprueba nunca la acción del agente?

    Que se te llena la base de datos de agentes zombis, así que la caducidad forma parte del diseño. Pon un expiresAt en cada aprobación, y un job que cierre las vencidas devolviendo al modelo un resultado de expiración con la misma estructura que el rechazo — para que el agente pueda cerrar la conversación explicando qué quedó sin hacer. Si un tipo de aprobación caduca de forma sistemática, el problema no es el TTL: es que estás pidiendo permiso para algo que a nadie le importa.

    ¿Cómo evito que el agente ejecute dos veces si la aprobación llega duplicada?

    Con dos capas. La primera es reclamar el checkpoint con un UPDATE ... WHERE status = 'awaiting_approval' RETURNING, en una sola sentencia atómica: si devuelve cero filas, otro ya lo reanudó y no ejecutas nada. La segunda es hacer idempotente la acción en el otro extremo, usando el approvalId como clave de idempotencia o como restricción única, porque el compare-and-swap no te salva si el proceso se cae justo después de mover el dinero y antes de registrarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Agentic Loop en TypeScript: cómo evitar el bucle infinito

    Agentic Loop en TypeScript: cómo evitar el bucle infinito

    Un viernes a las 11 de la noche dejé corriendo un script experimental con un agente para refactorizar unos modelos de datos.

    A la mañana siguiente abrí la consola de Anthropic y vi que había ejecutado más de 300 llamadas a herramientas seguidas. ¿El motivo? Intentó leer un archivo que no existía, la herramienta devolvió un error genérico, el modelo interpretó que la ruta estaba mal escrita, probó otra ruta inexistente, y así durante horas.

    Un agente de IA no es un modelo inteligente: es un Agentic Loop, un bucle while en TypeScript que tú controlas (o que te controla a ti). La factura de tokens dolió, pero la lección técnica valió cada céntimo.

    La mayoría de tutoriales te enseñan a pasarle tres herramientas a un LLM y llamar a generateText. Nadie te explica qué pasa cuando el modelo entra en pánico lógico, se niega a terminar o repite la misma llamada una y otra vez.

    Aquí está cómo funciona de verdad el Agentic Loop en producción y cómo implementarlo en TypeScript sin caer en trampas de novato.


    Qué es realmente un Agentic Loop

    La diferencia entre un chatbot clásico y un agente autónomo no es el modelo de lenguaje. Ambos pueden usar Claude Sonnet 5, Opus 5 o el GPT vigente. La diferencia es el patrón de ejecución.

    Un chatbot recibe un mensaje y devuelve texto. Fin del ciclo.

    Un agente recibe una instrucción, razona qué herramienta necesita, la ejecuta, observa el resultado y vuelve a razonar con esa nueva información hasta que considera que la tarea está terminada.

    El flujo básico sigue siempre este ciclo:

    1. Reasoning (Razonamiento): El modelo evalúa el historial y decide si responder o invocar una herramienta (Tool Call).
    2. Action (Acción): Tu servidor ejecuta la función requerida (leer un archivo, consultar una base de datos, llamar a una API).
    3. Observation (Observación): Inyectas el resultado de la función de vuelta al contexto como un mensaje de rol tool.
    4. Evaluation (Evaluación): El modelo analiza el nuevo estado. Si el objetivo está cumplido, entrega la respuesta final; si no, repite desde el paso 1.

    Si este ciclo te suena, es porque es la formalización del patrón ReAct: Thought → Action → Observation. Ahí explico el razonamiento; aquí vamos a lo que nadie cuenta: qué defensas necesita ese bucle para sobrevivir a producción.

    Parece sencillo en un diagrama. En producción, si dejas este bucle sin defensas activas, tienes una bomba de tiempo.


    Los 3 errores fatales que rompen tus agentes en producción

    1. No tener un límite de pasos rígido

    Si no defines un tope máximo de iteraciones, un fallo imprevisto en una API externa convertirá a tu agente en un generador infinito de facturación. En cualquier sistema agéntico serio, cada tarea debe tener un presupuesto máximo de pasos (usualmente entre 5 y 15 para tareas estándar).

    2. Tratar los errores de las herramientas como excepciones no controladas

    Si una tool lanza un throw new Error("File not found") y tu código revienta el proceso de Node/Bun, tu agente se cae. Pero si capturas el error y le devuelves un string vacío, el agente asumirá que el archivo está en blanco y tomará decisiones erróneas.

    Devuelve los errores de herramientas formateados como datos descriptivos para que el modelo sepa exactamente qué falló y pueda autocorregirse.

    3. Falta de detección de estancamiento (Loop Fingerprinting)

    El modelo a veces se obsesiona. Ejecuta readFile({ path: "config.json" }), falla, y en el siguiente paso vuelve a llamar exactamente a readFile({ path: "config.json" }) esperando un milagro.

    Si no comparas la huella de la llamada actual con las anteriores, tu agente se quedará atascado en un ciclo ciego. Y ojo: un límite de pasos no te salva de esto, solo te acota el gasto. El agente sigue quemando el presupuesto entero sin avanzar un milímetro.


    Implementando un Agentic Loop robusto en TypeScript

    Para evitar dependencias pesadas que oscurezcan lo que pasa por debajo, el estándar más limpio hoy es usar el Vercel AI SDK con schemas tipados mediante Zod.

    La clave está en stopWhen: acepta un array de condiciones y detiene el bucle cuando cualquiera de ellas se cumple. Eso te permite combinar el techo de gasto con tu propio detector de bucles.

    Aquí tienes una implementación defensiva lista para producción:

    import { generateText, tool, isStepCount, type StopCondition } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    
    // 1. Definición estricta de herramientas con Zod
    const tools = {
      readFile: tool({
        description: "Lee el contenido de un archivo del proyecto",
        inputSchema: z.object({
          filePath: z.string().describe("Ruta relativa del archivo a leer"),
        }),
        execute: async ({ filePath }) => {
          try {
            const content = await Bun.file(filePath).text();
            return { success: true, data: content };
          } catch (err: any) {
            // Devolvemos el error como información útil para el agente
            return {
              success: false,
              error: `No se pudo leer el archivo "${filePath}": ${err.message}`,
            };
          }
        },
      }),
    };
    
    // 2. Huella de cada tool call: nombre + argumentos exactos
    const fingerprint = (call: { toolName: string; input: unknown }) =>
      `${call.toolName}:${JSON.stringify(call.input)}`;
    
    // 3. Condición de parada propia: corta a la tercera llamada idéntica
    //    (la segunda es un reintento legítimo; la tercera ya es obsesión)
    const noRepeatedCalls: StopCondition<typeof tools> = ({ steps }) => {
      const calls = steps.flatMap((step) => step.toolCalls.map(fingerprint));
    
      return calls.some(
        (f) => calls.filter((other) => other === f).length >= 3
      );
    };
    
    // 4. Ejecutor agéntico con las dos defensas activas
    export async function runAgentTask(prompt: string, maxIterations = 10) {
      const result = await generateText({
        model: anthropic("claude-sonnet-5"),
        system: `Eres un asistente de desarrollo autónomo.
        Usa las herramientas disponibles para inspeccionar el entorno.
        Si una herramienta falla, analiza el motivo antes de reintentar.
        Cuando termines la tarea, responde con el resumen final sin invocar más tools.`,
        prompt,
        tools,
        // Para en cuanto se cumpla una: presupuesto agotado o bucle detectado
        stopWhen: [isStepCount(maxIterations), noRepeatedCalls],
        onStepFinish: ({ toolCalls }) => {
          for (const call of toolCalls) {
            console.log(`[STEP] ${fingerprint(call)}`);
          }
        },
      });
    
      return { text: result.text, steps: result.steps.length };
    }
    

    Fíjate en lo que hace este patrón:

    1. Schemas Zod estrictos: Si el LLM intenta inventarse un parámetro que no existe, la librería lo rechaza antes de tocar el sistema de archivos. Si quieres profundizar en cómo validar estructuras complejas, en nuestro curso de Zod para TypeScript vemos cómo blindar estas entradas.
    2. Resultados estructurados: Las herramientas devuelven { success: boolean, data?: string, error?: string }. El modelo sabe interpretar este formato a la primera.
    3. Dos condiciones de parada independientes: isStepCount es el techo de gasto; noRepeatedCalls es el que de verdad mata el bucle infinito, porque detecta el estancamiento aunque queden pasos de presupuesto.
    4. Trazabilidad paso a paso: onStepFinish te da el log de cada decisión del agente. No puede abortar el bucle —eso es trabajo de stopWhen—, pero es lo que te permite reconstruir después por qué se atascó.

    Un detalle que se pasa por alto: la parada devuelve el control a tu código, no lanza una excepción. Comprueba steps al recibir el resultado — si el agente terminó en el paso 10 de 10, probablemente no completó la tarea y toca escalarla, no darla por buena.

    Es el mismo cambio de mentalidad del que hablo en Loop Engineering: el valor ya no está en el prompt, está en el bucle que lo envuelve.


    La regla de oro: Antes de escribir el loop, define el Spec

    El mejor código de loop no compensa una instrucción ambigua. Si le dices a tu agente "arregla el bug del login", gastará 8 iteraciones solo descubriendo dónde está el archivo de login.

    Esta es la razón por la que en Dominicode insistimos tanto en la metodología Spec-First. Antes de soltar a un agente a modificar código, generamos una especificación técnica clara que acota el alcance exacto de la tarea. Es exactamente el flujo que enseñamos en el curso Construye con IA: de la idea al producto y en el libro de Spec-Driven Development.


    Qué puedes cambiar hoy en tu arquitectura

    Si ya tienes agentes corriendo en tus proyectos locales o en servidores de staging, haz esta revisión técnica hoy mismo:

    1. Revisa tu límite de pasos (stopWhen): Ninguna llamada agéntica debería correr sin un límite superior finito.
    2. Audita el retorno de tus tools: Asegúrate de que las excepciones devuelvan mensajes de error útiles en lugar de romper el runtime o devolver respuestas vacías.
    3. Implementa fingerprinting: Añade una condición de parada propia que compare la huella de cada tool call con las anteriores y corte a la tercera repetición exacta.
    4. Comprueba en qué paso terminó: Si el agente agota el presupuesto, trátalo como fallo y escala la tarea. Un resultado entregado en el último paso casi nunca es un resultado bueno.

    En Dominicode Labs estamos probando patrones avanzados de orquestación agéntica con subagentes independientes y guardrails de seguridad en proyectos reales.

    Construir con IA no consiste en maravillarse con lo que genera el modelo en el primer prompt, sino en diseñar la arquitectura que hace que el sistema sea predecible y seguro cuando nadie está mirando la pantalla.


    Y si alguna de esas herramientas hace algo que no se puede deshacer, el loop necesita además un punto de parada para un humano: cómo interrumpirlo, persistirlo y reanudarlo está en arquitectura human in the loop en TypeScript.

    Preguntas frecuentes

    ¿Cuántos pasos como máximo debe tener un Agentic Loop?

    Entre 5 y 15 para tareas estándar. Con menos de 5 el agente no llega a explorar el entorno; por encima de 15 el problema casi nunca es el presupuesto, sino que la instrucción era ambigua. Si necesitas 30 pasos, parte la tarea en dos.

    ¿Qué diferencia hay entre un Agentic Loop y el patrón ReAct?

    ReAct describe el razonamiento del modelo: pensar, actuar, observar. El Agentic Loop es la implementación real de ese ciclo en tu código, con sus límites, su manejo de errores y sus condiciones de parada. ReAct es el qué; el Agentic Loop es el cómo lo ejecutas sin que se te vaya la factura.

    ¿Debo lanzar una excepción cuando falla una tool?

    No. Captura el error dentro de execute y devuélvelo como dato estructurado ({ success: false, error: "..." }). Si lanzas la excepción, rompes el proceso; si devuelves vacío, el modelo asume que el resultado era vacío y decide mal. El error descriptivo es lo único que le permite autocorregirse.

    ¿No basta con poner un límite de pasos para evitar el bucle infinito?

    El límite evita que el gasto sea infinito, pero no evita el bucle. Un agente atascado consumirá los 10 pasos repitiendo la misma llamada y te devolverá un resultado inútil habiendo pagado el presupuesto completo. El límite de pasos es el airbag; el fingerprinting es el freno.

    ¿Necesito un framework de orquestación para implementar esto?

    No para un bucle de una sola tarea: el Vercel AI SDK con stopWhen te da control de pasos y parada personalizada en unas 40 líneas. Los frameworks de grafos empiezan a compensar cuando necesitas ramificaciones, estado persistente entre sesiones o varios agentes coordinados.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Construyendo Agentes Rápidos con TypeScript y Vercel AI SDK

    Construyendo Agentes Rápidos con TypeScript y Vercel AI SDK

    TypeScript + Vercel AI SDK: la combinación que uso para construir agentes rápido

    Tiempo estimado de lectura: 4 min

    • Tipado + validación: TypeScript en la superficie y Zod en runtime reducen errores silenciosos y permiten refactors seguros.
    • API unificada: Vercel AI SDK conecta proveedores y ofrece streaming y herramientas tipadas.
    • Extracción y control: generateObject y esquemas evitan ingeniería de prompt frágil y JSON truncado.
    • UX y operaciones: streamText mejora la percepción de latencia; métricas y circuit breakers mantienen robustez en producción.

    TypeScript + Vercel AI SDK: la combinación que uso para construir agentes rápido. Si vas a poner agentes en producción, necesitas que la capa que conecta al LLM con tus herramientas sea predecible, tipada y validada desde el primer día. Esa combinación reduce errores silenciosos, acelera refactors y convierte promesas estocásticas en contratos verificables.

    Resumen rápido (lectores con prisa)

    TypeScript para tipado estático, Zod para validación en runtime y Vercel AI SDK como API unificada. Juntos: herramientas tipadas, extracción estructurada (generateObject), y streaming (streamText) para agentes más seguros y previsibles.

    TypeScript + Vercel AI SDK: por qué funciona para agentes rápidos

    Tres problemas recurrentes al construir agentes:

    1. El LLM alucina parámetros para las herramientas (tool calls)

    Los modelos pueden generar parámetros inválidos o inventados para llamadas a herramientas, lo que puede llevar a ejecuciones peligrosas si no se validan antes.

    2. Las respuestas JSON vienen envueltas en markdown o truncadas

    Solemos ver JSON con backticks, texto adicional o respuestas incompletas que complican el parsing confiable.

    3. Cambios en la API del proveedor rompen integraciones silenciosamente

    Actualizar modelos o proveedores puede introducir cambios incompatibles si no hay contratos y pruebas robustas.

    La solución práctica es simple: tipos en la superficie (TypeScript), contratos ejecutables (Zod) y una API que integra ambas cosas (Vercel AI SDK). Beneficios concretos:

    • Autocompletado que evita buscar docs.
    • Tool calls que no se ejecutan si los datos no validan.
    • Extracción de objetos estructurados (generateObject) sin ingeniería de prompt frágil.
    • Streaming nativo (streamText) para UX reactiva.

    Tool calls tipados: la barrera que evita ejecuciones peligrosas

    Definir herramientas con esquemas evita que el agente ejecute acciones con parámetros inventados. Ejemplo:

    import { tool } from 'ai';
    import { z } from 'zod';
    
    const searchOrders = tool({
      description: 'Busca pedidos por ID de cliente',
      parameters: z.object({
        customerId: z.string().uuid(),
        status: z.enum(['pending','shipped','delivered']).optional(),
      }),
      execute: async ({ customerId, status }) => {
        return queryOrdersDatabase({ customerId, status });
      },
    });
    

    Si el LLM devuelve un customerId inválido, Zod lo rechazará antes de llamar a execute. Resultado: menos excepciones en la base de datos y trazabilidad clara del fallo (prompt → validación → rechazo).

    generateObject: extracción fiable de datos estructurados

    generateObject obliga al modelo a respetar un esquema y te devuelve un objeto tipado sin hacer JSON.parse() manual. Ejemplo práctico:

    import { generateObject } from 'ai';
    import { openai } from '@ai-sdk/openai';
    import { z } from 'zod';
    
    const schema = z.object({
      sentiment: z.enum(['positive','neutral','negative']),
      confidence: z.number().min(0).max(1),
      topics: z.array(z.string()).max(5)
    });
    
    const { object } = await generateObject({
      model: openai('gpt-4o'),
      schema,
      prompt: 'Analiza la reseña y devuelve sentiment, confidence y topics.'
    });
    
    // object ya está tipado según schema
    

    Esto reduce la ingeniería de prompts (“Devuelve SOLO JSON”) y aumenta la tasa de respuestas utilizables desde el primer intento.

    streamText: UX que comunica progreso y permite pasos intermedios

    Los agentes suelen ejecutar varias herramientas en cadena. streamText permite emitir texto progresivo y reflejar estados intermedios (p. ej. “consultando base de datos…”) en la UI sin arquitectura adicional:

    • Emite tokens progresivamente al frontend.
    • Reporta eventos de invocation/execute de herramientas.
    • Funciona tanto en Server (Next.js) como en cliente con hooks (useChat).

    Esto mejora la percepción de latencia y permite interacciones más naturales con agentes multi‑paso.

    Integración práctica y operaciones en producción

    Patrón recomendado

    1. Diseña esquemas Zod como fuente única de verdad.
    2. Expón el esquema (o ejemplo) en el prompt para guiar al LLM.
    3. Usa safeParse() para reintentos y autocorrección de prompts; usa parse() para endpoints que deben fallar rápido.
    4. Loguea prompt, raw response y error de Zod (flatten) para trazabilidad.

    Medidas operativas

    • Métricas: tasa de validación fallida, latencia media por herramienta, reintentos por prompt.
    • Retries limitados con backoff y contador de intentos (p. ej. 2 reintentos de autocorrección antes de degradar a humano).
    • Circuit breaker para evitar invocar herramientas costosas si la validación falla en cascada.

    Limitaciones y decisions trade‑offs

    • No eliminas la estocasticidad del LLM; la controlas. Algunos casos requerirán supervisión humana.
    • generateObject y Structured Outputs reducen errores de formato, pero no sustituyen la validación semántica (p. ej. números positivos). Zod sigue siendo necesaria.
    • Tipar desde el día 0 impone disciplina, pero acelera onboarding y refactors.

    Conclusión

    TypeScript + Vercel AI SDK: la combinación que uso para construir agentes rápido no es un truco de marketing. Es una estrategia concreta: tipos para detectar cambios, Zod para validar en runtime, y un SDK que une proveedores, streaming y herramientas tipadas. Si tu objetivo es desplegar agentes que actúen sobre sistemas reales—bases de datos, pedidos, o infraestructuras—esta pila reduce fallos silenciosos y convierte iteración rápida en ingeniería sostenible.

    Para equipos que exploran automatización y agentes como flujo de trabajo productivo, una guía práctica y recursos adicionales están disponibles en Dominicode Labs. Es una continuación lógica para quienes quieren aterrizar estas prácticas en sistemas reales.

    FAQ

    ¿Por qué combinar TypeScript con Zod y un SDK como Vercel AI SDK?

    TypeScript aporta seguridad estática y autocompletado; Zod proporciona validación en runtime; y Vercel AI SDK unifica la interacción con proveedores, streaming y herramientas tipadas. La combinación reduce errores silenciosos y facilita refactors.

    ¿Cómo evitan las herramientas tipadas ejecuciones peligrosas?

    Al definir parámetros con esquemas Zod, cualquier dato que no valide se rechaza antes de ejecutar la función execute, evitando operaciones con parámetros inventados o inválidos.

    ¿Qué ventaja ofrece generateObject frente a parsear JSON manualmente?

    generateObject obliga al modelo a respetar un esquema y devuelve un objeto ya tipado, evitando la ingeniería de prompt para forzar JSON y reduciendo errores por markdown, texto adicional o truncado.

    ¿Cuándo debo usar streamText?

    Cuando quieras mejorar la UX en interacciones multi‑paso: emitir tokens progresivamente, mostrar estados intermedios y reportar eventos de invocation/execute sin añadir complejidad arquitectónica.

    ¿Qué métricas operativas son críticas?

    Métricas como tasa de validación fallida, latencia media por herramienta y reintentos por prompt son esenciales para monitorear la salud y eficacia del agente.

    ¿Cuáles son las limitaciones principales de esta pila?

    No elimina la estocasticidad del LLM; solo la controla. También requiere validación semántica adicional (p. ej. asegurar números positivos). Tipar desde el día 0 impone disciplina, aunque acelera onboarding y refactors.