Tag: Signals

  • Cuándo usar RxJS o Signals en Angular: el criterio real

    Cuándo usar RxJS o Signals en Angular: el criterio real

    El mes pasado, en un code review, me encontré esto:

    // user.service.ts
    private readonly userSubject = new BehaviorSubject<User | null>(null);
    readonly user$ = this.userSubject.asObservable();
    
    setUser(user: User) {
      this.userSubject.next(user);
    }
    

    Nadie combinaba ese observable con nada. Nadie lo cancelaba. Solo se consumía con async en dos plantillas. Es un signal con tres pasos de más.

    Dos archivos más abajo estaba el problema espejo:

    readonly productos = signal<Product[]>([]);
    readonly cargando = signal(false);
    readonly error = signal<string | null>(null);
    private peticionEnCurso = 0; // para descartar respuestas viejas
    

    Eso ya no es estado. Es un observable reimplementado a mano, y mal.

    Le pregunté al dev qué criterio había usado. Me dio el mismo que da todo el mundo cuando le preguntas cuándo usar RxJS o Signals en Angular: "Signals para estado, RxJS para async".

    La regla es correcta. Yo también la he escrito. Y no le sirvió de nada, porque los dos fragmentos que acabas de ver la cumplen.

    Cuándo usar RxJS o Signals en Angular: la regla que no decide nada

    "Estado" y "async" no describen tu código. Describen categorías. Y tu código real vive justo en la frontera entre las dos.

    Un autocompletado con debounceTime que además guarda el producto elegido: ¿eso es estado o es async? Las dos cosas. Un WebSocket de precios que solo se pinta en pantalla: es async por definición, y sin embargo la UI solo quiere el último valor. Una cancelación de peticiones que ayer era switchMap y hoy podría ser un resource.

    En todos esos casos la regla te deja exactamente donde estabas: eligiendo por costumbre.

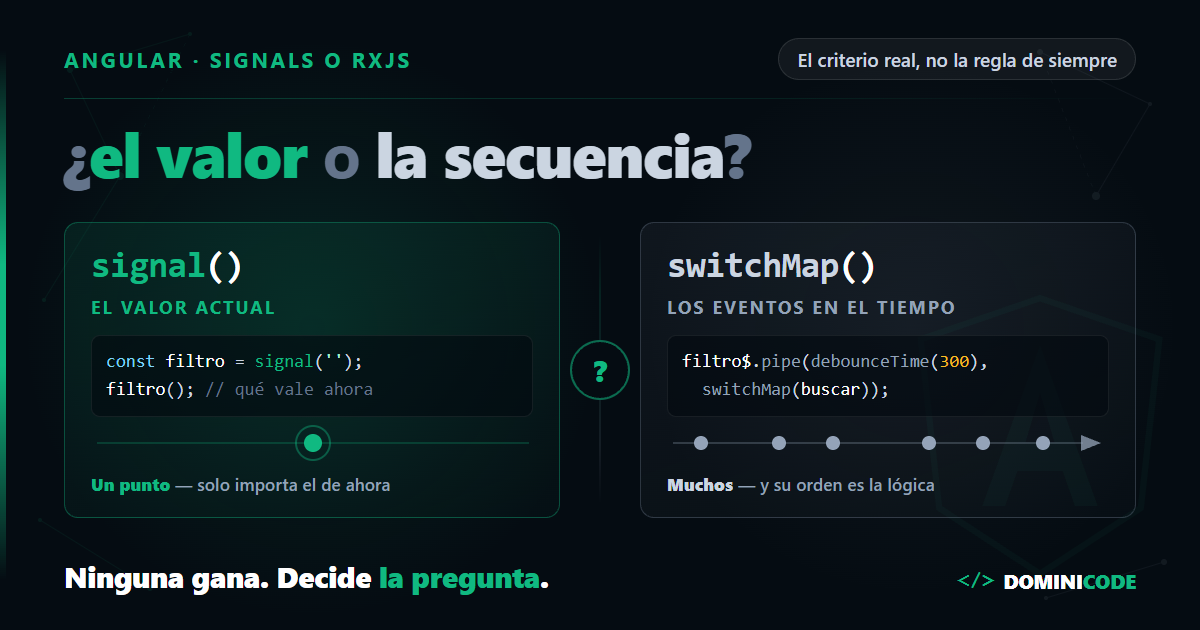
    El criterio que sí decide: ¿necesitas el valor o la secuencia?

    Signals te dan el valor actual. Qué vale esto ahora, en este instante, cuando alguien lo lee.

    RxJS te da los eventos en el tiempo. Qué pasó, en qué orden, cuántas veces, y qué hacer si llega otro antes de que termine el anterior.

    Esa es toda la decisión:

    • Si el cuándo y el en qué orden forman parte de tu lógica, es RxJS.
    • Si solo importa qué vale ahora, es un signal.

    Aplícalo a los dos fragmentos del principio y se resuelven solos. El BehaviorSubject del usuario nunca pregunta cuántas veces cambió ni en qué orden: quiere el valor actual. Es un signal. Y el signal() rodeado de cargando, error y peticionEnCurso está preguntando exactamente eso —cuál llegó primero, cuál descarto— con las manos. Es un flujo.

    La pista más fiable es esta: en cuanto necesitas una variable auxiliar para saber qué pasó antes, has salido del territorio de los signals.

    Tabla de decisión: RxJS o Signals, caso por caso

    Necesitas… Elige Por qué
    El valor actual para pintarlo signal Solo importa qué vale ahora
    Derivar un valor de otros computed Sin suscripciones ni sincronización manual
    Que el orden de llegada cambie el resultado RxJS El tiempo es parte de la lógica
    Esperar a que el usuario deje de escribir RxJS (debounceTime) Los signals no tienen noción de tiempo
    Reaccionar a cada evento, uno a uno RxJS El grafo de signals colapsa valores intermedios
    Descartar la respuesta anterior al llegar otra switchMap o un resource Cancelación a mano o incluida
    Guardar lo que el usuario eligió signal Es estado, no un evento
    Un push del servidor que solo se pinta toSignal() del stream La secuencia se procesa fuera; el valor entra al grafo

    Esta tabla decide. No ejecuta. Cuando ya sepas qué mover, el cómo —los patrones de refactorización, uno a uno— está en la guía de migración de RxJS a Signals.

    Frontera 1: el autocompletado que además guarda la selección

    El caso que rompe la regla. Hay tiempo (debounce, cancelación) y hay estado (el término, la selección).

    No elijas. Parte el componente por la mitad:

    readonly term = signal('');                        // valor
    readonly selected = signal<Product | null>(null);  // valor
    
    private readonly results$ = toObservable(this.term).pipe( // secuencia
      debounceTime(300),
      distinctUntilChanged(),
      switchMap((t) => this.http.get<Product[]>(`/api/products?q=${encodeURIComponent(t)}`)),
    );
    
    readonly results = toSignal(this.results$, { initialValue: [] }); // vuelve a valor
    
    choose(p: Product) {
      this.selected.set(p);
      this.term.set(p.name);
    }
    

    Estado a los lados, secuencia en el medio. El pipeline no guarda nada y los signals no saben nada del tiempo.

    Este reparto —qué vive en el grafo y qué vive en el pipeline— es la base de la arquitectura de señales que trabajo a fondo en el curso de Angular Moderno. Y cómo se ordena a escala de aplicación entera —servicios, stores, componentes— lo desarrollé en la arquitectura moderna de Angular con Signals.

    Frontera 2: el WebSocket que alimenta la UI

    Aquí todo el mundo asume RxJS y se queda ahí. La mitad de la respuesta es correcta.

    La conexión y el filtrado son secuencia pura: RxJS. Pero lo que la plantilla consume es un valor.

    private readonly ticks$ = webSocket<Tick>('wss://api.example.com/ticks').pipe(
      filter((t) => t.symbol === 'BTC'),
    );
    
    readonly lastTick = toSignal(this.ticks$, { initialValue: null });
    

    toSignal() se desuscribe solo cuando se destruye el componente o el servicio que lo crea, salvo que le pases manualCleanup. No hay takeUntil, ni async repetido en la plantilla, ni ngOnDestroy.

    Y si tu lógica necesita cada tick —contarlos, agruparlos por ventana, acumularlos— eso se queda en el pipeline. No lo subas al signal.

    Frontera 3: cancelar peticiones, switchMap o un resource

    Este es el que más ha cambiado.

    switchMap cancela la petición anterior cuando llega un valor nuevo. Sigue siendo la respuesta correcta si en el mismo flujo hay debounce, reintentos con backoff o una combinación de varias fuentes.

    Pero si lo único que haces es "cuando cambia este parámetro, vuelve a pedir y descarta lo anterior", ya no necesitas escribir el flujo. httpResource es un envoltorio sobre HttpClient que te da el estado de la petición y la respuesta como señales, pasando por los interceptors. Y rxResource acepta una propiedad stream con una función que devuelve un Observable, para cuando la fuente ya la tienes en RxJS:

    readonly detail = rxResource({
      params: () => this.selectedId(),
      stream: ({ params }) => this.http.get<Product>(`/api/products/${params}`),
    });
    

    Un detalle de la documentación que cuesta caro descubrir en producción: ese Observable debe emitir un valor o un error antes de completar. Si le encadenas un catchError(() => EMPTY) —o un filter que a veces no deja pasar nada— y el Observable completa sin emitir, Angular lanza NG0991, Resource completed before producing a value. No se queda esperando: revienta.

    Frontera 4: dónde va el efecto secundario, effect() o tap()

    La diferencia no es de estilo. Es de garantías.

    tap() se ejecuta una vez por evento, en un punto conocido del orden, y ve el evento.

    effect() se ejecuta cuando el valor acaba siendo algo. No te garantiza que veas todos los intermedios: el grafo de señales agrupa actualizaciones y ejecuta el efecto sobre el resultado ya estabilizado. Si alguna vez te has preguntado por qué un computed no se recalcula cuando esperabas, la explicación está en cómo funciona el grafo reactivo de Angular por dentro.

    La regla práctica:

    • Analítica de "el usuario pulsó el botón" → tap(). Cada pulsación cuenta.
    • "Cuando el carrito quede vacío, oculta el panel" → effect(). Da igual cómo llegó a estar vacío.

    Y si el efecto es calcular otro valor, no es un efecto. Es un computed. Escribir signals dentro de un effect es la forma más rápida de construir un grafo que nadie entiende y que ningún test cubre.

    La frontera exacta de toSignal()

    toSignal() es el punto donde una secuencia se convierte en valor. Vive en @angular/core/rxjs-interop y necesita un contexto de inyección, o que le pases un Injector.

    Tres cosas que la documentación dice y casi nadie lee.

    Se suscribe inmediatamente. La doc lo avisa: "Like the async pipe, toSignal subscribes to the Observable immediately, which may trigger side effects". Si tu observable dispara una petición al suscribirse, esa petición sale ya.

    No lo llames dos veces. "You should avoid calling it repeatedly for the same Observable, and instead reuse the signal it returns". Cada llamada es una suscripción nueva. Dos toSignal() sobre el mismo stream son dos conexiones.

    Los errores se lanzan al leer. No al emitir: al leer el signal. Y si el observable completa, el signal se queda con el último valor emitido, no se vacía.

    Traducido: toSignal() es una frontera de salida, y se cruza una sola vez, lo más cerca posible de la plantilla.

    Cuándo toObservable() te avisa de que vas al revés

    toObservable() es legítimo, y lo has visto arriba: tienes un signal de input y necesitas operadores de tiempo. Estado que se convierte en secuencia.

    El problema es el otro uso, el de volver a RxJS por inercia. Y tiene una trampa medible.

    toObservable() está implementado con un effect y un ReplaySubject. Eso significa que agrupa varias actualizaciones del signal en una sola emisión. Si actualizas el signal tres veces seguidas, no vas a recibir tres valores.

    Así que si tu pipeline necesita ver cada cambio, toObservable() no te lo va a dar. Y si no necesita verlos, probablemente no necesitabas el pipeline.

    Dos señales de que has girado en dirección equivocada: usarlo para combinar dos signals —eso es un computed— o usarlo para ejecutar algo cuando cambia un valor, que es un effect.

    toSignal() debería aparecer varias veces en tu código. toObservable(), muy pocas, y cada una con un operador de tiempo detrás que lo justifique.

    Qué hacer hoy en tu proyecto Angular

    Abre tu proyecto y busca signals con una variable auxiliar al lado: un flag cargando, un contador de peticiones, un ultimoId. Cada una de esas variables es la secuencia que el signal no sabe representar. Ahí tienes un flujo pidiendo volver a RxJS.

    Luego busca lo contrario, que cuesta menos: cada BehaviorSubject del que solo se lee el último valor. Si nadie depende del orden en que llegaron —y en un .asObservable() consumido con async casi nunca se depende—, tienes un signal esperando a salir.

    Los dos del principio de este post salen así: el BehaviorSubject del usuario son tres líneas —subject privado, observable público y setter— que se quedan en una, signal<User | null>(null). Y los cuatro campos del segundo caso —productos, cargando, error y peticionEnCurso— se quedan en un resource. Puedes contarlos tú en los snippets de arriba.

    Diez minutos. Y decides con el criterio, no con la moda.

    Y si quieres discutir estas decisiones sobre proyectos reales, y no sobre listas de tareas, es justo lo que hacemos en Dominicode Labs.

    Preguntas frecuentes

    ¿Cuándo usar RxJS o Signals en Angular?

    Pregúntate si necesitas el valor o la secuencia. Los signals te dan el valor actual: qué vale algo ahora mismo. RxJS te da los eventos en el tiempo: qué pasó, en qué orden y qué hacer si llega otro antes de terminar el anterior. Si el cuándo y el orden forman parte de tu lógica, es RxJS. Si solo importa el valor actual, es un signal. La pista más fiable es que necesites una variable auxiliar para recordar qué pasó antes: ahí ya has salido del territorio de los signals.

    ¿Sigue teniendo sentido RxJS ahora que existen los signals?

    Sí, y no por compatibilidad hacia atrás. Los signals no tienen ninguna noción de tiempo: no saben esperar, ni descartar, ni contar emisiones, ni reintentar con backoff. Nada de eso lo cubre el grafo reactivo. Mientras tu lógica dependa de la secuencia —debounce, WebSockets, coordinación de varias fuentes asíncronas, cancelación combinada con otros operadores— RxJS es la herramienta correcta y no hay sustituto.

    ¿Debo reemplazar todos mis BehaviorSubject por signals?

    Todos no. Reemplaza los que solo mantienen el último valor y se consumen con la pipe async o con un subscribe que hace un set. Esos son signals con pasos de más. Deja los que participan en un flujo real: los que se combinan con otros streams, los que alimentan un pipeline con operadores de tiempo o los que representan eventos en los que el orden importa. El criterio no es el tipo, es qué haces con él.

    ¿Cuál es la diferencia entre effect() y tap() para efectos secundarios?

    tap() se ejecuta una vez por evento, en un punto conocido del flujo, y recibe el evento. effect() se ejecuta cuando el valor acaba estabilizándose, y no garantiza que veas los estados intermedios porque el grafo agrupa actualizaciones. Para "el usuario pulsó tres veces" necesitas tap(). Para "cuando esto quede vacío, oculta el panel" necesitas effect(). Y si lo que quieres es calcular otro valor, el effect sobra: eso lo resuelve un computed.

    ¿Es mala señal usar toObservable() en mi código?

    Depende de en qué dirección vayas. Si conviertes un signal de estado en secuencia para aplicarle operadores de tiempo, es exactamente para lo que existe. Si lo usas para combinar dos signals o para reaccionar a un cambio, te estás alejando: eso son computed y effect. Además tiene una consecuencia práctica que conviene conocer: agrupa varias actualizaciones del signal en una sola emisión, así que no verás todos los valores intermedios.


    Comportamiento verificado contra la documentación de Angular 22 en septiembre de 2026.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • httpResource vs TanStack Query: cuál usar en Angular 22

    httpResource vs TanStack Query: cuál usar en Angular 22

    Un dev me escribió hace tres semanas con una captura de su package.json. Proyecto Angular 22 recién creado, dos días de vida, y ya tenía @tanstack/angular-query-experimental dentro.

    Le pregunté por qué. Respuesta: "en React siempre lo uso".

    Ese es el 80% de las discusiones de httpResource vs TanStack Query que veo por ahí: no son decisiones, son inercias. El resto viene del extremo contrario. Alguien leyó en un hilo que "httpResource no cachea", cerró la pestaña y descartó la API estándar de Angular sin llegar a preguntarse qué caché necesitaba de verdad su aplicación.

    Las dos posturas fallan por el mismo motivo: comparan dos cosas que no juegan en la misma liga.

    Este post no es un tutorial. Si buscas el cómo, ya publiqué la guía de la Resource API en Angular 22 y la de httpResource con señales. Aquí vamos a lo otro: qué eliges, por qué, y qué te va a costar.

    httpResource vs TanStack Query: la respuesta corta

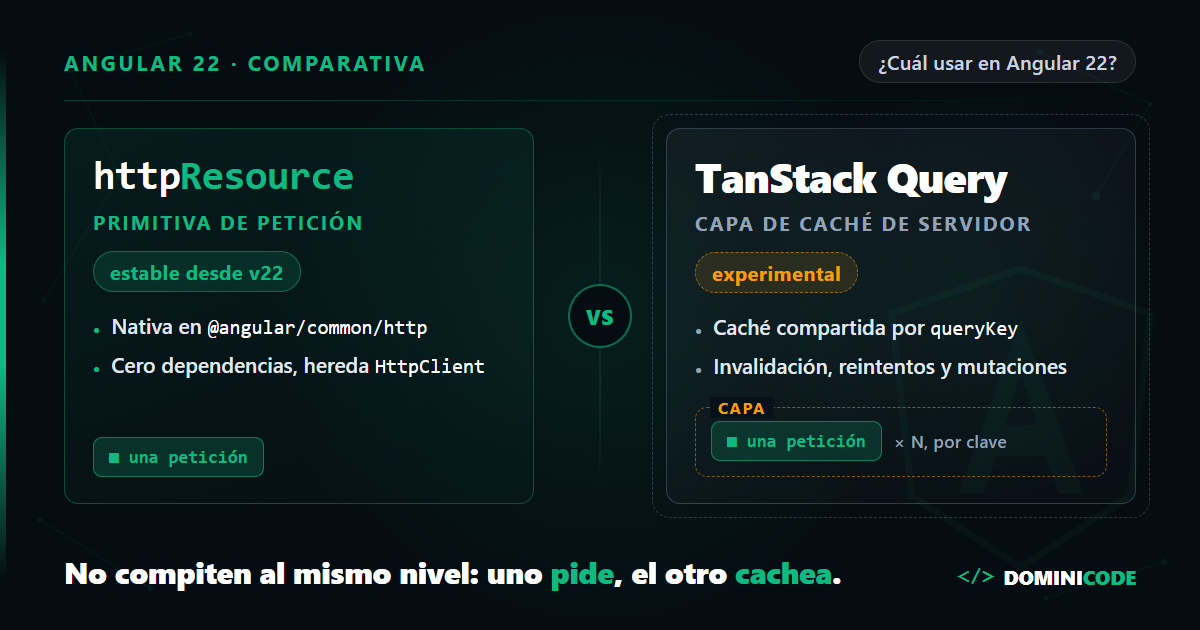
    Usa httpResource por defecto en Angular 22. Es la API estándar, es estable desde la v22.0, no añade dependencias y hereda todo el ecosistema de HttpClient. Cambia a TanStack Query solo cuando necesites una caché de servidor compartida entre componentes con invalidación por clave, mutaciones optimistas o scroll infinito, y estés dispuesto a asumir que su adaptador de Angular se llama literalmente @tanstack/angular-query-experimental.

    Esa es la decisión. El resto del post explica por qué, con la letra pequeña que casi nadie te cuenta.

    La diferencia real: petición reactiva vs caché de estado de servidor

    httpResource es una primitiva de petición reactiva. Le das una función que construye una URL a partir de señales, y la petición se vuelve a lanzar sola cuando esas señales cambian. Vive dentro del grafo reactivo de Angular como un nodo más. Su unidad de trabajo es una petición atada a un estado.

    TanStack Query es otra cosa. Es una capa de caché de estado de servidor. Su unidad de trabajo no es la petición: es la clave. Cuando escribes queryKey: ['products', filtro], estás diciendo "estos datos existen en la aplicación bajo este identificador". A partir de ahí llegan la deduplicación de peticiones en vuelo, la invalidación cruzada, el stale-while-revalidate y las mutaciones optimistas. Todo eso son consecuencias de tener una clave y un almacén global, no de saber hacer un GET.

    Por eso la pregunta "¿cuál es mejor?" lleva casi siempre a la respuesta equivocada. Es como comparar fetch con Redis. Uno trae datos; el otro decide quién los tiene, cuándo caducan y a quién hay que avisar.

    La pregunta correcta es esta: ¿tu aplicación tiene un problema de caché de servidor, o solo tiene peticiones que dependen de un estado?

    Cinco pantallas CRUD con filtros y un detalle no tienen problema de caché. Un dashboard donde ocho componentes distintos leen el mismo listado, donde una mutación en un modal tiene que refrescar tres widgets y donde el usuario espera ver el cambio antes de que responda el servidor, sí lo tiene.

    El mismo caso resuelto con httpResource

    Lista de productos con filtro reactivo. Esta es la versión con la API estándar.

    import { Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    
    type Product = { id: string; name: string; price: number };
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isLoading()) {
          <p>Cargando…</p>
        } @else if (products.error()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.value(); track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      readonly query = signal('');
    
      readonly products = httpResource<Product[]>(
        () => `/api/products?q=${encodeURIComponent(this.query())}`,
        { defaultValue: [] },
      );
    }
    

    Cero dependencias. Cero providers. El HttpResourceRef te expone value, status, error, headers, statusCode, progress e isLoading como señales, más los métodos hasValue() y reload().

    Hay un detalle que se pasa por alto: la documentación oficial aclara que si hay una petición pendiente cuando cambia la dependencia, el resource cancela la anterior antes de lanzar la nueva. El caso del input que escribe rápido está resuelto de fábrica.

    Si quieres validar la respuesta, tienes la opción parse con Zod o Valibot. Y como usa HttpClient por debajo, tus interceptors de auth, de reintentos y de logging siguen aplicando sin tocar nada. Este patrón, con la arquitectura de señales completa alrededor, es lo que trabajo a fondo en el curso de Angular Moderno.

    El mismo caso resuelto con TanStack Query

    Mismo componente, otra filosofía. Primero el provider en el arranque.

    import { provideHttpClient } from '@angular/common/http';
    import { provideTanStackQuery, QueryClient } from '@tanstack/angular-query-experimental';
    
    bootstrapApplication(AppComponent, {
      providers: [provideHttpClient(), provideTanStackQuery(new QueryClient())],
    });
    

    Y el componente:

    import { Component, inject, signal } from '@angular/core';
    import { HttpClient } from '@angular/common/http';
    import { lastValueFrom } from 'rxjs';
    import {
      injectQuery,
      injectMutation,
      QueryClient,
    } from '@tanstack/angular-query-experimental';
    
    type Product = { id: string; name: string; price: number };
    type NewProduct = Omit<Product, 'id'>;
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isPending()) {
          <p>Cargando…</p>
        } @else if (products.isError()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.data() ?? []; track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      private readonly http = inject(HttpClient);
      private readonly queryClient = inject(QueryClient);
    
      readonly query = signal('');
    
      readonly products = injectQuery(() => ({
        queryKey: ['products', this.query()],
        queryFn: () =>
          lastValueFrom(
            this.http.get<Product[]>(`/api/products?q=${encodeURIComponent(this.query())}`),
          ),
      }));
    
      readonly createProduct = injectMutation(() => ({
        mutationFn: (product: NewProduct) =>
          lastValueFrom(this.http.post<Product>('/api/products', product)),
        onSuccess: () => {
          this.queryClient.invalidateQueries({ queryKey: ['products'] });
        },
      }));
    }
    

    Fíjate en lo que aparece y en lo que desaparece.

    Aparece el queryKey: ese array es la identidad de los datos en toda la aplicación. Si otros seis componentes montan la misma clave, hay una sola petición y una sola copia en memoria. Y aparece invalidateQueries, la pieza que httpResource no tiene: un componente puede invalidar datos que él nunca pidió.

    Desaparece la simplicidad. Tienes un provider global, un queryFn que devuelve promesas (de ahí el lastValueFrom para puentear el observable de HttpClient) y un vocabulario nuevo que todo el equipo tiene que aprender.

    Tabla comparativa: httpResource vs TanStack Query en Angular 22

    Solo celdas verificadas contra la documentación y los tipos publicados de ambos proyectos, a septiembre de 2026: Angular 22.1.4 y @tanstack/angular-query-experimental 5.102.8.

    Criterio httpResource (Angular 22) TanStack Query (adaptador Angular)
    Estabilidad Estable desde v22.0 Experimental: breaking changes en releases minor y patch
    Dependencias Ninguna, viene en @angular/common/http @tanstack/angular-query-experimental, que arrastra @tanstack/query-core
    Caché compartida entre componentes No Sí, por queryKey
    Deduplicación de peticiones en vuelo No entre instancias; cancela su propia petición anterior Sí, por clave
    Invalidación por clave No queryClient.invalidateQueries({ queryKey })
    Stale-while-revalidate Conserva el valor anterior mientras recarga, pero no hay política de caducidad ni refetch en segundo plano Sí, con staleTime y refetch en segundo plano
    Reintentos automáticos No incluidos (las opciones son parse, defaultValue, injector, equal y debugName) Sí, tres reintentos por defecto con backoff exponencial
    Mutaciones y updates optimistas Fuera de alcance por diseño injectMutation con invalidación en onSuccess
    Paginación infinita A mano injectInfiniteQuery
    Devtools de datos Sin panel de caché propio; los nodos aparecen en el signal graph de Angular DevTools vía debugName withDevtools() desde el subpath /devtools
    Interceptors de HttpClient Siempre, usa HttpClient por debajo Solo si el queryFn usa HttpClient
    Testing HttpTestingController estándar provideTanStackQuery en TestBed, QueryClient nuevo por spec, retry: false, y requiere Angular ≥ 19
    SSR / hydration Entra en el transfer cache de provideClientHydration Sin guía de SSR propia para Angular; expone injectIsRestoring
    Versión mínima de Angular 22 para la versión estable 16 (19 para la integración de testing)

    Dónde httpResource se queda corto de verdad

    No voy a defender la API estándar más allá de lo que aguanta. Hay cuatro escenarios en los que httpResource te deja escribiendo infraestructura a mano.

    Caché compartida entre componentes. Si el header, la sidebar y la tabla montan tres httpResource contra /api/user, son tres peticiones. No hay almacén común. Puedes subir el resource a un servicio con providedIn: 'root' y compartirlo, claro, pero eso ya es tu caché artesanal, con tus reglas de caducidad escritas por ti y mantenidas por ti.

    Invalidación cruzada tras una mutación. Guardas un producto en un modal y necesitas refrescar el listado, el contador del carrito y el widget de novedades. Con httpResource toca llamar a reload() en cada uno, lo que obliga al modal a conocer a esos tres. Es acoplamiento, y escala mal.

    Paginación infinita. Acumular páginas, saber si hay siguiente, mantener el scroll. injectInfiniteQuery te lo da resuelto. A mano son varias tardes y unos cuantos bugs sutiles.

    Actualizaciones optimistas con rollback. Pintar el cambio antes de que responda el servidor y deshacerlo limpio si falla es un problema de gestión de estado, no de HTTP.

    Y añado una limitación que no es un defecto sino una decisión de diseño: la documentación de Angular es explícita en que hay que evitar httpResource para mutaciones tipo POST o PUT, y usar directamente HttpClient. httpResource lee; no escribe.

    Dónde TanStack Query te sale caro

    Empecemos por lo que está escrito en su propia web, palabra por palabra:

    "This library is currently in an experimental stage. This means that breaking changes will happen in minor AND patch releases."

    Léelo otra vez, porque no es la típica etiqueta beta de adorno. Es el equipo de TanStack diciéndote que un patch puede romperte la capa de datos. Y no es un aviso antiguo: sigue ahí, en la documentación del adaptador de Angular, con el paquete en la versión 5.102.8. El "experimental" está en el nombre del paquete que vas a escribir en tu package.json.

    En una prueba de concepto da igual. En una aplicación de empresa que va a vivir cinco años y que mantendrá otro equipo, eso significa fijar la versión, leerte cada changelog y aceptar que una parte crítica de tu arquitectura evoluciona a un ritmo que tú no controlas.

    El segundo coste es más sutil: te sales del ecosistema de HttpClient. Los interceptors de Angular solo se aplican si tu queryFn usa HttpClient. En cuanto alguien del equipo escribe un queryFn con fetch porque le resulta más cómodo, esa petición se salta el interceptor de auth, el de reintentos y el de trazas. Y no falla en desarrollo: falla el día que caduca un token en producción.

    Ese mismo salto te afecta al testing. httpResource se testea con HttpTestingController, igual que cualquier otra llamada de tu aplicación. Con TanStack Query montas provideTanStackQuery en el TestBed, creas un QueryClient limpio en cada spec, desactivas los reintentos para que los fallos no tarden tres backoffs y esperas a whenStable(). Se puede, está documentado, pero es una capa más que mantener. Si quieres el enfoque completo de testing en Angular moderno, lo tienes en el curso de Testing en Angular con Jest y Testing Library.

    Y el tercer coste es el SSR. httpResource usa HttpClient, así que se beneficia del transfer cache de la hidratación sin que hagas nada. El adaptador de Angular de TanStack Query no publica hoy una guía de SSR equivalente a la de React.

    Veredicto: el árbol de decisión

    Me mojo.

    Por defecto, httpResource. En un proyecto Angular 22 nuevo, empieza con la API estándar. Es estable, no amplía tu superficie de dependencias, integra con interceptors, testing y SSR, y cubre el 80% de los casos reales: listados, detalles, filtros, buscadores. Si hoy dudas, esta es tu respuesta.

    TanStack Query cuando se cumplen las tres condiciones a la vez:

    1. Varios componentes independientes consumen los mismos datos de servidor y quieres una única fuente en memoria.
    2. Necesitas invalidación cruzada tras mutaciones, scroll infinito o updates optimistas, y ya has calculado lo que cuesta escribir todo eso a mano.
    3. Aceptas el riesgo de breaking changes en versiones patch y vas a fijar la versión exacta.

    Si falla una sola de las tres, no lo metas.

    Y la opción que casi nadie considera: los dos. No son excluyentes. Puedes servir el grueso de tus pantallas con httpResource y reservar TanStack Query para el módulo de dashboard donde de verdad existe un problema de caché compartida. Aísla la decisión en una zona del código en lugar de casarte con ella en toda la aplicación.

    Lo que no vale es lo que hacía el dev del package.json: instalarlo el primer día porque en React lo usabas. Angular 22 no es React. El grafo de señales que llegó con la v22 ya te da reactividad de primera clase, y esa es justo la pieza que TanStack Query tuvo que inventar en el mundo de los hooks.

    Qué hacer hoy

    Abre tu proyecto y cuenta cuántos componentes distintos piden el mismo endpoint. Solo eso.

    Si el número es cero o uno, no tienes un problema de caché de servidor: tienes peticiones reactivas, y httpResource te sobra para resolverlas. Si el número es tres o más, y además hay mutaciones que deben refrescar varias vistas a la vez, ahí sí te has ganado el derecho a meter una dependencia externa en la capa de datos.

    Ese conteo tarda diez minutos y vale más que cualquier hilo de discusión en X.

    En Dominicode Labs trabajamos este tipo de decisiones de arquitectura sobre proyectos reales, no sobre ejemplos de listas de tareas. Y si prefieres verlo en vídeo, en el canal de YouTube publico cada semana contenido de Angular moderno e IA aplicada al desarrollo.

    Preguntas frecuentes

    ¿Qué es mejor en Angular 22, httpResource o TanStack Query?

    httpResource es la mejor opción por defecto en Angular 22: es la API estándar, es estable desde la versión 22.0, no añade dependencias y hereda los interceptors, el testing y el transfer cache de HttpClient. TanStack Query solo compensa cuando varios componentes independientes consumen los mismos datos y necesitas invalidación por clave, mutaciones optimistas o scroll infinito. No resuelven el mismo problema: httpResource es una primitiva de petición reactiva y TanStack Query es una capa de caché de estado de servidor.

    ¿httpResource cachea las peticiones?

    No, y ese malentendido origina la mitad de las discusiones sobre el tema. httpResource no mantiene un almacén de datos por clave: lanza la petición cuando cambian las señales de las que depende y expone el resultado como señal. Si necesitas que varios componentes compartan la misma copia en memoria, tienes que construir esa caché tú, por ejemplo elevando el resource a un servicio raíz, o usar una librería que ya la traiga resuelta.

    ¿Puedo usar httpResource y TanStack Query en la misma aplicación?

    Sí, y en muchos proyectos es la decisión más sensata. Nada impide resolver el grueso de las pantallas con la API estándar de Angular y reservar TanStack Query para el módulo concreto que tiene un problema real de caché compartida e invalidación cruzada. Así limitas la superficie de la dependencia externa a una zona del código, en lugar de extenderla por toda la base.

    ¿Es seguro usar el adaptador de Angular de TanStack Query en producción?

    Sí, siempre que fijes la versión exacta, revises el changelog antes de cada actualización y tengas tests que cubran la capa de datos. El riesgo está declarado en su propia documentación: habrá cambios que rompan en versiones minor y también en versiones patch. Si el proyecto lo va a mantener otro equipo dentro de dos años, piénsalo dos veces.

    ¿Los interceptors de HttpClient funcionan con TanStack Query?

    Solo si la función de la query usa HttpClient por debajo. Si alguien la escribe con fetch o con axios porque le resulta más cómodo, esa petición se salta los interceptors de autenticación, reintentos y trazas de Angular, y el problema aparecerá en producción y no en desarrollo. Si adoptas la librería, conviene dejar por escrito en el equipo que toda petición pasa por HttpClient.

    ¿Sirve httpResource para POST y PUT?

    No, y no es una limitación sino una decisión de diseño. La documentación de Angular recomienda de forma explícita evitar httpResource para mutaciones y usar directamente las APIs de HttpClient. httpResource está pensado para leer datos de forma reactiva; escribir es otro problema, con otro ciclo de vida y otros requisitos de control de errores.

    ¿Qué versión de Angular necesito para cada opción?

    httpResource es estable desde Angular 22.0 y vive en el paquete de HTTP común, así que no tienes que instalar nada. El adaptador de TanStack Query declara compatibilidad desde Angular 16 en adelante, aunque su propia guía de testing avisa de que esa integración requiere Angular 19 o superior, porque las versiones anteriores no soportan PendingTasks.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • OpenRouter: Qué es, para qué sirve y por qué lo necesitas

    OpenRouter: Qué es, para qué sirve y por qué lo necesitas

    Si estás construyendo una aplicación o un agente autónomo de IA, tu archivo de configuración de claves de API probablemente se parezca a una pesadilla. Tienes un token de facturación para OpenAI, otro para Anthropic, otro para los modelos de Google, y quizás una cuenta en un hosting de GPUs externas para los modelos de código abierto.

    Facturas fragmentadas, SDKs de código distintos y un dolor de cabeza constante cada vez que un proveedor sube los precios o sufre una caída de servicio.

    Hay una forma mucho más inteligente de gestionar esto.

    Hoy te quiero explicar qué es openrouter y para qué sirve, y por qué se ha convertido en la herramienta de backend indispensable para cualquier desarrollador de inteligencia artificial moderna.


    ¿Qué es OpenRouter?

    OpenRouter (disponible en openrouter.ai) es un enrutador y pasarela de API unificada para modelos de lenguaje. Actúa como un intermediario o agregador: tú te conectas a OpenRouter con una única clave de API y, a cambio, ellos te dan acceso a cientos de modelos distintos de múltiples proveedores de forma instantánea.

    En lugar de registrarte en Anthropic, OpenAI, Google Cloud, Meta y DeepSeek por separado, solo te registras en OpenRouter, cargas saldo en una sola cuenta y consumes los modelos que necesites pagando estrictamente por el uso de tokens.


    ¿Para qué sirve OpenRouter en el día a día?

    Si eres desarrollador de software o integras IA en tus flujos de negocio, OpenRouter resuelve cuatro problemas de infraestructura masivos:

    1. Unificación de SDKs (API compatible con OpenAI)

    No necesitas aprender a usar la librería de Anthropic o los formatos específicos de Google. OpenRouter utiliza el formato estándar de la API de OpenAI. Para cambiar de modelo, solo tienes que cambiar una string de texto en tu llamada, sin tocar una sola línea de código. Como vimos en nuestro análisis de Qwen 3.7 y OpenRouter, esto te permite cambiar de modelo en caliente para aprovechar el contexto extendido y las capacidades de razonamiento.

    2. Acceso a Modelos Propietarios y Open-Source

    En la misma plataforma conviven los gigantes de pago (como GPT-4o o Gemini 1.5 Pro) junto con las versiones de código abierto servidas a alta velocidad (como Qwen 2.5 Coder o DeepSeek-R1). Esto te permite experimentar con docenas de variantes en segundos.

    3. Redundancia y Fallbacks

    Si la API oficial de Anthropic se cae o sufre congestión, puedes configurar tu código para que OpenRouter derive la petición automáticamente a un modelo equivalente (como GPT-4o) de forma transparente para el usuario final, garantizando que tu aplicación nunca deje de responder.

    4. Control de Costes y Estadísticas

    La plataforma ofrece un panel visual increíblemente detallado que te muestra qué modelos están consumiendo más recursos, cuántos tokens envías en la fase de contexto y la latencia promedio de cada proveedor.


    Cómo implementarlo en tus Agentes Autónomos

    Integrar OpenRouter en frameworks agénticos como Hermes es sumamente sencillo. Al ser compatible con la especificación de OpenAI, basta con apuntar el base_url del cliente al endpoint unificado:

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: "https://openrouter.ai/api/v1",
      apiKey: "tu_token_de_openrouter_aqui",
    });
    
    async function main() {
      const completion = await client.chat.completions.create({
        model: "anthropic/claude-3.5-sonnet", // Cambia a "qwen/qwen-2.5-coder-32b" cuando quieras
        messages: [
          { role: "user", content: "Escribe una función de ordenamiento en TypeScript." }
        ],
      });
    
      console.log(completion.choices[0].message.content);
    }
    main();
    

    Este enfoque híbrido y unificado es la infraestructura de base que montamos en el curso de Construye con IA para desarrollar productos escalables, y el que explotamos en producción para conectar canales de comunicación automatizados en el nuevo curso de Hermes Agent.


    Conclusión: La API definitiva para Developers

    No pierdas el tiempo gestionando contratos de facturación individuales ni peleando con diferentes SDKs. Al adoptar OpenRouter en tus desarrollos de inteligencia artificial, simplificas tu código a una única conexión, blindas tu aplicación contra caídas de proveedores y tienes la libertad de elegir el modelo idóneo para cada tarea con un solo cambio de configuración.

    Si estás utilizando OpenRouter en producción y quieres optimizar el consumo de tus tokens en tareas agénticas complejas, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿OpenRouter cobra alguna comisión por encima del precio del modelo?

    No. OpenRouter ofrece los modelos a los precios de coste oficiales de los proveedores (e incluso más baratos en algunos modelos de código abierto debido a acuerdos de volumen con servidores de hosting de inferencia como Together o Fireworks). Su modelo de negocio se basa en la agregación y volumen de tráfico.

    ¿Qué sucede con la privacidad de mis datos al usar OpenRouter?

    OpenRouter actúa como un proxy de transporte. Tus prompts viajan encriptados a través de su API hacia el proveedor del modelo seleccionado. La plataforma no almacena las conversaciones de tus usuarios a menos que actives explícitamente los logs en tu panel de configuración para depuración de errores.

    ¿Se pueden usar herramientas (Tool Calling) a través de OpenRouter?

    Sí. OpenRouter soporta el paso de herramientas (tools) y la llamada de funciones nativas para todos los modelos que lo admitan de forma nativa en su arquitectura (como las familias de Claude, GPT, Llama y Qwen).

    ¿Es seguro usar OpenRouter para aplicaciones de producción masivas?

    Sí, es una infraestructura robusta utilizada por miles de aplicaciones y startups en producción a nivel global. Al contar con endpoints optimizados y soporte para conmutación por error (fallbacks), suele ofrecer una estabilidad incluso superior a la de conectarse directamente a un único proveedor.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • De callbacks a Signals: la reactividad real del frontend

    De callbacks a Signals: la reactividad real del frontend

    Un excliente me escribió hace años, angustiado. Su carrito de compras mostraba 3 artículos en el header, pero el checkout decía que había 5. Los clientes se quejaban en soporte y algunos abandonaban la compra.

    Revisé el código. Puro estilo jQuery: DOM manipulado a mano, evento por evento. Un event listener actualizaba el contador del header. Otro, completamente separado, actualizaba el resumen del checkout. Nadie los había conectado entre sí — y ahí estaba el problema real: cero programación reactiva, cero garantía de que el estado y la interfaz dijeran la misma verdad.

    Cuando alguien hacía clic dos veces seguidas y rápido, un listener terminaba antes que el otro. El total quedaba repartido entre cuatro variables sueltas, cada una con su propia versión de la verdad. Pasé tres horas arreglando algo que debería haberme tomado diez minutos. No porque el bug fuera complejo — porque nada en el código garantizaba que la interfaz reflejara el estado real.

    Llevamos veinte años resolviendo ese mismo problema con herramientas distintas. Primero fueron callbacks manuales sobre el DOM. Luego llegó el Virtual DOM. Ahora, señales. Cada era resolvió lo que la anterior no pudo — y entender por qué importa más que memorizar sintaxis nueva cada dos años.


    Era 1: callbacks manuales y el DOM que se te olvida sincronizar

    En los tiempos de jQuery — y del DOM vanilla antes de eso — la única forma de reaccionar a un evento era escucharlo y mutar el DOM a mano. Tú decidías qué elemento tocar, cuándo y con qué valor.

    Toma el ejemplo clásico: un contador de carrito con tres elementos que dependen del mismo dato.

    let count = 0;
    
    const counterEl = document.querySelector('#counter');
    const totalEl = document.querySelector('#total');
    const shippingMsgEl = document.querySelector('#shipping-msg');
    
    document.querySelector('#add-btn').addEventListener('click', () => {
      count++;
      counterEl.textContent = count;
      totalEl.textContent = `$${(count * 19.99).toFixed(2)}`;
      shippingMsgEl.textContent = count >= 5
        ? '¡Envío gratis!'
        : `Añade ${5 - count} más para envío gratis`;
    });
    
    document.querySelector('#remove-btn').addEventListener('click', () => {
      count = Math.max(0, count - 1);
      counterEl.textContent = count;
      totalEl.textContent = `$${(count * 19.99).toFixed(2)}`;
      // shippingMsgEl no se actualiza aquí. Nadie lo notó en code review.
    });
    

    Mira el comentario en la última línea. Ese es, casi literal, el bug que revisé en el carrito de mi excliente.

    No es un error de sintaxis — el código compila, pasa QA si nadie prueba el camino de "quitar un producto cuando ya tenías envío gratis". El bug vive en la cabeza del developer: hay que acordarse de tocar los tres elementos en cada handler que mueva ese estado.

    La ventaja de este modelo es real: control total, cero abstracciones, cero curva de aprendizaje. Para un widget aislado — un acordeón, un modal, un tooltip — sigue siendo la opción correcta hoy mismo.

    El problema aparece en cuanto el estado deja de ser trivial:

    • Cada elemento dependiente necesita su propia línea de sincronización, repetida en cada handler que toque ese estado.
    • El estado vive disperso: a veces en el DOM (el.textContent), a veces en variables sueltas, a veces en atributos data-*.
    • Los listeners no se limpian solos. En una SPA que monta y desmonta vistas, cada addEventListener sin su removeEventListener es un memory leak esperando a pasar factura.

    Esto nunca fue un problema de jQuery. Fue un problema de arquitectura: nada en el modelo te obligaba a centralizar el estado ni a declarar sus dependencias. Cada developer inventaba su propia disciplina — y la disciplina, a escala de equipo, no escala.

    Era 2: Virtual DOM y el modelo declarativo

    React cambió la pregunta. En lugar de "¿qué elemento del DOM tengo que tocar?", pasó a ser "¿cómo se ve la UI dado este estado?". Tú describes el resultado final; el framework decide cómo llegar ahí.

    function Counter() {
      const [count, setCount] = useState(0);
      const total = (count * 19.99).toFixed(2);
      const shippingMsg = count >= 5
        ? '¡Envío gratis!'
        : `Añade ${5 - count} más para envío gratis`;
    
      return (
        <div>
          <p>{count}</p>
          <p>${total}</p>
          <p>{shippingMsg}</p>
          <button onClick={() => setCount(c => c + 1)}>Añadir</button>
          <button onClick={() => setCount(c => Math.max(0, c - 1))}>Quitar</button>
        </div>
      );
    }
    

    El bug del carrito es estructuralmente imposible aquí. total y shippingMsg se calculan en la misma función, a partir del mismo count, cada vez que el componente se ejecuta. No hay "actualizar" — hay "recalcular todo desde cero", así que no hay forma de que uno se sincronice y el otro se olvide.

    Ahí está la clave del Virtual DOM. React no toca el DOM real en cada cambio. Construye un árbol en memoria — objetos JavaScript planos que describen cómo debería verse la UI — y lo compara contra el árbol anterior. Ese proceso se llama reconciliation, y el algoritmo de comparación es el diffing: detecta qué nodos cambiaron, cuáles se reutilizan, y calcula el mínimo de operaciones para que el DOM real refleje el nuevo árbol. Solo entonces toca el DOM — y solo donde hace falta.

    Es un modelo declarativo y predecible. Pero el coste real no es gratis, y es lo que casi nadie menciona en los tutoriales de introducción: cada cambio de estado re-ejecuta la función completa del componente y, por defecto, la de sus hijos.

    En un árbol de cuarenta componentes anidados, un solo tecleo puede disparar cuarenta re-renders y cuarenta diffs — la mayoría comparando nodos que ni siquiera cambiaron.

    La respuesta del ecosistema fue la memoization: memo(), useMemo(), useCallback(). Son parches necesarios para un problema que el propio modelo introduce: no sabes qué cambió hasta que recalculas y comparas. Memoizar es responsabilidad manual otra vez — la misma que el Virtual DOM prometía eliminar, solo que movida un nivel más arriba en el árbol.

    Era 3: reactividad fina — el grafo en vez del árbol

    Los signals no comparan nada. No hay árbol virtual, no hay diffing, no hay re-render de una función completa. Un signal es una caja que guarda un valor y sabe, con precisión, quién depende de él.

    import { Component, signal, computed, effect } from '@angular/core';
    
    @Component({
      selector: 'app-cart-counter',
      template: `
        <p>{{ count() }}</p>
        <p>${{ total() }}</p>
        <p>{{ shippingMsg() }}</p>
        <button (click)="count.set(count() + 1)">Añadir</button>
        <button (click)="count.set(count() - 1)">Quitar</button>
      `,
    })
    export class CartCounterComponent {
      count = signal(0);
    
      total = computed(() => (this.count() * 19.99).toFixed(2));
    
      shippingMsg = computed(() =>
        this.count() >= 5
          ? '¡Envío gratis!'
          : `Añade ${5 - this.count()} más para envío gratis`
      );
    
      constructor() {
        effect(() => {
          console.log(`Carrito: ${this.count()} items — $${this.total()}`);
        });
      }
    }
    

    Cuando count cambia, Angular no re-ejecuta el componente entero ni reconstruye ningún árbol para comparar. total y shippingMsg ya saben que dependen de count — lo registraron la primera vez que se ejecutaron, al construirse el grafo reactivo. Angular actualiza exactamente el nodo del DOM ligado a cada binding. Nada más se mueve.

    Esto es reactividad fina (fine-grained reactivity): la granularidad de la actualización no es el componente, ni el subárbol — es el binding individual. Angular v22 lleva esto hasta el final siendo zoneless por defecto: ya no depende de Zone.js interceptando cada setTimeout o evento del navegador para saber cuándo revisar cambios. El grafo de signals es la única fuente de verdad sobre qué actualizar y cuándo.

    Angular no inventó este modelo — lo adoptó y lo llevó a producción a escala. Solid.js lo demostró primero, sin Virtual DOM desde el diseño inicial. Svelte llega a un resultado parecido compilando la reactividad en tiempo de build. Los tres coinciden en el mismo diagnóstico: comparar árboles es trabajo evitable si sabes de antemano quién depende de quién.

    Si quieres ver cada primitiva documentada en detalle, la guía oficial de Angular Signals cubre signal(), computed() y effect() con más profundidad de la que cabe en un post.

    Si quieres ver cómo se construye ese grafo de dependencias paso a paso — incluyendo los casos raros donde un effect() se dispara más veces de las que esperas — lo cubrí a fondo en el post sobre el grafo reactivo de Angular Signals.

    En el curso de Angular Moderno construimos este modelo mental desde cero, con proyectos reales donde pasar de Zone.js a zoneless cambia decisiones de arquitectura, no solo de sintaxis.

    Los tres paradigmas, uno al lado del otro

    Modelo mental Cómo detecta cambios Granularidad de la actualización Coste computacional Dónde brilla
    Callbacks (jQuery / DOM imperativo) Tú mutas el DOM a mano, evento por evento No detecta nada — el developer decide cuándo actualizar La que tú programes, elemento por elemento Bajo por operación, alto en mantenimiento y bugs de sincronización Widgets aislados, prototipos, páginas sin estado compartido
    Virtual DOM (React) La UI es una función pura del estado Diffing — compara árbol virtual anterior vs. nuevo Por componente/subárbol, tras re-ejecutar y comparar Re-ejecuta la función de render completa y diffea en cada cambio Apps con estado complejo, equipos grandes, ecosistema maduro
    Signals (Angular, Solid, Svelte) Grafo de dependencias reactivas Suscripción directa — el signal sabe quién lo consume El binding o nodo exacto del DOM que depende del valor Solo se ejecuta lo que realmente cambió UI de alta frecuencia de actualización, listas grandes, apps sensibles a rendimiento

    Por qué la reactividad fina no es una moda

    Cada era resolvió el cuello de botella real de la anterior — no la anterior en abstracto, la anterior en producción.

    Los callbacks resolvieron "cómo reacciono a un evento del usuario". Fue suficiente mientras la UI tenía poco estado compartido. Dejó de serlo en cuanto una sola acción tenía que actualizar cinco sitios distintos de la pantalla.

    El Virtual DOM resolvió "cómo mantengo la UI declarativa sin perder la cordura sincronizando elementos a mano". A cambio, aceptó un coste: recalcular y comparar árboles que, la mayoría de las veces, apenas habían cambiado.

    Signals resuelve el cuello de botella que el Virtual DOM introdujo: cómo evitar recalcular y comparar lo que ya sabías que no había cambiado. No es una versión "más rápida" de React. Es una respuesta distinta a la misma pregunta de fondo: ¿qué es lo mínimo que tengo que actualizar para que la UI diga la verdad?

    Esto no significa que el Virtual DOM esté acabado, ni que debas reescribir tu app de React mañana.

    Significa que si estás arrancando un proyecto hoy, entender este modelo ya no es opcional — es la diferencia entre construir sobre un patrón que resuelve el problema en su raíz o sobre uno que lo parchea con memoization.

    Esta decisión de arquitectura — dónde vive el estado, cómo fluye, qué parte del sistema es responsable de mantenerlo sincronizado con la UI — es exactamente el tipo de decisión que trato en el post sobre Clean Architecture para frontend con IA: la reactividad que elijas no es un detalle de implementación, es una decisión que carga con consecuencias durante años.

    Si vas a construir con signals en producción, en algún momento necesitarás verificar que esos computed() y effect() se comportan como esperas bajo distintos escenarios — eso es justo lo que trabajamos con casos reales en el curso de Testing en Angular con Jest y Testing Library.

    Y si quieres discutir esto con otros developers que están tomando las mismas decisiones ahora mismo, en Dominicode Labs es donde pasa esa conversación cada semana.

    Preguntas frecuentes sobre programación reactiva en el frontend

    ¿Qué es la programación reactiva?

    Es el paradigma en el que la interfaz se actualiza automáticamente cuando cambia el estado del que depende, sin que el desarrollador tenga que sincronizarla a mano evento por evento. Los tres modelos de este post — callbacks, Virtual DOM y signals — son formas distintas de resolver ese mismo problema, con más o menos reactividad real incorporada al framework.

    ¿El Virtual DOM está muerto?

    No. Sigue siendo el modelo dominante en producción — React tiene el ecosistema, el talento disponible y millones de líneas de código funcionando con él hoy. Lo que cambió es que ya no es la única opción seria para UI compleja: Signals, Solid.js y Svelte demuestran que el diffing es una solución al problema, no la única posible.

    ¿Los Signals reemplazan a React?

    No en el sentido de que React vaya a desaparecer. Angular con Signals, Solid.js y Svelte son alternativas con un modelo distinto, no reemplazos del ecosistema React. Sí es cierto que la presión competitiva ya empujó a React hacia herramientas como React Compiler, que intenta automatizar la memoization que antes hacías a mano.

    ¿Qué es la reactividad fina (fine-grained reactivity)?

    Es un modelo donde cada pieza de estado (signal) mantiene una lista explícita de quién depende de ella — otros signals derivados (computed) o efectos secundarios (effect). Cuando el valor cambia, solo se re-ejecuta lo que está suscrito a ese valor específico, sin comparar árboles ni recalcular lo que no depende de ese dato.

    ¿Angular usa Virtual DOM?

    No, y nunca lo usó. Angular usaba Zone.js y un mecanismo de change detection basado en recorrer el árbol de componentes buscando cambios. Con Signals y el modo zoneless, por defecto desde Angular v22, Angular elimina también ese recorrido: el grafo de signals le dice exactamente qué actualizar, sin Zone.js y sin diffing.

    ¿Debo migrar mi app de React a Signals?

    No si tu app funciona bien y el equipo domina React. La reactividad fina brilla en escenarios concretos: dashboards con actualizaciones muy frecuentes, listas grandes, apps donde el rendimiento de render es un cuello de botella medido, no sospechado. Si estás empezando un proyecto nuevo, sí vale la pena evaluar Angular v22 con Signals como opción seria.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
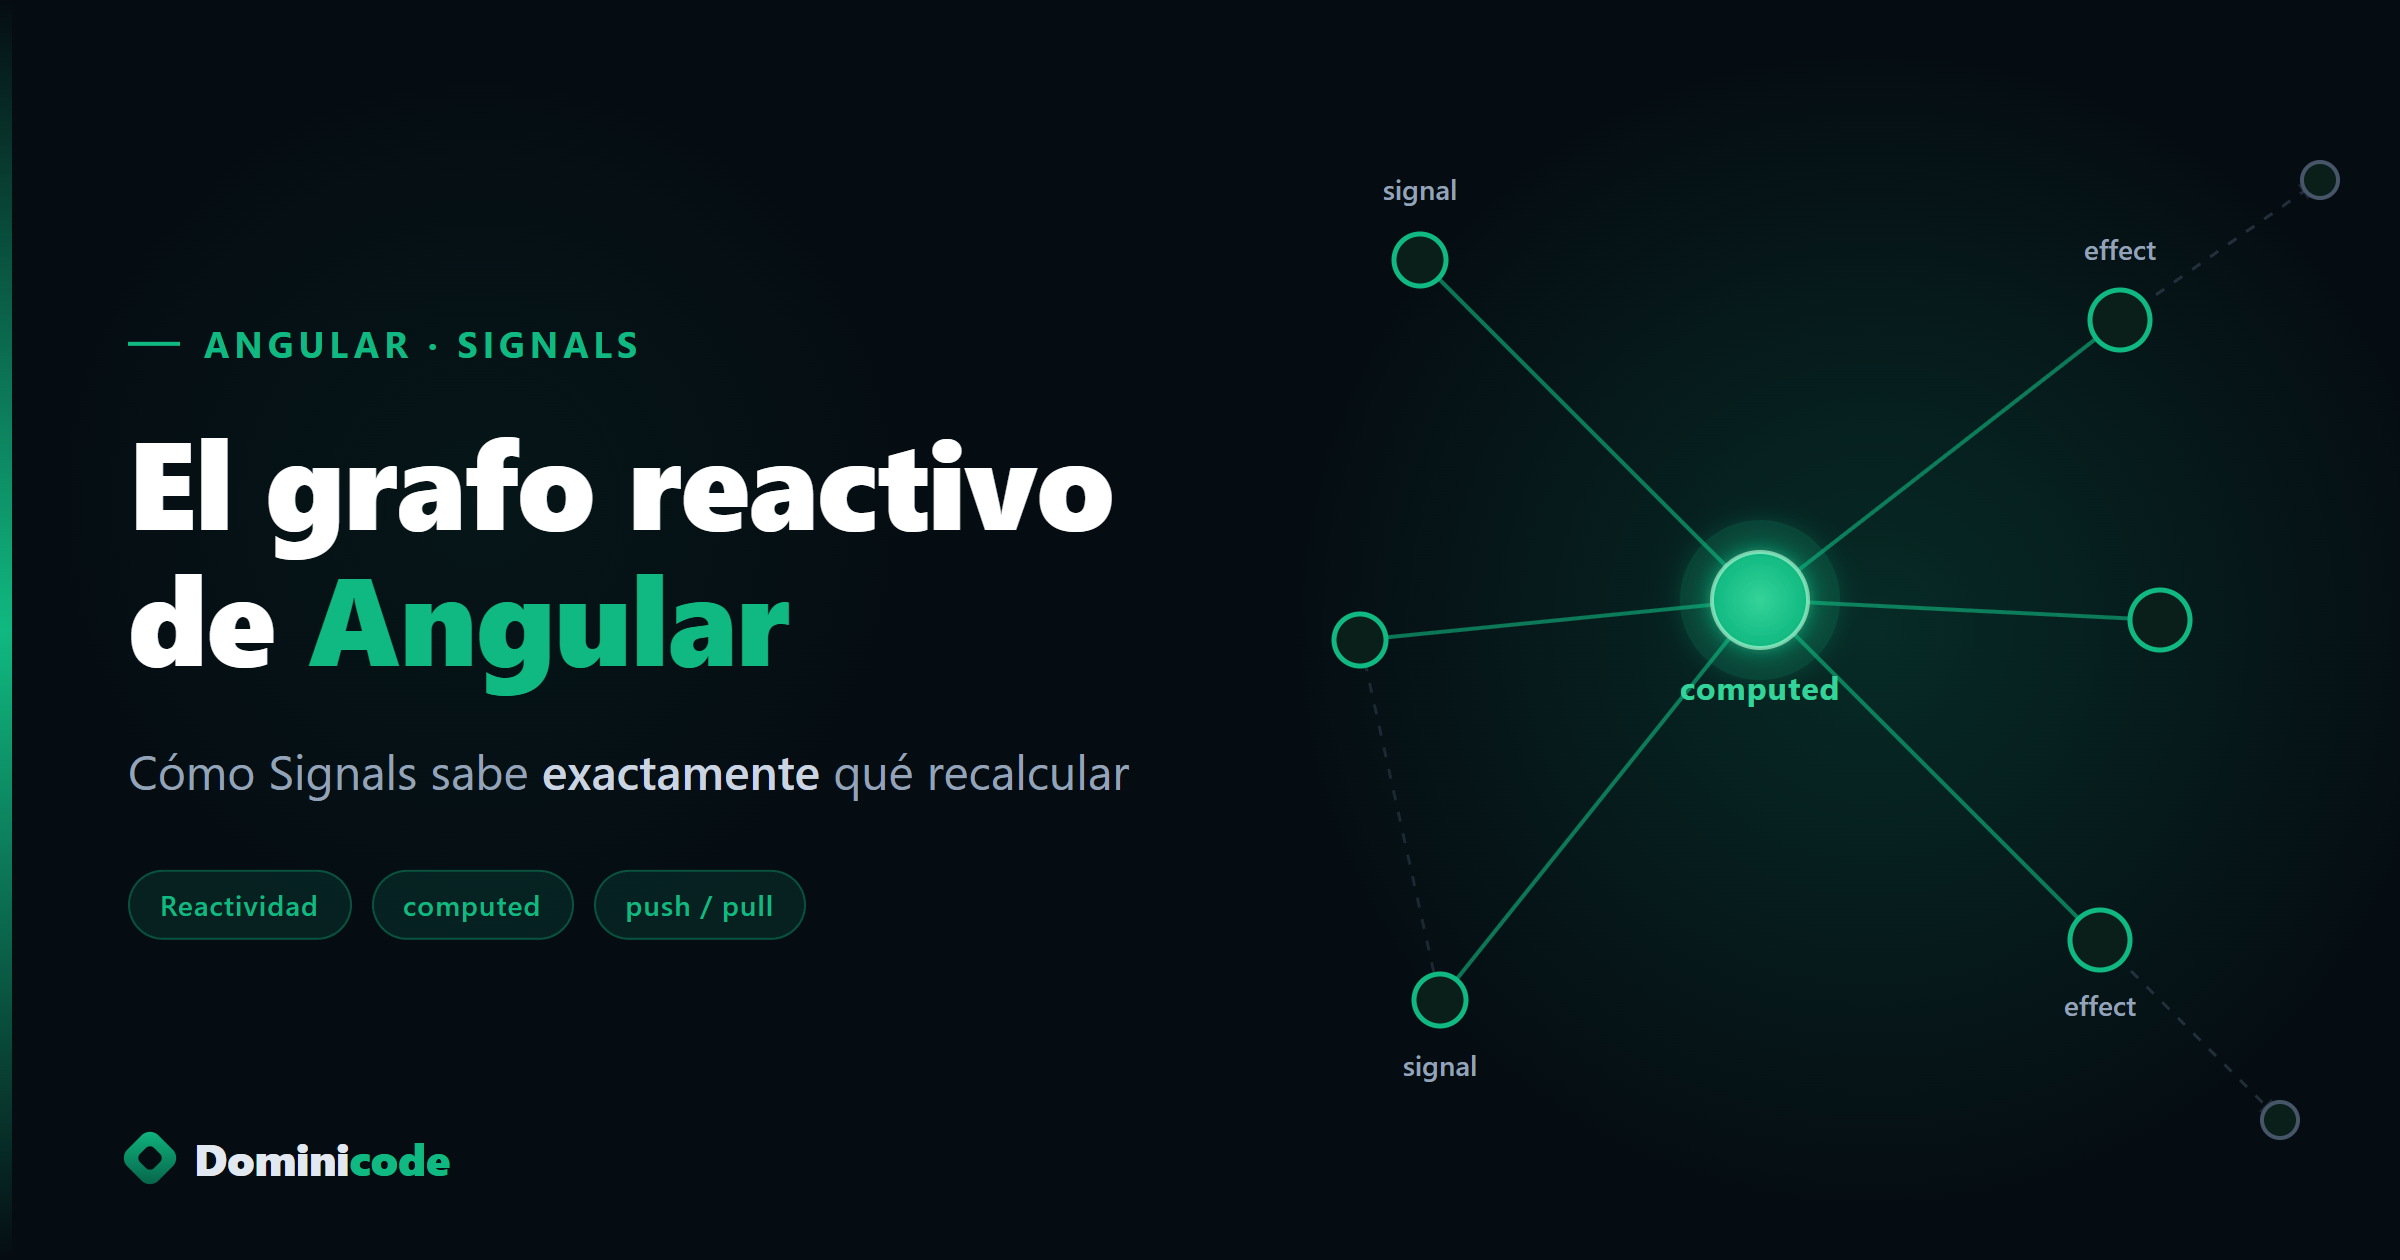
  • El grafo reactivo de Angular: cómo Signals sabe qué recalcular

    El grafo reactivo de Angular: cómo Signals sabe qué recalcular

    Un junior del equipo me enseñó hace poco un computed() que calculaba el total de un carrito. Funcionaba. Pero me dijo una frase que lo delata todo: “le metí un console.log dentro y no se imprime cuando cambio la cantidad… hasta que abro el modal del total”.

    No estaba roto. Estaba haciendo exactamente lo que debe hacer.

    El problema no era su código. Era su modelo mental. No conocía el grafo reactivo de Angular, la estructura que decide qué se recalcula y cuándo. Pensaba que un computed() se recalcula cuando cambian sus datos. Y no. Se recalcula cuando alguien lo lee. Esa diferencia, que parece un detalle, es la puerta de entrada a entender cómo piensa Angular por dentro.

    Porque eso es justo lo que vive debajo de signal(), computed() y effect(): un grafo que casi nadie se molesta en entender, y que lo explica todo.

    ¿Qué es el grafo reactivo de Angular?

    El grafo reactivo de Angular es la estructura interna que el framework construye con su sistema de Signals para saber, en todo momento, qué valores dependen de qué otros. No es una API que tú llamas. Es el motor que se monta solo cuando declaras signals, computeds y effects, y es lo que permite que Angular recalcule únicamente lo que cambió en lugar de revisar la aplicación entera.

    Los Signals son estables desde Angular 16-17 (2023), y son la base sobre la que se apoya el modo zoneless, disponible como opción de producción a partir de Angular v20.

    Imagínalo literalmente como un grafo: nodos conectados por flechas. Los nodos son tus valores reactivos. Las flechas son las dependencias entre ellos. Cuando un valor cambia, Angular recorre esas flechas para decidir qué tocar y qué dejar en paz.

    Y la clave —la que casi nadie explica— es que esas flechas no las dibujas tú. Las descubre Angular en tiempo de ejecución.

    Vamos por partes.

    Los nodos: productores y consumidores

    Todo en el grafo es una de dos cosas (o las dos a la vez). Te lo presento como modelo conceptual, no como API pública: Angular no te expone estos nombres, pero entenderlos cambia cómo lees tu propio código.

    • Un signal() es un productor puro. Tiene un valor, otros lo leen, pero él no depende de nadie. Es una raíz del grafo.
    • Un computed() es consumidor y productor a la vez. Lee otros signals (consume) y a su vez otros lo leen a él (produce). Es un nodo intermedio.
    • Un effect() es un consumidor puro. Lee signals y reacciona, pero nadie lee a un effect. Es una hoja del grafo, el final de la cadena.
    import { signal, computed, effect } from '@angular/core';
    
    const precio = signal(100);          // productor puro (raíz)
    const cantidad = signal(2);          // productor puro (raíz)
    
    const total = computed(() =>         // consumidor (lee precio y cantidad)
      precio() * cantidad());            // + productor (otros leerán 'total')
    
    effect(() => {                       // consumidor puro (hoja)
      console.log('Total actual:', total());
    });

    El grafo aquí tiene una forma clarísima: precio y cantidad apuntan a total, y total apunta al effect. Cuatro nodos, tres flechas.

    Pero tú no escribiste ni una sola de esas flechas.

    Las aristas: tracking dinámico de dependencias

    Aquí está la primera idea que separa a quien usa signals de quien los entiende.

    Las dependencias no se declaran. Angular las descubre.

    Cuando un computed() o un effect() se ejecuta, Angular activa un registro temporal: “todo signal que se lea durante esta ejecución se anota como dependencia”. Lees precio() dentro del computed → se crea la flecha precio → total. Lees cantidad() → se crea cantidad → total. Termina la ejecución, se cierra el registro.

    Esto tiene una consecuencia preciosa: las dependencias pueden ser condicionales. Cada ejecución puede producir un conjunto distinto de aristas.

    const modoOscuro = signal(false);
    const colorClaro = signal('#ffffff');
    const colorOscuro = signal('#1a1a1a');
    
    const colorFondo = computed(() => {
      if (modoOscuro()) {
        return colorOscuro();   // solo se lee si modoOscuro es true
      }
      return colorClaro();      // solo se lee si modoOscuro es false
    });

    Cuando modoOscuro es false, este computed depende de modoOscuro y de colorClaro. No depende de colorOscuro en absoluto. Si cambias colorOscuro mientras estás en modo claro, colorFondo no se marca como sucio, no se recalcula, no pasa nada.

    Cambia modoOscuro a true y, en el siguiente recálculo, el grafo se reconfigura: ahora la flecha sale de colorOscuro y la de colorClaro desaparece.

    Esto no lo consigues gratis con RxJS combinando observables. Aquí es el comportamiento por defecto, sin esfuerzo. Es exactamente este tipo de detalle el que trabajamos a fondo en el curso de Angular Moderno, porque entender el grafo cambia cómo estructuras el estado de toda la app.

    Push y pull: por qué el computed de mi compañero no se ejecutaba

    Volvamos a la historia del principio. El console.log que no se imprimía.

    El grafo reactivo funciona con dos fases distintas, y casi todo el mundo solo conoce la primera.

    Fase push (cuando cambias un signal). Llamas a cantidad.set(5). Angular recorre el grafo hacia abajo y marca a los consumidores como “sucios” (stale). total se marca sucio. El effect que depende de total se marca sucio. Y ya. No se recalcula nada todavía. Solo se propaga una marca de “esto podría haber cambiado”.

    Fase pull (cuando alguien lee). El valor de un computed() solo se recalcula cuando alguien lo lee y está marcado sucio. Es perezoso (lazy) y memoizado: si nadie lo lee, no se ejecuta jamás.

    const a = signal(1);
    const b = signal(2);
    
    const suma = computed(() => {
      console.log('¡Calculando suma!');   // ¿cuándo se imprime esto?
      return a() + b();
    });
    
    a.set(10);
    a.set(20);
    a.set(30);
    // Hasta aquí: el log NO se ha impreso ni una vez.
    
    console.log(suma());  // AHORA imprime "¡Calculando suma!" y luego 32
    console.log(suma());  // NO vuelve a imprimir: valor memoizado

    Tres cambios en a y cero recálculos, porque nadie leyó suma. La leemos una vez y se calcula una vez. La leemos de nuevo sin cambios de por medio y devuelve el valor cacheado sin recalcular.

    Por eso el computed() del carrito “no se ejecutaba” hasta abrir el modal: ningún template estaba leyendo ese valor. En cuanto el modal lo renderizó, lo leyó, y entonces —y solo entonces— se recalculó.

    No era un bug. Era el grafo trabajando exactamente como debe: no malgastar ni un ciclo de CPU en valores que nadie está mirando.

    Consistencia glitch-free: nunca verás un estado intermedio falso

    Pregunta incómoda: ¿qué pasa cuando un nodo depende del mismo origen por dos caminos distintos?

    const base = signal(10);
    
    const doble = computed(() => base() * 2);
    const triple = computed(() => base() * 3);
    
    const resumen = computed(() => `${doble()} y ${triple()}`);

    resumen depende de doble y de triple, y ambos dependen de base. Hay dos rutas desde base hasta resumen.

    Cuando cambias base, un sistema reactivo mal diseñado podría recalcular resumen dos veces (una por cada ruta) o, peor, calcularlo con doble ya actualizado pero triple todavía viejo. Eso es un glitch: un estado intermedio que nunca debió existir.

    El grafo de Angular es glitch-free. Ante un cambio en base, resumen se recalcula una sola vez, y cuando lo hace, tanto doble como triple ya están coherentes. Nunca observas la mezcla rara. El orden de evaluación del grafo (pull bajo demanda) junto con el versionado de cada nodo garantizan que un consumidor con varias rutas hacia el mismo origen converja en un único recálculo consistente.

    Esto importa de verdad en producción. Es la diferencia entre una UI que parpadea con valores intermedios y una que actualiza limpio.

    Versiones e igualdad: la poda que ahorra renders

    Aquí entra el matiz que convierte el grafo en algo eficiente y no solo correcto.

    Cada productor lleva, conceptualmente, una versión. Cuando un consumidor está sucio y va a recalcular, primero compara: “¿la versión de mis dependencias cambió de verdad respecto a la última vez que las usé?”. Si nada cambió realmente, no recomputa.

    Y hay una segunda poda, más conocida: la función de igualdad. Por defecto, un signal usa Object.is para decidir si el nuevo valor es distinto del anterior. Si haces set con un valor igual al actual, el grafo no propaga nada aguas abajo.

    const estado = signal('activo');
    
    const etiqueta = computed(() => {
      console.log('Recalculando etiqueta');
      return estado().toUpperCase();
    });
    
    etiqueta();              // imprime "Recalculando etiqueta" → "ACTIVO"
    estado.set('activo');    // mismo valor: Object.is da true → NO propaga
    etiqueta();              // NO recalcula: el grafo nunca se marcó sucio

    Puedes personalizar esa comparación cuando trabajas con objetos:

    const usuario = signal(
      { id: 1, nombre: 'Ana' },
      { equal: (a, b) => a.id === b.id }   // igual si el id no cambia
    );

    Ahora, si emites un objeto nuevo con el mismo id, el grafo lo considera igual y corta la propagación ahí mismo. Menos recálculos, menos renders. Esta equal es tu palanca para podar el grafo a mano cuando lo necesitas.

    Effects y el scheduler: por qué no son síncronos

    Un detalle que confunde: los effect() no corren en el instante exacto en que cambias un signal.

    Cuando un signal del que depende un effect cambia, el effect se marca sucio y se agenda (scheduler). Angular lo ejecuta de forma agrupada, ligado normalmente a su ciclo de detección de cambios. Esto evita que un effect se dispare diez veces si haces diez set seguidos en la misma tarea: se ejecuta una vez, con el estado final.

    const x = signal(0);
    
    effect(() => console.log('x es', x()));
    
    x.set(1);
    x.set(2);
    x.set(3);
    // El effect NO imprime tres veces seguidas.
    // Se agenda y corre una vez, con el valor final: "x es 3"

    Si vienes de pensar en callbacks síncronos, este es el ajuste mental que necesitas. El effect reacciona, pero reacciona cuando toca, no a cada microcambio.

    El contraste que lo explica todo: grafo vs. Zone.js

    Ahora la pieza que da sentido a todo lo anterior.

    Durante años, Angular detectó cambios con Zone.js + dirty checking. El modelo era de fuerza bruta: cuando algo podía haber cambiado (un click, un timeout, una respuesta HTTP), Angular recorría todo el árbol de componentes comprobando cada binding por si acaso. Funcionaba, pero el framework no sabía qué había cambiado. Solo sabía que algo pudo cambiar, y revisaba entero por si las moscas.

    El grafo reactivo invierte el modelo. Angular ya no necesita preguntar “¿cambió algo en alguna parte?”. El propio grafo sabe exactamente qué signal cambió y qué nodos dependen de él. La actualización deja de ser una búsqueda y pasa a ser una notificación dirigida.

    Zone.js + dirty checking Grafo reactivo (Signals)
    ¿Qué sabe el framework? Que algo pudo cambiar Qué signal cambió exactamente
    Alcance de la revisión Todo el árbol de componentes Solo el nodo y sus dependientes
    Disparo Cualquier evento async (click, timeout, HTTP) El cambio concreto de un signal
    Coste Proporcional al tamaño del árbol Proporcional a lo que de verdad cambió
    Viabilidad zoneless No (necesita Zone.js) Sí (Angular puede prescindir de Zone.js)

    Esto es la base técnica de zoneless —opción de producción desde Angular v20— y de la detección de cambios granular: si todo tu estado vive en signals, Angular puede prescindir de Zone.js por completo, porque el grafo ya le dice qué refrescar. Pasas de “revisa todo el árbol por si acaso” a “actualiza este nodo y sus tres dependientes, nada más”.

    Si quieres ver dónde encaja esto en la versión actual, lo cuento en detalle en las novedades de Angular v22, y cómo este mismo grafo gobierna la carga de datos asíncrona en el post sobre la Resource API de Angular 22.

    Qué puedes hacer con esto hoy

    No necesitas memorizar internals para escribir signals. Pero con este modelo en la cabeza dejas de programar a ciegas:

    1. Mete tu lógica derivada en computed() sin miedo a la performance: si nadie lo lee, no cuesta nada.
    2. Deja de “optimizar” recálculos a mano — el grafo ya memoiza y poda por ti.
    3. Usa equal personalizado cuando trabajes con objetos y veas renders de más.
    4. Mueve estado de RxJS a signals donde la lógica sea síncrona y derivada; reserva RxJS para flujos de eventos reales.

    La próxima vez que un computed() “no se ejecute cuando esperabas”, ya no vas a pensar que está roto. Vas a saber que el grafo está esperando, perezoso y eficiente, a que alguien lea el valor.

    Si quieres dominar Signals con esta profundidad —el grafo, los effects, la migración desde RxJS y los patrones que aguantan en producción— eso es justo lo que construimos paso a paso en el curso de Angular Moderno. Y si quieres seguir afilando el modelo mental con la comunidad, te espero en Dominicode Labs.

    Preguntas frecuentes

    ¿El grafo reactivo es lo mismo que los Signals?

    No exactamente. Los Signals (signal, computed, effect) son las APIs que tú usas; el grafo reactivo es la estructura interna que Angular construye a partir de ellas para saber qué depende de qué. Tú escribes signals; Angular monta el grafo automáticamente por debajo.

    ¿Necesito entender el grafo reactivo para usar Signals?

    Para escribir código que funcione, no. Para escribir código eficiente y entender por qué un computed() se comporta como lo hace —cuándo recalcula, cuándo no, por qué no parpadea— sí. Es la diferencia entre usar signals y dominarlos.

    ¿El grafo reactivo reemplaza a RxJS?

    No lo reemplaza, lo complementa. El grafo de Signals brilla en estado síncrono y valores derivados. RxJS sigue siendo la mejor herramienta para flujos de eventos complejos, streams asíncronos y operadores como debounce o switchMap. Muchos proyectos usan ambos: signals para el estado, RxJS para los flujos.

    ¿Qué relación tiene con zoneless?

    Total. El modo zoneless elimina Zone.js, y solo es viable porque el grafo reactivo ya le dice a Angular exactamente qué cambió y qué refrescar. Sin el grafo, Angular tendría que volver a revisar todo el árbol de componentes. El grafo es la condición que hace posible zoneless.

    ¿Un computed() se ejecuta siempre que cambian sus datos?

    No. Es perezoso: se marca como “sucio” cuando cambia una dependencia, pero solo se recalcula de verdad cuando alguien lee su valor. Si nadie lo lee, no se ejecuta. Y una vez calculado, devuelve un valor memoizado hasta que cambie alguna dependencia.

    ¿Cómo evita Angular recalcular un valor dos veces ante un mismo cambio?

    Gracias a la consistencia glitch-free y al versionado de nodos. Si un consumidor depende de un mismo origen por varias rutas, el grafo lo recalcula una sola vez y con valores coherentes, sin estados intermedios falsos ni recálculos duplicados.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
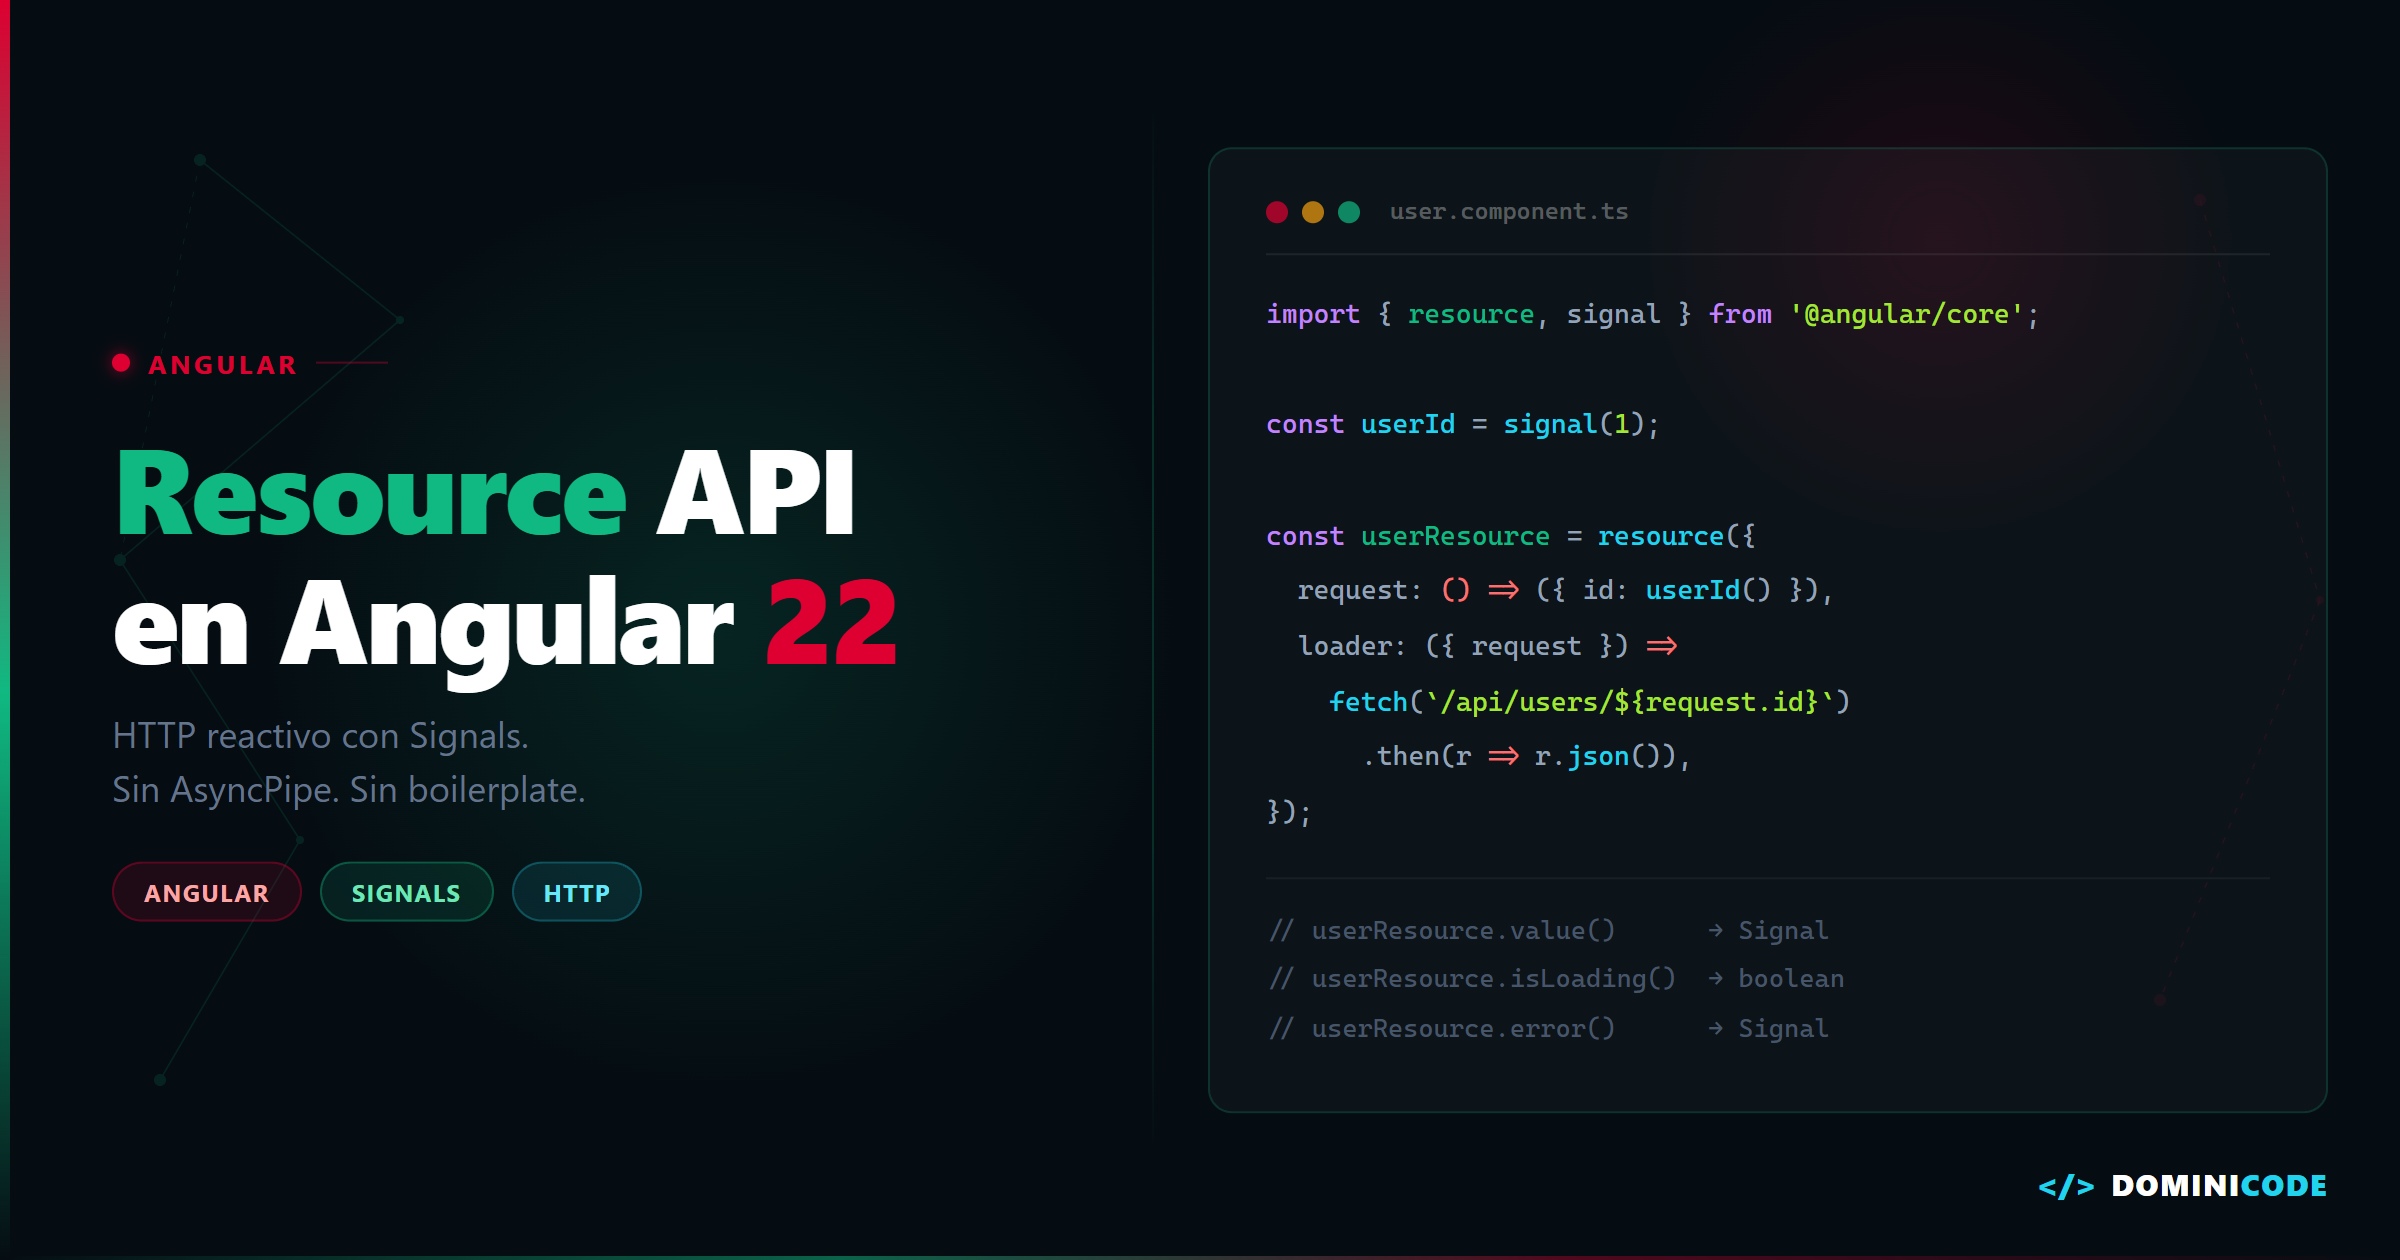
  • Resource API en Angular 22: el fin del subscribe() manual

    Resource API en Angular 22: el fin del subscribe() manual

    Revisé hace poco un componente de Angular que cargaba una lista de productos. Contaba los observables con los dedos: un BehaviorSubject para la categoría seleccionada, un switchMap hacia HttpClient, un catchError para los fallos, un takeUntilDestroyed para no dejar suscripciones vivas, y al final, un async pipe en el template.

    Todo correcto. Todo necesario. Y todo código que explica exactamente lo mismo que cualquier otro componente de carga de datos en la aplicación. La Resource API de Angular 22 resuelve exactamente este problema.

    Ese patrón tiene quince años. Angular 22 tiene la respuesta definitiva.

    Qué es la Resource API y por qué existe

    La Resource API es el mecanismo nativo de Angular para gestionar operaciones asíncronas dentro del sistema de Signals. No es una librería de terceros, no es un wrapper sobre RxJS: es la pieza que faltaba para que el modelo reactivo de Angular estuviera completo.

    La idea central es sencilla: tienes un signal que representa un parámetro (un ID, un filtro, una página), y quieres que Angular haga automáticamente el fetch cuando ese parámetro cambia. Sin subscribe, sin pipe, sin gestión manual del ciclo de vida.

    En Angular 22 el ecosistema completo se compone de tres APIs:

    • resource() — fetch genérico con Promise. Estable en v22.
    • rxResource() — puente para servicios basados en Observable. Estable en v22.
    • httpResource() — wrapper declarativo sobre HttpClient. Experimental en v22.

    El matiz de los estados de estabilidad importa. resource() y rxResource() ya son API pública con garantías de compatibilidad. httpResource() sigue marcado como experimental — la API puede cambiar. Para producción crítica, ten eso en cuenta.

    resource(): el punto de entrada

    Usa resource() cuando el origen de datos es una Promise o una función fetch directa. El parámetro reactivo se define en params, y la función que carga los datos en loader.

    import { ChangeDetectionStrategy, Component, signal, resource } from '@angular/core';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @switch (productos.status()) { @case ('loading') { <p>Cargando...</p> } @case ('reloading') { <p>Actualizando...</p> } @case ('error') { <p>Error: {{ productos.error() }}</p> } @default { @if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } } } <button (click)="categoria.set(categoria() + 1)">Siguiente</button> <button (click)="productos.reload()">Recargar</button> `, }) export class CatalogoComponent { categoria = signal(1);

    productos = resource<Producto[], { cat: number }>({ params: () => ({ cat: this.categoria() }), loader: ({ params, abortSignal }) => fetch(/api/products?category=${params.cat}, { signal: abortSignal }) .then(r => r.json()), }); }

    Dos errores que verás en código antiguo o en tutoriales desactualizados:

    • El campo se llama params, no request. Eso era la API experimental anterior.
    • Los estados son strings literales: 'loading', 'reloading', 'error'… ResourceStatus no es un enum TypeScript nativo — es un objeto de constantes (as const), así que se compara con strings literales, no con ResourceStatus.Loading.

    Cuando categoria cambia, Angular cancela el fetch anterior (usando el abortSignal que recibe el loader) y lanza uno nuevo. El ciclo de vida completo, gestionado sin escribir una sola línea de cleanup.

    rxResource(): para servicios que devuelven Observables

    La mayoría de proyectos Angular tienen servicios basados en HttpClient que devuelven Observable. Migrar todo a fetch puro no es viable ni deseable.

    rxResource() es el puente. En lugar de loader, usa stream, que devuelve un Observable.

    import { ChangeDetectionStrategy, Component, signal, inject } from '@angular/core';
    import { rxResource } from '@angular/core/rxjs-interop';
    import { HttpClient } from '@angular/common/http';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo-rx', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (productos.isLoading()) { <p>Cargando...</p> } @else if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } `, }) export class CatalogoRxComponent { private http = inject(HttpClient); categoria = signal(1);

    productos = rxResource({ params: () => ({ cat: this.categoria() }), stream: ({ params }) => this.http.get<Producto[]>(/api/products?category=${params.cat}), }); }

    Dos puntos que generan confusión frecuente:

    • El import correcto es @angular/core/rxjs-interop, no @angular/core.
    • El método se llama stream, no loader. Los ejemplos de versiones experimentales anteriores usaban loader, de ahí la confusión.

    httpResource(): la opción declarativa

    httpResource() va un paso más allá: elimina la necesidad de declarar un servicio intermedio para casos de fetching simple. Lo declaras directamente en el componente.

    import { ChangeDetectionStrategy, Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    

    interface User { id: number; name: string; }

    @Component({ selector: 'app-user-profile', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (user.isLoading()) { <p>Cargando...</p> } @else if (user.error()) { <p>Error al cargar el perfil</p> } @else if (user.hasValue()) { <p>{{ user.value()?.name }}</p> } `, }) export class UserProfileComponent { userId = signal(1);

    user = httpResource<User>(() => /api/user/${this.userId()}); }

    httpResource() expone dos signals exclusivos que no tienen resource() ni rxResource():

    • .statusCode() — el código HTTP de la respuesta (200, 404, 500…)
    • .headers() — las cabeceras de la respuesta

    Ambas son señales independientes de .status(), que sigue siendo el estado del ciclo de vida del recurso. Confundir .status() con .statusCode() es el error más frecuente al empezar con esta API.

    Para respuestas que no son JSON:

    // Texto plano
    const readme = httpResource.text(() => /docs/readme.md);
    

    // Binario const avatar = httpResource.blob(() => /api/user/${this.userId()}/avatar);

    Requiere provideHttpClient() en el bootstrap. Usa HttpClient e interceptores por debajo, así que tus interceptores de autenticación siguen funcionando sin cambiar nada.

    Recuerda que httpResource() sigue marcado como experimental en v22. Para proyectos con requisitos estrictos de estabilidad de API, usa rxResource() con tu servicio HttpClient habitual hasta que se estabilice.

    Cuándo usar cada uno

    No es una decisión complicada si tienes claros los criterios:

    | Situación | API recomendada | |—|—| | Fetch puro o API externa directa | resource() | | Tienes servicios con Observable existentes | rxResource() | | Fetching simple sin servicio intermedio (experimental) | httpResource() | | Necesitas el status code HTTP como signal | httpResource() |

    Las tres APIs comparten la misma superficie de lectura: .value(), .isLoading(), .error(), .hasValue(), .status(), .reload(). Cambiar de una a otra es mínimamente invasivo.

    Validación del dato en runtime

    El genérico de TypeScript solo existe en tiempo de compilación. Si el backend devuelve algo inesperado, httpResource() no lanzará ningún error — simplemente tendrás un objeto mal tipado en runtime.

    La opción parse existe exactamente para este caso:

    import { z } from 'zod';
    

    const UserSchema = z.object({ id: z.number(), name: z.string(), });

    user = httpResource( () => /api/user/${this.userId()}, { parse: UserSchema.parse } );

    Si el dato del backend no cumple el schema, el resource entra en estado 'error' automáticamente. Sin try/catch manual, sin runtime silencioso. Si quieres profundizar en cómo construir schemas robustos con Zod para este tipo de validación, el curso de Zod para TypeScript cubre exactamente estos patrones de producción.

    Lo que cambia en tu arquitectura

    La Resource API no elimina los servicios Angular — los reorganiza. Sigues necesitando servicios para encapsular lógica de negocio compleja, componer múltiples endpoints, o compartir estado entre componentes. Lo que elimina es el boilerplate de gestión de ciclo de vida en los componentes que simplemente cargan y muestran datos.

    Un componente que antes necesitaba un servicio, tres operadores RxJS y un takeUntilDestroyed ahora expresa la misma intención en diez líneas. La lógica no desaparece — se mueve al lugar correcto.

    Si quieres el cuadro completo — Signals, Resource API, Signal Forms, Zoneless y todo lo que llegó en v22 — el curso Angular Moderno tiene el módulo M10 dedicado íntegramente a Resource API con ejemplos sobre el proyecto ShopFlow.

    Qué hacer hoy

    Identifica en tu proyecto los componentes que tienen este patrón: signal o BehaviorSubject como parámetro, switchMap hacia HttpClient, y async pipe en el template.

    Esos son tus candidatos para migrar a rxResource(). No necesitas reescribir los servicios. Solo cambias la forma en que el componente consume el Observable.

    Empieza por un componente de solo lectura — uno que carga datos y no tiene formularios complejos. Comprueba que .status() en el template te da todo lo que necesitabas del loading$ que tenías antes.

    Si funciona ahí, tienes el patrón. El resto de la migración es repetirlo.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre resource() y httpResource() en Angular 22? resource() acepta cualquier función que devuelva una Promise — puedes usarlo con fetch, con SDKs externos, o con cualquier operación asíncrona. httpResource() es un wrapper declarativo sobre HttpClient que además expone el status code HTTP y las cabeceras como signals independientes. La diferencia clave: httpResource() sigue siendo experimental en v22; resource() es API estable.

    ¿Puedo usar rxResource() si tengo servicios que devuelven Observables? Sí. rxResource() está diseñado exactamente para ese caso. En lugar de loader, defines un stream que devuelve un Observable. Tus servicios existentes no cambian — solo cambia cómo el componente los consume.

    ¿La Resource API reemplaza completamente RxJS en Angular? No. RxJS sigue siendo útil para transformaciones complejas de streams, operadores avanzados y casos donde necesitas combinar múltiples fuentes. La Resource API reemplaza el patrón subscribe/unsubscribe para carga de datos HTTP en componentes — no todos los casos de uso reactivo.

    ¿Qué ocurre con los datos en caché cuando cambia el signal de parámetros? Cuando el signal de params cambia, el resource entra en estado 'reloading' (no 'loading'). El valor anterior sigue disponible en .value() durante la recarga. Esto permite mostrar datos obsoletos mientras llegan los nuevos, en lugar de mostrar un spinner que vacía la UI. Es el comportamiento por defecto — no necesitas configurarlo.

    ¿Funciona la Resource API con Angular SSR? Sí. httpResource() usa HttpClient internamente, que ya tiene soporte de transferencia de estado para SSR. Con resource() y rxResource() necesitas gestionar tú mismo la transferencia de estado si el servidor precarga datos. La integración más limpia con SSR actualmente es a través de httpResource() o rxResource() con un servicio que use TransferState.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode. Ha migrado proyectos Angular en producción desde v2 hasta v22.

    Sources: