Tag: SDD

  • Refactorizar código legacy con IA: el método SDD en brownfield

    Refactorizar código legacy con IA: el método SDD en brownfield

    El fichero se llamaba pricing.ts, tenía 1.100 líneas y un comentario en la línea 3 que decía // NO TOCAR — hablar con Javi antes. Javi se había ido de la empresa en 2021.

    Cero tests. Cero documentación. Y toda la facturación pasando por ahí.

    Hice lo que hace todo el mundo la primera vez que intenta refactorizar código legacy con IA: se lo pegué entero a Claude Code y le pedí que lo dejara limpio. Me devolvió algo precioso. Funciones puras, nombres decentes, 300 líneas en vez de 1.100.

    Y roto para los pedidos que acumulaban cupón y descuento de socio a la vez.

    El agente no alucinó nada. Hizo exactamente lo que le pedí. Le pedí arreglar un código cuya intención nadie le había explicado, porque nadie la sabía.

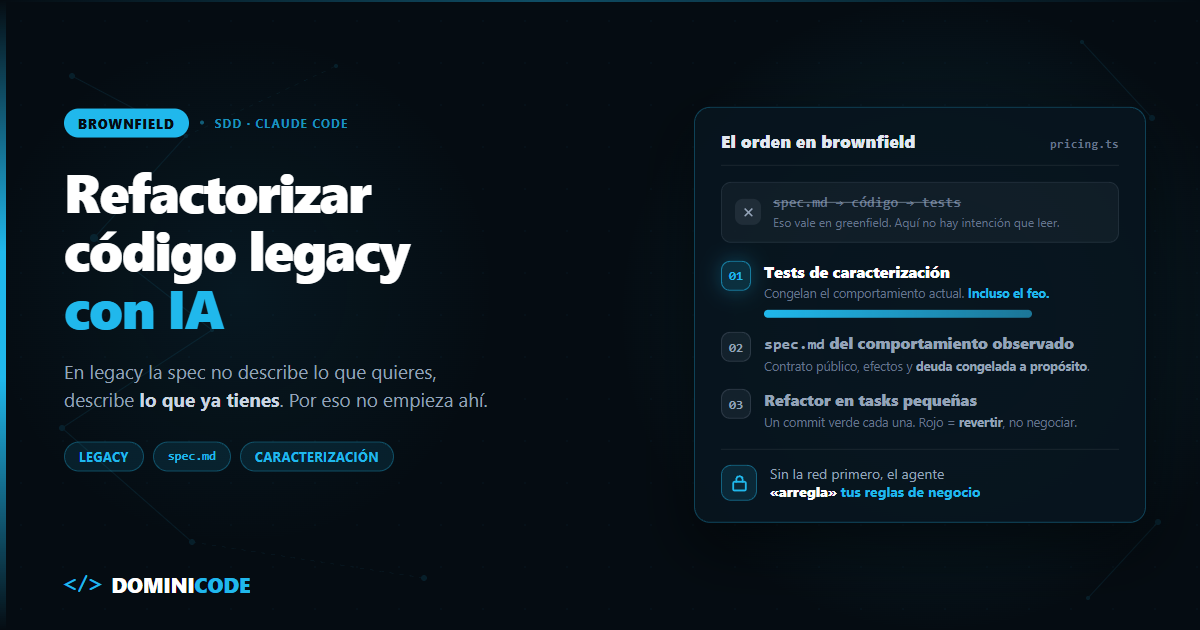
    Esa es la tesis de este post: en legacy la spec no describe la feature que quieres, describe el comportamiento que ya tienes. Y por eso el primer artefacto no es spec.md, son los tests de caracterización.

    Por qué refactorizar código legacy con IA falla sin tests

    Refactorizar código legacy con IA usando SDD consiste en invertir el ciclo habitual: primero tests de caracterización que congelan el comportamiento observable, después una spec que documenta lo que el sistema ya hace, y solo entonces plan y tasks.

    El motivo es simple. Un modelo lee código y ve perfectamente qué hace. Lo que no puede ver es qué debería hacer.

    En un proyecto nuevo eso da igual, porque la intención está en tu cabeza y la escribes tú. Es lo que hacemos cuando arrancamos un greenfield con slices verticales: la spec va delante porque describe algo que todavía no existe.

    En legacy la intención está enterrada bajo seis años de parches de viernes por la tarde. Y ahí aparece el problema real: ningún modelo distingue una regla de negocio rara de un bug que lleva años tolerándose.

    En mi pricing.ts había un Math.floor donde cualquiera pondría Math.round. Claude lo "arregló". Llevaba ahí desde 2019 porque el departamento financiero quería redondear siempre a favor del cliente.

    Eso no es un bug. Es un requisito no escrito. Y el agente no tenía forma humana de saberlo.

    Los antipatrones de este escenario los desarrollé en los 5 errores fatales al refactorizar legacy con IA, así que no los repito. El método positivo empieza invirtiendo el orden.

    Spec greenfield Spec brownfield
    Qué describe Lo que quieres construir Lo que ya hace el sistema
    Fuente de verdad Tu criterio de producto El código en producción
    Primer artefacto spec.md Tests de caracterización
    Criterio de éxito Cumple los casos de uso nuevos No cambia ninguna salida observable
    Ambigüedad Se resuelve preguntando Se resuelve ejecutando
    Riesgo principal Construir lo que no toca Romper lo que ya funcionaba

    En greenfield el ciclo es spec → plan → tasks → código. En brownfield es tests → spec → plan → tasks → código. La spec sigue existiendo, pero llega en segundo lugar: hasta que no ejecutas el módulo no sabes qué escribir en ella.

    Paso 0 — Acota el blast radius antes de abrir el editor

    La regla que más refactors me ha salvado: si no puedes escribir en una línea qué NO vas a tocar, no empieces.

    Escribe estas cuatro cosas antes de nada:

    • Dentro: src/pricing.ts y sus dos helpers.
    • Fuera: el modelo de datos, los endpoints, la UI de checkout.
    • Consumidores: quién importa esto. Lanza un rg sobre el repo y pega la lista tal cual.
    • Contrato público: las funciones exportadas que otros usan. Esas firmas no se tocan.

    Ese último punto es el que hace el trabajo acotable: si la frontera del módulo se mueve, ya no es un refactor, es un rediseño.

    Paso 1 — Arqueología asistida: el agente lee, no escribe

    Aquí Claude Code es brutalmente bueno, y es la parte que casi nadie usa. El agente tiene prohibido cambiar una sola línea.

    El prompt que uso, más o menos literal:

    Lee src/pricing.ts. No propongas mejoras ni refactorices nada.
    
    Produce docs/legacy/pricing-observado.md con:
    1. Cada rama de decisión del módulo, con la condición exacta que la activa.
    2. Las entradas: tipos reales, no los declarados. Marca los que en la práctica
       llegan como null o undefined.
    3. Las salidas: forma del retorno en cada rama.
    4. Efectos secundarios: I/O, escrituras, logs, mutación de argumentos, lecturas
       de Date/Math.random o de variables globales.
    5. Una sección "Comportamientos sospechosos": cosas que parecen bugs.
       NO las arregles. Solo lístalas con número de línea.
    6. Una sección "Preguntas que no puedo responder leyendo el código".
    

    Las secciones 5 y 6 son el oro: una lista lo que el agente habría "arreglado" solo, la otra lo que tienes que ir a preguntarle a un humano o a los logs de producción.

    En pricing.ts la sección 6 tenía nueve preguntas. Siete las resolví mirando datos reales. Dos las resolvió el responsable de facturación en cinco minutos. Ese día no escribí código y fue el día más productivo del refactor.

    Paso 2 — Tests de caracterización: congela el comportamiento, incluso el feo

    Un test de caracterización no comprueba que el código sea correcto. Comprueba que sigue haciendo lo mismo. En TDD el test va delante y define lo deseable; aquí va detrás y define lo existente.

    Aunque lo existente sea horrible.

    // pricing.characterization.test.ts
    import { describe, it, expect } from 'vitest'
    import { calcularPrecioFinal } from '../src/pricing'
    
    // Casos capturados de pedidos reales de producción, anonimizados.
    const CASOS = [
      { nombre: 'base sin descuentos', pedido: { subtotal: 100, cupon: null, pais: 'ES', socio: false } },
      { nombre: 'cupon y socio acumulados', pedido: { subtotal: 100, cupon: 'VIP10', pais: 'ES', socio: true } },
      { nombre: 'cupon caducado', pedido: { subtotal: 100, cupon: 'OLD20', pais: 'ES', socio: false } },
      { nombre: 'pais sin IVA', pedido: { subtotal: 100, cupon: null, pais: 'US', socio: false } },
      { nombre: 'decimales feos', pedido: { subtotal: 1234.56, cupon: 'VIP10', pais: 'ES', socio: true } },
      { nombre: 'subtotal cero', pedido: { subtotal: 0, cupon: 'VIP10', pais: 'ES', socio: true } },
    ] as const
    
    // CONGELADO: el caso 'decimales feos' devuelve un céntimo de menos por el
    // Math.floor de pricing.ts:412. Se arregla DESPUÉS del refactor, en un
    // commit propio. Ver LEG-14.
    describe('calcularPrecioFinal — caracterización', () => {
      it.each(CASOS)('$nombre', ({ pedido }) => {
        expect(calcularPrecioFinal(pedido)).toMatchSnapshot()
      })
    })
    

    Fíjate en lo que no hay: ningún valor esperado escrito a mano. El snapshot lo genera la primera ejecución. Tú no decides la salida correcta, la registras.

    El término viene de Working Effectively with Legacy Code (Michael Feathers, 2004), y en Vitest 5 lo implementas con toMatchSnapshot().

    Después abres el fichero de snapshots y lo lees entero. Ahí aparecen las sorpresas y ahí apuntas los // CONGELADO:. Cada uno es un ticket futuro, no una excusa para tocar nada ahora.

    Y sí, congelas el bug a propósito. Si arreglas comportamiento y estructura en el mismo commit, cuando algo falle en producción no sabrás cuál de las dos cosas lo rompió.

    Paso 3 — La spec brownfield

    Ahora, y solo ahora, escribes la spec. Con los tests en verde delante deja de ser un ejercicio de memoria, y las secciones que importan no son las de un proyecto nuevo:

    # Spec — Refactor de pricing
    
    ## Comportamiento observado
    Documentado en docs/legacy/pricing-observado.md.
    Congelado en pricing.characterization.test.ts (6 casos).
    
    ## Contrato público (NO cambia)
    calcularPrecioFinal(pedido: Pedido): Precio
    - Devuelve `total` en céntimos como number. No se migra a bigint en este refactor.
    - Nunca lanza: ante entrada inválida devuelve { total: 0, error: string }.
    
    ## Efectos secundarios actuales
    - Escribe en la tabla pricing_audit. SE MANTIENE.
    - Lee process.env.TAX_MODE en caliente. SE MANTIENE, se aísla en config.ts.
    - Muta el objeto `pedido` recibido. SE ELIMINA: ningún consumidor depende de
      ello, verificado en los 4 call sites.
    
    ## Deuda congelada a propósito
    - LEG-14: redondeo con Math.floor en la línea 412.
    - LEG-15: cupón caducado devuelve descuento 0 en vez de error.
    
    ## Fuera de alcance
    Modelo de datos, endpoints, UI de checkout, migración a bigint.
    
    ## Criterio de aceptación
    Los 6 tests de caracterización pasan sin modificar sus snapshots.
    El test de equivalencia legacy/refactor pasa en las 72 combinaciones.
    

    Es corta a propósito. Y es lo que le das al agente en cada task, no el fichero de 1.100 líneas.

    El formato completo lo tienes en el libro de Spec-Driven Development. Para el esqueleto uso el skill dominicode-sdd-creator, que genera spec.md + plan.md + tasks.md; el contenido brownfield lo pones tú, porque sale de los tests.

    Si dudas de cuánta ceremonia merece el módulo, el criterio está en los tres niveles de SDD. Un refactor de legacy con dinero de por medio es nivel alto, sin discusión.

    Paso 4 — Plan por fases, tasks pequeñas, un commit verde cada una

    El plan de un refactor brownfield tiene siempre la misma forma:

    1. Aislar. Extraer funciones puras sin cambiar la lógica. Copiar, no reescribir.
    2. Tipar los bordes. Con los tipos reales del paso 1, no los declarados.
    3. Sustituir por partes. La implementación nueva convive con la vieja mientras dure.
    4. Borrar el legacy. Cuando la equivalencia lleve dos semanas en verde.

    La fase 3 es la que necesita andamio. Copia el original a pricing.legacy.ts, deja pricing.ts para la implementación nueva, y este es todo el andamio:

    // pricing.equivalence.test.ts
    import { describe, it, expect } from 'vitest'
    import { calcularPrecioFinal as legacy } from '../src/pricing.legacy'
    import { calcularPrecioFinal as refactor } from '../src/pricing'
    
    const subtotales = [0, 9.99, 100, 1234.56]
    const cupones = [null, 'VIP10', 'OLD20']
    const paises = ['ES', 'US', 'DE']
    const socios = [true, false]
    
    describe('legacy vs refactor — equivalencia', () => {
      for (const subtotal of subtotales) {
        for (const cupon of cupones) {
          for (const pais of paises) {
            for (const socio of socios) {
              const pedido = { subtotal, cupon, pais, socio }
              it(`${subtotal} / ${cupon ?? 'sin cupon'} / ${pais} / socio=${socio}`, () => {
                expect(refactor(pedido)).toEqual(legacy(pedido))
              })
            }
          }
        }
      }
    })
    

    72 combinaciones que el agente ejecuta solo cada vez que cierra una task. Y ojo: si el test sale intermitente no tienes un problema de refactor, tienes un Date.now() o un Math.random() sin inyectar. Arréglalo antes de seguir.

    Regla de tamaño de task: si el diff no lo puedes leer entero en diez minutos, pártela. El límite no lo pone el agente, lo pone tu capacidad de revisar lo que produjo — que es el verdadero cuello de botella de trabajar con agentes.

    Paso 5 — Qué haces cuando un test se pone rojo

    Un test de caracterización en rojo tiene tres causas. Míralas en este orden.

    Uno: el refactor rompió algo. Nueve de cada diez veces, por mi experiencia. Revierte la task, no la parchees: el diff es pequeño precisamente para que revertir sea barato.

    Dos: el refactor arregló un bug sin querer. Pasa más de lo que parece y es una trampa. Revierte igual y arréglalo en su propio commit, con su snapshot actualizado. Un cambio de comportamiento colado dentro de un refactor pasa desapercibido en la review casi siempre.

    Tres: el test no era determinista. Fechas, aleatoriedad, orden de un Object.keys, zona horaria. Eso no es caracterización, es ruido. Arréglalo en el test o inyecta la dependencia.

    La regla que resume el paso 5 entero: un refactor nunca cambia comportamiento, y un cambio de comportamiento nunca se llama refactor. Commits distintos, PRs distintas, riesgos distintos.

    Este bucle es el mismo que aplico en TDD potenciado por IA, solo que en legacy los tests no los escribes para diseñar: los escribes para tener permiso a tocar.

    Cómo empezar a refactorizar legacy con Claude Code el lunes

    Coge el fichero que todo el mundo evita en tu repo. No lo refactorices. Haz solo esto, y no tardas más de una hora.

    Escribe en una línea qué entra y qué queda fuera. Lanza a Claude Code el prompt de arqueología del paso 1 en modo lectura. Y escribe cinco tests de caracterización con los casos que ya te sabes de memoria, porque son los que se rompen cada trimestre.

    El lunes no refactorizas nada. El martes ya puedes, y con red.

    Cuando quieras montar la verificación en serio — el AGENTS.md, los carriles del agente y los criterios que se comprueban solos — está en el ebook gratuito de Revisión por Contrato. Y el ciclo completo de idea a producto con Claude Code ejecutando tasks es el recorrido del curso Construye con IA.

    El código legacy no da miedo por antiguo. Da miedo porque no sabes qué hace. Y eso se arregla escribiendo tests, no reescribiendo código.

    Preguntas frecuentes

    ¿Qué es un test de caracterización y en qué se diferencia de un test unitario normal?

    Un test unitario afirma que el código hace lo correcto. Un test de caracterización afirma que sigue haciendo lo mismo que antes, sea correcto o no. No lo escribes a mano: ejecutas el módulo con entradas reales y registras la salida en un snapshot. Su único trabajo es ponerse rojo cuando el refactor cambia una salida observable.

    ¿Merece la pena congelar un comportamiento que sé que es un bug?

    Sí, siempre. Si arreglas el bug en el mismo commit en el que reestructuras el código y algo revienta en producción, no podrás distinguir cuál de las dos cosas lo rompió. Congélalo con un comentario que explique la sospecha y su ticket, y arréglalo después en un commit propio donde el cambio de snapshot sea la parte visible de la pull request.

    ¿Cuánto código legacy le puedo dar a Claude Code de una vez?

    Menos del que cabe. El límite útil no es la ventana de contexto, es lo que tú puedes verificar después. Yo trabajo módulo a módulo y en cada task le paso la spec brownfield y los tests, no el fichero original. Una vez documentado el comportamiento en el paso 1, ese documento sustituye al código fuente como contexto.

    ¿Puedo saltarme los tests de caracterización si el módulo ya está tipado con TypeScript estricto?

    No. Los tipos garantizan la forma del dato, no el valor. Un refactor que cambia Math.floor por Math.round, que invierte el orden de dos descuentos o que redondea antes en vez de después compila perfecto, pasa el type-check y factura mal. Los tipos protegen el contrato; los tests de caracterización protegen el comportamiento.

    ¿Y si el módulo legacy no se puede ejecutar de forma aislada?

    Entonces esa es tu primera task, y no es refactorizar. Si no puedes invocar la función sin levantar media aplicación, lo que falta es una costura: inyectar la base de datos, el reloj y las llamadas HTTP para poder ejecutarla con entradas controladas. Feathers lo llama seam. Hasta que no consigues ejecutar el módulo con entradas que tú decides, no hay tests de caracterización posibles ni refactor seguro.

    ¿Sirve este método si el módulo legacy no está en TypeScript?

    Sí, el orden no cambia. Lo único que necesitas es un runner con snapshots: pytest con syrupy en Python, ApprovalTests en Java o C#, o el propio Vitest si es JavaScript sin tipar. Lo que sí cambia es el paso de tipar los bordes: sin tipos estáticos pierdes la red del compilador y el peso recae entero sobre los tests de caracterización, así que conviene capturar más casos de los que capturarías en TypeScript.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cuándo usar vibe coding: la frontera exacta donde deja de servir

    Cuándo usar vibe coding: la frontera exacta donde deja de servir

    Hace unas semanas un amigo me enseñó una app que había montado en un fin de semana.

    Sin spec. Sin tests. Sin AGENTS.md. Sin una sola de las cosas que yo llevo un año contando por aquí. Prompt, ver qué sale, prompt otra vez. Puro vibe coding.

    Y funcionaba. Bien, además.

    Me tocó quedarme callado, que es una postura que recomiendo más a menudo de lo que se practica.

    Y me obligó a replantearme cuándo usar vibe coding y cuándo no, porque la respuesta que yo daba no explicaba lo que estaba viendo.

    Porque el problema de este debate es que casi siempre lo plantea alguien que necesita que el otro lado esté equivocado. Y no lo está. La gente que hace vibe coding y dice que le funciona no miente ni se engaña: le funciona de verdad. Lo que pasa es que no ha llegado todavía al sitio donde deja de funcionar, y ese sitio no está donde la mayoría cree.

    Así que vamos con las dos partes. Primero por qué tienen razón. Después dónde exactamente se acaba.

    Lo que el vibe coding acierta y ningún método te da

    Tres cosas, y las tres son reales.

    Cuando no sabes lo que quieres, escribir una especificación es adivinar. Es el fallo que más veo en la gente que se toma en serio lo de las specs: escribe cuarenta líneas de criterios de aceptación sobre un producto que todavía no ha visto funcionando. Eso no es rigor, es ficción con formato. Muchas veces la forma más rápida de saber qué quieres es tener algo delante y odiarlo.

    Casi todo lo que generas así está pensado para tirarse, y está bien. La ceremonia sobre código desechable es coste puro. Si vas a borrar la carpeta entera el lunes, todo lo que gastes en hacerla mantenible es dinero quemado. Ahí el vibe coding no es una versión relajada del método: es objetivamente la decisión correcta.

    Y la velocidad cambia qué problemas te atreves a atacar. Esto es lo que menos se dice y lo que más importa. Cuando probar una idea cuesta cuarenta minutos en vez de dos días, pruebas ideas que antes ni te planteabas. Eso no lo da ninguna metodología, y quien lo ha probado no va a volver atrás por un post. Yo tampoco volvería.

    Ojo, que velocidad de exploración y coste no son lo mismo: improvisar con un agente sobre algo que sí va a existir sale unas 7 veces más caro en turnos. Lo que el vibe coding abarata es descubrir qué quieres, no construirlo.

    Con lo cual, si tu argumento contra el vibe coding es "así no se hacen las cosas", no tienes un argumento. Tienes una preferencia estética.

    Qué es el vibe coding (y la mitad de la frase que se cortó)

    El vibe coding es generar código conversando con un modelo sin revisar lo que produce: describes lo que quieres, ejecutas el resultado y, si funciona, sigues sin leer el diff.

    El término lo acuñó Andrej Karpathy en febrero de 2025, en un tuit que ya es historia de esta profesión: "hay un nuevo tipo de programación que llamo vibe coding, en el que te entregas del todo a las vibras, abrazas las exponenciales y olvidas que el código existe" (en el original: "There's a new kind of coding I call 'vibe coding', where you fully give in to the vibes, embrace exponentials, and forget that the code even exists").

    Esa mitad la ha leído todo el mundo. La otra, que va unas líneas más abajo en el mismo mensaje, casi nadie:

    "It's not too bad for throwaway weekend projects, but still quite amusing."

    No está mal para proyectos desechables de fin de semana — y sigue teniendo su gracia.

    El término no llegó sin instrucciones de uso. Llegó con el rango de validez escrito al lado, en el mismo tuit. Lo que pasó después es que la industria se quedó con el eslogan y tiró la letra pequeña, que es lo que hace la industria con todo.

    Y hay una segunda parte, de octubre de 2025. Karpathy publicó nanochat, unas 8.000 líneas que cubren el pipeline entero de entrenar un modelo pequeño.

    Le preguntaron cuánto de ese código había escrito a mano y contestó que está "basically entirely hand-written (with tab autocomplete)". A mano, con autocompletado y poco más. Probó agentes de Claude y de Codex varias veces y su conclusión fue que no funcionaban lo bastante bien, posiblemente porque ese repositorio está demasiado lejos de la distribución de datos con la que se entrenaron.

    No es un arrepentimiento ni una retractación, y quien lo venda así te está vendiendo humo. Es un tipo que sabe en qué casilla está trabajando cada vez.

    Ahí está el matiz que se pierde en la discusión de siempre: el vibe coding no es una postura moral que adoptas y defiendes en Twitter. Es una técnica con un rango. El debate útil no es si es bueno o malo. Es dónde está el borde.

    Cuándo usar vibe coding: la frontera no la marca el tamaño

    Aquí es donde casi todo el mundo se equivoca de línea, yo el primero durante bastante tiempo.

    La frontera no es "prototipo contra producción", porque nadie sabe dónde está esa raya. Tampoco es el número de líneas, ni si tiene base de datos, ni si lo has desplegado. Todo eso son síntomas.

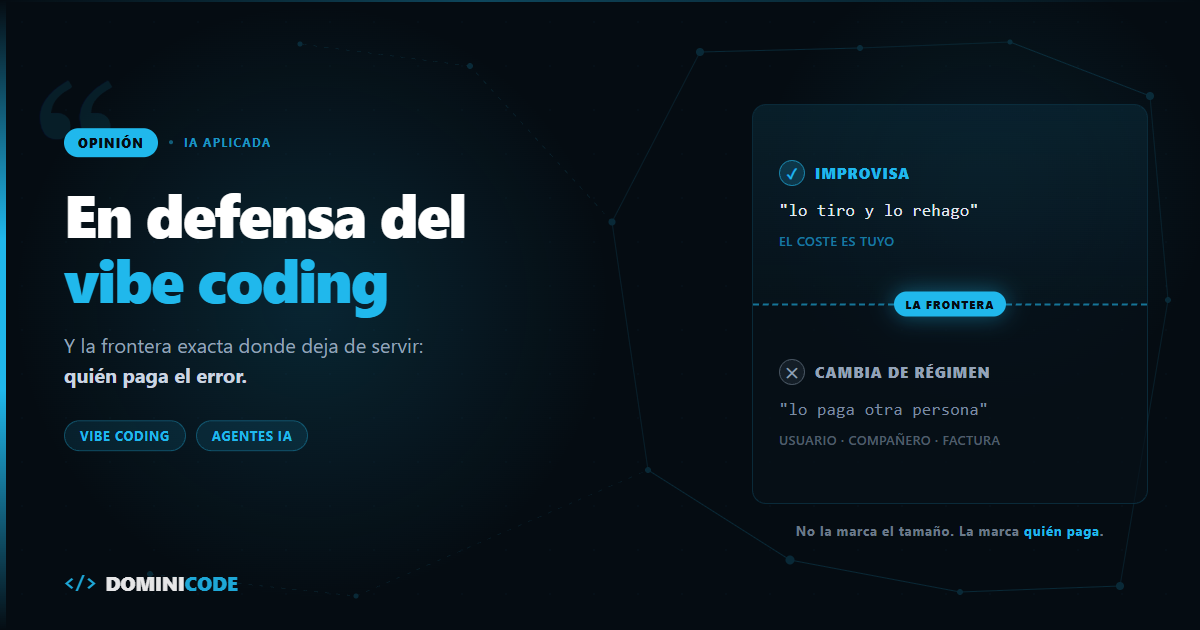
    La frontera es esta: quién paga el error.

    Situación ¿Quién paga el error? Régimen
    Prototipo que borras el lunes Tú Vibe coding puro, cero ceremonia
    Herramienta interna de un solo usuario Tú Vibe coding + carril mínimo
    Repo que va a mantener otra persona Tu compañero Contrato de 4 líneas + verificación
    Usuarios reales o datos que no puedes rehacer El usuario Verificación en cada cambio
    Migraciones, cobros, credenciales, borrados Todos Fuera del carril: nunca improvisado

    Mientras el peor caso posible sea "lo tiro y lo rehago", el vibe coding es la mejor herramienta que tienes y cualquier ceremonia que le añadas es coste. Improvisa todo lo que quieras. Yo lo hago.

    En el momento en que el peor caso incluye a otra persona — un usuario que pierde datos, un compañero que va a mantener esto el año que viene, una factura que sale mal, una tabla de la que ya no puedes hacer rollback — cambiaste de régimen. Aunque el código sea exactamente el mismo. Aunque lo hayas escrito igual de rápido.

    Lo que cambia no es la calidad del código. Es que el coste de descubrir un fallo dejó de ser tuyo.

    Y date cuenta de una cosa: esa frontera puede cruzarse el día 3 de un proyecto de cien líneas y no cruzarse nunca en uno de veinte mil. No tiene nada que ver con el tamaño.

    Por qué cruzas la frontera sin enterarte

    Ahora el problema de verdad, que no es el vibe coding.

    Es que nadie cruza esa frontera un martes por la mañana, conscientemente, diciendo "vale, esto ya es producción, voy a cambiar de forma de trabajar".

    Se cruza sola. Un amigo que lo prueba. Un dominio que compras porque ya que estás. El primer usuario que no eres tú. Un compañero que abre el repo para tocar una cosa pequeña. Ninguno de esos días parece nada.

    El vibe coding no es una decisión que tomas y revocas. Es un estado por defecto que se queda.

    El día 1 es una técnica excelente. El día 90 es una herencia, y la recibe alguien — muchas veces tú mismo, con el contexto ya evaporado.

    Lo peor es que el sistema no te avisa, porque no hay nada que avise. No se pone nada en rojo. No falla ningún comando, entre otras cosas porque no hay comandos.

    Todo sigue funcionando exactamente igual hasta el día que no, y ese día ya arrastras noventa jornadas de decisiones que nadie escribió en ningún sitio. Es el mecanismo exacto por el que un proyecto con IA se rompe sin que nadie lo decida: la arquitectura acaba pareciendo una Casa Winchester, con habitaciones que no llevan a ninguna parte, escaleras que dan al techo, y ni un solo día en el que alguien decidiera construirlas.

    "Ya, pero los modelos van a mejorar"

    Este es el argumento con el que se cierra el 90% de estas conversaciones, y es el más equivocado de todos.

    Un modelo mejor amplía el rango del vibe coding en tamaño, no en criticidad.

    Te va a dejar improvisar ocho mil líneas donde hoy improvisas ochocientas. No te va a decir cuáles de esas ocho mil son correctas, ni quién paga si una no lo es. La confianza no es un subproducto de la fluidez: son dos ejes distintos, y solo estamos avanzando por uno.

    De hecho, cuanto mejor es el modelo, más rápido cruzas la frontera sin enterarte — porque el resultado se parece cada vez más a algo terminado. Un prototipo que se ve regular te recuerda solo lo que es. Un prototipo impecable no te recuerda nada.

    Y si tu problema es raro, el modelo mejor tampoco te salva. Justo eso es lo que le pasó a Karpathy con nanochat: cuanto más lejos estás de lo que todo el mundo ha escrito ya, menos te ayudan los agentes. La media no cubre tu caso.

    Vibe coding vs Spec-Driven Development: lo que hacemos mal los del método

    Toca la parte incómoda para mí, porque el vibe coding no creció solo. Creció porque la alternativa se presentó fatal.

    Specs de cuarenta páginas para un CRUD. Plantillas con doce secciones obligatorias. Gente pidiendo un documento de diseño para cambiar el color de un botón. Si tu método le impone eso a alguien que quiere probar una idea un sábado, esa persona vuelve al vibe coding y hace bien.

    El peso del método tiene que ser proporcional al coste del error, no al tamaño del código. Un contrato de cuatro líneas para algo que toca dinero. Cero líneas para algo que vas a borrar el lunes. Todo lo demás, en medio. Ese criterio —cuánto método aplicar y dónde— es la mitad del libro de Spec-Driven Development.

    Cuando alguien te dice que el Spec-Driven Development es lento, casi siempre está describiendo con precisión el SDD mal aplicado, que efectivamente lo es. Yo mismo tengo escritos los seis casos en los que no compensa aplicarlo, y no es un gesto de falsa modestia: es que un método que no dice dónde no sirve es una religión.

    La propuesta: no dejes de vibe codear

    No te voy a pedir que cambies tu forma de trabajar. Va a sonar raro viniendo de mí, pero es que no hace falta.

    Sigue improvisando. Sigue sin escribir la spec cuando no sabes lo que quieres. Lo único que te pido es que le pongas al proyecto dos cosas que se ejecutan solas y que tardan una tarde en existir:

    Un carril — cuatro líneas diciendo qué no se toca: migraciones, despliegue, dependencias, credenciales. Y un veredicto — los comandos que ya tienes hoy, aunque solo sean el build y el type checker, puestos en un sitio donde el agente los ejecute después de cada cambio.

    Así de literal es. Nueve líneas en AGENTS.md:

    ## No se toca sin permiso
    - Migraciones y esquema de base de datos
    - Configuración de despliegue
    - Dependencias nuevas
    - Credenciales y variables de entorno
    
    ## Verificación después de cada cambio
    - `npm run build`
    - `npx tsc --noEmit`
    

    Improvisa todo lo que quieras dentro de ese carril. Eso sigue siendo vibe coding, con la misma velocidad y la misma libertad. La única diferencia es quién se entera de que cruzaste la línea: ahora es el sistema, no tú a las tres de la mañana de un martes.

    Eso es lo que llamo Revisión por Contrato, y no es lo contrario del vibe coding. Es lo que le permite durar más de un fin de semana.

    La pregunta que cierra el debate

    Cuando termines lo próximo que generes, hazte esta:

    Si esto falla el martes a las tres de la mañana, ¿quién se entera y quién lo paga?

    Si la respuesta es "yo, y lo tiro", cierra este post y vibe codea tranquilo. Lo digo en serio: estás usando la herramienta correcta y cualquiera que te diga lo contrario te está vendiendo algo.

    Si la respuesta incluye a alguien que no eres tú, entonces ya no estás haciendo vibe coding. Estás haciendo producción sin verificación y llamándolo vibe coding, que es una cosa bastante distinta y con muchísima peor prensa.

    Y a partir de ahí ya no discutimos de metodología. Discutimos de cómo se llaman las cosas.

    Si quieres el carril y el veredicto montados, sin escribirlos desde cero, están enteros en el ebook gratuito de Revisión por Contrato — treinta páginas y ningún coste. Y si lo que te interesa es ver dónde termina exactamente la improvisación y empieza el método sobre un proyecto real, ese es el recorrido de Construye con IA: de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Cuándo usar vibe coding y cuándo no?

    Úsalo mientras el peor caso posible de un fallo sea "lo tiro y lo rehago". Prototipos, pruebas de concepto, herramientas internas de un solo usuario, cualquier cosa que vayas a borrar. Deja de usarlo tal cual en el momento en que el coste de un error lo pague otra persona: un usuario, un cliente, o el compañero que herede el repositorio. La frontera no la marca el número de líneas ni si está desplegado, sino quién paga el fallo.

    ¿El vibe coding sirve para producción?

    No como técnica única. Puedes seguir generando código de forma improvisada en producción siempre que el proyecto tenga dos cosas que no dependan de ti: límites declarados sobre lo que el agente no toca y comandos de verificación que se ejecuten en cada cambio. Sin eso, lo que tienes no es vibe coding en producción, es producción sin verificación.

    ¿Karpathy dijo que el vibe coding era solo para proyectos desechables?

    En el tuit original de febrero de 2025 donde acuñó el término escribió que "no está mal para proyectos desechables de fin de semana". Nunca lo presentó como un método general de desarrollo. Además, cuando publicó nanochat en octubre de 2025 —unas 8.000 líneas de código de entrenamiento de modelos— explicó que estaba escrito prácticamente a mano y que los agentes que probó no le resultaron útiles en ese repositorio, posiblemente por estar demasiado fuera de la distribución de datos habitual.

    ¿No arreglarán esto los modelos cuando sean mejores?

    Un modelo mejor amplía cuánto código puedes improvisar, no cuánta confianza tienes en él. Son dos ejes distintos. De hecho, cuanto mejor es el resultado, más fácil es cruzar sin enterarte la línea entre prototipo y sistema del que depende alguien, porque un prototipo impecable ya no se parece a un prototipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • SDLC context engineering: arregla el ciclo, no el prompt

    SDLC context engineering: arregla el ciclo, no el prompt

    El mismo agente. El mismo modelo. Prácticamente el mismo prompt.

    En uno de mis repositorios la tarea salió a la primera. En el otro, el agente se inventó un helper que no existía y escribió los tests con una librería que ese proyecto abandonó hace más de un año.

    No falló el modelo. Falló todo lo que había alrededor del modelo.

    Y eso que hay alrededor tiene nombre: SDLC context engineering. Tu ciclo de desarrollo es la fábrica del contexto que consume el agente, y si la fábrica va mal, da igual cómo escribas el prompt.

    El primer repositorio tiene un CLAUDE.md con las convenciones escritas, una carpeta de decisiones de arquitectura y un índice del contenido previo que el agente puede consultar. El segundo tiene un README viejo y el resto vive en mi cabeza.

    Y ahí está el problema: cuando el contexto vive en tu cabeza, el agente tiene que adivinarlo. Adivinar, en un modelo de lenguaje, se llama alucinar.

    Por eso llevo meses insistiendo en lo mismo: el prompt no es la unidad de contexto. Puedes escribir el prompt más elaborado del mundo, con sus tres adjetivos y su frase en mayúsculas, que si la información que necesita el agente no existe en ningún sitio legible, no va a aparecer porque tú se lo pidas con más énfasis.

    El contexto no se escribe en el prompt. Se fabrica antes, en tu ciclo de desarrollo.

    Opero Dominicode solo: cursos, libros, una plataforma y un canal. No tengo un equipo que rellene los huecos por mí, así que los huecos los tengo que cerrar en el proceso. De ahí sale la idea que más ha cambiado mi forma de trabajar en el último año:

    Tu SDLC no es un proceso para humanos. Es la cadena de montaje que fabrica el contexto que consumen tus agentes.


    Qué es el SDLC context engineering

    El SDLC context engineering es tratar tu ciclo de vida del software como el sistema que fabrica el contexto que consumen tus agentes de IA.

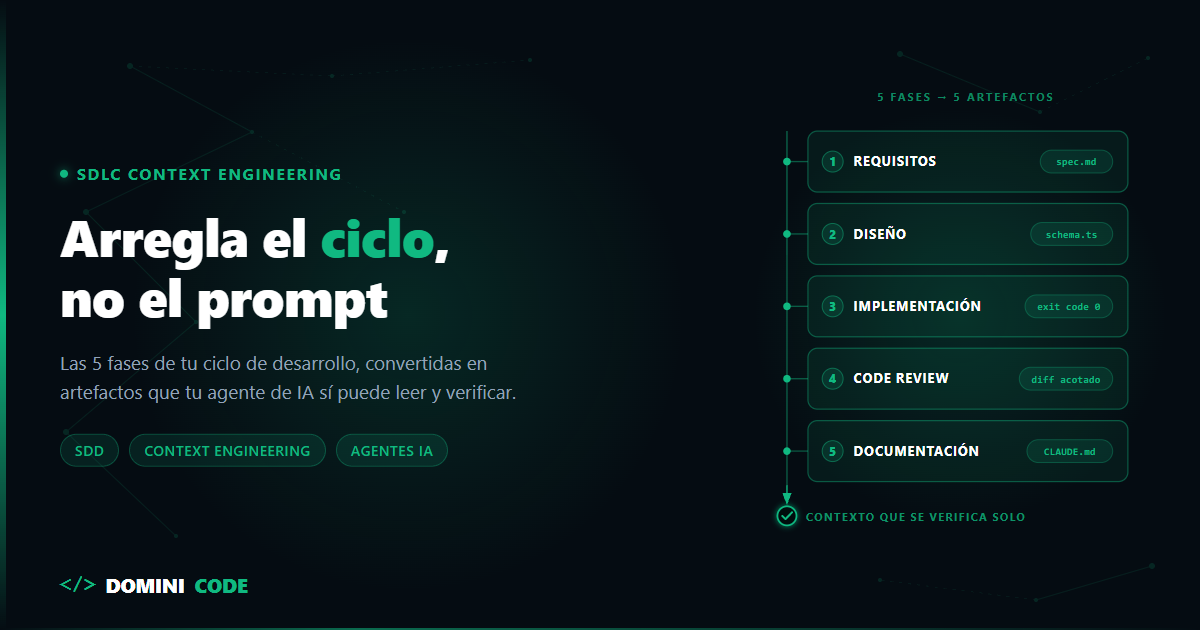
    Cada una de las cinco fases —requisitos, diseño, implementación, code review y documentación— deja de producir artefactos para humanos y pasa a producir artefactos que una máquina puede leer, verificar y ejecutar: una spec con límites, un esquema de validación, una suite de tests como gate, un diff acotado y contexto versionado en el repositorio.

    La diferencia con el prompt engineering es de capa. El prompt engineering optimiza la instrucción de un turno. El SDLC context engineering optimiza la información que esa instrucción tiene disponible, y esa información la produce tu proceso, no tú en el momento de escribir.


    Qué cambia cuando el que lee el proceso es una máquina

    Cuando el que lee tu proceso es una máquina cambia el destinatario de cada artefacto: deja de valer lo que un humano completa con conocimiento implícito y solo cuenta lo que cabe en la ventana de contexto.

    El ciclo de vida clásico producía artefactos para personas: un ticket de tres líneas, la foto de una pizarra, un hilo de Slack, una reunión de refinamiento.

    Todo eso funciona con humanos por una razón que casi nunca decimos en voz alta: una persona rellena los huecos con conocimiento implícito. Sabe que en este proyecto los servicios van en esa carpeta. Sabe que ese campo del modelo está deprecado aunque siga ahí. Y, sobre todo, sabe a quién preguntar cuando algo no cuadra.

    Un agente no tiene a quién preguntar. Solo tiene lo que le entre por la ventana de contexto.

    Así que cada fase de tu ciclo tiene dos versiones posibles: la que produce algo para un humano y la que produce algo que una máquina puede leer, verificar y ejecutar.

    # Fase del ciclo Artefacto para humanos Artefacto para agentes
    1 Requisitos Ticket de 3 líneas spec.md con límites explícitos
    2 Diseño Diagrama en una pizarra Contratos ejecutables que validan
    3 Implementación "En mi máquina funciona" Tests como gate de salida
    4 Code review "A mí me parece bien" Diff acotado + auditor automático
    5 Documentación Wiki de hace tres años Contexto versionado en el repositorio

    La columna de la derecha es tu context engineering. No es un documento aparte que escribes el viernes por la tarde: es el residuo natural de un ciclo bien montado.

    Vamos fase por fase.


    1. Requisitos: del ticket de tres líneas al spec.md

    Qué falla: un ticket ambiguo no le da al agente lo único que de verdad necesita. Y no es la descripción de la funcionalidad: son los límites.

    Esta es la frase que más repito y la que más discusión genera: el alcance no es lo que el agente tiene que hacer, es lo que el agente no puede tocar.

    Un agente al que le pides "añade validación al formulario de registro" y no le dices nada más, se expande. Toca el modelo de datos porque le pareció que hacía falta. Refactoriza el componente de al lado porque estaba feo. Añade una dependencia. Y cuando abres el diff, tienes once archivos modificados y ninguna forma rápida de saber cuáles querías.

    Una spec no necesita ser larga. Una página con cuatro bloques:

    • Contratos de datos. La forma exacta de lo que entra y lo que sale.
    • Archivos afectados. Las rutas concretas que se pueden tocar.
    • Fuera de alcance. Lo que no se toca, escrito explícitamente.
    • Criterio de terminado. Qué comando tiene que pasar en verde.

    Con esos cuatro bloques, una spec entera te cabe en la pantalla:

    # Spec — Validación del formulario de registro
    
    ## Contratos
    - Entrada: { email: string, password: string, acceptedTerms: boolean }
    - Salida: { ok: true } | { ok: false, errors: FieldError[] }
    
    ## Archivos afectados
    - src/features/auth/register-form.tsx
    - src/features/auth/register.schema.ts
    
    ## Fuera de alcance
    - No tocar el modelo de usuario ni las migraciones
    - No añadir dependencias nuevas
    - No refactorizar componentes vecinos
    
    ## Terminado cuando
    - `bun test src/features/auth` pasa en verde
    - `tsc --noEmit` sin errores
    

    Ese tercer bloque es el que mejor retorno da de todo el documento, y es el que casi nunca veo escrito.

    Improvisar aquí no sale gratis, y el coste se puede calcular turno a turno: lo hice en la factura del vibe coding. Si tus specs ya existen pero el agente sigue desviándose, el problema suele estar en uno de estos 7 fallos. Y si quieres saber hasta dónde llevar el enfoque, están los tres niveles de Spec-Driven Development.

    La metodología completa, con las plantillas que uso a diario, está en el libro de Spec-Driven Development.


    2. Diseño: del diagrama en la pizarra a contratos ejecutables

    Qué falla: si la forma de tus datos vive dispersa por el código, el agente inventa propiedades. Y las inventa con una seguridad absoluta, porque estadísticamente user.email es un campo muy razonable aunque en tu proyecto se llame user.contactAddress.

    La solución no es documentar los tipos en un wiki. Es que la definición y la verificación sean el mismo artefacto.

    Un esquema de validación —Zod 4 en el ecosistema TypeScript, pero el principio vale para cualquier stack— hace tres cosas a la vez:

    • Describe la forma de los datos en un sitio único y localizable.
    • La comprueba en ejecución, así que si la descripción miente, algo se rompe y te enteras.
    • Genera el tipo con z.infer, así que la definición y la verificación salen del mismo artefacto y se actualizan a la vez.

    Esa segunda parte es la que lo convierte en contexto fiable. Un diagrama puede quedarse obsoleto en silencio durante dos años. Un esquema que se ejecuta, no: cuando un campo obligatorio cambia de tipo o desaparece, revienta y te enteras.

    Con un matiz que conviene saber, porque es donde la gente se confía: por defecto z.object() descarta las claves que no conoce en lugar de fallar. Si la API empieza a devolver campos nuevos, tu esquema los tira sin decir nada. Para que esa deriva también haga ruido necesitas z.strictObject(). El esquema te protege del campo que falta; del campo que sobra, solo si se lo pides.

    Y no confundas una cosa con la otra: los tipos de TypeScript desaparecen al compilar y no validan nada en ejecución. Evitan bugs antes de desplegar, que no es poco, pero el que comprueba lo que entra de verdad por la API es el esquema.

    Estos patrones —esquemas como contrato, inferencia de tipos y validación en los bordes— son los que desarrollo en el curso de Zod para TypeScript.

    La otra mitad del diseño es el acceso. En vez de pegar el esquema de tu base de datos dentro del prompt cada mañana, expones la fuente y dejas que el agente la consulte cuando la necesite. Eso es lo que resuelven los servidores de Model Context Protocol: el contexto deja de ser algo que copias y pasa a ser algo que se consulta.

    Eso sí, cada servidor que conectas mete sus definiciones de herramientas en la ventana. MCP cambia copiar por consultar, no elimina el coste de contexto: conecta los que uses, no los que tengas.


    3. Implementación: del "en mi máquina funciona" al gate de salida

    Qué falla: preguntarle al agente si ha terminado.

    Te va a decir que sí. No porque mienta, sino porque no tiene forma de saberlo: está evaluando su propio trabajo con exactamente el mismo contexto con el que lo escribió. Si le faltaba una pieza para escribirlo bien, le sigue faltando para revisarlo.

    Necesitas una señal que venga de fuera del modelo. Y la señal más barata que existe es un código de salida.

    El bucle que uso:

    1. El agente escribe primero el test que falla.
    2. Escribe el código mínimo para que pase.
    3. El pipeline ejecuta tipado, tests y lint. Si sale 0, la tarea entra en la cola de revisión. Si no, el agente recibe el error y corrige sin que yo intervenga.

    El gate no tiene que ser un pipeline entero. Un script que encadene los tres comandos ya sirve: si devuelve 0, la tarea pasa; si no, el agente recibe el error y sigue solo.

    {
      "scripts": {
        "gate": "tsc --noEmit && bun test && bun run lint"
      }
    }
    

    Lo importante no es que sea TDD de manual. Es que la condición de parada la decide un proceso externo y no una frase del agente. Mientras la puerta de calidad seas tú leyendo la terminal, no has automatizado nada: solo has cambiado de sitio el cuello de botella.

    El flujo completo de validar código generado antes de mergear lo desarrollé en TDD con IA. Y si lo que quieres es probar al propio agente en CI —no solo al código que produce— eso es un test harness, que es una pieza distinta.

    Y ojo con el nivel de la suite, porque aquí hay un efecto perverso: unos tests flojos no son neutros. Le dan al agente permiso para dar por terminado un trabajo a medias, con la ventaja de que ahora el sello de aprobado es automático.


    4. Code review: del "a mí me parece bien" al diff acotado

    Qué falla: el volumen. Un agente produce en veinte minutos más código del que puedes revisar con atención en una tarde.

    Y aquí hay una trampa que cuesta ver: la calidad de tu code review se decide en la fase 1, no en la fase 4. Un diff de once archivos es muy difícil de auditar bien, y la razón por la que toca once archivos es que la spec no dijo cuáles no tocar. Cuando el alcance está escrito, el diff sale acotado solo, y revisarlo pasa de ser una tarde a ser un rato.

    Con el diff ya acotado, la revisión se reparte en dos filtros:

    • El automático, primero. Tipado, tests, lint y un auditor que mire el diff antes que tú. Lo que no pasa esos gates no llega a tus ojos. Cómo montarlo en el pipeline lo detallé en revisiones de código con IA en CI/CD.
    • El tuyo, después, y solo para lo que la máquina no puede ver. Que la abstracción elegida sea la correcta. Que no haya duplicado algo que ya existía. Que el error se maneje donde tiene sentido y no donde resultaba cómodo.

    Esa segunda lista es más larga de lo que parece, y hay fallos del código generado por IA que un code review directamente no ve. Los tests cubren la corrección. Tú cubres el criterio.

    El checklist que uso para auditar diffs generados por IA antes de mergear está en el ebook gratuito Revisión por Contrato.


    5. Documentación: del wiki muerto al contexto versionado

    Qué falla: guardar la arquitectura en herramientas que el agente no puede abrir.

    El contexto tiene que vivir en el repositorio, al lado del código y bajo control de versiones, en cuatro capas de artefactos de contexto para agentes que hacen cosas distintas:

    • CLAUDE.md o AGENTS.md en la raíz. Convenciones, comandos de build, qué no se toca. AGENTS.md es un formato abierto supervisado por la Agentic AI Foundation, bajo la Linux Foundation, y lo usan ya más de 60.000 proyectos open source. Es lo primero que lee el agente al arrancar y lo que evita la mayoría de los "esto no va aquí".
    • docs/adr/ con decisiones de arquitectura. Markdown ligero que explica por qué se decidió algo, no solo qué se decidió. Sin el porqué, el agente deshace tus decisiones creyendo que mejora el código.
    • Un índice consultable del conocimiento previo. Para que pueda buscar en lo que ya existe sin que le metas el proyecto entero en la ventana.
    • Un mapa de dependencias del repositorio. Qué depende de qué. Es la diferencia entre un agente que cambia una función y otro que sabe qué se rompe al cambiarla, y va de graph engineering.

    Con una advertencia importante, porque es el error clásico de quien descubre esto: más contexto no es mejor contexto. Llenar la ventana de documentación irrelevante degrada las respuestas igual que no tener nada, solo que gastando más. Cómo estructurar esa memoria para que sume está en context engineering aplicado a agentes, y qué pasa cuando la conversación se alarga demasiado, en context drift.


    La regla del eslabón más débil de tu SDLC

    La regla del eslabón más débil dice que tu ciclo rinde lo que rinda su fase peor: da igual lo bien que hagas las otras cuatro, el resultado del agente lo marca la fase rota.

    Por eso esta es la parte práctica, la que decide por dónde empezar mañana:

    • Specs impecables sin gate de tests: el agente escribe muy rápido algo que nadie valida.
    • Tests excelentes con tickets ambiguos: validas a la perfección la funcionalidad equivocada.
    • Todo bien montado y el conocimiento en tu cabeza: cada mañana empiezas de cero.

    Así que no empieces por la fase que más te apetece, que suele ser la que ya haces bien. Empieza por la que te está costando dinero ahora mismo. Este diagnóstico lo resuelve en un minuto:

    Lo que te pasa con el agente Fase que tienes rota
    Se sale del alcance y toca archivos que no debía 1. Requisitos
    Inventa campos, funciones o rutas que no existen 2. Diseño
    Dice que ha terminado y no funciona 3. Implementación
    Los diffs son tan grandes que no los revisas 4. Code review
    Repite errores que ya corregiste la semana pasada 5. Documentación

    Ese último síntoma es el más frecuente y el que más gente confunde con un problema de memoria del modelo. No lo es. Es que la corrección se quedó en el chat en vez de acabar en un archivo del repositorio.


    Lo que no debes hacer

    Documentarlo todo.

    Es la reacción típica cuando alguien entiende esta idea: se pasa un fin de semana escribiendo un CLAUDE.md de cuarenta secciones y una carpeta de ADRs preciosa. Tres meses después, la mitad ya no es verdad.

    Y contexto desactualizado es peor que no tener contexto, porque el agente lo obedece. Un archivo que dice que los servicios van en una carpeta que ya no existe no es un documento inútil: es una instrucción activa para hacerlo mal.

    La regla que aplico: si no lo vas a mantener, no lo escribas. Es preferible un archivo de quince líneas verdaderas que uno de doscientas donde no sabes cuáles siguen siéndolo.

    Tampoco todo proyecto necesita este aparato montado. Hay casos concretos en los que el enfoque de spec te frena, y conviene reconocerlos antes de meter ceremonia donde no hace falta.


    Los 3 cambios para tu próximo ticket

    No hace falta rehacer la metodología de tu equipo. En la próxima tarea que delegues:

    1. Escribe el "fuera de alcance". Una línea diciendo qué archivos no debe tocar el agente. Es el cambio con mejor retorno de esta lista.
    2. Pon un gate automático. Aunque sea solo tsc --noEmit y los tests. Que la respuesta a "¿ha terminado?" la dé un código de salida y no una frase.
    3. Mueve una convención de tu cabeza al repositorio. Una. La que más veces has tenido que repetirle al agente esta semana.

    Con esos tres, el siguiente prompt que escribas tiene muchas más probabilidades de salir a la primera sin que le cambies ni una palabra. Porque no habrás mejorado el prompt: habrás mejorado la fábrica que lo alimenta. Eso es SDLC context engineering.

    El flujo completo, de la idea al producto con herramientas agénticas, lo enseño paso a paso en el curso Construye con IA con Claude Code.

    Y si quieres ver los artefactos reales —specs, gates y archivos de contexto de proyectos que están en producción— eso es lo que compartimos cada semana en Dominicode Labs.

    Deja de buscar el prompt mágico. Arregla la fase que tienes rota y el contexto se arregla solo.


    Preguntas frecuentes

    ¿Qué es exactamente el SDLC context engineering?

    Es tratar tu ciclo de vida del software como el sistema que fabrica el contexto de tus agentes de IA. En lugar de escribir prompts cada vez más largos, haces que cada fase del ciclo —requisitos, diseño, implementación, revisión y documentación— deje un artefacto que una máquina pueda leer y verificar: una spec con límites, un esquema de validación, una suite de tests, un diff acotado y contexto versionado en el repositorio.

    ¿Esto no es lo mismo que el prompt engineering?

    No, y la diferencia es de escala. El prompt engineering trabaja sobre la instrucción concreta que escribes en un turno. El context engineering trabaja sobre la información que esa instrucción tiene disponible, y esa información la produce tu proceso, no tú en el momento de escribir. Un buen prompt sobre un ciclo roto sigue dando resultados malos, solo que con mejor redacción.

    ¿Por dónde empiezo si tengo las cinco fases mal?

    Por el síntoma que estés sufriendo ahora, no por el orden numérico. Si el agente se sale del alcance, empieza por la spec. Si inventa campos que no existen, por los contratos de datos. Si dice que ha terminado y no funciona, por el gate de tests. La cadena rinde lo que rinda su fase peor, así que arreglar la que más te está costando da más retorno que mejorar la que ya funciona.

    ¿Hace falta usar Spec-Driven Development para esto?

    No es obligatorio, pero la fase de requisitos es la que más impacto tiene sobre las otras cuatro, y SDD es la forma más ordenada de resolverla. Puedes empezar con algo mucho más ligero: una línea de "fuera de alcance" en el ticket ya cambia el comportamiento del agente. Y hay casos concretos en los que el enfoque de spec te frena en vez de ayudarte, así que conviene reconocerlos antes de montar ceremonia.

    ¿Cuánto contexto es demasiado contexto?

    El que no puedas mantener actualizado. Un archivo de contexto que ya no refleja la realidad no es neutro: el agente lo obedece y hace las cosas mal con total seguridad. La medida correcta no es cuántas páginas tienes, sino cuántas líneas puedes garantizar que siguen siendo ciertas hoy. Además, llenar la ventana de contexto irrelevante degrada las respuestas y encarece cada turno.

    ¿Qué documentación para agentes de IA hace falta de verdad en un repositorio?

    Cuatro capas y nada más: un CLAUDE.md o AGENTS.md en la raíz con convenciones y comandos, una carpeta docs/adr/ con el porqué de las decisiones de arquitectura, un índice consultable del conocimiento previo y un mapa de dependencias del repositorio. Todo versionado junto al código. Lo que no esté en el repositorio, el agente no lo puede abrir.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Programar con IA: el cuello de botella es verificar, no escribir

    Programar con IA: el cuello de botella es verificar, no escribir

    Hace un año le pedía una feature al agente y me devolvía doscientas líneas.

    Hoy me devuelve ochocientas, y tarda menos.

    Mi ritmo de entrega es exactamente el mismo.

    El cuello de botella dejó de ser escribir código. Ahora es verificarlo — y eso lo sigo haciendo yo, a mano.

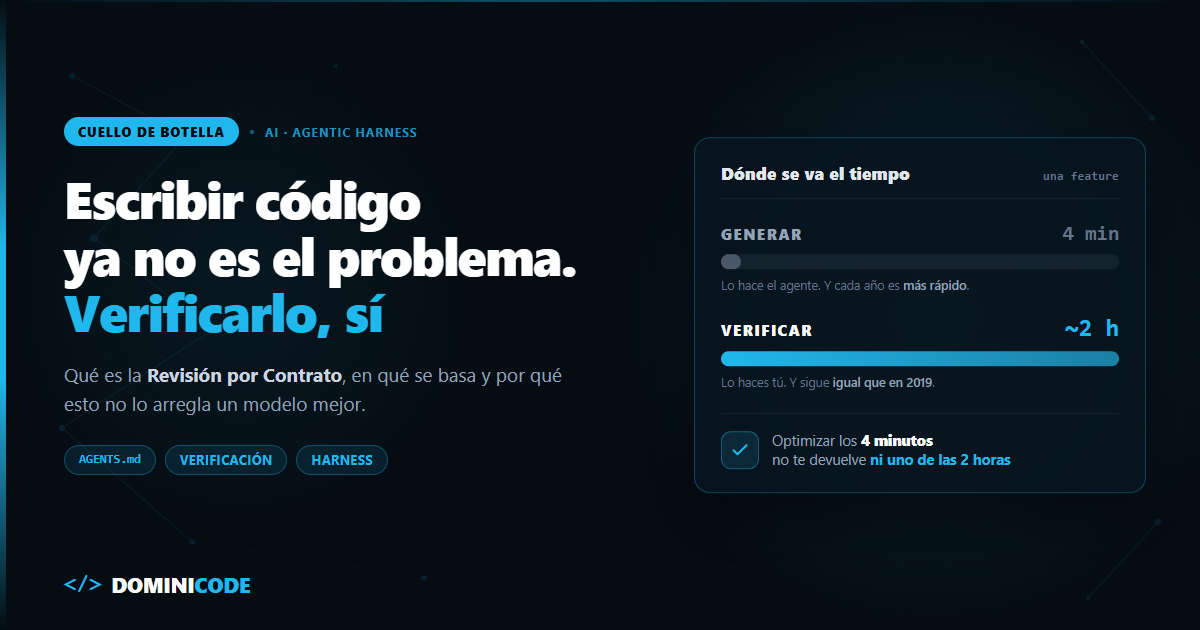
    Durante meses lo achaqué a cosas mías: mala semana, tarea rara, repo complicado. Hasta que hice el cálculo aburrido de cuánto tiempo pasaba generando y cuánto verificando código generado por IA. Generar: cuatro minutos. Verificar: casi dos horas.

    Cuadruplicar la velocidad de los cuatro minutos no me iba a devolver ni un minuto de las dos horas.

    Goldratt lo dejó escrito en La Meta, en 1984, y sigue siendo la frase más útil que conozco para esto: una hora ganada donde no está el cuello de botella es un espejismo. Toda la industria lleva tres años ganando horas justo ahí.

    El cuello de botella se movió y nadie avisó

    El cuello de botella del desarrollo con IA se movió de escribir código a verificarlo. Los datos van en la misma dirección que la anécdota.

    El informe DORA de 2024 midió algo que a mucha gente le sentó fatal: por cada 25% de aumento en la adopción de IA en una organización, el throughput de entrega bajaba un 1,5% estimado y la estabilidad un 7,2%. Más código, menos entrega, y bastante menos tranquilidad.

    Lo interesante es lo que pasó después. En la edición de 2025 el throughput ya sale positivo: aprendimos a mover el código generado hasta producción sin atascarnos tanto. Pero la relación con la estabilidad sigue siendo negativa.

    Traducido: arreglamos la velocidad. No arreglamos la confianza.

    Y no es raro, porque entre el código que sale del agente y producción hay un paso que no ha mejorado nada en tres años: alguien tiene que decidir si eso es correcto. Ese alguien eres tú, con el mismo cerebro de 2019 y menos horas de sueño.

    Es el único componente del sistema que no escala, y es el que recibe todo lo que los demás producen más rápido.

    Por eso un modelo mejor no lo arregla. Un modelo mejor te da código correcto más a menudo — te sube el porcentaje de aciertos, no te quita la obligación de comprobar. Y como no sabes de antemano cuál de las ochocientas líneas es la que falla, sigues teniendo que mirarlas todas.

    Un modelo con un 97% de acierto sobre ochocientas líneas te deja veinticuatro líneas malas escondidas y ninguna pista de dónde.

    Qué es la Revisión por Contrato

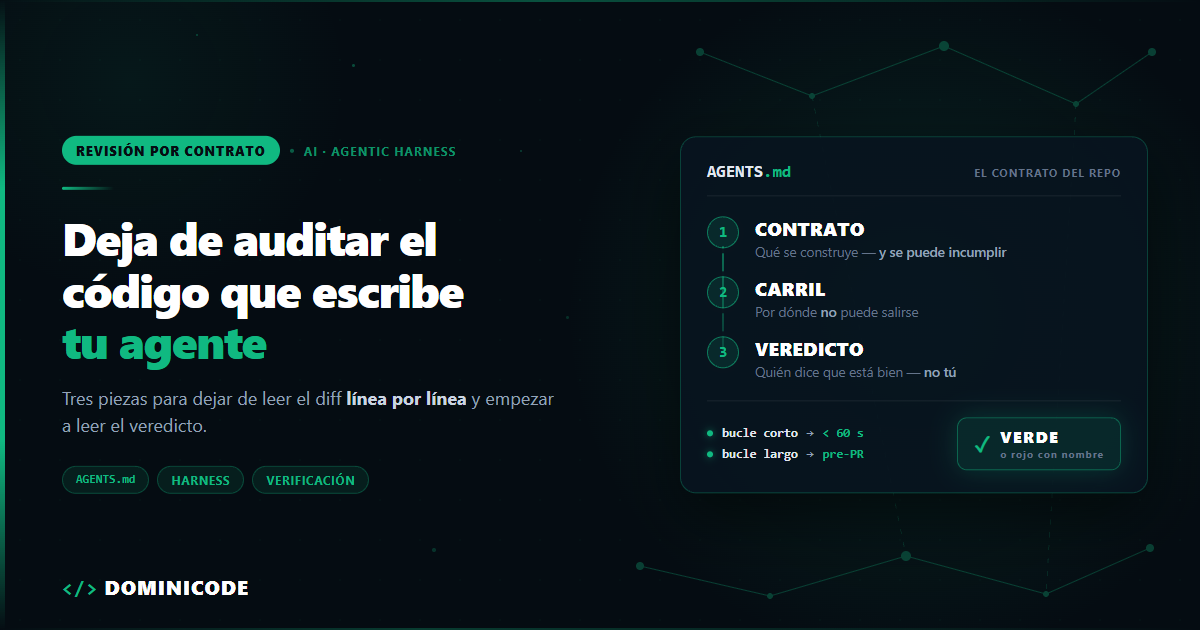
    Revisión por Contrato es un método para verificar código generado por IA sin leerlo entero, moviendo la verificación de tu cabeza a procesos que se ejecutan solos. Son tres piezas, en este orden:

    Contrato. Lo que se construye, escrito de forma que una máquina pueda rechazarlo. No "el endpoint debe ser rápido", sino "p95 por debajo de 200 ms en el test de carga del CI". Vive en dos sitios: el AGENTS.md para lo permanente del repositorio, la spec para lo que nace y muere con esta tarea.

    Carril. Por dónde el agente no puede salirse. Qué ficheros no toca, qué no instala, qué asserts existentes no modifica. Porque la mayoría de los desastres de un agente no son de lógica: son de alcance.

    Veredicto. Quién dice que está bien. Un conjunto de comandos con dos estados posibles y ninguno más: build, tipos, lint, tests y — la que casi nadie tiene — un comando detrás de cada criterio de aceptación.

    Pieza Qué declara Quién la hace cumplir
    Contrato Lo que se construye, en cláusulas que una máquina puede rechazar AGENTS.md para lo permanente del repo + la spec de la tarea
    Carril Por dónde el agente no puede salirse: qué no toca, qué no instala, qué asserts no modifica Límites de escritura declarados por escrito
    Veredicto Si está bien o no, en dos estados y ninguno más El harness de verificación: build, tipos, lint, tests y un comando por criterio de aceptación

    Lo que revisas después no es el diff. Es el veredicto y el contrato.

    Cómo se monta cada pieza, con el AGENTS.md entero y los dos bucles de verificación, lo tengo desarrollado en el post del método. Aquí me interesa lo otro: por qué esto funciona.

    En qué se basa el método para verificar código generado por IA

    Nada de esto lo he inventado yo. Son tres ideas viejas que la IA no rompió, solo hizo urgentes.

    1. Una especificación que no puede fallar es un comentario

    En 1986 Bertrand Meyer metió los contratos dentro del lenguaje Eiffel: precondiciones, postcondiciones, invariantes. La idea era que la especificación de una función dejara de vivir en un documento y pasara a vivir en el código, con una propiedad nueva — que el programa revienta cuando se incumple.

    Esa es la línea que separa documentar de obligar. La misma que ya conoces entre un README que pide formatear antes de commitear y un hook que no te deja commitear sin formatear.

    Tu spec para el agente está casi entera del lado equivocado de esa línea. Coge la última que escribiste y cuenta cuántas de sus líneas podría rechazar una máquina. Suelen ser tres de veinte. Las otras diecisiete son intenciones: orientan al modelo, no rechazan nada, y por eso tu spec no te frenó ni un bug.

    Un contrato no es una spec mejor escrita. Es una spec que puede decir que no.

    Esa conversión —coger tu spec y pasar sus líneas a cláusulas que se pueden incumplir— la tienes entera en el ebook gratuito de Revisión por Contrato, con el código puesto para que lo copies.

    2. Quien produce no puede ser quien juzga

    En cualquier oficio donde el resultado importa, esto es tan obvio que ni se discute. El que lleva las cuentas no es el que las audita. El que escribe el paper no es quien lo revisa.

    En tu repo lleva meses pasando lo contrario y no lo has mirado: el agente tiene permiso de escritura sobre la cosa que lo verifica.

    Los tests son ficheros. El linter se configura con un fichero. El workflow de CI es un fichero. Todo está dentro de su radio de acción. Y cuando le pides que los tests pasen, tocar el assert es un camino perfectamente válido hacia lo que pediste — más corto que arreglar el código, de hecho.

    No hace trampas. Cumple el objetivo por la ruta más barata, que es exactamente para lo que está optimizado.

    Si el verificado puede editar al verificador, no tienes verificación. Tienes teatro. Y de ahí sale el carril, que no es una regla de buenas maneras: es la separación de poderes de tu repositorio.

    3. Llevamos cuarenta años sacando comprobaciones de la cabeza del humano

    El compilador quitó una clase entera de errores que antes se cazaban leyendo. El type checker quitó otra. El linter quitó las discusiones de estilo de las revisiones de código. El CI quitó el "en mi máquina funciona".

    Cada salto de productividad real de esta profesión ha sido el mismo movimiento: coger una comprobación que hacía una persona cansada y dársela a un proceso que no se cansa.

    La Revisión por Contrato no es una idea nueva. Es ese mismo movimiento aplicado al último sitio donde todavía no lo habíamos hecho: comprobar que el código generado hace lo que se pidió.

    Y aquí está el error de época, el que veo en casi todos los equipos: creer que la IA también puede hacer esa parte. Poner un segundo agente a revisar al primero se siente productivo, pero un modelo probabilístico revisando a otro modelo probabilístico no te da un veredicto — te da una segunda opinión, más larga y con la misma naturaleza. La IA genera. Verificar lo hace algo determinista, que sale con código cero o distinto de cero.

    Por qué esto sí resuelve el cuello de botella

    Tres razones, y la tercera es la que me convenció.

    Tu revisión deja de escalar con el tamaño del diff. Hoy revisas ochocientas líneas porque el agente escribió ochocientas. Con contrato revisas cuarenta líneas de contrato y un veredicto, y esas cuarenta líneas no crecen cuando el agente escribe el doble. Rompes el vínculo entre lo que produce la máquina y lo que consume tu atención, que es literalmente la definición de desatascar un cuello de botella.

    El error cambia de sitio y de dueño. Un fallo que detecta el bucle corto a los veintiocho segundos lo arregla el agente, casi siempre solo, y no te enteras. El mismo fallo dentro de una pull request cuesta tu contexto, tu tarde y a veces tu fin de semana. No es que haya menos errores: es que dejan de ser tuyos.

    Y es la única pieza que mejora cuando el modelo mejora. Esta es la buena. Sin verificación, un agente el doble de rápido te dobla la cola de revisión — la mejora del proveedor se convierte en trabajo tuyo. Con verificación, un agente el doble de rápido entrega el doble, porque el harness absorbe el aumento sin pedirte más atención. Es la diferencia entre que los próximos dos años de avances te lleguen como regalo o como factura.

    Lo que no resuelve

    Sería raro que te vendiera esto sin decirte dónde se acaba.

    El contrato comprueba que el código hace lo que pediste. No tiene ni idea de si pediste lo correcto.

    Tampoco te dice si el nombre de ese servicio encaja con el lenguaje del dominio, si la solución es proporcionada al problema, o si acabas de meter la tercera forma distinta de hacer lo mismo en el mismo repo. Eso sigue siendo trabajo humano y lo va a seguir siendo.

    Lo cual, si lo piensas, es una noticia excelente. Ese trabajo — decidir qué se construye y si tiene sentido — siempre fue el nuestro. Lo que nos habíamos autoimpuesto era el otro: leer ochocientas líneas buscando un null.

    La prueba de una línea

    Si quieres saber en treinta segundos si tienes un contrato o un deseo, coge el último criterio de aceptación que escribiste y hazte esta pregunta:

    ¿Puedo escribir algo que compruebe esto sin mí?

    Si la respuesta es sí, es una cláusula. Si es no, es una intención. Y tu tiempo de revisión es, casi exactamente, la suma de tus intenciones.

    Empieza por ahí. Una sola línea de una sola spec, convertida en un comando que devuelve cero o distinto de cero. Es media hora y ya lo notas en la siguiente tarea.

    Cuando quieras el sistema completo — las cinco secciones del AGENTS.md, los dos bucles y los límites, con el porqué de cada línea — está en el ebook gratuito de Revisión por Contrato. Treinta páginas, sin coste.

    Si lo que quieres es montarlo entero de una sentada, sobre un Issue de verdad y hasta la pull request verificada, ese camino completo es el workshop de SDD + Agentic Engineering. Tres horas on-demand, nueve módulos, y sales con tu harness montado en tu repo, no con apuntes.

    Y si prefieres verlo antes de leer nada, esto lo monto en directo cada cierto tiempo: webinar de Revisión por Contrato. Cincuenta y cinco minutos sobre una feature real — el agente entrega, la verificación falla, y en pantalla se ve qué cláusula rompió. Gratis, y la próxima fecha está en la página.

    La parte de cómo se escribe la spec de cada tarea, con más profundidad, la tienes en el libro de Spec-Driven Development.

    El cuello de botella no se mueve solo. Pero se mueve.

    Preguntas frecuentes

    ¿Qué es exactamente la Revisión por Contrato?

    Un método para verificar código generado por IA sin leerlo entero. Tiene tres piezas: un contrato con cláusulas que una máquina puede rechazar (no "debe ser rápido", sino "p95 < 200 ms en el CI"), un carril que declara por escrito dónde el agente no puede escribir, y un veredicto emitido por comandos ejecutables con dos estados posibles. Lo que revisa la persona después es el veredicto y el contrato, no el diff completo.

    ¿Por qué un modelo mejor no te ahorra verificar código generado por IA?

    Porque un modelo mejor sube el porcentaje de aciertos, no elimina la obligación de comprobar. Con un 97% de acierto sobre ochocientas líneas te quedan veinticuatro líneas malas y ninguna indicación de cuáles son, así que sigues teniendo que revisarlas todas.

    ¿No puedo poner otro agente a revisar el código del primero?

    Ayuda como segunda opinión, no como veredicto. Un modelo probabilístico revisando a otro modelo probabilístico produce texto plausible, no un resultado binario y reproducible. La verificación tiene que apoyarse en algo determinista — build, tipos, lint, tests, criterios de aceptación con un comando detrás — precisamente porque no cambia según cómo venga el día.

    ¿Qué relación tiene la Revisión por Contrato con Design by Contract?

    Es la misma idea de Bertrand Meyer (Eiffel, 1986) sacada de la función y aplicada al agente. Design by Contract mete precondiciones, postcondiciones e invariantes dentro del lenguaje para que el programa reviente cuando se incumplen. La Revisión por Contrato hace lo mismo un nivel por encima: escribe los criterios de aceptación de la tarea en cláusulas que un comando puede rechazar, para que el fallo lo cace el harness de verificación y no tus ojos a las once de la noche.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Revisar código generado por IA: el método Revisión por Contrato

    Revisar código generado por IA: el método Revisión por Contrato

    Una noche estuve casi dos horas revisando una pull request.

    No la escribí yo. La escribió el agente, en dos minutos.

    Y ahí me quedé, con el diff abierto a las tantas, leyendo línea por línea un código que no había escrito, buscando el fallo que sabía que estaba en alguna parte.

    Dos minutos de generación. Ciento diez de revisión.

    Revisar código generado por IA se había comido entero el tiempo que la IA me iba a ahorrar.

    Nos vendieron que la IA nos iba a quitar trabajo, y es verdad a medias, que es la peor forma de ser verdad. Te quitó el trabajo de escribir. Te dio el trabajo de auditar.

    Antes escribías cuatrocientas líneas en dos horas. Ahora las lees en dos horas.

    Por qué revisar código generado por IA cansa más que escribirlo

    Revisar código generado por IA cansa más que escribirlo porque no sigues un razonamiento: verificas cuatrocientas afirmaciones independientes, una a una, sin ningún hilo que las sostenga.

    Cuando escribes esas cuatrocientas líneas, el modelo mental se construye contigo. Entender es un subproducto gratis de haberlas escrito.

    Cuando las revisas, tienes que reconstruir ese modelo desde fuera, deduciendo la intención a partir del resultado. Y ahí está el detalle:

    Del otro lado no había ningún modelo mental.

    Tu compañero, cuando escribió aquella función rara, tenía un motivo. Malo o bueno, pero un motivo, y podías preguntárselo. El agente produjo el token más probable dadas las circunstancias. Estás reconstruyendo una intención que nunca existió.

    Por eso cansa distinto, y por eso no mejora con la práctica: no hay nada que aprender, solo cuatrocientas comprobaciones que hacer.

    Y lo peor no es el tiempo. Es que nunca sabes del todo si se te ha colado algo, porque en la línea 230 aflojaste y lo sabes. O lo lees entero con la misma atención en la 400 que en la 12, o lo mergeas con el nudo en el estómago. No hay tercera.

    Y ya sabes cuál de las dos gana casi siempre: en cinco proyectos de gran escala, el 64,7% de las pull requests se aprueba sin un solo comentario.

    El problema no era el agente

    Yo estuve meses culpando al modelo. Cambié de herramienta tres veces y escribí prompts cada vez más largos, con más reglas, más ejemplos y más mayúsculas.

    Mejoraba un poco. Nunca lo suficiente.

    Hasta que caí en lo que estaba delante desde el principio: el problema no era el agente, era que yo era la única verificación del sistema. Entre el código generado y producción no había nada más que mis ojos cansados.

    Eso no lo arregla un modelo mejor. Un modelo mejor te da código correcto más a menudo, pero no cambia quién tiene que comprobarlo.

    De hecho, cada mejora en la velocidad de generación empeora tu situación. Si el agente pasa de cuatrocientas líneas a ochocientas en el mismo rato, tú no has ganado nada: has doblado la cola de revisión. La única parte del proceso que no escala eres tú, y todo el mundo está optimizando las otras.

    Por qué tu spec no lo arregló

    Aquí es donde la mayoría me dice que ya probó lo de escribir specs y lo dejó.

    Yo también. Y no es que las specs sean inútiles: es que escribiste la spec para el agente, no para la verificación.

    Mira tus criterios de aceptación de la última vez. “El endpoint debe ser rápido.” “Maneja bien los errores.” “No rompas nada.” Frases que ninguna máquina puede rechazar. Una spec que nadie comprueba es documentación, y la documentación no ha frenado un bug en la historia de esta profesión.

    Un contrato es una especificación contra la que algo puede fallar. Fallar de verdad: salir con código distinto de cero, poner el CI en rojo, parar la cosa antes de que llegue a ti.

    Es la misma diferencia que ya conoces entre un README que dice “recuerda formatear antes de commitear” y un hook que no te deja commitear sin formatear. Los dos expresan la misma norma. Uno confía en que alguien se acuerde.

    Tu spec era un README muy bien escrito. Lo que necesitas es el hook.

    Así que coge cualquier línea de cualquier spec tuya y pregúntate esto:

    ¿Puedo escribir algo que compruebe esto sin mí?

    Si la respuesta es sí, tienes una cláusula. Si es no, tienes una intención. Las intenciones no se tiran —orientan al agente y algo aportan—, pero no cuentan: no van a rechazar nada y no puedes apoyarte en ellas para dejar de leer el diff entero.

    Cuando pasas tu spec entera por esa pregunta suele salir algo incómodo: de veinte líneas, diecisiete eran intenciones.

    Si al hacer el recuento te sale un número parecido, el problema no es que escribas mal specs: son los siete fallos típicos que hacen que una spec no aguante delante de un agente, y casi todos se arreglan con la misma pregunta.

    Ahí está tu tiempo de revisión. Y convertir esas diecisiete es lo que llamo Revisión por Contrato: tres piezas en un orden que importa.

    La Revisión por Contrato es un método para revisar código generado por IA sin leer el diff entero. Consta de tres piezas: conviertes las intenciones de tu spec en cláusulas que una máquina puede rechazar (contrato), declaras por escrito dónde el agente no puede escribir (carril) y dejas que un conjunto de comandos ejecutables emita el resultado (veredicto). Lo que tú revisas después es el veredicto y el contrato, no las cuatrocientas líneas.

    1. Contrato: qué se construye

    La conversión desde tu spec actual es bastante mecánica:

    Spec (describe) Contrato (se puede incumplir)
    “El endpoint debe ser rápido” p95 < 200 ms en el test de carga del CI
    “Maneja bien los errores” Todo path de error devuelve un tipo del enum AppError
    “No rompas nada” La suite existente pasa sin cambios en sus asserts
    “Sigue las convenciones” lint y typecheck en verde, sin excepciones nuevas

    Hay dos contratos, y confundirlos es el error más común. El AGENTS.md es el contrato permanente del repositorio: lo que es cierto para cualquier tarea que se haga aquí. La spec es el contrato de esta tarea concreta, nace con el issue y muere con la pull request. Si metes lo de la tarea en el AGENTS.md, envejece fatal y en dos meses nadie se fía de lo que dice.

    Para la parte de la tarea tengo publicada la skill que uso yo, sdd-creator: obliga al agente a escribir spec.md, plan.md y tasks.md antes de tocar código, y funciona igual en Claude Code, Codex, Cursor o Gemini.

    Aquí vamos con el AGENTS.md, que es el que más rinde por línea escrita. Esta es la primera mitad:

    # AGENTS.md
    
    API de facturación interna. Emite y consulta facturas para el equipo de
    operaciones. No es público: todo el tráfico entra por el gateway.
    
    ## Stack
    
    - **Lenguaje:** TypeScript 7, Node 24 LTS
    - **Framework:** Fastify 5
    - **Gestor de paquetes:** pnpm — derivado de `pnpm-lock.yaml`. No uses otro.
    
    ## Convenciones
    
    - Los handlers no hablan con Prisma. Pasan por un servicio en `src/services/`.
    - Todo error de dominio es un `AppError`. No se lanzan strings ni `Error` pelado.
    - Los tests van junto al fichero que prueban, como `*.test.ts`.
    
    ## Definición de terminado
    
    Una tarea está terminada cuando:
    
    1. El bucle corto pasa en verde.
    2. El bucle largo pasa en verde.
    3. Cada criterio de aceptación de la spec tiene evidencia: qué comando lo
       demuestra y cuál fue su salida.
    4. El diff no contiene nada que la spec no pidiera.
    

    Las convenciones no las inventes: ábrete tres ficheros del repo y escribe lo que ya se hace. Una convención impuesta desde fuera que el código existente incumple es la peor línea que puedes meter ahí, porque el agente la seguirá y su código no se parecerá a nada de lo que hay alrededor.

    Y el punto 4 merece párrafo propio, porque es el que casi nadie escribe y el que más caro sale.

    Le pides al agente que arregle un bug del IVA. Arregla el bug. Y de paso renombra dos variables, extrae un helper, actualiza un comentario y reordena los imports de tres ficheros. Puede que hasta sean mejoras, pero ninguna de esas líneas está cubierta por ningún contrato: nadie las pidió, nadie definió cuándo estarían bien, y ahora están en tu diff obligándote a leerlas.

    Código de más es código sin contrato. Esa línea sola recorta el diff medio de una forma que se nota la primera semana.

    2. Carril: por dónde no puede salirse

    Piensa en la última vez que un agente te dejó algo raro. Ajustó el assert de un test que fallaba. Añadió una dependencia entera para no escribir tres líneas. Metió un as any. Marcó un test lento como skip. Tocó un fichero de despliegue.

    Ninguno de esos es un fallo de razonamiento. En todos entendió perfectamente lo que le pediste.

    La mayoría de los desastres que te va a dar un agente no son de lógica. Son de alcance.

    No hace trampas: hace lo que le pediste por el camino más corto que encontró. Le pediste que los tests pasaran. No le pediste que el código funcionara. Casi siempre coinciden, por eso vivimos tranquilos. Cuando dejan de coincidir, el camino corto es tocar el test.

    Y de aquí sale lo que de verdad importa:

    Si el agente puede modificar la cosa que lo comprueba, no tienes verificación. Tienes teatro.

    Los tests, el linter, el CI — todo eso son ficheros del repositorio, dentro de su radio de acción. Salvo que digas lo contrario, el que recibe el veredicto tiene permiso de escritura sobre quien lo emite. Ningún juzgado funcionaría así.

    ## Límites
    
    Sin permiso explícito, el agente no toca:
    
    - `prisma/migrations/` ni el esquema. Una migración se revisa a mano, siempre.
    - `.github/workflows/`, `Dockerfile` ni nada de despliegue.
    - `package.json`: no se añaden ni se actualizan dependencias. Si hace falta
      una, para y pregunta.
    - `.env`, `.env.*` ni ningún fichero con credenciales.
    - Los asserts de los tests que ya existen. Añadir tests nuevos, sí. Cambiar
      los que ya estaban, no.
    - `src/lib/money.ts`. Es aritmética de céntimos y ya nos ha mordido dos veces.
    

    El “para y pregunta” es una salida y hace falta: un límite sin salida se convierte en un agente bloqueado o, peor, en un agente que se lo salta.

    La línea de los asserts es la que protege al verificador. No prohíbe tocar los tests: prohíbe cambiar los que ya estaban. Añadir cobertura nueva puede y debe; aflojar la existente para que su trabajo pase, no.

    Y la última línea es la que hace creíbles a todas las demás. money.ts no está ahí por una regla general, sino porque ese fichero ya mordió dos veces. Las cuatro primeras las copias de cualquier plantilla; esa la escribes tú. Tu repo tiene dos o tres. Ya sabes cuáles son.

    Ahí está el cambio de postura que ordena todo lo demás: dejas de pedirle al agente que se porte bien y montas un sitio donde portarse mal se detecta solo. Un prompt es una petición y depende de que el modelo esté teniendo un buen día. Un límite es una propiedad del sitio donde trabaja.

    Eso sí, sé honesto con lo que es un fichero markdown: una señal, no una valla. Los límites de verdad viven en tres capas — declarado (el AGENTS.md), impedido (permisos y hooks que rechazan escrituras fuera del alcance) y detectado (CI y protección de rama). La primera cuesta diez minutos y quita la inmensa mayoría de las desviaciones. Si alguien te vende que un markdown le pone puertas a un proceso con acceso de escritura a tu disco, desconfía.

    3. Veredicto: quién dice que está bien

    Un veredicto no es una opinión. Una opinión es lo que da un linter cuando sugiere, o lo que das tú a las once de la noche cuando dices “bueno, tiene buena pinta”.

    Un veredicto es un proceso que termina en dos estados y ninguno más. No admite matices y no cambia según lo cansado que estés.

    Y no lo emite una cosa. Lo emiten cinco:

    Capa Pregunta que responde
    Build ¿Esto compila?
    Tipos ¿Las piezas encajan entre sí?
    Lint ¿Se parece al resto del código de esta casa?
    Tests ¿El comportamiento sigue siendo el que era?
    Criterios de aceptación ¿Hace lo que la spec pidió?

    Las cuatro primeras ya las tienes: están en tu repo desde antes de que existieran los agentes. La quinta es la que casi nadie tiene, y es la que convierte un montón de comandos sueltos en un harness, porque conecta el contrato con algo que se ejecuta.

    Un aviso sobre la palabra “harness”, que se usa para dos cosas distintas: aquí es el conjunto de comandos que verifica el código que tu agente escribe. Si lo que quieres es probar el agente en sí —tools falsas, presupuesto de tokens, trazas reproducibles en CI—, eso es otro montaje y lo explico en el test harness para agentes de IA.

    Esa quinta capa es la que tengo automatizada en ai-workflow-kit —v2.5.0 en npm a septiembre de 2026—, que se instala con npx ai-workflow-kit. El plan de la tarea lleva una casilla por paso, y cada casilla lleva detrás el comando que la demuestra: verify la marca solo cuando ese comando sale con código cero. Lo que queda escrito en el fichero es lo que se demostró, no lo que el agente dijo que había hecho.

    El harness tiene dos velocidades, y esa decisión que parece técnica es la que decide si el sistema se usa o se abandona. El bucle corto lo ejecuta el agente después de cada cambio y tiene que bajar de sesenta segundos; si tarda más, hace tandas más largas entre comprobaciones y cuando algo falla ya no sabes cuál de los quince cambios lo rompió. El bucle largo se ejecuta una vez, antes de abrir la PR.

    Y no, no puedes meterlo todo en el corto por si acaso. Un bucle corto de ocho minutos no es exhaustivo: es un bucle que nadie ejecuta. Los sesenta segundos son el umbral por debajo del cual la gente no busca la forma de esquivarlo.

    ## Verificación
    
    Estos comandos están ejecutados y comprobados. Son el harness: si uno falla,
    el trabajo no está hecho.
    
    ### Bucle corto — después de cada cambio
    
        pnpm typecheck      # 4s
        pnpm lint           # 6s
        pnpm test:unit      # 18s
    
    ### Bucle largo — antes de abrir la PR
    
        pnpm build          # 40s
        pnpm test           # 2m 10s
        pnpm test:e2e       # 3m 30s
    
    ### Rojos conocidos
    
    - `pnpm test:e2e` falla 2 de 34 en `emision-factura.e2e.ts` desde el cambio
      del proveedor de firma. Es anterior al agente. Si falla cualquier otro,
      lo rompiste tú.
    

    Si te llevas una sola línea técnica de este post, que sea esta: nunca metas en el harness un comando que no hayas ejecutado.

    El agente lee el fichero, ve pnpm test:integration, lo lanza, el comando no existe, el error es raro y decide seguir adelante. Él cree que está verificado. Tú crees que está verificado. Nadie ha comprobado nada. Has empeorado tu punto de partida y encima duermes mejor.

    Los tiempos anotados al lado de cada comando tampoco son decoración: son lo que te permite saber dentro de seis meses si el bucle corto sigue siendo corto. Los harness no se rompen de golpe, se degradan un comando cada vez.

    Y los rojos conocidos son lo que más me costó aceptar. ¿Qué haces con un comando importante que hoy falla? La tentación es dejarlo fuera hasta arreglarlo. No lo hagas: ponlo y documenta que está en rojo. Un harness honesto con dos rojos vale más que uno verde de mentira. Además, si el agente sabe qué estaba roto antes de empezar, distingue lo que rompió él de lo que ya estaba roto, en vez de ponerse a investigarlo y a veces a “arreglarlo”.

    Qué cambia el martes por la mañana

    Le pides una feature y el agente rompe el contrato — pongamos que dos tests existentes fallan.

    Sin harness, eso te llega como una PR de cuatrocientas líneas y tú descubriéndolo en el minuto cuarenta. O peor, no descubriéndolo.

    Con harness, el bucle corto se pone rojo a los veintiocho segundos y el agente sabe exactamente qué rompió, porque el rojo tiene nombre y no está en la lista de rojos conocidos. La mayoría de las veces lo arregla solo. Y cuando no puede, lo que te llega no es un diff: es una frase — no puedo cumplir esta cláusula sin tocar lo que dijiste que no tocara.

    Mi tiempo medio de revisión pasó de una hora cincuenta a veinte minutos. A cuatro PRs por semana son seis horas a la semana. No lo redondeo a “cinco veces más rápido” porque los porcentajes bonitos son lo primero que hace desconfiar: es un número mío, medido en mi repo. Tú tendrás el tuyo.

    Pero los veinte minutos siguen ahí, y aquí es donde muchos esperan que diga “y ya no revisas nada”. Lo que cambió es en qué se te van:

    1. Miras el veredicto. Qué pasó, qué falló, qué se saltó. Treinta segundos.
    2. Lees el contrato, no la implementación. Cuarenta líneas. Y la pregunta ya no es “¿está bien este código?” sino “¿pedí lo correcto?”, que es muchísimo mejor pregunta y que solo puedes responder tú.
    3. Lees el diff, pero apuntando a las zonas donde el contrato no llega: si el nombre encaja con el dominio, si la solución es la adecuada para este proyecto. Ahí es donde viven los fallos que un code review no puede ver —N+1, fugas de recursos, race conditions—, y por eso ese tercer paso no lo puedes borrar del proceso.

    Ese tercer punto es tu trabajo de verdad, y es el que la IA no te va a quitar. Nunca fue leer cuatrocientas líneas buscando un null. Era decidir si lo que se construyó tenía sentido.

    Qué hacer hoy

    Cuatro cosas, por orden. Ninguna te lleva más de una tarde.

    1. Pasa tu última spec por la prueba de una línea. Cuenta cláusulas e intenciones. Ese número explica tu tiempo de revisión mejor que cualquier otra cosa.
    2. Ejecuta tus comandos de verificación, uno a uno, apuntando lo que tarda cada uno. De ahí salen tu bucle corto, tu bucle largo y tus rojos conocidos.
    3. Escribe el AGENTS.md con esas secciones: stack, convenciones, definición de terminado, límites y verificación. Media página. El punto 4 de la definición de terminado no te lo saltes.
    4. Añade una línea de carril que sea tuya. El fichero que ya te mordió. Esa es la que hace creíbles a las otras cinco.

    El AGENTS.md no hace falta que lo escribas mirando a una pantalla en blanco: lo tienes entero, con las cinco secciones y los comentarios de por qué está cada línea, en el ebook gratuito de El método Revisión por Contrato. Treinta páginas, sin coste.

    Si prefieres ver el AGENTS.md, el harness y los límites montados sobre un proyecto real en vez de partir de una plantilla, ese es justo el recorrido de Construye con IA: de la idea al producto con Claude Code.

    Un apunte que te ahorra una tarde: AGENTS.md es un estándar abierto, no algo que traigan todas las herramientas. En su lista de compatibilidad, consultada el 6 de septiembre de 2026, están Codex, Cursor, el agente de codificación de Copilot, Gemini CLI o Zed. Claude Code es la excepción, y conviene saberlo porque es de las más usadas: lee CLAUDE.md. Se arregla con un fichero de una línea que importe el otro con @AGENTS.md. Compruébalo en tu versión, que esto es de lo poco aquí que puede cambiar en tres meses.

    Si quieres el marco completo alrededor de esto —cómo se escribe la spec de la tarea, no solo el contrato del repo— lo desarrollo en el libro de Spec-Driven Development, en papel o en ebook.

    Empieza por el punto 2. Es el más aburrido de los cuatro y es el que sostiene los otros tres.

    Preguntas frecuentes

    ¿Cómo se revisa código generado por IA sin leer todo el diff?

    Necesitas tres cosas antes de que la pull request llegue a ti: un contrato con cláusulas que una máquina pueda rechazar, límites escritos sobre qué ficheros el agente no toca, y un harness de comandos ejecutables que emita un veredicto binario. Con eso, tu revisión se reduce a tres pasos: mirar el veredicto (treinta segundos), leer el contrato para comprobar que pediste lo correcto (unas cuarenta líneas) y leer el diff solo en las zonas que el contrato no cubre —nombres, encaje con el dominio, si la solución es la adecuada para este proyecto—. En mi repo eso bajó el tiempo medio de revisión de una hora cincuenta a veinte minutos.

    ¿Esto no es simplemente tener buenos tests?

    Los tests son una de las cinco capas, no el mecanismo. Puedes tener una suite excelente y seguir revisando cuatrocientas líneas a mano, porque los tests responden “¿el comportamiento sigue siendo el que era?” y no responden “¿esto hace lo que la spec pidió?” ni “¿el agente se salió de su terreno?”. La pieza que casi nadie tiene es la quinta: criterios de aceptación con un comando detrás. Y si quieres que el test defina el contrato antes de que el agente escriba nada, eso es TDD con IA y encaja encima de esto, no en su lugar.

    Mi repo no tiene tests. ¿Esto me sirve de algo?

    Sí, y probablemente más. Empieza por lo que ya existe aunque no lo llames harness: el build, el type checker y el linter ya emiten veredictos hoy. Escribe el AGENTS.md con esos tres comandos y los límites, y añade tests después, uno por tarea. La alternativa —esperar a tener cobertura para empezar— es como la gente se queda un año sin hacer nada.

    ¿No es más fácil poner todo esto en el prompt?

    Funciona. Casi siempre. El problema es el casi. El prompt vive en una conversación y muere con ella. El fichero vive en el repositorio: se escribe una vez y se aplica a todas las tareas que vengan detrás, incluidas las que lance otra herramienta o cualquiera que entre al repo después de ti.

    ¿Esto no ralentiza al agente?

    Al contrario, aunque el bucle corto sume segundos. Sin verificación el agente entrega rápido y falso, y el coste aparece luego en tu revisión y en los arreglos. Con verificación, el error llega a los veintiocho segundos, con nombre, y lo arregla él. La velocidad que importa no es la de generar código: es la de llegar a algo que se pueda mergear.

    ¿Sirve si mi stack no es TypeScript?

    La estructura es la misma en Python, Go o Java — stack, convenciones, definición de terminado, límites y verificación. Lo que cambian son los comandos concretos, y esos salen de tu proyecto, no de un ejemplo. Copia la forma y rellénala con lo tuyo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
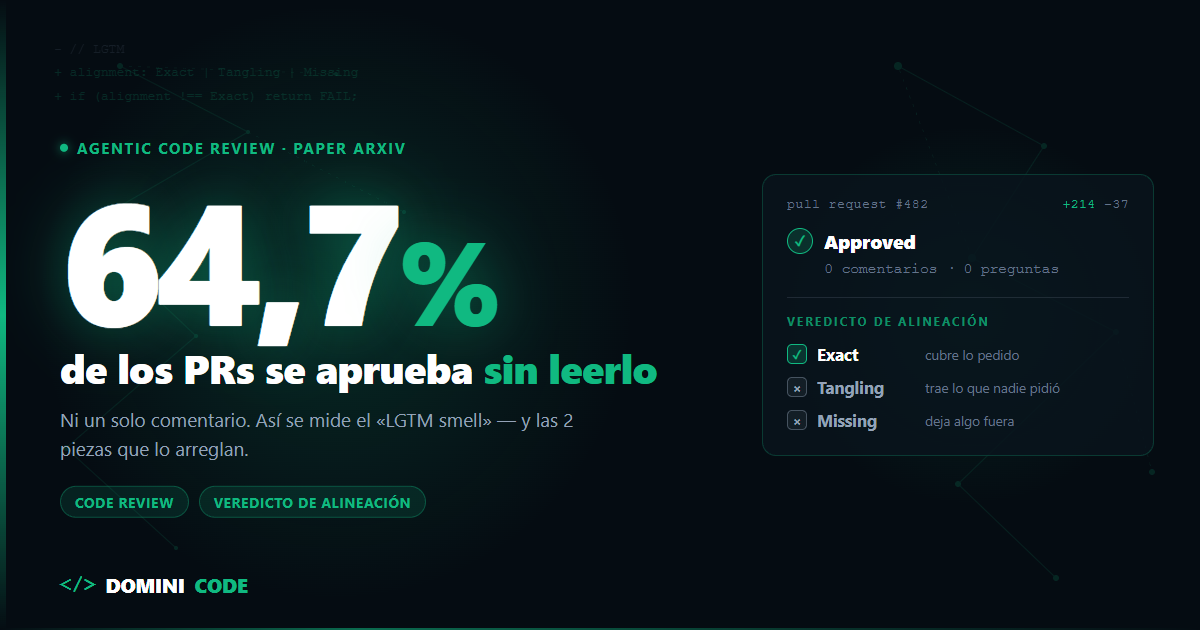
  • Agentic code review: el 64,7% de los PRs se aprueba sin leerlo

    Agentic code review: el 64,7% de los PRs se aprueba sin leerlo

    Esta semana has aprobado al menos un PR sin leerlo entero. Has mirado el diff en diagonal, has visto que el CI estaba en verde y has escrito "LGTM".

    No te estoy juzgando. Te estoy describiendo. Y no lo digo yo. Lo dice un estudio sobre cinco proyectos de gran escala (Gon et al.), recogido en un paper académico sobre agentic code review que acabo de leer entero: el 64,7% de los PRs se aprueban sin un solo comentario. Y esos reviews silenciosos presentan el "LGTM smell" —aprobar sin revisar de verdad— 3,5 veces más que los reviews con conversación.

    El paper se llama Rethinking Code Review in the Age of AI: A Vision for Agentic Code Review (arXiv:2605.17548). Es un vision paper: propone un framework, no un sistema implementado. Pero la radiografía que hace del review actual es tan incómoda que he cambiado cómo revisan código mis dos herramientas open source.

    Te cuento por qué.

    Los números que describen tu equipo

    El paper recopila estudios empíricos de la última década. Léelos pensando en tu repo, no en el de otros:

    • El 34% de 333.001 descripciones de PR analizadas en GitHub estaban vacías. Ni una línea de contexto (Liu et al.).
    • El 34,3% de los PRs no enlazan con ningún issue. En commits de bugfix, el 52,4% van sin enlazar (Dogan et al.; Bachmann et al.).
    • En Mozilla, el 54% de los code reviews no detectaron bugs que estaban presentes en commits aprobados (Kononenko et al.).
    • En Microsoft, solo el 15% de los comentarios de review señalaban defectos potenciales (Czerwonka et al.). Y entre un 34,5% y un 44,47% de los comentarios se clasifican directamente como "no útiles".
    • Un 19,1% de los comentarios de review de un dataset estudiado eran, literalmente, tóxicos (Sarker et al.).

    La etapa que llamamos "control de calidad" dejó pasar bugs en más de la mitad de los reviews medidos en Mozilla, genera ruido en un tercio de los comentarios y a veces hasta hace daño.

    Y ahora métele IA.

    El code review con IA no arregla el problema. Lo desborda

    Los asistentes de IA aceleran las tareas individuales de código en más de un 50%, según los estudios que recopila el paper. Escribimos más código que nunca. Pero hay dos datos que deberían quitarte la sonrisa.

    Uno: las contribuciones generadas por IA requieren más iteraciones de review que las escritas por humanos.

    Dos: cuando la IA asiste al reviewer, este encuentra más issues de severidad baja… pero no más defectos graves. La automatización arrastra tu atención hacia los problemas fáciles. El naming, el estilo, el typo. Mientras, el bug de concurrencia pasa de largo con su "LGTM".

    El paper lo dice sin rodeos: el code review ya no es solo un cuello de botella de productividad, es "la superficie de control primaria de la calidad y la responsabilidad del código producido por IA".

    Piensa en lo que eso significa. Si un agente escribe el 60% de tu código, el review es el único punto donde un humano responde por él. Y ese punto, según los datos de arriba, está roto.

    Hay una capa del problema que el review ni siquiera puede tocar, y la desarrollé aparte en los 5 fallos del código generado por IA que un code review no puede ver. Este post va de la otra mitad: arreglar lo que el review sí puede hacer y no hace.

    Qué es el agentic code review: el review no es una etapa, es un ciclo

    El agentic code review es un modelo de revisión en el que agentes de IA especializados cubren las cinco etapas del ciclo de vida del PR, mientras el humano actúa como supervisor con capacidad de veto en cada punto de decisión. La diferencia con "un bot que comenta el diff" es que el contexto cruza las fronteras entre etapas en lugar de perderse en cada salto.

    Y esa es la propuesta central del paper: la efectividad del review no es el resultado de una etapa aislada, sino de todo el ciclo de vida del PR.

    Un comentario de review útil depende de que el PR tenga una descripción con rationale. La descripción depende de que exista un issue enlazado. Y los reviews futuros dependen de que las lecciones de los reviews pasados queden escritas en algún sitio. Ninguna herramienta que optimice una sola etapa puede resolver esas dependencias.

    El framework tiene cinco etapas con agentes especializados y puertas humanas en cada punto de decisión: PR Creation → PR Augmentation → Reviewer Selection → AI-Assisted Code Review → PR Retrospective. El reviewer deja de ser un inspector manual y pasa a ser un operador supervisor de agentes.

    De todo el framework, hay dos piezas que me parecen oro. Y son las dos que he implementado hoy.

    Qué es el veredicto de alineación: Exact, Tangling y Missing

    El paper recoge una taxonomía de Isik et al. que formaliza algo que todos intuimos pero nadie mide: ¿el PR hace lo que se pidió?

    Categoría Qué significa Cómo se manifiesta con agentes Dato del paper
    Exact Cubre lo pedido, sin extras El caso que quieres —
    Tangling Incluye código que nadie pidió Le pides un fix y refactoriza tres ficheros "de paso" 7-20% de los changesets
    Missing No cubre todo lo pedido Marca la tarea como hecha sin implementar el criterio 16,5% de los PRs
    Missing and Tangling Ambas a la vez Se deja lo pedido y añade lo que no —

    Un review que solo busca bugs responde a la pregunta equivocada. La primera pregunta no es "¿este código tiene errores?". Es "¿este código es el que se pidió?".

    Por eso el skill /ak:review de ai-workflow-kit y la fase de Code Review del plugin sdd-creator ya no cierran el review con una lista de bugs. Cuando encuentran una spec que cubre el cambio, abren el review con una capa de cumplimiento y lo cierran con un veredicto de alineación explícito, contrastado criterio a criterio contra esa spec:

    ## Review: [feature slug]
    
    Status: PASS | CHANGES REQUIRED
    Alignment: Exact | Tangling | Missing | Missing and Tangling
    
    ### Requirements compliance
    - [AC-XX]: implemented / missing / diverges — [evidence]
    - Tasks marked done without a matching implementation: [list or none]
    - Out of scope: [code no criterion asks for, or none]
    

    La regla que lo hace útil es la última: un veredicto distinto de Exact no puede ser PASS salvo que tú aceptes la desviación por escrito. El código fuera de alcance se quita o se especifica; el trabajo que falta se completa o se saca del alcance. Es un veredicto que puedes verificar en dos minutos, en lugar de un "se ve bien" que no compromete a nadie.

    Si el repo no tiene specs/, no hay contra qué contrastar y el review vuelve al formato de severidades de siempre. Que es, en sí mismo, el argumento del paper.

    Qué es la retrospectiva de PR y por qué un review sin memoria se repite

    La quinta etapa del framework es la que casi todo el mundo se salta: el PR Retrospective. Cuando el PR se aprueba o se rechaza, un agente resume qué se decidió, qué se descartó y por qué, y lo guarda en la memoria del repositorio para que los agentes (y los humanos) del siguiente review partan de ahí.

    Aquí el paper suelta un detalle que valida algo que llevo tiempo defendiendo. Al explicar por qué los modelos no generalizan entre proyectos distintos, dice que inyectar reglas específicas del repositorio vía archivos de configuración tipo "Agents.MD" directamente en la ventana de contexto del agente es una alternativa computacionalmente barata al fine-tuning. No necesitas reentrenar un modelo para que entienda tu proyecto. Necesitas escribir las decisiones en un fichero que viaje con el repo.

    Eso también lo he incorporado: los dos productos ahora cierran el review proponiendo qué promocionar a la memoria del proyecto — decisión confirmada, alternativa rechazada, riesgo que se materializó. En el flujo SDD va a specs/INDEX.md; en el kit, a memory/decisions/. Los arreglos de código se quedan en el review; solo sube el conocimiento duradero. El siguiente review no redescubre lo mismo. Acumula.

    El paper valida SDD sin saberlo

    Y hay una frase del paper que me hizo reírme solo: "el contexto debe cruzar las fronteras entre etapas". Porque eso es exactamente Spec-Driven Development: el spec.md, el plan.md y el tasks.md no se quedan en la fase de diseño. Viajan hasta el review y hasta el PR. El reviewer no reconstruye la intención desde el diff — la tiene delante, escrita antes de la primera línea de código.

    El 34% de descripciones de PR vacías no es un problema de disciplina. Es un problema de flujo: si el contexto no existe antes de codificar, nadie lo va a escribir después. SDD lo resuelve por diseño — siempre que la spec esté bien planteada, porque una spec mal escrita rompe al agente igual que no tener ninguna.

    Lo que el paper admite que puede salir mal

    No te vendo humo: los propios autores dedican una sección entera a los riesgos, y son serios.

    Las alucinaciones se propagan en cascada entre agentes. Si el agente de review inventa una vulnerabilidad de concurrencia, el agente de fixes genera locks innecesarios. Para cuando el humano detecta el error, ya has pagado los tokens de tres agentes resolviendo un problema que nunca existió.

    Súmale la degradación de contexto en PRs grandes y el sesgo de automatización: aceptar el output del agente sin verificarlo, que es el LGTM smell con esteroides.

    Y el más silencioso de todos: el deterioro del mentoring implícito. Si el chatbot le explica el PR al junior, el senior ya no se lo explica.

    La respuesta a todos esos riesgos es la misma: puertas humanas con veredictos verificables. No "confía en el agente". Tampoco "desconfía de todo". Sino: exige al agente un output que un humano pueda comprobar en minutos.

    Cómo aplicar el agentic code review hoy en 3 pasos

    No necesitas esperar a que alguien implemente el framework completo del paper. Las tres piezas con más retorno caben en tu flujo actual:

    1. Cierra cada review con un veredicto de alineación. Exact, Tangling, Missing o ambas, contra el issue o la spec. Si no puedes emitirlo, no tenías contexto para revisar — y ese es el verdadero hallazgo del review.
    2. Escribe una retrospectiva de tres líneas por PR relevante. Qué se confirmó, qué se rechazó, qué riesgo apareció. Guárdala en el repo, donde el siguiente agente la pueda leer.
    3. Haz que el contexto viaje. Spec antes del código, spec enlazada en el PR, spec delante del reviewer.

    Si además quieres que esto corra solo en cada push, ya escribí cómo integrar revisiones de código automáticas con IA en el pipeline de CI/CD — el veredicto de alineación encaja ahí como un check más.

    Y si prefieres verlo funcionando en lugar de montarlo desde cero, tanto sdd-creator como ai-workflow-kit son open source y ya incorporan las dos piezas. Si quieres montarlo guiado y de principio a fin, el curso Construye con IA recorre justo este flujo: de la spec al PR revisado. Y si lo que buscas es trabajarlo sobre proyectos completos y en directo, eso es Dominicode Labs.

    El code review no va a desaparecer. Va a convertirse en el trabajo más importante que hagas. Mejor llegar con el contexto puesto.

    Preguntas frecuentes

    ¿Qué es el agentic code review?

    Es un modelo de revisión de código en el que agentes de IA especializados cubren las cinco etapas del ciclo de vida del PR —creación, enriquecimiento, selección de reviewer, revisión y retrospectiva— mientras el humano actúa como supervisor con capacidad de veto en cada punto de decisión. La diferencia con "un bot que comenta el diff" es que el contexto cruza las fronteras entre etapas en lugar de perderse en cada salto.

    ¿Cómo emito un veredicto de alineación en un PR?

    Compara el PR contra el issue o la spec y clasifícalo en una de cuatro categorías: Exact si cubre lo pedido sin extras, Tangling si trae cambios que nadie pidió, Missing si deja algo fuera, o Missing and Tangling si ocurren ambas. Escribe la categoría explícitamente en el PR con una frase de justificación. Si no puedes clasificarlo, el problema no es el PR: es que no tenías contexto suficiente para revisarlo.

    ¿No basta con poner un agente de IA a comentar los pull requests?

    No. Cuando la IA asiste al reviewer aparecen más issues de severidad baja, pero no más defectos graves: la herramienta desplaza la atención hacia lo fácil de detectar. Y un agente que solo comenta diffs no puede saber si el PR hace lo que se pidió, porque nadie le pasó la spec ni el issue.

    ¿En qué se diferencia esto de automatizar el code review en CI/CD?

    En el alcance. Automatizar en CI/CD resuelve la ejecución: que la revisión corra sola en cada push. El enfoque agéntico resuelve el contexto: que la revisión sepa qué se pidió, quién debe revisarlo y qué se aprendió en los PRs anteriores. Son complementarios — el veredicto de alineación se puede publicar como un check más del pipeline.

    ¿El framework del paper ya se puede usar en producción?

    El framework completo no: es un vision paper, una propuesta arquitectónica sin implementación ni evaluación empírica. Pero dos de sus piezas —el veredicto de alineación y la retrospectiva escrita en el repo— no dependen de ninguna infraestructura nueva y las puedes adoptar hoy con las herramientas que ya usas.


    Referencia: Kamalı, H. Ö., Tuna, E., Haratian, V., Tüzün, E. (2026). Rethinking Code Review in the Age of AI: A Vision for Agentic Code Review. Ankara University, Microsoft y Bilkent University. arXiv:2605.17548, mayo de 2026. Vision paper — propuesta de framework, no sistema implementado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
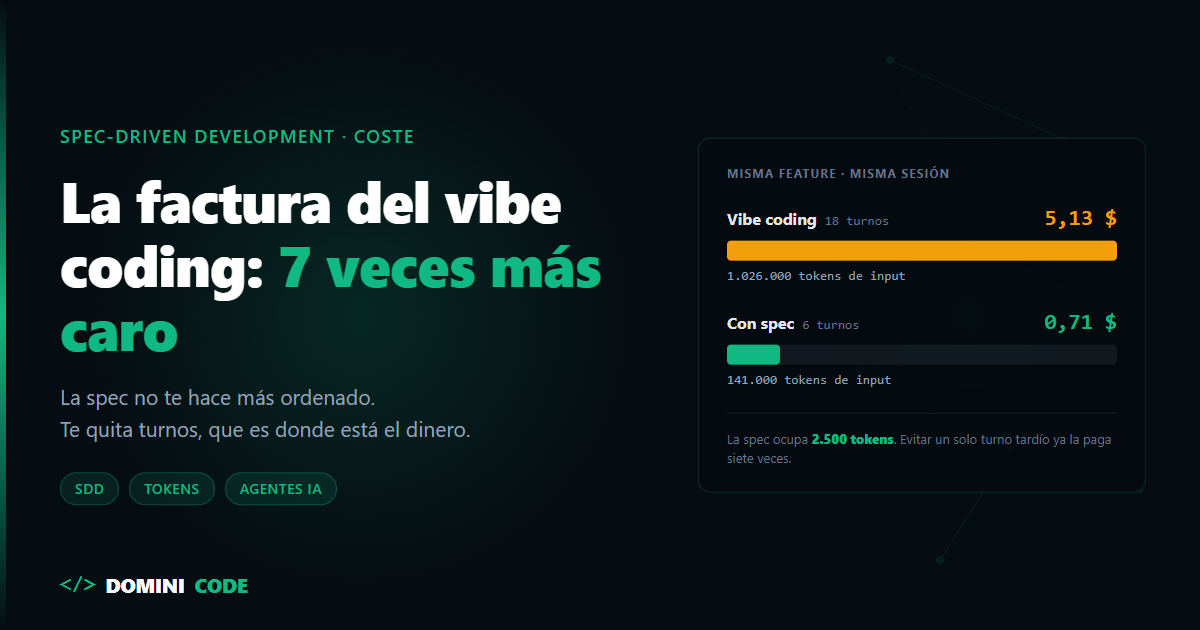
  • La factura del vibe coding: improvisar con un agente sale 7 veces más caro

    La factura del vibe coding: improvisar con un agente sale 7 veces más caro

    "Añade suscripciones con Stripe, cupones de descuento y control de acceso por roles."

    Un prompt. Diecisiete palabras. El agente arrancó con entusiasmo: creó catorce archivos, instaló tres dependencias que no hacían falta, inventó un esquema de base de datos incompatible con el que ya existía y, hacia el paso dieciocho, se puso a arreglar errores de compilación que había provocado él mismo seis pasos antes.

    Cuarenta y cinco minutos después, git reset --hard. Salía más a cuenta tirarlo todo que rescatarlo.

    Esa historia —el vibe coding en estado puro— la hemos vivido todos, y siempre se cuenta igual: en tiempo perdido y en frustración. Nadie mira la otra columna.

    Lo que nadie miró ese día fue la factura. Y es la parte más fácil de calcular, la más incómoda de ver y la que convence a un jefe en treinta segundos, que es más de lo que ha conseguido nunca el argumento de "escribir la spec es buena práctica".

    De qué es SDD, qué lleva dentro un spec.md y cómo se genera el plan.md no voy a hablar aquí: está en por qué Spec-Driven Development triplica tu velocidad. Este post hace una sola cosa: poner precio a improvisar.


    La factura no crece con los turnos: crece con su cuadrado

    Aquí está la parte que casi nadie tiene interiorizada, y sin ella todo el cálculo parece exagerado.

    Un agente no manda tu último mensaje: manda toda la conversación otra vez, en cada turno. Lo que escribiste al principio, la salida de aquel grep, el test que falló en el turno 3. Todo, cada vez.

    Si cada turno añade d tokens al contexto y la sesión dura n turnos, lo que pagas no es n × d. Es esto:

    total = n · base  +  d · n · (n − 1) / 2
                         └──────┬─────────┘
                         el término que te mata
    

    Ese segundo término es cuadrático. En cristiano: duplicar los turnos de una sesión no duplica la factura, la multiplica por casi cuatro. El mecanismo, con la instrumentación para medirlo en tu propio agente, lo desglosé en medir el consumo de tokens de un agente.

    Y ahora la pregunta que conecta las dos mitades del post: ¿qué hace una especificación, exactamente?

    Reduce n.

    No hace al modelo más listo ni al código más bonito. Solo elimina turnos: los de explorar el repositorio a ciegas, los de elegir una librería y cambiarla, los de deshacer, los de arreglar lo que rompió al deshacer. Y como la factura va con el cuadrado de los turnos, quitar turnos por delante es la palanca más potente que existe.


    Las dos sesiones, en números

    Cojamos la sesión de Stripe de arriba y su versión con spec. Mismo modelo, mismo repositorio, misma persona.

    Los supuestos, sobre la mesa antes que los resultados:

    • 6.000 tokens de base por turno: system prompt, definiciones de herramientas, archivos abiertos.
    • 6.000 tokens que se añaden en cada turno: el diff, la salida del test, lo que devuelve cada herramienta.
    • La spec ocupa 2.500 tokens y se paga en todos los turnos, porque viaja en el contexto entera.
    • 18 turnos improvisando, 6 con la spec delante.
    • Precio de entrada: 5 $ por millón de tokens.
    Vibe coding Con spec
    Turnos 18 6
    Base por turno 6.000 8.500 (incluye la spec)
    Tokens de input acumulados 1.026.000 141.000
    Coste de entrada 5,13 $ 0,71 $

    Siete veces. Y no por un truco: los 141.000 son el 13,7 % de 1.026.000, así que el ahorro es del 86 %.

    Fíjate en el detalle que hace daño: los 2.500 tokens de la spec, multiplicados por los seis turnos, suman 15.000 tokens de sobrecoste. Un solo turno tardío de la sesión improvisada —el turno 18, con todo el historial detrás— cuesta 108.000. La especificación se paga siete veces con evitar un único turno al final.

    Estos números son un modelo, no una medición de laboratorio: salen de aplicar la fórmula de arriba a los supuestos declarados. Cambia los tuyos y cambiarán los resultados. Lo que no cambia es la forma de la curva, porque el término cuadrático no depende del precio: si el ratio de turnos es 3 a 1, el ratio de coste ronda 7 a 1 pagues lo que pagues — y llega a 8 a 1 si no cuentas lo que ocupa la propia spec.


    De dónde salen los doce turnos que te ahorras

    No son turnos imaginarios. Son estos, y los reconocerás todos:

    • Reconocimiento. Sin spec, el agente abre archivos "por si acaso" para deducir tu arquitectura. Con la spec, ya sabe qué toca y qué no.
    • Decisiones que tú deberías haber tomado. Elige una librería, la instala, no encaja, la quita. Tres turnos que se resolvían con una línea en el documento.
    • Marcha atrás. Descubre en el turno 12 que el esquema de base de datos no cuadra con lo que ya existe y rehace lo del turno 5.
    • Parches sobre parches. Arregla un error de compilación creando otro, porque ya no recuerda la restricción del primer mensaje.

    Los dos últimos tienen la peor propiedad de todas: son los turnos más caros de la sesión, porque ocurren al final, cuando el contexto ya pesa. En una sesión de 18 turnos, los seis últimos se llevan más de la mitad de la factura.

    Ojo con la conclusión fácil, eso sí: una spec ambigua o incompleta no ahorra nada, porque el agente vuelve a decidir por su cuenta y los turnos regresan. Por qué una especificación falla y qué la hace inservible lo conté en por qué tu spec falla con un agente de IA.

    Y hay un caso en el que este cálculo se da la vuelta: cuando el trabajo es tan pequeño que escribir la spec cuesta más turnos que hacerlo. Los seis escenarios donde no compensa están en cuándo NO usar Spec-Driven Development.


    Cómo medir esto en tu repositorio esta semana

    No hace falta creerme. Tienes los datos en tu historial:

    1. Cuenta los turnos de tus últimas cinco sesiones con el agente. Solo el número, nada más.
    2. Sepáralas en dos montones: las que empezaron con un documento delante y las que empezaron con una frase.
    3. Aplica la fórmula con tu base y tu delta reales, que los saca la instrumentación del post de consumo de tokens en media hora.
    4. Multiplica por sesiones al mes. Ahí es donde el número deja de ser una curiosidad y pasa a ser una cifra de la que hablar en una reunión.

    Si además pagas por suscripción y no por API, el cálculo sigue valiendo: no cambia la factura, cambia cuántas sesiones te caben antes de tocar el límite de uso.

    El flujo completo —de la idea a la spec, y de la spec al agente ejecutando por fases— lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code, y como referencia de consulta está el libro de Spec-Driven Development.

    Una última pieza, porque es la que cierra el círculo: el agente no puede dar una tarea por terminada porque "el código parece correcto". Necesita un test que devuelva 0, y para eso hacen falta suites rápidas y fiables — que es lo que trabajo en el curso de Testing en Angular con Jest y Testing Library. Sin esa comprobación, los turnos de marcha atrás vuelven por la puerta de atrás y con ellos la factura.

    En Dominicode Labs trabajamos así todos los proyectos de la comunidad.

    Escribir la especificación no es burocracia ni buena práctica de manual. Son 2.500 tokens que te ahorran un millón.


    Preguntas frecuentes

    ¿El prompt caching no se come todo este ahorro?

    Lo reduce, no lo elimina. La caché abarata el reenvío del historial ya visto, así que el término cuadrático pasa a costar una fracción — pero solo mientras el prefijo se mantenga idéntico. Y una sesión improvisada es justo la que peor lo mantiene: cada marcha atrás reescribe contexto anterior e invalida la caché a partir de ahí. Con caché el 8 a 1 se estrecha; la dirección no cambia.

    ¿Cuántos tokens puede ocupar la spec para que siga saliendo a cuenta?

    Muchos más de los que vas a escribir. La spec se suma a la base y por tanto cuesta tokens × turnos; un turno tardío evitado cuesta base + delta × (n−1). Con los supuestos de este post, una spec de 10.000 tokens en una sesión de seis turnos sale por 60.000, todavía por debajo de lo que costaba aquel turno 18 en solitario. El límite práctico no es económico: es que una spec larga se lee peor y decide peor.

    ¿Y si trabajo con suscripción en vez de pagar por token?

    El coste cambia de moneda, no desaparece. Con tarifa plana pagas en cuota de uso y en tiempo de espera: la misma sesión cuadrática te consume el límite antes y te deja mirando el reloj. La ventaja de medirlo en tokens es que es la única unidad que no depende de la tarifa que tengas contratada.

    Si la spec está mal escrita, ¿ahorra igual?

    No, y este es el fallo más común. Una spec con huecos —sin decir qué queda fuera de alcance, sin contratos de datos, sin nombrar los archivos que se tocan— devuelve las decisiones al modelo, y con ellas vuelven los turnos de exploración y marcha atrás. Una especificación ambigua tiene el coste de escribirla y ninguno de sus beneficios.

    ¿Merece la pena para un cambio de veinte líneas?

    No. Para un bug acotado o un ajuste de copy, el trabajo cabe en dos o tres turnos y ahí el término cuadrático no ha despegado todavía: la spec es sobrecoste puro. Este cálculo empieza a inclinarse a partir de las sesiones largas, que son precisamente las que hoy nadie planifica.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • OpenSpec y Claude Code: integración paso a paso del flujo OPSX

    OpenSpec y Claude Code: integración paso a paso del flujo OPSX

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso: lo acordado vive en archivos versionados dentro del repo y el agente los lee antes de tocar código.

    Tutorial de integración OpenSpec Claude Code, paso a paso: instalación, inicialización y el flujo OPSX de principio a fin.


    Aviso rápido: OpenSpec no es OpenAPI

    Comparten cuatro letras y nada más.

    OpenSpec es un framework open source de spec-driven development para asistentes de código, de Fission-AI. No describe endpoints REST. Si has llegado buscando Swagger, este no es tu post.

    Lo que hace es meter una capa de especificación entre tú y el agente: propuesta, diseño, tareas y spec del cambio. Todo en Markdown, todo dentro del repo, todo bajo control de versiones.


    Paso 1: instalar (y el error de scope que arrastran los tutoriales viejos)

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto, sin relación con el framework. Es el fallo más repetido en tutoriales de hace unos meses, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Paso 2: inicializar OpenSpec en Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Paso 3: llena el config.yaml antes de pedir nada

    Este paso parece opcional. No lo es.

    openspec/config.yaml no es un README que el agente abre si le apetece. Su contenido se inyecta en cada petición de planificación. Va dentro del prompt, siempre.

    Dedica cinco minutos a describir de verdad tres cosas: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear.

    Un apunte honesto: no inventes claves en el YAML. Completa las que el propio init deja generadas y, si necesitas un campo que no existe, mira la doc oficial.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    Paso 4: el flujo OPSX de principio a fin

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:update y /opsx:sync — mantener la spec viva

    Antes de archivar, el perfil por defecto trae dos comandos más que casi nadie menciona: /opsx:update revisa los artefactos de un cambio si algo se movió a mitad de camino, y /opsx:sync fusiona la delta spec del cambio dentro de las specs generales del proyecto, para que la spec principal quede al día sin tocarla a mano.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y actualiza la fuente de verdad del proyecto. A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    El perfil extendido (y dónde vive /opsx:verify)

    El perfil por defecto (core) trae los seis comandos que acabas de ver: explore, propose, apply, update, sync y archive. Si necesitas control más granular, cambias de perfil:

    openspec config profile
    openspec update
    

    Eso desbloquea /opsx:new, /opsx:continue, /opsx:ff, /opsx:bulk-archive, /opsx:onboard y, el que más se echa en falta, /opsx:verify: contrasta la implementación contra la spec acordada. No es un test runner, es la comprobación de que no se coló nada que nadie pidió y que no falta nada que sí se pidió.

    Empieza sin el perfil extendido. Actívalo cuando el ciclo base (explore → propose → apply → archive) te sepa corto.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Aquí está la decisión de diseño que hace a OpenSpec usable en el mundo real.

    La spec de un cambio no describe tu sistema entero. Describe solo lo que se mueve:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ## REMOVED Requirements
    

    Escenarios en Markdown plano con sintaxis WHEN/THEN. Sin Gherkin, sin herramientas extra, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development. Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto.


    Si vienes de un tutorial de hace unos meses

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano. Vuelve a ejecutar openspec init y deja que la herramienta reconstruya lo suyo.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.

    Dos avisos para terminar. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es volver a ejecutar openspec init en el proyecto en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso. OpenSpec es un framework open source de spec-driven development creado por Fission-AI que guarda lo acordado — propuesta, diseño, tareas y spec — en archivos Markdown versionados dentro del repo, para que Claude Code los lea antes de tocar código. En esta guía lo instalamos, lo inicializamos con openspec init y recorremos el flujo OPSX completo sobre un proyecto que ya existe.


    OpenSpec no es OpenAPI: la diferencia en una tabla

    Comparten cuatro letras y nada más.

    OpenSpec OpenAPI
    Qué es Framework de spec-driven development para asistentes de código Especificación para describir APIs REST
    Quién lo mantiene Fission-AI OpenAPI Initiative (Linux Foundation)
    Formato Markdown dentro del repo YAML o JSON
    Para qué sirve Que un agente implemente lo acordado Que un cliente sepa llamar a tu API

    Si has llegado buscando Swagger, este no es tu post.


    Cómo instalar OpenSpec para Claude Code (y el error de scope de npm)

    OpenSpec se instala como CLI global. Requiere Node.js 20.19.0 o superior, y la versión actual es la 1.8.0.

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto: openspec a secas es la versión 0.0.0 publicada el 9 de abril de 2019, sin relación alguna con el framework y sin una sola actualización desde entonces. Es el fallo más repetido en tutoriales, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Qué crea openspec init en un proyecto con Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Qué poner en openspec/config.yaml (y por qué no es opcional)

    openspec/config.yaml es el archivo donde defines el schema por defecto, el contexto del proyecto y las reglas por artefacto. No es documentación que el agente abre si le apetece: es entrada del modelo. La doc oficial lo dice sin rodeos — "When generating any artifact, your context and rules are injected into the AI prompt".

    Sus claves de nivel superior son cuatro:

    Clave Para qué
    schema El schema por defecto de los artefactos
    context La información de tu proyecto. Aparece en todos los artefactos
    rules Restricciones por artefacto. Solo aparecen en el artefacto que coincide
    operations Guía opcional para apply y archive

    Ese matiz de context y rules importa: el contexto viaja siempre, las reglas solo cuando toca. Así que lo que quieras que el agente tenga presente en cada decisión va en context.

    Dedica cinco minutos a describir de verdad tres cosas ahí: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear. El detalle de cada clave está en la doc de customization.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    El flujo OPSX paso a paso en Claude Code

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y consolida lo implementado en openspec/specs/, que es la fuente de verdad del proyecto — "Specs are the source of truth — they describe how your system currently behaves". A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    Los otros dos del perfil por defecto

    /opsx:update revisa los artefactos de planificación de un cambio y los mantiene coherentes entre sí, en cualquier dirección: si editas el diseño, la propuesta se ajusta.

    /opsx:sync fusiona las delta specs en openspec/specs/ sin archivar el cambio. Útil cuando quieres consolidar antes de cerrar.

    Los extendidos, y por qué /opsx:verify no te va a funcionar todavía

    Aquí está el detalle que hace perder media hora a mucha gente: el perfil por defecto no trae verify.

    El perfil core son los seis de arriba — propose, explore, apply, update, sync, archive. Los extendidos son otros seis: /opsx:new, /opsx:continue, /opsx:ff, /opsx:verify, /opsx:bulk-archive y /opsx:onboard. Si escribes /opsx:verify recién instalado, no autocompleta y no pasa nada.

    Para activarlos:

    openspec config profile   # selecciona el perfil ampliado
    openspec update           # aplica los cambios en el proyecto
    

    Con el perfil ampliado activo, /opsx:verify contrasta la implementación contra la spec. No es un test runner: es la comprobación de que no se ha colado nada que nadie pidió y de que no falta nada que sí se pidió.

    Empieza por los seis del perfil core. Los extendidos los necesitarás cuando tengas el ciclo rodado y lleves varios cambios a la vez.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Una delta spec es una spec que describe solo lo que cambia — lo añadido, lo modificado y lo eliminado — en vez de redescribir el sistema entero. Es lo que hace viable OpenSpec en un proyecto que ya existe.

    Así se ve una:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - GIVEN el listado de productos cargado
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ### Requirement: Paginación del listado
    El listado DEBE conservar el filtro activo al cambiar de página.
    

    Dos cosas que conviene saber antes de copiar esto. Las etiquetas son literales y no se traducen: ADDED, MODIFIED, REMOVED, Requirement:, Scenario: y GIVEN/WHEN/THEN van en inglés aunque el cuerpo esté en español. Y solo incluyes las secciones que uses — si el cambio no elimina nada, no dejes un ## REMOVED Requirements vacío.

    Sobre los escenarios: es vocabulario Gherkin, pero en Markdown plano. Sin ficheros .feature, sin Cucumber, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development.

    Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto. La lista completa está en la tabla de herramientas soportadas, que cubre más de treinta.


    Cómo migrar del flujo antiguo de OpenSpec al flujo OPSX

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano: ejecuta openspec update, que regenera los ficheros de skills y comandos para las herramientas que tengas configuradas.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Dos avisos antes de que te lances. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Por qué no me funciona el comando /opsx:verify?

    Porque no viene en el perfil por defecto. OpenSpec usa el perfil core, que trae seis comandos: propose, explore, apply, update, sync y archive. El comando verify pertenece al perfil ampliado, junto a new, continue, ff, bulk-archive y onboard. Para activarlo ejecuta openspec config profile y después openspec update.

    ¿Qué comandos trae OpenSpec por defecto?

    El perfil core incluye seis: propose para generar la propuesta, explore para planificar sin compromiso, apply para implementar, update para mantener coherentes los artefactos de planificación, sync para fusionar las delta specs en openspec/specs/ y archive para cerrar el cambio.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es ejecutar openspec update en el proyecto, que regenera skills y comandos, en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
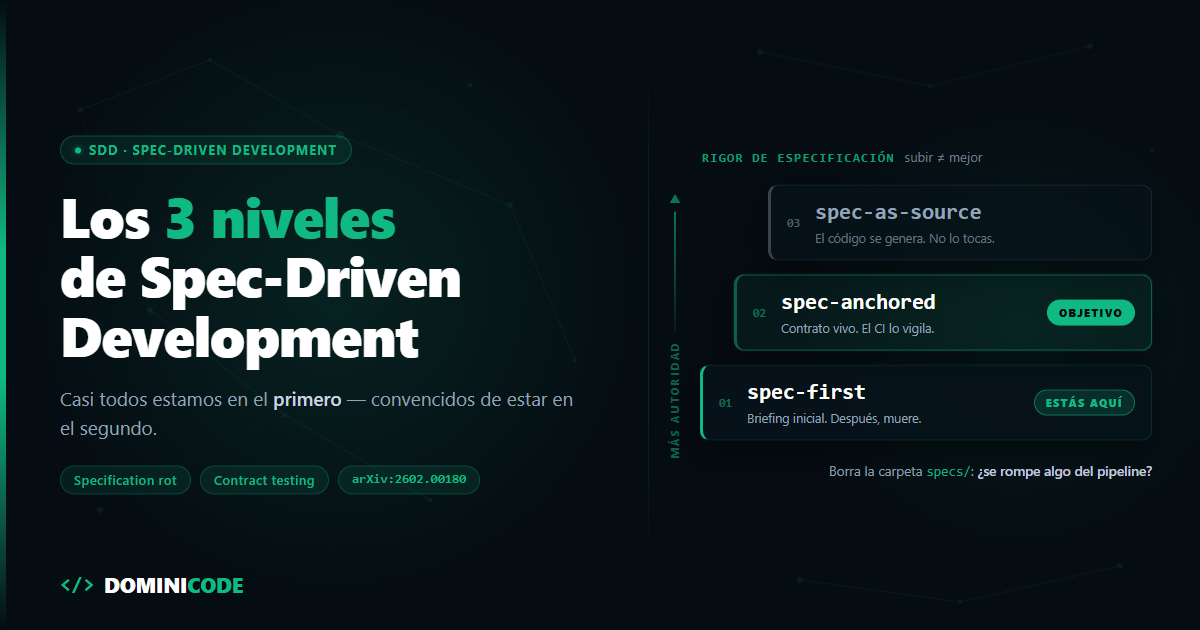
  • Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Hace unas semanas abrí un repo mío de febrero. Fui a la carpeta specs/. Ahí seguía todo: spec.md, plan.md, tasks.md.

    El spec.md describía tres endpoints. El código tenía once.

    La spec no estaba mal escrita. Estaba muerta. Cinco meses sin tocarla mientras el código crecía por su cuenta. Y lo peor es que todo funcionaba: los tests pasaban, el deploy iba, nadie se enteró de nada.

    Yo llevaba meses diciendo que hacía SDD. No lo hacía. Hay tres niveles de Spec-Driven Development y yo estaba en el primero convencido de estar en el segundo.

    Esto no va de qué es SDD. Va de diagnóstico: en qué nivel estás de verdad y a cuál te conviene subir. Que no siempre es el de arriba.

    El test de los 30 segundos: borra la carpeta specs/

    Antes de leer nada más, hazte esta pregunta.

    Si borras la carpeta specs/ de tu proyecto ahora mismo, ¿se rompe algo del pipeline?

    Si la respuesta es no —si el build sigue verde, los tests pasan y el deploy sale— entonces tu spec es un documento, no un artefacto de ingeniería. Eres spec-first. Da igual lo bien escrita que esté. Da igual que tengas constitution.md y siete plantillas.

    Nada que se pueda borrar sin consecuencias forma parte del sistema.

    Y ojo, que esto no es un insulto. Spec-first es un nivel legítimo y para la mitad de tus proyectos es exactamente el que necesitas. El problema no es estar ahí. El problema es estar ahí creyendo que estás dos escalones más arriba, y por tanto confiando en garantías que no tienes.

    Qué son los tres niveles de rigor de especificación

    Deepak Babu Piskala publicó el 30 de enero de 2026 el preprint Spec-Driven Development: From Code to Contract in the Age of AI Coding Assistants (arXiv:2602.00180, cs.SE). Es el primer sitio donde he visto puesto por escrito, con nombres, lo que la mayoría hacemos por intuición.

    El paper define tres niveles de rigor de especificación: spec-first, spec-anchored y spec-as-source. Lo único que cambia entre ellos es cuánta autoridad tiene la spec sobre el código — el eje de su primera figura se llama literalmente increasing specification authority.

    No son fases de madurez que haya que recorrer. Son opciones, y cada una tiene un coste.

    Nivel La spec es… ¿Quién escribe el código? ¿Qué pasa con el drift? Es tu nivel si…
    Spec-first Un briefing inicial Tú o el agente al arrancar; después, solo tú Ocurre en silencio, nadie se entera Prototipos, features puntuales, exploración
    Spec-anchored Un contrato vivo Tú, con la spec como referencia obligatoria Lo detecta el CI si lo automatizas; si no, rot La mayoría de sistemas en producción
    Spec-as-source El único artefacto que un humano edita Nadie. Se genera No existe por construcción Automoción, embebidos, dominios certificados

    Spec-first: la spec guía el arranque

    Definición del paper: la especificación se escribe antes de programar para guiar la implementación inicial.

    Ahí está la palabra clave: inicial. La spec hace su trabajo en el minuto cero y después su vida útil se acaba. El agente genera el código, tú lo revisas, y desde ese momento el código es la única fuente de verdad.

    El paper es explícito: spec-first funciona en desarrollo inicial de features con asistentes de IA, y en prototipos y features de usar y tirar.

    Es donde está casi todo el mundo que usa Claude Code o Cursor con un spec.md delante. Y para mucho de lo que hacemos, está perfecto. Escribes la spec, el agente construye, tú corriges, sigues adelante. Es el flujo que enseño en el curso de Construye con IA para ir de idea a producto sin caos.

    El fallo no es usar spec-first. El fallo es usar spec-first en un sistema que va a vivir tres años y con cuatro personas tocándolo.

    Spec-anchored: la spec vive con el código

    Definición del paper: la especificación se mantiene junto al código durante todo el ciclo de vida del sistema.

    Y aquí viene la frase que a mí me hizo replantearme cosas. El paper llama a spec-anchored el punto óptimo para la mayoría de sistemas en producción, porque te da los beneficios de documentación clara y requisitos verificables sin exigir que el código se genere entero.

    Traducido: tienes las garantías sin renunciar a escribir código.

    El riesgo de este nivel tiene nombre propio en el paper: specification rot. La podredumbre de la especificación, que aparece cuando los equipos no actualizan las specs a medida que el código cambia. Exactamente lo que le pasó a mi repo de febrero.

    Y la solución que propone el paper no es disciplina. Es automatización: los tests imponen la alineación entre spec y código, con escenarios BDD funcionando como tests automáticos que corren en cada commit.

    Esa es la diferencia real entre los dos primeros niveles. No es cuánto cuidas la spec. Es si la alineación depende de tu voluntad o de un check que falla el build.

    Spec-as-source: la spec es el código

    Definición del paper: la especificación es el único artefacto que los humanos editan directamente. El código se genera enteramente a partir de la spec.

    La regla operativa que da el paper es tajante: si quieres cambiar la funcionalidad, cambias la spec y regeneras. Nunca editas el código generado directamente.

    El drift desaparece. No se gestiona, no se detecta: no puede existir. Como el código se regenera en lugar de editarse a mano, spec y código están siempre alineados por construcción.

    Suena a futuro lejano. No lo es, y esto es lo que más me sorprendió del paper.

    Spec-as-source ya existe. Y una parte ya la haces

    Hay una idea instalada de que spec-as-source es hacia dónde vamos cuando los LLM sean lo bastante buenos.

    Falso. El paper lo desmonta con una frase: spec-as-source ya es práctica estándar en dominios con generación de código bien definida, y pone dos ejemplos. Uno es generar código embebido certificado desde modelos de Simulink. En la capa de control, el ingeniero rara vez escribe a mano el C que acaba en la ECU: escribe el modelo, y el generador produce el C.

    El otro ejemplo del paper es generar los stubs de servidor desde un openapi.yaml.

    Eso también es spec-as-source. Y llevas años haciéndolo sin llamarlo así: editas el contrato, regeneras, nunca tocas a mano lo generado. Es exactamente la regla del nivel tres.

    La diferencia es qué generas. Ahí generas el andamio. Nadie ha certificado un generador para la lógica de negocio.

    Entonces, ¿por qué no puedes hacer lo mismo con la lógica de tu app de Next.js?

    Porque, según el paper, spec-as-source solo es práctico hoy en dominios donde esa confianza está establecida. El paper no entra en por qué, pero la respuesta no está en el modelo: está en el toolchain. Generadores cualificados bajo norma, trazabilidad auditable y décadas de proceso detrás.

    Tu lógica de negocio no tiene eso. No porque la IA no dé la talla, sino porque no hay un organismo que responda cuando el código generado la líe en producción.

    Así que spec-as-source completo no es tu nivel hoy si haces web. Y no pasa nada. Perseguirlo con las herramientas actuales es la forma más rápida de acabar con el peor de los dos mundos: código generado que nadie entiende y una spec que tampoco es la fuente real de verdad.

    Qué cuesta subir de spec-first a spec-anchored

    Este es el salto que sí te interesa. Y es más barato de lo que parece, porque no va de escribir más documentación. Va de cerrar el bucle.

    El paper describe un flujo de cuatro fases: Specify → Plan → Implement → Validate.

    La mayoría hacemos tres. Especificamos, planificamos, implementamos, y en cuanto la feature funciona nos vamos a la siguiente. Validate se queda sin hacer. Y para mí, Validate es la fase que convierte spec-first en spec-anchored.

    En un proyecto normal de TypeScript, el salto son tres movimientos concretos.

    Uno: los criterios de aceptación de la spec dejan de ser prosa y pasan a ser tests. Cada comportamiento descrito en la spec tiene un test que lo verifica. Si la spec dice que un usuario sin permisos recibe un 403, hay un test que lo comprueba. Si no puedes escribir ese test, tu spec no era verificable — que es uno de los motivos por los que una spec falla con un agente de IA aunque esté impecablemente redactada.

    Dos: los contratos se validan contra la implementación. El paper lista aquí las herramientas por categoría: OpenAPI y Swagger, GraphQL SDL o Protocol Buffers para las specs de API, y Pact o Specmatic para contract testing. Tu openapi.yaml deja de ser documentación y pasa a ser el árbitro. Si el backend devuelve un campo que el contrato no declara, falla.

    Tres: eso corre en CI y rompe el build.

    # .github/workflows/ci.yml
    on: [push, pull_request]
    
    jobs:
      spec-alignment:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v5
          - run: npm ci
          - run: npm run test:contract     # implementación vs openapi.yaml
          - run: npm run test:acceptance   # escenarios derivados de la spec
    

    Ese bloque es la frontera entre los dos niveles. El día que alguien añade un endpoint sin tocar el contrato, el build se pone rojo antes de que llegue a review. La alineación deja de depender de que te acuerdes.

    Sobre el retorno de esto, el paper documenta un caso de estudio de microservicios API-first con OpenAPI y Specmatic con una reducción del 75% en el tiempo de ciclo de integración. Es un caso concreto del paper, no una media del sector, y conviene leerlo como lo que es: una señal de dónde está el valor, no una promesa.

    La parte incómoda es que este salto se apoya en tener una cultura de testing decente. Si tu suite de tests es frágil, spec-anchored no te va a salvar: vas a tener dos cosas rotas en vez de una. Arregla primero los tests — y si tu stack es Angular, esa base la trabajo entera con Jest y Testing Library en el curso de Testing en Angular, que es la misma disciplina en cualquier proyecto de TypeScript.

    El fallo que sobrevive a todos los niveles

    Hay una trampa que no se arregla subiendo de nivel, y el paper la nombra sin anestesia: los tests de spec que pasan no garantizan software correcto si las specs están mal.

    Falsa confianza. Para mí es el fallo más caro de los cuatro que lista el paper —junto a la sobre-especificación, la podredumbre de la spec y convertir las specs en burocracia— porque los otros tres se notan y este no.

    Tienes el CI verde, el contrato validado, los escenarios BDD pasando. Y estás construyendo con enorme rigor exactamente lo que el negocio no pidió.

    Por eso el paper reformula el rol del developer: pasamos de programar a mano a orquestar especificaciones, revisar salidas de IA y centrarnos en el diseño de alto nivel. Si tu spec es mala, subir de nivel solo automatiza el error y le pone un sello de calidad encima.

    La regla de oro del Spec-Driven Development: usa el mínimo rigor

    El paper cierra con un marco de decisión que merece la pena tener a mano. SDD aporta valor cuando hay asistencia de IA de por medio, requisitos complejos, sistemas de vida larga, varios mantenedores, generación de código viable o integración complicada. Y hay que saltárselo en prototipos desechables, trabajo en solitario de vida corta, código exploratorio o CRUD simple con requisitos evidentes.

    Que es básicamente lo que ya defendí en su día al hablar de cuándo no usar Spec-Driven Development, y me alegra ver que el paper llega a la misma conclusión.

    Porque el principio rector que se lleva el paper, y el que yo me he apuntado, es este:

    Usa el mínimo nivel de rigor de especificación que elimine la ambigüedad en tu contexto.

    Subir de nivel no es mejor. Es más caro. Spec-anchored en un script que vas a borrar en dos semanas no es madurez profesional, es ceremonia. Y spec-first en la plataforma que factura no es agilidad, es deuda con fecha de vencimiento.

    Lo que puedes hacer hoy, en diez minutos: coge tu proyecto más importante y aplícale el test de los 30 segundos. Borra mentalmente la carpeta specs/. Si no se rompe nada y ese proyecto va a vivir más de seis meses con más de una persona tocándolo, ya sabes cuál es tu siguiente PR. No es escribir más spec. Es añadir el check que la vuelve obligatoria.

    Si quieres el método completo —cómo redactar specs que un agente ejecuta sin inventarse la mitad y cómo mantenerlas vivas sin que se conviertan en burocracia— lo desarrollo entero en el libro de Spec-Driven Development. Y en Dominicode Labs tienes los proyectos donde esto está montado tal cual lo uso en producción, con el CI incluido.

    Preguntas frecuentes

    ¿Cuáles son los tres niveles de Spec-Driven Development?

    Spec-first, spec-anchored y spec-as-source. En spec-first la spec guía la implementación inicial y después puede quedar obsoleta. En spec-anchored la spec se mantiene junto al código durante todo el ciclo de vida y hay tests que verifican la alineación. En spec-as-source la spec es el único artefacto que edita un humano y el código se genera entero a partir de ella. Los definió Deepak Babu Piskala en el preprint arXiv:2602.00180.

    ¿Spec-first significa que lo estoy haciendo mal?

    No. Spec-first es un nivel legítimo y el paper lo recomienda explícitamente para prototipos, features de usar y tirar y desarrollo inicial con asistentes de IA. El problema aparece cuando aplicas spec-first a un sistema de vida larga y asumes garantías de trazabilidad que ese nivel no te da.

    ¿Cómo sé si mi spec está viva o solo bien escrita?

    Comprueba si algo del pipeline depende de ella. Si puedes borrar la spec y el build sigue verde, la spec es documentación. Una spec viva rompe algo cuando desaparece o cuando el código se desvía de ella, porque hay tests o validaciones de contrato que la usan como referencia.

    ¿Necesito Cucumber o BDD para ser spec-anchored?

    No obligatoriamente. El paper menciona los frameworks BDD (Cucumber, SpecFlow, Behave) como la forma habitual de que los escenarios se conviertan en tests automáticos, pero lo que define el nivel es que exista una verificación automática de la alineación, no la herramienta concreta. Con contract testing sobre OpenAPI usando Pact o Specmatic ya cumples el requisito.

    ¿Spec-as-source llegará algún día al desarrollo web?

    En parte ya llegó: generar los stubs de servidor desde un openapi.yaml es el ejemplo de spec-as-source que el propio paper pone, y es desarrollo web. Lo que no ha llegado es la lógica de negocio, y el cuello de botella no es la capacidad del modelo sino la confianza en el generador. En automoción y embebidos spec-as-source ya es práctica estándar desde hace años con Simulink o SCADE, y una de las razones es que esos generadores están cualificados bajo norma y auditados.

    Si mis tests de spec pasan, ¿está el software correcto?

    No. El paper lo advierte de forma directa: que los tests de spec pasen no garantiza que el software sea correcto si las propias specs son incorrectas. Verificar que cumples la spec y validar que la spec era la adecuada son dos problemas distintos, y el segundo sigue siendo humano.

    ¿Merece la pena spec-anchored si trabajo solo?

    Depende de la vida del proyecto, no del tamaño del equipo. El paper desaconseja SDD en trabajo en solitario de vida corta, pero si eres solo tú manteniendo algo durante años, el "otro mantenedor" eres tú dentro de ocho meses sin recordar nada. Ahí el contrato en CI te protege igual que protegería a un equipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.