Tag: Python

  • Python 3.15: novedades que cambian tu código y tus scripts

    Python 3.15: novedades que cambian tu código y tus scripts

    Vienes de TypeScript y escribes .toUpperCase() en Python sin querer. Python te devuelve un AttributeError seco que no ayuda nada.

    En Python 3.15 ese error termina con una sugerencia: Did you mean '.upper'?. Dice mucho de quién va a notar esta versión: quien usa Python como segundo lenguaje, para scripts y agentes.

    Pero la misma release trae otro cambio que no lanza ningún error. Solo hace que tu script lea un CSV distinto al de ayer.

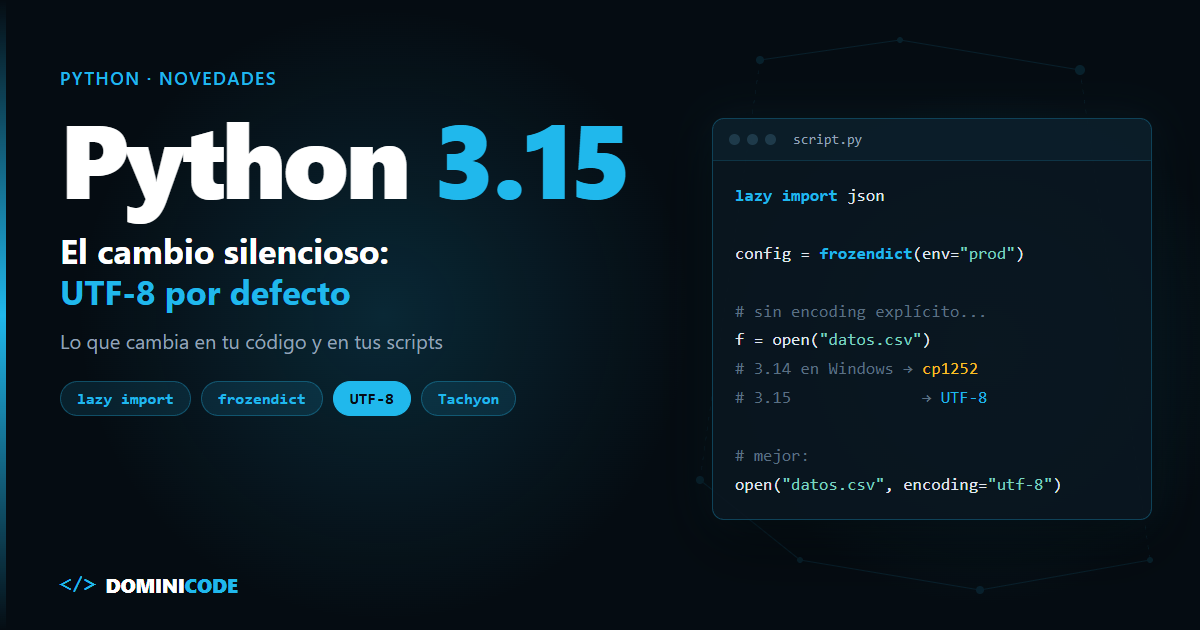
    En corto: Python 3.15.0 salió el 9 de octubre de 2026. Trae lazy import para arrancar más rápido, frozendict y sentinel como built-ins, unpacking con * en comprehensions y un profiler de muestreo llamado Tachyon. El cambio que más puede romperte es silencioso: UTF-8 pasa a ser la codificación por defecto, y eso afecta sobre todo a scripts en Windows.

    ¿Qué es Python 3.15 y cuándo salió?

    Python 3.15 es la versión estable de CPython publicada el 9 de octubre de 2026, con unos 5.643 commits de 1.012 contribuidores respecto a la 3.14.

    Las cifras vienen del anuncio oficial de Hugo van Kemenade, release manager de la 3.15. Estaba prevista para el 1 de octubre, pero un rc3 sorpresa la retrasó al 9 por un motivo que cuento más abajo. El calendario final está en la PEP 790. La lista completa está en el What's New in Python 3.15.

    Novedades de Python 3.15 que afectan a tu código

    Las novedades con impacto real en scripts, APIs y agentes, todas confirmadas en la documentación oficial:

    Novedad Qué hace A quién afecta Riesgo o límite
    lazy import (PEP 810) Retrasa la carga de un módulo hasta su primer uso CLIs, agentes y apps con arranque lento Los ImportError aparecen al usar el módulo, no al arrancar
    UTF-8 por defecto (PEP 686) open(), stdio y pipes usan UTF-8 sin importar el locale Scripts en Windows que leen o escriben texto Archivos en cp1252 pueden leerse mal sin error visible
    frozendict (PEP 814) Diccionario inmutable y hasheable Configuración, cachés, claves compuestas No es subclase de dict: isinstance(x, dict) da False
    sentinel() (PEP 661) Crea valores centinela con buen repr y pickling Autores de librerías y APIs con defaults opcionales Sin equivalente nativo en versiones anteriores
    Unpacking en comprehensions (PEP 798) [*L for L in lists] aplana listas Cualquiera que transforme datos Sintaxis nueva: rompe en 3.14 o anteriores
    profiling.sampling / Tachyon (PEP 799) Profiler de muestreo que se engancha a procesos vivos Quien depura rendimiento en producción Requiere permisos elevados para hacer attach
    JIT experimental mejorado 7-8% de media en x86-64 Linux, 11-12% en AArch64 macOS Código Python puro intensivo en CPU Sigue siendo experimental; rango de -15% a +100% según el benchmark
    Mensajes de error Sugerencias tipo Did you mean '.append'? Developers que vienen de JS/TS Ninguno relevante

    Lazy imports en Python 3.15: arrancar sin cargar lo que no usas

    Un lazy import es un import que enlaza el nombre al momento, pero solo carga el módulo la primera vez que lo usas. Hasta ahora Python cargaba todo al arrancar, aunque tu CLI solo fuera a ejecutar --help.

    La sintaxis oficial es esta:

    lazy import json
    lazy from pathlib import Path
    
    print("Starting up...")  # json y pathlib aún no se han cargado
    
    data = json.loads('{"key": "value"}')  # json se carga aquí
    p = Path(".")  # pathlib se carga aquí
    

    Piensa en un agente que importa pandas, un SDK de LLM y un cliente de base de datos, pero casi siempre usa solo uno. Con lazy, pagas cada import cuando lo necesitas.

    Hay reglas que la PEP 810 deja claras. Solo funciona a nivel de módulo: dentro de funciones, clases o bloques try es SyntaxError. lazy from module import * también lo es.

    Si mantienes una librería que debe seguir funcionando en 3.14, la PEP ofrece __lazy_modules__: un set de nombres de módulo que la 3.15 trata como lazy y las versiones anteriores ignoran. Es el puente de migración.

    UTF-8 por defecto en Python 3.15: el cambio que no hace ruido

    Desde Python 3.15, si no pasas encoding, Python usa UTF-8 para archivos, stdio y pipes, sin importar el locale del sistema. La PEP 686 lo resume: en la mayoría de sistemas Unix ya era así, de modo que el cambio afecta sobre todo a Windows.

    La novedad que más te va a costar no es la más vistosa. Es esta.

    Un script de automatización que lee un CSV exportado desde Excel en Windows probablemente funcionaba porque el default era cp1252 y el archivo también. En 3.15 lo leerá como UTF-8. Si tienes suerte, UnicodeDecodeError. Si no, caracteres corruptos que nadie ve hasta que llegan a tu base de datos. La propia PEP habla de posible corrupción silenciosa de datos.

    La solución es explícita. Antes de actualizar, activa el aviso de codificación en 3.14 para encontrar cada llamada sin encoding:

    python -X warn_default_encoding tu_script.py
    

    Después, añade encoding="utf-8" donde el archivo sea UTF-8 y encoding="locale" donde dependas de la codificación del sistema. Si necesitas tiempo, PYTHONUTF8=0 o -X utf8=0 restauran el comportamiento anterior.

    Este es el tipo de bug que repasé en los errores de Python en automatización: el código no falla, falla el dato.

    frozendict, unpacking y mejores errores en Python 3.15

    frozendict es el diccionario inmutable built-in de Python 3.15: no admite asignaciones y es hasheable si sus claves y valores lo son. Sirve como clave de caché o para configuración que nadie debe mutar:

    >>> a = frozendict(x=1, y=2)
    >>> a['z'] = 3
    TypeError: 'frozendict' object does not support item assignment
    >>> hash(a) == hash(frozendict(y=2, x=1))
    True
    

    El unpacking en comprehensions elimina el doble for que siempre había que releer dos veces:

    >>> lists = [[1, 2], [3, 4], [5]]
    >>> [*L for L in lists]
    [1, 2, 3, 4, 5]
    
    >>> dicts = [{'a': 1}, {'b': 2}, {'a': 3}]
    >>> {**d for d in dicts}
    {'a': 3, 'b': 2}
    

    Si preparas contexto para un LLM fusionando metadatos de varios documentos, {**d for d in dicts} es justo el patrón que usarías. Lo aplico a ese caso en cómo preparar datos para agentes de IA con Python.

    Y los errores ya entienden a quien viene de JavaScript: 'list' object has no attribute 'push'. Did you mean '.append'?. El resto de diferencias están en Python para developers JavaScript.

    Tachyon: profiling de un proceso en marcha

    Tachyon es el profiler de muestreo de Python 3.15: lee el stack de un proceso en marcha desde fuera, sin instrumentar el código ni reiniciarlo.

    El nuevo paquete profiling agrupa el profiler determinista de siempre (profiling.tracing, el antiguo cProfile) y uno nuevo de muestreo, Tachyon, en profiling.sampling. Según el What's New, puede muestrear hasta 1.000.000 Hz (por defecto usa 1 kHz).

    Lo interesante para agentes y workers de larga duración es que se engancha a un proceso vivo:

    python -m profiling.sampling attach --flamegraph -d 30 -o profile.html 12345
    

    Treinta segundos de muestreo y un flamegraph en HTML, sin reiniciar nada. La documentación de profiling.sampling avisa: necesita permisos elevados (root o CAP_SYS_PTRACE en Linux, root en macOS, administrador en Windows, entre otras opciones) y la misma versión menor en profiler y proceso.

    Cómo probar Python 3.15 hoy con uv

    Si usas uv, el post de Astral sobre la 3.15 recomienda actualizar uv primero:

    uv self update
    uv python upgrade 3.15
    uv run --python 3.15 python -c "import sys; print(sys.version)"
    

    Las builds de python-build-standalone con 3.15.0 están en la release 20261009. Crea un entorno aparte, corre tus tests y no toques el Python del sistema.

    Cuándo NO actualizar a Python 3.15 todavía

    Pruébala ya. No la pongas en producción esta semana. Tres motivos.

    Tus dependencias pueden no tener wheels. En el anuncio del rc3, Hugo van Kemenade contaba que el 22,2% de los 360 paquetes más populares ya declaraba soporte para 3.15. La mayoría aún no. Si una dependencia con extensiones en C no publica wheel, pip intentará compilarla. Revisa el árbol antes, como explico en auditar dependencias de npm y pip.

    Los lazy imports acaban de estabilizarse. El rc3 existió precisamente por "last-minute lazy-import release blockers", según el mismo hilo. Espera al menos a la 3.15.1 antes de llenar tu código de lazy.

    Hay eliminaciones que rompen. Se van sre_compile, sre_parse, Loader.load_module(), CGIHTTPRequestHandler y PurePath.is_reserved(), entre otras. Y la política de event loops de asyncio, incluida WindowsSelectorEventLoopPolicy, está deprecada para eliminarse en 3.16. Si tu script en Windows la usa para evitar problemas con el event loop, la alternativa oficial es asyncio.run(main(), loop_factory=asyncio.SelectorEventLoop).

    Qué opina la comunidad de Python 3.15

    En el hilo de Hacker News de la release, con más de 300 puntos, varios comentarios celebran por fin los lazy imports, frozendict y el unpacking en comprehensions. Simon Willison apunta otro efecto: cada release nueva marca el fin de soporte de una vieja, en este caso la 3.10, y eso permite a los mantenedores de librerías usar por fin features de la 3.11.

    Nathan Goldbaum destaca el nuevo ABI estable abi3t para la build free-threaded, que facilita que las librerías con C soporten Python sin GIL.

    Qué hacer hoy con Python 3.15

    Una sola cosa: ejecuta tu suite o tu script más importante con -X warn_default_encoding en tu versión actual. Cada aviso es un sitio donde la 3.15 puede cambiarte un dato sin decírtelo. Arréglalo con encoding explícito y la migración será aburrida, que es como debe ser.

    Si usas Python para construir agentes, el ebook gratuito El Developer Agéntico cubre la arquitectura completa: tools, memoria, RAG y MCP. Y si quieres llevar ese agente de la idea a producto con Claude Code, es lo que hacemos en Construye con IA.

    Preguntas frecuentes

    ¿Cuándo salió Python 3.15?

    Python 3.15.0 se publicó el 9 de octubre de 2026. Estaba prevista para el 1 de octubre, pero el equipo de release añadió un tercer release candidate para resolver bloqueantes de última hora en los lazy imports.

    ¿Los lazy imports de Python 3.15 son automáticos?

    No. Por defecto solo son lazy los imports que llevan la palabra lazy. Existe un modo global con -X lazy_imports=all o la variable PYTHON_LAZY_IMPORTS, pero la PEP 810 lo presenta como una opción avanzada, no pensada para librerías.

    ¿Python 3.15 rompe mis scripts en Windows?

    Puede hacerlo si lees o escribes archivos de texto sin indicar encoding y esos archivos no son UTF-8. Python 3.15 usa UTF-8 por defecto. Añade encoding explícito o desactiva el modo con PYTHONUTF8=0 mientras migras.

    ¿El JIT de Python 3.15 está listo para producción?

    Sigue siendo experimental. La documentación oficial reporta una mejora media del 7-8% en x86-64 Linux y del 11-12% en AArch64 macOS, pero con un rango que va desde un 15% más lento hasta más del doble de rápido según el benchmark. Mide tu caso antes de confiar en él.

    ¿frozendict sustituye a dict?

    No. Es un tipo distinto, inmutable y hasheable, y no hereda de dict. Úsalo para configuración y claves de caché. Ojo con el código que comprueba isinstance(x, dict), porque devolverá False.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • El Python que necesitas si construyes agentes en TypeScript

    El Python que necesitas si construyes agentes en TypeScript

    Tu producto está en TypeScript. Tu agente también.

    Y aun así, en algún momento vas a acabar escribiendo Python. No porque quieras cambiar de lenguaje, sino porque entre tus datos en crudo y el contexto que lee tu agente hace falta una capa que transforme lo uno en lo otro, y esa capa se escribe casi siempre en Python.

    No es un curso de Data Science. No hace falta álgebra lineal, ni estadística inferencial, ni un notebook con gráficos bonitos. Hacen falta cuatro operaciones, y con ellas se resuelve prácticamente todo lo que un agente necesita que le den masticado.

    Empiezo por el número que justifica el post entero.


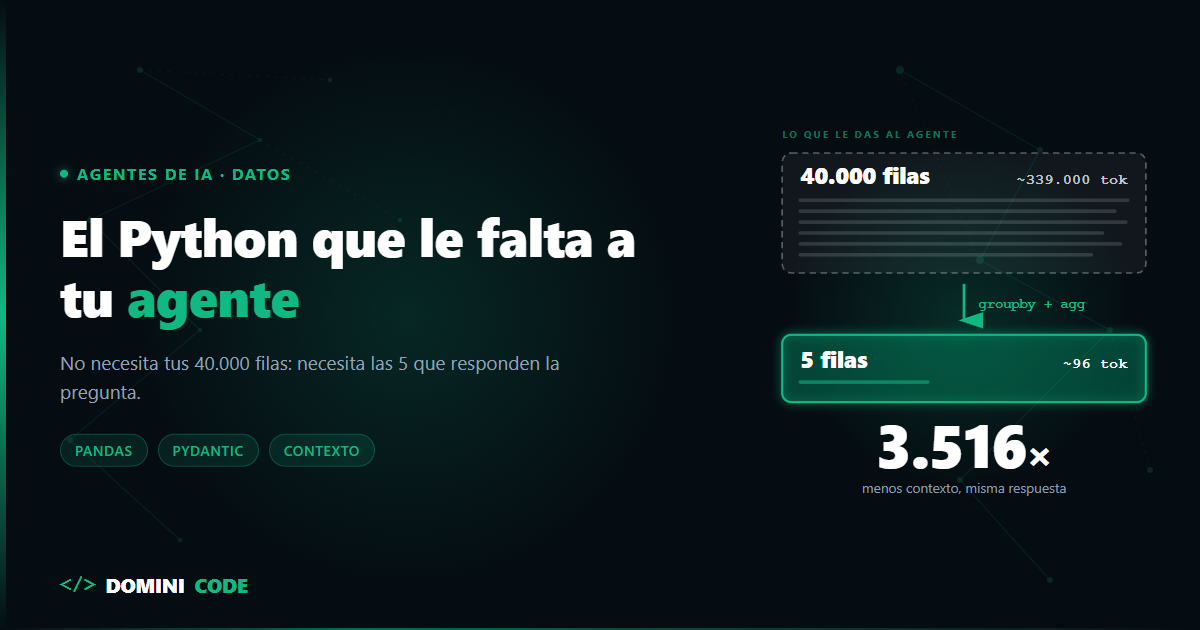
    339.276 tokens contra 96

    Tengo una exportación de ventas: 40.000 filas, cinco columnas. La pregunta que quiero que responda el agente es sencilla: ¿qué curso conviene empujar el mes que viene?

    La forma perezosa es meterle el CSV entero en el contexto. Vamos a medir qué significa eso:

    import pandas as pd
    
    df = pd.read_csv("ventas.csv")          # 40.000 filas
    
    crudo = df.to_csv(index=False)
    
    resumen = (df.groupby("curso")
                 .agg(ventas=("precio", "size"),
                      ingresos=("precio", "sum"),
                      tasa_completado=("completado", "mean"))
                 .round(2)
                 .reset_index()
                 .sort_values("ingresos", ascending=False))
    
    compacto = resumen.to_json(orient="records")
    
    print(f"crudo   : {len(crudo):,} caracteres")
    print(f"resumen : {len(compacto):,} caracteres")
    print(f"factor  : {len(crudo)/len(compacto):,.0f}x")
    

    Resultado:

    crudo   : 1.357.104 caracteres
    resumen :       386 caracteres
    factor  :     3.516x
    

    A razón de unos cuatro caracteres por token, eso es pasar de ~339.000 tokens a ~96. Y esto es lo que ve el agente después de la reducción:

         curso  ventas  ingresos  tasa_completado
            IA    8792 439512.08             0.27
       Angular   12349 370346.51             0.48
    TypeScript    9522 190344.78             0.39
       Testing    5621 168573.79             0.55
          Node    3716  74282.84             0.34
    

    Cinco filas. Y ahí dentro ya está la respuesta, que además no es la obvia: IA es lo que más factura pero tiene la peor tasa de finalización (0,27), y Testing es lo que menos factura con la mejor con diferencia (0,55). Ese contraste no se ve en 40.000 filas ni lo va a encontrar un modelo leyéndolas.

    Esto no va de ahorrar dinero, aunque también. Va de que un modelo con 40.000 filas delante tiene 40.000 oportunidades de fijarse en lo que no toca. Reducir no es una optimización: es parte de la respuesta. Es exactamente el argumento de context engineering para estructurar la memoria de tus agentes, aplicado a la capa de datos. Y si quieres ver a dónde se te va la factura, lo desglosé en medir el consumo de tokens de un agente.


    Las cuatro operaciones

    Todo lo que necesitas hacer con Python en este contexto cae en una de estas cuatro:

      1. CARGAR   →  CSV, SQL, JSON, Parquet
      2. LIMPIAR  →  tipos, nulos, duplicados
      3. REDUCIR  →  agrupar, agregar, ordenar
      4. VALIDAR  →  esquema antes de entregar
      ─────────────────────────────────────────
      la 3 es la que decide si el agente acierta
    

    No hay una quinta. Si te encuentras entrenando un modelo, te has ido del carril.


    1 y 2. Cargar y limpiar

    Pandas carga desde casi cualquier sitio con una línea, y el 90% del trabajo de limpieza son tres cosas:

    import pandas as pd
    
    df = pd.read_csv("ventas.csv", parse_dates=["fecha"])
    
    df = df.drop_duplicates(subset=["id_pedido"])       # duplicados por clave
    df = df.dropna(subset=["curso", "precio"])          # filas sin lo esencial
    df["precio"] = pd.to_numeric(df["precio"], errors="coerce")
    

    Ese errors="coerce" es el detalle que más disgustos evita: convierte a NaN lo que no se pueda parsear en vez de reventar. Un CSV real siempre trae una celda con "29,99 €" donde esperabas un número.

    Dos cosas que muerden el primer día:

    El filtrado es una máscara booleana. df["completado"] devuelve una serie de True/False, y df[mascara] se queda con las filas donde es True. Con condiciones compuestas usa & y | con paréntesis, nunca and y or.

    Casi todo devuelve un objeto nuevo. Si haces df.drop(columns=["x"]) y no reasignas, no ha pasado nada.


    3. Reducir, que es donde está el trabajo de verdad

    groupby más agg resuelve la inmensa mayoría de las preguntas que le vas a hacer a un agente sobre tus datos:

    resumen = (df.groupby("curso")
                 .agg(ventas=("precio", "size"),
                      ingresos=("precio", "sum"),
                      tasa_completado=("completado", "mean"))
                 .round(2)
                 .reset_index())
    

    Tres detalles que importan:

    • .agg() con nombres te deja bautizar las columnas de salida. Sin eso acabas con nombres compuestos horribles y el agente los lee peor.
    • mean() sobre una columna booleana da la proporción directamente. Ahí sale el 0,27 de la tabla de arriba sin cálculo extra.
    • .reset_index() baja la clave del agrupado del índice a columna. Si se te olvida, el JSON que entregas sale con otra forma.

    La regla, si te quedas con una sola de este post: agrega hasta que la tabla quepa en una pantalla. Si no cabe, todavía no has terminado de reducir.

    Cuando el volumen crezca o prefieras SQL a encadenar métodos, tienes la alternativa sin salir del portátil en DuckDB para analizar con SQL sin exportar nada.


    4. Validar en la frontera: Pydantic es el Zod de Python

    Aquí es donde tu instinto de TypeScript te sirve tal cual. Lo que hace Zod en tu producto lo hace Pydantic en la capa de datos: defines el esquema y lo que no encaja no pasa.

    from pydantic import BaseModel, Field
    
    class ResumenCurso(BaseModel):
        curso: str
        ventas: int = Field(ge=0)
        ingresos: float = Field(ge=0)
        tasa_completado: float = Field(ge=0, le=1)
    
    filas = [ResumenCurso(**r) for r in resumen.to_dict(orient="records")]
    payload = [f.model_dump() for f in filas]
    

    Ese le=1 en tasa_completado parece una tontería y es justo el guardarraíl que quieres: si un cambio en el pipeline te deja una proporción en 1,4, prefieres que explote aquí y no que el agente construya un razonamiento entero sobre un dato imposible.

    Y esa es la diferencia de fondo con el análisis de datos clásico: un dato sucio ya no es una celda rara en un gráfico, es una alucinación con aspecto de respuesta correcta. El agente no va a dudar de lo que le des.

    Los patrones de contrato del lado TypeScript están en el curso de Zod para TypeScript, y se trasladan casi literalmente a Pydantic.


    ¿Y NumPy? Solo cuando toca

    NumPy aparece en todos los tutoriales de Python y datos, así que conviene decir cuándo lo vas a necesitar de verdad: cuando hagas aritmética sobre muchos números.

    Una lista de Python guarda punteros a objetos dispersos y obliga al intérprete a resolver el tipo en cada elemento. NumPy guarda los números en un bloque contiguo y opera en C sobre todo el bloque. Sobre un millón de valores:

    import numpy as np, timeit
    
    lista = [float(i) for i in range(1_000_000)]
    arr = np.array(lista)
    
    t_list = timeit.timeit(lambda: [x * 0.85 for x in lista], number=5) / 5
    t_np   = timeit.timeit(lambda: arr * 0.85, number=5) / 5
    print(f"lista: {t_list*1000:.1f} ms | numpy: {t_np*1000:.1f} ms | {t_list/t_np:.0f}x")
    

    En mi máquina: 102,3 ms contra 6,4 ms. Dieciséis veces. Córrelo tú, que el factor depende del hardware.

    Ahora, la parte honesta: si tu pipeline agrupa 40.000 filas una vez al día, esa diferencia no la vas a notar. Pandas ya usa NumPy por debajo. Aprende NumPy cuando el perfilado te diga que ahí está el problema, no antes.


    Cuándo NO deberías meter Python

    Añadir un lenguaje a un proyecto tiene un coste real: otro entorno, otro despliegue, otra cosa que se rompe.

    No lo metas si:

    • Son menos de unos miles de registros y ya los tienes en tu app. Un reduce en TypeScript te lo resuelve sin añadir nada.
    • Los datos ya están en tu base de datos. Un GROUP BY en SQL es más rápido y más simple que exportar, cargar en Pandas y volver.
    • Es una consulta que harás una vez. Escríbela donde te resulte más rápido y olvídala.

    Merece la pena cuando cruzas fuentes distintas (un CSV de la pasarela de pago con un export de tu base y una hoja de cálculo), cuando la limpieza tiene reglas de verdad, o cuando el paso se repite cada día. Ahí Pandas gana con claridad. Para automatizar ese paso una vez que funcione, tengo el terreno cubierto en scripts de Python para tu productividad semanal.


    El pipeline entero

    Junto, esto es todo lo que hace falta entre tu exportación y el contexto de tu agente:

    import json
    import pandas as pd
    from pydantic import BaseModel, Field
    
    class ResumenCurso(BaseModel):
        curso: str
        ventas: int = Field(ge=0)
        ingresos: float = Field(ge=0)
        tasa_completado: float = Field(ge=0, le=1)
    
    def contexto_para_agente(ruta: str) -> str:
        df = (pd.read_csv(ruta, parse_dates=["fecha"])
                .drop_duplicates(subset=["id_pedido"])
                .dropna(subset=["curso", "precio"]))
    
        resumen = (df.groupby("curso")
                     .agg(ventas=("precio", "size"),
                          ingresos=("precio", "sum"),
                          tasa_completado=("completado", "mean"))
                     .round(2)
                     .reset_index()
                     .sort_values("ingresos", ascending=False))
    
        filas = [ResumenCurso(**r) for r in resumen.to_dict(orient="records")]
        return json.dumps([f.model_dump() for f in filas], ensure_ascii=False)
    

    Treinta líneas. La salida cabe en un mensaje y ya viene validada.

    Cómo se conecta esa salida con un agente que decide y actúa sobre ella, de la idea a producción, lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.


    Qué hacer esta semana

    1. Monta el entorno con uv: uv venv y uv pip install pandas pydantic. Un segundo. (Aviso por si te lo cruzas en algún tutorial: Bun no gestiona Python, es un runtime de JavaScript; el equivalente aquí es uv.)
    2. Coge la exportación más grande que le estés pasando a un agente y mide sus caracteres. Divide entre cuatro para hacerte una idea de los tokens.
    3. Escribe el groupby que responde la pregunta que de verdad le haces, y vuelve a medir. El factor de reducción que te salga es lo que te estabas gastando de más.
    4. Ponle un esquema Pydantic a la salida antes de entregársela al modelo.

    En Dominicode Labs comparto los pipelines de datos y telemetría que uso de verdad para mirar lanzamientos y retención.

    Tu agente no necesita tus datos. Necesita la respuesta que hay dentro de ellos, y esa parte todavía la pones tú.


    Preguntas frecuentes

    ¿Por qué no le paso el CSV entero al agente y que se apañe?

    Por dos motivos. El coste, que es el menor: en el ejemplo de este post, 40.000 filas son unos 1,35 millones de caracteres —del orden de 339.000 tokens— frente a los 386 caracteres del resumen. Y el importante: un modelo con 40.000 filas delante tiene 40.000 oportunidades de fijarse en lo que no toca. Reducir no es solo ahorrar, es acotar dónde puede mirar.

    ¿Necesito saber estadística para esto?

    No. Las cuatro operaciones son cargar, limpiar, reducir y validar, y todas son programación. La estadística hace falta cuando entras en modelado predictivo, que es un problema distinto y que en la mayoría de los productos con agentes no aparece nunca.

    ¿Pandas o Polars?

    Empieza por Pandas: más documentación, más respuestas cuando te atasques y es lo que vas a encontrar en el código de otros. Polars es más rápido y su API más consistente, y compensa cuando el volumen te empiece a doler. Los conceptos —DataFrame, filtrado, agrupación— se trasladan casi enteros.

    ¿Puedo hacer esto en TypeScript y ahorrarme el Python?

    Para volúmenes pequeños, sí, y probablemente deberías: un reduce no justifica añadir un lenguaje al proyecto. Python empieza a compensar cuando cruzas fuentes distintas, cuando la limpieza tiene reglas de verdad o cuando el paso se repite a diario. Si los datos ya viven en tu base de datos, la respuesta suele ser ninguno de los dos: un GROUP BY en SQL.

    ¿Dónde pongo esta capa: en el agente o antes?

    Antes, siempre, y como un paso determinista. Si el agente tiene que cargar y agregar por su cuenta, estás usando un modelo probabilístico para hacer aritmética que un groupby resuelve exacto, más barato y sin variar entre ejecuciones. El agente debe recibir la tabla ya reducida y validada, y dedicarse a lo suyo: decidir.

  • Cómo implementar un loop de agente efectivo para LLM en producción

    Cómo implementar un loop de agente efectivo para LLM en producción

    El loop de agente que sí funciona en producción

    Tiempo estimado de lectura: 5 min

    • Contrato y salida clara: fuerza una condición de salida semántica explícita (herramienta finalizar / AgentFinish con respuesta_final).
    • Validación antes de actuar: validar payloads con Pydantic y devolver errores estructurados como observaciones.
    • Errores como contexto: convertir fallos de herramientas en observaciones legibles (p. ej. ERROR_TOOL: nombre — detalle).
    • Límites y circuit breakers: limitar iteraciones con MAX_STEPS y cortar si el mismo error aparece repetidamente.

    ¿Quieres que tu agente deje de repetir el mismo error a las 3 a. m. y empiece a resolver problemas reales? El loop de agente que sí funciona en producción es exactamente eso: una celda de contención determinista alrededor de un motor estocástico.

    En las primeras líneas: El loop de agente que sí funciona en producción obliga al agente a operar con contratos claros (plan), validar antes de actuar (act), convertir fallos en contexto (observe) y respetar límites duros (reflect). Si no aplicas estas reglas, el agente acabará en bucles infinitos, consumiendo tokens y creando deuda técnica.

    Resumen rápido (lectores con prisa)

    Qué es: un patrón de control que encierra un LLM estocástico en un loop determinista con contratos claros y límites.

    Cuándo usarlo: flujos síncronos y de corta duración (consultas DB, enriquecimiento, generación de artefactos pequeños).

    Por qué importa: evita bucles infinitos, reduce deuda técnica y mejora la capacidad de recuperación ante errores de herramienta.

    Cómo funciona: usar una herramienta de cierre (finalizar), validar entradas con Pydantic, registrar errores como observaciones y aplicar límites de iteración.

    El loop de agente que sí funciona en producción: diseño y principios

    Los LLMs no tienen intención ni memoria fiable. Son modelos probabilísticos que requieren disciplina del lado del ingeniero. Esto significa aplicar cuatro reglas innegociables:

    1. Forzar una condición de salida semántica explícita

    Define la herramienta de cierre del flujo. Llama a la función finalizar o AgentFinish y exige que incluya respuesta_final. Ese es el interruptor lógico que separa “sigo pensando” de “he terminado”.

    2. Validar todos los argumentos antes de ejecutar herramientas

    Valida con Pydantic cada payload que el modelo devuelve. Si no pasa validación, no ejecutes nada: devuelve el error al agente como observación estructurada.

    3. Inyectar errores técnicos al historial como observaciones

    Si una herramienta falla (timeout, DB deadlock, error de tipo), captura la excepción y agrega al historial un mensaje tipo: “ERROR_TOOL: nombre — detalle”. No ocultes fallos: convertirlos en contexto mejora la capacidad del agente para corregir su siguiente plan.

    4. Imponer límites duros de iteración y circuit breakers semánticos

    Finalmente, limita las iteraciones con MAX_STEPS. Si el agente alcanza ese límite, devuelve un error controlado y registra el incidente. Implementa circuit breakers si el mismo error aparece repetidamente.

    Ejemplo práctico en Python

    Aquí tienes un esqueleto funcional, pensado para integrarse con cualquier cliente LLM que soporte tool-calling. Incluye validación Pydantic y la inyección de errores al historial.

    import json
    from pydantic import BaseModel, ValidationError
    
    MAX_STEPS = 5
    
    # Ejemplo de validator para una tool
    class CreateTicketArgs(BaseModel):
        title: str
        priority: str  # 'low'|'medium'|'high'
    
    # Simulación de herramientas
    def create_ticket(title: str, priority: str):
        # lógica real aquí (DB, API)
        return {"ticket_id": "TCK-123", "title": title, "priority": priority}
    
    TOOLS = {
        "create_ticket": (create_ticket, CreateTicketArgs),
        # "finalizar" no necesita validator complejo; solo espera respuesta_final
    }
    
    def run_agent(user_prompt: str, llm_client) -> str:
        messages = [
            {"role": "system", "content":
             "Eres un agente. Devuelve siempre JSON con 'tool_call' o 'final_text'. "
             "Usa la herramienta 'finalizar' con {'respuesta_final': '...'} para terminar."},
            {"role": "user", "content": user_prompt}
        ]
    
        seen_errors = {}
        for step in range(MAX_STEPS):
            response = llm_client.chat(messages=messages, tools=get_tool_schemas(TOOLS))
    
            # respuesta textual sin tool_call
            if response.finish_reason == "stop" and not response.tool_calls:
                return response.content
    
            for tc in response.tool_calls:
                name = tc.name
                args_raw = json.loads(tc.arguments)
    
                if name == "finalizar":
                    return args_raw.get("respuesta_final", "")
    
                tool_fn, validator = TOOLS[name]
    
                # VALIDACIÓN (Act)
                try:
                    args = validator(**args_raw)
                except ValidationError as ve:
                    observation = f"VALIDATION_ERROR: {ve.json()}"
                    messages.append({"role": "assistant", "content": response.content})
                    messages.append({"role": "tool", "tool_call_id": tc.id, "content": observation})
                    # registro para circuit breaker
                    seen_errors.setdefault(str(ve), 0)
                    seen_errors[str(ve)] += 1
                    if seen_errors[str(ve)] >= 2:
                        return f"Interrumpido: error recurrente de validación: {ve}"
                    continue
    
                # EJECUCIÓN segura (Observe)
                try:
                    result = tool_fn(**args.dict())
                    observation = f"RESULT: {json.dumps(result)}"
                except Exception as e:
                    observation = f"ERROR_TOOL: {name} — {str(e)}"
                    seen_errors.setdefault(str(e), 0)
                    seen_errors[str(e)] += 1
                    if seen_errors[str(e)] >= 2:
                        return f"Interrumpido: error recurrente en herramienta: {e}"
    
                messages.append({"role": "assistant", "content": response.content})
                messages.append({"role": "tool", "tool_call_id": tc.id, "content": observation})
    
        return "Error: el agente superó el límite de pasos permitidos."

    Operaciones que debes instrumentar desde el día uno

    • Logging estructurado por paso: step, tool, args, resultado, tokens consumidos.
    • Conteo de tokens del historial; si supera el 75–80% de la ventana del modelo, ejecuta resumen (ver técnicas de resumen).
    • Circuit breaker semántico: si el mismo error aparece dos veces, corta y alerta.
    • Métricas SLIs: tiempo por petición, reintentos por herramienta, tasa de finalización exitosa.

    Cuándo no usar este loop y optar por orquestación

    Usa este loop en procesos síncronos y de corta duración: consultas DB, enriquecimiento de datos, generación de artefactos pequeños. Si tu flujo dura horas/días, incluye pasos humanos o requiere durabilidad de estado, cambia a un orquestador (n8n, LangGraph) que persista estado y permita reprogramación.

    Cierre práctico

    El loop de agente que sí funciona en producción no es una trick de prompts: es ingeniería. Forzar salida semántica (finalizar), validar antes de actuar (Pydantic), convertir fallos en contexto y aplicar límites duros son las piezas que convierten un prototipo ruidoso en un agente fiable. Implementa esto, instrumenta y repite: la estabilidad viene de la disciplina, no de la magia.

    Para recursos experimentales y proyectos relacionados con automatización y agentes, considera explorar los trabajos y laboratorios prácticos en Dominicode Labs. Es una referencia contextual para implementar pipelines y pruebas prácticas en entornos de ingeniería.

    FAQ

    ¿Cuál es la función de la herramienta finalizar?

    Es el interruptor semántico que indica que el agente ha terminado su trabajo. Debe devolver un objeto que incluya respuesta_final, que el loop interpreta como salida definitiva.

    ¿Por qué usar Pydantic para validar payloads?

    Porque ofrece validación estructurada y errores claros. Validar evita ejecuciones inseguras y permite convertir fallos en observaciones reutilizables por el agente.

    ¿Qué hacer si una herramienta externa falla repetidamente?

    Registrar el fallo como ERROR_TOOL: nombre — detalle, aplicar un circuit breaker y, si el error se repite, interrumpir el loop con un error controlado para evitar consumo indefinido de recursos.

    ¿Cómo definir MAX_STEPS?

    Depende del dominio y del coste por iteración. Empieza con un valor conservador (p. ej. 5) y monitoriza reintentos y tiempo por petición para ajustarlo.

    ¿Cuándo prefiero un orquestador en lugar de este loop?

    Si el flujo requiere durabilidad, pasos humanos o puede durar horas/días, usa un orquestador como n8n o LangGraph para persistir estado y reintentar tareas.

    ¿Qué métricas debo recolectar desde el día uno?

    Tiempo por petición, reintentos por herramienta, tasa de finalización exitosa, conteo de tokens y registros estructurados por paso (tool, args, resultado).

  • Cómo convertir un script Python en un micro-SaaS funcional

    Cómo convertir un script Python en un micro-SaaS funcional

    De script a micro-SaaS: convertir código Python en un producto vendible

    Tiempo estimado de lectura: 5 min

    • Desacopla procesamiento pesado de los endpoints HTTP usando colas de tareas.
    • Usa FastAPI + Celery + Redis como arquitectura mínima reproducible.
    • Prioriza autenticación, límites y facturación antes de añadir features.

    Tabla de contenidos

    “De script a micro-SaaS: convertir código Python en un producto vendible” no es un titular bonito: es la ruta práctica que separa un hobby útil de un servicio que paga facturas. Si tu script hace algo que otros necesitan —OCR, scraping, normalización de datos, generación de insights— puedes empaquetarlo, protegerlo y venderlo. Aquí tienes la arquitectura mínima, ejemplos y criterios para pasar de prototipo a producto real.

    Resumen rápido (lectores con prisa)

    Qué es: Un patrón para transformar scripts Python en un servicio con API, cola de tareas y facturación.

    Cuándo usarlo: Cuando tus tareas son largas o requieren recursos y vas a exponerlas vía API.

    Por qué importa: Evita timeouts y trabajadores bloqueados, habilita control de cuota y facturación.

    Cómo funciona: FastAPI recibe la petición y encola un job en Celery/Redis; un worker procesa y guarda resultados.

    De script a micro-SaaS: arquitectura mínima y por qué importa

    Stack recomendado

    • FastAPI (API + validación con Pydantic).
    • Celery (ejecución de jobs background).
    • Redis (broker y backend ligero).
    • Docker / Docker Compose para despliegue reproducible.

    Flujo básico

    1. Cliente POST /jobs → recibe 202 y job_id.
    2. FastAPI encola tarea en Redis/Celery.
    3. Worker procesa en background y guarda resultado.
    4. Cliente GET /jobs/{id} consulta estado/resultado.

    Código mínimo: entrada, worker y status

    FastAPI encola; Celery procesa. Ejemplo mínimo ilustrativo:

    # main.py (FastAPI)
    from fastapi import FastAPI
    from pydantic import BaseModel, HttpUrl
    from worker import run_task
    
    app = FastAPI()
    
    class JobRequest(BaseModel):
        source_url: HttpUrl
    
    @app.post("/jobs", status_code=202)
    async def create_job(req: JobRequest):
        task = run_task.delay(str(req.source_url))
        return {"job_id": task.id}
    # worker.py (Celery)
    from celery import Celery
    from my_script import process_url
    
    celery_app = Celery("app", broker="redis://redis:6379/0", backend="redis://redis:6379/0")
    
    @celery_app.task(acks_late=True)
    def run_task(url):
        return process_url(url)

    Endpoint de status usa AsyncResult de Celery para devolver estado y resultado.

    Autenticación, límites y monetización

    Un micro-SaaS no es solo código: es quien paga por usarlo. Implementa tres capas mínimas:

    1. API Keys

    Header X-API-KEY validado contra tu base de datos (o Supabase). Emite y revoca keys vinculadas a facturación y cuotas.

    2. Rate limiting

    Usa Redis + slowapi o fastapi-limiter para imponer cuotas por key.

    3. Facturación básica

    Integra Stripe para generar suscripciones y emitir API Keys tras pago. Un webhook puede crear la key y enviarla por correo. Payment Links + webhook de entrega de key son suficientes al inicio.

    • Freemium: N jobs/mes gratis (onboarding).
    • Pro: precio fijo + cuota de jobs.
    • Enterprise: acuerdos, SLA y keys con prioridad en la cola.

    Deploy rápido y operaciones

    Conteneriza todo y usa Docker Compose para desarrollo y pruebas; despliega en PaaS para producción (Railway, Render, DigitalOcean). Un archivo docker-compose mínimo facilita reproducibilidad y onboarding de colaboradores.

    Monitoreo y operativa

    • Logging estructurado (python logging o structlog).
    • Retries y soft_time_limit en Celery para evitar jobs colgados.
    • Métricas: exporta métricas básicas (queue length, job duration) a Prometheus/Grafana.
    • Persistencia: guarda metadatos de jobs y uso de clientes en PostgreSQL para facturación y auditoría.

    Plataformas PaaS recomendadas

    Primeras tácticas de crecimiento y validación

    • Publica documentación técnica y una colección de ejemplos: FastAPI genera Swagger en /docs automáticamente — úsalo como demo.
    • Ofrece una integración de ejemplo con n8n para flujos no-code y demuestra cómo tu API entra en workflows.
    • Lanza con precio bajo y limita uso para forzar upgrades; monitoriza conversiones y tiempo hasta el primer pago.
    • Usa canales técnicos (IndieHackers, Hacker News, Reddit r/SaaS) y aporta un caso de uso concreto en el post (ej. OCR a $0.01/página).

    Criterio final: qué priorizar en las primeras semanas

    1. Desacoplar (FastAPI + Celery).
    2. Validación y seguridad (Pydantic + API Keys).
    3. Observabilidad (logs + métricas).
    4. Un onboarding que convierta (docs + demo + pago simple).

    Convertir un script en micro-SaaS es ingeniería, no marketing. Si tu servicio resuelve un problema real, empaquetarlo con esta arquitectura te permite cobrar por cada petición sin romperte la espalda. Empieza por un endpoint, una cola y una suscripción: si la gente paga, escala; si no, iteras rápido.

    Dominicode Labs

    Si te interesa continuar con prototipos, integraciones no-code y flujos de automatización, considera explorar recursos y experimentos en Dominicode Labs. Es una continuación natural para validar integraciones y ejemplos técnicos antes de escalar.

    FAQ

    ¿Por qué desacoplar tareas largas de los endpoints?

    Las tareas largas (10–60 segundos) provocan timeouts y pueden bloquear workers si se ejecutan en peticiones síncronas. Desacoplar mediante una cola evita estos problemas y mejora la disponibilidad del servicio.

    ¿Qué aporta FastAPI en este stack?

    FastAPI proporciona un framework ligero para exponer endpoints HTTP con validación de entrada mediante Pydantic y documentación automática en /docs. Facilita la construcción de APIs robustas y bien tipadas.

    ¿Cómo emito API Keys tras un pago?

    Usa Stripe Checkout o Payment Links. Configura un webhook que escuche eventos de pago y, al confirmar la suscripción, genere y almacene la API Key asociada al cliente.

    ¿Qué debo monitorizar inicialmente?

    Comienza con logs estructurados, longitud de cola, duración de jobs y errores. Exporta métricas a Prometheus y visualízalas en Grafana para detectar cuellos de botella y patrones de fallo.

    ¿Es suficiente Docker Compose para producción?

    Docker Compose es suficiente para desarrollo y pruebas reproducibles. Para producción conviene desplegar en un PaaS o usar orquestadores con escalado y alta disponibilidad; las PaaS sugeridas facilitan arrancar rápido.

  • Evita errores comunes al iniciar con Python en automatización

    Evita errores comunes al iniciar con Python en automatización

    Errores comunes al empezar con Python en automatización

    Tiempo estimado de lectura: 4 min

    • Ideas clave:
    • Evita dependencias globales: usa herramientas de bloqueo y entornos aislados.
    • Reemplaza print() por logging estructurado y agrega observabilidad desde el inicio.
    • Implementa reintentos específicos y manejo de errores; no confíes en el camino feliz.
    • Gestiona secretos con variables de entorno y validación; no hardcodees credenciales.
    • Separa responsabilidades: módulos, pruebas y linting desde el día uno.

    Los errores comunes al empezar con Python en automatización no son fallos de sintaxis; son decisiones de diseño que convierten un script útil en una fuente de incidentes a las 3 A.M. Tratar cada automatización como “algo temporal” es la receta para deuda técnica: dependencias rotas, secretos expuestos y procesos que fallan en silencio.

    Aquí tienes los fallos que veo una y otra vez —por qué dañan sistemas en producción— y la forma minimalista y profesional de evitarlos desde el día uno.

    Resumen rápido (lectores con prisa)

    Qué es: Conjunto de prácticas para que automatizaciones en Python sean reproducibles, observables y resilientes.

    Cuándo usarlo: Desde el primer script que vaya a ejecutarse fuera de tu máquina local o que maneje datos sensibles.

    Por qué importa: Reduce fallos en producción, exposición de secretos y tiempo de mantenimiento.

    Cómo funciona: Aislamiento de dependencias, logging estructurado, manejo de errores con retries, configuración validada y código modular.

    Errores comunes al empezar con Python en automatización: 5 fallos que rompen scripts

    1) Dependencias globales: reproducibilidad rota

    Fallarás si instalas paquetes en el entorno global. Dos scripts con versiones distintas de la misma librería empiezan a pelearse.

    Solución: aislar y bloquear. Usa Poetry o uv para gestionar pyproject.toml y lockfile. En CI y Docker usa exactamente el mismo lockfile.

    Ejemplo mínimo de pyproject.toml:

    [tool.poetry.dependencies]
    python = "^3.11"
    httpx = "^0.24"
    

    Resultado: entornos reproducibles y despliegues predecibles.

    2) No usar logging estructurado: fallos que nadie ve

    print() funciona en tu consola pero es inútil en producción. Sin timestamps, niveles ni contexto, depurar es lotería.

    Solución: logging estándar o structlog para JSON. Logs estructurados permiten alertas y búsquedas en Grafana/CloudWatch.

    Patrón:

    import logging
    logging.basicConfig(level=logging.INFO)
    logger = logging.getLogger(__name__)
    logger.error("job_failed", extra={"job_id": job_id, "reason": "timeout"})
    

    O usa structlog: structlog.

    3) Gestión de errores inexistente: confiar en el “camino feliz”

    Scripts lineales mueren ante el primer error: timeout, campo faltante, API caída. Procesos batch se interrumpen y nadie recibe notificación útil.

    Solución: captura específica + retries con backoff. No uses except Exception: a la ligera; maneja requests.exceptions.Timeout, KeyError, etc. Para reintentos robustos, Tenacity es la herramienta (Tenacity).

    Ejemplo:

    from tenacity import retry, stop_after_attempt, wait_exponential
    import httpx
    
    @retry(stop=stop_after_attempt(3), wait=wait_exponential(min=2, max=10))
    def fetch(url):
        r = httpx.get(url, timeout=10)
        r.raise_for_status()
        return r.json()
    

    4) Hardcoding de secretos y configuración: riesgo y rigidez

    Credenciales en el código, URLs codificadas, paths “mágicos”. Un commit y tus claves están en el mundo.

    Solución: variables de entorno + validación con Pydantic Settings. No arranques si falta una variable crítica.

    Ejemplo:

    from pydantic_settings import BaseSettings
    
    class Settings(BaseSettings):
        API_KEY: str
        DB_URL: str
        TIMEOUT: int = 30
    
        class Config:
            env_file = ".env"
    
    settings = Settings()
    

    Docs: Pydantic Settings

    5) Script monolítico: difícil de probar y mantener

    Todo en main.py: lectura, lógica, I/O, notificaciones. Eso mata testing, reuso y saneamiento.

    Solución: separa responsabilidad (SRP). Divide en módulos: config.py, input.py, process.py, output.py. Haz funciones puras para la lógica y aisladas para I/O. Añade tests con pytest (pytest) y linting con Ruff (Ruff) desde el inicio.

    Estructura sugerida:

    automatizacion/
    ├── config.py
    ├── data_source.py
    ├── processing.py
    ├── orchestrator.py
    └── tests/
    

    Stack profesional mínimo que evita estos errores

    Adopta la plantilla una vez: Dockerfile + pyproject.lock + .env.example + pipeline CI que ejecuta linters y tests. Esto reduce el tiempo de mantenimiento y te da confianza para escalar.

    Criterio práctico final

    Si vas a automatizar algo crítico, piensa en fallos, no en casos felices. Construye plantillas: aislamiento de dependencias, logging estructurado, validación de configuración, retries inteligentes y código modular. Esa inversión inicial de horas evitará noches enteras solucionando scripts que “dejan de funcionar”.

    Automatización profesional = software con observabilidad y resiliencia. Haz la transición desde parches a herramientas confiables y tu equipo (y tu sueño) te lo agradecerán.

    Para equipos que trabajan con automatización y workflows, una continuación lógica para prototipado y validación de prácticas es Dominicode Labs, donde pueden iterar plantillas, CI y despliegues controlados.

    FAQ

    ¿Por qué no debo usar print() en producción?

    print() carece de niveles, timestamps y contexto estructurado. En producción necesitas logs que permitan filtrado, alertas y correlación; usa logging estándar o structlog para salida JSON.

    ¿Cómo aseguro que mi entorno en CI y Docker sea el mismo que en local?

    Usa un lockfile y el mismo flujo de instalación en CI/Docker que en desarrollo (por ejemplo, pyproject.lock generado por Poetry). Construye la imagen o el entorno a partir de ese lockfile para garantizar reproducibilidad.

    ¿Qué librería recomiendan para reintentos?

    Para reintentos y backoff robusto, el artículo recomienda Tenacity. Permite configurar intentos, waits exponenciales y manejar excepciones específicas.

    ¿Cómo manejo secretos de manera segura?

    No hardcodees credenciales. Usa variables de entorno y valida su existencia en arranque con Pydantic Settings (Pydantic Settings); no inicies si faltan variables críticas.

    ¿Cuál es la estructura mínima de proyecto para empezar bien?

    Una estructura mínima propuesta: módulos separados para configuración, entrada, procesamiento y salida, junto con un directorio de tests. Ejemplo en el artículo: automatizacion/ con config.py, data_source.py, processing.py, orchestrator.py y tests/.

    ¿Qué herramientas de observabilidad debo integrar primero?

    Empieza por logging estructurado (logging JSON o structlog) y métricas/alertas integradas con tu plataforma (por ejemplo Grafana o CloudWatch) para detectar fallos y latencias.

  • Cómo integrar Python con n8n para evitar duplicación de lógica

    Cómo integrar Python con n8n para evitar duplicación de lógica

    Cómo combinar Python + n8n sin duplicar trabajo

    Tiempo estimado de lectura: 4 min

    • Separación clara de responsabilidades: n8n orquesta estado y flujos; Python ejecuta procesamiento y lógica compleja.
    • Patrones de integración: nodo Code para tareas pequeñas; microservicio HTTP (FastAPI) para lógica reutilizable y testeable.
    • Contratos y versionado: usar Pydantic y endpoints versionados para evitar duplicación y errores.
    • Procesos largos y archivos grandes: usar encolado (job_id / callback) y almacenamiento externo (S3/GCS).
    • Observabilidad y despliegue: logging estructurado, dockerización y healthchecks.

    Introducción

    Cómo combinar Python + n8n sin duplicar trabajo empieza por una decisión simple: n8n orquesta, Python procesa. Si lo inviertes, acabarás con canvas ilegible o con scripts monolíticos imposibles de testear. Aquí tienes la guía práctica para separar responsabilidades, comunicar ambos mundos sin fricción y evitar los errores que consumen tiempo.

    Resumen rápido (lectores con prisa)

    Qué es: Integración entre n8n (orquestación) y Python (procesamiento).

    Cuándo usarlo: Usa n8n para flujos, triggers y estado; usa Python para transformaciones pesadas, dependencias y testing.

    Por qué importa: Evita lógica duplicada, facilita testing y escalado independiente.

    Cómo funciona: Dos patrones: nodo Code para tareas pequeñas; microservicio HTTP (por ejemplo con FastAPI) para lógica compleja y reutilizable.

    Cómo combinar Python + n8n sin duplicar trabajo: regla y ejemplos

    La regla es directa: n8n gestiona estado, conexiones y flujo; Python hace la transformación y la lógica compleja.

    • n8n: Triggers, autenticación OAuth2, retries, enrutamiento (If, Switch), integración final (CRM, Sheets), almacenar estado.
    • Python: Procesamiento pesado (Pandas, NumPy), ML/IA, scraping (Playwright), parsing de archivos grandes, reglas de negocio complejas.

    Si tu función necesita dependencias pip, CPU/ram o test unitario: ponla en Python.

    Patrones de comunicación (2 opciones)

    Hay dos patrones sólidos para integrar Python en n8n. Escoge según necesidad.

    1) Nodo Code (rápido, limitado)

    Útil para arreglos pequeños: regex, formateos, cálculos puntuales. Evita para lógica que requiera paquetes externos.

    Ejemplo dentro de n8n (pseudo):

    # Python en nodo Code
    text = $input.first().json["message"]
    urls = re.findall(r'https?://\S+', text)
    return [{"urls": urls}]
    

    Limitación: no puedes garantizar dependencias ni buen versionado. Úsalo para tareas menores.

    2) Microservicio HTTP (recomendado)

    Exponer Python como una API REST (FastAPI) es la arquitectura profesional. n8n usa su nodo HTTP Request para llamar a endpoints.

    Ventajas:

    • Contrato claro con Pydantic.
    • Testable con pytest/postman.
    • Escalable por separado.
    • Reutilizable desde varios workflows.

    Ejemplo mínimo de FastAPI con contrato (Pydantic):

    # api.py
    from fastapi import FastAPI
    from pydantic import BaseModel
    
    app = FastAPI()
    
    class LeadInput(BaseModel):
        text: str
        company_size: int
    
    @app.post("/score")
    def score(data: LeadInput):
        # Lógica compleja aquí (Pandas, embeddings...)
        score = len(data.text) * (data.company_size / 100)
        return {"score": score, "status": "qualified" if score > 50 else "nurture"}
    

    Docs: FastAPI, Pydantic

    En n8n configuras un nodo HTTP Request:

    • Method: POST
    • URL: endpoint /score
    • Body JSON: {"text": "{{$json.body.text}}", "company_size": {{$json.body.size}}}

    Contratos de datos: la pieza que evita duplicación

    Define un contrato claro. Es la única manera de que n8n y Python no reinventen la misma validación.

    • Usa Pydantic en Python para validar y documentar entradas.
    • En n8n, transforma y envía solo los campos necesarios. No envíes el objeto completo de n8n.
    • Versiona tu API: /v1/score → /v2/score cuando el contrato cambie.

    Si n8n envía datos mal formados, la API debe responder 422 con un payload explicativo. Eso convierte los fallos en alertas, no en comportamiento errático.

    Patrones para procesos largos o con archivos grandes

    1. Si el procesamiento tarda >30–60s, no bloquees el flujo HTTP síncrono. Implementa este patrón:

      • n8n hace POST → Python responde 202 con job_id.
      • Python encola la tarea (Celery/RQ) y cuando termina hace callback a webhook de n8n o actualiza una cola/persistencia que n8n consulta.
    2. Para archivos grandes (PDFs, imágenes):

      • n8n sube el archivo a un storage (S3/GCS) y pasa la URL firmada a Python. Evitas JSON enormes y timeouts.

    Errores frecuentes y soluciones concretas

    • Lógica duplicada (mismos cálculos en n8n y Python): centraliza en Python y deja en n8n sólo la decisión (If score > 80).
    • Uso del nodo Code para lógica crítica: mueve esa lógica a la API y versiona.
    • No manejar retries/backoff: usa el sistema nativo de reintentos de n8n y expon un endpoint idempotente en Python (acepta reintentos seguros).
    • Pasar estructuras cambiantes: define schemas Pydantic y agrega tests contractuales para detectar cambios en producción.

    Observabilidad y despliegue

    • Logging estructurado en Python (JSON logs). Almacénalos en ELK/Datadog.
    • En n8n, usa el histórico de ejecución para auditoría del flujo.
    • Dockeriza la API Python y define healthchecks. Ejemplo básico en Docker:
    FROM python:3.11-slim
    WORKDIR /app
    COPY . .
    RUN pip install -r requirements.txt
    CMD ["uvicorn", "api:app", "--host", "0.0.0.0", "--port", "8000"]
    

    Cierre: criterio para elegir ahora mismo

    • Si la tarea:
      • Requiere dependencias, CPU o tests → Python (microservicio).
      • Es un trigger/entrega/condición simple → n8n.
      • Mezcla estados (login, retries) y transformación → n8n orquesta; Python ejecuta.

    Separar responsabilidades no es esfuerzo extra; es la inversión que evita la deuda técnica. Diseña contratos claros, expón lógica compleja como servicios y deja a n8n dirigir la orquesta. Tus automatizaciones dejarán de ser hacks y pasarán a ser una plataforma sólida.

    Para más recursos y experimentos relacionados con automatización y workflows, consulta Dominicode Labs. Es una continuación lógica para explorar plantillas, ejemplos y herramientas prácticas que complementan esta guía.

    FAQ

    ¿Cuándo debo usar el nodo Code en n8n y cuándo Python?

    Usa el nodo Code para ajustes pequeños: regex, formateos, cálculos puntuales. Si necesitas paquetes externos, CPU, memoria o tests unitarios, implementa la lógica en Python.

    ¿Cómo evito duplicar validación entre n8n y Python?

    Define un contrato único y público (Pydantic) en la API Python. En n8n transforma y envía sólo los campos necesarios; no intentes replicar toda la validación en n8n.

    ¿Qué hago si un procesamiento tarda más de 60 segundos?

    No bloquees la llamada HTTP. Responde 202 con un job_id, encola la tarea (Celery/RQ) en Python y notifica a n8n vía callback o actualiza una persistencia que n8n consulta.

    ¿Cómo manejar archivos grandes entre n8n y Python?

    Sube los archivos a un storage (S3/GCS) desde n8n y pasa la URL firmada a Python. Así evitas JSON enormes, timeouts y transmisión directa de binarios.

    ¿Qué prácticas de observabilidad recomiendan?

    Logging estructurado (JSON) en Python, almacenar logs en ELK/Datadog y usar el histórico de ejecución de n8n para auditoría. Añade healthchecks y métricas básicas en la API.

    ¿Cómo asegurar endpoints contra reintentos y errores de red?

    Implementa endpoints idempotentes y documenta los contratos. Usa el sistema de reintentos de n8n con backoff y maneja responses 4xx/5xx apropiadamente (422 para validación).

    ¿Cómo versionar cambios en el contrato de datos?

    Expon versiones en la URL (por ejemplo /v1/score, /v2/score). Acompaña con tests contractuales y notas de migración para los consumidores (n8n workflows).

  • Implementación de IA en producción con Python: patrones efectivos

    Implementación de IA en producción con Python: patrones efectivos

    Python + IA en producción (sin hype)

    Tiempo estimado de lectura: 5 min

    Ideas clave

    • Tratar al LLM como servicio predecible: input → validación → procesamiento → output validado → observabilidad.
    • Validación estricta: Pydantic / Instructor para outputs estructurados; fallback rules-based cuando falle la validación.
    • RAG anclado: embeddings + vector DB + prompt que use solo el contexto recuperado para evitar hallucinations.
    • Generación con revisión humana: producir borradores estructurados que reduzcan el trabajo humano al 20–30%.

    Tabla de contenidos

    Introducción

    Python + IA en producción (sin hype) significa integrar modelos de lenguaje como componentes técnicos previsibles: funciones probabilísticas encapsuladas, validadas y monitorizadas. No es “darle un prompt y esperar magia”; es diseñar pipelines que conviertan texto ruidoso en datos accionables, enrutando, extrayendo, recuperando y generando borradores útiles.

    Resumen rápido (lectores con prisa)

    Qué es: integrar LLMs como servicios deterministas y validados para procesos de negocio.

    Cuándo usarlo: cuando los inputs textuales son ruidosos y requieren estructura o enrutamiento automatizado.

    Por qué importa: reduce errores, controla coste y evita entregar contenido no verificado.

    Cómo funciona: pipelines con validación (Pydantic), recuperación anclada (embeddings + vector DB) y revisión humana para entregables finales.

    Python + IA en producción (sin hype): casos y patrones comprobables

    Abajo tienes cuatro patrones que realmente funcionan en empresas: clasificación, extracción, RAG y generación con revisión humana. Cada uno incluye la arquitectura mínima, fragmentos de código y consideraciones operativas.

    1) Clasificación de documentos: el Router Pattern

    Problema: cientos de reglas basadas en keywords que rompen con variaciones de lenguaje.

    Solución: usar un modelo como clasificador determinista (temperature=0) y forzar respuestas válidas contra un Enum. Resultado: enrutamiento a colas (Celery), webhooks (n8n) o routers internos.

    from enum import Enum
    from pydantic import BaseModel
    from openai import OpenAI
    
    class Category(str, Enum):
        SUPPORT = "support"
        BILLING = "billing"
        SALES = "sales"
    
    client = OpenAI()
    
    def classify(text: str) -> Category:
        resp = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role":"system","content":"Responde con una sola de: support, billing, sales"},
                      {"role":"user","content":text}],
            temperature=0
        )
        return Category(resp.choices[0].message.content.strip())

    Determinismo + validación reducen falsos positivos. Docs modelos

    2) Extracción estructurada: Text → JSON fiable

    Problema: OCR/HTML sucio produce texto que no entra directo en una base de datos.

    Solución: definir un esquema con Pydantic y usar una capa que obligue al LLM a devolver ese esquema (Instructor o Structured Outputs de OpenAI). Valida antes de insertar.

    from pydantic import BaseModel, Field
    from instructor import from_openai
    from openai import OpenAI
    
    class Invoice(BaseModel):
        vendor: str
        date: str  # validar con regex si hace falta
        total: float = Field(...)
    
    client = from_openai(OpenAI())
    invoice = client.chat.completions.create(
        model="gpt-4o-mini",
        response_model=Invoice,
        messages=[{"role":"user","content":ocr_text}]
    )

    Instructor: https://github.com/jxnl/instructor — Pydantic

    Siempre: retry + fallback rules-based si la validación falla.

    3) RAG simple y robusto (Búsqueda semántica anclada)

    RAG práctico = embeddings + vector DB + prompt que obliga a usar solo el contexto recuperado. Evita “hallucinations” anclando la generación a fragmentos verificados.

    Arquitectura mínima:

    • Chunking de documentos (ej. 500 tokens).
    • Embeddings (OpenAI embeddings o HuggingFace).
    • Vector store (ChromaDB o pgvector).
    • Recuperación top-k + prompt con instrucción de uso exclusivo del contexto.
    # obtener top_k documentos -> context
    prompt = f"Usa SOLO este contexto:\n{context}\n\nPregunta: {query}"
    answer = llm.chat(prompt)

    Stack y enlaces: ChromaDB ; pgvector

    Medir: recall de recuperación, latencia y coste por llamada.

    4) Generación de borradores: human-in-the-loop

    No entregues contenido final. Genera estructuras (Markdown/JSON) que reduzcan el trabajo humano al 20–30%.

    Patrón:

    1. Ingesta (diff, transcripción, notas).
    2. LLM genera estructura estandarizada (usando Pydantic).
    3. Enviar borrador a CMS/Notion/Slack para revisión.

    Beneficio: consistencia, velocidad y control de calidad.

    Stack recomendado y consideraciones operativas

    – Modelos/abstracción: usar LiteLLM para poder cambiar provider sin reescribir lógica.

    – Validación: Pydantic + Instructor / Structured Outputs.

    – Vector store: ChromaDB o pgvector (Postgres) según infraestructura.

    – Orquestación: código Python limpio; para workflows visuales, n8n. FastAPI para endpoints.

    – Observabilidad: LangSmith / Helicone para trazabilidad y coste por llamada.

    Criterios de producción

    • Determinismo: temperature=0 para clasificación/extraction.
    • Validación estricta: si Pydantic falla, fallback o alert.
    • Control de costes: medir tokens por request; cache de embeddings y respuestas frecuentes.
    • Fallbacks: reglas deterministas para casos críticos cuando el LLM no valida.
    • Telemetría: loggear prompts, embeddings IDs, latencia y coste por petición.

    Conclusión: ingeniería antes que hype

    Python + IA en producción funciona cuando tratas al LLM como un servicio: input → validación → procesamiento → output validado → observabilidad. Empieza por casos que entreguen ROI medible: clasificación y extracción. Añade RAG cuando la base de conocimiento sea crítica. Usa generación para acelerar humanos, no para sustituirlos.

    Para experimentación interna y pruebas de integración continua, considera también recursos y prototipos en Dominicode Labs. Es una continuación lógica para validar pipelines y plantillas operativas antes de llevarlos a producción.

    Recursos directos

    FAQ

    ¿Por qué usar temperature=0 para clasificación?

    Temperature=0 reduce la aleatoriedad en la generación, promoviendo respuestas deterministas que facilitan la validación contra enums o listas cerradas.

    ¿Cómo garantizar la fiabilidad de la extracción estructurada?

    Definiendo esquemas estrictos (Pydantic), obligando al LLM a devolver un modelo estructurado (Instructor/Structured Outputs) y aplicando validación previa a la inserción; en caso de fallo, usar retries y reglas deterministas.

    ¿Qué métricas son críticas para RAG?

    Recall de recuperación, precisión de respuestas ancladas, latencia end-to-end y coste por petición (tokens + inferencia).

    ¿Cuándo aplicar fallbacks rules-based?

    En casos críticos donde la validación falla o el coste de un error es alto; los fallbacks deben cubrir las rutas esenciales para mantener disponibilidad y consistencia.

    ¿Cómo integrar revisión humana sin frenar el flujo?

    Genera borradores estructurados y metadatos que reduzcan la edición humana al 20–30%, y delega la aprobación final a revisores mediante integraciones con CMS/Slack/Notion para revisión asincrónica.

    ¿Qué vector store elegir entre ChromaDB y pgvector?

    Elegir según infraestructura: ChromaDB para despliegues dedicados y rápidos de prototipo; pgvector si ya usas Postgres y necesitas consolidar datos en una sola plataforma.

  • Usar Python para Automatización y Conexión de APIs en Workflows Complejos

    Usar Python para Automatización y Conexión de APIs en Workflows Complejos

    Python como pegamento de automatización: Cómo usar Python para conectar APIs, scrapers, IA y bases de datos cuando n8n o no-code se quedan cortos

    Tiempo estimado de lectura: 4 min

    • Python complementa no-code: delega la orquestación a n8n y la lógica pesada a servicios Python.
    • Patrón híbrido: webhook → endpoint Python → procesamiento (scraping/IA/DB) → respuesta a n8n.
    • Stack práctico: httpx + pydantic, Playwright + BeautifulSoup, Pandas/Polars, LiteLLM + LangChain, Qdrant/Pinecone.
    • Buenas prácticas: validación temprana, retries/backoff, timeouts, observabilidad y bulk inserts para BD.

    Si estás aquí es porque n8n, Make o Zapier hicieron el trabajo fácil —hasta que dejaron de hacerlo. Este artículo muestra, con criterio técnico y ejemplos concretos, cómo usar Python como pegamento de automatización para conectar APIs, scrapers, modelos de IA y bases de datos cuando la orquestación visual alcanza su techo.

    Resumen rápido (lectores con prisa)

    Qué: usar Python para la lógica y el procesamiento pesado en flujos orquestados por n8n.

    Cuándo: ETL a gran escala, scraping de SPAs, pipelines de IA/RAG y operaciones BD eficientes.

    Por qué importa: control, rendimiento y acceso a bibliotecas maduras que no-code no ofrece.

    Cómo encaja: n8n dispara; Python procesa; Python persiste; n8n continúa con notificaciones o triggers.

    Python como pegamento de automatización: patrón, cuándo y por qué

    El patrón y cuándo usarlo

    El patrón es simple: n8n orquesta, Python ejecuta la lógica pesada. Usa Python cuando:

    • Procesas grandes volúmenes (ETL: 10k–100k filas).
    • Necesitas scraping de SPAs o interacción real con la web.
    • Ejecutas pipelines de ML/IA, RAG o agentes.
    • Requieres operaciones de base de datos eficientes (bulk inserts, transformaciones complejas).

    No es “todo código”. Es delegar lo que el no-code no puede: control, rendimiento y bibliotecas maduras.

    Arquitectura recomendada (híbrida)

    1. Trigger en n8n

    Trigger en n8n (webhook, email, scheduler).

    2. n8n envía un POST a un endpoint Python

    n8n envía un POST a un endpoint Python (FastAPI / serverless).

    3. Python valida, procesa y persiste

    Python valida, procesa (scraping / IA / ETL), persiste en DB o vector DB.

    4. Python devuelve JSON; n8n continúa

    Python devuelve JSON; n8n continúa (notificaciones, webhooks, triggers).

    Ejemplo mínimo FastAPI

    from fastapi import FastAPI
    from pydantic import BaseModel
    
    app = FastAPI()
    
    class Payload(BaseModel):
        urls: list[str]
    
    @app.post("/process")
    async def process(payload: Payload):
        # llama al scraping / IA / BD
        return {"status": "ok", "count": len(payload.urls)}

    Desplegar como Lambda o en un container permite escalado y control de costos.

    Librerías y patrones clave (stack práctico)

    HTTP + validación: httpx + pydantic

    httpx maneja async, retries y sesiones; pydantic valida entrada/salida y evita datos corruptos.

    Scraping: Playwright + BeautifulSoup

    Playwright simula navegador real para SPAs; BeautifulSoup para parseos rápidos de HTML estático.

    Transformación: Pandas / Polars

    Limpieza, join y chunking antes de cargas masivas. Polars si buscas rendimiento en paralelo.

    IA y agentes: LiteLLM + LangChain

    LiteLLM unifica modelos; LangChain orquesta RAG y agentes.

    Persistencia: SQLAlchemy / asyncpg / bulk insert

    Evita insertar fila a fila. Haz bulk inserts o COPY para Postgres.

    Observabilidad y resiliencia

    Tenacity, structlog, OpenTelemetry: retries, backoffs exponenciales, logs estructurados y tracing cross-service.

    Ejemplo: flujo RAG realista (n8n → Python → Qdrant → n8n)

    1. n8n sube PDF a S3 y hace webhook a /index.

    2. Endpoint Python:

    • Descarga PDF (PyMuPDF / unstructured).
    • Chunking semántico.
    • Embeddings (OpenAI o SentenceTransformers).
    • Upsert a Qdrant/Pinecone.

    3. Respuesta JSON con status y chunks indexados.

    4. n8n notifica al usuario.

    Este flujo evita que n8n haga operaciones pesadas y mantiene trazabilidad centralizada en Python.

    Buenas prácticas imprescindibles

    • Validación temprana: Pydantic rechaza malformados (425–422) antes de procesar.
    • Retries y backoff: tenacity + retryWhen pattern. No bombardees APIs con 500s.
    • Cancelación y timeouts: establece timeouts en httpx y límites en Playwright.
    • Pausas inteligentes: detecta contexto (mobile, background tab) si aplicable.
    • Observabilidad: logs estructurados (request_id), métricas (latencia, errores) y tracing.
    • Tipado y tests: type hints + unit tests + integration tests con fixtures que simulan n8n.
    • Gestión de dependencias: poetry + lockfile + imágenes Docker reproducibles.

    Casos donde no uses Python (o complementa con otra tecnología)

    • Latencia real-time (<1s) y alta frecuencia → WebSockets o SSE.
    • Arquitecturas totalmente event-driven con millones de eventos/s → sistemas stream (Kafka).
    • Si la lógica es mínimamente transformacional y n8n lo resuelve sin deuda técnica, mantén no-code.

    Recursos y enlaces útiles

    Conclusión

    Python como pegamento no es un capricho: es la manera de mantener workflows escalables, observables y mantenibles cuando la herramienta visual llega a su límite. Implementa el patrón híbrido, encapsula la complejidad en servicios Python bien diseñados y deja a n8n su papel: coordinar. Aplica estas prácticas y tu plataforma de automatización dejará de ser frágil para convertirse en una arquitectura sostenible y auditable.

    Para continuidad y experimentación con integraciones y prototipos avanzados puedes explorar recursos y proyectos de laboratorio en Dominicode Labs. Es una continuación lógica para validar patrones híbridos y pruebas de concepto centradas en automatización e IA aplicada.

    FAQ

    ¿Cuándo debo mover lógica de n8n a Python?

    Cuando la tarea requiere procesamiento intensivo (ETL de decenas de miles de filas), interacción con SPAs, pipelines de IA o operaciones de BD que no son eficientes en modo visual. Si n8n puede hacerlo sin deuda técnica, mantenlo; si no, extrae la lógica a Python.

    ¿Qué stack recomiendan para scraping de SPAs?

    Playwright para automatizar y renderizar SPAs, combinado con BeautifulSoup para parseo de HTML estático cuando corresponda. Añade timeouts y límites de concurrencia.

    ¿Cómo manejar grandes cargas hacia Postgres?

    Evita insertar fila a fila. Usa bulk inserts o COPY, y bibliotecas como SQLAlchemy/asyncpg para manejar conexiones y transacciones eficientemente.

    ¿Qué prácticas de observabilidad son imprescindibles?

    Logs estructurados con request_id, métricas (latencia, errores), tracing cross-service (OpenTelemetry) y retries con backoff controlado (tenacity).

    ¿Debo usar serverless o containers para endpoints Python?

    Depende del patrón de tráfico. Serverless puede ser rentable para picos esporádicos; containers facilitan control, dependencias y cargas sostenidas. Ambos son válidos según escalado y costos.

    ¿Cómo integrar RAG en el flujo con n8n?

    Haz que n8n suba los activos (ej. PDF) y dispare un webhook. Python se encarga de extracción, chunking, embeddings y upsert a un vector DB (Qdrant/Pinecone). Devuelve JSON con estado para que n8n notifique al usuario.

  • Por qué Python es el lenguaje preferido por los founders técnicos

    Por qué Python es el lenguaje preferido por los founders técnicos

    Por qué Python es el lenguaje favorito para founders técnicos

    Tiempo estimado de lectura: 6 min

    • Velocidad para convertir hipótesis en producto: sintaxis cercana al pseudocódigo y bajo boilerplate.
    • Ecosistema maduro: PyPI, FastAPI, Pydantic, Pandas y frameworks para producción.
    • Liderazgo en IA y datos: PyTorch, Hugging Face y orquestación para RAG y agentes.
    • Automatización y hiring: glue code rápido, integración con SaaS y pool de talento amplio.

    Por qué Python es el lenguaje favorito para founders técnicos: velocidad de ejecución mental

    La ventaja más concreta de Python es la reducción de la “fricción sintáctica”: su sintaxis es cercana al pseudocódigo. Eso importa cuando un founder técnico alterna entre producto, inversión y operaciones.

    • Menos boilerplate = menos contexto requerido para entender código ajeno.
    • Tipado gradual (type hints + Pydantic) permite pasar de prototipo a producción con seguridad.
    • Prototipado rápido: tareas comunes (procesar CSVs, exponer un endpoint) se hacen en unas pocas líneas con Pandas y FastAPI.

    Ejemplo práctico: montar un endpoint que reciba leads y calcule un score con Pandas y FastAPI toma horas, no días. Para validar hipótesis de negocio, esa diferencia es estratégica.

    Ecosistema: “batteries included” aplicado a startups

    PyPI ofrece paquetes maduros para casi cualquier necesidad. Esto reduce reinventar soluciones y acelera el delivery.

    Backend: FastAPI + Pydantic

    FastAPI + Pydantic facilitan APIs tipadas y documentación automática.

    Monolito con admin listo: Django

    Django sigue siendo la opción cuando necesitas panel y ORM desde el día 0.

    Procesamiento de datos: Pandas/NumPy

    Pandas/NumPy tienen la ergonomía necesaria para ETLs y análisis exploratorio.

    Jobs y orquestación

    Celery/Dramatiq y Airflow/Dagster para pipelines reproducibles.

    El ecosistema baja el riesgo técnico: menos piezas caseras, más componentes probados.

    IA y datos: la plataforma por defecto

    Si tu producto usa IA o modelos de lenguaje, Python no es solo conveniente: es la opción natural.

    Frameworks y herramientas

    Frameworks nativos como PyTorch y TensorFlow, y herramientas del ecosistema como Hugging Face.

    Orquestación y RAG

    Librerías de orquestación para agentes y RAG como LangChain y LlamaIndex.

    Integración directa con bases de datos vectoriales y pipelines de embeddings.

    Intentar construir una stack de IA sin Python suele terminar con un microservicio Python de todas formas. Unificar el stack simplifica arquitectura y contratación.

    Automatización y “glue code”: mover el producto

    Las startups viven de integrar SaaS y automatizar procesos: Stripe, Slack, Notion, CRMs. Python es el pegamento ideal.

    Scripts para migraciones, transformaciones y webhooks

    Scripts para migraciones, transformaciones y webhooks son rápidos de escribir y mantener.

    Herramientas low‑code: n8n

    Herramientas low‑code como n8n se complementan con Python para la lógica pesada.

    Mantener infra, ETL y producto en un lenguaje facilita la cultura DevOps y reduce fricción entre equipos.

    Cuando un founder necesita “hacer que algo funcione hoy”, Python es la respuesta que tiene menos fricción operativa.

    Hiring y productividad del equipo

    La disponibilidad de talento es un factor estratégico.

    • Python tiene una comunidad grande y diversa; el pool de candidatos es amplio.
    • La curva de aprendizaje es moderada, lo que reduce tiempo de onboarding.
    • Un desarrollador Python suele ser versátil: backend, datos, automatización y ML con el mismo lenguaje.

    Para una startup, esto significa contratar y girar el equipo sin romper el stack tecnológico.

    Cuándo no elegir Python: criterio honesto

    No es una panacea. El criterio técnico manda:

    Latencia extrema o sistemas de trading

    Rust/C++.

    Concurrencia masiva y pocos recursos por conexión

    Go/Elixir pueden ser mejores cuando se requieren millones de websockets y eficiencia por conexión.

    Aplicaciones móviles nativas

    Swift/Kotlin.

    Si el principal cuello de botella es rendimiento raw en producción, evalúa alternativas. En la mayoría de productos web/IA/prototipos, Python gana por su velocidad para aprender y cambiar.

    Conclusión

    Para un founder técnico, la tecnología debe maximizar aprendizaje y minimizar coste de cambio. Python entrega eso: velocidad mental, un ecosistema amplio, liderazgo en IA y facilidad para automatizar. No es el más rápido en benchmarks, pero sí el que acelera la construcción de negocios. Eso, para quien debe validar ideas y escalar rápido, es la ventaja competitiva más sólida.

    Si trabajas en automatización, agentes o workflows y quieres explorar integraciones y experimentos prácticos, considera recursos adicionales en Dominicode Labs como continuación lógica para prototipos y pruebas.

    FAQ

    ¿Por qué Python reduce el Time‑to‑Market?

    Porque su sintaxis cercana al pseudocódigo y el bajo boilerplate permiten convertir ideas en prototipos rápidamente. La disponibilidad de librerías maduras acelera tareas comunes (APIs, ETL, ML).

    ¿Es Python adecuado para producción en startups?

    Sí. Con prácticas adecuadas (tipado gradual, pruebas, despliegue y observabilidad) Python es perfectamente válido para producción en startups centradas en web, datos o IA.

    ¿Qué herramientas recomienda para APIs tipadas?

    FastAPI junto con Pydantic proporcionan APIs tipadas y documentación automática, lo que facilita pasar de prototipo a servicio estable.

    ¿Cómo encaja Python en una stack de IA?

    Python es el ecosistema por defecto para IA: frameworks como PyTorch y herramientas como Hugging Face permiten experimentación y despliegue; librerías de orquestación facilitan RAG y agentes.

    ¿Cuándo debería considerar Go, Rust o Elixir?

    Considera Rust/C++ cuando la latencia y rendimiento bruto son críticos. Go o Elixir son mejores para concurrencia masiva y eficiencia por conexión. Si el cuello de botella es rendimiento raw, evalúa estas alternativas.

    ¿Qué papel juegan herramientas low‑code como n8n?

    Herramientas como n8n aceleran integraciones y workflows; se complementan con Python para la lógica compleja o procesamiento intensivo.

  • Scripts en Python para optimizar tu productividad semanal

    Scripts en Python para optimizar tu productividad semanal

    Scripts en Python que te ahorran horas cada semana (Casos reales)

    Tiempo estimado de lectura: 4 min

    • Automatiza lo repetitivo: pequeñas tareas con scripts te devuelven horas cada semana.
    • Enfoque pragmático: ejemplos listos para copiar, adaptar y ejecutar hoy mismo.
    • Integración: combina Python con n8n o FastAPI para orquestación sin perder flexibilidad.
    • Producción segura: logging, retries, timeouts, tests y entornos reproducibles como pasos mínimos.

    Introducción

    Si buscas “Scripts en Python que te ahorran horas cada semana (casos reales)”, estás en el lugar correcto. En las primeras líneas: este artículo muestra scripts prácticos —limpieza de datos, renombrado masivo, scraping controlado y generación de informes— que puedes copiar, adaptar y ejecutar hoy mismo para recuperar horas semanales.

    No es teoría: son patrones productivos con código mínimo, buenas prácticas y enlaces a la documentación oficial para escalar a producción.

    Resumen rápido (lectores con prisa)

    Qué es: Colección de scripts Python prácticos para tareas repetitivas.

    Cuándo usarlo: Cuando procesos manuales consumen tiempo semanalmente.

    Por qué importa: Scripts reproducibles reducen errores humanos y liberan tiempo.

    Cómo funciona: Pequeños scripts con dependencias claras, logging y orquestación via n8n o FastAPI.

    Scripts en Python que te ahorran horas cada semana: cuatro casos reales

    1) Limpieza y normalización de datos (Pandas)

    Problema: CSVs semanales con fechas mixtas, espacios, duplicados. Resultado: 30 minutos manuales por archivo.

    Solución: usar pandas para normalizar columnas, coercionar fechas y eliminar duplicados. Dependencias: pandas.

    import pandas as pd
    
    def clean_sales(input_path, output_path):
        df = pd.read_csv(input_path)
        df.columns = df.columns.str.strip().str.lower().str.replace(' ', '_')
        if 'fecha_venta' in df:
            df['fecha_venta'] = pd.to_datetime(df['fecha_venta'], errors='coerce').dt.date
        df.drop_duplicates(subset=['email'], inplace=True)
        df.dropna(subset=['monto', 'email'], inplace=True)
        df.to_csv(output_path, index=False)
    

    Por qué funciona: debug determinista, reproducible y scriptable desde cron o n8n.

    2) Renombrado y organización masiva de archivos (Pathlib)

    Problema: carpeta Downloads repleta de facturas, imágenes y PDFs sin orden.

    Solución: Pathlib + shutil para mover por fecha de modificación o por patrón. Pathlib docs.

    from pathlib import Path
    import shutil
    from datetime import datetime
    
    src = Path.home() / "Downloads"
    dst = Path.home() / "Documents/Invoices"
    
    for f in src.glob("*.pdf"):
        ts = datetime.fromtimestamp(f.stat().st_mtime)
        target = dst / str(ts.year) / f"{ts.month:02d}"
        target.mkdir(parents=True, exist_ok=True)
        shutil.move(str(f), str(target / f.name))
    

    Impacto: cientos de archivos organizados en segundos, sin errores humanos.

    3) Scraping controlado y monitoreo (Requests + BeautifulSoup)

    Problema: comprobar precios o disponibilidad manualmente cada mañana.

    Solución: Requests + BeautifulSoup para sitios estáticos. Respecta robots.txt y usa headers.

    import requests
    from bs4 import BeautifulSoup
    
    url = "https://ejemplo.com/producto"
    headers = {"User-Agent": "bot@miempresa.com"}
    r = requests.get(url, headers=headers, timeout=10)
    r.raise_for_status()
    soup = BeautifulSoup(r.text, "html.parser")
    price = soup.select_one(".price").get_text(strip=True)

    Cuando la web es dinámica, usa Playwright.

    Buenas prácticas: backoff en reintentos, pausas entre requests y registro estructurado.

    4) Generación automática de informes (Jinja2 → Email/HTML/PDF)

    Problema: compilar métricas de distintas fuentes y formatearlas manualmente cada semana.

    Solución: Jinja2 para plantilla HTML + render + envío por SMTP o vía n8n. Jinja2 docs.

    from jinja2 import Environment, FileSystemLoader
    env = Environment(loader=FileSystemLoader("templates"))
    tpl = env.get_template("weekly.html")
    html = tpl.render(metrics=metrics_dict)

    Patrón:

    • Recoger datos (DB / API)
    • Renderizar plantilla Jinja2
    • Guardar HTML o convertir a PDF (weasyprint / wkhtmltopdf)
    • Enviar por correo o subir a un canal Slack

    Automatización: conviértelo en endpoint FastAPI o ejecútalo desde n8n.

    Cómo convertir un script útil en una automatización confiable

    • Logging estructurado: usa logging/structlog, evita prints.
    • Configuración externa: variables de entorno (.env), no claves hardcodeadas.
    • Retries y backoff: tenacity o patrones de retry para redes inestables.
    • Timeouts y cancelación: define límites en requests/Playwright.
    • Tests y tipo: type hints + pytest para evitar regresiones.
    • Entornos reproducibles: poetry/venv y Dockerfile.
    • Observabilidad: métricas de ejecución y alertas (errores, latencias).

    Integración práctica con n8n y workflow orquestado

    Patrón recomendado: n8n orquesta (triggering, branching, notificaciones) → tu servicio Python ejecuta la tarea pesada → devuelve JSON → n8n sigue con distribución y persistencia. Esto mantiene la UX del no-code y la potencia de Python para lo que importa.

    n8n Execute Command o un endpoint HTTP (FastAPI) son las formas más sencillas de integrar.

    Conclusión: dónde empezar hoy

    Elige la tarea que te roba más tiempo y conviértela en script. Empieza por:

    • limpieza de datos si trabajas con CSVs;
    • organización de archivos si pierdes tiempo buscando;
    • scraping si haces comprobaciones manuales diarias;
    • reportes si dedicas horas a consolidar métricas.

    Implementa logging, pruebas mínimas y despliega como función serverless o servicio ligero. Un script que hoy te ahorre 30 minutos semanales será un activo que multiplica su valor con el tiempo.

    Recursos

    Si trabajas con automatización, n8n o workflows y quieres continuar experimentando con patrones y pruebas, visita Dominicode Labs para recursos adicionales y experimentos prácticos. Es una continuación lógica para quienes combinan no-code y código en producción.

    FAQ

    ¿Qué dependencias necesito?

    Depende de la tarea: para limpieza de datos, pandas. Para scraping estático, Requests y BeautifulSoup. Para render dinámico, Playwright. Para plantillas, Jinja2.


    ¿Cómo integrarlo con n8n?

    Usa n8n como orquestador: trigger → ejecutar comando → recibir JSON. Puedes usar Execute Command o un endpoint HTTP (FastAPI) que reciba peticiones desde n8n y devuelva resultados procesables.


    ¿Qué pruebas debo escribir?

    Tests unitarios básicos con pytest y pruebas de integración para las interacciones de red o filesystem. Añade type hints y pruebas que cubran casos esperados y errores comunes (fechas inválidas, campos faltantes, timeouts).


    ¿Cómo manejar secretos y configuración?

    Usa variables de entorno, managers de secretos o servicios de vault. Nunca hardcodees claves en el repositorio; utiliza .env para desarrollo y soluciones seguras en producción.


    ¿Qué hacer si el scraping requiere JS?

    Pasa a herramientas headless como Playwright o Puppeteer. Define timeouts, espera selectores y respetar robots.txt y límites de requests.


    ¿Cómo convertir HTML a PDF?

    Renderiza tu plantilla Jinja2 a HTML y usa weasyprint o wkhtmltopdf para la conversión. Alternativamente genera HTML y envíalo por correo si PDF no es estrictamente necesario.