Tag: PostgreSQL

  • Sincronizar el read model en CQRS: outbox, idempotencia y rebuild

    Sincronizar el read model en CQRS: outbox, idempotencia y rebuild

    Un lunes por la mañana, soporte abrió un ticket con la frase que más miedo da de todas: «el cliente dice que pagó y su pedido sigue saliendo como pendiente».

    Miramos la tabla de pedidos. Pagado. Miramos la vista que consume el frontend. Pendiente. Llevaba once días así.

    Nadie se había enterado porque el sistema no estaba roto. Todos los endpoints devolvían 200. Los logs estaban limpios. Simplemente, el read model se había quedado atrás y no existía ninguna alarma que mirase esa diferencia.

    Ese es el problema real de CQRS: cómo sincronizar el read model con el write model sin que se pudra. No aparece el día que lo eliges; aparece tres meses después. Si todavía estás decidiendo si el patrón te conviene, ese es otro debate — qué es CQRS y cuándo compensa aplicarlo. Este post empieza el día siguiente.

    Y la tesis, por delante: no pierdes eventos por culpa del bus. Los pierdes en el hueco que hay entre tu COMMIT y tu publish.


    Por qué el read model se desincroniza: el problema del dual write

    El read model se desincroniza porque el cambio de estado y la publicación del evento son dos operaciones contra dos sistemas distintos, sin transacción común. Si la segunda falla, no queda nadie para reintentarla.

    Este código lo he visto en producción más veces de las que me gustaría:

    await db.query(`update orders set status = 'paid' where id = $1`, [orderId])
    await bus.publish('order.paid', { orderId })
    

    Dos líneas. Parecen una unidad. No lo son.

    Entre la primera y la segunda cabe todo: un timeout del broker, un deploy que mata el pod, el OOM killer, un ECONNRESET. Si la segunda línea falla, la base de datos de escritura dice "pagado" y el read model no se entera nunca. No hay reintento que te salve, porque el proceso que tenía que reintentar ya no existe.

    Invertir el orden es peor. Si publicas primero y la transacción hace rollback después, has emitido un evento sobre algo que no ocurrió. El read model muestra un pedido pagado que en la fuente de verdad sigue pendiente. Ese bug se tarda semanas en encontrar.

    Esto tiene nombre: dual write. Escribir en dos sistemas que no comparten transacción. No se arregla con try/catch, ni con reintentos en el catch, ni metiendo el publish dentro de la transacción —porque la red no hace rollback.

    La solución académica es 2PC. La que usa la gente que tiene que dormir por las noches es otra.


    Transactional outbox: sincronizar el read model en una sola transacción

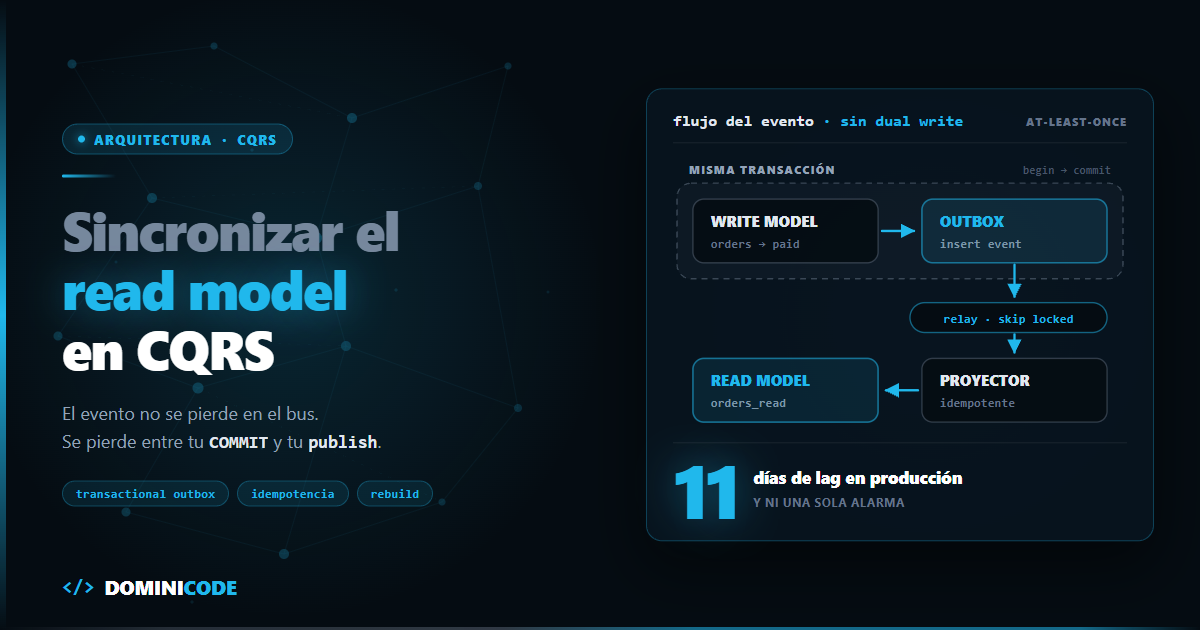
    El transactional outbox es un patrón que elimina el dual write escribiendo el evento en una tabla de la misma base de datos, dentro de la misma transacción que el cambio de estado; un proceso aparte —el relay— lee esa tabla y lo publica en el bus. Está catalogado así en el catálogo de patrones de microservicios de Chris Richardson.

    Y la idea es tonta de simple: si no puedes hacer atómicas dos operaciones contra dos sistemas, haz que las dos vayan contra el mismo sistema.

    El evento no se publica. Se inserta en una tabla de la misma base de datos, dentro de la misma transacción que el cambio de estado. Si el COMMIT pasa, el evento existe. Si no pasa, tampoco. Atomicidad gratis, la que ya te da Postgres.

    create table outbox (
      id             bigserial   primary key,
      aggregate_id   uuid        not null,
      aggregate_type text        not null,
      event_type     text        not null,
      version        int         not null,
      payload        jsonb       not null,
      occurred_at    timestamptz not null default now(),
      published_at   timestamptz
    );
    
    -- índice parcial: solo lo pendiente, que es lo que el relay consulta cada tick
    create index outbox_pending_idx on outbox (id) where published_at is null;
    

    Y el comando queda así:

    import { Pool } from 'pg'
    
    const pool = new Pool({ connectionString: process.env.DATABASE_URL })
    
    export async function markOrderAsPaid(orderId: string, total: number) {
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        const { rows } = await client.query<{ version: number }>(
          `update orders
              set status = 'paid', paid_at = now(), version = version + 1
            where id = $1 and status = 'pending'
            returning version`,
          [orderId],
        )
    
        if (rows.length === 0) throw new Error('ORDER_NOT_PENDING')
    
        await client.query(
          `insert into outbox (aggregate_id, aggregate_type, event_type, version, payload)
           values ($1, 'order', 'order.paid', $2, $3)`,
          [orderId, rows[0].version, { orderId, total, paidAt: new Date().toISOString() }],
        )
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Fíjate en el returning version. Ese número lo vas a necesitar dentro de dos secciones y es lo que separa un read model correcto de uno que a veces acierta.

    El relay

    Un proceso aparte lee la tabla y publica. Nada más. La clave está en el for update skip locked —disponible desde Postgres 9.5—: te deja correr varias instancias del relay sin que dos cojan la misma fila.

    export async function relayTick(bus: Bus, batchSize = 100) {
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        const { rows } = await client.query<OutboxRow>(
          `select id, aggregate_id, event_type, version, payload, occurred_at
             from outbox
            where published_at is null
            order by id
            limit $1
              for update skip locked`,
          [batchSize],
        )
    
        for (const row of rows) {
          await bus.publish({
            id: String(row.id),
            type: row.event_type,
            aggregateId: row.aggregate_id,
            version: row.version,
            payload: row.payload,
            occurredAt: row.occurred_at,
          })
        }
    
        if (rows.length > 0) {
          await client.query(
            `update outbox set published_at = now() where id = any($1::bigint[])`,
            [rows.map((r) => r.id)],
          )
        }
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Léelo otra vez y busca el agujero, porque lo tiene: si bus.publish va bien y el commit del update ... published_at falla, el evento sale publicado dos veces.

    Eso es intencionado. El outbox te garantiza at-least-once, nunca exactly-once. Y está bien. Preferimos un evento duplicado que un evento perdido, porque el duplicado se resuelve en el consumidor y la pérdida no se resuelve en ningún sitio.

    El relay es, además, donde el bus te va a fallar de verdad. Con el broker caído, reintentar en bucle cerrado solo empeora las cosas: aplica el mismo razonamiento que expliqué sobre circuit breakers y clasificación de fallos. Cortar, esperar, dejar que el outbox acumule. Para eso está la tabla: el relay puede pasarse diez minutos parado y no se pierde ni un evento.


    Idempotencia en el proyector: procesar dos veces sin duplicar

    Si el bus entrega al menos una vez, el proyector tiene que poder comerse el mismo evento dos veces y terminar en el mismo estado. Punto.

    Dos piezas: una tabla que registra qué eventos ya se procesaron y un upsert que no dependa del orden de llegada.

    create table processed_events (
      projection   text        not null,
      event_id     bigint      not null,
      processed_at timestamptz not null default now(),
      primary key (projection, event_id)
    );
    
    create table projection_checkpoint (
      projection    text        primary key,
      last_event_id bigint      not null default 0,
      updated_at    timestamptz not null default now()
    );
    
    create table orders_read (
      order_id uuid        primary key,
      status   text        not null,
      total    numeric     not null,
      paid_at  timestamptz,
      version  int         not null
    );
    

    El primary key de order_id no es decorativo: sin esa restricción única, el on conflict (order_id) del proyector ni siquiera llega a ejecutarse.

    Antes de tocar nada, valida el payload. El evento viaja como JSON opaco y puede llevar meses en la tabla: el día que alguien cambie su forma en el productor, tu proyector recibirá algo que no espera. Parsea siempre con un schema —aquí, Zod 4— y manda a dead letter lo que no cumpla, en vez de dejar que un undefined acabe escrito en la vista.

    import { z } from 'zod'
    
    const OrderPaid = z.object({
      orderId: z.uuid(),
      total: z.number().nonnegative(),
      paidAt: z.iso.datetime(),
    })
    
    export async function projectOrderPaid(event: DomainEvent) {
      const parsed = OrderPaid.safeParse(event.payload)
      if (!parsed.success) {
        await deadLetter(event, parsed.error)
        return
      }
    
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        // 1. Reclamar el evento. Si ya estaba, no hacemos nada más.
        const claim = await client.query(
          `insert into processed_events (projection, event_id)
           values ('orders_read', $1)
           on conflict do nothing`,
          [event.id],
        )
    
        if (claim.rowCount === 0) {
          await client.query('rollback')
          return
        }
    
        // 2. Upsert con guarda de versión.
        await client.query(
          `insert into orders_read (order_id, status, total, paid_at, version)
           values ($1, 'paid', $2, $3, $4)
           on conflict (order_id) do update
              set status  = excluded.status,
                  total   = excluded.total,
                  paid_at = excluded.paid_at,
                  version = excluded.version
            where orders_read.version < excluded.version`,
          [parsed.data.orderId, parsed.data.total, parsed.data.paidAt, event.version],
        )
    
        // 3. Avanzar el checkpoint.
        await client.query(
          `update projection_checkpoint
              set last_event_id = greatest(last_event_id, $1), updated_at = now()
            where projection = 'orders_read'`,
          [event.id],
        )
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Lo importante: los tres pasos van en la misma transacción. Si el proceso muere entre el paso 1 y el 2, el rollback deshace la reclamación y el evento se vuelve a entregar. Sin transacción, esa tabla de deduplicación no te protege, te miente.

    Este parseo de eventos es, por cierto, uno de los sitios donde Zod paga solo: el mismo schema te da el tipo de TypeScript, la validación en runtime y el mensaje de error que vas a leer en el dead letter a las tres de la mañana.

    Si quieres exprimir esa parte —discriminated unions por event_type, transformaciones, versionado de schemas— lo trabajo a fondo en el curso de Zod para TypeScript.


    Orden y versiones: cuando el v3 llega antes que el v2

    Ningún bus te garantiza el orden global. Con particiones, reintentos y varios consumidores en paralelo, el evento v3 de un pedido puede llegar antes que el v2. Es normal, no es un bug del broker.

    La cláusula que ya has visto arriba resuelve el caso:

    where orders_read.version < excluded.version
    

    Si llega el v3 y lo aplicas, cuando aparezca el v2 el WHERE da falso y el update no ocurre. El evento viejo se descarta en silencio, que es exactamente lo que quieres: tu read model no retrocede jamás.

    Ahora la letra pequeña, que es donde se rompe la gente: esto solo funciona si tus eventos llevan el estado completo. Si order.paid dice "el total es 120 y el estado es paid", aplicar el v3 y tirar el v2 deja la vista correcta. Si tus eventos son deltas —"suma 3 al stock", "descuenta 20 del saldo"— descartar el v2 te deja con un número mal para siempre.

    Con deltas necesitas detectar huecos y esperar. Cambias la guarda por una igualdad estricta:

    -- solo aplico si soy exactamente el siguiente
    where orders_read.version = excluded.version - 1
    

    Y si rowCount === 0 y la versión del evento es mayor que la actual más uno, lanzas para que el bus te lo vuelva a entregar más tarde, cuando el que falta ya haya pasado.

    Cambia también el SET: con deltas ya no copias excluded, acumulas — set total = orders_read.total + excluded.total. Y ojo al caso borde, que es el que muerde: esa guarda solo se evalúa en la rama DO UPDATE. Si la fila todavía no existe, el INSERT entra con la versión que traiga y el hueco pasa sin que nadie lo vea. Con deltas, crea la fila en la versión 0 cuando das de alta el agregado.

    Mi recomendación después de sufrir las dos: haz los eventos state-carrying siempre que puedas. Pesan más en la cola y a cambio te ahorran toda la maquinaria de gaps, buffers y reentregas. Es el cambio de diseño más rentable de esta lista.


    Rebuild de proyecciones: el superpoder que nadie usa

    Aquí está la parte buena de CQRS, la que compensa todo lo anterior: si tu read model es una función pura de la secuencia de eventos, el read model es desechable. ¿Se corrompió por un bug del proyector? Lo tiras. ¿Quieres añadir una columna calculada a la vista? Lo tiras. ¿Cambias la forma entera de la proyección? Lo tiras.

    Con la condición que casi nadie cumple: no borres los eventos. Un outbox con delete from outbox where published_at is not null es un outbox que funciona y que te quita esta capacidad para siempre. Archiva a un event_log en vez de borrar. Es la diferencia entre una cola y un log.

    El patrón es proyección versionada, y son cuatro pasos:

    1. Creas orders_read_v2 con el esquema nuevo, vacía, y su propia fila en projection_checkpoint.
    2. Arrancas el proyector v2 en modo replay, leyendo el event_log desde el id 0. El v1 sigue vivo y sirviendo tráfico.
    3. Cuando el v2 alcanza al v1 y ambos consumen en tiempo real, comparas. Unos cuantos agregados a mano o un diff de checksums.
    4. Cambias el puntero.

    Ese cambio de puntero es lo único delicado. Si la capa de consulta lee a través de una vista, es una sentencia:

    begin;
      drop view orders_read_current;
      create view orders_read_current as select * from orders_read_v2;
    commit;
    

    Dentro de la transacción toma un ACCESS EXCLUSIVE sobre la vista: las consultas en vuelo esperan unos milisegundos y siguen. Y no, create or replace view no vale aquí: solo admite añadir columnas al final, no cambiar nombres, tipos ni orden —que es exactamente lo que cambia en un rebuild.

    Si no tienes vista, usa un flag de configuración que lea la capa de consulta al construir la query: más código, pero te deja volver atrás sin desplegar.

    Con un rebuild fiable, tocar el read model deja de dar miedo. Ya no migras datos con un ALTER TABLE a las dos de la mañana: construyes una tabla nueva en paralelo, con tráfico real, y decides con datos si la enciendes.

    Un apunte de método: el evento order.paid es una API pública aunque no tenga endpoint. Quién lo emite, qué campos garantiza y cómo se versiona tiene que estar escrito antes de picar el proyector.

    Es de lo que más insisto en el libro de Spec-Driven Development, y en sistemas de eventos se nota el doble: el coste de equivocarte no lo pagas en el deploy, lo pagas seis meses después, cuando ya hay cuatro consumidores.


    Medir el lag del read model: el único aviso temprano que vas a tener

    En CQRS la consistencia eventual no es un fallo, es el contrato: el read model siempre va algo por detrás del write model. El fallo es no saber cuánto.

    Todo lo anterior puede estar bien implementado y aun así tu read model puede ir veinte minutos por detrás porque el relay se quedó colgado. No se lanza ninguna excepción. No hay error 500. Todo está "verde".

    Solo hay una métrica que te avisa: la antigüedad del evento pendiente más viejo.

    select coalesce(
      extract(epoch from now() - min(o.occurred_at)),
      0
    ) as lag_seconds
    from outbox o
    left join processed_events p
           on p.projection = 'orders_read'
          and p.event_id   = o.id
    where p.event_id is null;
    

    Devuelve 0 cuando no hay nada pendiente y crece cuando algo se atasca. Exponla como gauge y ponle alerta.

    No la escribas contra last_event_id del checkpoint. Como el checkpoint avanza con greatest(), es una marca de agua alta: el v2 que se fue al dead letter queda por debajo de ella, la query no lo ve y te devuelve 0 con la proyección rota. Que es, literalmente, el ticket de los once días. Si purgas processed_events, limita el anti-join a tu ventana de retención.

    Cuidado con la versión ingenua de esta métrica, que es la que suele estar puesta: now() - last_event_at del checkpoint. Esa te mide "cuánto hace que proyecté algo", y si a las tres de la madrugada no hay tráfico te va a despertar sin motivo. Peor: te acostumbra a ignorar la alarma. Mide lo que está esperando, no lo último que hiciste.

    Yo añado dos series más al dashboard:

    • Lag en eventos: cuántas filas del outbox siguen sin aparecer en processed_events. Te dice si el proyector está perdiendo la carrera. No lo calcules como max(id) − last_event_id: arrastra exactamente el mismo punto ciego de la marca de agua.
    • Tamaño del dead letter: si crece, hay eventos que no se están aplicando y el read model ya está mal.

    Con esas tres, aquel ticket de los once días se habría abierto en once minutos.


    Cuándo no necesitas absolutamente nada de esto

    Si tu "read model" es una réplica de lectura de la misma base de datos, no tienes este problema. Postgres replica por ti, la sincronía la resuelve el WAL, y tu única métrica es el lag de replicación —que ya viene dado por pg_last_xact_replay_timestamp() y pg_stat_replication.

    Nada de outbox, nada de proyectores, nada de checkpoints. Si separaste lectura y escritura solo para repartir carga, esa es la respuesta correcta y es aburridísima, que es justo lo que quieres en infraestructura.

    Lo mismo si tu vista denormalizada es una materialized view en la misma base y toleras refrescarla cada pocos minutos. REFRESH MATERIALIZED VIEW CONCURRENTLY resuelve más casos de los que la gente cree. Pide dos cosas: un índice UNIQUE sobre columnas —sin expresiones y sin WHERE— y que la vista ya esté poblada. A cambio refresca sin bloquear lecturas, aunque tarda bastante más que un refresh normal.

    Todo lo de este post empieza a hacer falta cuando el read model vive en otro sitio: otro motor, otro servicio, un índice de búsqueda, una tabla con una forma que no se deriva de un SELECT. Ahí sí tienes dual write y ahí sí necesitas el outbox.

    Dónde vive tu read model Cómo se sincroniza Qué tienes que operar Lag típico
    Réplica de lectura, misma base Replicación física (WAL) Nada, lo hace Postgres Milisegundos
    Materialized view, misma base REFRESH MATERIALIZED VIEW CONCURRENTLY Un cron Minutos
    Otra tabla, otro servicio, índice de búsqueda Transactional outbox + relay Tabla outbox, relay, checkpoints Segundos
    Igual que arriba, sin mantener relay CDC leyendo el WAL Kafka + Connect Segundos

    Y si estás en ese caso pero no quieres mantener la tabla ni el relay, mira CDC antes de escribir código: resuelve lo mismo leyendo el WAL, a cambio de infraestructura extra. Lo desarrollo en las preguntas de abajo.


    Qué hacer hoy

    Si ya tienes CQRS en producción y nada de esto está montado, no empieces por el outbox. Empieza por la métrica.

    Escribe la query del lag, ponla en un dashboard y déjala una semana. Vas a descubrir dos cosas: cuántos eventos estabas perdiendo sin saberlo, y si tu problema real era ese o era otro. Es media hora de trabajo, y es lo único de esta lista que te da información antes de que te la pida un cliente enfadado. El resto —outbox, idempotencia, versiones, rebuild— se construye después, con datos encima de la mesa.

    Si quieres ver este tipo de arquitecturas montadas de principio a fin, con el código completo y las decisiones discutidas, en Dominicode Labs es donde publico los proyectos largos que no caben en un post.


    Preguntas frecuentes

    ¿Por qué mi read model no se actualiza en CQRS?

    Casi siempre por dual write: el cambio de estado se guardó, pero el evento nunca llegó al bus porque publicar y hacer commit son dos operaciones distintas y la segunda falló sin que nadie reintentara.

    Los otros dos sospechosos habituales son el relay parado —el evento sigue en la tabla outbox con published_at a null— y un evento que el proyector rechaza una y otra vez hasta acabar en el dead letter. Los tres casos se distinguen en treinta segundos con la query de lag de este post: si devuelve un número alto, el evento existe y no se ha proyectado; si devuelve 0 y la vista sigue mal, mira el dead letter.

    ¿El transactional outbox añade latencia a cada escritura?

    Añade un INSERT dentro de una transacción que ya estaba abierta. En la práctica es ruido comparado con el resto del comando.

    La latencia que sí importa es la otra: cuánto tarda el evento en llegar al read model. Eso lo marca el intervalo de polling del relay, no el insert. Si necesitas bajarlo, usa LISTEN/NOTIFY de Postgres para despertar al relay en cuanto hay una fila nueva, en lugar de esperar al siguiente tick.

    ¿Puedo usar CDC en lugar de la tabla outbox?

    Sí, y resuelve el mismo problema de dual write. Debezium lee el WAL de Postgres y publica los cambios sin que tu código haga nada — trae incluso un outbox event router preparado exactamente para este patrón.

    La diferencia es qué publicas. Con outbox publicas eventos de dominio que tú diseñas; con CDC a secas publicas cambios de filas, y tus consumidores acaban acoplados al esquema de tu base de datos. El punto medio más usado es CDC leyendo precisamente la tabla outbox: eventos de dominio sin escribir relay, a cambio de operar Kafka y Connect.

    ¿Qué hago con un evento que el proyector nunca consigue procesar?

    Dead letter después de N intentos, y alerta. Lo que no puedes hacer es reintentarlo en bucle para siempre: bloqueas la partición y frenas todo lo que viene detrás.

    Ojo con la consecuencia que se pasa por alto: si mandas a dead letter el v2 de un agregado y sigues procesando el v3, esa fila queda incoherente hasta que reproceses. Por eso el dead letter va en el dashboard y no en un buzón que nadie abre.

    ¿Necesito event sourcing para poder reconstruir proyecciones?

    No. Necesitas retener los eventos, que es mucho menos que event sourcing.

    En event sourcing el log de eventos es la fuente de verdad y el estado se deriva de él. Aquí la fuente de verdad sigue siendo tu tabla orders, y el log de eventos es solo el historial de cambios publicados. Con archivar el outbox en un event_log en vez de borrarlo ya puedes reconstruir cualquier proyección.

    ¿Cada cuánto debería hacer polling del outbox?

    Depende del lag que tu producto tolere, no de lo que haga la industria. Un panel interno aguanta segundos; un contador que el usuario ve moverse tras pulsar un botón, no.

    Define el número primero —"el read model va como mucho X segundos por detrás"—, mídelo con la query de lag y ajusta el intervalo hasta cumplirlo. Sin ese número escrito, cualquier valor que pongas es una opinión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Abro una app de notas con IA, escribo una pregunta y espero.

    No espero al modelo. Eso lo entiendo: el modelo piensa. Espero a que la app viaje al servidor para leer tres filas de mi propio historial, las traiga de vuelta y solo entonces monte el prompt. Doscientos milisegundos de red para leer datos que ya estaban en mi portátil.

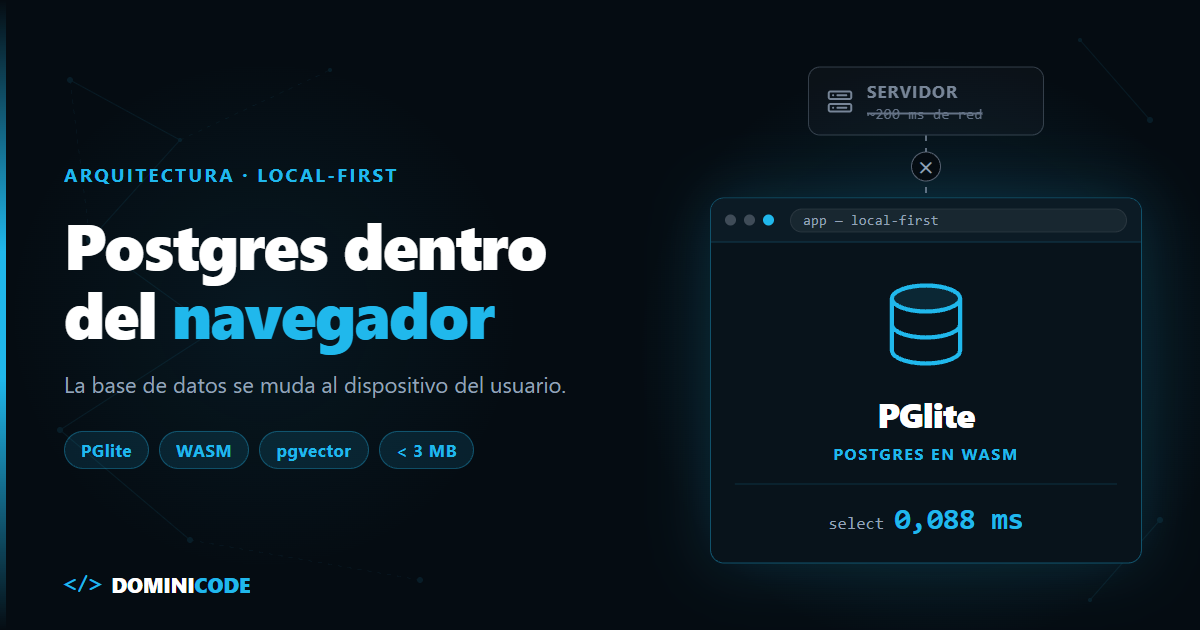
    Ese es el patrón por defecto de casi todas las apps de IA que reviso. La arquitectura local-first le da la vuelta: la base de datos vive en el dispositivo del usuario, la app lee de ahí a velocidad de memoria, y el servidor pasa de ser la fuente de toda verdad a ser un destino de sincronización.

    Aquí va la tesis. Mover la base de datos al cliente no es una optimización: es un cambio de arquitectura que reparte de otra forma la latencia, el coste de tokens y la privacidad, y a cambio te devuelve tres problemas que en el servidor no tenías — una sola conexión, migraciones que corren en máquinas que no controlas, y un camino de escritura hacia el servidor que nadie te da hecho.

    Si terminas de leer sabiendo si te toca o no, el post ha cumplido.

    Qué es la arquitectura local-first

    Local-first es una arquitectura en la que la base de datos vive en el dispositivo del usuario: la aplicación lee y escribe siempre contra esa copia local, a velocidad de memoria, y el servidor deja de ser la fuente de toda verdad para convertirse en un destino de sincronización. La app funciona sin red por defecto, no como caso degradado.

    No es lo mismo que cachear. Una caché es una copia que aceleras y que puedes tirar; en local-first la copia local es donde de verdad ocurre todo, y la red es un detalle de implementación.

    Qué es PGlite y por qué no es "otra base de datos en el navegador"

    PGlite es Postgres compilado a WebAssembly y empaquetado como librería de TypeScript. Corre en el navegador, en Node.js y en Bun, sin dependencias externas y sin proceso servidor.

    La distinción que importa está en su propia documentación: "Unlike previous 'Postgres in the browser' projects, PGlite does not use a Linux virtual machine – it is simply Postgres in WASM."

    Eso no es marketing, es la decisión arquitectónica del proyecto. Los intentos anteriores emulaban una máquina Linux entera para arrancar encima un Postgres normal: pagabas el peso de un sistema operativo simulado para ejecutar un SELECT. PGlite elimina esa capa.

    Los números, para que no tengas que buscarlos:

    • PGlite pesa menos de 3 MB gzipped y corre Postgres compilado a WASM, sin máquina virtual Linux.
    • Persiste en memoria (efímero), en IndexedDB en el navegador, o en el sistema de ficheros en Node y Bun.
    • La versión actual de @electric-sql/pglite es la 0.5.8, publicada el 26 de agosto de 2026, y el plugin de sincronización @electric-sql/pglite-sync va por la 0.6.9.

    Retén ese "0.x". Vuelvo a ello más abajo.

    Qué gana una app de IA con arquitectura local-first

    Una app de IA gana tres cosas al pasar a local-first: latencia de microsegundos en lugar de un round-trip de red, menos tokens por turno porque filtras el contexto donde ya están los datos, y una garantía de privacidad real porque el historial no tiene por qué salir del dispositivo. Ninguno de los tres es "va más rápido" a secas.

    Latencia: microsegundos frente a un round-trip de red

    Los benchmarks oficiales, medidos en un MacBook Air M2 con PGlite en memoria, dan estos tiempos de ida y vuelta por operación: insert de una fila pequeña en 0,058 ms, select en 0,088 ms, update en 0,073 ms y delete en 0,145 ms.

    Compáralo con los 50-200 ms de una llamada HTTP a tu API y el cambio deja de ser cuantitativo: pasa a ser de diseño.

    Cuando leer cuesta microsegundos dejas de diseñar para minimizar consultas. Se acabó cachear tres pantallas por delante, montar endpoints agregados y pintar skeletons.

    Coste de tokens: RAG en el navegador con pgvector

    Este es el eje que más se subestima, y el que de verdad justifica local-first en una app de IA.

    El patrón habitual del chatbot es incómodo cuando lo miras de frente: mandas todo el historial al servidor en cada turno para que el backend reconstruya un contexto que ya estaba entero en el dispositivo del usuario. Pagas tokens por transportar información que no había salido de casa.

    Con un Postgres real en el cliente filtras el contexto en local —con SQL de verdad, joins y filtros por fecha— y mandas al modelo solo lo que importa. Y como PGlite soporta pgvector, ese filtro puede ser búsqueda semántica y no solo un WHERE:

    import { PGlite } from '@electric-sql/pglite'
    import { vector } from '@electric-sql/pglite-pgvector'
    
    const pg = new PGlite({
      extensions: { vector },
    })
    
    await pg.exec('CREATE EXTENSION IF NOT EXISTS vector;')
    

    La consulta por distancia de embeddings corre en el navegador y solo los cinco fragmentos relevantes viajan al modelo:

    SELECT id, content
    FROM chunks
    ORDER BY embedding <-> $1::vector
    LIMIT 5;
    

    Ese <-> es distancia euclídea; si tus embeddings vienen de OpenAI, lo habitual es coseno con <=>. Elige el operador que case con el índice que crees, no el del ejemplo que copiaste.

    Decidir qué entra en el contexto antes de escribir el primer prompt es justo el trabajo que hacemos en el curso de Construye con IA: el prompt no es el sistema, es la última capa.

    Si vienes de montar RAG en servidor, el contraste está en Búsqueda híbrida y embeddings en Supabase — misma técnica, distinto sitio. Y si aún dudas de si tu caso pide RAG, contexto o fine-tuning, esa decisión va antes que esta y la tienes en RAG vs fine-tuning vs contexto.

    Privacidad: los datos no salen del dispositivo

    En una app de notas es un argumento de venta. En salud, legal o finanzas es el requisito que decide si el proyecto existe.

    Con la base de datos en el cliente decides tú qué se sincroniza. Y puedes decidir que nada: si esa tabla no entra en ningún shape, el historial del usuario nunca toca tu infraestructura. Solo sale lo que mandas al modelo, y eso lo controlas con una consulta, no con una política de retención.

    Es la diferencia entre "prometemos que no miramos tus datos" y "no los tenemos".

    Pero ese modo máximo se paga dos secciones más abajo: sin copia en servidor no hay red de seguridad para las migraciones ni multi-dispositivo. Privacidad total y recuperación ante desastres son dos posiciones del mismo mando.

    Cómo queda la arquitectura: PGlite como fuente de verdad local

    PGlite es la fuente de verdad para la UI: la aplicación lee y escribe siempre contra la base local, nunca contra la red. El servidor mantiene su Postgres, que sigue siendo la fuente de verdad del negocio, y las escrituras llegan hasta él por un camino que montas tú. Ahora vuelvo a eso.

    Entre los dos, sincronización basada en shapes. Un shape es un subconjunto de una tabla: no te bajas messages entera, te bajas "los mensajes de las conversaciones de este usuario de los últimos 90 días". El cliente declara qué porción del mundo le interesa y el sync la mantiene al día.

    Y aquí va el matiz que decide presupuestos: ese sync va en una sola dirección. La documentación de pglite-sync no se esconde — "We don't yet support local writes being synced out, or conflict resolution" — y Electric lo remata: hace read-path sync, y no hace write-path sync.

    Traducido: el camino servidor → cliente te lo dan hecho. El camino cliente → servidor lo escribes tú. Cola de escrituras local, reintentos, orden, idempotencia y qué pintas mientras la escritura está en vuelo. Electric documenta cuatro patrones para eso, pero son patrones, no un paquete que instalas.

    Dos límites más de los shapes que conviene saber antes de diseñar: no se pueden sincronizar varios shapes sobre la misma tabla, porque una suscripción necesita poder tirar todos los datos y empezar de cero; y para garantizar consistencia transaccional los datos se agregan en memoria, lo que con shapes muy grandes se nota.

    Encima van las live queries del módulo @electric-sql/pglite/live: registras una consulta y los resultados se actualizan solos cuando cambian los datos, vengan del usuario o del sync. Sin polling y sin invalidación manual de caché.

    Ahí está el efecto secundario grande: desaparece la mitad de tu capa de gestión de estado. El estado del servidor deja de ser algo que cacheas a mano y pasa a ser una tabla que se actualiza. Esa reorganización de responsabilidades la traté en Clean Architecture en Frontend.

    Lo que se te rompe al llevar Postgres al navegador

    Llevar Postgres al navegador te devuelve seis problemas que en el servidor no tenías: una sola conexión, migraciones que corren en dispositivos ajenos, resolución de conflictos sin librería que la resuelva por ti, el peso de arranque, benchmarks que solo valen en memoria y una API todavía en 0.x. Esta es la sección que importa.

    Una sola conexión: el worker no es opcional

    La documentación lo dice sin adornos: "PGlite is single connection only". Y hay un segundo problema encima: si ejecutas PGlite en el hilo principal, bloqueas la UI.

    La solución oficial es el multi-tab worker: una única instancia de PGlite dentro de un Web Worker y una elección de líder que hace de proxy para las peticiones de todas las pestañas abiertas. Cuando la pestaña líder se cierra, se elige otra y se levanta una instancia nueva.

    El worker:

    // my-pglite-worker.js
    import { PGlite } from '@electric-sql/pglite'
    import { worker } from '@electric-sql/pglite/worker'
    
    worker({
      async init() {
        return new PGlite()
      },
    })
    

    Y el cliente:

    import { PGliteWorker } from '@electric-sql/pglite/worker'
    
    const pg = new PGliteWorker(
      new Worker(new URL('./my-pglite-worker.js', import.meta.url), {
        type: 'module',
      }),
    )
    

    Son quince líneas, pero no las trates como boilerplate. Tu base de datos vive ahora detrás de una frontera asíncrona con elección de líder, y eso condiciona cómo pruebas la app y qué ocurre en el segundo en que el usuario cierra la pestaña líder.

    Migraciones de esquema en dispositivos que no controlas

    En el servidor una migración es un evento: la lanzas, corre, se acabó. Hay una base de datos y tú tienes la llave.

    En local-first tienes N versiones del esquema repartidas por dispositivos ajenos. Un usuario abrió la app en marzo y no ha vuelto. Cuando vuelva, su base local está seis migraciones por detrás y esas seis tienen que aplicarse en orden, en su navegador, sin romperse a mitad.

    Esto es lo que se lleva por delante los planes de rollback: no puedes revertir una migración en 8.000 portátiles.

    La consecuencia práctica es que el esquema local evoluciona de forma aditiva casi siempre. Columnas nuevas, no renombradas. Tablas nuevas, no reestructuradas. Y una tabla de versión de esquema desde el día uno, antes de tener usuarios.

    La red de seguridad que sí funciona no es el rollback, es el reset. Si el servidor es la fuente de verdad del negocio, la base local es desechable: ante una migración que no aplica, la borras del dispositivo y vuelves a sincronizar los shapes desde cero. Es feo, tarda y hay que pintarlo bien, pero funciona.

    La letra pequeña: eso solo existe si hay copia en servidor. Si elegiste el modo máximo de privacidad, no hay de dónde resincronizar y cada migración es un disparo único sobre datos irrecuperables. Ahí el esquema aditivo deja de ser buena práctica y pasa a ser la única opción.

    Resolución de conflictos: aquí no hay magia

    Dos dispositivos offline. Los dos editan el mismo registro. Los dos recuperan la red.

    Sí existen librerías que deciden por ti: los CRDT de Yjs, Automerge o Loro convergen sin preguntarte. Pero convergen a una respuesta, no necesariamente a la que tu negocio considera correcta. Un CRDT te garantiza que dos dispositivos acaban iguales; no te garantiza que el saldo resultante sea el que el usuario esperaba. Esa decisión no la delegas.

    Tus opciones reales son tres: last write wins y perder ediciones en silencio, guardar ambas versiones y preguntar al usuario, o modelar los datos para que los conflictos sean estructuralmente imposibles — append-only, eventos en vez de estado, campos con un único dueño. La tercera es la buena, y es una decisión de modelado que tomas antes de escribir código.

    Su contrapartida: una base append-only crece sin techo, y eso choca con la pregunta que cierra este post — si los datos caben en el dispositivo. Compacta por antigüedad o materializa el estado cada N eventos, desde el principio.

    Un detalle que se olvida: lo que llega del sync es entrada externa y merece validarse como el body de una API. Un payload con un campo cambiado por una versión antigua del cliente puede corromper la base local del usuario, y ahí ya no tienes acceso para arreglarlo. Es el escenario exacto para el que trabajamos schemas en el curso de Zod: validar en la frontera, no confiar en el tipo.

    3 MB antes de que el usuario vea nada

    PGlite pesa menos de 3 MB gzipped, y es un coste de arranque real que pagas en el primer render.

    En una app que el usuario abre a diario se amortiza en el primer uso. En una landing con formulario es inaceptable. Cárgalo diferido, después del primer pintado, con un estado de "preparando" que no sea una pantalla en blanco.

    Los 0,058 ms son en memoria

    Aquí es donde muchos posts sobre PGlite venden humo, así que lo digo claro: los benchmarks de PGlite están medidos en memoria; en cuanto persistes a IndexedDB, la foto cambia.

    La propia documentación lo reconoce: "An fsync or flush to the underlying storage can be quite slow, particularly in the browser with IndexedDB for PGlite, or OPFS for wa-sqlite."

    Y es igual de honesta comparándose con SQLite en WASM: "wa-sqlite is faster than PGlite when run purely in memory", aunque "For single row CRUD inserts and updates, PGlite is faster then wa-sqlite", por usar Write-Ahead Log frente al rollback journal de SQLite.

    La doc avisa además de que comparar Postgres con SQLite es difícil y de que sus benchmarks son un punto de partida, no una sentencia.

    Traducción: sigue siendo órdenes de magnitud más rápido que la red, pero mide tus escrituras con persistencia activada antes de prometer nada.

    Sigue en 0.x

    @electric-sql/pglite está en la 0.5.8 y @electric-sql/pglite-sync en la 0.6.9. Pre-1.0 significa que la API puede moverse entre versiones menores.

    No es razón para descartarlo. Es razón para fijar la versión, leer los changelogs antes de actualizar y no esparcir PGlite por medio proyecto sin una capa propia delante.

    Cuándo NO usar local-first (y qué hacer en su lugar)

    La respuesta honesta es que a la mayoría de las apps no les toca.

    Tu situación Qué hacer
    App de IA de uso diario, con historial largo y propio de cada usuario Local-first con PGlite. Es tu caso.
    Datos sensibles que no deberían tocar tu servidor (salud, legal, finanzas) Local-first, y aquí es requisito, no optimización.
    Necesitas funcionar offline de verdad Local-first. No hay alternativa real.
    Datos compartidos que muchos usuarios editan a la vez Servidor. El coste de resolver conflictos se come la ganancia.
    Landing, e-commerce o cualquier app de sesión corta Servidor. 3 MB de arranque para dos consultas no sale.
    Necesitas consultar millones de filas que no caben en el cliente Servidor, con RAG clásico. Los shapes tienen un límite práctico.
    Equipo sin experiencia en sincronización de datos Servidor, hasta que el dolor justifique la curva.
    Tests de integración y CI que hoy levantan Docker con Postgres PGlite en Node o Bun. Sin migraciones ni sync, pero sigue siendo de una sola conexión.

    Esa última fila merece una nota. Aunque tu app no sea local-first, PGlite te sirve hoy en el pipeline: es un Postgres real, arranca en milisegundos y no necesita contenedor. Cambiar docker compose up por una instancia en memoria en tus tests es la puerta de entrada barata a esta tecnología. Con dos límites: al ser de una sola conexión ahí no vas a reproducir deadlocks, bloqueos entre sesiones ni el comportamiento de tu pool; y PGlite trae un catálogo concreto de extensiones, así que comprueba que las de tu esquema estén en la lista antes de tirar el Docker.

    Cómo decidir esto hoy, en diez minutos

    Responde a una sola pregunta: ¿los datos que tu IA necesita para responder son de un único usuario y caben en su dispositivo?

    Si es que sí, local-first con PGlite te saca el round-trip de red de la ruta crítica, te baja los tokens por turno y te da una historia de privacidad que tus competidores no pueden contar. Empieza por el worker, el esquema versionado, el camino de escritura y una estrategia de conflictos escrita antes de crear la primera tabla.

    Si es que no, quédate en el servidor y duerme tranquilo.

    Y si quieres ver este tipo de decisiones discutidas con proyectos reales delante, es lo que hacemos cada semana en Dominicode Labs.

    Preguntas frecuentes sobre local-first con PGlite

    ¿PGlite sustituye a mi Postgres del servidor?

    No. PGlite es un Postgres embebido de una sola conexión, pensado para vivir junto a la aplicación y no para servir a muchos clientes concurrentes. En una arquitectura local-first, PGlite es la fuente de verdad local del dispositivo y tu Postgres del servidor sigue siendo la del negocio: entre ambos hay sincronización —de servidor a cliente te la dan hecha, de cliente a servidor la montas tú—, no sustitución.

    ¿Puedo hacer RAG entero en el navegador con PGlite?

    Sí, siempre que el corpus sea del usuario y quepa en su dispositivo. PGlite soporta pgvector a través del paquete @electric-sql/pglite-pgvector, así que puedes guardar embeddings y hacer búsqueda por similitud en local sin que los documentos salgan del navegador. Lo que no puedes hacer en el cliente es RAG sobre un corpus corporativo de millones de documentos: eso sigue siendo trabajo de servidor.

    ¿Cuánto pesa PGlite y cómo afecta al arranque de la app?

    PGlite pesa menos de 3 MB gzipped. Se carga una vez y luego queda cacheado, pero es un coste real en el primer render, así que conviene cargarlo diferido después del primer pintado. En una app de uso diario se amortiza sin problema; en una página de sesión corta no compensa.

    ¿Qué pasa si el usuario abre la app en dos pestañas?

    PGlite admite una sola conexión, así que dos pestañas no pueden abrir dos instancias sobre la misma base de datos. La solución oficial es el multi-tab worker: una única instancia dentro de un Web Worker y una elección de líder que hace de proxy para todas las pestañas. Cuando la pestaña líder se cierra, se elige otra automáticamente y se levanta una instancia nueva.

    ¿Está listo para producción si sigue en 0.x?

    Depende de tu tolerancia a que la API cambie. @electric-sql/pglite está en la 0.5.8 y el plugin de sync en la 0.6.9, y pre-1.0 significa que puede haber cambios de API entre versiones menores. Hay proyectos en producción con PGlite, pero si entras, fija la versión exacta, lee los changelogs antes de cada actualización y aísla PGlite detrás de una capa propia para que un cambio de API no te toque cincuenta ficheros. Y si vas a hacer RAG en el navegador, mira el eslabón más verde de la cadena: el paquete de pgvector, @electric-sql/pglite-pgvector, va por la 0.0.9.

    ¿En qué se diferencia PGlite de IndexedDB o de SQLite en WASM?

    IndexedDB es un almacén clave-valor sin lenguaje de consultas: cualquier filtro o join lo escribes tú en JavaScript. SQLite compilado a WASM sí te da SQL y en memoria pura es más rápido que PGlite, pero es SQLite: otro dialecto y otras extensiones que las de tu servidor. PGlite es Postgres compilado a WASM sin máquina virtual Linux, así que ejecutas el mismo dialecto y un catálogo de extensiones que se solapa con el de tu servidor —pgvector incluida—, aunque no estén todas las de Postgres. En local-first, esa paridad es lo que evita mantener dos modelos de datos distintos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Neon vs Supabase: comparación técnica honesta (2026)

    Neon vs Supabase: comparación técnica honesta (2026)

    Hace unos meses estaba arrancando un proyecto nuevo. Stack limpio, decisiones por tomar. Y en cuestión de minutos tuve el debate de siempre en el canal de decisiones técnicas: ¿Neon o Supabase?

    Los dos son Postgres. Los dos tienen free tier. Los dos aparecen en casi cualquier lista de "stack moderno para SaaS". Y los dos hacen cosas completamente distintas.

    Este post es la Neon vs Supabase comparación técnica que me hubiera ahorrado dos horas de lectura de docs.


    Qué es cada uno en una línea

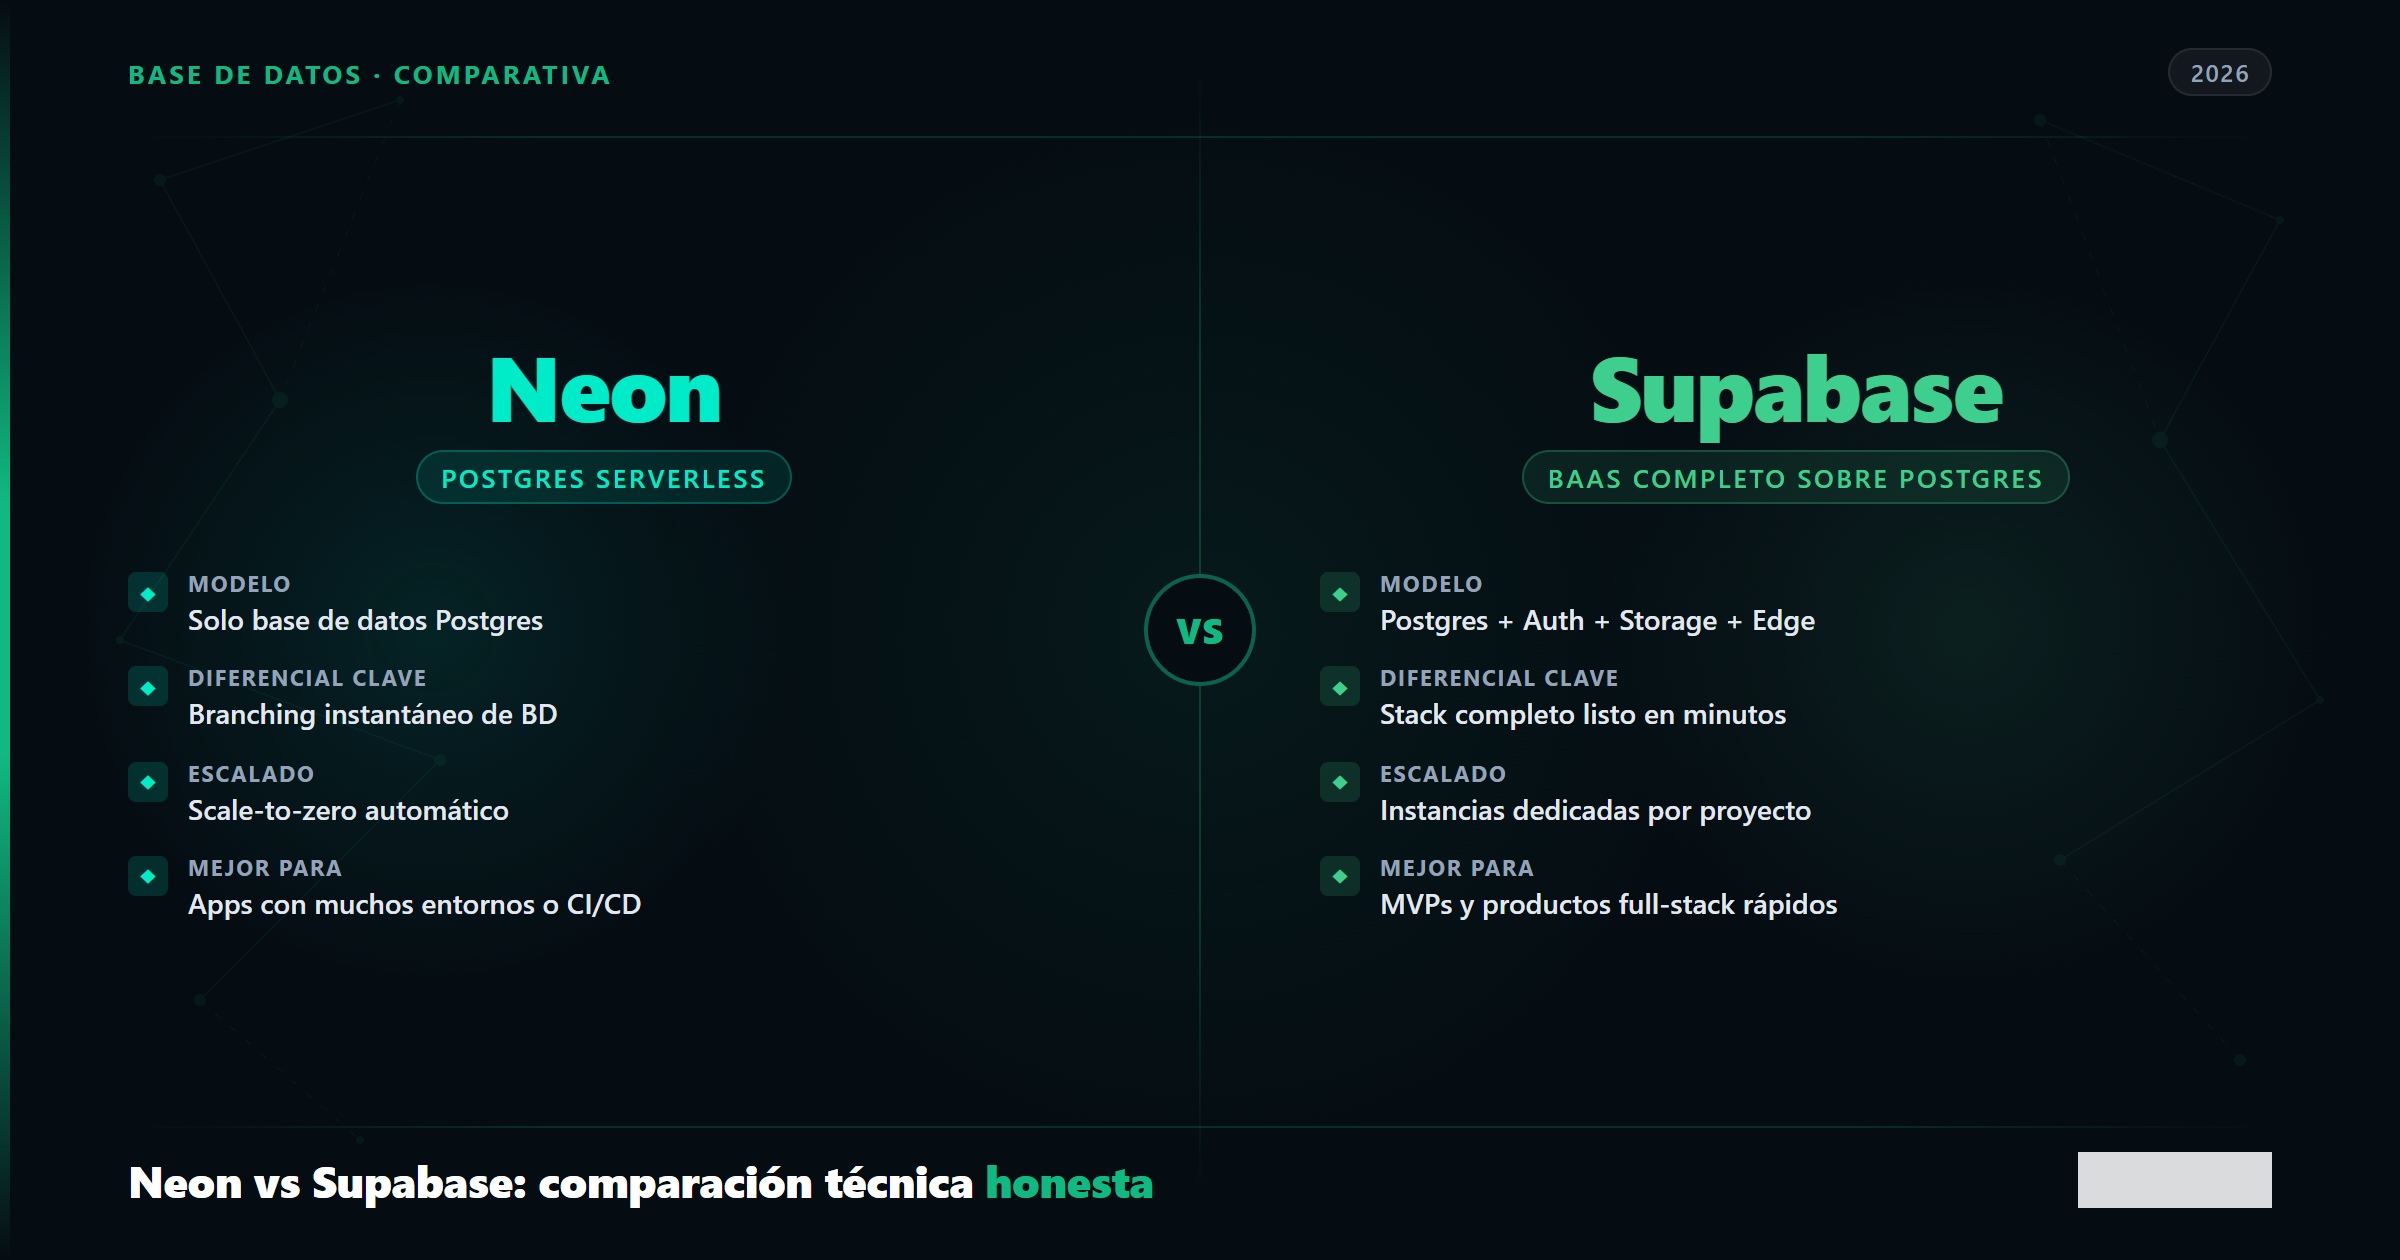
    Neon: Postgres serverless puro con branching de base de datos y scale-to-zero.

    Supabase: Plataforma BaaS construida sobre Postgres — incluye Auth, Storage, Realtime y Edge Functions en un solo sitio.

    La diferencia de fondo: Neon es una base de datos. Supabase es un backend completo que usa Postgres como motor.


    Tabla comparativa

    Criterio Neon Supabase
    Tipo Postgres serverless BaaS completo sobre Postgres
    Scale-to-zero Sí, nativo No en producción (pausa en free tier)
    Branching de DB Sí, copy-on-write instantáneo Solo Pro+ (beta); provisiona DB nueva + migraciones
    Auth nativo No Sí (JWT, OAuth, Magic Link)
    Storage nativo No Sí (S3-compatible)
    Realtime No Sí (WebSockets sobre Postgres)
    Edge Functions No Sí (Deno runtime)
    Free tier DB 0.5 GB, 100 CU-h 500 MB, pausa tras 7 días idle
    Plan de pago Desde ~$19/mes (usage-based) $25/mes (Pro, todo incluido)
    ORM compatible Cualquiera (Drizzle, Prisma, pg) Cliente JS/TS propio + cualquier ORM
    Tipado auto-generado Via ORM Sí, con supabase gen types
    Adquirida por Databricks (2025, ~$1B) Independiente

    Arquitectura de Neon vs Supabase: la diferencia que más importa

    Neon separa compute y storage. Cuando no hay peticiones, el compute se apaga solo — y cuando llega la primera query, arranca en milisegundos. El storage usa copy-on-write, lo que hace que crear una rama de base de datos sea instantáneo y casi sin coste.

    Supabase no funciona así. Tu base de datos corre en una instancia dedicada. Si estás en el free tier, Supabase pausa el proyecto tras 7 días sin actividad. En Pro, la instancia corre siempre — pagas compute 24/7 aunque tu app esté durmiendo.

    Para proyectos en producción con tráfico real, esto no es necesariamente un problema. Para proyectos con muchos entornos (staging, feature branches, demos de clientes), la diferencia de coste es brutal.


    Branching: por qué Neon gana en CI/CD

    Esta es la feature que más me ha cambiado el flujo de trabajo.

    Con Neon puedes crear una rama de base de datos por PR. Misma estructura, mismos datos (o un subconjunto). La rama vive mientras dura el PR y desaparece al hacer merge. No hay que mantener un entorno de staging contaminado con datos de otras features. Si tienes un pipeline con code review automático antes del merge, tienes el flujo completo en el post sobre agentic code review con Claude Code.

    # Crear una rama de DB para una PR concreta
    neon branches create --name feature/payment-refactor --parent main
    

    Supabase también tiene branching, pero funciona diferente: aprovisiona una base de datos nueva, ejecuta tus migraciones y carga el seed. Es más lento y consume más recursos. Para un equipo pequeño o un proyecto personal, puede ser suficiente. Para un pipeline de CI/CD que crea y destruye entornos constantemente, Neon gana por goleada.


    SDK y DX: dos filosofías distintas

    Supabase tiene un cliente JS/TS que abstrae casi todo. Queries, auth, storage, realtime — todo desde el mismo objeto.

    // Supabase: cliente unificado con tipado auto-generado
    import { createClient } from '@supabase/supabase-js'
    import type { Database } from './database.types' // generado con supabase gen types
    
    const supabase = createClient<Database>(
      process.env.SUPABASE_URL!,
      process.env.SUPABASE_ANON_KEY!
    )
    
    const { data, error } = await supabase
      .from('products')
      .select('id, name, price')
      .eq('active', true)
    

    Neon apuesta por Postgres nativo. Usas tu ORM de siempre — Drizzle, Prisma, o pg directo — contra un connection string estándar. Sin abstracciones propias, sin vendor lock-in de cliente.

    // Neon: Drizzle sobre el driver serverless de Neon
    import { neon } from '@neondatabase/serverless'
    import { drizzle } from 'drizzle-orm/neon-http'
    import { products } from './schema'
    import { eq } from 'drizzle-orm'
    
    const sql = neon(process.env.DATABASE_URL!)
    const db = drizzle(sql)
    
    const activeProducts = await db
      .select({ id: products.id, name: products.name, price: products.price })
      .from(products)
      .where(eq(products.active, true))
    

    Si ya tienes un ORM configurado en tu proyecto, migrar a Neon es cambiar el connection string. Con Supabase, el cliente propio es más cómodo para proyectos nuevos pero añade una dependencia específica a la plataforma.


    Precios Neon vs Supabase: cuándo cada modelo tiene sentido

    Neon (usage-based):

    • Free: $0 — 100 CU-horas, 0.5 GB storage
    • Launch: ~$19/mes — $0.106/CU-hora, $0.35/GB storage
    • Scale: desde ~$701/mes — con SLA e HIPAA incluidos

    Supabase (plataforma flat + overages):

    • Free: $0 — 500 MB DB, 50K MAU, 1 GB storage (pausa tras 7 días idle)
    • Pro: $25/mes — 8 GB DB, 100K MAU, Auth + Storage + Edge Functions incluidos
    • Team: $599/mes — SSO, SOC 2

    Para un proyecto con tráfico irregular o muchos entornos temporales, el modelo de Neon puede salir significativamente más barato. Para un SaaS en crecimiento que necesita Auth + Storage + DB y quiere una sola factura, el Pro de Supabase a $25 es imbatible en relación precio/funcionalidad.

    Precios verificados en junio 2026. Consulta las páginas oficiales de Neon y Supabase para tarifas actualizadas — los modelos usage-based cambian con frecuencia.


    Cuándo elegir Neon

    • Quieres Postgres puro sin opiniones sobre tu stack de auth o storage.
    • Tu pipeline de CI/CD se beneficia de tener una rama de DB por PR.
    • Tienes cargas de trabajo variables o intermitentes — el scale-to-zero te ahorra dinero real.
    • Ya tienes Drizzle o Prisma configurado y no quieres añadir un cliente propio.
    • Estás construyendo agentes de IA que necesitan provisionar bases de datos efímeras. La arquitectura serverless de Neon (y el respaldo de Databricks) la convierte en la opción natural para cargas de trabajo agénticas — incluidos los pipelines donde el agente lee un ticket, implementa y despliega de forma autónoma, como los que explico en el post sobre automatizar el proceso de desarrollo con IA.

    Cuándo elegir Supabase

    • Necesitas Auth desde el día uno — OAuth, magic link, JWT — sin montar Clerk ni Auth.js.
    • Tu proyecto necesita file storage y no quieres gestionar un bucket S3 por tu cuenta.
    • Quieres Realtime (subscripciones en tiempo real) sin añadir Redis ni WebSockets propios.
    • Valoras tener un solo proveedor para DB + Auth + Storage con una sola factura.
    • El free tier te basta para empezar y no te molesta que el proyecto se pause tras 7 días idle.

    Edge cases que nadie menciona

    Supabase no hace scale-to-zero en producción. Esto es intencionado — una instancia siempre activa garantiza latencia consistente. Pero si tienes 10 entornos de staging o un proyecto que duerme la mayor parte del tiempo, estás pagando compute en vacío.

    Neon no tiene Auth ni Storage nativos. Si los necesitas, tienes que añadirlos tú: Clerk, Better Auth, Auth.js para autenticación; Cloudflare R2, AWS S3 o Uploadthing para ficheros. No es un problema técnico, pero sí es trabajo de integración que con Supabase viene resuelto de fábrica.

    El branching de Supabase requiere CLI y configuración previa. No es tan plug-and-play como en Neon. Si quieres branching en Supabase, necesitas tener migraciones bien organizadas desde el principio.


    FAQ

    ¿Puedo usar Drizzle con Supabase?
    Sí. Supabase es Postgres estándar — puedes conectar cualquier ORM con el connection string del proyecto. El cliente propio de Supabase es opcional, no obligatorio.

    ¿Neon tiene Realtime o Auth?
    No de forma nativa. Puedes añadir LISTEN/NOTIFY de Postgres para eventos básicos, pero no hay un sistema de auth ni storage integrado. Para eso necesitas otra capa.

    ¿El scale-to-zero de Neon afecta a producción?
    Depende de tu configuración. El cold start de Neon suele estar por debajo de 500ms en condiciones normales. Para la mayoría de apps es aceptable. Si tienes requisitos de latencia muy estrictos, puedes configurar un mínimo de compute activo en el plan de pago.

    ¿Qué pasa con la adquisición de Neon por Databricks?
    Databricks compró Neon en 2025 por aproximadamente $1B. La apuesta es que los agentes de IA van a necesitar provisionar bases de datos efímeras a escala. Para el usuario, de momento se traduce en mejoras de precios — el storage bajó de $1.75 a $0.35/GB-mes. El roadmap a largo plazo aún está por verse.

    ¿Puedo migrar de Supabase a Neon (o al revés) más adelante?
    La base de datos en sí migra sin problema — es Postgres estándar en los dos casos. El trabajo real está en reemplazar el cliente de Supabase (auth, storage, realtime) si decides cambiar. Si usas Drizzle o Prisma desde el principio, cambiar el connection string es trivial.


    La decisión no es técnica en el fondo — es de qué quieres gestionar tú y qué quieres que gestione la plataforma. Si quieres Postgres puro con control total y branching en CI/CD, Neon. Si quieres un backend completo sin ensamblar piezas, Supabase.

    Ninguna de las dos es la respuesta correcta en abstracto. Ambas son la respuesta correcta para el problema adecuado.

    Si en tu proyecto estás usando IA para construir features o automatizar flujos, en el curso Construye con IA trabajamos exactamente con este tipo de decisiones de arquitectura — desde la elección de herramientas hasta el producto en producción.

    Si quieres profundizar en cómo tomar este tipo de decisiones de arquitectura en proyectos reales — con IA en el loop — en Dominicode Labs tenemos proyectos completos con el stack detallado y la justificación técnica detrás de cada decisión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.