Tag: Open Source

  • Anthropic Cyber Mission: qué cambia si mantienes open source

    Anthropic Cyber Mission: qué cambia si mantienes open source

    En mayo, Daniel Stenberg recibió un informe de Claude Mythos sobre curl. Cinco "vulnerabilidades de seguridad confirmadas". El equipo las revisó una a una: tres eran falsos positivos, una era un bug sin más y solo una era una vulnerabilidad real, de severidad baja. Hubo además una veintena de bugs bien explicados, casi sin falsos positivos. Aun así, Stenberg lo escribió en su blog sin rodeos: el gran hype alrededor del modelo había sido, sobre todo, marketing.

    Cinco meses después, el 8 de octubre de 2026, Anthropic lanzó la Anthropic Cyber Mission. Y en el anuncio de su escáner para open source aparece una cita del mismo Stenberg: OSS Scanner les ha ayudado a encontrar en curl "múltiples problemas que merecen ser abordados", entre ellos una de las peores vulnerabilidades de curl reportadas en los últimos años.

    Esa distancia entre mayo y octubre es la noticia de verdad.

    En corto: La Anthropic Cyber Mission (8 de octubre de 2026) junta un programa de defensa de infraestructura crítica con 11 partners y OSS Scanner, un escáner gratuito y opt-in que revisa proyectos open source críticos con los modelos más capaces de Anthropic, incluido Claude Mythos. Los informes llegan al maintainer sin revisión humana. Solicítalo solo si mantienes una librería que procesa entrada no confiable y tienes capacidad de triaje.

    ¿Qué es la Anthropic Cyber Mission?

    La Anthropic Cyber Mission es el compromiso a largo plazo de Anthropic para poner sus modelos de frontera al servicio de quienes defienden infraestructura crítica y software open source, empezando por dos programas: el Critical Infrastructure Defense Program y OSS Scanner. Así lo presenta el anuncio oficial.

    El primero, el Critical Infrastructure Defense Program (CIDP), lleva modelos, ingenieros in situ e investigación de amenazas a quienes protegen tecnología operacional: redes eléctricas, agua, transporte y sistemas de gobierno. Los partners fundadores son 11: Accenture, Booz Allen, CrowdStrike, Deloitte, Dragos, Hitachi, Insane Cyber, Nozomi Networks, Palo Alto Networks, PwC y Rockwell Automation.

    El segundo programa de la Anthropic Cyber Mission, OSS Scanner, es el que te afecta como developer. Anthropic dice que se inspira en OSS-Fuzz de Google: te inscribes y recibes escaneos periódicos gratuitos.

    El 6 de octubre Anthropic ya había ampliado su Cyber Verification Program e integrado Project Glasswing, que desde abril daba Mythos a un grupo seleccionado de organizaciones. Si leíste lo que contamos de Mythos 5.1, esta es la pieza que faltaba: una vía para proyectos que nunca habrían entrado en Glasswing.

    Qué ofrece cada programa de la Anthropic Cyber Mission y a quién va dirigido

    La respuesta corta: casi todo es para organizaciones, y solo OSS Scanner y Claude for OSS están pensados para maintainers individuales.

    Pieza Qué ofrece Para quién Límite o riesgo
    CIDP Modelos de frontera, ingenieros in situ, investigación de amenazas Operadores de OT, vía los 11 partners Sin condiciones comerciales publicadas (SiliconANGLE, citando a Axios)
    OSS Scanner Escaneos periódicos con reproducer, explicación y parche candidato Core maintainers de proyectos críticos, vía PR a anthropics/oss-scanner Sin revisión humana; severidad o parche pueden fallar
    Cyber Verification Program Opus 5.5, Sonnet 5.5 y Mythos 5.1 con menos bloqueos Equipos de seguridad verificados Retención de datos obligatoria (con excepciones temporales hasta que llegue EFS)
    Claude for OSS Claude Max 20x gratuito Maintainers Es acceso al modelo, no un escáner
    CVD clásico Informes verificados por humanos Proyectos sin capacidad de triaje Más lento

    Las cifras de OSS Scanner: qué dicen y qué no

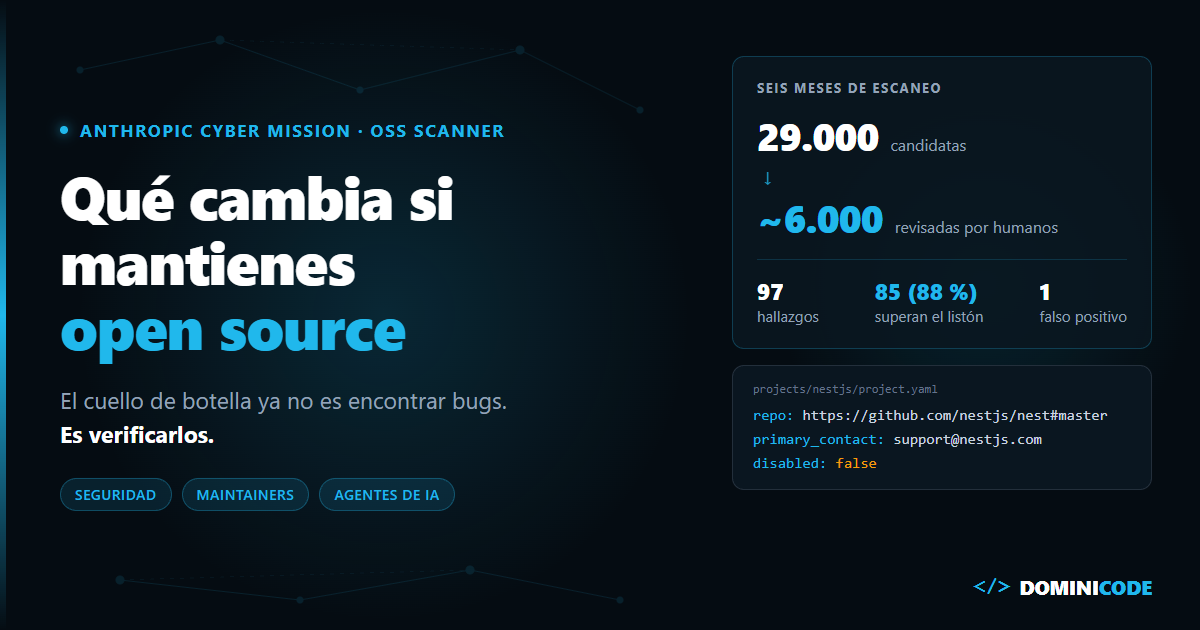
    Según el post técnico de lanzamiento, en seis meses sus modelos encontraron más de 29.000 vulnerabilidades candidatas en software muy usado. Los humanos revisaron unas 6.000. Se enviaron casi 5.000 informes a maintainers que pidieron recibirlo todo, aunque no estuviera validado.

    El cuello de botella ya no está en encontrar bugs. Está en que alguien los verifique.

    Dato (fuente oficial, octubre 2026) Valor
    Hallazgos críticos/altos revisados por pentesters 97, en 48 proyectos
    Superaron el listón de divulgación 85 (88 %)
    Reales, pero duplicados de problemas conocidos o de otros hallazgos 11
    Falsos positivos 1
    Informes recibidos por wolfSSL 74, todos válidos salvo 2; 5 acabaron en CVE
    Tasa de verdaderos positivos que Anthropic espera Superior al 90 %
    Responsabilidad máxima de Anthropic según los términos 1.000 USD

    Un matiz: el 88 % que superó el listón no es la "tasa de verdaderos positivos superior al 90 %". De 97 hallazgos, 96 eran bugs reales, pero 11 eran duplicados. Un duplicado no es un falso positivo, pero sí es tiempo de triaje.

    Cómo inscribir tu proyecto en OSS Scanner

    Se hace con un pull request al repositorio de GitHub que añade projects/<nombre>/project.yaml. Los campos obligatorios son repo y primary_contact, más un Dockerfile que instale dependencias y compile el proyecto. El escaneo corre sin acceso a internet, así que todo lo necesario se descarga durante el build.

    Tu proyecto no tiene que estar en GitHub; solo el PR. Lo preguntaron en el issue #331 de anthropics/oss-scanner pensando en git, FFmpeg o Linux, y un colaborador del repo respondió que basta con que sea público y clonable. Otro participante del hilo señala lo que falta aclarar: cómo verifican que quien inscribe un repo de fuera de GitHub es su maintainer.

    NestJS, por ejemplo, ya está inscrito. Su project.yaml cabe en cuatro líneas, con el Dockerfile y el threat_model.md al lado:

    repo: https://github.com/nestjs/nest#master
    primary_contact: support@nestjs.com
    homepage: https://nestjs.com
    disabled: false
    

    Hay una pieza opcional que yo no dejaría vacía: el threat_model.md. Ahí le dices al escáner qué entradas no son de confianza, qué entra en el alcance y cómo calibrar la severidad. Es una especificación para el agente. Quien haya trabajado con Spec-Driven Development reconocerá el patrón: el agente rinde según la calidad de lo que le describes.

    Los criterios de entrada, según la página del servicio, son los de OSS-Fuzz: exposición a ataques remotos y número de dependientes. Y tienes que poder asumir informes de severidad alta o crítica. Puedes pausar los informes con disabled: true o salir borrando el directorio con otro PR.

    La demanda va por delante del triaje: en sus primeros días el repo recibió 414 PRs de inscripción, y a 11 de octubre había 28 fusionados, 186 cerrados sin fusionar y 200 abiertos (PRs del repo).

    Mi opinión: si mantienes un parser o una librería de red, criptografía o serialización con muchos dependientes, solicítalo esta semana. Si es una librería de UI sin entrada externa, probablemente no entres.

    El doble uso en la Anthropic Cyber Mission: la misma IA defiende y ataca

    La Anthropic Cyber Mission parte de un riesgo que Anthropic reconoce: los mismos modelos que encuentran vulnerabilidades sirven para explotarlas, y los atacantes ya tienen modelos capaces. Prevé que en dos años la IA favorecerá a la defensa, y reconoce que a corto plazo puede que no sea así.

    Si un atacante puede apuntar un modelo a tu repo hoy, la pregunta es quién lee primero el informe. Un usuario de Hacker News lo resumía en el hilo del lanzamiento: frente a los "investigadores" que envían por separado informes idénticos sin que nadie los pida, esto es opt-in, gratis y el informe vuelve al maintainer. Eso sí, pedía modelos locales para no depender de un SaaS.

    Encontrar no es arreglar, y el anuncio lo reconoce: en Glasswing a menudo pasaban meses entre el hallazgo y el parche. En sistemas industriales que no se pueden parar, en casos raros, décadas.

    Límites y riesgos de OSS Scanner

    Los informes no los revisa nadie antes de que te lleguen. Los términos dicen que los informes pueden ser incompletos e inexactos, que se entregan "tal cual" y que el participante es responsable de revisar cada informe y cada parche propuesto. Un parche que cierra el agujero y rompe otra cosa es tu problema. Revisarlo exige el mismo rigor que cualquier diff de un agente; es lo que defendemos en revisión por contrato.

    La responsabilidad de Anthropic tiene un techo de 1.000 USD. Lo dice la sección 7 de los términos. Para un proyecto voluntario no cambia mucho, pero si tu empresa mantiene el proyecto, que lo lea legal antes de abrir el PR.

    No hay periodo de divulgación de 90 días para los hallazgos sin validar. Los informes son confidenciales y no se publican, pero si uno se valida después por el proceso CVD clásico, la cuenta de 90 días empieza entonces.

    No cubre tu cadena de dependencias. Inscribir tu librería no protege a quien la instala junto a cientos de paquetes transitivos: auditar dependencias sigue siendo trabajo tuyo.

    La otra mitad de la Anthropic Cyber Mission, el CIDP, es opaca por ahora. Sin condiciones comerciales publicadas, no se sabe quién paga el cómputo ni cómo se probarán parches en sistemas que no se pueden parar.

    Qué hacer con tu repo esta semana

    Si mantienes algo que procesa entrada no confiable, escribe el threat_model.md aunque no vayas a solicitar OSS Scanner. Te obliga a decir por escrito qué consideras ataque, y sirve para cualquier auditoría futura, humana o automática. Después, decide con honestidad si tienes capacidad de triaje. Si no la tienes, no te apuntes: lo que Anthropic encuentre te llegará por la vía clásica, verificado por humanos.

    Y si construyes tus propios agentes que tocan código o infraestructura, el problema del doble uso también es tuyo. En el ebook gratuito El Developer Agéntico trato la seguridad de agentes junto a su arquitectura y sus herramientas.

    Preguntas frecuentes

    ¿Qué incluye la Anthropic Cyber Mission además de OSS Scanner?

    El Critical Infrastructure Defense Program (CIDP), con 11 partners fundadores, que lleva modelos, ingenieros in situ e investigación de amenazas a quienes protegen redes eléctricas, agua, transporte y sistemas de gobierno.

    ¿OSS Scanner es gratis?

    Sí. Anthropic lo ofrece sin coste para los proyectos aceptados, y dice que el Defender Advantage Fund, lanzado en agosto, ayuda a mantenerlo gratuito. Los maintainers pueden solicitar aparte una suscripción gratuita a Claude Max 20x mediante Claude for OSS.

    ¿Puede cualquier proyecto open source inscribirse?

    No. La aceptación es caso a caso, con criterios parecidos a los de OSS-Fuzz: exposición a ataques remotos y número de usuarios o dependientes. Anthropic valida manualmente que quien solicita es core maintainer y espera que el proyecto pueda gestionar informes de severidad alta.

    ¿Esto ayuda también a los atacantes?

    La capacidad ofensiva ya existe y Anthropic lo reconoce. OSS Scanner no la crea; intenta que el maintainer reciba el hallazgo antes que nadie. Su previsión de que la IA favorecerá a la defensa es a dos años.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • ¿Es JEV open source? Acceso, despliegue local y alternativas

    ¿Es JEV open source? Acceso, despliegue local y alternativas

    Cada vez que sale un modelo que rompe la tabla de benchmarks en latencia y precio, se repite la misma comedia en dos actos.

    Acto 1: el equipo técnico se emociona en el canal de Slack compartiendo que han encontrado la pieza perfecta para resolver el triaje de datos en 100 milisegundos, que es lo que dice la web.

    Acto 2: entra el responsable de seguridad y cumplimiento legal con una pregunta de cuatro palabras que congela la reunión: "¿Dónde corren los pesos?".

    Si trabajas en banca, salud, sector público o con datos protegidos por el RGPD en Europa, no puedes enchufar alegremente un endpoint cloud sin saber quién almacena el payload, durante cuánto tiempo y si tus datos se usan para reentrenar modelos.

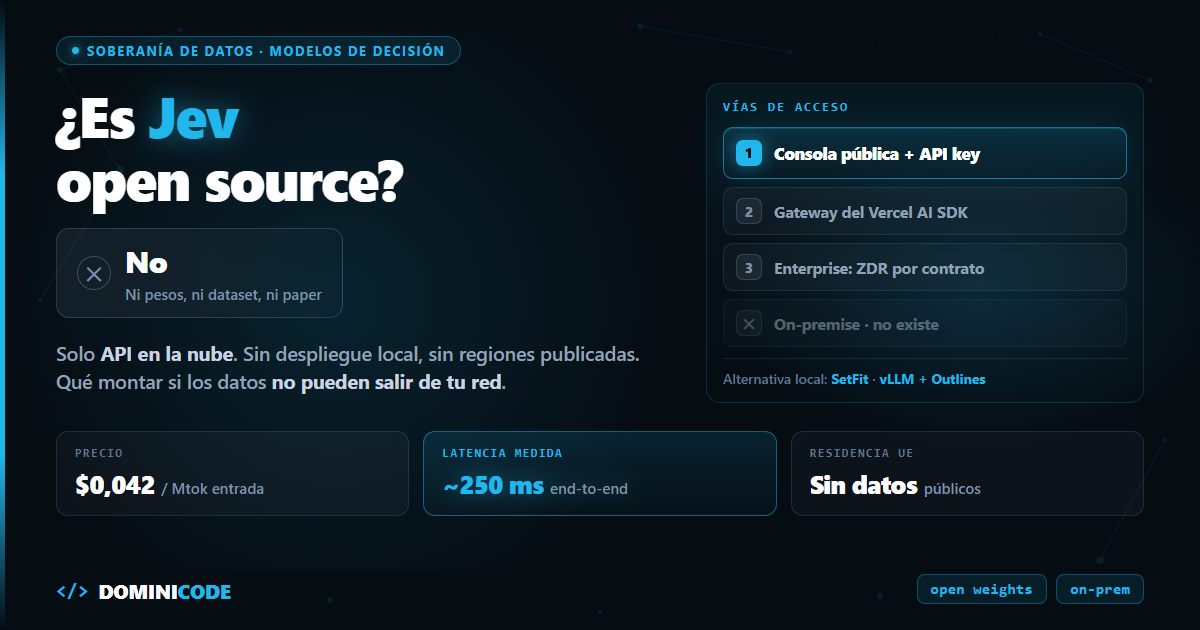
    En corto: no, Jev no es open source. Es un modelo propietario de TypeSafe AI cuyos pesos no están disponibles para descarga ni para despliegue on-premise. El acceso se hace a través de su API en la nube (POST https://api.typesafe.ai/v1/systemone). Si necesitas ejecución local en tus propios servidores, la alternativa más cercana es un clasificador encoder tipo ModernBERT entrenado con SetFit, o un modelo pequeño servido con vLLM y salida forzada por gramática con Outlines. Ninguna de las dos te da la calibración de Jev, y esa es justo la parte que duele.

    Actualización (16 de octubre de 2026): Jev sigue sin ser open source, pero ya hay una vía local mucho más cercana. Desde la versión 0.35.0 (28 de septiembre de 2026), Ollama sirve un endpoint /v1/systemone con la misma forma de petición que la API de Jev (state, model y questions) y modelos de decisión con pesos abiertos: Nimble (Bespoke Labs), Tev1 (Together AI), Clef (Cloudflare) y, desde la 0.40.4, Kev (Jared Palmer). Igual que con las alternativas de abajo, la calibración sobre tus datos la tienes que medir tú: el paso a paso, con código en TypeScript, está en System One en local con Ollama.


    ¿Es Jev open source? La realidad de su licencia

    Jev es un servicio cerrado: ni los pesos del modelo, ni el dataset de entrenamiento, ni el código de inferencia se han liberado bajo Apache 2.0, MIT ni ninguna otra licencia abierta. Tampoco hay paper ni descripción pública de la arquitectura.

    Lo único abierto son los SDK cliente (@typesafe-ai/sdk en TypeScript y typesafe-sdk en Python), que son envoltorios HTTP sobre su endpoint privado. Útiles, pero ahí no hay modelo: hay fetch con reintentos.

    ¿Por qué TypeSafe AI ha tomado este camino? La empresa no lo ha explicado, así que esto es lectura mía sobre datos públicos:

    1. El negocio es la inferencia. Salieron de stealth el 15 de septiembre de 2026 con una ronda seed de 40 millones de dólares liderada por DCVC (Wilson Sonsini, Forbes). Cobran por token de entrada ($0,042 por millón; la salida es gratis). Liberar los pesos es cargarse la única línea de ingresos que tienen.
    2. RLCD es lo que los diferencia. Su documentación llama a su vía de entrenamiento RLCD — reinforcement learning for calibrated decisions — y la presenta como una tercera rama frente a RLHF y RLVR. De cómo funciona por dentro no publican nada. En el hilo de Hacker News del lanzamiento un comentarista lo resumió bien: "System One hasn't said how RLCD works, but they do say it is explicitly training models to output calibrated probabilities".
    3. La capacidad manda sobre la hoja de ruta. Su propia página de modelos avisa de que los límites de servicio "can change without notice" mientras aterrizan compras grandes de GPU y dejan entrar a más usuarios. Quien tiene que racionar GPUs no regala pesos.

    Opciones de acceso oficiales a Jev

    Hay cuatro puertas de entrada, y conviene no confundirlas:

    VÍAS DE ACCESO AL ECOSISTEMA JEV
    
    1. Consola pública      console.typesafe.ai — playground + API keys, pago por uso
    2. Vercel AI SDK        gateway 'typesafe-ai/jev' (documentado del lado de Vercel)
    3. OpenRouter          'typesafe/jev-1.13' — sin cuenta de TypeSafe
    4. Planes enterprise    límites a medida (sales@) + zero data retention (privacy@)
    
    1. Consola pública. Entras en console.typesafe.ai, abres el playground, sacas la API key desde el dashboard y ya estás llamando al endpoint. Los límites por defecto son 1.200 peticiones por minuto y 250.000 tokens por segundo, con la advertencia de arriba: se mueven sin aviso. Pasarse de cualquiera de los dos devuelve 429. Ojo: desde el 22 de septiembre TypeSafe tiene pausadas las altas nuevas por exceso de demanda (lo anunció su cuenta oficial en X; la doc no lo menciona). Las cuentas anteriores siguen funcionando. Si no tenías una, las dos vías siguientes no la necesitan.
    2. Vercel AI SDK. Existe integración vía experimental_evaluate() y el identificador de gateway 'typesafe-ai/jev'. Ojo con la fuente: esto está documentado del lado de Vercel, no en la documentación de TypeSafe — me bajé las 109 páginas de su doc y no aparece ni una vez.
    3. OpenRouter. Según su guía oficial, Jev está disponible como typesafe/jev-1.13 con tu clave de OpenRouter, sin cuenta de TypeSafe, y se factura en tu cuenta de OpenRouter. No va por /chat/completions: tiene su propio endpoint, POST https://openrouter.ai/api/v1/systemone, pensado para quien ya usa los SDK de TypeSafe, y una Decisions API en alpha. El contexto es de 32.000 tokens para estado y preguntas combinados. Para lo que te preocupa en este post, es un intermediario más: tus datos pasan por OpenRouter antes de llegar a TypeSafe, y la guía no dice nada de retención, así que revisa también sus condiciones.
    4. Planes enterprise. Es la única vía que toca lo que te preocupa. Su documentación ofrece zero data retention (ZDR) para clientes enterprise escribiendo a privacy@typesafe.ai, y límites más altos en planes a medida a través de sales@typesafe.ai. Lo que no dice su documentación en ningún sitio: nada de VPC peering, nada de Private Link, nada de despliegue en tu cuenta de AWS o GCP. Si alguien te lo vende, que te lo ponga por escrito en el contrato.

    Alternativas open source para desplegar en local

    Si tu departamento legal veta las APIs externas y necesitas que la decisión se ejecute en tu hardware —o en una máquina aislada sin salida a internet—, Jev queda descartado. No hay versión local y no la ha habido nunca. Lo que sí puedes montar:

    Antes de montar nada de lo que sigue, prueba la vía más directa: ollama pull nimble y una petición a http://localhost:11434/v1/systemone (Ollama 0.35.0 o posterior). Devuelve choice, score y noul con probabilidades, sin entrenar nada. Las opciones de esta sección siguen siendo útiles si necesitas fine-tuning con tus propias etiquetas o un encoder más pequeño.

    1. ModernBERT o DeBERTa-v3 con SetFit — la ruta más corta

    Si tu tarea es clasificación pura o detección binaria, un encoder pequeño te acerca bastante:

    • Herramienta: la librería setfit de Hugging Face (Apache 2.0). Entrena clasificadores decentes con 20-30 ejemplos por clase.
    • Latencia: decenas de milisegundos en una GPU modesta, y a menudo también en CPU moderna. Mídelo en tu hardware antes de prometerlo en una reunión: depende del modelo, del tamaño del batch y de la longitud del texto.
    • Coste: cero en licencias. El coste es tu servidor y el dataset de ejemplos, que tienes que construir tú.

    2. Outlines + vLLM sobre un modelo pequeño

    Si necesitas evaluar estados complejos en lenguaje natural respetando un schema estricto:

    • Motor: vLLM sirviendo un modelo de 1.000 a 3.000 millones de parámetros. Qwen 2.5 en sus tamaños pequeños es Apache 2.0; Llama 3.2 va bajo la licencia comunitaria de Meta, que no es permisiva del todo — léela antes de meterla en un producto.
    • Capa estructurada: Outlines o SGLang, que fuerzan una gramática JSON guiando los logits en tiempo real. Un comentarista de Hacker News describía esta misma receta con logprob("YES") menos logprob("NO") como proxy de confianza casera.
    • La diferencia que importa: sigue siendo autorregresivo, así que pagas cientos de milisegundos, y esos logprobs no están calibrados. Que el número esté entre 0 y 1 no significa que de lo que responde al 90% acierte el 90%. Eso es exactamente lo que Jev vende y lo que no se replica con una fórmula sobre logits.

    3. La alternativa que tres comentaristas citaron, y que fui a comprobar

    En el hilo de Hacker News aparecieron varias menciones a un proyecto llamado Laya como equivalente open source de Jev, apoyadas en una publicación que llegó a 96 puntos: "Open-sourced jev architecture last year with model, paper and dataset".

    Fui al paper. Es arXiv 2503.23303, SalesRLAgent, de marzo de 2025: un sistema de refuerzo para predecir la probabilidad de conversión en conversaciones de ventas, con embeddings de Azure OpenAI y datos sintéticos generados con GPT-4o. Es un trabajo real y publicado, pero no es una arquitectura general de decisiones calibradas. Llamarlo "la arquitectura de Jev liberada hace un año" es estirar mucho el chicle.

    Lo cuento porque es el patrón habitual: en cuanto alguien pregunta si existe alternativa abierta, aparecen tres enlaces y ninguno aguanta una lectura del abstract. Léelos tú.


    Comparativa: Jev en la nube frente a alternativas locales

    Factor Jev (TypeSafe AI) SetFit / ModernBERT en local Modelo pequeño + Outlines en vLLM
    Licencia Propietaria, servicio cerrado Apache 2.0 Apache 2.0 (Qwen) o comunitaria (Llama)
    Despliegue on-premise ❌ No existe ✅ GPU o CPU ✅ Requiere GPU
    Soberanía de datos Sus servidores; ZDR solo en enterprise Total Total
    Mantenimiento Ninguno: consumes una API Medio: servir y versionar el modelo Alto: orquestar vLLM y su memoria
    Latencia ~100 ms de inferencia; ~250 ms end-to-end medidos desde mi red Decenas de ms, mídelo tú Cientos de ms: sigue siendo autorregresivo
    Calibración Entrenada con RLCD, medida sobre grupos de predicciones Softmax sin calibrar Logprobs sin calibrar
    Puesta en marcha Minutos Necesitas datos de ejemplo Media: montar el servidor de inferencia

    Sobre la latencia, que es donde más se miente: la documentación de TypeSafe dice "most queries complete in about 100 ms", y eso es tiempo de inferencia, lo que tarda el modelo en su infraestructura. Lo que mide tu aplicación es otra cosa. Yo lo cronometré el 20 de septiembre de 2026 contra api.typesafe.ai reutilizando la conexión TLS: p50 de 258 ms, mínimo de 213. Abriendo conexión nueva en cada llamada —lo que hace por defecto cualquier cliente HTTP ingenuo— se va a 628 ms. Esa diferencia no es el modelo: es el viaje hasta San Francisco. Y es justo la parte que desaparece cuando el modelo corre en tu sala de máquinas.

    Sobre la calibración, un matiz que su propia documentación se encarga de poner: se mide sobre grupos de predicciones, no garantiza que una respuesta concreta sea correcta. Es una propiedad estadística, no una promesa individual.


    Lo que la comunidad pidió, y lo que contestaron

    El hilo de Hacker News del lanzamiento —más de 1.900 puntos y cerca de 500 comentarios— tiene la conversación sobre esto mejor que cualquier análisis. Tres comentarios que resumen el estado de la cuestión:

    "The fact this isn't open-source is troublesome. Such large advances shouldn't be locked up away from local hardware."

    "What are peoples' thoughts on whether a local version of Jev is possible? Having to call an API for something that's main benefit is speed is orthagonal to their ethos."

    Y el que mejor retrata el problema europeo, de alguien que trabaja en EdTech:

    "Any plans for offering this through a European provider at some point after launching in the US? We work in EdTech, so non-EU-sovereign solutions are a harder sell to our customers."

    Ese último comentario no tuvo respuesta. Ni de TypeSafe ni de nadie. A día de hoy su documentación no menciona regiones, ni residencia de datos en la Unión Europea, ni un mapa de centros de datos. Si tu caso depende de eso, la única vía es preguntar por escrito antes de firmar nada.


    Privacidad y cumplimiento: lo que hay que revisar antes de firmar

    Si aun así decides adoptar Jev en un entorno regulado, estos son los puntos concretos:

    1. Retención de datos. Su documentación legal remite al Data Processing Agreement y ofrece ZDR solo para enterprise. Pregunta explícitamente qué pasa con lo que mandas en el campo state: si se escribe en logs de depuración, cuánto sobrevive ahí y quién los lee.
    2. Reentrenamiento. Aquí sí son claros: "Jev is not trained on customer requests or responses", y además no hay fine-tuning ni LoRA con datos de cliente — los mismos pesos sirven a todas las cuentas. Que quede igual de claro en tu contrato.
    3. Residencia de datos. No publican regiones. Si necesitas que los datos personales no salgan de la UE, exige la respuesta por escrito y las cláusulas contractuales tipo (SCC) firmadas, porque la transferencia internacional existe hasta que te demuestren lo contrario.
    4. El estado no es un dato neutral. Esto no lo arregla ni la nube ni el local: su propia documentación de limitaciones reconoce que texto escrito para manipular la respuesta puede moverla. Si el state lo rellena un usuario, tienes un vector de inyección, tanto si el modelo corre en Virginia como en tu sótano.

    Cierre accionable

    La decisión no es técnica, es de riesgo: si lo que priorizas es salir a producción rápido, sin gestionar GPUs y con una probabilidad calibrada de verdad, la API de Jev es difícil de batir a 250 ms end-to-end. Si tu prioridad es que los datos no salgan de tu red, monta un clasificador local con SetFit y asume que la calibración te la vas a tener que medir tú.

    Lo que no deberías hacer es tomar esa decisión de forma irreversible. Si la llamada al modelo vive detrás de una interfaz tuya, con su contrato y su schema de salida, cambiar de proveedor SaaS a modelo local es cambiar una implementación, no reescribir el producto. Ese desacoplamiento es el núcleo de Spec-Driven Development.

    Si todavía no tienes claro qué es exactamente Jev y por qué no genera texto, empieza por este post.

    Y para construir sistemas con IA que aguanten en entornos corporativos reales, el curso Construye con IA va justo de eso. Si lo que quieres es debatirlo con otros developers que están en la misma pelea, te espero en Dominicode Labs.


    Si estás evaluando Jev en serio, en Jev y las decisiones tipadas con IA tienes el análisis completo: qué devuelve de verdad la API, cuánto cuesta y cuánto tarda medido, cómo escribir el código para poder cambiar de proveedor y las alternativas para cuando no te conviene.

    Preguntas frecuentes

    ¿Ha anunciado TypeSafe AI planes para liberar los pesos?

    No hay ningún anuncio público en ese sentido. Su documentación no menciona open weights por ninguna parte, y la petición apareció varias veces en el hilo de lanzamiento en Hacker News sin respuesta de la empresa. Ausencia de anuncio no es lo mismo que negativa oficial, pero a día de hoy no hay nada a lo que agarrarse.

    ¿Puedo ejecutar Jev en un contenedor Docker en mi máquina?

    No. No existe imagen pública con el runtime de Jev. Cualquier contenedor que montes solo ejecutará tu código cliente haciendo llamadas remotas a api.typesafe.ai, que es exactamente lo que querías evitar.

    ¿Cuánto cuesta una máquina local para acercarse a esa velocidad?

    Para servir un modelo pequeño con Outlines por debajo de 300 ms necesitas una GPU dedicada —una RTX 4090 o una A10G como suelo—, es decir varios miles de euros de hardware más consumo eléctrico y mantenimiento. A $0,042 por millón de tokens de entrada, la API sale mucho más barata para volúmenes medianos. La cuenta solo se da la vuelta cuando el motivo no es el coste, sino que los datos no pueden salir.

    ¿Cumple Jev con el RGPD en su tier de desarrollador?

    Como cualquier proveedor estadounidense, la transferencia internacional de datos personales requiere DPA firmado y cláusulas contractuales tipo. Su documentación legal publica el Data Processing Agreement y la política de privacidad; el zero data retention es una opción de enterprise, no el comportamiento por defecto. Con el tier de desarrollador y datos personales reales, tu departamento legal va a decir que no, y hará bien.

    Si despliego en local, ¿me libro de los problemas de Jev?

    De unos sí y de otros no. Te libras de la transferencia internacional y de la latencia de red. No te libras de que el texto que analizas pueda estar escrito para manipular la respuesta, ni de tener que calibrar los umbrales tú mismo con tus propios datos, que es trabajo real y recurrente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.