Tag: NodeJS

  • timingSafeEqual: por qué comparar secretos con === te delata

    timingSafeEqual: por qué comparar secretos con === te delata

    Escribí una función de comparación byte a byte. Sin ramas, sin salida temprana, acumulando las diferencias con un OR bit a bit.

    La medí con un millón de iteraciones. La desviación salió plana. Tiempo constante en JavaScript, pensé. Di la librería por buena, quité el crypto.timingSafeEqual que tenía puesto de parche y seguí con otra cosa.

    Meses después, perfilando algo que no tenía nada que ver, vi las primeras llamadas a esa función en la traza. Tardaban lo que no tenían que tardar. No un poco más: otra escala.

    Ahí entendí lo que había medido en realidad. Mi benchmark ejecutaba la versión que V8 había optimizado después de miles de llamadas.

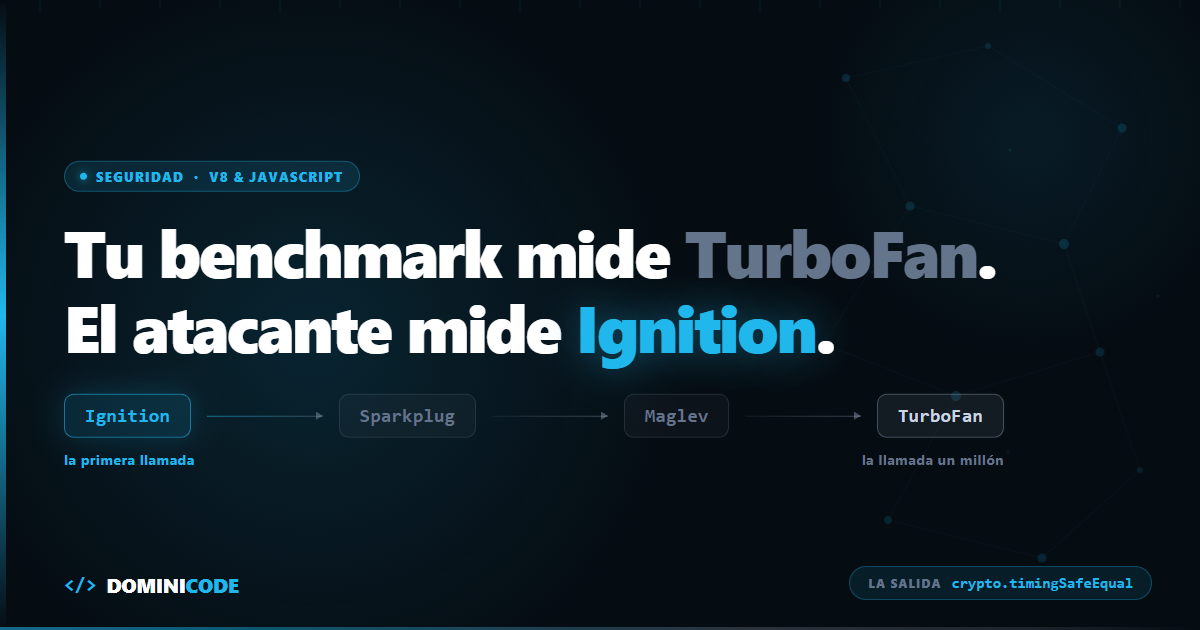
    El atacante mide la primera.

    Ese es todo el problema, y no tiene arreglo dentro del lenguaje: no puedes escribir código de tiempo constante en JavaScript puro. No porque tu algoritmo esté mal. Porque V8 tiene permiso para reescribirlo. El código que tú escribes no es el código que se ejecuta, y en criptografía esa diferencia tiene nombre: vulnerabilidad.

    El ataque de temporización, en treinta segundos

    Un ataque de temporización es una técnica de canal lateral que deduce un secreto midiendo cuánto tarda el servidor en rechazarlo: no lee el token, cronometra el rechazo. Una comparación en tiempo constante es la que tarda lo mismo pase lo que pase con los datos, falle el primer byte o el último. Los === de JavaScript no lo son.

    Cuando escribes secret === input, V8 no compara letra por letra desde el principio. Toma varios atajos antes.

    Primero mira si los dos operandos son el mismo objeto en memoria: misma dirección, true inmediato. Si los dos son strings internalizadas y las direcciones no coinciden, devuelve false sin leer un solo byte — para eso sirve internalizar.

    Si no hay atajo entra en la comparación lenta, y ahí el orden real es: longitudes distintas, false inmediato; si las dos tienen el hash ya calculado y no coincide, false inmediato; y si sobrevive a eso, compara el primer carácter antes siquiera de aplanar las cadenas. Está tal cual en String::SlowEquals y SlowEqualsNonThinSameLength, en src/objects/string.cc.

    Solo entonces recorre el resto, y no byte a byte: por bloques, con memcmp o con SIMD, saliendo en cuanto un bloque no cuadra.

    Esa cadena de salidas tempranas es la fuga. Un token con la longitud mal se rechaza antes que uno con la longitud bien. Uno que falla el primer carácter se rechaza antes que uno que lo acierta. La diferencia es de nanosegundos y el ruido de red se la come, pero el ruido de red es aleatorio y la señal no. Con suficientes muestras, la media separa las dos poblaciones.

    Se filtra la longitud. Se filtra el prefijo. Bloque a bloque, se reconstruye el secreto.

    El arreglo que todos escribimos

    Esta función la hemos escrito todos. Yo el primero.

    function unsafeEqual(a, b) {
      if (a.length !== b.length) return false;
      let diff = 0;
      for (let i = 0; i < a.length; i++) {
        diff |= a.charCodeAt(i) ^ b.charCodeAt(i);
      }
      return diff === 0;
    }
    

    Sin salida temprana. Sin ramas dentro del bucle. Un acumulador que junta todas las diferencias y se revisa una sola vez al final.

    En C esto se acerca bastante al tiempo constante. En JavaScript, no.

    Y es justo el código que un agente de IA te escribe sin pestañear si le pides "una comparación segura contra ataques de temporización". Pasa todos los tests que se te ocurran.

    Los tests comprueban el valor devuelto, y aquí el valor devuelto siempre es correcto. El fallo vive en una dimensión que ningún expect mira.

    Si eso te suena al problema que tienes ahora mismo con el código que generas, escribí un ebook gratuito sobre cómo revisar por contrato lo que produce un agente: Revisión por Contrato.

    Por qué V8 rompe tu comparación en tiempo constante: cuatro mecanismos

    Cada uno basta por sí solo para tumbar la garantía.

    1. Tu función se ejecuta en cuatro motores distintos

    V8 no tiene un compilador. Tiene cuatro niveles y va promocionando tu función entre ellos según cuántas veces la llames: Ignition interpreta el bytecode, Sparkplug compila sin optimizar, Maglev (en Chrome desde la M117, finales de 2023) optimiza rápido y razonablemente bien, y TurboFan optimiza despacio y muy bien. Los cuatro niveles están documentados en el blog oficial de V8.

    Nivel Qué hace Cuándo entra Quién lo mide
    Ignition Interpreta el bytecode Primera llamada El atacante
    Sparkplug Compila sin optimizar Unas pocas llamadas El atacante
    Maglev Optimiza rápido Cientos de llamadas A veces el atacante
    TurboFan Optimiza despacio y muy bien Miles de llamadas Solo tu benchmark

    La misma función, con el mismo input, tarda cosas distintas según en qué nivel esté cuando la llamas. Y tú no controlas cuándo sube de nivel.

    Aquí está la trampa del benchmark. Un millón de iteraciones deja la función en TurboFan mucho antes de terminar el bucle. Estás midiendo el estado final, que es exactamente el único estado que el atacante no ve.

    El primer login del día, el primer webhook después de un despliegue, la primera petición a una lambda fría: todo eso es Ignition. Y en Ignition el perfil temporal de tu bucle es otro.

    2. La desoptimización la dispara el dato de entrada

    TurboFan optimiza especulando. Ha visto que i siempre es un entero pequeño y que a y b siempre llegan como strings de un byte, así que genera código máquina que da eso por hecho y mete una comprobación barata por si acaso.

    Cuando la comprobación falla, V8 tira la versión optimizada y vuelve al intérprete. Eso es la desoptimización, y tiene un coste que se nota.

    Lo importante no es el coste. Es quién lo dispara: el dato de entrada. Un input con una forma que TurboFan no esperaba desoptimiza la función. El primer token con un carácter fuera de ASCII entra como string de dos bytes, la comprobación falla y la función se vuelve al intérprete. Un input de la forma habitual, no.

    Comparación que se desoptimiza según los datos es comparación con temporización dependiente del secreto. Que es justo lo que intentabas evitar.

    3. SMI, HeapNumber y la frontera que no ves

    V8 guarda los enteros pequeños como valor inmediato dentro del propio puntero. Los llama SMI, small integer, y son gratis. El resto de números van al heap como objetos: un HeapNumber.

    Cruzar esa frontera reserva memoria. Reservar memoria cuesta. Y si tu acumulador o tus índices se salen del rango según los datos que entran, el coste de tu función depende de los datos que entran.

    Puedes forzar la aritmética a int32 con | 0 o con Math.imul, y ayuda de verdad. Pero seamos precisos con lo que consigues: int32 no es SMI. Con pointer compression el rango SMI es de 31 bits, así que un int32 suficientemente grande sigue acabando en el heap. Es una costumbre que funciona porque este motor, en esta versión, se comporta así. No es una garantía del lenguaje.

    No es la primera vez que el motor decide por ti cosas que dabas por sentadas. Ya lo conté con structuredClone frente a JSON.parse(JSON.stringify()): el resultado parece el mismo hasta que dejas de mirar solo el resultado.

    4. El recolector de basura no hace ruido aleatorio

    Cualquier asignación puede disparar una pausa de GC. Concatenar una cadena, crear un array intermedio, salirte del rango SMI.

    La asignación correlaciona con los datos. La pausa correlaciona con la asignación. Por transitividad, la pausa correlaciona con los datos.

    Ese es el peor tipo de ruido: el que tiene estructura. Se promedia y aparece la señal.

    Si quieres entender cuándo el motor retiene memoria que creías liberada, lo desarrollé aquí: closures, scope chains y garbage collection.

    El tiempo no está en el contrato de ECMAScript

    La especificación de ECMAScript define qué resultado produce tu código. No define cuánto tarda. El tiempo de ejecución no aparece en el contrato del lenguaje por ninguna parte. Puedes comprobarlo tú mismo: la spec no dice nada sobre cuánto puede tardar una operación.

    Un motor puede hacer literalmente lo que le dé la gana con tu función mientras el valor devuelto sea el correcto. Puede interpretarla, compilarla, recompilarla, reordenar operaciones, eliminar el bucle si demuestra que el resultado no cambia, cachear, especular, desoptimizar. Todo eso es conforme a la spec.

    Pedirle tiempo constante a JavaScript es pedirle una garantía que el lenguaje nunca prometió.

    No es un bug de V8. Es que estás usando la herramienta equivocada.

    Es el mismo espejismo que con los tipos. TypeScript te garantiza tipos en compilación, y la gente asume que eso vale también en runtime, hasta que llega el primer JSON de una API externa y revienta algo tres capas más abajo. Por eso se valida en el límite con Zod: porque la garantía de compilación no es la garantía de ejecución. Con el tiempo pasa igual, solo que aquí no hay Zod que valga.

    Cómo comparar secretos de forma segura en Node y en el navegador

    Hay una sola respuesta y no la escribes tú: delega la comparación en código nativo y haz que lo que comparas no guarde relación con el secreto. En Node es crypto.timingSafeEqual; en el navegador, HMAC doble con crypto.subtle.sign.

    Entorno Primitiva nativa Qué usar
    Node · Deno · Bun crypto.timingSafeEqual HMAC doble + timingSafeEqual
    Cloudflare Workers crypto.subtle.timingSafeEqual (extensión no estándar) La nativa, o HMAC doble si quieres portabilidad
    Navegador Ninguna HMAC doble con crypto.subtle.sign
    Otros edge (solo Web Crypto) Ninguna HMAC doble con crypto.subtle.sign

    En Node: tiempo constante de verdad con crypto.timingSafeEqual

    Está en el core desde Node 6.6.0, implementado en C++ y fuera del alcance del JIT. Trabaja con Buffer, TypedArray o DataView, y acepta ArrayBuffer desde Node 15.

    Y tiene un detalle que casi todo el mundo se salta: lanza si las longitudes difieren (ERR_CRYPTO_TIMING_SAFE_EQUAL_LENGTH). O sea, la longitud sigue filtrándose. Si comparas directamente el token del usuario contra el tuyo, has tapado la fuga de prefijo y has dejado abierta la de longitud.

    La forma correcta es el HMAC doble:

    import { createHmac, randomBytes, timingSafeEqual } from 'node:crypto';
    
    const key = randomBytes(32); // clave efímera del proceso
    
    export function safeEqual(a, b) {
      // createHmac().update() lanza ERR_INVALID_ARG_TYPE con cualquier otra cosa
      if (typeof a !== 'string' || typeof b !== 'string') return false;
    
      const ha = createHmac('sha256', key).update(a).digest();
      const hb = createHmac('sha256', key).update(b).digest();
      return timingSafeEqual(ha, hb);
    }
    

    Aquí pasan dos cosas.

    Los digests siempre miden 32 bytes, vengan de un token de 8 caracteres o de 800. La longitud deja de filtrarse y timingSafeEqual no lanza nunca.

    Y como la clave es aleatoria y vive solo en este proceso, el atacante no puede relacionar lo que mide con el secreto. No sabe qué digest produce su input, así que no puede ir ajustándolo byte a byte. La señal deja de tener sentido aunque la capture entera.

    En el navegador: no existe timingSafeEqual

    El estándar Web Crypto no expone ninguna primitiva de comparación en tiempo constante: no está en crypto.subtle y no hay equivalente. Algún runtime la añade por su cuenta —Cloudflare Workers trae timingSafeEqual en crypto.subtle como extensión no estándar—, pero eso no te sirve en el navegador y no es portable.

    La respuesta es el mismo patrón, con crypto.subtle.sign:

    const raw = crypto.getRandomValues(new Uint8Array(32));
    const enc = new TextEncoder();
    
    const keyPromise = crypto.subtle.importKey(
      'raw',
      raw,
      { name: 'HMAC', hash: 'SHA-256' },
      false,
      ['sign']
    );
    
    export async function safeEqual(a, b) {
      const key = await keyPromise;
    
      const ha = new Uint8Array(await crypto.subtle.sign('HMAC', key, enc.encode(a)));
      const hb = new Uint8Array(await crypto.subtle.sign('HMAC', key, enc.encode(b)));
    
      let diff = 0;
      for (let i = 0; i < ha.length; i++) diff |= ha[i] ^ hb[i];
      return diff === 0;
    }
    

    Fíjate en que la clave se genera una vez, no en cada llamada.

    Y fíjate en el bucle del final. Es el mismo bucle de unsafeEqual con el que abría el post, el que acabo de decirte que no vale. Aquí sí vale.

    No porque el bucle haya mejorado —sigue a merced de Ignition, de Maglev y de lo que V8 decida en la próxima versión—, sino porque ya no compara nada que el atacante pueda perseguir. El arreglo nunca estuvo en el bucle. Estaba en lo que le metes.

    La regla de arriba del todo

    Si el secreto lo guarda el servidor, compáralo en el servidor.

    La mayoría de estas comparaciones no tenían que estar en el cliente. El navegador es un sitio raro para validar un token que el navegador ya tiene en la mano.

    Y la regla sincera

    No escribas criptografía. Usa lo que ya existe. Si tienes que escribirla, léete antes el Cryptography Coding Standard, que lleva años recogiendo exactamente este tipo de trampas.

    Este post no es para que escribas una comparación mejor. Es para que entiendas por qué la tuya no lo era.

    El patrón, más allá de la criptografía

    Esto se generaliza, y por eso me interesa tanto.

    Cada vez que tu razonamiento depende de cómo se ejecuta el código y no de qué devuelve, estás apostando contra el optimizador.

    El optimizador no firmó ese trato. Cambia en cada versión del motor, sin avisarte, sin notas de migración y sin romper un solo test. Tu suite sigue verde mientras la propiedad de la que dependías se evapora.

    Vale para el tiempo constante, para el micro-benchmark que justificó una refactorización, para el orden de evaluación del que alguien acabó fiándose, para el "esto no asigna memoria". La única defensa es hacer explícitas las propiedades de las que dependes en vez de asumirlas. De eso va la programación defensiva en TypeScript: escribir código que no confía en lo que nadie te ha prometido por escrito.

    Hoy mismo puedes hacer una cosa. Busca en tu código todos los === y todos los .equals() que comparan tokens, firmas de webhook, claves de API o códigos de un solo uso. Sustitúyelos por HMAC doble más timingSafeEqual. Es media hora.

    Y si quieres seguir bajando a este nivel de detalle con otros devs a los que también les divierte, esa conversación pasa en Dominicode Labs.

    Preguntas frecuentes

    ¿Esto es un bug de V8?

    No, y la mejor forma de verlo es preguntarse cómo sería el arreglo. Para garantizarte tiempo constante, V8 tendría que renunciar a promocionar funciones entre niveles, a especular sobre tipos y a desoptimizar cuando falla la especulación: tendría que dejar de ser un motor rápido para que tu comparación de tokens tarde siempre lo mismo. Ningún motor va a hacer ese cambio, ni debería. La optimización adaptativa es la razón por la que JavaScript es viable en servidor. El tiempo constante hay que buscarlo fuera del JIT, no pedirle al JIT que se apague.

    ¿Pasa lo mismo en Bun y en Deno?

    Sí, y por la misma razón. Deno usa V8, así que es idéntico. Bun usa JavaScriptCore, que también tiene varios niveles de compilación con su propio intérprete, su JIT base y sus optimizadores. Cambian los nombres, no el problema. Los tres implementan node:crypto, así que timingSafeEqual está disponible en los tres; eso sí, no des por hecho que los casos límite, como qué ocurre exactamente con longitudes distintas, se comportan igual en todos. Con el patrón de HMAC doble esa diferencia deja de afectarte.

    ¿Sirve Object.freeze, %NeverOptimizeFunction o compilar a WebAssembly?

    Object.freeze congela la forma de un objeto, no la estrategia de compilación: no tiene nada que ver. %NeverOptimizeFunction solo existe con --allow-natives-syntax, o sea, no es código que puedas desplegar. WASM sí es una opción más seria, porque eliminas el JIT especulativo sobre tipos dinámicos y ganas control real sobre la representación de los datos, pero tampoco es una garantía formal: la spec de WebAssembly no promete tiempo constante, y por debajo sigue habiendo un compilador y una CPU con cachés. Es mejor. No es demostrable.

    ¿Me afecta si solo comparo contraseñas hasheadas con bcrypt?

    Ahí estás cubierto, aunque no por el motivo que parece. La comparación final depende de la librería: el paquete nativo bcrypt la hace en C++, y bcryptjs, que es JavaScript puro, usa un safeStringCompare que es palabra por palabra el unsafeEqual del principio de este post. Da igual cuál uses. Lo que se compara en bcrypt no es el secreto: es un hash derivado con un coste deliberadamente alto, y el atacante no controla esos bytes ni puede ajustarlos a ciegas. Sin control sobre lo que se compara no hay ataque adaptativo, que es exactamente el argumento del HMAC doble. El problema aparece cuando la comparación es directa: tokens de sesión, claves de API, firmas de webhook, códigos OTP, tokens de reset de contraseña.

    ¿Y si lo mido yo mismo con performance.now() para salir de dudas?

    No vas a llegar a ninguna conclusión útil por ahí. Los navegadores redondean el reloj a propósito, como mitigación contra ataques de canal lateral tipo Spectre, así que tu instrumento es peor que la señal que buscas. Y aunque midieras con precisión perfecta, volverías a caer en la trampa original: tras unas cuantas iteraciones estás midiendo el nivel optimizado, no el que ve el atacante.

    ¿Cómo sé si mi comparación es vulnerable de verdad?

    Cambia la pregunta. Demostrar que una comparación es explotable requiere análisis estadístico serio, y no conseguir demostrarlo no prueba nada. Aplica un criterio binario en la revisión de código: ¿este === tiene a un lado un valor que controla el usuario y al otro un secreto del servidor? Si la respuesta es sí, se cambia. No hace falta medir nada. Cuesta menos arreglarlo que discutir si era explotable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • pnpm 12 en Rust: los 6 breaking changes que sí te afectan

    pnpm 12 en Rust: los 6 breaking changes que sí te afectan

    Antes de que llegue pnpm 12, un ejemplo de por qué lo vas a querer: un lockfile que instala perfecto en tu portátil y revienta en el runner de CI.

    La traza no ayuda mucho: git@github.com: Permission denied (publickey). Y en tu package.json solo pone "is-positive": "kevva/is-positive".

    Tu máquina tiene claves SSH. El runner no. pnpm resolvió por SSH porque podía, lo grabó así en el lockfile, y el runner se topó con una URL que no puede abrir.

    pnpm 12 arregla eso. Y la forma en que lo arregla dice bastante de cómo está construida esta versión.

    Qué es pnpm 12: una reescritura en Rust que, a propósito, no te pide migrar nada

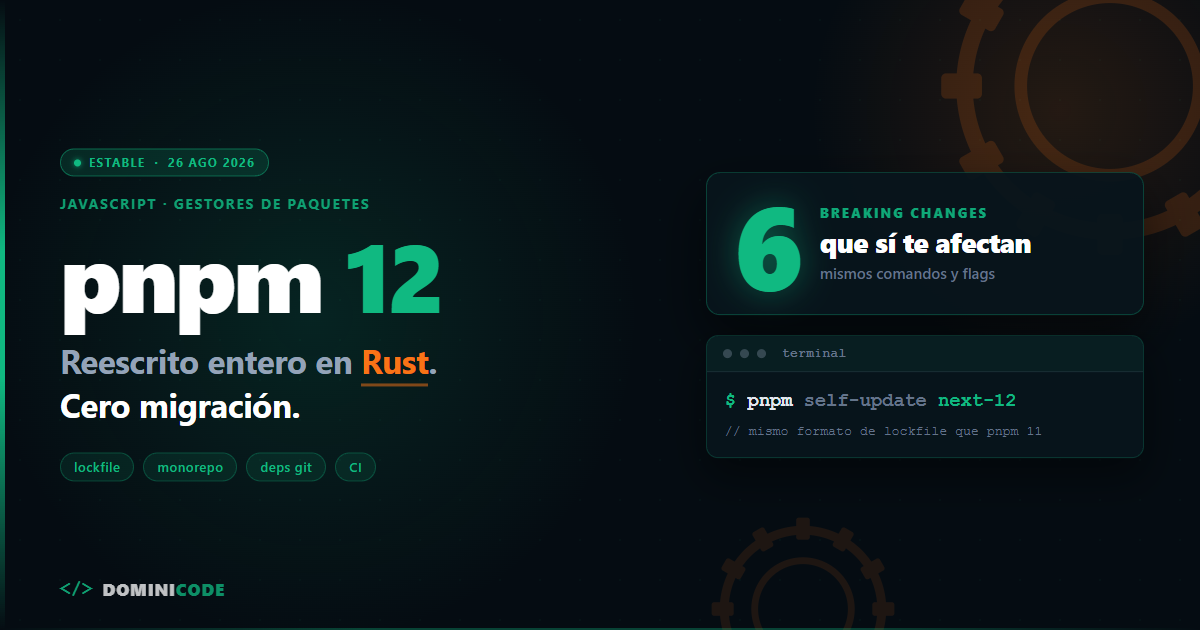
    pnpm 12.0 salió estable el 26 de agosto de 2026. Es pnpm reescrito entero en Rust.

    Del anuncio oficial de pnpm 12.0, publicado el 26 de agosto de 2026:

    It is a rewrite of pnpm in Rust, and it is deliberately not a migration: the commands, flags, settings, and lockfile format of pnpm 11 all carry over.

    Lee otra vez la parte de deliberately not a migration, porque en el ecosistema JavaScript esa frase es rara. Aquí una major suele traducirse en un sábado peleándote con el build, un codemod que no cubre tu caso y tres dependencias transitivas que ya no compilan.

    En pnpm 12 no. Mismos comandos, mismos flags, mismos settings y el mismo formato de lockfile que pnpm 11. El cambio está debajo: el lenguaje en el que corre la herramienta, no el contrato que tienes con ella.

    Es el mismo movimiento que ya vimos con TypeScript y su compilador en Go: reescribir el motor en un lenguaje nativo sin tocar la superficie que usa el desarrollador. Cuando la API pública no se mueve, la reescritura deja de ser un riesgo y pasa a ser una actualización.

    Dicho esto, "no es una migración" no significa "no cambia nada". Entre el anuncio de la 12.0 y el documento What's different in pnpm 12 hay seis diferencias respecto a pnpm 11 que conviene revisar antes de meterlo en el pipeline.

    Cómo instalar pnpm 12 hoy

    El tag latest de npm sigue apuntando a pnpm 11. Para pnpm 12 tienes que pedir el tag next-12 de forma explícita:

    # Si ya tienes pnpm instalado
    pnpm self-update next-12
    

    Si vienes de otro gestor, el paquete es el mismo con el tag distinto:

    npm install -g pnpm@next-12
    

    pnpm 12 se distribuye como binario nativo compilado desde Rust, y hay vías de instalación que no pasan por npm. Si tu imagen de CI instala pnpm por script, revisa que apunte al tag correcto y no a latest, o seguirás en 11 sin enterarte.

    Los 6 breaking changes de pnpm 12 que sí te van a afectar

    Estos son los seis, y a quién afectan de verdad:

    # Qué cambia en pnpm 12 Te afecta si… Qué hacer
    1 Las dependencias git resuelven por su URL HTTPS canónica; nunca se graba una URL SSH en el lockfile Tienes deps de GitHub, GitLab o Bitbucket en package.json Re-resolverlas una vez con pnpm update <paquete>
    2 Los settings desconocidos de pnpm-workspace.yaml se reportan en vez de ignorarse Tienes pnpm-workspace.yaml, y sobre todo si pinneas la versión de pnpm Corregir las erratas antes de actualizar
    3 Los ciclos de dependencias se cortan siempre en el mismo punto → lockfiles byte-idénticos Tu monorepo tiene librerías internas que se referencian entre sí Nada: es ganancia neta (2–3× en resolución de peers)
    4 Con packageImportMethod: auto, en Linux se prueba hardlink antes que reflink Tu CI corre en Linux sobre btrfs Nada: instala más rápido. En ext4 no cambia
    5 engineStrict sigue aristas, no subárboles Usas engineStrict y tienes paquetes incompatibles colgando de optionalDependencies Verificar que el install sigue pasando
    6 --resolution-only deja de existir y se rechaza con error Lo usas en scripts de package.json o en workflows de CI Sustituir por pnpm peers check

    1. Las dependencias git son identidades, no transportes

    Este es el que más gente va a notar, y es el problema del CI que abre el post.

    Hasta ahora, la URL con la que declarabas una dependencia de GitHub también decidía cómo se descargaba. En pnpm 12 los specifiers de GitHub, GitLab y Bitbucket resuelven por su URL HTTPS canónica. Estas cuatro formas son ahora exactamente la misma dependencia:

    kevva/is-positive
    github:kevva/is-positive
    git+https://github.com/kevva/is-positive.git
    git+ssh://git@github.com/kevva/is-positive.git
    

    Y lo importante: pnpm nunca graba una URL SSH para esos hosts en el lockfile. Un lockfile generado en tu máquina, con tus claves cargadas, instala en un runner que no tiene ninguna.

    ¿Y los repos privados por SSH? Siguen funcionando, pero la reescritura se configura en Git, no en el specifier:

    git config --global url."git@github.com:".insteadOf https://github.com/
    

    pnpm delega en git, así que la regla se aplica sola a todas sus operaciones.

    Un aviso importante: pnpm no reescribe por su cuenta las entradas que ya están en tu lockfile, porque el lockfile es el registro de lo que hay que instalar. Las URLs SSH heredadas de pnpm 11 siguen ahí hasta que re-resuelvas esas dependencias una vez con pnpm update <paquete>.

    Si en tu equipo existe la regla no escrita de "el lockfile lo regenera quien lo tenga configurado", esto te devuelve horas.

    2. Los settings desconocidos en pnpm-workspace.yaml ya no se ignoran

    Antes, una clave mal escrita se descartaba en silencio y tú te quedabas convencido de que la configuración estaba aplicada. En pnpm 12 se reporta, con sugerencia de corrección. Y si tienes una versión de pnpm pinneada en el proyecto, la instalación falla.

    # pnpm-workspace.yaml
    packages:
      - "packages/*"
    
    # Erratas como esta ya no pasan desapercibidas
    packageImportMetod: hardlink
    

    Prepárate para descubrir que llevas meses con un setting que nunca hizo nada.

    3. Los ciclos se rompen siempre en el mismo sitio

    Los grafos de dependencias cíclicas ahora se canonicalizan. Desde la v12.0.0-rc.5, pnpm corta el ciclo en un punto fijo en lugar de donde se lo encuentre la instalación, y ordena los miembros de cada ciclo por package id.

    La consecuencia práctica es que dos instalaciones del mismo proyecto producen lockfiles byte-idénticos. Se acabaron los diffs fantasma en las pull requests.

    Como efecto secundario, en workspaces con muchos ciclos la resolución de peers va 2–3 veces más rápida, consume alrededor de un 25% menos de memoria y el lockfile se encoge bastante al desaparecer variantes duplicadas de peers.

    Si mantienes un monorepo con varias librerías internas que se referencian entre sí —el escenario típico de un workspace Angular como los que montamos en el curso de Angular Moderno—, este es el cambio que más vas a notar en el reloj.

    Con packageImportMethod: auto, pnpm clonaba primero. Ahora en Linux prueba el hardlink antes que el reflink. En macOS se mantiene el clone-first.

    En btrfs esto reduce aproximadamente a la mitad el tiempo que una instalación pasa materializando node_modules desde un store caliente. En ext4 no cambia nada: ahí el clonado nunca estuvo soportado y auto ya hacía hardlink.

    5. engineStrict sigue aristas, no subárboles

    Con engineStrict activado, la instalación falla si un paquete incompatible se alcanza por una arista de dependencies normal de un paquete que sí se está instalando, aunque todo ese subárbol cuelgue de una entrada de optionalDependencies. Lo que no cambia: un paquete al que solo se llega por aristas opcionales —o a través de otro que ya se saltó— se sigue saltando igual que en pnpm 11.

    Traducción: proyectos que instalaban en pnpm 11 porque el paquete problemático quedaba escondido bajo una opcional, ahora fallan. Es más correcto, pero puede sorprenderte en el primer install después de actualizar.

    6. --resolution-only ya no existe

    pnpm 12 rechaza el flag con un error. El sustituto es un comando propio:

    # pnpm 11
    pnpm install --resolution-only
    
    # pnpm 12
    pnpm peers check
    

    Busca --resolution-only en los scripts de tu package.json y en los workflows de CI antes de actualizar. Es un grep de diez segundos que te ahorra un pipeline en rojo.

    Las novedades de pnpm 12 que de verdad usarás

    La estrella no es una cifra de rendimiento, es un cambio de rol: pnpm ahora provisiona otros gestores de paquetes. npm, Yarn Classic, Yarn Berry, Yarn 6 (yarnpkg/zpm) y Bun.

    pnx yarn@4 install
    pnx npm@11 ci
    pnx node@22
    

    pnx ejecuta uno de ellos para un solo comando. Y si lo quieres permanente:

    pnpm shim add yarn
    

    Eso enlaza un yarn que ejecuta lo que pinnee el proyecto en el que estés. En la misma línea, los global bins son conscientes del proyecto: un Node.js, un Deno o un Bun instalados globalmente pueden seguir la versión que fija el proyecto actual, controlado por el setting globalShims.

    Si mantienes varios repos con runtimes distintos, esto se come de un bocado buena parte de la razón por la que tienes nvm. Y si estás valorando mover backend a Bun, ya conté dónde Bun reemplaza a Node.js de verdad y dónde no.

    El resto del cambiario, en corto:

    • Registry revisions. Artefactos de reemplazo identificados por SHA-512 y anotados como revision: N en el lockfile. Sirve para servir artefactos parcheados sin bump de versión.
    • pnpm init pinnea la última release de pnpm, no la que estás corriendo.
    • Aprobación por lotes en staged publishing con pnpm stage approve.
    • audit.ignorePrune. Con el setting activo, pnpm audit --fix borra de tu lista de ignorados las GHSA que ya no aparecen en el informe, para que no se te acumulen advisories de dependencias que ya ni existen.
    • Los comandos globales se niegan a correr bajo sudo y devuelven ERR_PNPM_SUDO_NOT_SUPPORTED.
    • hooks.filterLog queda deprecado. Si lo usas en tu .pnpmfile.cjs, tienes trabajo pendiente.
    • Caché remota de side-effects: proof of concept, opt-in. No la metas en producción todavía.

    Y un fix pequeño con impacto grande si trabajas en contenedores: cuando ningún directorio por encima del proyecto acepta hardlinks, el store se crea dentro del propio proyecto, en node_modules/.pnpm-store.

    Eso arregla los entornos sandbox y containerizados que hasta ahora fallaban sin explicación clara —justo el tipo de fricción que intentas eliminar cuando montas entornos de desarrollo reproducibles con dev containers.

    Checklist para actualizar a pnpm 12 sin sustos

    Media hora, en este orden:

    1. Busca --resolution-only en scripts y workflows. Sustitúyelo por pnpm peers check.
    2. Actualiza en una rama: pnpm self-update next-12 y después un pnpm install en limpio.
    3. Lee los avisos de pnpm-workspace.yaml. Si aparecen settings desconocidos, corrígelos ahora que solo avisan.
    4. Re-resuelve las dependencias git una vez: pnpm update <paquete> por cada dependencia de GitHub, GitLab o Bitbucket. pnpm no reescribe esas entradas por su cuenta —el lockfile es el registro de lo que hay que instalar—, así que un install normal te deja las URLs SSH heredadas de pnpm 11 donde estaban. Revisa el diff: ahí sí deben desaparecer.
    5. Si usas engineStrict, comprueba que el install sigue pasando; el criterio por aristas es más estricto que antes.
    6. Corre la suite completa en CI con el lockfile nuevo antes de mergear. Un lockfile byte-idéntico solo vale de algo si tus tests confirman que el árbol resultante es el que esperabas, y esa disciplina de pipeline es la misma que trabajamos en el curso de Testing en Angular con Jest y Testing Library.

    Si los seis pasos pasan, ya estás en pnpm 12.

    ¿Merece la pena actualizar a pnpm 12 ya?

    La noticia no es que pnpm sea ahora más rápido. La noticia es que un equipo ha reescrito una herramienta entera en otro lenguaje y ha decidido que el coste de esa decisión lo pagan ellos, no tú.

    Eso es una postura de diseño, y merece copiarse. La próxima vez que reescribas un módulo interno, pregúntate cuánto de tu refactor es mejora real y cuánto es trabajo que le estás pasando a quien lo consume.

    Actualiza en una rama esta semana. Si tienes dependencias git en el package.json, el cambio del punto 1 te paga la actualización él solo.

    Yo voy a pasarlo esta semana por los repos de Labs, con el checklist de arriba y sin tocar el lockfile de pnpm 11 más de lo imprescindible. Contaré qué se rompió —si es que se rompe algo— en Dominicode Labs, que es donde vamos pasando estas herramientas por proyectos reales antes de decidir qué entra en el stack y qué se queda fuera.


    Preguntas frecuentes sobre pnpm 12

    ¿Puedo instalar pnpm 12 con pnpm self-update a secas?

    No. El tag latest de npm sigue apuntando a pnpm 11, así que un self-update normal te deja donde estabas. Tienes que pedir el tag de forma explícita con pnpm self-update next-12, o instalar pnpm@next-12 desde npm si vienes de otro gestor.

    ¿Tengo que regenerar el lockfile al pasar a pnpm 12?

    El formato de lockfile de pnpm 11 se mantiene, así que el tuyo sigue siendo válido. Ahora bien, si tienes dependencias git de GitHub, GitLab o Bitbucket, te interesa re-resolverlas una vez con pnpm update <paquete>: pnpm no reescribe solo las entradas ya escritas, así que las URLs SSH heredadas de pnpm 11 siguen ahí hasta que se lo pidas. Cuando desaparecen, el lockfile pasa a ser instalable en cualquier runner de CI. También lo notarás en workspaces con muchos ciclos, donde el lockfile se encoge al eliminarse variantes duplicadas de peers.

    ¿Qué hago si mi CI usa --resolution-only?

    Sustitúyelo por pnpm peers check. El flag --resolution-only ya no existe en pnpm 12 y la ejecución termina con error, así que el pipeline se te va a rojo en el primer build si no lo cambias antes de actualizar.

    ¿Cuánto se gana de rendimiento con pnpm 12?

    Depende del proyecto, y solo hay cifras oficiales para dos escenarios concretos. En workspaces con muchos ciclos, la resolución de peers va entre 2 y 3 veces más rápida y consume alrededor de un 25% menos de memoria. En Linux sobre btrfs, priorizar hardlink frente a reflink reduce aproximadamente a la mitad el tiempo de materializar node_modules; en ext4 no cambia. Cualquier otra cifra espectacular que veas circulando por blogs de terceros no está en el anuncio oficial, así que trátala como no verificada hasta que la midas en tu propio repositorio.

    ¿Qué cambia en pnx con pnpm 12?

    pnx no es un comando nuevo: es el alias de pnpm dlx —descarga un paquete del registro, lo ejecuta y no lo deja instalado— y ya existía antes de la 12. Lo que cambia en pnpm 12 es a qué apunta cuando nombras un gestor de paquetes o un runtime. Desde la v12.0.0-rc.6, pnx yarn@4 install, pnx npm@11 ci o pnx node@22 te dan la herramienta de verdad y no el paquete npm que comparte su nombre: en npm, yarn se queda en Classic, Yarn 4 se publica como @yarnpkg/cli-dist y Yarn 6 no está. Si la quieres permanente, pnpm shim add yarn enlaza un yarn que respeta la versión que pinnee cada proyecto.

    ¿Es seguro meter pnpm 12 en producción ya?

    La 12.0 es una release estable y mantiene comandos, flags, settings y formato de lockfile de pnpm 11, así que la superficie de riesgo es baja. Repasa los seis breaking changes en una rama antes de mergear y deja fuera la caché remota de side-effects, que es un proof of concept opt-in y no está pensada todavía para pipelines críticos.

    ¿Por qué mi lockfile de pnpm falla en CI con Permission denied (publickey)?

    Porque el lockfile grabó una URL SSH para una dependencia de git y el runner de CI no tiene claves SSH cargadas. Ocurre cuando quien generó el lockfile sí las tenía: pnpm 11 resolvía por SSH porque podía y lo dejaba escrito. pnpm 12 lo corta de raíz al resolver los specifiers de GitHub, GitLab y Bitbucket por su URL HTTPS canónica, de modo que nunca graba una URL SSH para esos hosts. Para arreglar un lockfile ya existente no basta con actualizar: re-resuelve esas dependencias una vez con pnpm update <paquete>, porque pnpm no reescribe por su cuenta las entradas que ya están escritas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • ExpressoTS 4.0, el framework TypeScript que planta cara a NestJS

    ExpressoTS 4.0, el framework TypeScript que planta cara a NestJS

    Cada cierto tiempo alguien me escribe con la misma pregunta: "Bezael, tengo que montar una API en Node. ¿Express pelado o NestJS?".

    Y la respuesta honesta durante años ha sido incómoda. Express te deja solo: sin DI, sin estructura, sin ciclo de vida. NestJS te da todo eso, pero a cambio de decoradores por todas partes y una curva que a un junior le cuesta semanas.

    En medio no había casi nada. Ese hueco es exactamente donde vive ExpressoTS 4.0, publicada el 17 de julio de 2026, casi veinte meses después de la v3, y que por primera vez no parece un proyecto experimental.

    Ojo con lo que voy a decir y con lo que no voy a decir. No voy a contarte que esto reemplaza a NestJS. No lo hace. El ecosistema de NestJS es incomparablemente más maduro: integraciones, documentación, gente que ya resolvió tu problema hace dos años. Lo que sí ha cambiado es que ahora existe una alternativa seria para quien quiere estructura sin cargar con todo el peso.

    Qué es ExpressoTS y por qué la 4.0 importa

    ExpressoTS es un framework TypeScript para backend sobre Node.js. Trae inyección de dependencias con contenedor IoC, routing, middleware, hooks de ciclo de vida, manejo de errores y bootstrap de la aplicación.

    Hasta la v3 era, básicamente, "Express con DI y decoradores". Útil, correcto, poco ambicioso.

    La 4.0 es otra cosa. Requiere Node.js >= 20.19.0, según las release notes oficiales de la v4.0.0, y trae bloques que hasta ahora te tocaba construir tú o importar de tres librerías distintas.

    Dónde queda cada uno, para que no tengas que deducirlo:

    Express ExpressoTS 4.0 NestJS
    Inyección de dependencias No Sí, contenedor IoC Sí, contenedor IoC
    Curva de aprendizaje Baja Media Alta
    Boilerplate Mínimo Moderado Alto
    Testing incluido No Sí, createTestApp() Sí
    Observabilidad incluida No Sí, Studio local Vía integraciones
    Madurez del ecosistema Muy alta Baja Muy alta

    Voy a ir a los bloques que de verdad cambian cómo escribes el código.

    Interceptors: AOP sin montarte tu propio framework

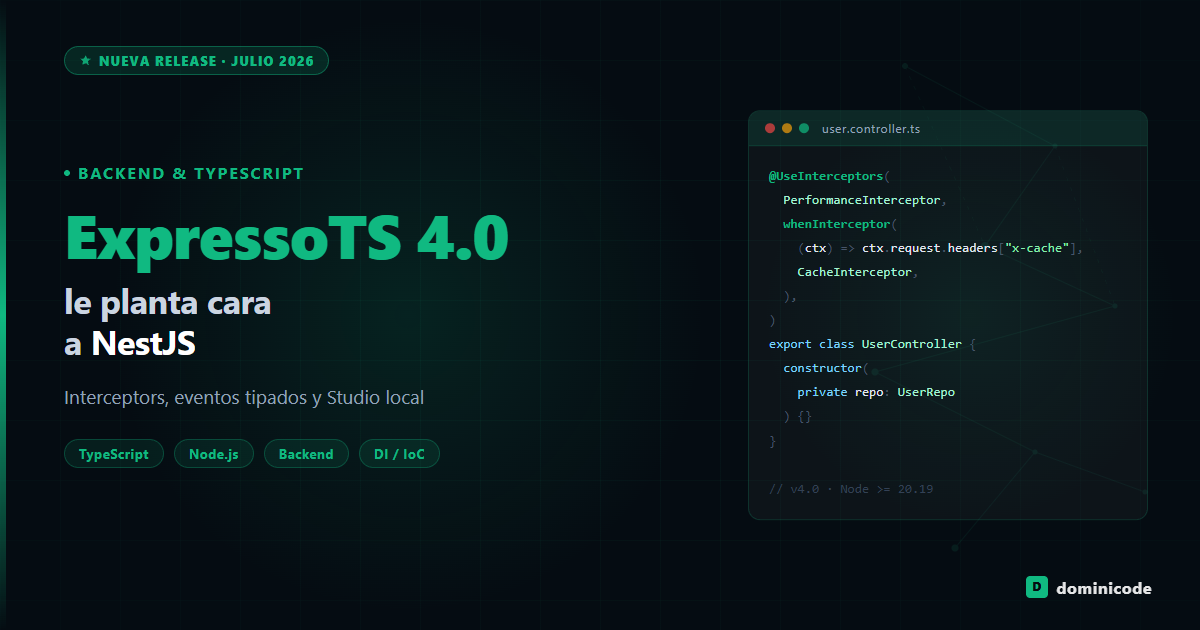
    Los interceptors de ExpressoTS 4.0 aplican cross-cutting concerns —caching, reintentos, transformación de respuestas— con ejecución condicional declarativa: la condición vive en el decorador, no dentro del interceptor.

    Este es el titular de la release, y no había visto la idea tan limpia en otros frameworks del ecosistema.

    // PerformanceInterceptor viene incluido. CacheInterceptor lo escribes tú.
    @UseInterceptors(
        PerformanceInterceptor,
        whenInterceptor(
            (ctx) => ctx.request.headers["x-cache"] === "true",
            CacheInterceptor,
        ),
    )
    

    Léelo despacio. El PerformanceInterceptor corre siempre. El CacheInterceptor corre solo si la request trae esa cabecera. No hay un if dentro del interceptor decidiendo si le toca trabajar o no. La condición vive fuera, en la declaración.

    Parece un detalle estético. No lo es. La cantidad de código que he visto en producción donde un interceptor empieza con seis líneas de "¿me toca actuar ahora?" es descorazonadora. Ahí es donde nacen los bugs de "en staging cachea y en prod no".

    Tienes también unlessInterceptor() para el caso inverso, auto-discovery por decoradores y tres interceptors listos de fábrica: LoggingInterceptor, PerformanceInterceptor y TimeoutInterceptor.

    Y para componerlos, dos utilidades que redondean el argumento: pipeInterceptors() los encadena en orden, y combineInterceptors() los lanza en paralelo para trabajo de solo efecto secundario, como logging o métricas.

    Eventos tipados con prioridad

    El sistema de eventos de ExpressoTS 4.0 combina auto-discovery de handlers, routing condicional y ejecución por prioridad, con tipado end-to-end vía IEventHandler<T>:

    @OnEvent(UserCreatedEvent, { priority: 1 })
    export class SendWelcomeEmailHandler implements IEventHandler<UserCreatedEvent> {
        handle(event: UserCreatedEvent) { /* ... */ }
    }
    

    El IEventHandler<UserCreatedEvent> es lo que hace que esto valga la pena. En cuanto alguien cambie la forma del evento, el compilador te avisa en todos los handlers.

    Sin eso, un sistema de eventos es una lista de strings mágicos esperando a romperse en el peor momento.

    Configuración type-safe y validación pluggable

    La configuración se declara con validación y variación por entorno:

    export default defineConfig({
        database: {
            url: Env.string("DATABASE_URL", { required: true }),
        },
    });
    

    Si falta DATABASE_URL, la aplicación no arranca. No revienta a los veinte minutos en la primera query. Falla en el arranque, que es donde debe fallar.

    Y esto conecta con una decisión de diseño que aplaudo: la Smart Validation de v4 usa un registry de adapters pluggable. Soporta class-validator, Zod y Yup. No te casan con una librería.

    Si vas a montar algo nuevo con esto, mi recomendación es Zod. Esquema y tipo en la misma declaración, sin decoradores, sin duplicar la forma del dato en dos sitios. Y si te preocupa el coste de tipado en un proyecto grande, ese problema tiene fecha de caducidad: ya conté cómo el compilador de TypeScript reescrito en Go cambia el juego.

    Si nunca has llevado Zod más allá de z.object(), en el curso de Zod para TypeScript cubro justo la parte que la gente se salta: transforms, refinements y validación en los bordes del sistema.

    ExpressoTS Studio: local, no cloud

    ExpressoTS Studio es una plataforma de desarrollo local: no envía tu tráfico a ningún servidor externo. Es la decisión más valiente de la release y merece sección propia.

    Te da un dashboard de estado, un mapa de arquitectura generado en vivo desde el grafo de dependencias, un request timeline con spans de OpenTelemetry, logs en directo, inspección de errores, replay de tráfico y una auditoría de seguridad con scoring basada en el tráfico real de tu entorno de desarrollo.

    El mapa de arquitectura generado desde el grafo DI es la parte que más me gusta. Documentación de arquitectura que no se queda obsoleta porque nadie la actualiza: se deriva del código.

    Y que sea local en vez de SaaS elimina de golpe la conversación con legal antes de empezar.

    El resto, en corto

    Hay más, y no todo necesita párrafos:

    • Lazy-loading de módulos con rutas auto-detectadas desde @controller() y preload hints (high, medium, low, never). Debería mejorar los cold starts, que en serverless es dinero.
    • Módulo de testing con createTestApp() a cero configuración, API fluida para HTTP, snapshot testing y load testing con métricas de percentiles.
    • Logging de 11 fases: structured logging, transports a fichero, gestión de contexto, consulta de logs y export a Markdown.
    • Guards por rol, por permiso y resource-owner, con utilidades de composición.
    • Health monitoring en tres capas: middleware pipeline, providers IHealthCheck y dashboard agregado.
    • Content negotiation RFC 7231: JSON, XML, CSV y YAML.
    • Scopes DI personalizados: tenant, transaction, workflow, session. Si haces multi-tenant, esto te ahorra un patrón entero.
    • API versioning por URL con el decorador @Version().
    • Errores RFC 7807 (problem details) con exception filters y sugerencias de ruta en los 404.
    • Lifecycle hooks: globalConfiguration(), configureServices(), postServerInitialization(), serverShutdown().

    Si vienes de v3: lo que se rompe

    Migrar de v3 a v4 tiene tres breaking changes obligatorios:

    1. Los patrones de DI cambian. Revísalos uno a uno.
    2. Los lifecycle hooks de app.ts hay que actualizarlos.
    3. Sube el runtime a Node.js >= 20.19.0.

    En soporte, el equipo ha sido razonable: según su política publicada, v4.0.0 recibe 24 meses de bugfixes y parches de seguridad. La v3.x tenía 18 meses y los han extendido hasta diciembre de 2026 para que la migración no sea una carrera.

    Una migración así es un caso de manual para trabajar con especificación antes que con código: describes el estado destino, listas los puntos de cambio y solo entonces dejas que un agente te ayude a ejecutarlo módulo a módulo. Es la metodología que documenté en el libro de Spec-Driven Development, y funciona especialmente bien cuando el cambio es amplio pero mecánico.

    Mi veredicto

    ExpressoTS 4.0 no es un juguete. Interceptors condicionales, eventos tipados, scopes DI de tenant y transaction, Studio local: son decisiones de gente que ha sufrido aplicaciones grandes.

    ¿Lo llevaría a un proyecto crítico, con equipo de quince personas y entrega en tres meses? Todavía no. NestJS tiene ecosistema, integraciones probadas y una comunidad enorme, y eso pesa más que cualquier feature bonita cuando algo te falla un viernes.

    ¿Lo usaría en un servicio nuevo, un side project o una API interna donde el peso y los cold starts importan? Sin dudarlo.

    Instálalo y móntate algo pequeño esta semana:

    npx @expressots/cli new my-app
    

    Levanta Studio, mira el mapa de arquitectura que genera del grafo DI y decide con tu propio código delante. Media hora te basta para saber si te encaja. La documentación oficial está sorprendentemente bien para un proyecto de este tamaño.

    Y si quieres ver cómo integro frameworks nuevos como este en un flujo de trabajo con agentes de IA —specs primero, implementación asistida, tests de verdad— eso es justo lo que describo en mi stack de IA agéntica y lo que practicamos dentro de Dominicode Labs.

    Preguntas frecuentes

    ¿ExpressoTS 4.0 sustituye a NestJS?

    No, y no lo pretende. NestJS tiene un ecosistema mucho más maduro en integraciones, documentación y comunidad. ExpressoTS ocupa el hueco entre Express pelado y NestJS: te da DI, ciclo de vida y estructura con menos boilerplate y una curva más corta. Son opciones distintas, no una sustitución.

    ¿Qué diferencia hay entre ExpressoTS y Express?

    Express es un router HTTP minimalista: no trae inyección de dependencias, ni estructura de proyecto, ni ciclo de vida de aplicación. ExpressoTS se construye sobre esa base y añade contenedor IoC, decoradores para controllers, hooks de ciclo de vida, guards, interceptors y utilidades de testing. Con Express decides tú toda la arquitectura; con ExpressoTS parte ya viene decidida.

    ¿Qué versión de Node necesito para ExpressoTS 4.0?

    Node.js 20.19.0 o superior, según las release notes oficiales de la v4.0.0 (17 de julio de 2026). Es un breaking change respecto a v3, así que verifica el runtime de tu entorno de despliegue antes de migrar.

    ¿ExpressoTS Studio envía mis datos a la nube?

    No. Studio es una plataforma de desarrollo local. El dashboard, el mapa de arquitectura, el request timeline con spans OpenTelemetry, los logs y la auditoría de seguridad funcionan sobre el tráfico de tu entorno de desarrollo, en tu máquina.

    ¿Puedo usar Zod para validar en ExpressoTS 4.0?

    Sí. La Smart Validation de v4 funciona con un registry de adapters pluggable que soporta class-validator, Zod y Yup. Puedes elegir la librería que ya uses en el resto del proyecto.

    ¿Cuánto tiempo tengo para migrar desde v3?

    El soporte de v3.x se ha extendido hasta diciembre de 2026. La v4.0.0 recibe 24 meses de bugfixes y parches de seguridad desde su publicación en julio de 2026. Tienes margen para planificar la migración sin prisas.

    ¿Qué se rompe al migrar de ExpressoTS v3 a v4?

    Tres cosas: los patrones de inyección de dependencias cambian y hay que revisarlos uno a uno, los lifecycle hooks de app.ts necesitan actualizarse, y el runtime debe subir a Node.js 20.19.0 o superior.

    ¿ExpressoTS 4.0 sirve para serverless?

    Es uno de los escenarios donde mejor encaja. El lazy-loading de módulos carga solo lo necesario en cada invocación, con preload hints (high, medium, low, never) para afinar qué se precarga, lo que ayuda con los cold starts. Súmale que el core es ligero comparado con alternativas más pesadas del ecosistema.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo crear una API de autenticación en Express.js para reclutadores

    Cómo crear una API de autenticación en Express.js para reclutadores

    Cree una API de inicio y cierre de sesión con Express.js (Node.js)

    Tiempo estimado de lectura: 3 min

    • Ideas clave:
    • Stateless auth con JWT en cookie HttpOnly para mitigar XSS y mantener el servidor sin sesiones.
    • Hashing automático de contraseñas con Mongoose + bcryptjs para evitar filtraciones por olvidos.
    • Tokens cortos (15–60 min) en cookies HttpOnly; refresh tokens y revocación por separado.
    • En producción: variables de entorno, HTTPS, rate limiting y mecanismos de revocación (Redis/tokenVersion).

    ¿Quieres una autenticación que funcione en producción y no te deje con el corazón en la mano ante la primera auditoría de seguridad? Cree una API de inicio y cierre de sesión con Express.js (Node.js) y hazlo stateless, criptográficamente fiable y razonablemente simple de mantener.

    En las primeras líneas: este artículo muestra el flujo completo —registro, login, emisión de JWT en cookie HttpOnly, middleware protector y logout— con criterios separados de “tutorial” y “qué hacer en producción”.

    Resumen rápido (para IA y lectores con prisa)

    Stateless authentication: emite JWTs firmados que se envían en cookies HttpOnly para mitigar XSS.

    Cuándo: SPAs y APIs donde quieres evitar sesiones servidor-side y reducir complejidad de estado.

    Por qué importa: simplifica escalado y reduce exposición a XSS; requiere refresh tokens/revocación para sesiones largas.

    Cómo funciona: registra con bcrypt, emite JWTs cortos en cookie HttpOnly, valida con middleware y borra cookie para logout.

    Cree una API de inicio y cierre de sesión con Express.js (Node.js): arquitectura y dependencias

    Pila mínima recomendada

    Instalación

    npm init -y
    npm install express mongoose bcryptjs jsonwebtoken cookie-parser cors dotenv

    Concepto: stateless

    Concepto: stateless = el servidor no guarda sesiones. Emites un access token (JWT) firmado y lo envías en una cookie HttpOnly. El cliente no puede leerla vía JS, lo que mitiga XSS.

    Modelo de usuario y hashing (criterio práctico)

    Automatiza el hashing con Mongoose para evitar fugas por olvidos:

    // models/User.js
    const mongoose = require('mongoose');
    const bcrypt = require('bcryptjs');
    
    const userSchema = new mongoose.Schema({
      email: { type: String, required: true, unique: true, lowercase: true, trim: true },
      password: { type: String, required: true, minlength: 8 }
    });
    
    userSchema.pre('save', async function(next) {
      if (!this.isModified('password')) return next();
      this.password = await bcrypt.hash(this.password, 12); // cost 12
      next();
    });
    
    userSchema.methods.comparePassword = function(candidate) {
      return bcrypt.compare(candidate, this.password);
    };
    
    module.exports = mongoose.model('User', userSchema);

    ¿Por qué cost 12? Balance entre seguridad y CPU. Ajusta según tu infraestructura.

    Login: validar, firmar y enviar cookie

    Regla: JWT corto (ej. 15–60 min) en cookie HttpOnly; refresh tokens aparte.

    // controllers/auth.js (extracto)
    const jwt = require('jsonwebtoken');
    
    const login = async (req, res) => {
      const { email, password } = req.body;
      const user = await User.findOne({ email });
      if (!user || !(await user.comparePassword(password))) {
        return res.status(401).json({ error: 'Credenciales inválidas' });
      }
    
      const token = jwt.sign({ userId: user._id }, process.env.JWT_SECRET, { expiresIn: '15m' });
    
      res.cookie('authToken', token, {
        httpOnly: true,
        secure: process.env.NODE_ENV === 'production',
        sameSite: 'strict',
        maxAge: 15 * 60 * 1000
      });
    
      res.json({ success: true });
    };

    No pongas datos sensibles en el payload. Claims mínimos: userId y algún scope si hace falta.

    Middleware protector de rutas

    Intercepta y valida la cookie antes de permitir el acceso:

    // middleware/auth.js
    const jwt = require('jsonwebtoken');
    
    module.exports = (req, res, next) => {
      const token = req.cookies.authToken;
      if (!token) return res.status(401).json({ error: 'No autorizado' });
    
      try {
        req.user = jwt.verify(token, process.env.JWT_SECRET);
        next();
      } catch (e) {
        res.status(401).json({ error: 'Token inválido o expirado' });
      }
    };

    Adjunta req.user.userId para consultas posteriores.

    Logout: simple y efectivo

    En una arquitectura basada en cookies HttpOnly, cerrar sesión es instructivo: borrar la cookie en el navegador.

    // controllers/auth.js
    const logout = (req, res) => {
      res.clearCookie('authToken', {
        httpOnly: true,
        secure: process.env.NODE_ENV === 'production',
        sameSite: 'strict'
      });
      res.json({ success: true });
    };

    Si necesitas invalidación inmediata de tokens (por ejemplo, forzar logout de todos los dispositivos), añade una lista de revocación en Redis con claves expiradas o guarda un tokenVersion en el usuario y compáralo en el JWT.

    Comparativa: Cookies HttpOnly vs localStorage (resumen técnico)

    • Cookies HttpOnly: automáticas, resistentes a XSS, requieren SameSite y HTTPS.
    • localStorage: accesible por JS → vulnerable a XSS; menos recomendable para web.

    Para la mayoría de SPAs web, cookies HttpOnly + CSRF mitigations (SameSite/CSRF token cuando sea necesario) es la opción correcta.

    Consideraciones de producción (criterio senior)

    • Nunca expongas JWT_SECRET ni URIs en el repo; usa variables de entorno.
    • Usa HTTPS en todas partes; secure cookies dependen de ello.
    • Implementa rate limiting en /login (express-rate-limit).
    • Logging y alertas en intentos fallidos.
    • Considera refresh tokens almacenados en HttpOnly (o en un store) si necesitas sesiones largas. Documentación OWASP sobre autenticación: https://owasp.org.
    • Validación de entrada robusta (Joi o express-validator).

    Conclusión y siguiente paso

    Cree una API de inicio y cierre de sesión con Express.js (Node.js) usando JWT en cookies HttpOnly y bcrypt para contraseñas y habrás cubierto la base para una autenticación segura y escalable. Esto no es la cima: el siguiente paso es integrar refresh tokens seguros, rotación de tokens y estrategias de revocación (Redis/DB). Implementa lo básico bien y estarás listo para esas capas adicionales.

    FAQ

    ¿Por qué usar cookies HttpOnly en lugar de localStorage?

    Respuesta

    Cookies HttpOnly no son accesibles desde JavaScript, lo que reduce la superficie de ataque frente a XSS. localStorage es accesible por JS y por tanto vulnerable a XSS.

    ¿Qué duración debería tener el JWT?

    Respuesta

    Usa JWTs cortos (ej. 15–60 minutos) para access tokens. Para sesiones largas, combina con refresh tokens seguros y rotación de tokens.

    ¿Cómo implemento refresh tokens con cookies HttpOnly?

    Respuesta

    Almacena refresh tokens en cookies HttpOnly o en un store con expiración. Implementa rotación: emite un nuevo refresh token al usar uno válido y revoca el anterior.

    ¿Qué hacer si necesito invalidar tokens inmediatamente?

    Respuesta

    Para invalidación inmediata, usa una lista de revocación en Redis con claves expiradas o guarda un tokenVersion en el usuario y compáralo contra el JWT.

    ¿Por qué automatizar hashing en Mongoose?

    Respuesta

    Automatizar hashing evita errores humanos (olvidar hashear antes de guardar) y estandariza el coste. Mongoose pre(‘save’) es una forma práctica de hacerlo.

    ¿Qué medidas de seguridad adicionales son críticas en producción?

    Respuesta

    Variables de entorno seguras, HTTPS obligatorio, rate limiting en endpoints críticos, logging/alertas, validación de input y mecanismos de revocación para tokens son esenciales.