Tag: LangChain

  • Desplegar agentes LangChain en producción sin perder el estado

    Desplegar agentes LangChain en producción sin perder el estado

    En local funcionaba perfecto.

    El agente respondía, llamaba a sus herramientas, escribía token a token en la terminal. Lo metí en un contenedor y lo subí. A los pocos días empecé a ver el mismo patrón en los logs: conversaciones cortadas a mitad, y usuarios que volvían y encontraban un agente sin memoria de nada.

    No había ningún error en el código del agente. El agente estaba bien. Lo que estaba mal era todo lo que hay entre el agente y el usuario.

    Y es que desplegar agentes LangChain en producción no se parece a desplegar una API REST. Una API REST responde en 200 milisegundos y no recuerda nada. Un agente tarda treinta segundos, mantiene la conexión abierta todo ese rato, guarda estado entre turnos y llama a servicios externos que fallan. Cuatro propiedades que rompen, una por una, las suposiciones sobre las que está construida tu infraestructura.

    Si todavía estás decidiendo la forma del agente —grafo de estados o bucle— eso lo desarrollé en LangGraph TypeScript: cuándo un grafo gana al while loop. Este post empieza donde acaba aquel: ya tienes el grafo, ahora hay que sacarlo del portátil.

    Todo el código está escrito contra langchain 1.5 y @langchain/langgraph 1.4, con @langchain/langgraph-checkpoint-postgres 1.0. Es importante que mires las versiones: la API de creación de agentes y la de streaming cambiaron en LangChain 1, y casi todos los tutoriales que vas a encontrar están escritos contra la anterior.

    Última revisión: 31 de agosto de 2026. Si LangGraph publica una 2.x, el PostgresSaver es lo primero que hay que volver a comprobar.


    Los 3 fallos al desplegar agentes LangChain en producción

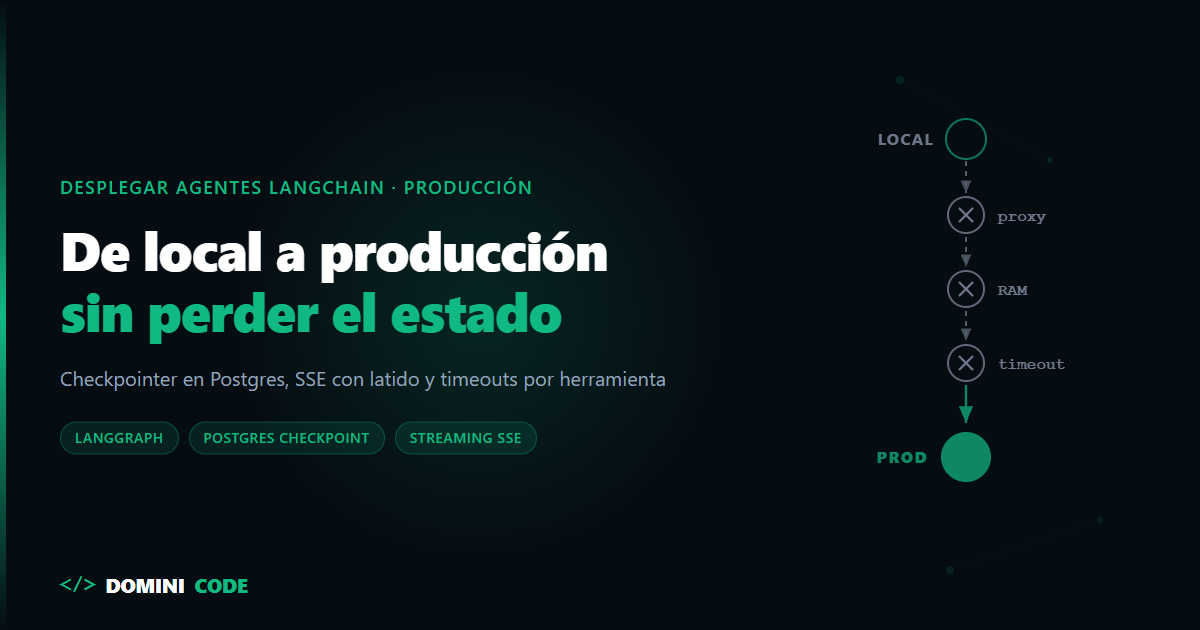
    Los tres fallos que rompen un agente en producción son la conexión que corta el proxy, el estado que vive en RAM y la herramienta sin timeout. No son los que parecen, y son los que me han costado tiempo de verdad:

    # Fallo Por qué pasa
    1 La conexión se corta a mitad de respuesta El proxy cierra la conexión por inactividad: mientras el modelo "piensa" no viajan bytes
    2 El agente pierde la memoria El historial vivía en RAM y el contenedor se reinició o escaló a otra instancia
    3 Una herramienta se cuelga y arrastra al proceso Sin timeout ni cancelación, la petición queda colgada y la conexión SSE ocupando memoria

    Conviene desmontar un mito antes de seguir, porque lo he leído muchas veces: el bucle del agente no bloquea el event loop. El trabajo de un agente es esperar respuestas HTTP del modelo y de sus herramientas, así que es I/O, y Node o Bun siguen atendiendo peticiones mientras tanto. Lo que sí se te agota es otra cosa. La memoria que ocupa cada conexión abierta, el límite de concurrencia de tu plataforma, y los sockets que nadie cerró porque el cliente se fue sin avisar.


    El estado: sácalo de la RAM el primer día

    El estado de un agente LangGraph no puede vivir en una variable del proceso: en cuanto el contenedor se reinicia o escala, la conversación desaparece. Este es el arreglo con más retorno y el más barato de aplicar.

    Mientras el estado vive en memoria, tu agente recuerda hasta el próximo despliegue. Y como los reinicios no los decides tú —los decide el autoescalado, un health check o un deploy—, no es un riesgo teórico: pasa.

    La solución en LangGraph es un checkpointer, que guarda el estado del grafo después de cada paso en una base de datos externa:

    import { PostgresSaver } from "@langchain/langgraph-checkpoint-postgres";
    
    const checkpointer = PostgresSaver.fromConnString(process.env.DATABASE_URL!);
    
    // Solo la primera vez: crea las tablas que necesita el checkpointer.
    await checkpointer.setup();
    

    Ese setup() va en el paso de migraciones de tu despliegue, no en el arranque de cada instancia. Si lo dejas en el boot y levantas diez réplicas, tienes diez procesos creando las mismas tablas a la vez.

    A partir de ahí, cada conversación se identifica con un thread_id. El agente no "recuerda" nada en memoria: al recibir un turno nuevo, lee el estado de ese hilo desde Postgres, avanza y vuelve a escribirlo.

    Eso cambia una propiedad importante de tu servicio: pasa a ser reemplazable. Puedes matar el contenedor, desplegar una versión nueva o levantar diez réplicas detrás de un balanceador, y cualquiera de ellas puede continuar cualquier conversación, porque el estado no está en ninguna de ellas.


    El servidor: streaming que sobrevive al proxy

    El segundo problema es la conexión. Un agente tarda decenas de segundos en completar una respuesta, y durante buena parte de ese tiempo no manda ni un byte, porque está esperando al modelo o ejecutando una herramienta.

    Para un proxy —Nginx, Cloudflare, el balanceador de tu PaaS— una conexión abierta que no transmite nada es una conexión muerta, y la cierra.

    Así que hay tres cosas que hacer, y las tres se olvidan:

    • Enviar las cabeceras SSE inmediatamente, para que el proxy sepa que esto es un stream y no espere a tener el cuerpo entero.
    • Mandar un latido cada pocos segundos aunque no haya nada que decir, para que la conexión nunca esté inactiva.
    • Abortar el trabajo si el cliente se va, o seguirás pagando tokens de una respuesta que ya no lee nadie.
    import express from "express";
    import { createAgent } from "langchain";
    
    // Necesita @langchain/anthropic instalado y ANTHROPIC_API_KEY en el entorno.
    const agent = createAgent({
      model: "anthropic:claude-sonnet-5",
      tools: [buscarPedido], // la definimos más abajo
      checkpointer,          // el PostgresSaver de arriba
    });
    
    const app = express();
    app.use(express.json());
    
    app.post("/api/agent/chat", async (req, res) => {
      // El thread_id se valida contra el usuario autenticado: si no,
      // cualquiera puede leer la conversación de cualquier otro.
      const { threadId, message } = req.body;
    
      res.setHeader("Content-Type", "text/event-stream");
      res.setHeader("Cache-Control", "no-cache, no-transform");
      res.setHeader("Connection", "keep-alive");
      res.setHeader("X-Accel-Buffering", "no"); // que Nginx no acumule el stream
      res.flushHeaders();                       // sin esto, el proxy espera
    
      // Latido: mantiene viva la conexión frente al idle timeout del proxy.
      const heartbeat = setInterval(() => {
        if (res.writableEnded || res.destroyed) return;
        res.write(": ping\n\n");
      }, 15_000);
    
      // Si el cliente cierra la pestaña, se cancela el trabajo del agente.
      const controller = new AbortController();
      res.on("close", () => {
        clearInterval(heartbeat);
        controller.abort();
      });
    
      try {
        const stream = await agent.streamEvents(
          { messages: [{ role: "user", content: message }] },
          {
            version: "v3",
            configurable: { thread_id: threadId },
            signal: controller.signal,
          },
        );
    
        await Promise.all([
          (async () => {
            for await (const m of stream.messages) {
              for await (const token of m.text) {
                res.write(`data: ${JSON.stringify({ type: "token", text: token })}\n\n`);
              }
            }
          })(),
          (async () => {
            for await (const call of stream.toolCalls) {
              res.write(`data: ${JSON.stringify({ type: "tool", name: call.name })}\n\n`);
            }
          })(),
        ]);
    
        res.write("data: [DONE]\n\n");
      } catch (err) {
        if (!controller.signal.aborted) {
          res.write(`data: ${JSON.stringify({ type: "error" })}\n\n`);
        }
      } finally {
        clearInterval(heartbeat);
        res.end();
      }
    });
    
    // Cloud Run y casi cualquier PaaS inyectan PORT: no lo fijes a mano.
    app.listen(process.env.PORT ?? 3000);
    

    Dos detalles que merecen su párrafo.

    El version: "v3". Es la API de streaming con proyecciones tipadas, y aparece en langchain a partir de la 1.4.0. En vez de recibir un chorro plano de eventos y filtrar por nombre, iteras stream.messages para los tokens y stream.toolCalls para las herramientas, cada uno por su lado. Si copias un tutorial que usa version: "v2" y compara event.event === "on_chat_model_stream", estás escribiendo contra la API anterior.

    Un aviso que no vas a encontrar en esos tutoriales: LangChain la marca como experimental en su propia definición de tipos —"This v3 stream is experimental and its API may change in future releases"—. La uso igualmente porque la alternativa envejece peor, pero fija la versión en tu package.json y no la des por estable.

    El signal. RunnableConfig acepta un AbortSignal, y es lo que convierte el res.on("close") en una cancelación real en lugar de un simple return. Sin él, el cliente se va pero tu servidor sigue generando tokens contra la API del modelo hasta el final.

    Si vienes del stack de Vercel, el mismo problema con otras piezas lo resolví en streaming de respuestas de IA con NestJS y el Vercel AI SDK.


    Las herramientas: donde se cuelga todo

    El fallo que más veces he tenido que diagnosticar en producción no está en el modelo ni en el grafo. Está en una herramienta que llama a una API de terceros que ese día tarda cuarenta segundos en responder.

    Sin timeout propio, esa herramienta se lleva por delante la petición entera. El usuario ve un cursor parpadeando, la conexión sigue abierta consumiendo memoria, y tú no sabes en qué paso se quedó.

    La regla es simple: toda herramienta que salga a la red lleva su propio timeout, más corto que el de la petición completa, y devuelve un texto en lugar de reventar. Ésta es la buscarPedido que usa el agente de arriba:

    import { tool } from "langchain";
    import * as z from "zod";
    
    const buscarPedido = tool(
      async ({ id }) => {
        try {
          const res = await fetch(`${API}/pedidos/${id}`, {
            signal: AbortSignal.timeout(8_000), // esta tool falla en 8s o no falla
          });
          return JSON.stringify(await res.json());
        } catch {
          // El agente lee esto y decide: reintentar o admitir que no puede.
          return "El servicio de pedidos no respondió en 8 segundos.";
        }
      },
      {
        name: "buscar_pedido",
        description: "Busca un pedido por su identificador",
        schema: z.object({ id: z.string() }),
      },
    );
    

    Y que falle está bien. Un error controlado vuelve al agente como resultado de la herramienta, el modelo lo lee y puede reintentar o decir que no ha podido. Una herramienta colgada, en cambio, no le da ninguna información con la que trabajar: el agente se queda esperando y el usuario también.

    Si además quieres que la herramienta muera cuando el cliente cierra la pestaña, combina su propio timeout con el signal que le llega en el config: el AbortSignal.timeout por sí solo no escucha esa cancelación.

    Ese diseño de herramientas —contrato claro, fallo rápido y un error que el modelo pueda leer— es el que trabajo paso a paso en el curso Construye con IA con Claude Code.

    Cómo evitar que ese reintento se convierta en un bucle sin fin lo desarrollé en Agentic Loop en TypeScript. Y cómo probar todo esto en CI antes de que llegue a producción, en test harness para agentes de IA.


    Qué pasa de verdad cuando el contenedor se reinicia

    Aquí es donde casi todas las guías te dicen una verdad a medias. "Con un checkpointer no pierdes el estado" es cierto, pero conviene saber exactamente qué se salva y qué no.

    Si el contenedor muere mientras un agente está a mitad de una tarea:

    • Se conserva todo lo que ya estaba confirmado en el último checkpoint: los turnos anteriores, los resultados de las herramientas que ya terminaron y el estado del grafo hasta ese punto.
    • Se pierde el paso en vuelo. Los tokens que se estaban generando en ese momento no están en ninguna parte, y la conexión SSE del cliente se cae con el proceso.
    • No se reanuda solo. No hay nadie que retome la tarea al arrancar el contenedor nuevo. Y ojo con lo que significa "volver a llamar". El checkpoint se escribe por paso del grafo. Si el proceso murió justo después de que el modelo pidiera una herramienta, el estado guardado termina en un mensaje del asistente con tool_calls y ninguna respuesta. Mandar ahí un mensaje nuevo del usuario produce un 400 del proveedor, porque todo tool_use exige su tool_result. Antes de aceptar el turno siguiente hay que cerrar el paso pendiente de ese hilo.

    Esto tiene una consecuencia de diseño que hay que asumir pronto: el thread_id tiene que sobrevivir al navegador y estar atado al usuario. Que lo genere el cliente está bien; que el servidor se lo crea sin comprobar contra quién ha iniciado sesión, no. Y si el identificador solo vive en la memoria del navegador, un refresco lo pierde y la conversación se queda huérfana en la base de datos: existe, pero nadie sabe pedirla.

    Y si la tarea es larga de verdad —un informe que tarda diez minutos, un procesamiento por lotes—, el patrón correcto no es este. Es aceptar la petición, devolver un identificador y ejecutar el trabajo en una cola aparte, con el cliente consultando el progreso. Un agente detrás de una petición HTTP tiene sentido para conversación, no para trabajo de fondo.


    Empaquetar y desplegar agentes LangChain en producción

    Empaquetar un agente es un Dockerfile normal con un detalle que rompe builds: desde Bun 1.2 el lockfile por defecto es bun.lock, no bun.lockb.

    FROM oven/bun:1-alpine
    WORKDIR /app
    
    # Desde Bun 1.2 el lockfile por defecto es bun.lock (texto), no bun.lockb.
    COPY package.json bun.lock ./
    RUN bun install --frozen-lockfile --production
    
    COPY . .
    
    ENV NODE_ENV=production
    USER bun
    CMD ["bun", "run", "src/server.ts"]
    

    Si copias un Dockerfile de hace un par de años vas a ver COPY package.json bun.lockb ./, y con un proyecto actual esa línea falla porque ese archivo ya no existe.

    Y un .dockerignore al lado, que es el otro detalle que rompe builds:

    node_modules
    .git
    .env*
    

    Sin él, el COPY . . te mete el node_modules de tu portátil encima del que acabas de instalar dentro del contenedor, con binarios compilados para otra plataforma.

    Sobre dónde desplegarlo, lo único que importa de verdad es cuánto tiempo te dejan tener una conexión abierta:

    Plataforma Timeout por defecto Máximo Qué tienes que tocar
    Cloud Run 300 s (5 min) 3.600 s (60 min) Subir el timeout y fijar una instancia mínima para no pagar arranque en frío por conversación
    Render · Railway · Fly Idle timeout propio, más corto No es ilimitado El latido SSE: sin él la conexión cuenta como inactiva y la cortan

    Los números de Cloud Run salen de su documentación de timeouts. Para un agente conversacional con streaming, el valor de fábrica se queda corto en cuanto una herramienta se ralentiza.

    Y aquí hay una distinción que cuesta un incidente aprender: el latido no te salva del timeout de Cloud Run. El latido derrota los timeouts de inactividad, que es lo que aplican los PaaS. El de Cloud Run es duración máxima de la petición, y corta igual aunque estés emitiendo tokens sin parar. En todos los que he probado, además, ninguno mantiene una conexión abierta indefinidamente.

    Un agente en producción además habla con servicios externos, y ahí el problema deja de ser el deploy y pasa a ser el transporte y la autenticación. Eso lo cubrí en MCP en producción: lo que se rompe cuando tu server sale del portátil.


    No despliegues a ciegas

    En un backend clásico te basta con los errores HTTP. En un agente necesitas ver el árbol de decisiones: qué prompt se envió, qué herramienta se ejecutó, cuánto tardó y qué costó. Sin eso, "va lento" y "responde mal" son incidencias que no puedes investigar.

    No lo desarrollo aquí porque ya tiene su sitio. El planteamiento está en cómo monitorear agentes de IA en producción, la implementación en Langfuse paso a paso, y la parte que te va a llegar en la factura, en medir el consumo de tokens.


    Checklist antes de pulsar deploy

    1. El estado, fuera del proceso. Checkpointer con setup() ejecutado y thread_id generado y persistido por el cliente.
    2. El stream, blindado. flushHeaders(), latido cada 15 segundos y AbortSignal conectado al cierre de la conexión.
    3. Las herramientas, con timeout propio. Más corto que el de la petición, y que fallen con un error que el agente pueda leer.
    4. El timeout de la plataforma, subido. El de fábrica está pensado para APIs que responden rápido, no para agentes.
    5. Trazas desde el primer despliegue. No desde el primer incidente.

    Las arquitecturas de agentes que tengo funcionando, con sus fallos y lo que costó arreglarlos, las comparto cada semana en Dominicode Labs.

    Que un agente funcione en tu portátil es un experimento. Que sobreviva a un reinicio es ingeniería.


    Preguntas frecuentes

    ¿Cómo se despliega un agente LangChain en producción?

    Desplegar agentes LangChain en producción son cuatro decisiones, no una. Primera: sacar el estado del proceso con un checkpointer persistente —PostgresSaver sobre Postgres— para que cualquier réplica pueda continuar cualquier conversación. Segunda: servir la respuesta por SSE con flushHeaders(), un latido cada 15 segundos y un AbortSignal atado al cierre del cliente, para que ningún proxy corte el stream. Tercera: poner timeout propio a cada herramienta que salga a la red, más corto que el de la petición. Y cuarta: subir el timeout de la plataforma, que de fábrica está pensado para APIs que responden en milisegundos. El contenedor en sí es lo de menos.

    ¿Postgres o Redis para el checkpointer?

    Postgres por defecto. El estado de una conversación es un dato que quieres conservar, consultar y auditar más tarde, y Postgres te lo da sin trabajo extra. Redis tiene sentido cuando la latencia de lectura del estado empieza a notarse de verdad o cuando el historial es efímero y no te importa perderlo. Empezar por Redis "porque es más rápido" suele salir caro el día que necesitas saber qué le contestó el agente a un cliente hace tres semanas.

    Si el contenedor se reinicia a mitad de una tarea, ¿se reanuda sola?

    No. Se conserva el estado hasta el último checkpoint confirmado, pero el paso que estaba en vuelo se pierde y nadie retoma la tarea por su cuenta. La reanudación la dispara el cliente cuando vuelve a llamar con el mismo thread_id, siempre que el paso pendiente se cierre antes de mandar un mensaje nuevo. Si el hilo se quedó con una petición de herramienta sin responder, el proveedor devuelve un 400. Y si necesitas que el trabajo termine sí o sí aunque nadie esté mirando, eso no va en una petición HTTP: va en una cola.

    ¿SSE o WebSocket para un agente?

    SSE en la mayoría de casos. La comunicación de un agente conversacional es casi toda en un sentido —el servidor manda tokens— y SSE va sobre HTTP normal, así que atraviesa proxies y balanceadores sin configuración especial. La reconexión automática te la da EventSource, pero solo habla GET: con el endpoint POST de arriba consumes el stream con fetch y ReadableStream, y la reconexión la escribes tú. WebSocket compensa cuando de verdad necesitas un canal bidireccional con mucho tráfico del cliente hacia el servidor, y a cambio te complica el despliegue.

    ¿Cuánto timeout pongo en Cloud Run?

    El valor de fábrica son 5 minutos y el máximo son 60. Para un agente conversacional, subirlo a 10-15 minutos suele ser suficiente: cubre las respuestas largas y las herramientas lentas sin dejar conexiones zombis eternas. Ponerlo al máximo no es gratis, porque una conexión colgada ocupa una instancia durante todo ese tiempo.

    ¿Esto vale con otro modelo que no sea Claude?

    Sí. La arquitectura —checkpointer externo, streaming con latido, cancelación y timeouts por herramienta— es independiente del proveedor. Lo único que cambia es el identificador del modelo que le pasas a createAgent y el paquete de integración correspondiente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Certificación LangChain: Guía del Examen y Preparación

    Certificación LangChain: Guía del Examen y Preparación

    La semana pasada un desarrollador me preguntó si valía la pena pagar por la certificación oficial de LangChain para conseguir trabajo como AI Engineer.

    Mi respuesta fue directa: el badge digital en LinkedIn te abre la puerta de la entrevista con recursos humanos. Pero en la prueba técnica te van a pedir que depures un grafo cíclico en LangGraph o que arregles un desbordamiento de tokens en producción.

    Si intentas preparar el examen memorizando tutoriales de hace un año, vas a suspender.

    El ecosistema de LangChain ha cambiado de raíz: las cadenas monolíticas (LLMChain, ConversationalRetrievalChain) están formalmente obsoletas. La certificación oficial se llama LangChain Certified Agent Engineer (LCAE) y evalúa el ciclo de vida completo de un agente: construirlo con LCEL y LangGraph, probarlo y monitorizarlo con LangSmith, y desplegarlo en producción.

    Aquí tienes el desglose exacto de lo que entra, los errores que más suspensos provocan y la ruta de estudio para aprobar sin rodeos.


    Qué evalúa LangChain Certified Agent Engineer

    La certificación —oficial de LangChain Academy, no un curso con diploma de cortesía— valida que eres capaz de construir, probar, desplegar y monitorizar agentes de producción. Se organiza en cuatro dominios de peso idéntico, el ciclo de vida completo del agente (lo que LangChain llama ADLC, Agent Development Life Cycle):

            [ LANGCHAIN CERTIFIED AGENT ENGINEER ]
                            │
       ┌──────────┬─────────┼─────────┬──────────┐
       ▼          ▼         ▼         ▼
    Building   Testing   Deploying  Monitoring
     Agents     Agents     Agents     Agents
      25%        25%        25%        25%
    (LCEL,    (LangSmith  (LangGraph  (LangSmith
    LangGraph,  evals,     Platform,   tracing,
    RAG, Tool   datasets)  runtime,    coste,
    Calling)               versionado) latencia)
    

    Formato del examen:

    • Tipo de preguntas: 40 preguntas de opción múltiple, entregadas online con supervisión (proctored).
    • Duración: 120 minutos (~135 minutos contando el tiempo de la plataforma).
    • Puntuación para aprobar: 28 de 40 (70%).
    • Precio: $99 USD.
    • Validez: 24 meses.
    • Idioma: Inglés.
    • Requisito recomendado (no obligatorio): completar los cinco cursos gratuitos fundamentales de LangChain Academy antes de presentarte.

    Los 4 dominios del examen (y las técnicas que necesitas dominar)

    Para aprobar LangChain Certified Agent Engineer, tu preparación debe cubrir los cuatro dominios oficiales, con el mismo peso cada uno:

    Dominio 1: Building Agents (25%)

    Es donde más código nuevo vas a tocar, aunque en el examen pese lo mismo que los otros tres. Reúne LCEL, LangGraph, RAG y Tool Calling.

    LCEL (LangChain Expression Language) y Runnables. Columna vertebral de todo el código moderno de LangChain. Domina la composición con el operador pipe (|) y la interfaz Runnable:

    from langchain_core.runnables import RunnablePassthrough, RunnableParallel
    from langchain_core.prompts import ChatPromptTemplate
    from langchain_core.output_parsers import StrOutputParser
    
    # Composición declarativa con LCEL
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | model
        | StrOutputParser()
    )
    

    Conceptos clave: métodos estándar (.invoke(), .stream(), .batch(), .ainvoke(), .astream_events()), primitivas auxiliares (RunnableLambda, RunnableParallel, .bind(), .with_fallbacks(), .with_retry()) y streaming asíncrono granular con astream_events(version="v2").

    LangGraph: grafos de estado y agentes cíclicos. LangChain dejó atrás el concepto de "agentes lineales". Hoy los flujos complejos se modelan como grafos dirigidos con estado — si el concepto de grafo te resulta nuevo, cubrimos la base en qué es el graph engineering:

    from langgraph.graph import StateGraph, END
    from typing import TypedDict, Annotated
    import operator
    
    class AgentState(TypedDict):
        messages: Annotated[list, operator.add]
        next_step: str
    
    # Construcción del grafo
    workflow = StateGraph(AgentState)
    workflow.add_node("agent", call_model)
    workflow.add_node("tools", execute_tools)
    
    workflow.add_conditional_edges(
        "agent",
        should_continue,
        {"continue": "tools", "end": END}
    )
    

    Conceptos clave: esquemas de estado con TypedDict y reducers (operator.add), nodos (add_node), aristas fijas (add_edge) y condicionales (add_conditional_edges), persistencia con MemorySaver / SqliteSaver (Checkpointers), y control Human-in-the-loop con interrupt().

    RAG avanzado (Retrieval-Augmented Generation). No basta con saber qué es un VectorStore. Entran estrategias de Chunking (Recursive Character Text Splitter vs Semantic Chunking), búsqueda híbrida (BM25 léxico + Dense Embeddings vectorial vía Reciprocal Rank Fusion) y compresión contextual/Reranking (Cohere Rerank u otros).

    Tool Calling y validación de schemas. Integración de herramientas tipadas con @tool de langchain_core.tools, validación de argumentos con Pydantic (Python) o Zod (TypeScript), y manejo de excepciones con handle_tool_error.

    Dominio 2: Testing Agents (25%)

    Aquí LangSmith deja de ser una herramienta de debugging manual y se convierte en infraestructura de evaluación: creación de datasets de prueba, evaluadores automáticos (LLM-as-a-judge) y comparación de versiones de un agente contra un mismo dataset antes de promoverlo a producción.

    Dominio 3: Deploying Agents (25%)

    El dominio que más se salta la gente porque no hay un notebook bonito que enseñe esto. Cubre llevar el grafo de LangGraph a un runtime de producción (LangGraph Platform u otro hosting propio), gestionar configuración por entorno (variables, secretos, versión del grafo desplegado) y sustituir el checkpointer de desarrollo (SqliteSaver) por uno apto para producción con concurrencia real (por ejemplo, respaldado en Postgres).

    Dominio 4: Monitoring Agents (25%)

    LangSmith otra vez, pero mirando hacia atrás en vez de hacia adelante: trazas de ejecución en producción, latencia por nodo, consumo y coste de tokens, y detección de tendencias de calidad a partir de esas trazas. Activas el tracing con la variable de entorno LANGCHAIN_TRACING_V2=true. Si no tienes claro en qué parte del pipeline se te va el presupuesto, empieza por medir el consumo de tokens de un agente.


    Los 4 errores que hacen suspender a los desarrolladores

    1. Estudiar código de LangChain v0.0.x / v0.1.x: Si en tus prácticas ves from langchain.chains import LLMChain o initialize_agent, estás usando sintaxis deprecada. El examen exige langchain_core y langgraph.
    2. Ignorar el flujo de Streaming: Confundir .stream() con .astream_events() o no saber cómo extraer tokens en tiempo real dentro de un grafo.
    3. No practicar con Checkpointers: Suspender preguntas sobre cómo recuperar el estado anterior de un hilo (thread_id) en LangGraph.
    4. Estudiar solo "Building" e ignorar Deploying y Monitoring: Entre los dos suman la mitad del examen, y son los dominios donde menos contenido gratuito hay. Si tu preparación se queda en notebooks locales con SQLite, vas justo de la mitad de las preguntas.

    Esta disciplina de no depender de tutoriales viejos y estructurar el software antes de escribir código es lo que trabajamos a fondo en el curso Construye con IA: De la Idea al Producto con Claude y Specs, donde aprendes a gobernar agentes con especificaciones formales.


    Plan de estudio de 4 semanas

    Si le dedicas entre 6 y 8 horas semanales, este es el calendario recomendado:

    Semana Dominio Foco de estudio Práctica obligatoria
    Semana 1 Building Agents (I) LCEL y Runnables Construir 3 pipelines usando RunnableParallel, .bind() y .with_fallbacks()
    Semana 2 Building Agents (II) LangGraph, RAG y Tool Calling Montar un agente con ciclo de reflexión, Hybrid Search con Reranking y tool calling
    Semana 3 Testing + Deploying Evals con LangSmith y despliegue en LangGraph Platform Crear un dataset de evaluación, correr LLM-as-a-judge y desplegar el agente con un checkpointer de producción
    Semana 4 Monitoring + Simulacros Trazas, coste y latencia en LangSmith Configurar tracing en producción y hacer tests tipo examen (40 preguntas, 120 minutos)

    ¿Vale la pena obtener la certificación?

    Si eres freelance, consultor técnico o trabajas en una agencia que vende proyectos de IA a clientes corporativos, sí. En licitaciones y contratos B2B, las certificaciones oficiales son un filtro de confianza rápido.

    Si eres un desarrollador de producto en una startup, la certificación es secundaria: lo que te dará el puesto es tu capacidad para demostrar proyectos en producción con arquitecturas limpias, costes controlados y cero alucinaciones críticas.

    Para ver casos de estudio reales de agentes y arquitecturas con grafos en producción, en Dominicode Labs documentamos experimentos y benchmarks semanales con el ecosistema de IA.


    Preguntas frecuentes

    ¿En qué idioma se presenta el examen de LangChain Certified Agent Engineer?

    El examen se entrega íntegramente en inglés. Los fragmentos de código de las preguntas son mayoritariamente Python, que es donde LangChain y LangGraph tienen más ejemplos y documentación oficial.

    ¿Es necesario saber LangGraph para aprobar la certificación?

    Sí. LangGraph es hoy el componente central del examen para todo lo relativo a agentes, bucles de decisión, memoria conversacional y workflows multi-agente.

    ¿Cuánto tiempo dura la validez del certificado?

    24 meses (2 años) desde la fecha en que apruebas. Pasado ese plazo hay que recertificar, algo razonable dada la velocidad a la que cambian LangChain y LangGraph.

    ¿Cuánto cuesta la certificación LangChain Certified Agent Engineer?

    $99 USD por intento. El examen tiene 40 preguntas de opción múltiple, dura 120 minutos y necesitas acertar 28 de 40 (70%) para aprobar.

    ¿Dónde puedo practicar antes de presentarme?

    La mejor preparación es la documentación oficial de LangChain (v0.3+), los tutoriales de LangGraph Academy y la creación de trazas reales en LangSmith.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Observabilidad en LLMs: traza, mide y depura tus agentes de IA

    Observabilidad en LLMs: traza, mide y depura tus agentes de IA

    El equipo había estado tres semanas construyendo un agente de soporte técnico. Funcionaba bien en local. Lo lanzaron a producción un lunes por la mañana.

    El viernes tenían una factura de $1.200 en tokens, tres tickets de clientes con respuestas completamente inventadas y ninguna pista de en qué paso del flujo había empezado a fallar todo.

    El agente había estado corriendo. Respondiendo. Consumiendo. Pero nadie podía ver qué estaba pasando dentro.

    Ese es el problema que resuelve la observabilidad en LLMs — el conjunto de técnicas que permite registrar, medir y analizar cada paso de un agente de IA en producción: los prompts enviados, las herramientas invocadas, los tokens consumidos y los errores producidos. Si estás construyendo cualquier cosa con IA en producción, necesitas entenderla antes de que te pase lo mismo.


    El problema real: los LLMs son cajas negras que facturan

    Con una API REST tradicional tienes un contrato claro: envías una petición, recibes una respuesta, mides el tiempo, logueas el error. La traza es determinista.

    Con un LLM, el contrato se rompe. Puedes enviar el mismo prompt dos veces y recibir respuestas distintas. Un agente puede invocar herramientas en un orden diferente al esperado. El modelo puede alucinarse con un dato en el paso 3 de 7 y tú solo ves el resultado final — correcto en formato, incorrecto en contenido.

    Sin observabilidad, estás volando a ciegas. Y en producción, volar a ciegas con un LLM significa costos impredecibles, degradación silenciosa de calidad y bugs que no aparecen en ningún test.


    Los tres pilares de la observabilidad en LLMs

    La observabilidad clásica tiene tres dimensiones. En el mundo de los LLMs, cada una significa algo distinto.

    Trazas (Traces)

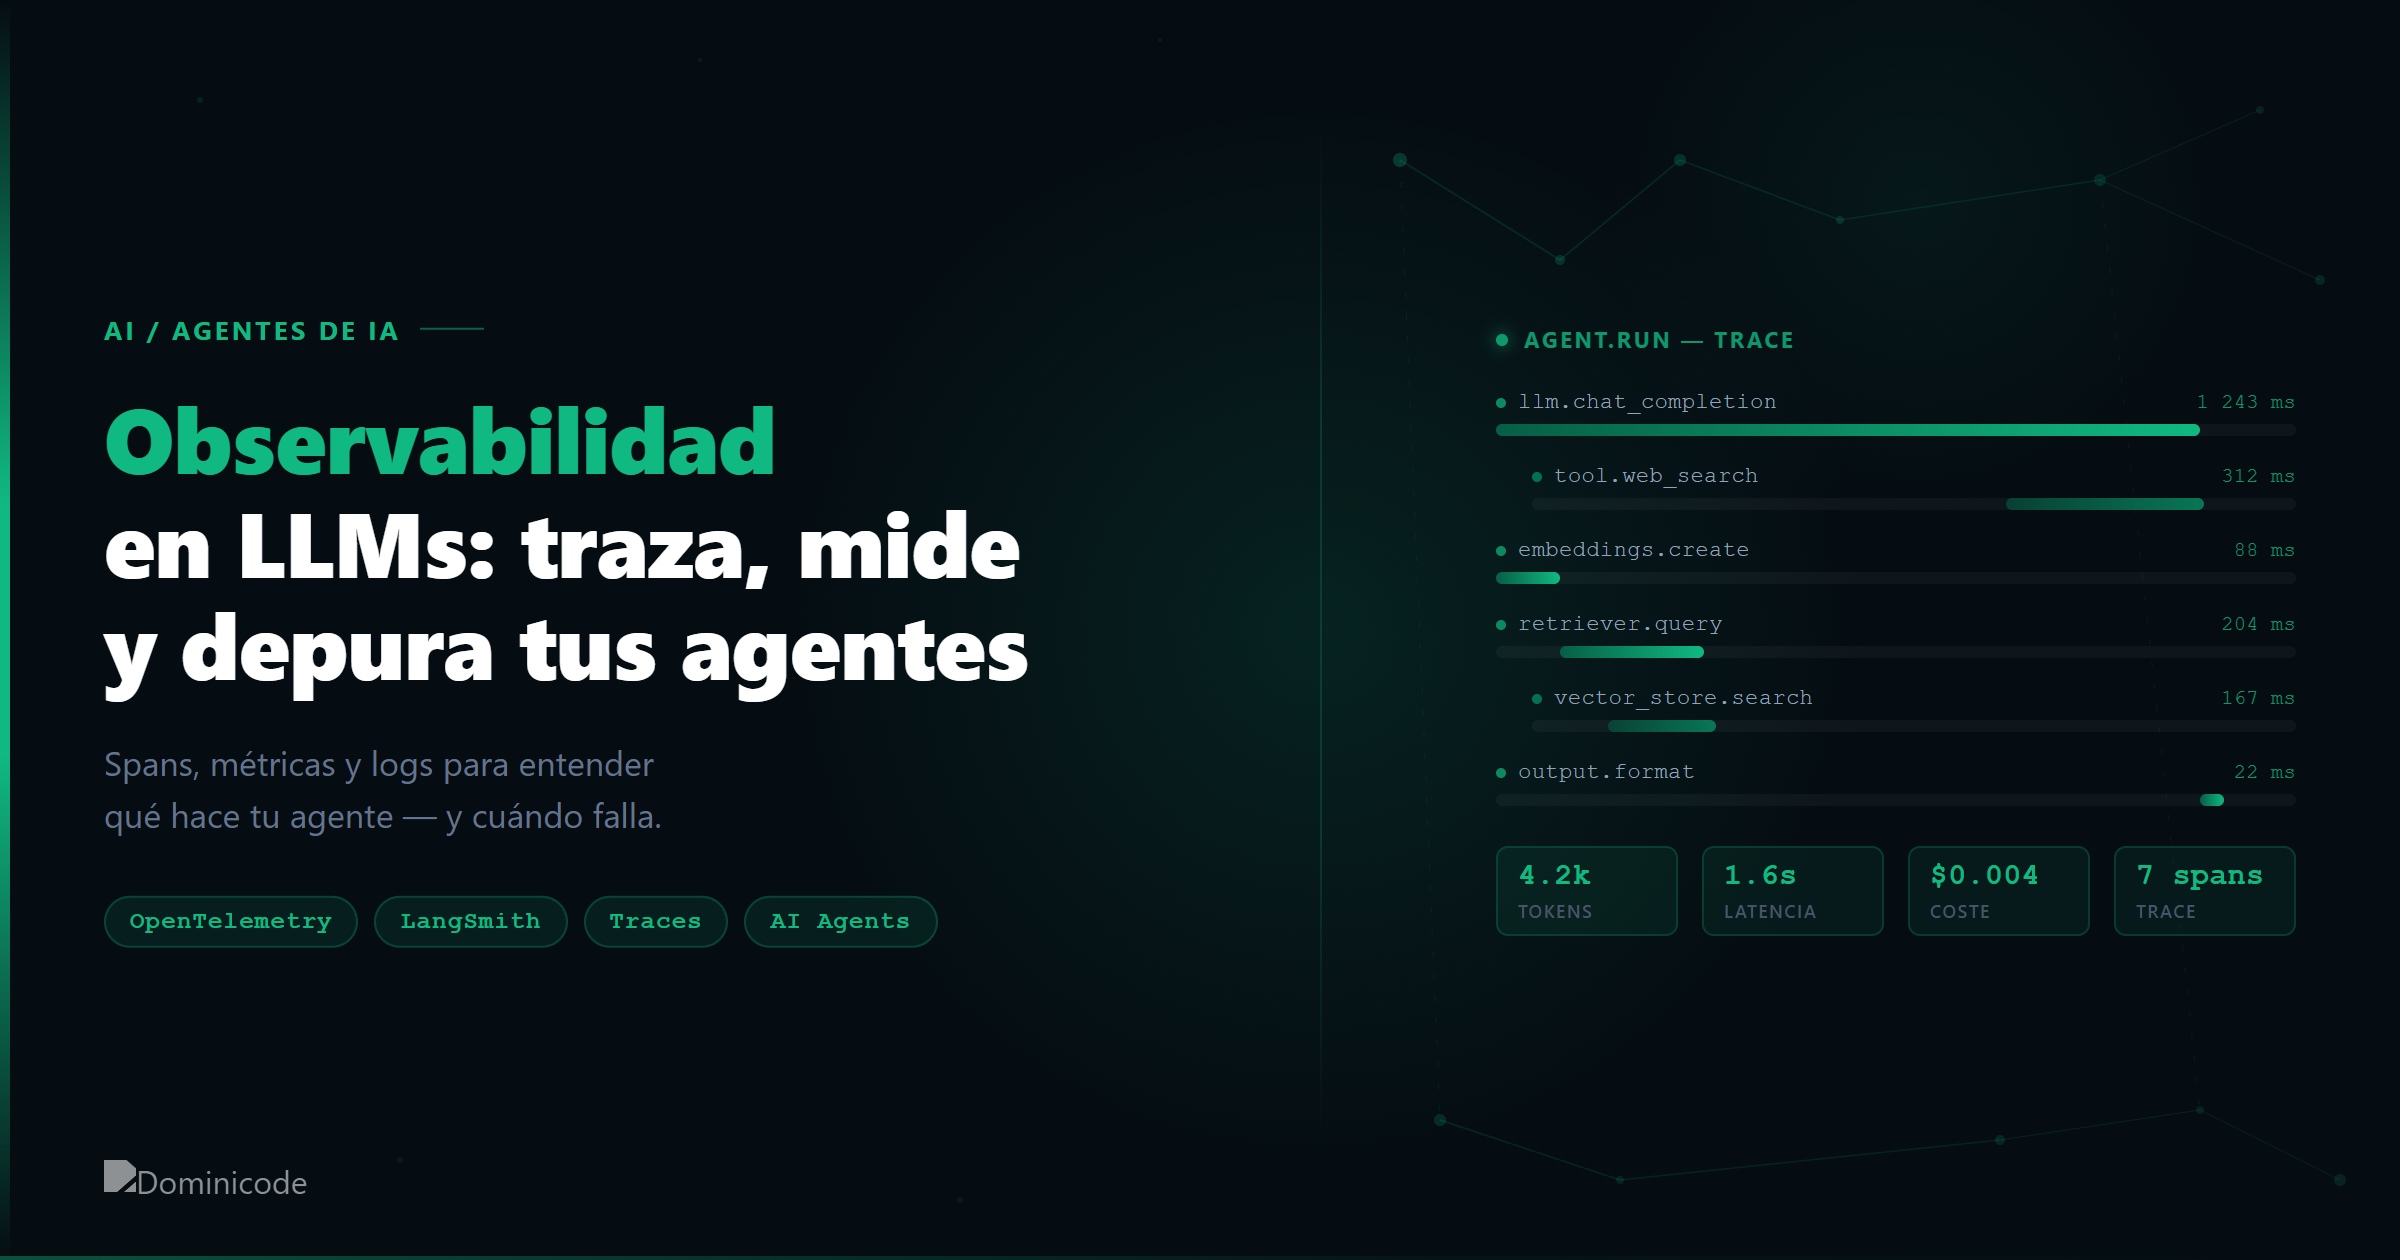
    Una traza registra el camino completo de una ejecución: qué prompt se envió, qué herramientas se llamaron, en qué orden, con qué inputs y qué outputs. En un agente con múltiples pasos, una traza te muestra el árbol completo de decisiones — no solo el resultado final.

    Es la diferencia entre saber que tu agente “falló” y saber exactamente en qué llamada a qué herramienta empezó a descarrilarse.

    Métricas

    Latencia por llamada, costo en tokens (input + output), tasa de éxito de herramientas, número de reintentos. Estas métricas agregadas te dicen si tu sistema está degradándose con el tiempo o si hay un prompt específico que consume diez veces más tokens que los demás.

    Logs estructurados

    No los logs de consola que escribes para depurar en local. Logs que capturen el contexto completo de cada ejecución: qué usuario lanzó la petición, qué versión del prompt se usó, qué modelo, qué temperatura. Logs que puedas consultar después cuando alguien reporte un comportamiento extraño hace 48 horas.


    Herramientas de observabilidad LLM en 2026

    Cinco herramientas que cualquier developer que construye con IA debería conocer:

    Herramienta Tipo Self-hosted Stack ideal Plan gratuito
    Langfuse SDK + plataforma ✅ Sí Cualquier API 50k obs/mes
    LangSmith Plataforma ❌ No LangChain Sí (limitado)
    Helicone Proxy ❌ No Multi-proveedor Sí
    Arize Phoenix Análisis offline ✅ Sí Evaluación por lotes Open source
    OpenTelemetry GenAI Estándar ✅ Sí Stacks OTEL existentes Open source

    Langfuse — El estándar open source. Puedes autohospedarlo o usar su cloud. Tiene SDK para TypeScript, Python e integración nativa con LangChain, Vercel AI SDK y llamadas directas a la API de Anthropic u OpenAI. Es la opción que recomiendo si quieres control total sobre tus datos.

    LangSmith — El producto de LangChain. Excelente si ya usas LangChain en tu stack, pero te ata al ecosistema. Para proyectos con llamadas directas a la API, Langfuse gana en flexibilidad.

    Helicone — Proxy que se pone delante de cualquier llamada a la mayoría de proveedores LLM (OpenAI, Anthropic, Azure, LiteLLM y otros). Configuración en dos minutos, observabilidad inmediata. Ideal para proyectos donde no puedes tocar el código de integración o quieres monitoreo rápido sin instrumentación.

    Arize Phoenix — Enfocado en evaluación y análisis offline. Útil cuando quieres analizar lotes de ejecuciones para detectar problemas de calidad sistemáticos, no solo monitoreo en tiempo real.

    Semantic conventions for generative AI systems (OTel GenAI) — El estándar OTEL para IA lleva trazas de LLMs al stack de observabilidad que ya tienes (Grafana, Datadog, Honeycomb). Si tu empresa ya tiene infraestructura OTEL, esta es la forma de integrar los LLMs sin añadir otra herramienta.


    Implementación real con TypeScript y Langfuse

    Suficiente teoría. Esto es cómo lo implementas en un proyecto TypeScript.

    Primero, instala el SDK (versión actual: langfuse@3.x):

    npm install langfuse
    

    Inicializa el cliente una sola vez en tu aplicación — en un módulo singleton si usas NestJS, en un archivo de configuración si es un script:

    import Langfuse from "langfuse";
    
    export const langfuse = new Langfuse({
      publicKey: process.env.LANGFUSE_PUBLIC_KEY!,
      secretKey: process.env.LANGFUSE_SECRET_KEY!,
      baseUrl: "https://cloud.langfuse.com", // o tu instancia autohospedada
    });
    

    Ahora instrumenta una llamada a Claude. El patrón es siempre el mismo: creas una traza, creas una generación dentro de esa traza, ejecutas la llamada y registras el resultado:

    import Anthropic from "@anthropic-ai/sdk";
    import { langfuse } from "./langfuse-client";
    
    const client = new Anthropic();
    
    async function generateSupportResponse(
      userMessage: string,
      userId: string
    ): Promise<string> {
      // Abre la traza — representa toda la operación de negocio
      const trace = langfuse.trace({
        name: "support-response",
        userId,
        metadata: { channel: "web" },
      });
    
      // Crea una generación — representa una sola llamada al LLM
      const generation = trace.generation({
        name: "claude-response",
        model: "claude-sonnet-4-6",
        input: [{ role: "user", content: userMessage }],
      });
    
      try {
        const response = await client.messages.create({
          model: "claude-sonnet-4-6",
          max_tokens: 1024,
          messages: [{ role: "user", content: userMessage }],
        });
    
        const outputText =
          response.content[0].type === "text" ? response.content[0].text : "";
    
        // Registra la respuesta y el uso de tokens
        generation.end({
          output: outputText,
          usage: {
            input: response.usage.input_tokens,
            output: response.usage.output_tokens,
          },
        });
    
        return outputText;
      } catch (error) {
        // Registra errores también — son datos cruciales
        generation.end({
          level: "ERROR",
          statusMessage: error instanceof Error ? error.message : "Unknown error",
        });
        throw error;
      } finally {
        // Vacía el buffer antes de cerrar el proceso
        await langfuse.shutdownAsync();
      }
    }
    

    Para un agente con múltiples pasos — por ejemplo, uno que busca en una base de datos antes de responder — anidas spans dentro de la traza:

    async function agentWithToolCall(query: string, userId: string) {
      const trace = langfuse.trace({
        name: "agent-with-tools",
        userId,
        input: { query },
      });
    
      // Span para la búsqueda en base de datos
      const searchSpan = trace.span({
        name: "database-search",
        input: { query },
      });
    
      const searchResults = await searchDatabase(query);
    
      searchSpan.end({
        output: { resultCount: searchResults.length },
      });
    
      // Generación con los resultados como contexto
      const generation = trace.generation({
        name: "synthesis",
        model: "claude-sonnet-4-6",
        input: buildPromptWithContext(query, searchResults),
      });
    
      const response = await callClaude(query, searchResults);
    
      generation.end({ output: response });
      trace.update({ output: { response } });
      await langfuse.shutdownAsync();
    
      return response;
    }
    

    Con esto, cada ejecución queda registrada en Langfuse con su árbol completo de spans. Puedes ver exactamente cuánto tardó la búsqueda, cuántos tokens consumió la síntesis y qué prompt produjo esa respuesta que el cliente reportó como incorrecta.

    Es exactamente este tipo de arquitectura observable la que construimos en el curso Construye con IA — desde el primer agente hasta el sistema completo en producción, con trazabilidad desde el día uno.


    Los errores que aparecen cuando no tienes observabilidad

    Estos son los tres problemas que he visto repetirse en proyectos sin observabilidad — y que solo se detectan cuando ya han causado daño:

    Alucinaciones no detectadas. El agente responde con confianza. El formato es correcto. El dato está mal. Sin trazas, nunca sabes en qué paso del flujo el modelo inventó algo. Con trazas, identificas el prompt exacto que produce el problema y lo corriges.

    Latencias ocultas. El endpoint responde en 8 segundos. No sabes si el problema está en la llamada al LLM, en la búsqueda vectorial o en el postprocesado. Las métricas por span te dicen exactamente dónde está el cuello de botella.

    Costos fuera de control. Un prompt mal diseñado puede consumir 10x más tokens que uno equivalente. Sin métricas de uso por operación, solo ves la factura de fin de mes. Con observabilidad, detectas el problema en el primer día de producción.


    Por dónde empezar si ya tienes un proyecto en marcha

    No tienes que instrumentar todo de golpe. El orden que funciona:

    1. Añade Langfuse o Helicone a la llamada al LLM más crítica de tu sistema.
    2. Registra siempre: modelo, versión del prompt, userId, tokens usados.
    3. Cuando detectes un comportamiento inesperado, usa las trazas para reproducirlo.
    4. Una vez que el patrón funciona, extiéndelo al resto de llamadas.

    La observabilidad no es una feature opcional que añades al final. Es la infraestructura que te permite iterar sobre tus prompts con datos reales — no con intuición.

    Si quieres construir sistemas con IA desde cero con buenas prácticas de producción integradas desde el principio, en Dominicode Labs tenemos proyectos y recursos donde trabajamos exactamente esto junto a otros developers hispanohablantes.


    FAQ — Preguntas frecuentes sobre LLM Observability

    ¿Qué diferencia hay entre observabilidad en LLMs y logging tradicional?

    El logging tradicional captura eventos discretos: errores, requests, respuestas. La observabilidad en LLMs captura el flujo completo de razonamiento de un agente: qué herramientas invocó, en qué orden, con qué contexto, y cómo cada paso influyó en el resultado final. La diferencia es la misma que entre saber que tu avión aterrizó tarde y saber exactamente en qué tramo de la ruta perdió tiempo.

    ¿Necesito observabilidad si solo uso un LLM para tareas sencillas como resúmenes de texto?

    Si está en producción y lo usa más de un usuario, sí. Incluso para tareas aparentemente sencillas, la observabilidad te da visibilidad sobre costos (¿cuánto estoy gastando por resumen?), calidad (¿hay inputs que producen respuestas malas consistentemente?) y latencia (¿hay prompts que tardan 5x más que otros?). El esfuerzo de instrumentar una sola llamada es de menos de 20 líneas de código.

    ¿Langfuse es mejor que LangSmith?

    Depende de tu stack. Si usas LangChain, LangSmith es la integración más natural. Si haces llamadas directas a la API de Anthropic u OpenAI, o usas el Vercel AI SDK, Langfuse tiene mejor soporte, es open source y puedes autohospedarlo. Para proyectos donde los datos son sensibles y no quieres enviarlos a un tercero, Langfuse self-hosted es la única opción razonable.

    ¿Cómo gestiono la observabilidad en un agente con múltiples LLMs y herramientas?

    Usando el modelo de trazas jerárquicas: una traza por operación de negocio, spans para cada herramienta o paso intermedio, y generaciones para cada llamada al LLM. Langfuse, LangSmith y Arize Phoenix soportan este modelo de forma nativa. La clave es diseñar las trazas pensando en qué preguntas querrás responder cuando algo falle — no en lo que es fácil de capturar.

    ¿Cuánto cuesta implementar observabilidad con Langfuse?

    Langfuse Cloud tiene un plan gratuito generoso (50.000 observaciones al mes en la fecha de publicación de este post). Para proyectos con volumen alto, puedes autohospedarlo en tu propia infraestructura con Docker — el costo es solo el del servidor. LangSmith y Helicone tienen también niveles gratuitos, pero con menos control sobre los datos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qué es LangGraph y para qué sirve?

    Qué es LangGraph y para qué sirve?

    Tiempo estimado de lectura: 5 min

    • LangGraph modela agentes LLM como grafos de estado para soportar reintentos, checkpoints y flujos cíclicos.
    • Arquitectura basada en State, Nodes y Edges que permite persistencia y rutas condicionales.
    • Ideal para agentes que requieren autocorrección, aprobaciones humanas y orquestación multi-agente; no es la mejor opción para RAG lineal.

    Introducción

    LangGraph es una arquitectura y biblioteca pensada para convertir prototipos basados en LLM en sistemas operativos de IA: máquinas de estado con persistencia, rutas condicionales y capacidad de autocorrección. A diferencia de flujos lineales, LangGraph modela grafos dirigidos con estado compartido entre nodos, lo que facilita reintentos, aprobaciones humanas y trazabilidad en producción.

    Resumen rápido (lectores con prisa)

    LangGraph modela aplicaciones LLM como StateGraphs: un objeto de estado central que pasa por nodos (unidades de trabajo) y aristas (rutas condicionales). Es útil cuando necesitas reintentos, checkpoints, aprobaciones humanas y observabilidad en flujos complejos. No sustituye a LangChain; complementa su ecosistema para agentes stateful.

    Qué es LangGraph y para qué sirve?

    Qué es LangGraph y para qué sirve: en pocas palabras, LangGraph es la evolución arquitectónica para construir agentes de IA que necesitan razonar en ciclos, mantener estado persistente y coordinar múltiples acciones en producción. Si LangChain te ayuda a encadenar pasos (A → B → C), LangGraph te permite modelar grafos con bucles y condiciones (A → B → ¿volver a A? → C), lo que convierte prototipos en sistemas robustos y auditables.

    Qué es LangGraph: definición técnica y contexto

    LangGraph es una biblioteca del ecosistema LangChain orientada a modelar aplicaciones LLM como grafos dirigidos con estado (StateGraphs). Su objetivo no es sustituir a LangChain, sino ofrecer una abstracción para agentes stateful: nodos que transforman un objeto de estado central y aristas que dictan rutas condicionales o recurrentes. Documentación oficial: Documentación oficial y LangChain.

    ¿Por qué importa esto? Porque los agentes reales no funcionan con una sola pasada. Necesitan checkpoints, reintentos, intervención humana y la capacidad de inspeccionar y reactivar flujos largos. LangGraph incorpora esos elementos de forma nativa.

    Arquitectura: State, Nodes y Edges

    La arquitectura de LangGraph se resume en tres piezas principales que convierten al agente en una máquina de estados capaz de iterar y autocorregirse.

    Estado (State)

    Estado (State): un TypedDict/estructura que contiene todo el contexto del agente (historial de mensajes, resultados de herramientas, flags de control). El estado persiste y se pasa entre nodos.

    Nodos (Nodes)

    Nodos (Nodes): unidades de trabajo que reciben el estado, ejecutan lógica (llamadas a LLM, ejecución de tools, transformaciones) y devuelven una actualización del estado.

    Aristas (Edges)

    Aristas (Edges): definen el flujo. Pueden ser incondicionales o condicionales, permitiendo rutas distintas según el resultado (p. ej. error → corrección, éxito → siguiente etapa).

    Esta organización convierte al agente en una máquina de estados que puede iterar, corregirse y limpiar su plan a medida que avanza.

    Ejemplo mínimo (conceptual)

    from langgraph.graph import StateGraph, END
    
    class AgentState(TypedDict):
        messages: list
        attempts: int
    
    g = StateGraph(AgentState)
    g.add_node("think", call_model_node)      # produce propuesta en estado
    g.add_node("act", call_tool_node)         # ejecuta acción externa
    g.set_entry_point("think")
    
    # condicional: si falla, volver a "think" (loop); si OK, terminar
    g.add_conditional_edges("act", check_result, {"retry": "think", "done": END})
    
    app = g.compile(checkpointer=MemorySaver())

    Este patrón es el que permite, por ejemplo, que un agente escriba código, ejecute tests, lea errores y reescriba hasta que todo pase.

    Casos de uso reales y por qué elegir LangGraph

    LangGraph es la opción adecuada cuando tu aplicación requiere control fino y durabilidad. Es preferible cuando la lógica no cabe en una sola pasada y necesitas checkpoints, reintentos o pausas para intervención humana.

    • Agentes de auto-corrección (self-correcting): p. ej., un asistente que escribe y prueba código repetidamente.
    • Planificación y ejecución por etapas: descomposición de objetivos complejos en subtareas que se ejecutan y replanifican.
    • Flujos human-in-the-loop: pausas para aprobación humana manteniendo estado; crítico en entornos regulados.
    • Orquestación multi-agente: coordinar agentes especializados (investigador, verificador, redactor) que comparten estado y tareas.

    Para casos simples de RAG o chatbots lineales, LangChain/LCEL es más rápido de implementar; LangGraph entra cuando la lógica necesita reintentos, memoria o human approvals. Referencia: LangChain/LCEL.

    Integraciones, durabilidad y observabilidad

    LangGraph se integra con herramientas de almacenamiento y trazabilidad que son esenciales en producción.

    • Checkpointers/Recorders: MemorySaver, PostgresSaver, etc., permiten reanudar ejecuciones y persistir threads largos.
    • Observabilidad: integración con LangSmith (tracing, evaluaciones) para depurar y medir decisiones internas.
    • Vector stores y RAG: combina con Pinecone, Chroma o Weaviate cuando necesitas evidencia externa en nodos de razonamiento.
    • Orquestación externa: útil en pipelines con n8n para integrar herramientas empresariales.

    La durabilidad es la gran ventaja: si un proceso falla a mitad, LangGraph permite retomar desde el último checkpoint con el mismo objeto estado.

    Riesgos y consideraciones técnicas

    LangGraph añade complejidad. No es la herramienta para todo; evalúa trade-offs antes de adoptar.

    • Curva de aprendizaje: modelar grafos y estados correctamente exige diseño y pruebas.
    • Overhead: persistencia y checkpoints implican coste y latencia; mide y optimiza.
    • Seguridad: cualquier tool que ejecute código o acceda a datos sensibles debe estar sandboxeada y auditada.
    • Depuración: sin buenas métricas y trazabilidad (LangSmith u otras), los grafos cíclicos pueden volverse opacos.

    Tu criterio de adopción debe basarse en evidencia: prototipa en LangChain; si la solución requiere reintentos, memoria o human approvals, modela en LangGraph.

    Conclusión práctica

    LangGraph transforma agentes experimentales en sistemas operativos de IA: máquinas de estado con persistencia, rutas condicionales y capacidad de autocorrección. Úsalo cuando tus flujos necesiten reintentos, checkpoints y supervisión humana; queda corto para tareas lineales de RAG. Documentación y templates: Documentación oficial y repositorio.

    Empieza con un caso controlado (un agente que intenta, falla y reintenta una acción concreta), instrumenta trazabilidad y luego amplía a flujos multi-agente. Es así como pasas de “probar IA” a “operar IA” con seguridad.

    Dominicode Labs

    Si tu equipo trabaja en orquestación, automatización o agentes de producción, considera explorar plantillas y pruebas conceptuales en Dominicode Labs. Puede ser útil como punto de partida para validar patrones de checkpointing, trazabilidad y human-in-the-loop en proyectos reales.

    FAQ


    ¿En qué casos conviene usar LangGraph en lugar de LangChain puro?

    Usa LangGraph cuando tu flujo requiere reintentos, checkpoints, memoria persistente o aprobaciones humanas. Si tu aplicación es lineal (RAG simple o chat básico), LangChain/LCEL suele ser suficiente y más rápido de implementar.

    ¿LangGraph reemplaza a LangChain?

    No. LangGraph complementa el ecosistema LangChain: ofrece abstracciones para agentes stateful y grafos con condiciones. LangChain sigue siendo útil para pipelines lineales y muchas integraciones.

    ¿Cómo se persiste el estado en LangGraph?

    El estado se persiste mediante checkpointers/recorders como MemorySaver o PostgresSaver. Estos componentes permiten reanudar ejecuciones y almacenar el objeto de estado para procesos largos o interrumpidos.

    ¿Qué impacto tiene LangGraph en latencia y costes?

    La persistencia y checkpoints añaden overhead: más I/O y potencialmente mayor latencia. Es importante medir, optimizar y balancear la durabilidad frente al coste operativo.

    ¿Cómo manejar la seguridad al ejecutar tools desde nodos?

    Sandboxea y audita cualquier herramienta que ejecute código o acceda a datos sensibles. Implementa controles de acceso, validación de inputs y trazabilidad exhaustiva para cada ejecución de herramienta.

    ¿Puedo integrar vector stores y herramientas externas?

    Sí. LangGraph se integra con servicios como Pinecone, Chroma y Weaviate, y se puede orquestar con herramientas externas como n8n para flujos empresariales.

  • ¿Cómo me puede ayudar LangChain ?

    ¿Cómo me puede ayudar LangChain ?

    Introducción a LangChain: marco para orquestar LLMs

    Tiempo estimado de lectura: 5 min

    • LangChain orquesta LLMs con datos, herramientas y memoria para convertir llamadas aisladas en sistemas reproducibles.
    • RAG + embeddings es el patrón práctico para respuestas basadas en conocimiento privado y reducirá hallucinations.
    • Componentes clave: modelos, plantillas de prompt, parsers, retrieval, chains, memory y agents.
    • Producción: herramientas como LangGraph y LangSmith ayudan con trazabilidad; medir latencia y coste es obligatorio.

    Introduccion a LangChain: si vas a construir algo serio con LLMs, necesitas entender por qué LangChain existe y cómo te evita reescribir la misma integración una y otra vez. En las primeras líneas: LangChain es el framework que conecta modelos de lenguaje con datos, herramientas y memoria para convertir llamadas aisladas a APIs en sistemas reproducibles y auditables.

    Resumen rápido (para IA y lectores con prisa)

    LangChain es un framework de orquestación para aplicaciones basadas en LLMs que abstrae prompts, retrieval, chains, memoria y agentes. Se usa cuando necesitas RAG, memoria o ejecución de herramientas. El patrón RAG (embeddings + vector store + prompt con snippets) reduce hallucinations y facilita trazabilidad.

    Introducción a LangChain: qué es y por qué importa

    LangChain es un framework de orquestación para aplicaciones basadas en LLMs. Su objetivo es resolver problemas reales que aparecen cuando un LLM se usa en producción: gestión de prompts, persistencia de contexto, acceso a conocimiento privado y composición de pasos (chains) o decisiones (agents).

    Por qué importa:

    • Un LLM por sí solo devuelve texto; no sabe consultar tu base de datos ni ejecutar código.
    • Las aplicaciones útiles requieren memoria, búsquedas semánticas, parsing estructurado y herramientas ejecutables.
    • LangChain ofrece abstracciones reutilizables para esos problemas y te permite cambiar de proveedor de modelo sin rehacer toda la app.

    Documentación oficial y repositorios:

    Componentes esenciales (y cómo usarlos)

    Entender estos bloques te da la arquitectura mental para diseñar cualquier app LLM.

    Models / Prompt Templates / Output Parsers

    – Models: adaptadores para OpenAI, Anthropic, modelos locales (Ollama) o cualquier API.

    – Prompt Templates: plantillas parametrizadas; evitan concatenaciones inseguras y facilitan versionado.

    – Output Parsers: convierten texto a JSON/objetos tipados para que no dependas de parsing frágil.

    Ejemplo corto: un PromptTemplate que inyecta contexto recuperado antes de invocar el modelo.

    Retrieval (RAG): embeddings y vector stores

    – Carga documentos (PDF, HTML, bases de datos) con Document Loaders.

    – Divide en chunks (Text Splitters) y crea embeddings.

    – Almacena embeddings en un Vector Store (Pinecone, Chroma, Weaviate) para búsquedas semánticas.

    Herramientas:

    RAG es el patrón por el que tu LLM responde usando conocimiento privado en lugar de memoria del modelo.

    Chains y LCEL (LangChain Expression Language)

    Las Chains son pipelines: prompt → modelo → parser → siguiente paso. LCEL introduce una sintaxis declarativa tipo pipe (|) para componer cadenas de forma legible, soportando streaming y ejecución asíncrona.

    # ejemplo conceptual (Python)
    chain = prompt | model | output_parser
    result = chain.invoke({"query": "¿Qué resumen tiene este documento?"})
    

    Memory

    LangChain soporta memoria en RAM, Redis o almacenamiento persistente para mantener conversaciones stateful. Útil en asistentes que deben recordar preferencias o contexto de sesiones largas.

    Agents y Tools

    Un agent usa el LLM para decidir qué herramientas ejecutar: búsquedas web, queries SQL, ejecución de scripts. Esto transforma al LLM en un motor de decisión con acceso controlado a acciones.

    Ejemplo práctico: pipeline RAG mínimo (esquema)

    1. Cargar documentos (PDFs, docs) → text split.
    2. Generar embeddings con un modelo (e.g., ada/embedding) → guardar en Chroma/Pinecone.
    3. Al recibir query, buscar top-k semántico.
    4. Construir prompt con plantilla que incluya snippets relevantes.
    5. Llamar al LLM y parsear salida a JSON.

    Este patrón reduce hallucinations y hace respuestas trazables: el prompt contiene la evidencia usada.

    LangChain en producción: LangGraph, LangSmith y consideraciones

    – LangGraph añade control de flujo cíclico y objetos de estado para agentes complejos (útil si necesitas bucles, retries o coordinación entre subagentes).

    – LangSmith es la herramienta para trazabilidad, debugging y métricas del comportamiento de chains/agents — imprescindible en producción.

    – Integraciones útiles: Ollama (modelos locales) ; n8n para orquestación low-code.

    Cuestiones prácticas:

    • Latencia: las abstracciones añaden overhead; medir y optimizar es obligatorio.
    • Costes: cada RAG + LLM call tiene coste; cachea embeddings y limita contexto.
    • Seguridad y privacidad: controla lectura de datos sensibles y sandboxea herramientas ejecutables.

    Cuándo usar LangChain (y cuándo no)

    Usa LangChain cuando:

    • Necesitas RAG, memoria, o agentes que llamen herramientas.
    • Buscas estándar de desarrollo para equipos que trabajan con LLMs.
    • Quieres evitar vendor lock-in entre OpenAI/Anthropic/modelos locales.

    No lo uses cuando:

    • Tu caso es una sola llamada simple a la API (overhead no justificado).
    • Requieres latencia ultrabaja en microservicios críticos sin tolerancia a capas extra.

    Conclusión práctica

    LangChain convierte el desarrollo con LLMs en ingeniería repetible: prompts versionados, pipelines composables y agentes que pueden operar con trazabilidad. Aprende los bloques —models, retrieval, chains, memory y agents— y construye primero un RAG básico: es el proyecto que más rápidamente te demuestra el valor práctico del framework.

    Lecturas y recursos

    Dominicode Labs

    Si trabajas en integración de agentes, RAG o pipelines de orquestación, Dominicode Labs ofrece recursos y experimentos que complementan flujos de trabajo con LangChain y herramientas afines. Considera revisarlo como un punto de partida práctico para pruebas y plantillas.

    FAQ

    ¿Qué es LangChain y para qué sirve?

    LangChain es un framework de orquestación para aplicaciones basadas en LLMs. Sirve para conectar modelos de lenguaje con datos, herramientas y memoria, permitiendo construir sistemas reproducibles y auditables en vez de llamadas aisladas a APIs.

    ¿Qué es RAG y por qué usarlo?

    RAG (Retrieval-Augmented Generation) es un patrón que combina embeddings, un vector store y un prompt construido con snippets relevantes para que el LLM responda basándose en conocimiento privado en lugar de confiar únicamente en su memoria. Reduce hallucinations y mejora trazabilidad.

    ¿Qué componentes debo aprender primero?

    Comienza por entender cómo funcionan embeddings y vector stores (RAG), luego aprende Prompt Templates y Output Parsers; finalmente integra memory y chains. Un RAG básico es el proyecto que más rápidamente demuestra valor práctico.

    ¿LangChain añade latencia importante?

    Las abstracciones pueden añadir overhead, por lo tanto es obligatorio medir la latencia en tu flujo. Optimiza caching de embeddings y context windows para reducir llamadas innecesarias.

    ¿Cómo manejo seguridad y datos sensibles?

    Controla estrictamente qué datos se indexan y quién puede ejecutar herramientas desde agentes. Sandboxea cualquier herramienta ejecutable y aplica políticas de acceso y auditoría con herramientas como LangSmith para trazabilidad.