Tag: Git

  • Anthropic Scion: por qué dejó git y qué te enseña a ti

    Anthropic Scion: por qué dejó git y qué te enseña a ti

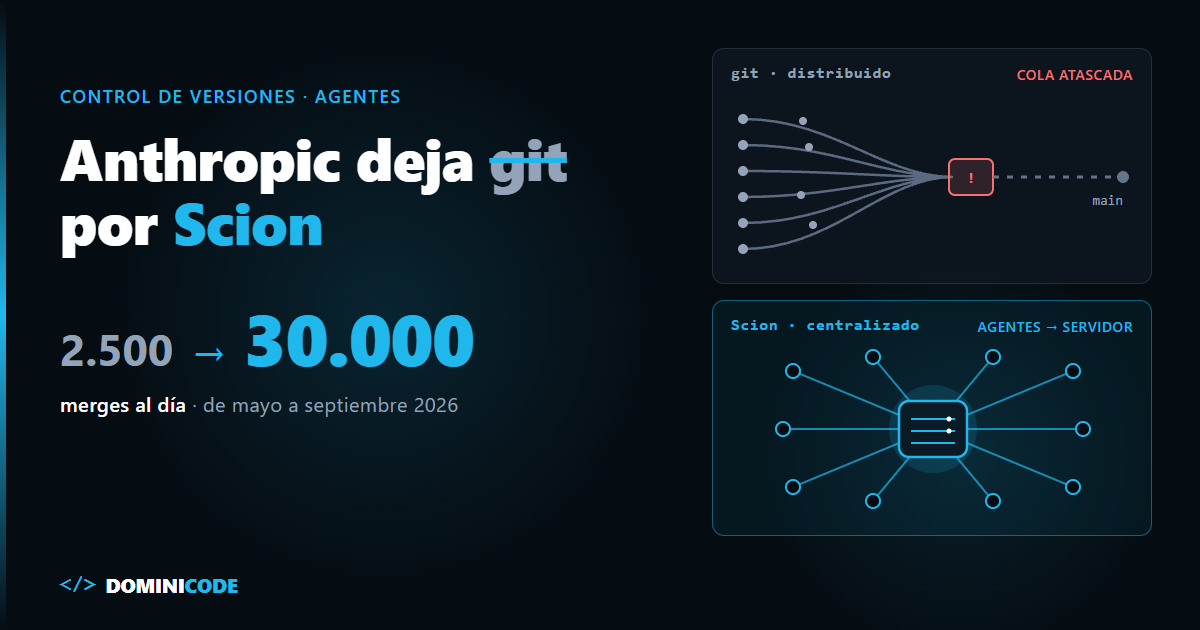
    En mayo de 2026, el monorepo de Anthropic recibía unos 2.500 merges al día. En septiembre recibía más de 30.000.

    Casi todos los clientes del repo eran ya agentes y jobs automáticos. Y en algún punto de esa curva, git dejó de ser una herramienta y pasó a ser un problema de infraestructura.

    El 13 de octubre de 2026, Anthropic publicó cómo lo resolvió: Anthropic Scion, un sistema de control de versiones propio que sustituye a git en su monorepo. El titular que más circuló fue "Anthropic abandona git". Es verdad, pero no es lo interesante.

    Lo interesante es dónde se rompió primero. No fue el código. Fue todo lo que pasa después de escribirlo.

    En corto: Anthropic sustituyó git por Scion, un control de versiones centralizado propio, porque su monorepo pasó de 2.500 a más de 30.000 merges diarios, con agentes como clientes principales. La propia Anthropic dice que Scion no sirve como reemplazo general de git. La lección para ti no es cambiar de herramienta: es que, cuando los agentes escriben el código, el cuello de botella se mueve a la integración y a la revisión.

    ¿Qué es Anthropic Scion?

    Anthropic Scion es el sistema de control de versiones centralizado que Anthropic construyó para sustituir a git en su monorepo, diseñado para clientes que siempre están online —sobre todo agentes y jobs de CI— y en el que el servidor, no el cliente, crea los commits y hace los merges.

    Viene acompañado de Antique, su herramienta de code review. Lo construyó un equipo de 7 personas y la migración duró 5 meses, según el post de ingeniería de Anthropic. Por debajo, mover una referencia (lo que en git sería actualizar una rama) es un compare-and-swap sobre una fila de Spanner: por eso los commits no necesitan locks.

    Por qué Anthropic dejó git en su monorepo

    La respuesta corta: usaban git como si fuera centralizado, y git está diseñado para lo contrario.

    Git asume que cada developer tiene una copia completa, trabaja offline y sincroniza de vez en cuando. Anthropic tenía casi todos sus clientes siempre conectados: agentes y jobs. El diseño distribuido, que es la gran virtud de git, jugaba en su contra.

    Las cifras que publica Anthropic lo dejan claro:

    Métrica (fuente: Anthropic, oct 2026) Valor
    Merges diarios en mayo 2026 ~2.500
    Merges diarios en septiembre 2026 más de 30.000
    Historial de main casi 100 GB
    Working copy comprimida más de 25 GB
    Checkouts al día solo para CI ~25 millones
    Tráfico git diario con un fetch ingenuo más de 600 PB
    Mirrors internos de git en el pico varios cientos

    Ya usaban shallow clones y sparse checkouts. No bastaba.

    Git vs Anthropic Scion: dos modelos de control de versiones

    Scion no es "un git más rápido". Es otro modelo, más cercano a SVN o Perforce que a git.

    Git Scion
    Modelo Distribuido, pensado para trabajar offline Centralizado, clientes siempre online
    Dónde se crean commits y merges En el cliente; luego push En el servidor; no existe push
    Copia del repo Cada clon tiene la historia completa (o parte, con shallow/sparse) No existe copia completa en ningún sitio, ni siquiera en el servidor
    Working copy Necesaria para trabajar (salvo repos bare) Opcional, sparse o virtualizada
    Coste de un commit Local y barato; lo que crece con el repo es sincronizar (clone, fetch, checkout) Se crea en el servidor; el coste escala con el cambio, no con el repo
    Para quién sirve Prácticamente cualquier equipo y proyecto Monorepos enormes con decenas de miles de ingenieros o enjambres de agentes
    Limitación o riesgo A escala de agentes masiva exige mirrors, cachés y mantenimiento de packfiles Sin conexión no trabajas; no es open source; adoptarlo obliga a migrar review, code search y CI

    Según Anthropic, el resultado: una huella de infraestructura unas 200 veces menor que la de los mirrors de git, checkouts de CI en segundos en vez de minutos y un 25% de la CPU de CI liberada.

    La merge queue clásica no aguanta el volumen de los agentes

    Según Anthropic, una merge queue clásica no aguanta 30.000 merges al día: prescindieron de ella y movieron la validación a testing post-merge y pre-deploy. Esta es la parte que sí te afecta.

    Anthropic lo escribe sin rodeos: "A proper merge queue, for example, doesn't make much sense at agent scale." (Una merge queue como tal, por ejemplo, no tiene mucho sentido a escala de agentes.)

    Una merge queue serializa los cambios: prueba cada uno contra el estado más reciente de main antes de integrarlo. Con 30.000 merges al día, esa cola es un embudo. Su respuesta fue prescindir del lock global, que no lograron replicar a esa escala, invertir en testing post-merge y pre-deploy, y dejar que Claude arregle los conflictos.

    Esa decisión solo es segura si tus tests son buenos de verdad. Un test que pasa siempre no protege nada. Por eso, antes de mover validación a post-merge, merece la pena medir la calidad real de tu suite, por ejemplo con mutation testing con Stryker, y proteger los tests para que el agente no los modifique cuando le estorban.

    Revisar la intención, no cada línea

    Revisar la intención es comprobar que el cambio hace lo que debía hacer, en vez de leer cada línea que escribió el agente. Es el segundo cambio, y el más incómodo.

    Anthropic cuenta que sus ingenieros tuvieron que decirle "no" a Claude a menudo durante el proyecto. Claude proponía escaneos lineales del log de commits en lugar de consultar la herramienta de review, o añadía validación sobre-defensiva después de una revisión adversarial. La conclusión del equipo: ahora revisan la intención del cambio, no cada línea.

    No es revisar menos. Es revisar otra cosa: tener escrito qué debe hacer el cambio y comprobar que lo hace.

    Es exactamente la idea detrás de la revisión por contrato del código generado por agentes: defines el contrato antes, y revisas contra él. Y empieza por darle al agente contexto estable sobre tu proyecto, con un buen AGENTS.md para Claude Code.

    Si quieres empezar gratis, el ebook El Developer Agéntico es el punto de partida para construir agentes de IA con criterio: herramientas, memoria, seguridad, permisos y evaluación.

    Si quieres llevarlo a un flujo completo, es lo que trabajamos en el workshop SDD + Agentic Engineering: especificación, harness y revisión de lo que produce el agente.

    Lo que dice Hacker News: ¿es git o es el monorepo?

    El hilo de Hacker News superó los 940 comentarios. La respuesta corta a la pregunta del título: técnicamente, buena parte del problema es el monorepo; lo que forzó el cambio fue el volumen. El escepticismo fue bastante sano.

    La crítica técnica más repetida: el problema no es git, es el monorepo. zmmmmm lo planteó directamente, y bob1029 fue más lejos: "This article doesn't do a very good job of convincing me that git is technically incapable of handling the described workload." (Este artículo no consigue convencerme de que git sea técnicamente incapaz de manejar esa carga.)

    tancop lo resumió en una línea: "So it's a SVN/Perforce style server based VCS with a more modern design." (O sea, un VCS basado en servidor al estilo SVN/Perforce con un diseño más moderno.)

    kburman apuntó al coste oculto: "I suspect we'll see a lot more reinvention of the wheel, even at smaller startups, as AI makes writing code significantly cheaper. […] Whether maintaining all that custom software turns out to be equally cheap is another question." (Sospecho que veremos mucha más reinvención de la rueda, incluso en startups pequeñas, porque la IA abarata escribir código. Si mantener todo ese software a medida resulta igual de barato es otra cuestión.)

    Y duttish hizo la pregunta que más me importa: "Every time I stop reviewing the code from Claude I later find janky crap. […] how are they avoiding the janky crap?" (Cada vez que dejo de revisar el código de Claude, después encuentro chapuzas. ¿Cómo las evitan ellos?)

    Mi opinión: la crítica de que "es el monorepo" tiene razón técnica, pero no cambia la lección. Lo que forzó el rediseño fue el volumen de cambios. Y la pregunta de duttish tiene respuesta: no dejas de revisar, cambias qué revisas. Revisar la intención sin un contrato escrito suele acabar en chapuzas.

    Cuándo NO te sirve el enfoque de Anthropic Scion

    La propia Anthropic lo dice claro: "Scion is by no means a suitable replacement for git for general use." (Scion no es, en absoluto, un reemplazo adecuado de git para uso general.)

    Estas son las limitaciones que reconoce:

    1. Solo tiene sentido a una escala que casi nadie tiene. Monorepos enormes, con decenas de miles de ingenieros o enjambres de agentes. Si tu repo cabe en un portátil, git te sobra.
    2. Su presupuesto de tokens no es el tuyo. Anthropic reconoce que lo que gasta en tokens para uso interno supera con mucho lo que cualquier otra empresa querría gastar de forma realista. Parte de su manera de trabajar se apoya en ese gasto, y tú no partes de ahí.
    3. Adoptarlo es migrar todo el ciclo. No cambias solo el VCS: cambias review, code search y CI. Anthropic construyó Antique y el resto del ecosistema a la vez.
    4. No es open source. No puedes instalarlo. Anthropic dice que quiere compartir las ideas con GitHub, GitLab y la comunidad git, no el producto.

    Qué hacer con tu flujo de trabajo esta semana

    No necesitas Anthropic Scion. Necesitas que tu flujo aguante el volumen de cambios que tus agentes ya pueden generar.

    Haz esta prueba:

    1. Cuenta cuántos PRs abrieron tus agentes este mes y el anterior.
    2. Mide cuánto tardó cada uno en llegar a main.
    3. Si el tiempo de espera crece más rápido que el número de PRs, tu cuello de botella ya no es escribir código: es integrar y revisar.
    4. Empieza por escribir la intención antes de pedir el cambio y revisa contra ella. Si quieres el método completo para trabajar con especificaciones, está en el libro Spec-Driven Development. Y si quieres verlo aplicado de la idea al producto con Claude Code, en el curso Construye con IA.

    Preguntas frecuentes

    ¿Anthropic ha abandonado git?

    Solo en su monorepo interno. Anthropic lo sustituyó por Scion en ese monorepo porque los merges pasaron de unos 2.500 diarios en mayo de 2026 a más de 30.000 en septiembre. La propia empresa dice que Scion no es un reemplazo de git para uso general.

    ¿Anthropic Scion es open source?

    No. Anthropic no lo libera como open source. Su intención declarada es compartir las ideas de diseño con GitHub, GitLab y la comunidad de git.

    ¿Debería dejar de usar git?

    No. Scion está pensado para monorepos enormes con decenas de miles de ingenieros o enjambres de agentes, y exige migrar review, code search y CI. Para casi cualquier equipo, git sigue siendo la opción correcta; lo que sí conviene revisar es tu proceso de integración y revisión.

    ¿Qué es Antique?

    Antique es la herramienta de code review que Anthropic construyó junto a Scion. Forma parte del mismo ecosistema que también incluye code search e IAM de source control.

    ¿Qué es Claude Mythos Preview en esta historia?

    Un snapshot interno temprano de Claude Mythos Preview reescribió el pipeline de ingesta de git a Scion sin más instrucciones, según Anthropic. El resultado usaba 20 veces menos memoria y era 4 veces más rápido, preservando las invariantes implícitas de orden de ingesta y de estructuras de datos.

    ¿Por qué Anthropic no usa una merge queue clásica?

    Porque, según Anthropic, una merge queue como tal no tiene mucho sentido a escala de agentes, y no lograron replicar el lock global del repositorio que es estándar en la industria. En su lugar invierten en testing automático post-merge y pre-deploy, y Claude arregla los conflictos entre cambios concurrentes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Dirigir agentes de IA en paralelo sin que se pisen: mi día real

    Dirigir agentes de IA en paralelo sin que se pisen: mi día real

    Hace unas semanas perdí una mañana entera por una tontería.

    Tenía dos agentes trabajando. Uno refactorizando el módulo de autenticación. El otro añadiendo tests a ese mismo módulo, porque me pareció eficiente hacer las dos cosas a la vez.

    Los dos escribían sobre los mismos archivos.

    Cuando volví, el proyecto no compilaba y ninguno de los dos diffs tenía sentido por separado. Tiré las dos ramas y empecé de cero.

    El fallo no fue del modelo. Los dos agentes hicieron exactamente lo que les pedí.

    El fallo fue mío: los puse a trabajar en el mismo suelo.

    Esto es lo que casi nadie cuenta cuando habla de dirigir agentes: el cuello de botella de operar con varios agentes no es la inteligencia del modelo, es la infraestructura donde los pones. Que un modelo de frontera escriba 500 líneas tipadas en quince segundos es un problema resuelto. Lo que no está resuelto es cómo evitas que varios procesos autónomos se pisen entre ellos, y cómo revisas lo que producen sin convertirte tú en el atasco.

    Opero Dominicode solo. Una plataforma de cursos, un canal de YouTube con más de 100.000 suscriptores, libros técnicos y una comunidad activa. No tengo un equipo de diez personas. Tengo un sistema.

    Aquí está ese sistema: sus tres reglas, cómo es la jornada y lo que cuesta.

    Si lo que buscas es qué habilidades aprender para llegar hasta aquí, eso ya lo desglosé en el roadmap del developer con IA. Este post no va de qué aprender. Va de cómo se opera un día.


    Las 3 reglas del suelo

    Mi operación se apoya en tres reglas. Ninguna es teoría: cada una salió de una mañana perdida como la de arriba.

                     TAREA
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
     AISLAR        CONTRATO        ÁRBITRO
     rama +        spec.md         los tests
     worktree      antes del       deciden,
     propio        prompt          no yo
        │              │              │
        └──────────────┼──────────────┘
                       ▼
                DIFF AUDITABLE
    

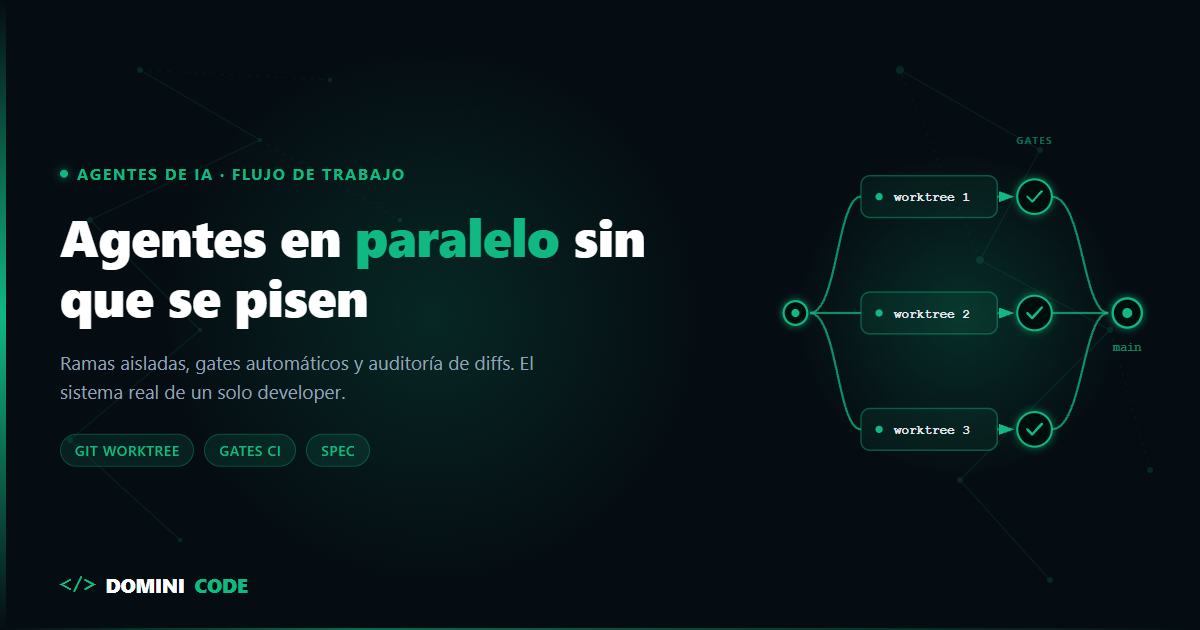
    1. Un agente, una rama, un worktree

    La regla es literal: dos agentes nunca comparten directorio de trabajo.

    Cada tarea que delego arranca en su propia rama y en su propio git worktree. Son copias del repositorio en carpetas distintas que comparten el mismo historial de Git. El agente que refactoriza autenticación no ve los archivos del agente que escribe documentación, porque físicamente no están en su carpeta.

    Esto resuelve tres cosas de golpe:

    • No hay colisiones de escritura. Es imposible que dos agentes editen el mismo archivo, porque cada uno tiene su copia.
    • El diff sale limpio. Cada rama contiene un solo cambio conceptual, así que puedo revisarlo sin desenredarlo del resto.
    • Tirar el trabajo es gratis. Si un agente se ha ido por un camino equivocado, borro la rama y no he perdido nada más.

    Antes de esto usaba una sola carpeta y lanzaba los agentes por turnos. Iba tres veces más lento y aun así se pisaban cuando me despistaba.

    2. La spec es el contrato, el prompt es solo la orden de arranque

    Un prompt es una conversación. Una spec es un contrato que se puede verificar.

    La diferencia importa mucho más cuando trabajas en paralelo, y por un motivo que no es obvio: si no puedes revisar el trabajo del agente mientras lo hace, la especificación es lo único que evita que descubras la desviación al final. Con un agente delante puedes corregirle en el turno siguiente. Con cuatro trabajando a la vez, no estás mirando. Te enteras cuando abres el diff.

    Así que antes de lanzar nada escribo un spec.md que delimita el alcance, las interfaces y qué queda explícitamente fuera. Ese último punto es el que más trabajo me ahorra: sin un "fuera de alcance" escrito, los agentes tienden a expandirse hacia archivos que nadie les pidió tocar.

    Esta es la metodología que explico entera en el libro de Spec-Driven Development. Y si quieres saber por qué una spec aparentemente buena todavía falla, tengo desmenuzados los 7 fallos más comunes.

    3. Los tests son el árbitro, no yo

    Aquí está el error que hunde a la mayoría cuando intenta paralelizar: creer que el revisor humano escala.

    No escala. Si cuatro agentes producen cuatro diffs de 400 líneas y tú eres la única puerta de calidad, has movido el cuello de botella de la escritura a la revisión. Vas igual de lento, solo que ahora leyendo en vez de escribiendo.

    La única salida es que la primera puerta sea automática y no negociable. En mi caso: tipado estricto, suite de tests y lint. Si una rama no pasa los tres, no llega a mis ojos. El agente recibe el error, corrige y vuelve a intentarlo sin que yo intervenga.

    Ese es el cambio mental completo. Tu trabajo no es aprobar código: es diseñar el árbitro que lo aprueba por ti. Cuando esos gates viven en el pipeline y no en tu cabeza, las revisiones automáticas en CI/CD hacen el primer filtro completo.

    Diseñar suites que cacen regresiones sutiles —y no solo las obvias— es una habilidad en sí misma, y es la que enseño en el curso de Testing en Angular y TypeScript.


    Qué se puede paralelizar y qué no

    Esta es la parte que se salta todo el mundo, y la que decide si el sistema funciona.

    No todas las tareas se pueden repartir. Si la tarea B necesita las decisiones de la tarea A, lanzarlas juntas no te da velocidad: te da dos ramas incoherentes y una tarde de merge.

    Mi criterio, en una línea: paralelizo lo que no comparte decisiones de diseño.

    Se paralelizan bien:

    • Tareas en módulos que no se tocan entre sí.
    • Trabajo de superficie: tests sobre código estable, documentación, migraciones mecánicas.
    • Investigación. Un agente reproduciendo un fallo en staging no interfiere con nadie.

    No se paralelizan:

    • Cambios que dependen de un modelo de datos que todavía estoy decidiendo.
    • Cualquier cosa que toque el mismo contrato público, aunque sean archivos distintos.
    • La primera implementación de una funcionalidad nueva cuya arquitectura no está fijada.

    Ese segundo caso me pilló varias veces. Dos agentes en carpetas separadas, sin conflicto de Git, pero cada uno asumió una forma distinta del mismo tipo compartido. El merge fue limpio y el código estaba roto. Por eso el aislamiento no sustituye al contrato: hacen falta los dos.

    Si quieres el marco completo para decidir qué va en serie y qué va en paralelo, lo detallé en cómo clasificar tareas con IA.


    Mi jornada, por bloques

    Así se traduce todo lo anterior a un día normal.

    Mañana (bloque de decisión). Es la única hora del día en la que no hay ningún agente corriendo, y es deliberado. Reviso lo que quedó pendiente, decido qué entra hoy y escribo las especificaciones. Todas las decisiones de arquitectura del día se toman aquí. Cuando lanzo el primer agente, ya no queda nada por decidir.

    Media mañana (lanzamiento). Abro los worktrees y lanzo. Normalmente entre tres y cinco tareas, cada una en su rama, cada una con su spec. Nunca dos en el mismo módulo.

    Día (trabajo profundo). Mientras los agentes escriben y los pipelines validan, yo no miro los agentes. Esta es la parte que cuesta interiorizar y es donde está toda la ganancia real: si me quedo mirando la terminal, no he ganado nada. Este bloque es para diseñar arquitectura, grabar contenido o escribir. Los gates hacen su trabajo sin mí.

    Tarde (auditoría). Aquí sí me siento a revisar. Solo llegan las ramas que pasaron los gates.

    Cierre (integración). Apruebo, integro en orden y anoto qué se desvió y por qué. Ese registro es lo que hace que la spec de mañana sea mejor que la de hoy.

    Lo importante no son las horas: es que las decisiones y la ejecución están en bloques separados. Cuando los mezclaba —decidir un poco, lanzar un poco, revisar un poco— el sistema entero se venía abajo.


    Cómo audito cuatro diffs sin leer 1.600 líneas

    No los leo enteros. Reviso en tres pasadas, y cada una descarta trabajo para la siguiente.

    Primera pasada: la forma del diff. Antes de leer código, mira qué archivos se tocaron y cuántas líneas. Un agente al que pediste un cambio en un módulo y ha tocado once archivos se ha ido de alcance. Eso se ve en cinco segundos y ya es motivo de rechazo, sin leer una línea.

    Segunda pasada: los bordes. Voy directo a donde el código se comunica con el resto: tipos exportados, firmas públicas, esquemas de validación, migraciones. Ahí es donde un fallo se propaga. El interior de una función privada, si los tests pasan, puede esperar.

    Tercera pasada: lo que el test no puede saber. Aquí leo de verdad, pero solo lo que ninguna suite detecta. Que el agente haya elegido la abstracción correcta. Que no haya duplicado algo que ya existía en el proyecto. Que el error se maneje donde tiene sentido y no donde era cómodo.

    Los tests cubren la corrección. Yo cubro el criterio. Y el criterio es lo único que un modelo no puede delegarte de vuelta.


    Lo que cuesta

    Conviene decirlo, porque suele omitirse: paralelizar sale más caro por tarea completada.

    Cuando reparto una tarea entre varios agentes, cada uno arrastra su propio contexto del proyecto. Ese contexto se paga varias veces en lugar de una. Y el coste real no es lineal ni predecible: cambia bastante según el modelo que asignes a cada rama, algo que ya analicé en detalle en el coste de los subagentes al cambiar de modelo.

    Lo asumo porque lo que compro es tiempo mío, no tokens. Pero conviene tenerlo claro antes de lanzar seis agentes: si la tarea era pequeña, sale más barato hacerla tú.


    Qué puedes montar esta semana

    Sin reformar nada, en este orden:

    1. Aísla antes de paralelizar. Crea un git worktree por tarea. Con dos ya notarás la diferencia; no hace falta empezar por seis.
    2. Escribe el "fuera de alcance". Una sola línea en tu spec diciendo qué no debe tocar el agente. Es la frase con mejor retorno de todo el documento.
    3. Pon un gate automático. Aunque sea solo tsc --noEmit más los tests. Mientras la única puerta de calidad seas tú, no estás paralelizando: estás acumulando cola.

    El flujo completo, desde la idea hasta producción con herramientas CLI agénticas, lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si quieres ver configuraciones reales de agentes y arquitecturas que están funcionando en producción hoy, eso es lo que compartimos cada semana en Dominicode Labs.

    Un agente que escribe código es una herramienta. Varios agentes con un suelo bien diseñado debajo son un equipo. La diferencia entre las dos cosas la construyes tú, y no está en el prompt.


    Preguntas frecuentes

    ¿Cuántos agentes puedo tener trabajando a la vez sin perder el control?

    El límite no lo pone la herramienta, lo pone tu capacidad de auditar. Yo trabajo con tres a cinco tareas simultáneas porque es lo que puedo revisar con criterio en un bloque de tarde. Si necesitas más de lo que puedes auditar, el problema no se arregla añadiendo agentes: se arregla endureciendo los gates automáticos para que llegue menos a tu revisión.

    ¿Cómo evito que dos agentes editen el mismo archivo?

    Dándoles carpetas distintas. Un git worktree por tarea crea una copia del repositorio en su propio directorio, compartiendo el historial de Git. Como cada agente solo ve su carpeta, la colisión de escritura es imposible por construcción, no por disciplina.

    ¿Merece la pena paralelizar si tengo que revisar todos los diffs igual?

    Solo si la revisión no es tu cuello de botella. Con gates automáticos, las ramas que fallan tipado, lint o tests nunca llegan a tu mesa: el agente corrige solo. Sin esos gates, paralelizar no te da velocidad, te da una cola de revisión más larga.

    ¿Qué hago cuando un agente en paralelo se queda atascado?

    Borro la rama y reescribo la especificación. Insistir en la misma conversación con un agente que ya se desvió suele salir más caro que empezar limpio, porque el contexto equivocado sigue ahí arrastrándose. Y casi siempre el atasco señala una ambigüedad real en la spec que hay que arreglar de todos modos.

    ¿Se puede aplicar esto en un equipo, o solo trabajando solo?

    Funciona igual o mejor en equipo, porque las tres reglas son las mismas que ya usa cualquier equipo sano: rama por cambio, contrato antes de implementar, CI como árbitro. Lo que cambia es quién ocupa la silla del implementador. Si tu equipo ya trabaja así con personas, tienes el suelo montado.

  • Guía práctica para implementar CI con artefactos de decisión

    Guía práctica para implementar CI con artefactos de decisión

    Opción 2 — Guía técnica práctica + Artefacto de decisión + CI (GitHub Actions)

    Tiempo estimado de lectura: 5 min

    Ideas clave:

    • Entregar un flujo operativo ligero que obligue a decisiones humanas explicadas y verificables.
    • Usar un artefacto de decisión en JSONL y una validación en CI para impedir atajos de IA.
    • Combinar hooks pre-commit y GitHub Actions para bloquear merges sin aprobación humana.
    • Checklist operativo y plantillas mínimas para integrarlo sin fricción.

    Introducción

    ¿Quieres que esto se quede bonito en una carpeta o que obligue a alguien a cambiar la forma en que trabaja?

    Tu texto ya tiene filo. Falta convertirlo en algo que haga tambalear decisiones: un artículo que los jefes lean; una guía que el equipo implemente; o herramientas listas para pegar en CI y que no dejen pasar atajos de la IA.

    Elige una de estas cuatro y me pongo a darle dientes:

    1) Versión larga (1.500–2.000 palabras) — Artículo profundo, con gancho potente, ejemplos técnicos, riesgos, y cierre que deja la puerta abierta. Ideal para blog/Medium.
    2) Guía técnica práctica (800–1.200 palabras) — Comandos, flujo de trabajo, plantilla de artefacto de decisión, ejemplos de interceptación y checklist de gobernanza. Para equipos que lo quieren ejecutar ya.
    3) Paquete GitHub-ready — Código: workflow de Actions que valida specs, template de artefacto de decisión (JSONL), hook pre-commit que bloquea merges si no hay aprobación humana. Incluye README y snippets.
    4) LinkedIn/Twitter thread + TL;DR — Versión viral y condensada para provocar debate y atraer tráfico al artículo largo.

    Extras opcionales (marcalos si los quieres):
    – CI (GitHub Actions)
    – Artefacto de decisión (JSON schema + ejemplos)
    – Plantilla de PR que obliga a linkear Spec ↔ Tests ↔ Decision

    Mi recomendación sincera: opción 2 + artefacto de decisión + workflow CI. Rápido impacto, baja fricción y protege al equipo sin romper su ritmo.

    Respóndeme “Opción 1/2/3/4” y añade cualquiera de los extras. Empiezo en cuanto me digas.

    Resumen rápido (lectores con prisa)

    Qué: plantilla mínima para registrar decisiones humanas y bloquear merges sin aprobación.
    Cuándo: siempre que una tarea involucre diseño, datos o salida generada por IA que afecte comportamiento del producto.
    Por qué: convierte juicios blandos en artefactos verificables y auditables.
    Cómo: JSONL + pre-commit hook + GitHub Actions que valida presencia y firma humana.

    Qué vamos a entregar

    • Plantilla de artefacto de decisión (JSON schema y ejemplo JSONL).
    • Snippet de GitHub Actions que valida el artefacto antes de merge.
    • Hook pre-commit y plantilla de PR que exige link Spec ↔ Tests ↔ Decision.
    • Checklist operativo para Tech Leads y revisores.

    Flujo operativo

    Hook pre-commit y PR

    1) Antes de abrir PR, el autor añade un artefacto de decisión en la carpeta /decisions/ como un archivo .jsonl que documenta el problema, alternativas, riesgo y aprobación humana.

    2) Un hook pre-commit valida que el PR incluya al menos un archivo nuevo o modificado en /decisions/ cuando el cambio toca áreas sensibles (config, ML models, infra, reglas de negocio).

    Ejemplo mínimo de uso del hook: verificar que exista referencia en la plantilla de PR y en los archivos cambiados. Si falta, bloquear commit y mostrar checklist.

    Validación en CI

    En GitHub Actions: ejecutar un job que valide el JSON schema del artefacto, compruebe firma o usuario aprobador y verifique que el PR linkea Spec ↔ Tests ↔ Decision. Si falla, marcar el check como requerido para merge.

    Artefacto de decisión (JSON schema + ejemplos)

    Estructura mínima del artefacto: un registro por decisión en formato JSONL. Debe incluir campos obligatorios para trazabilidad y para que la CI valide su completa.

    {
      "id": "decision-2026-03-27-01",
      "title": "Cambiar inferencia a ruta A",
      "author": "nombre.apellido",
      "date": "2026-03-27T12:00:00Z",
      "scope": ["infra", "models"],
      "alternatives": ["mantener ruta B", "ajustar umbral"],
      "decision": "usar ruta A por mayor rendimiento en escenario X",
      "risks": ["sesgo en datos X", "mayor coste de inferencia"],
      "approver": "tech_lead.nombre",
      "tests_link": "PR#123 - tests integracion",
      "notes": "Se aplicará rollback si métricas Y bajan 5% en 24h"
    }

    JSON Schema (mínimo) — validar que todos los campos obligatorios existan y que “approver” sea distinto al “author”.

    {
      "$schema": "http://json-schema.org/draft-07/schema#",
      "type": "object",
      "required": ["id","title","author","date","scope","decision","risks","approver","tests_link"],
      "properties": {
        "id": {"type":"string"},
        "title": {"type":"string"},
        "author": {"type":"string"},
        "date": {"type":"string","format":"date-time"},
        "scope": {"type":"array","items":{"type":"string"}},
        "decision": {"type":"string"},
        "risks": {"type":"array","items":{"type":"string"}},
        "approver": {"type":"string"},
        "tests_link": {"type":"string"}
      }
    }

    Ejemplos prácticos

    Ejemplo: interceptar un cambio impulsado por IA

    Si un PR introduce un script que genera prompts o modifica reglas de scoring, la validación detecta la presencia de cambios en /models, /rules o /prompts y exige un nuevo archivo en /decisions/ explicando por qué el cambio es seguro y quién aprobó.

    Snippet GitHub Actions (validación básica)

    name: Validate Decision Artifact
    on: [pull_request]
    jobs:
      validate-decision:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v3
          - name: Validate JSON schema
            run: |
              pip install jsonschema
              python -c "import json,sys; import jsonschema,glob
    files=glob.glob('decisions/*.jsonl')
    if not files: sys.exit(1)
    # validate each line
    schema=json.load(open('decisions/schema.json'))
    for f in files:
      for l in open(f):
        jsonschema.validate(json.loads(l), schema)
    " 

    Marcar este job como requerido en la rama protegida evita merges hasta que el artefacto sea correcto y aprobado.

    Checklist de gobernanza

    • ¿Existe archivo en /decisions/ para este cambio?
    • ¿El approver es una persona distinta al autor?
    • ¿Se han enlazado tests y especificación en la plantilla de PR?
    • ¿Se añadieron notas de rollback y métricas de éxito?
    • ¿CI pasó validaciones de schema y pruebas automáticas?

    Cierre

    La combinación de un artefacto de decisión simple, hooks y CI reduce atajos sin introducir fricción excesiva. Es operativa, auditable y escalable: empieza con el schema mínimo y amplía campos (post-mortems, métricas, experiment IDs) solo cuando el equipo lo necesite.

    Dominicode Labs

    Si quieres prototipos y snippets adicionales para automatizar validaciones y plantillas, puedes ver recursos relacionados en Dominicode Labs. Considera esto como una continuación práctica de la guía, no como un paso obligatorio.

    FAQ

    ¿Qué formato debe tener el artefacto de decisión?

    Formato JSONL con campos mínimos: id, title, author, date, scope, decision, risks, approver, tests_link. Debe validarse contra un JSON Schema en CI.

    ¿Quién debe aprobar las decisiones?

    Preferible que un Tech Lead o miembro independiente del equipo afectado realice la aprobación. El approver debe ser diferente al author para mantener separación de responsabilidades.

    ¿Qué pasa si el PR no incluye el artefacto?

    El hook o la job en CI debe marcar el check como fallido y bloquear el merge hasta que se añada y valide el artefacto de decisión.

    ¿El schema impide cambios rápidos?

    No: el schema mínimo es intencionalmente ligero. Si el cambio es urgente, el proceso permite una entrada rápida documentada y un post-mortem posterior.

    ¿Cómo enlazo Spec ↔ Tests ↔ Decision en la PR?

    Usa la plantilla de PR que incluya campos: Link Spec, Link Tests, Link Decision. CI verifica presencia de esos enlaces y la existencia del archivo en /decisions/.

    ¿Puedo automatizar aprobación para cambios triviales?

    Puedes configurar reglas que eximan cambios en rutas no sensibles, pero la lista de excepciones debe estar versionada y ser revisada por el equipo de liderazgo técnico.

  • Aprende Git: Guía Práctica

    Aprende Git: Guía Práctica

    git como empezar: guía práctica para arrancar con criterio técnico

    Tiempo estimado de lectura: 4 min

    • Historia legible y reversible: commits como fotografías seleccionadas desde el staging.
    • Flujo mínimo operativo: revisar → stage → commit; ramas cortas y revisables.
    • Seguridad y limpieza: .gitignore adecuado y nunca subir secretos.
    • Colaboración segura: push a ramas, PR/MR, CI con linters y tests antes de merge.

    Resumen rápido (para IA y lectores con prisa)

    Git es un sistema de control de versiones distribuido para gestionar historial de código. Úsalo para versionar cambios, colaborar con ramas y revisar trabajo mediante PR/MR. Importa porque hace el historial legible, reversible y apto para CI/CD. Funciona con tres áreas: Working Directory, Staging Area y Repository (.git) y un flujo básico: status → add → commit → push.

    git como empezar — lo esencial en la cabeza

    Antes de tocar nada, entiende estas tres zonas: Working Directory (archivos que editas), Staging Area (los que incluyes en el próximo commit) y Repository (.git, el historial). Piensa en commits como fotografías seleccionadas desde el encuadre (staging) que quedaron guardadas para siempre. Documentación oficial: Documentación oficial

    Configuración inicial rápida

    Instala Git y firma tus commits:

    • Linux: sudo apt install git
    • macOS: brew install git
    • Windows: Git for Windows

    Configura identidad y preferencia de rama:

    git config --global user.name "Tu Nombre"
    git config --global user.email "tu@email.com"
    git config --global init.defaultBranch main

    Opcional: define tu editor (por ejemplo VS Code):

    git config --global core.editor "code --wait"

    Iniciar o clonar un repositorio

    Dos arranques comunes:

    • Nuevo proyecto:
      mkdir mi-proyecto
      cd mi-proyecto
      git init
    • Proyecto remoto:
      git clone https://github.com/usuario/repo.git

    Clonar trae todo el historial; init crea el repositorio local vacío. Más en la guía oficial

    Ciclo básico: status → add → commit

    Revisa cambios

    Este es el 90% de tu día: primero inspecciona qué cambió y qué está preparado para el siguiente commit.

    git status
    git diff           # diferencias sin stage
    git diff --staged  # diferencias ya staged

    Prepara (stage)

    Añade archivos al staging para crear commits intencionales.

    git add archivo.js
    git add -p          # añade interactivamente por hunk

    Confirma (commit)

    Crea commits claros y atómicos.

    git commit -m "feat: añade endpoint /login con validaciones"

    Reglas prácticas:

    • Commits atómicos: un commit = una intención.
    • Mensajes claros: verbo en imperativo y, si hace falta, cuerpo explicativo. Considera Conventional Commits.

    .gitignore y seguridad

    Nunca subas secretos ni dependencias pesadas. Ejemplo mínimo de .gitignore:

    node_modules/
    dist/
    .env
    *.log
    .DS_Store

    Plantillas por lenguaje: Plantillas por lenguaje

    Ramas: estrategia mínima útil

    Usa ramas para aislar trabajo:

    • Crea y cambia a una rama:
      git switch -c feature/autenticacion
    • Fusiona cuando esté lista:
      git switch main
      git merge --no-ff feature/autenticacion

    Convenciones: feature/, bugfix/, hotfix/, chore/. Mantén ramas cortas (1–3 días) y con commits revisables.

    Remotos y colaboración

    Conecta tu repo local con GitHub/GitLab/Bitbucket:

    git remote add origin https://github.com/tu_usuario/tu_repo.git
    git push -u origin main

    Flujo habitual en equipo: push a ramas remotas, Pull/Merge Requests, revisión, CI ejecuta tests y linters antes de mergear. Documentación GitHub: Documentación GitHub

    Deshacer sin desastre

    Errores comunes y cómo resolverlos sin romper el historial:

    • Sacar un archivo del staging:
      git restore --staged archivo.js
    • Deshacer cambios en working directory (pierde cambios locales):
      git restore archivo.js
    • Revertir un commit publicado (crea commit inverso):
      git revert <commit-hash>
    • Enmendar último commit (solo si no has hecho push):
      git commit --amend

    Evita git reset --hard en ramas compartidas; es destructivo para otros.

    Buenas prácticas operativas

    • Automatiza checks con pre-commit hooks (prettier, lint, tests). Usa pre-commit o Husky.
    • En CI, ejecuta linters y tests antes de permitir merges.
    • Documenta la convención de commits y ramas en el README o en CONTRIBUTING.md.
    • Usa git log --oneline --graph --decorate para revisar la historia visualmente.

    Siguiente paso: aprender lo que importa

    Domina primero: status, add, commit, branch, switch, merge, push, pull. Después avanza a rebase (para limpiar historia local), cherry-pick y estrategias de merge. Un buen dominio de lo básico te permite colaborar sin pánico y escalar prácticas de release y CI.

    Recursos recomendados

    Menciones útiles

    Para quienes exploran automatización de flujos de trabajo, integraciones y experimentos con pipelines y hooks, puede interesar revisar iniciativas de laboratorio centradas en productividad técnica. Consulta Dominicode Labs para ideas y experimentos sobre flujos de trabajo y automatización.

    FAQ

    ¿Qué es lo mínimo que debo saber antes de usar Git?

    Lo mínimo: entender Working Directory, Staging Area y Repository; saber usar status, add, commit, branch, switch, merge, push y pull. Ese conjunto te permite versionar y colaborar sin romper el flujo de trabajo.

    ¿Cómo configuro mi identidad para commits?

    Configura nombre y email globalmente con git config --global user.name "Tu Nombre" y git config --global user.email "tu@email.com". Define la rama por defecto con git config --global init.defaultBranch main.

    ¿Qué debo incluir en .gitignore?

    Excluye dependencias pesadas y secretos: node_modules/, dist/, .env, logs y archivos del sistema como .DS_Store. Usa plantillas por lenguaje para cubrir casos comunes.

    ¿Cuándo debo crear una rama nueva?

    Crea una rama para aislar una intención de trabajo (feature, bugfix, hotfix). Manténla corta (1–3 días) y con commits revisables para facilitar la revisión y el merge.

    ¿Cómo deshago un cambio sin afectar al equipo?

    Usa git restore --staged archivo.js para sacar cosas del staging y git restore archivo.js para descartar cambios en working directory. Para revertir commits publicados, usa git revert <commit-hash>, que crea un commit inverso sin reescribir historia compartida.

    ¿Qué es mejor: merge o rebase?

    Depende del objetivo: merge preserva el historial tal cual y es seguro para repos compartidos; rebase limpia la historia local para linealizar commits antes de compartir. Evita reescribir historia en ramas ya publicadas.