Tag: Gemini

  • Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

    Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

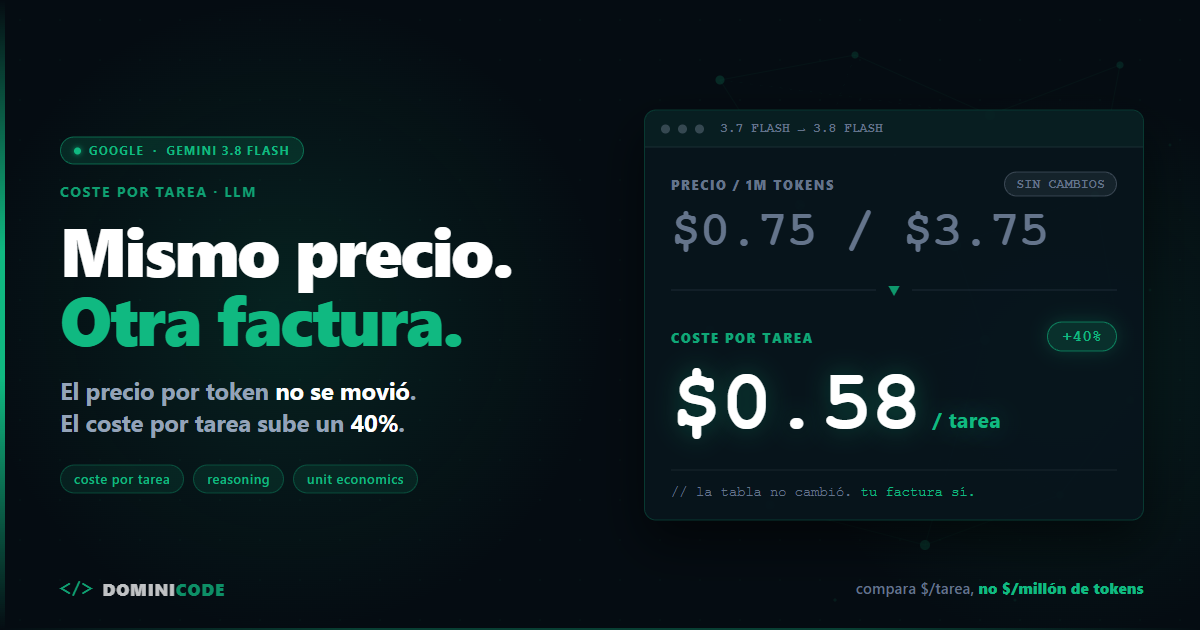
    Google anunció Gemini 3.8 Flash el 2 de septiembre de 2026 con el mismo precio por token que su antecesor: $0.75 por millón de tokens de entrada y $3.75 de salida. Ni un céntimo de diferencia en la tabla de precios.

    Artificial Analysis lo midió ese mismo día. El coste real por tarea completada de Gemini 3.8 Flash es un 40% más alto que el de Gemini 3.7 Flash.

    No es un error de facturación. Es el modelo haciendo exactamente lo que Google prometió: pensar más. Y pensar más se paga en tokens de salida.

    Esa es la parte del anuncio del 2 de septiembre que casi nadie está contando. Google presentó el modelo más barato jamás medido a ese nivel de inteligencia y, al mismo tiempo, subió el coste real de cada tarea un 40%. Las dos frases son verdad. Solo una te llega a la tarjeta.

    La tesis de este post: deja de comparar modelos por dólares por millón de tokens y empieza a compararlos por dólares por tarea completada. El precio por token lo pone el proveedor en una tabla. El coste por tarea lo pones tú con tu arquitectura, y la palanca que de verdad controlas se llama nivel de reasoning.

    El coste por tarea es el gasto total en tokens —entrada, salida y razonamiento— dividido entre el número de tareas que terminan con una salida válida. No entre llamadas a la API: entre tareas completadas.


    Qué es Gemini 3.8 Flash y qué lanzó Google el 2 de septiembre de 2026

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026 junto a Gemini 3.8 Flash Cyber, una variante restringida especializada en ciberseguridad. Es el cuarto modelo Flash que Google publica en menos de cuatro meses. Ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026. Disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    En benchmarks aguanta el pulso a modelos que cuestan casi siete veces más por token: 73,7% en DeepSWE v1.1 frente al 74,0% de Claude Opus 5, 54,9% en HLE-Verified y un 59 en el Artificial Analysis Intelligence Index, donde empata con GPT-5.6 Sol y Grok 4.6. También supera a modelos frontera mayores en Vals Finance Agent V2 y en el Harvey's Legal Agent Benchmark, que son evals de trabajo profesional, no de acertijos.

    Ese 73,7% contra el 74,0% de Opus 5 es la noticia de verdad. Es la misma tendencia que ya se veía en la comparativa de Opus 5, GPT-5.6 y Kimi K3 y en el repaso de Grok 4.5, Fable 5 y DeepSeek V4 para programar: la distancia entre la gama alta y la gama media se cierra por abajo.

    Hay otro dato que me importa. En el Gray Swan IPI, que mide robustez frente a inyección indirecta de prompts, un 5,5% de los ataques tuvo éxito: más de uno de cada veinte intentos. Si tu agente lee contenido que no controlas, ese 5,5% es tu problema, y se resuelve con defensas contra inyección indirecta de prompts, no con fe en el modelo.


    Cuánto cuesta Gemini 3.8 Flash: el precio por token es marketing, el coste por tarea es tu factura

    Aquí está la contradicción, medida de forma independiente por Artificial Analysis:

    Métrica Gemini 3.7 Flash Gemini 3.8 Flash
    Precio entrada / salida (por 1M tokens) $0.75 / $3.75 $0.75 / $3.75
    Tokens de salida por tarea referencia 48.000 (+30%)
    Coste por tarea, high reasoning referencia $0.58 (~+40%)

    Lee la tabla dos veces. La fila del precio no se mueve. La fila que pagas sube un 40%.

    Y ojo con el desglose, porque ese 30% de salida no explica por sí solo el 40% de subida. Con 48.000 tokens de salida a $3.75 el millón, la salida son unos $0.18 de los $0.58: el resto es entrada. Lo que dispara la factura son los turnos. Cada vuelta extra del agente reenvía el contexto acumulado, así que más razonamiento no solo genera más tokens de salida, también multiplica los de entrada. Por eso un +30% de salida termina en un +40% de coste por tarea.

    $0.58 por tarea del Intelligence Index es, según esa misma medición, el coste más bajo jamás registrado a ese nivel de inteligencia. El titular es justo. Pero si vienes de 3.7 Flash con un producto en marcha, tu unit economics acaba de empeorar un 40% sin que hayas tocado una línea de código. Es el mismo patrón que ya conté con el coste de los subagentes al cambiar de modelo: la factura se mueve sola cuando cambia el comportamiento del modelo, no cuando cambias tú el código.

    Del coste por tarea de Opus 5 o GPT-5.6 Sol no doy cifra porque no la tengo medida con el mismo eval, y compararlas de oído sería justo el error que denuncia este post. Lo público es el precio por token: Opus 5 cuesta $5.00 y $25.00 por millón, GPT-5.6 Sol $4.00 y $20.00. Sirve para situar la escala, no para decidir.

    Todas las cifras de coste de este post proceden de la medición independiente publicada por Artificial Analysis el 2 de septiembre de 2026, y los precios del anuncio oficial de Google de esa misma fecha. Verificadas el 3 de septiembre de 2026. Son precios introductorios: expiran el 31 de diciembre de 2026.


    Por qué sube el coste por tarea de Gemini 3.8 Flash: 48.000 tokens de salida

    La causa está publicada y no tiene misterio. Gemini 3.8 Flash gasta una media de 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y da más turnos en las evals agénticas.

    Traducido: razona más pasos antes de responder. Ese razonamiento se factura como salida, que es el token caro. A $3.75 el millón, cada vuelta extra de pensamiento tiene precio.

    Y no solo pagas más: esperas más. Artificial Analysis midió que el tiempo medio por tarea en high reasoning sube de 2,2 a 2,5 minutos. Un 14% más de latencia en cada tarea de tu producto, que con un usuario delante se nota antes que en la factura.

    Y si trabajas en español el efecto se acumula: el mismo contenido consume más tokens que en inglés por cómo funciona el tokenizador, algo que desglosé en el post sobre cuánto te cuesta de más escribir en español. Más tokens por razonar, multiplicado por más tokens por idioma, sobre el token que más caro se paga.


    Cómo medir tu coste por tarea real

    Para dejar de discutir con tablas de precios ajenas solo hace falta contar el usage de cada respuesta y dividirlo entre tareas completadas. No entre llamadas: entre tareas que terminaron bien.

    // task-meter.ts — mide lo que pagas, no lo que anuncia el pricing
    type Usage = { input: number; output: number };
    
    // Precio introductorio de Gemini 3.8 Flash (hasta el 31/12/2026), USD por token
    // Desde el 01/01/2027: { input: 1.50 / 1_000_000, output: 7.50 / 1_000_000 }
    const PRICE = { input: 0.75 / 1_000_000, output: 3.75 / 1_000_000 };
    
    type ApiResponse = Record<string, any>;
    
    // Los tokens de razonamiento se facturan como salida: súmalos siempre.
    function readUsage(res: ApiResponse): Usage {
      const u = res.usageMetadata ?? res.usage ?? {};
      return {
        input: u.promptTokenCount ?? u.input_tokens ?? 0,
        output: (u.candidatesTokenCount ?? u.output_tokens ?? 0) + (u.thoughtsTokenCount ?? 0),
      };
    }
    
    export class TaskMeter {
      private input = 0;
      private output = 0;
      private tasks = 0;
    
      track(res: ApiResponse) {
        const { input, output } = readUsage(res);
        this.input += input;
        this.output += output;
      }
    
      // Solo cuenta la tarea si el resultado es válido de verdad.
      completed() {
        this.tasks += 1;
      }
    
      report() {
        const cost = this.input * PRICE.input + this.output * PRICE.output;
        // Sin tareas completadas no hay media: devuelve el gasto en bruto, no NaN.
        if (this.tasks === 0) {
          return { tareas: 0, outputPorTarea: 0, costePorTarea: 0, costeTotal: +cost.toFixed(4) };
        }
        return {
          tareas: this.tasks,
          outputPorTarea: Math.round(this.output / this.tasks),
          costePorTarea: +(cost / this.tasks).toFixed(4),
          costeTotal: +cost.toFixed(4),
        };
      }
    }
    

    El detalle que separa esta métrica de un contador inútil está en completed(). Una tarea cuenta cuando la salida pasa tu validación, no cuando la API devuelve 200. Si el modelo responde un JSON que tu esquema rechaza, has pagado tokens y no has completado nada: eso encarece el coste por tarea, y así debe ser. Yo cierro ese bucle con un safeParse de Zod antes de llamar a completed(), que es justo el tipo de frontera que trabajo en el curso de validación y transformación de datos con Zod.

    Un aviso para que no te asustes de tu propio medidor: promptTokenCount incluye los tokens servidos desde caché de contexto, que se facturan más baratos. Si usas caching, el número que saques será algo pesimista.

    Ejecútalo una semana con tu carga real y tendrás un número que ninguna nota de prensa te puede dar. Para el instrumental completo, con desglose por turno y por herramienta, tienes la guía para medir el consumo de tokens de un agente de IA.


    Niveles de reasoning en Gemini 3.8 Flash: cuándo usar high, medium o low

    El nivel de reasoning es la palanca de coste más grande que tienes, y la mayoría de proyectos la dejan clavada en el máximo por defecto. Los tres niveles medidos por Artificial Analysis el 2 de septiembre de 2026, sobre las mismas tareas del Intelligence Index:

    Nivel de reasoning Intelligence Index Coste por tarea Ahorro vs high
    high 59 $0.58 —
    medium 57 $0.41 −29%
    low 52 $0.24 −59%

    Ahí está el argumento entero en dos números: bajar de high a medium te ahorra un 29% del coste por tarea y cuesta 2 puntos de Intelligence Index, 57 frente a 59. Bajar a low ahorra un 59% y cuesta 7 puntos. Si tu tarea se valida con un esquema, esos 7 puntos no los vas a notar; el 59% sí.

    Mi regla por defecto, la misma que aplico con cualquier modelo que exponga niveles de razonamiento:

    • Low para clasificar, extraer campos, enrutar y resumir. Si puedes validar el resultado con un esquema, no necesitas que el modelo medite.
    • Medium para el trabajo normal de un agente: varios pasos, alguna herramienta, contexto moderado. Este es el defecto sensato, no high.
    • High solo para razonamiento largo con estado, donde un error a mitad de camino te obliga a repetir la tarea entera. Ahí el sobrecoste frente a medium se paga solo, porque un reintento cuesta más que el ahorro.

    Y la consecuencia que a mucha gente se le escapa: si tu producto es un agente de varios pasos, no tienes que elegir un nivel único. Enruta por paso. La extracción va en low, la decisión difícil va en high. Esa granularidad es la diferencia entre un margen sano y uno que se come el precio del plan, y es una de las decisiones de arquitectura que más repito en el curso de Construye con IA.

    En la Gemini API el nivel se fija con thinking_level dentro de generation_config, y acepta low, medium y high:

    const res = await client.interactions.create({
      model: "gemini-3.8-flash",
      input: prompt,
      generation_config: { thinking_level: process.env.GEMINI_THINKING_LEVEL ?? "medium" },
    });
    

    Que salga de una variable de entorno no es cosmético: es lo que te deja bajar el nivel en producción sin desplegar, el día que veas la factura del primer mes.


    El 1 de enero de 2027 te duplica la factura

    Los $0.75 y $3.75 son precio introductorio hasta el 31 de diciembre de 2026. El 1 de enero de 2027 pasan a $1.50 de entrada y $7.50 de salida por millón, según la tabla de precios oficial de la Gemini API. El doble.

    Si estás construyendo un producto y calculas márgenes con el precio de hoy, tienes hasta el 31 de diciembre de espejismo. Un SaaS con un plan de $19 al mes que hoy deja margen holgado puede quedarse en pérdidas el 1 de enero sin que nadie haya tocado nada.

    Con 10.000 tareas al mes, el mismo código y sin tocar nada:

    Nivel de reasoning Factura mensual hoy Factura mensual desde el 1/1/2027
    high $5.800 $11.600
    medium $4.100 $8.200
    low $2.400 $4.800

    Fíjate en la diagonal: pasar de high a medium el 1 de enero te deja en $8.200, todavía por encima de los $5.800 que pagas hoy en high. Bajar un nivel no compensa la subida de precio. Bajar dos, sí.

    Haz el cálculo ahora con el precio de 2027. Si con $1.50 y $7.50 tu unit economics sigue en pie, adelante. Si no, tienes hasta el 31 de diciembre para bajar niveles de reasoning, recortar contexto o cambiar de modelo, que es mucho mejor que enterarte en enero. Este supuesto debería estar escrito en la spec antes de programar nada, con su fecha y su número, como planteo en el libro de Spec-Driven Development.

    Aun con el precio duplicado sigue siendo más barato por token que Opus 5 o GPT-5.6 Sol. Pero "más barato que el más caro" no es un modelo de negocio.


    Gemini 3.8 Flash Cyber y el Fairwind Program: el modelo que no puedes usar

    Gemini 3.8 Flash Cyber es la variante especializada en seguridad y tiene los mejores números del anuncio: 86,2% en CyberGym, que mide detección de vulnerabilidades en C y C++, frente al 77,5% de 3.5 Flash Cyber, el 83,6% de GPT-5.6 Sol y el 85,6% de GPT-5.5-Cyber. En CWE-Bench, parcheo automatizado, marca un 47,2% pass@1 frente al 47,8% del modelo frontera líder, pero a un coste muy inferior. Y supera el 70% de éxito descubriendo vulnerabilidades reales.

    No tienes acceso. Se distribuye por el Fairwind Program a organismos gubernamentales, operadores de infraestructura crítica y mantenedores de software.

    Lo cuento sin drama porque la decisión me parece defendible: un modelo que encuentra vulnerabilidades reales con esa tasa de acierto es igual de bueno encontrándolas para arreglarlas que para explotarlas. Es el mismo patrón de acceso restringido que vimos con Claude Mythos 5.1 y su programa por invitación.

    Lo que sí te llevas es información: si un modelo restringido ya está en el 70% de descubrimiento real, asume que la capacidad ofensiva del otro lado también ha subido. La defensa de tu agente no puede ser que nadie mire. Empieza por los guardrails para agentes con acceso a terminal y base de datos, que es donde más daño se hace.


    Qué hacer con esto hoy

    Instrumenta el coste por tarea antes de cambiar de modelo. Media hora de trabajo: un contador de usage dividido entre tareas que pasan tu validación. A partir de ahí, elegir modelo deja de ser una discusión de opiniones sobre benchmarks ajenos.

    Con ese número, la pregunta ya no es si Gemini 3.8 Flash es más barato que Opus 5, sino cuánto te cuesta a ti completar una tarea, en tu dominio, con tu prompt, en tu idioma. Ahí se gana o se pierde el margen.

    Si quieres ver este instrumental montado sobre proyectos reales, con enrutado por nivel de reasoning y métricas de coste en producción, es de lo que hablamos cada semana en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es Gemini 3.8 Flash?

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026. Tiene una ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026, y ofrece tres niveles de reasoning (low, medium y high) que cambian tanto la calidad como el coste. Está disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    ¿Merece la pena migrar de Gemini 3.7 Flash a Gemini 3.8 Flash?

    Depende de si tu carga aprovecha el razonamiento extra. Gemini 3.8 Flash puntúa más alto en benchmarks agénticos, pero al mismo precio por token consume 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y encadena más turnos, así que el coste por tarea sube alrededor de un 40%. Si tus tareas son clasificación, extracción o enrutado, quédate en 3.7 Flash o migra a 3.8 Flash con el reasoning en low; si son cadenas largas con herramientas donde un fallo obliga a repetir todo el trabajo, la migración se paga sola.

    ¿Cuánto cuesta realmente Gemini 3.8 Flash?

    Depende de qué midas. Por token, $0.75 la entrada y $3.75 la salida por millón, precio introductorio hasta el 31 de diciembre de 2026. Por tarea completada del Intelligence Index de Artificial Analysis, $0.58 con high reasoning, $0.41 con medium y $0.24 con low. La segunda cifra es la que se parece a tu factura.

    ¿Por qué sube el coste por tarea si el precio por token no ha cambiado?

    Porque el modelo genera más tokens. Gemini 3.8 Flash gasta 48.000 tokens de salida por tarea de media, un 30% más que 3.7 Flash, y ejecuta más turnos en tareas agénticas. Ese 30% de salida, más el contexto que se reenvía en cada turno extra y que se factura como entrada, deja el coste por tarea alrededor de un 40% por encima aunque la tabla de precios sea idéntica.

    ¿Qué pasa el 1 de enero de 2027 con el precio?

    Se acaba el precio introductorio y pasa a $1.50 de entrada y $7.50 de salida por millón: exactamente el doble. Si has calculado los márgenes de tu producto con el precio de 2026, rehaz los números con los de 2027 antes de fijar tus planes de precios.

    ¿Puedo usar Gemini 3.8 Flash Cyber?

    Salvo que trabajes en un organismo gubernamental, en un operador de infraestructura crítica o mantengas software ampliamente usado, no. Se distribuye únicamente a través del Fairwind Program. No hay endpoint público ni precio publicado, así que tu referencia para trabajar hoy es Gemini 3.8 Flash estándar.

    ¿Es Gemini 3.8 Flash mejor que Claude Opus 5 para programar?

    En DeepSWE v1.1 saca 73,7% frente al 74,0% de Opus 5: prácticamente empate, con Opus 5 a $5.00 y $25.00 por millón frente a $0.75 y $3.75. Para la mayoría de cargas, esa diferencia de tres décimas no justifica el sobrecoste. Para razonamiento muy largo donde un fallo obliga a repetirlo todo, mídelo con tu propio coste por tarea antes de decidir.

    ¿Qué nivel de reasoning debería usar por defecto?

    Medium, no high. Reserva high para tareas largas con estado donde un error a mitad de camino te obliga a rehacer el trabajo entero, y baja a low todo lo que tenga una respuesta verificable con un esquema. Si tu agente tiene varios pasos, enruta el nivel paso a paso en lugar de fijar uno global.

    ¿Cómo se cambia el nivel de reasoning en la Gemini API?

    Con el parámetro thinking_level dentro de generation_config, que en Gemini 3.8 Flash acepta los valores low, medium y high. Una llamada quedaría como generation_config: { thinking_level: "medium" } junto al modelo y el prompt. Léelo siempre de una variable de entorno en lugar de escribirlo a fuego en el código: es lo que te permite bajar el nivel en producción sin desplegar cuando el coste por tarea se dispare.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Integración de Gemini Nano con Angular para IA Local en el Navegador

    Integración de Gemini Nano con Angular para IA Local en el Navegador

    Integración de Gemini Nano con Angular: IA Local en el Navegador

    Tiempo estimado de lectura: 5 min

    Ideas clave

    • Gemini Nano puede ejecutarse on-device en Chrome mediante la Prompt API / LanguageModel API experimental, evitando enviar datos a la nube.
    • Recomienda abstraer el acceso a window.LanguageModel en un servicio Angular inyectable y exponer estados reactivos con Signals.
    • Implementa fallback a la nube (Vertex AI, OpenAI, etc.) si el modelo on-device no está disponible.
    • Prepárate para descargas iniciales de pesos, impacto en recursos del cliente y cambios en la API; ofrece métricas y UX claras.

    Tabla de contenidos

    Resumen rápido (lectores con prisa)

    Gemini Nano permite ejecutar modelos de lenguaje on-device en Chrome mediante una Prompt API experimental. Úsalo para operaciones sensibles a la privacidad y bajas latencias; diseña un servicio Angular que abstraiga window.LanguageModel, exponga estados con Signals y ofrezca fallback a la nube.

    Qué necesitas activar y por qué importa

    Gemini Nano llega al frontend vía la Prompt API / LanguageModel API que Chrome está probando. Es experimental: hay que habilitar flags y aceptar descargas iniciales del modelo en el cliente. Hazlo solo en entornos controlados.

    Puntos prácticos

    • Abre chrome://flags y habilita las flags relacionadas con Prompt API (busca “Prompt API” / “on-device model”).
    • Revisa chrome://components y chrome://on-device-internals para estado y métricas.
    • La primera ejecución puede descargar pesos (depende de la build). Avisa al usuario con un estado de “descarga en progreso”.

    Referencias útiles

    Arquitectura recomendada en Angular

    Regla número uno: no uses window directamente en componentes. Abstrae todo en un servicio inyectable que gestione disponibilidad, descarga y sesión. Usa Signals para exponer estados reactivos y facilitar la integración con componentes.

    global.d.ts (tipos mínimos)

    declare global {
      interface Window {
        LanguageModel?: {
          availability(options?: any): Promise;
          create(options?: any): Promise;
        };
      }
    }
    export {};

    Servicio Angular (esqueleto)

    import { Injectable, signal } from '@angular/core';
    
    @Injectable({ providedIn: 'root' })
    export class GeminiNanoService {
      isAvailable = signal<'checking'|'available'|'unavailable'>('checking');
      isReady = signal(false);
      private session: any = null;
    
      constructor() {
        this.checkAvailability();
      }
    
      async checkAvailability() {
        if (!window.LanguageModel) {
          this.isAvailable.set('unavailable');
          return;
        }
        try {
          const status = await window.LanguageModel.availability({
            expectedInputs:[{type:'text'}], expectedOutputs:[{type:'text'}]
          });
          this.isAvailable.set(status === 'available' ? 'available' : 'unavailable');
          if (this.isAvailable() === 'available') await this.init();
        } catch {
          this.isAvailable.set('unavailable');
        }
      }
    
      private async init() {
        this.session = await window.LanguageModel!.create({
          // monitor: callback para progreso de descarga si aplica
        });
        this.isReady.set(true);
      }
    
      async prompt(text: string, opts?: any) {
        if (!this.session || !this.isReady()) throw new Error('Gemini Nano no listo');
        return await this.session.prompt(text, opts);
      }
    }

    Usa APP_INITIALIZER si quieres bloquear rutas hasta que la disponibilidad esté verificada.

    Patrones de uso: Resúmenes y Smart Paste

    Dos patrones repetibles son útiles: resúmenes client-side y Smart Paste para estructurar texto del portapapeles. Úsalos cuando la privacidad y la latencia local sean prioritarias.

    1) Resúmenes client-side

    • Ideal para emails, tickets y documentación sensible.
    • Prompt corto, instrucciones claras y límites (p. ej. “tres bullets”).
    const prompt = `Resume en 3 viñetas técnicas, sin ejemplos ni explicaciones: ${longText}`;
    const summary = await geminiService.prompt(prompt);

    2) Smart Paste (estructurar texto del portapapeles)

    Intercepta ClipboardEvent, manda el texto al modelo y pide JSON estricto. Valida con JSON.parse y aplica patchValue en FormGroup.

    Ejemplo de prompt:

    Extrae nombre, cargo, empresa y teléfono del texto y responde SOLO con JSON válido.
    Texto: "..."

    Consejo: limpia la respuesta de bloques de código (“`json) antes de parsear.

    Estrategia híbrida: fallback a la nube

    La API es experimental y puede no estar disponible en todos los usuarios. Diseña un fallback:

    • Servicio expone promptLocal() y promptCloud().
    • Lógica: si isReady() → local; si no → cloud (Vertex AI, OpenAI, etc.).
    • Mantén la misma interfaz para consumidores.
    async prompt(input:string){
      return this.isReady() ? this.promptLocal(input) : this.promptCloud(input);
    }

    Limitaciones y decisiones técnicas

    No es magia. Decide por criterios claros:

    • Privacidad vs Capacidad: on-device evita enviar datos, pero modelos locales suelen ser más limitados en razonamiento y factualidad.
    • Recursos del cliente: descarga inicial y uso de RAM/GPU. Ofrece UI de progreso y posibilidad de desactivar la característica.
    • Inestabilidad: la API puede cambiar; encapsula y prueba en Canary/Dev builds.

    Buenas prácticas de implementación

    • Aisla feature flags para habilitar/deshabilitar en producción.
    • Expón métricas de adopción y errores (no datos sensibles).
    • Documenta UX: indica cuándo la funcionalidad requiere descarga y ofrece opción “Usar IA en la nube”.
    • Testea en dispositivos representativos de tus usuarios (PCs y Chromebooks, no asumas móviles).

    La integración de Gemini Nano con Angular no es un truco de marketing: es una arquitectura pragmática para reducir latencia, mejorar privacidad y sacar tareas concretas del backend. Implementa la abstracción, prevé el fallback y deja el modelo decidir cuándo merece la pena correr on-device. Esto apenas comienza: prueba en controlado, mide impacto y ajusta el balance on-device / cloud.

    Dominicode Labs ofrece un espacio para experimentar con integraciones de IA aplicada y workflows relacionados; puede servir como referencia para pruebas controladas y métricas de adopción.

    FAQ

    ¿Qué es Gemini Nano en el contexto del navegador?

    Es una implementación on-device de modelos de lenguaje accesible mediante la Prompt API / LanguageModel API experimental de Chrome, que permite ejecutar inferencia local en el navegador sin enviar datos a la nube.

    ¿Qué flags y páginas de Chrome debo revisar?

    Habilita las flags relacionadas con Prompt API en chrome://flags y revisa estado y métricas en chrome://components y chrome://on-device-internals.

    ¿Cómo debo abstraer la API en Angular?

    Crea un servicio inyectable que gestione disponibilidad, descarga y sesión; no uses window directamente en componentes. Exponer estados con Signals facilita la integración reactiva y el bloqueo de rutas con APP_INITIALIZER si es necesario.

    ¿Cuándo usar fallback a la nube?

    Implementa fallback cuando isReady() sea false o cuando el dispositivo no soporte la ejecución on-device. Mantén la misma interfaz para que consumidores no distingan origen (local vs cloud).

    ¿Qué impacto tiene en recursos del cliente?

    Puede requerir descarga inicial de pesos y uso adicional de RAM/GPU. Ofrece UI de progreso, opción para desactivar la característica y prueba en dispositivos representativos.

    ¿Cómo validar respuestas estructuradas como JSON?

    Pide al modelo que responda SOLO con JSON válido, limpia posibles bloqueos de código (“`json) y usa JSON.parse para validar antes de aplicar patchValue en formularios.

  • Automatizando el marketing técnico con NotebookLM, Gemini y Lovable

    Automatizando el marketing técnico con NotebookLM, Gemini y Lovable

    ¿Cómo podemos utilizar Lovable, NotebookLM y Gemini para hacer marketing?

    Si quieres saber cómo podemos utilizar Lovable, NotebookLM y Gemini para hacer marketing, la respuesta es simple: conviértelo en software. No en posts bonitos ni en ebooks olvidados. En herramientas que extraen insight, toman decisiones y se publican en horas.

    Esto no es teoría. Es un pipeline práctico para equipos técnicos que quieren captar leads cualificados sin secuestrar a todo el equipo de ingeniería.

    Resumen rápido (lectores con prisa)

    NotebookLM extrae el Voice of Customer desde documentos y issues. Gemini transforma esos insights en lógica accionable y variantes de copy. Lovable convierte la lógica en apps y landing pages listas para desplegar. Orquesta todo con n8n para crear assets que atraen y convierten en horas.

    Tiempo estimado de lectura: 4 min

    • Ideas clave:
    • Convierte feedback y docs en productos interactivos para captar leads.
    • NotebookLM para curación y extracción de Voice of Customer.
    • Gemini para arquitectura, lógica y variantes de copy.
    • Lovable para generar y desplegar aplicaciones rápidas y editables.

    NotebookLM: escuchar con precisión (sin ruido)

    NotebookLM es un RAG hecho para tus documentos. Le das transcripciones, issues, tickets, whitepapers y te devuelve patrones y frases exactas usadas por tus usuarios.

    Usos

    • Extraer el Voice of Customer desde issues de GitHub.
    • Priorizar problemas reales en vez de suposiciones de producto.
    • Convertir docs técnicos en formatos aprovechables: resúmenes, snippets para copy, o audio-overviews para redes.

    Ejemplo rápido

    Subes 50 issues sobre n8n y obtienes una tabla con los top 5 frictions. Esa tabla es tu brief de copy. No adivinaciones. Frases literales que venden a desarrolladores.

    Gemini: pensar a escala y automatizar decisiones

    Gemini es el cerebro analítico. Ventana de contexto grande, multimodal y capaz de razonamiento estructurado. Ideal para transformar los insights de NotebookLM en lógica accionable.

    Lo que hace bien

    • Analiza CSVs de Google Ads y detecta anomalías.
    • Genera pseudocódigo, fórmulas y variantes A/B basadas en datos reales.
    • Se integra vía API en flujos (n8n) para automatizar respuestas, crear alerts o redactar copies dinámicos.

    Ejemplo

    Gemini recibe la tabla de frictions y genera la lógica de una calculadora de ROI: fórmula, inputs necesarios, rangos y textos para cada umbral. También sugiere 4 variantes de CTA optimizadas para devs.

    Lovable: convertir lógica en producto, rápido

    Lovable es la herramienta que reduce a horas lo que antes eran sprints de frontend. Genera aplicaciones (React/Next.js, Tailwind, Supabase) a partir de especificaciones y pseudocódigo.

    Por qué lo usas

    • Despliegas lead magnets interactivos (calculadoras, auditores, generadores de snippets).
    • Obtienes código listo para deploy en Vercel y editable en VS Code.
    • Validación rápida: pruebas hipótesis con usuarios reales sin pedir un ticket a producto.

    Limitación real

    Integración avanzada (auth SSO, backends complejos) requiere revisión humana. Lovable acelera el 80% del trabajo; el 20% crítico lo debes revisar.

    Pipeline operativo: de insight a conversión en horas

    El flujo que funciona en equipos técnicos:

    • 1. NotebookLM (curación)
      • Input: transcripciones, issues, reseñas.
      • Output: pain points priorizados y quotes.
    • 2. Gemini (arquitectura y copy)
      • Input: pain points.
      • Output: pseudocódigo, lógica de producto, 4 variantes de copy/CTA, estructura de datos.
    • 3. Lovable (despliegue)
      • Input: pseudocódigo y copy.
      • Output: app web / landing / calculadora desplegada con tracking y formulario para leads.

    Orquestación

    Usa n8n para conectar todo. Ejemplo de flujo:

    • Trigger: subida de CSV con feedback → n8n envía a NotebookLM.
    • NotebookLM devuelve insights → n8n pasa resultados a Gemini.
    • Gemini produce el spec → n8n lanza un job en Lovable y crea un draft en tu repo.
    • Deploy automático y webhook que añade leads al CRM.

    Resultado: un asset técnico que atrae tráfico orgánico y convierte mejor que un PDF.

    Cuándo usar este stack (y cuándo no)

    Usa este stack si

    • Buscas tráfico cualificado (devs, tech leads, founders).
    • Tienes datos dispersos y necesitas señales claras.
    • Quieres validar ideas con prototipos interactivos sin bloquear ingeniería.

    No lo uses si

    • Tus necesidades son puramente offline o brand-driven.
    • No tienes datos ni documentos que alimentar a NotebookLM.
    • Requieres integraciones SSO complejas desde el día 1.

    Criterio práctico y riesgos

    • Evita la alucinación: mantén NotebookLM limitado a tus fuentes verificadas.
    • Revisa siempre el código generado por Lovable en seguridad y escalabilidad.
    • Considera costes y cuota de uso de Gemini si vas a procesar grandes volúmenes de datos.

    En equipos que hemos visto aplicar esto, el time-to-market de una campaña técnica baja hasta un 70% y las conversiones de lead magnets interactivos suben notablemente frente a contenido estático.

    Implementa esto en tu próximo experimento: exporta feedback real → pásalo por NotebookLM → diseña la lógica con Gemini → despliegue rápido con Lovable. Despúes, mide y repite. Esto no acaba aquí; es el patrón que escala cuando el marketing deja de ser humo y se convierte en producto.

    Para equipos que trabajan en automatización, IA aplicada y workflows técnicos, una continuación natural de este enfoque es revisar recursos y experimentos en Dominicode Labs.

    FAQ

    ¿Qué tipos de documentos debo alimentar a NotebookLM?

    Transcripciones, issues, tickets, whitepapers, reseñas y cualquier fuente de feedback directo de usuarios. El enfoque es limitar NotebookLM a fuentes verificadas para evitar ruido.

    ¿Cómo conecta Gemini con n8n y Lovable?

    Gemini produce pseudocódigo, fórmulas y especificaciones que n8n puede transferir a Lovable vía API. n8n orquesta la secuencia: enviar inputs, recibir spec y lanzar jobs de despliegue.

    ¿Qué limita a Lovable en producción?

    Integraciones avanzadas como auth SSO y backends complejos requieren revisión humana. Lovable acelera la mayor parte del trabajo, pero el 20% crítico debe ser inspeccionado y adaptado por ingeniería.

    ¿Cuánto reduce el time-to-market este pipeline?

    En equipos que han aplicado este enfoque, el time-to-market de una campaña técnica baja hasta un 70% y las conversiones de lead magnets interactivos suben frente a contenido estático.

    ¿Cómo evito alucinaciones en NotebookLM?

    Mantén NotebookLM limitado a tus fuentes verificadas y evita inyectar datos no confiables. Curación de fuentes y validación humana son necesarias para minimizar errores.

    ¿Necesito un equipo de ingeniería para usar este stack?

    Puedes desplegar la mayor parte del stack con flujos automatizados, pero se recomienda contar con revisión técnica para integraciones críticas, seguridad y escalabilidad.

  • Implementando Gemini Embedding 2 para optimizar pipelines multimodales

    Implementando Gemini Embedding 2 para optimizar pipelines multimodales

    Gemini Embedding 2: Nuestro primer modelo de incrustación multimodal nativo

    Tiempo estimado de lectura: 4 min

    • Un modelo multimodal nativo: texto, imagen y audio se representan en el mismo espacio semántico.
    • Simplifica pipelines: ingesta directa → vector multimodal → almacenamiento y búsqueda.
    • Impacto operativo: menor latencia, menos puntos de fallo y menos pérdida semántica frente a convertir todo a texto.
    • Consideraciones: coste computacional, chunking multimodal y balance calidad/coste.

    Introducción

    Gemini Embedding 2: Nuestro primer modelo de incrustación multimodal nativo aparece como un cambio arquitectónico claro: dejar de traducir imágenes, audio o video a texto para poder indexarlos. En las primeras líneas: este modelo convierte múltiples modalidades en vectores que coexisten en el mismo espacio semántico, y eso reconfigura cómo diseñamos RAG, agentes y pipelines de búsqueda. Fuente: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-embedding-2/

    Resumen rápido (lectores con prisa)

    Qué es: Un modelo de embeddings multimodales que representa texto, imagen y audio en un espacio latente compartido.

    Cuándo usarlo: Cuando las señales visuales o auditivas añaden valor a la búsqueda o memoria de agentes (diagramas, capturas, clips de vídeo, audio significativo).

    Por qué importa: Reduce pasos intermedios (OCR/descripción), latencia operacional y pérdida semántica al indexar multimodal directamente.

    Cómo funciona (alto nivel): Ingesta → vectorización multimodal → almacenamiento en DB vectorial → recuperación por similitud → LLM para RAG.

    Qué cambia en la práctica

    Antes: pipeline fragmentado. OCR → visión → descripción → vectorización. Ahora: ingesta directa. Esa diferencia reduce latencia operacional, puntos de fallo y, sobre todo, la pérdida semántica que ocurre al comprimir una imagen en texto.

    Implicaciones para un equipo técnico

    • Indexas diagramas, capturas de pantalla y clips de vídeo sin pasos intermedios.
    • Una misma consulta textual puede recuperar imágenes o fragmentos de audio porque sus vectores están alineados.
    • Los agentes con memoria dejan de depender exclusivamente del texto; pueden “recordar” por contenido visual o auditivo.

    No es magia. Es una abstracción más correcta: representa texto, imagen y audio en un solo espacio latente, simplificando las búsquedas semánticas y las respuestas de agentes.

    Arquitectura práctica: cómo integrarlo en un RAG moderno

    1. Ingesta

    Webhook recibe PDF, JPG o MP4.

    2. Enriquecimiento

    Opcional extracción de metadatos (autor, timestamp, página).

    3. Vectorización

    Llamada a Gemini Embedding 2 → vector multimodal.

    4. Almacenamiento

    Persistir vector + metadata en Qdrant/Pinecone/Weaviate.

    5. Recuperación

    Búsqueda por similitud y pase a un LLM para respuesta contextual (RAG).

    Consejo operativo: no trates cada frame de un vídeo como un vector único por defecto. Segmenta por escenas relevantes (detección de cambios de escena, keyframes, o subclips con audio significativo). El chunking multimodal es ahora la decisión de diseño central: afecta coste, latencia y calidad de recuperación.

    Ejemplo concreto con n8n + vector DB

    • Nodo HTTP recibe un ZIP de imágenes y un PDF.
    • Nodo Function extrae imágenes y páginas (si aplica).
    • Nodo HTTP (Gemini Embedding 2) vectoriza cada elemento y devuelve vectores con IDs.
    • Nodo DB inserta vectores en Qdrant con metadata {source, page, bbox, timestamp}.
    • Trigger de búsqueda: usuario pregunta en Slack; n8n consulta Qdrant por similitud y devuelve imágenes + extracto de texto al LLM que redondea la respuesta.

    Esto convierte un flujo de soporte técnico en algo utilizable: la captura de pantalla de un error devuelve soluciones anteriores sin depender de la calidad de la descripción humana.

    Costes, latencia y trade-offs reales

    Adoptar embeddings multimodales implica decisiones reales:

    Coste de cómputo

    Vectorizar video o largos audios consume más CPU/GPU. Para workloads síncronos, considera preprocesado asíncrono y cachés.

    Almacenamiento

    Vectores multimodales pueden requerir mayor dimensionalidad; esto aumenta coste por vector en DBs vectoriales. Usa reducción dimensional o compresión cuando tengas muchos vectores similares.

    Latencia

    En experiencias conversacionales en tiempo real, el procesamiento directo de vídeo puede ser demasiado lento. Fragmenta, pre-indexa o procesa en batch donde sea posible.

    Calidad vs. coste

    No siempre necesitas representación multimodal completa. Si tus consultas son casi siempre textuales, un pipeline texto-first sigue siendo válido.

    Estrategia de adopción — dónde empezar hoy

    1. Identifica contenido con valor visual real: manuales con diagramas, reportes con gráficos, repositorios con screenshots de errores.
    2. Prototipa un RAG limitado: 1k documentos multimodales, vectorízalos y corre consultas reales. Mide recuperación y coste.
    3. Ajusta chunking y dimensionalidad: balancea precisión vs. coste operativo.
    4. Expande gradualmente: añade vídeo/audio solo cuando el ROI de búsqueda visual/audio exista (p. ej., soporte de vídeo de producto, formación interna).

    Conclusión técnica y criterio

    Gemini Embedding 2 no es solo una mejora de rendimiento: cambia la unidad de abstracción con la que trabajamos. En lugar de forzar todo a texto, tratamos documentos como objetos multimodales nativos. Para equipos de automatización y arquitectos técnicos, la pregunta no es si usarlo, sino cómo incorporarlo sin disparar costes ni latencias.

    Empieza por validar con casos donde la señal visual o auditiva aporte claramente al resultado (resolución de errores, extracción de métricas de gráficos, búsqueda en tutoriales en video). Optimiza chunking y dimensionalidad antes de vectorizar todo tu repositorio. Así conviertes una promesa técnica en valor real, medible y reproducible para tu producto o tu operación interna.

    Para equipos interesados en prototipado y automatización aplicada, Dominicode Labs ofrece recursos y plantillas para integrar pipelines multimodales con herramientas como n8n y bases de datos vectoriales. Considera usar esos recursos como punto de partida para pruebas de concepto rápidas y controladas.

    FAQ

    ¿Qué distingue a Gemini Embedding 2 de embeddings solo textuales?

    Gemini Embedding 2 representa texto, imagen y audio en el mismo espacio semántico, permitiendo recuperar elementos multimodales con consultas textuales sin convertir previamente imágenes o audio a texto.

    ¿Cuándo merece la pena vectorizar vídeo o audio?

    Cuando la señal visual o auditiva aporta valor a las búsquedas o memoria (p. ej., tutoriales en video, soporte con capturas de pantalla, registros de audio con información útil). Si las consultas son casi siempre textuales, puede no ser necesario.

    ¿Cómo afecta esto al diseño de RAG y agentes?

    Permite que agentes y RAG recuperen y utilicen contenido no textual directamente, reduciendo pasos intermedios y pérdida semántica, y permitiendo memorias basadas en señales visuales y auditivas.

    ¿Qué bases de datos vectoriales son compatibles?

    Bases de datos como Qdrant, Pinecone y Weaviate son mencionadas como destinos para persistir vectores multimodales.

    ¿Cómo optimizo coste y latencia?

    Usa preprocesado asíncrono, cachés, reducción dimensional o compresión de vectores, y procesa vídeo/audio en batch o pre-indexado en lugar de en tiempo real cuando la interacción lo permite.

    ¿Qué es el chunking multimodal y por qué importa?

    Es la decisión de cómo segmentar contenido multimodal (frames, escenas, subclips, páginas). Afecta coste, latencia y calidad de recuperación; un mal chunking puede inflar costos o degradar resultados.