Tag: Context Engineering

  • CLAUDE.md modular vs monolítico: cómo organizar el contexto

    CLAUDE.md modular vs monolítico: cómo organizar el contexto

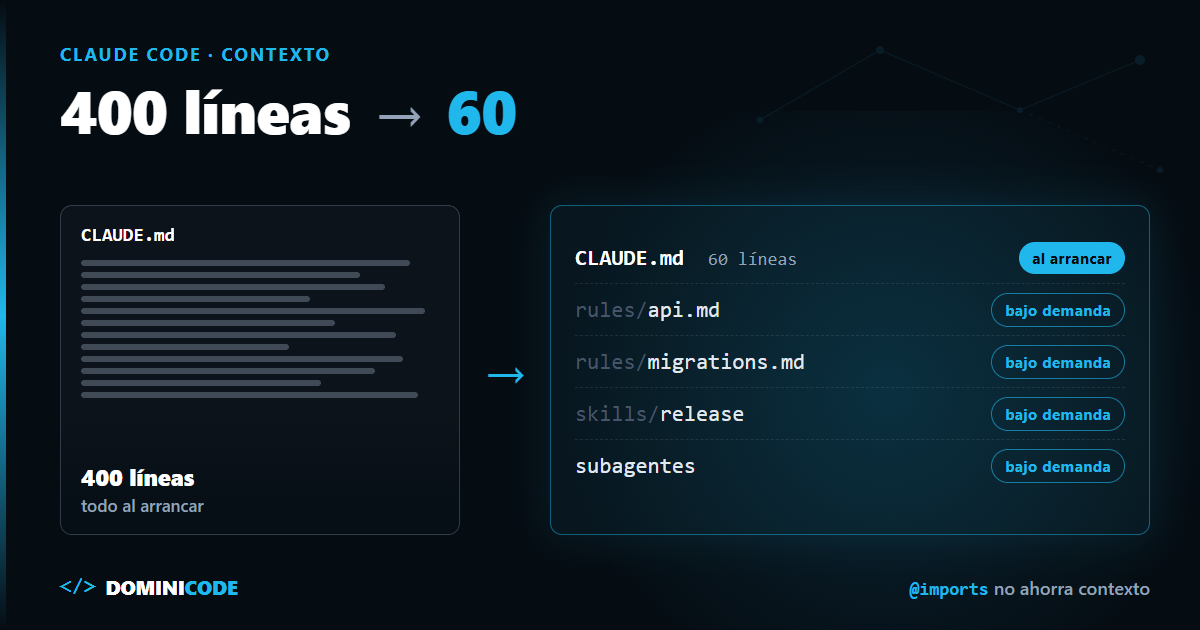
    Imagina un CLAUDE.md de 400 líneas. La regla sobre migraciones está en la 312.

    "Nunca edites una migración ya aplicada; crea una nueva." Claude la edita igual. La reescribes en mayúsculas, le pones un "IMPORTANTE" y la subes al principio. Dos semanas después, otra regla deja de cumplirse.

    Decides pasar a un CLAUDE.md modular. Partes el archivo en seis piezas enlazadas con @imports. Más ordenado, sí. Pero el agente se comporta igual, porque Claude Code sigue cargando las 400 líneas al arrancar.

    Partir el archivo no es tener un CLAUDE.md modular. Lo que cambia las cosas es cuándo carga cada instrucción.

    En corto: un CLAUDE.md modular deja en la raíz solo lo que hace falta en cada sesión y mueve el resto a capas que Claude Code carga bajo demanda: reglas con paths, CLAUDE.md de subcarpeta, skills y subagentes. Los @imports ordenan pero no ahorran contexto, porque cargan al arrancar. Menos ruido y menos contradicciones reducen las alucinaciones, aunque no las eliminan.

    El porqué está en Context Engineering: cómo estructurar la memoria de tus agentes. Aquí va el mapa de Claude Code y la migración.

    ¿Qué es un CLAUDE.md modular?

    Un CLAUDE.md modular es una arquitectura de contexto en la que el archivo raíz contiene solo los hechos que Claude necesita en todas las sesiones, y cada instrucción restante vive en la capa que se carga cuando de verdad aplica.

    La documentación oficial recomienda menos de 200 líneas por CLAUDE.md, porque los archivos largos "consumen más contexto y reducen la adherencia".

    Qué meter en la raíz ya lo conté en CLAUDE.md: el system prompt de tu proyecto. Este post trata de lo que sacas de ella.

    Las capas de contexto de Claude Code y cuándo carga cada una

    El momento de carga de cada capa decide lo que pagas en la ventana. Datos de la documentación de memoria, skills y subagentes, consultada el 7 de noviembre de 2026:

    Capa Cuándo entra en contexto Qué ocupa
    CLAUDE.md raíz + CLAUDE.local.md Siempre, al arrancar. El CLAUDE.md raíz se relee tras /compact Entero (se omite si pasa de 4 MiB)
    @imports Al arrancar, con el archivo que importa. Máximo 4 saltos Entero: no ahorra nada
    .claude/rules/ sin paths Al arrancar, con la prioridad de .claude/CLAUDE.md Entero
    .claude/rules/ con paths Al leer, escribir o editar un archivo que encaja con el glob Hasta 40.000 caracteres por archivo con ventana de 200K
    CLAUDE.md de subcarpeta Al leer, escribir o editar un archivo de esa carpeta Mismo límite
    Skills Descripción siempre; cuerpo al invocarse Hasta 1.536 caracteres por descripción; el listado, ~1% de la ventana
    Subagentes Al delegar, en su propia ventana Su prompt más tu CLAUDE.md, salvo Explore, Plan u omitClaudeMd
    Auto memory MEMORY.md al arrancar; temas bajo demanda Primeras 200 líneas o 25 KB de MEMORY.md

    Dos detalles cambian decisiones.

    Los niveles managed policy, usuario, proyecto y local no se sobrescriben: se concatenan, del más amplio al más específico. Si dos se contradicen, Claude "puede elegir uno de forma arbitraria". La precedencia estricta es de settings.json, no de CLAUDE.md.

    Y un subagente no te libra del monolito. Arranca con ventana limpia, pero carga toda tu jerarquía de CLAUDE.md. Con 400 líneas en la raíz, cada subagente las paga también. Más sobre esto en arquitectura de subagentes frente al mega-prompt.

    CLAUDE.md monolítico vs modular: la comparativa

    El monolítico gana en simplicidad; el modular, en precisión. Ninguno es gratis:

    Criterio Monolítico Modular
    Coste fijo por sesión Todo el archivo Raíz, reglas sin paths y listado de skills
    Encontrar una regla Un sitio, Ctrl+F Tienes que saber qué capa la tiene
    Contradicciones Frecuentes, pero visibles en una lectura Menos por pieza, invisibles entre piezas
    Previsibilidad Lo que está, carga Depende de que el agente toque el archivo que dispara la regla
    Limitación o riesgo Pasadas 200 líneas baja la adherencia y la regla 312 compite con todo Una regla con paths que no se dispara no existe para Claude, y no te avisa

    Mi opinión: a partir de 200 líneas, el monolítico ya no es una opción neutral. Es deuda, y un CLAUDE.md modular es la forma de pagarla.

    El error más común: creer que @imports ahorra contexto

    @imports organiza, pero no difiere la carga. La documentación lo dice explícitamente: dividir en imports "ayuda a organizar, pero no reduce el contexto", porque lo importado carga junto al CLAUDE.md que lo referencia.

    Hay una trampa más fina. En el issue #16299 de anthropics/claude-code, abierto en enero de 2026 sobre reglas con paths que cargaban siempre, un usuario midió en octubre, con la versión 2.1.300, que un @import dentro de una regla con ruta carga al arrancar aunque la regla no se dispare: el cuerpo de la regla no sumaba nada, pero el import de 20.000 caracteres que llevaba dentro sí, unos 17.000 tokens.

    En el mismo hilo, otro equipo cuenta que 75 archivos de referencia en .claude/rules/ sin paths le subían el arranque a 139.500 tokens antes de abrir un archivo. Lo vieron con /context.

    Si quieres que algo cargue tarde, no lo importes.

    Qué va en cada capa: criterios para organizar CLAUDE.md

    A cada bloque de tu CLAUDE.md, una pregunta: ¿cuándo lo necesita Claude?

    Si la instrucción… Va en…
    Aplica en toda sesión (build, convenciones globales, prohibiciones) CLAUDE.md raíz
    Solo importa al tocar ciertos archivos .claude/rules/ con paths
    Es un procedimiento de varios pasos Skill
    Llena la ventana de logs o búsquedas Subagente
    Es una preferencia tuya o la URL de tu sandbox CLAUDE.local.md, en .gitignore
    Claude la deduce leyendo el código En ningún sitio: bórrala
    Debe cumplirse sin excepción Un hook o permissions.deny

    La última fila pesa más de lo que parece: CLAUDE.md es contexto, no configuración que se haga cumplir.

    En monorepos, el CLAUDE.md por carpeta tiene sus propias reglas: las detallé en Claude Code en monorepos.

    Migración de ejemplo: de 400 líneas a un CLAUDE.md modular

    Imagina un backend en TypeScript con API REST, migraciones y tests end-to-end. Su CLAUDE.md de 400 líneas se reparte así:

    Bloque Líneas Destino
    Comandos, convenciones, prohibiciones 60 CLAUDE.md raíz
    Convenciones de la API 90 .claude/rules/api.md
    Migraciones y base de datos 70 .claude/rules/migrations.md
    Procedimiento de release 80 Skill release
    Árbol de carpetas y dependencias 50 Borrado
    URLs de staging y datos de prueba 50 CLAUDE.local.md

    El coste fijo por sesión pasa de 400 líneas a 60 más la descripción de una skill. Las 160 de API y migraciones solo entran cuando el agente toca esos archivos. Cifras ilustrativas.

    proyecto/
    ├── CLAUDE.md                 # 60 líneas: lo de todas las sesiones
    ├── CLAUDE.local.md           # en .gitignore
    └── .claude/
        ├── rules/
        │   ├── api.md            # paths: src/api/**
        │   └── migrations.md     # paths: src/db/**/*.ts
        └── skills/
            └── release/
                └── SKILL.md      # el cuerpo carga solo al invocarse
    

    Y la regla que no se cumplía, ahora pegada al código al que aplica:

    ---
    paths:
      - "src/db/**/*.ts"
    ---
    
    # Migraciones
    
    - Nunca edites una migración que ya está en main. Crea una nueva.
    - Cada migración lleva su `down`.
    - Ejecuta `npm run db:check` antes de dar la tarea por terminada.
    

    Para comprobarlo, ejecuta /context all al empezar: la regla de migraciones no debe estar en Memory files. Para ver cuándo entra, registra la carga con el hook InstructionsLoaded y pide a Claude que lea un .ts de src/db/. Si tu repo usa AGENTS.md, revisa antes cómo convive con CLAUDE.md: por defecto, un CLAUDE.md en la raíz hace que Claude deje de leerlo, salvo que lo importe con @AGENTS.md.

    Auto memory en Claude Code: por qué no es tu CLAUDE.md

    La memoria persistente de Claude Code son dos sistemas: CLAUDE.md lo escribes tú y auto memory lo escribe Claude. Auto memory vive en ~/.claude/projects/<proyecto>/memory/, solo en tu máquina.

    Al arrancar carga el índice MEMORY.md, hasta 200 líneas o 25 KB; los archivos de tema, bajo demanda. Es el patrón modular aplicado a la memoria.

    No la uses para reglas de equipo: no viaja por git ni llega a los subagentes. Un subagente puede tener su propia memoria con el campo memory, pero es otro directorio, no la tuya. La revisas con /memory. Cómo la uso en el día a día está en mi flujo real con CLAUDE.md y memoria.

    Si quieres llevar esto a la memoria y las herramientas de un agente propio, el ebook gratuito El Developer Agéntico lo trata a fondo.

    Por qué el contexto modular reduce alucinaciones (sin eliminarlas)

    El context engineering en Claude Code no hace que el modelo deje de inventar. Le quita motivos, por tres vías.

    Menos ruido. Si la sesión no toca la base de datos, las reglas de migraciones no compiten por atención.

    La regla llega cuando importa. Una regla con paths entra cuando Claude abre el archivo afectado, justo antes de decidir, aunque tras un /compact tiene que volver a dispararse.

    Menos contradicciones. Ante instrucciones contradictorias, Claude puede elegir una de forma arbitraria. Archivos pequeños de un solo tema se revisan mejor, y /doctor prompt-audit (desde la versión 2.1.283) busca archivos que chocan entre sí.

    Lo que no resuelve: una regla ambigua sigue siéndolo aunque cargue a tiempo. Revisar lo que genera el agente contra una especificación sigue siendo necesario; es lo que practicamos en el workshop de SDD + Agentic Engineering.

    Cuándo NO modularizar tu CLAUDE.md

    Si tu CLAUDE.md cabe en 100 líneas. Un CLAUDE.md modular añade indirección sin ahorrar nada. Un archivo que lees en un minuto se audita mejor que cinco.

    Si tu agente escribe mucho por Bash. En el issue #93248, de septiembre de 2026, un usuario documentó con la versión 2.1.267 que su regla de TypeScript no cargó al crear un .ts desde cero. Otro midió en octubre, con la 2.1.296, que la herramienta Write ya la dispara, pero que las escrituras por Bash (sed -i, >, heredocs) y los comandos con pipes no cargan nada; las lecturas simples con cat o head sí. Una regla crítica con ruta puede no llegar nunca.

    Si la regla tiene que sobrevivir a /compact. Las reglas con paths entran en el historial y la compactación las resume con todo lo demás; no vuelven hasta que Claude toque otra vez un archivo que encaje. La documentación lo dice claro: si una regla debe persistir, quítale paths o súbela al CLAUDE.md raíz. Para la regla de migraciones del ejemplo, si es crítica, valora dejarla en la raíz o respaldarla con un hook.

    Si nadie va a mantener el mapa. Sin ese criterio, el modular acumula contradicciones igual que el monolítico, pero escondidas.

    Empieza por medir, no por partir

    Así empieza un CLAUDE.md modular: ejecuta /context all y mira qué carga al arrancar. Luego marca cada bloque de tu CLAUDE.md con su respuesta a "¿cuándo lo necesita Claude?". Lo que no sea "siempre" tiene otro sitio. Lo que Claude deduce del código, bórralo.

    Si quieres aplicarlo de principio a fin en un proyecto, de la spec al producto, es el flujo del curso Construye con IA: de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Los @imports de CLAUDE.md reducen el consumo de contexto?

    No. Los archivos importados cargan al arrancar junto al CLAUDE.md que los referencia, con un máximo de cuatro saltos. Sirven para organizar o compartir un AGENTS.md, no para diferir la carga.

    ¿Cuándo se cargan los CLAUDE.md de las subcarpetas?

    Los del directorio donde arrancas y los superiores cargan al inicio. Los de subcarpetas, la primera vez que Claude lee, escribe o edita un archivo en ella. Por eso no salen en /context al empezar; cuando cargan, verás una línea Loaded con su ruta.

    ¿Sigue existiendo CLAUDE.local.md?

    Sí. Es el nivel local del proyecto: carga después de CLAUDE.md en el mismo directorio y debe ir en .gitignore. Si tu proyecto depende de AGENTS.md, crear un CLAUDE.local.md hace que Claude deje de leerlo, salvo que cambies la opción Project instructions en /config.

    ¿Cuánto contexto ocupa una skill que no he invocado?

    Su entrada en el listado: nombre y descripción, recortados a 1.536 caracteres. El listado completo tiene un presupuesto del 1% de la ventana. El cuerpo de SKILL.md entra al invocarla, y con disable-model-invocation: true ni siquiera la descripción está en contexto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • GitHub Spec Kit con Claude Code: specs que el agente cumple

    GitHub Spec Kit con Claude Code: specs que el agente cumple

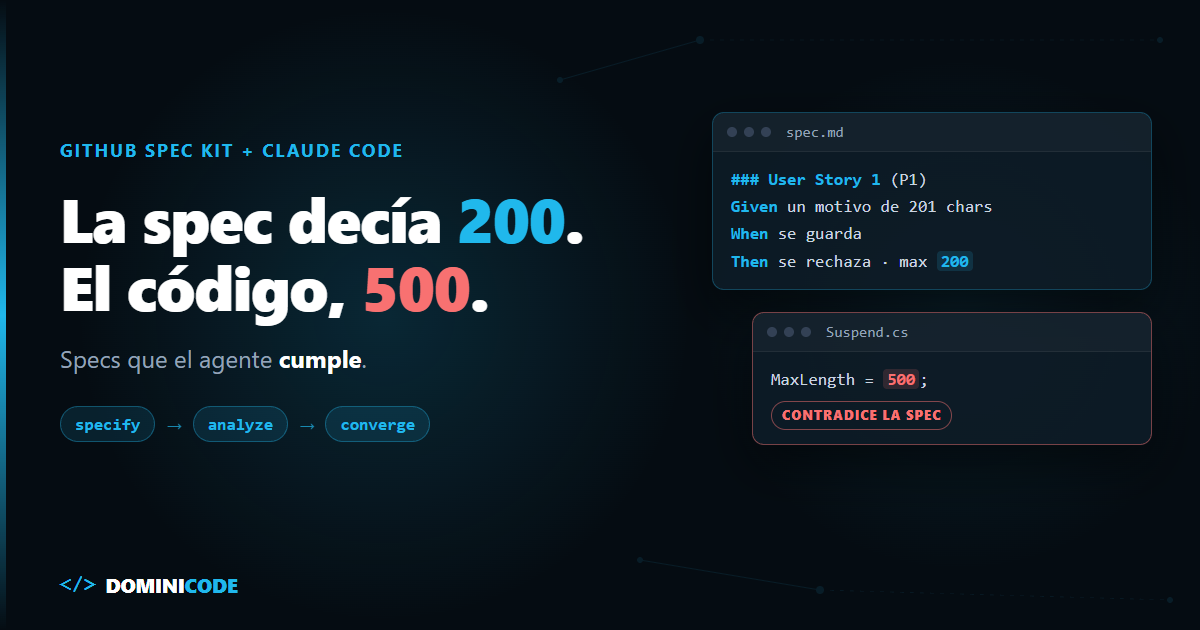
    La spec decía 200 caracteres. El código dice 500.

    En septiembre de 2026, un developer abrió el issue #4383 en el repo de Spec Kit. Había hecho todo bien: constitution, specify, plan, tasks, implement, usando GitHub Spec Kit con Claude Code. El PRD fijaba en 200 la longitud máxima de dos campos. spec.md lo decía. data-model.md también: SuspendReason nvarchar(200).

    Y Claude implementó SuspendReasonMaxLength = 500.

    Nadie le había dado mal la regla al agente. La regla se había perdido por el camino: tasks.md mencionaba el límite de un campo y no el del otro. Para el campo sin límite, el agente puso uno por su cuenta.

    En corto: GitHub Spec Kit no impide que Claude Code contradiga tu spec, pero hace visible dónde se rompe el hilo. Su plantilla te obliga a escribir historias priorizadas que se prueban por separado, escenarios Given/When/Then, requisitos numerados y criterios medibles. Sus comandos clarify, checklist, analyze y converge detectan las contradicciones antes de implementar y después.

    ¿Qué es GitHub Spec Kit?

    GitHub Spec Kit es un toolkit open source de GitHub que instala en tu agente de código (Claude Code, Copilot, Codex y otros) un proceso de Spec-Driven Development con plantillas y comandos que van de la especificación al plan, las tareas, el código y la verificación.

    No es un modelo ni un servicio. Es un CLI en Python (specify) que copia plantillas Markdown y skills a tu proyecto. Todo lo demás lo hace el agente siguiendo esas instrucciones.

    Va rápido. La última release cuando escribo esto es la v1.3.2, del 6 de noviembre de 2026, y el repo pasa de 148.000 estrellas (dato de la API de GitHub, 7 de noviembre de 2026).

    Los tres errores que hacen que el agente contradiga la spec

    Un agente contradice una spec por tres motivos que el formato de Spec Kit ataca de frente: la ambigüedad, la falta de slices verticales y los criterios de aceptación débiles.

    El resto de fallos lo tienes en los siete fallos de una spec que rompen a un agente de IA, y lo de los slices, en el post sobre spec global y slices verticales en un proyecto greenfield.

    La tesis es simple: un agente no contradice una spec por rebeldía. La contradice cuando la spec deja un hueco y él lo rellena. Spec Kit no hace al agente más obediente. Te deja menos huecos que rellenar.

    Cómo instalar GitHub Spec Kit en Claude Code

    Necesitas Python 3.11+, uv y Claude Code instalado. La página de la integración con Claude da la clave claude:

    uv tool install specify-cli
    specify init mi-proyecto --integration claude
    cd mi-proyecto
    

    En un proyecto que ya existe, la guía de proyectos existentes indica specify init --here --force --integration claude. Haz commit antes: --force puede sobrescribir archivos en las rutas que gestiona Spec Kit.

    Spec Kit instala sus comandos como skills en .claude/skills/speckit-<comando>/SKILL.md. En el chat de Claude Code se invocan con guion:

    /speckit-constitution Prioriza la exactitud fiscal y los tests de integración.
    /speckit-specify Exportación trimestral de facturas para la gestoría.
    /speckit-clarify
    /speckit-plan Next.js, Postgres y generación del CSV en el servidor.
    /speckit-checklist
    /speckit-tasks
    /speckit-analyze
    /speckit-implement
    /speckit-converge
    

    Si ves /speckit.specify con punto en la documentación, es la notación genérica: en Claude Code va con guion.

    El formato de spec de Spec Kit, sección a sección

    La plantilla spec-template.md tiene tres secciones obligatorias (User Scenarios & Testing, Requirements y Success Criteria), una condicional (Key Entities, si la feature maneja datos) y una sección final de Assumptions. Así se mapea cada error a un mecanismo concreto:

    Error en la spec Mecanismo de Spec Kit Qué lo detecta
    Ambigüedad Marcadores [NEEDS CLARIFICATION: …] (máximo 3 por spec) y sección Assumptions /speckit-clarify: hasta 5 preguntas y las respuestas se escriben en spec.md
    Sin slices verticales User stories con prioridad (P1, P2, P3) y un Independent Test cada una /speckit-tasks agrupa las tareas por historia
    Criterios débiles Escenarios Given/When/Then y Success Criteria medibles (SC-001…) /speckit-checklist, "unit tests for English"
    Spec, plan y tareas que no cuadran Requisitos numerados FR-001… para trazar cada uno /speckit-analyze, de solo lectura
    Código que no cumple la spec spec.md, plan.md y tasks.md como referencia /speckit-converge añade tareas por lo que falta
    Principios del proyecto ignorados .specify/memory/constitution.md /speckit-analyze marca cualquier conflicto con la constitución como CRITICAL

    Fuente: plantillas y comandos en templates/commands/, consultados el 7 de noviembre de 2026.

    La plantilla exige que cada historia sea "INDEPENDENTLY TESTABLE": si implementas solo una, sigues teniendo un MVP viable. Es un slice vertical con otro nombre.

    Ejemplo: de spec mala a spec en formato Spec Kit

    Caso: un SaaS de facturación para autónomos. Los usuarios quieren mandar sus facturas a la gestoría cada trimestre sin descargarlas una a una.

    La spec que suele llegar al agente:

    # Exportación para la gestoría
    
    Añadir exportación de facturas para la gestoría.
    Tiene que ser rápida y fácil de usar.
    Formato CSV o Excel.
    Opción de enviarlo por email automáticamente.
    Gestionar bien los errores.
    

    Cada línea es un hueco. "Rápida" no se puede medir. "CSV o Excel" deja la decisión al agente. "Gestionar bien los errores" no dice qué es un error. Y no hay orden: el agente puede empezar por el envío automático, la parte más difícil, sin que exista la exportación básica.

    La misma spec en el formato de Spec Kit:

    # Feature Specification: Exportación trimestral para la gestoría
    
    **Status**: Draft
    
    ## User Scenarios & Testing *(mandatory)*
    
    ### User Story 1 - Descargar el CSV del trimestre (Priority: P1)
    
    El autónomo elige un trimestre y descarga un CSV con todas sus
    facturas emitidas en ese periodo.
    
    **Why this priority**: sin esto no hay nada que enviar. Es el
    mínimo que ya ahorra el trabajo manual.
    
    **Independent Test**: con 3 facturas en el T2 y 1 en el T3,
    exportar el T2 devuelve un CSV con exactamente 3 filas.
    
    **Acceptance Scenarios**:
    
    1. **Given** un usuario con 3 facturas emitidas en el T2 de 2026,
       **When** exporta el T2 de 2026, **Then** descarga un CSV con
       3 filas y las columnas número, fecha, NIF del cliente, base
       imponible, tipo de IVA, cuota de IVA y total.
    2. **Given** una factura rectificativa en el T2, **When** exporta
       el T2, **Then** la rectificativa aparece con importes negativos.
    3. **Given** un trimestre sin facturas, **When** lo exporta,
       **Then** ve el mensaje "No hay facturas en este trimestre"
       y no se descarga ningún archivo.
    
    ---
    
    ### User Story 2 - Enviar el CSV al email de la gestoría (Priority: P2)
    
    El autónomo guarda el email de su gestoría y envía el CSV del
    trimestre con un botón.
    
    **Why this priority**: elimina el paso de adjuntar el archivo,
    pero depende de que la US1 funcione.
    
    **Independent Test**: con un email de gestoría guardado, pulsar
    "Enviar" genera un único email con el CSV del trimestre adjunto.
    
    **Acceptance Scenarios**:
    
    1. **Given** un email de gestoría guardado, **When** pulsa
       "Enviar T2", **Then** se envía un email con el CSV adjunto
       y el envío queda registrado con fecha y destinatario.
    2. **Given** que el T2 ya se envió, **When** pulsa "Enviar T2"
       otra vez, **Then** se le pide confirmación antes de reenviar.
    
    ---
    
    ### User Story 3 - Envío automático al cerrar el trimestre (Priority: P3)
    
    [...]
    
    ### Edge Cases
    
    - ¿Qué pasa con una factura con fecha del último día del trimestre
      a las 23:59 en otra zona horaria?
    - ¿Qué pasa si el email de la gestoría rebota?
    
    ## Requirements *(mandatory)*
    
    ### Functional Requirements
    
    - **FR-001**: System MUST incluir solo facturas emitidas, nunca
      borradores.
    - **FR-002**: System MUST asignar el trimestre por la fecha de
      emisión, no por la fecha de cobro.
    - **FR-003**: System MUST usar [NEEDS CLARIFICATION: ¿separador
      decimal coma o punto? Depende del programa de la gestoría].
    - **FR-004**: System MUST NOT modificar ninguna factura al exportar.
    
    ### Key Entities
    
    - **Factura**: número, fecha de emisión, cliente, base, IVA, total.
    - **Envío**: trimestre, destinatario, fecha y archivo enviado.
    
    ## Success Criteria *(mandatory)*
    
    ### Measurable Outcomes
    
    - **SC-001**: un usuario con 500 facturas en un trimestre obtiene
      el CSV en menos de 5 segundos.
    - **SC-002**: la suma de la columna total del CSV coincide al
      céntimo con el total facturado del trimestre en la app.
    
    ## Assumptions
    
    - La exportación a Excel queda fuera de esta versión.
    - Las facturas recibidas (gastos) no entran en esta feature.
    

    Fíjate en lo que cambió. El orden ya no es cosa del agente: P1 se puede terminar, probar y desplegar sin tocar P2. "Rápida" ahora es SC-001, con un número. "CSV o Excel" se convirtió en una decisión escrita en Assumptions. Y lo que de verdad no sabes, el separador decimal, queda marcado en vez de inventado.

    Ojo: una spec mejor no habría evitado por sí sola el bug del issue #4383. Allí la spec ya decía 200; el límite se perdió al pasar a tasks.md. Lo que lo atrapa es una restricción escrita como escenario (Given un motivo de 201 caracteres, When se guarda, Then se rechaza) más un comando que compare el código con ella. Un escenario se convierte en un test que falla, y un test que falla no deja pasar un 500 donde ponía 200.

    Cómo detecta Spec Kit las contradicciones antes de implementar

    Spec Kit detecta las contradicciones con cuatro comandos: clarify y checklist revisan la spec, analyze cruza spec, plan y tareas antes de implementar, y converge compara el código con los tres después. Es justo el punto donde falló el issue: algo se perdió entre spec.md y el código.

    /speckit-clarify revisa la spec por categorías y te hace como máximo cinco preguntas, de una en una, con opciones cerradas o respuestas de cinco palabras como mucho. Cada respuesta se escribe en spec.md. Pásalo antes de plan: es más barato resolver el separador decimal ahí que en un PR.

    /speckit-checklist genera lo que el propio comando llama "Unit Tests for English": comprueba si los requisitos están completos, son claros y no se contradicen. No prueba el código. Prueba la spec.

    /speckit-analyze cruza spec.md, plan.md y tasks.md y saca una tabla de hallazgos con severidad. Es estrictamente de solo lectura: no toca ningún archivo. Y la constitución manda: según el propio comando, un conflicto con ella es "automatically CRITICAL" y se arregla cambiando la spec, el plan o las tareas, no el principio.

    /speckit-converge va después de implementar. Compara el código con los tres artefactos y añade a tasks.md el trabajo que falta, sin tocar el código. Repites implement y converge hasta que el comando informa Converged.

    El issue #4383 acabó en un cambio a la plantilla de tasks. Desde el PR #4430, fusionado el 8 de septiembre de 2026, el comando pide citar literalmente en cada tarea las restricciones de campo de data-model.md: longitudes máximas, nullables, enums, reglas de validación. Aun así, el bot del repo, que clasificó el issue como "likely valid, needs reproduction", avisa de que el arreglo es solo de prompt y de que distintos agentes pueden seguir parafraseando las restricciones en vez de citarlas. Por eso no te fíes de un solo comando: analyze antes de implementar y converge después.

    La constitución: lo que ningún feature puede saltarse

    /speckit-constitution escribe .specify/memory/constitution.md, que se crea una vez por proyecto. La plantilla trae huecos para cinco principios, con ejemplos como "Test-First (NON-NEGOTIABLE)".

    Para el SaaS de facturas, uno de los principios sería este:

    ### I. Exactitud fiscal (NON-NEGOTIABLE)
    Los importes se calculan en céntimos enteros, nunca en coma flotante.
    Toda exportación tiene un test que compara su suma con el total del sistema.
    

    Ese principio no vive en ninguna spec concreta. Vive por encima de todas. Si mañana un plan propone calcular con number de JavaScript, analyze debería marcarlo como CRITICAL antes de que se escriba una línea.

    Spec Kit, un spec.md propio u OpenSpec

    No todo proyecto necesita Spec Kit:

    Criterio GitHub Spec Kit spec.md propio OpenSpec
    Instalación uv + Python 3.11+ Ninguna npm (Node 22.12+), Homebrew o script
    Formato de spec Plantilla fija: user stories P1-P3, Given/When/Then, FR, SC El que tú decidas Requisitos y escenarios en Markdown, por cambio
    Detección de contradicciones clarify, checklist, analyze, converge Depende de tu disciplina y tus prompts /opsx:verify en el perfil ampliado
    Specs a largo plazo Una carpeta por feature en specs/ Lo que mantengas a mano openspec/specs/ vivas; los cambios se archivan y las actualizan
    Limitación o riesgo Mucho Markdown y ceremonia; las specs por feature envejecen Nada te obliga a escribir criterios medibles Menos puertas de calidad; su README llama a Spec Kit "Thorough but heavyweight"

    Fuentes: README de Spec Kit, README de OpenSpec, consultados el 7 de noviembre de 2026. Si ya usas OpenSpec, tienes el paso a paso en cómo integrar OpenSpec con Claude Code.

    Mi opinión: el formato es lo mejor del paquete y te lo puedes llevar sin el CLI. Si copias la plantilla a tu spec.md propio, ya ganas la mitad; la otra mitad, analyze y converge, es lo que justifica instalarlo en proyectos medianos o grandes.

    Cuándo NO usar Spec Kit

    Para cambios pequeños. El proceso completo genera spec, plan, tareas, checklists y varios artefactos más. Para un bug de tres líneas es ceremonia pura. En este hilo de Hacker News, a raíz del análisis de Birgitta Böckeler sobre Kiro, Spec Kit y Tessl, un usuario contaba que lo dejó porque "Always made it too complex, and at some point it wasn't worth correcting it anymore". Para bugs, Spec Kit tiene ahora una extensión aparte (specify extension add bug); úsala en vez de pasar el bug por el flujo de features.

    Cuando esperas que la spec garantice el resultado. En el mismo hilo, otro usuario cuenta que usó Spec Kit con Claude Code durante dos semanas. Tras unos diez días de flujo, tenía tests fallando y un build que no salía. En el siguiente proyecto dejó de lado parte del flujo: montó sus propios comandos por sprint y revisaba cada sprint antes de seguir. Ese comentario es de octubre de 2025, antes de converge, pero la lección no caduca: la spec reduce los huecos, no sustituye la revisión.

    Cuando tus specs tienen que vivir años. Spec Kit crea una carpeta por feature. Si la feature 009 cambia lo que definió la 001, nada fusiona las dos automáticamente. Es lo que se preguntaba en el issue #620, "How to keep specs consistent and up-to-date with spec-kit?". Existe una guía para hacer evolucionar specs, pero el mantenimiento sigue siendo tuyo.

    Cuando no vas a leer lo que genera. Una spec sin revisar es un prompt vago convertido en Markdown largo; el README pide ejecutar los comandos de uno en uno y revisar cada resultado.

    Por dónde empezar a escribir specs para agentes de IA con Spec Kit

    Coge la última feature que le pediste a Claude Code y reescribe su spec con la plantilla: dos o tres historias con prioridad, un Independent Test por historia, escenarios Given/When/Then y al menos un criterio con número. Después pasa /speckit-clarify y mira qué te pregunta. Esas preguntas son los huecos que el agente iba a rellenar por ti.

    Si quieres el método completo detrás de este formato, está en el libro Spec-Driven Development. Y si prefieres verlo aplicado de la idea al producto con Claude Code, es lo que hacemos en el curso Construye con IA. Para la parte de revisar lo que genera el agente contra la spec, el workshop SDD + Agentic Engineering va justo de eso.

    Preguntas frecuentes

    ¿Cómo se instala GitHub Spec Kit en Claude Code?

    Con uv tool install specify-cli y specify init mi-proyecto --integration claude (en un repo existente, specify init --here --force --integration claude). Necesitas Python 3.11+, uv y Claude Code.

    ¿Los comandos de Spec Kit se escriben /speckit.specify o /speckit-specify?

    En Claude Code, /speckit-specify, con guion: Spec Kit los instala como skills en .claude/skills/. La documentación de referencia usa /speckit.specify como notación genérica, y cada agente tiene su propia forma de invocarlos.

    ¿Qué diferencia hay entre /speckit-clarify y /speckit-analyze?

    clarify resuelve dudas de la spec antes del plan y escribe las respuestas en spec.md. analyze cruza spec, plan y tareas después de tasks y no modifica ningún archivo.

    ¿Cómo se escriben criterios de aceptación para un agente de IA con Spec Kit?

    Con escenarios Given/When/Then en cada user story y Success Criteria numerados (SC-001…) con una cifra. Cada escenario fija un estado inicial, una acción y un resultado comprobable; cada criterio, un número que un test puede medir, como "menos de 5 segundos con 500 facturas". Si no se puede comprobar con un test, no es un criterio de aceptación: es un hueco que el agente rellenará por su cuenta.

    ¿Cuántos [NEEDS CLARIFICATION] puede tener una spec de Spec Kit?

    Como máximo tres. El comando specify está escrito para suponer con criterio y anotar esas suposiciones en Assumptions, y para marcar solo las decisiones críticas sin un valor razonable por defecto: alcance, seguridad o experiencia de usuario.

    ¿Spec Kit sirve para proyectos existentes o solo para empezar de cero?

    Sirve para los dos, pero en un proyecto existente no genera specs del comportamiento que ya tienes: empiezan con la siguiente feature que definas.

    ¿Puedo usar el formato de Spec Kit sin instalar el CLI?

    Sí. La plantilla templates/spec-template.md es Markdown público en el repo. Copiarla a tu propio spec.md te da las historias priorizadas, Given/When/Then, FR y SC. Lo que pierdes son los comandos que comprueban la coherencia entre spec, plan, tareas y código.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code output styles: cambia cómo te responde

    Claude Code output styles: cambia cómo te responde

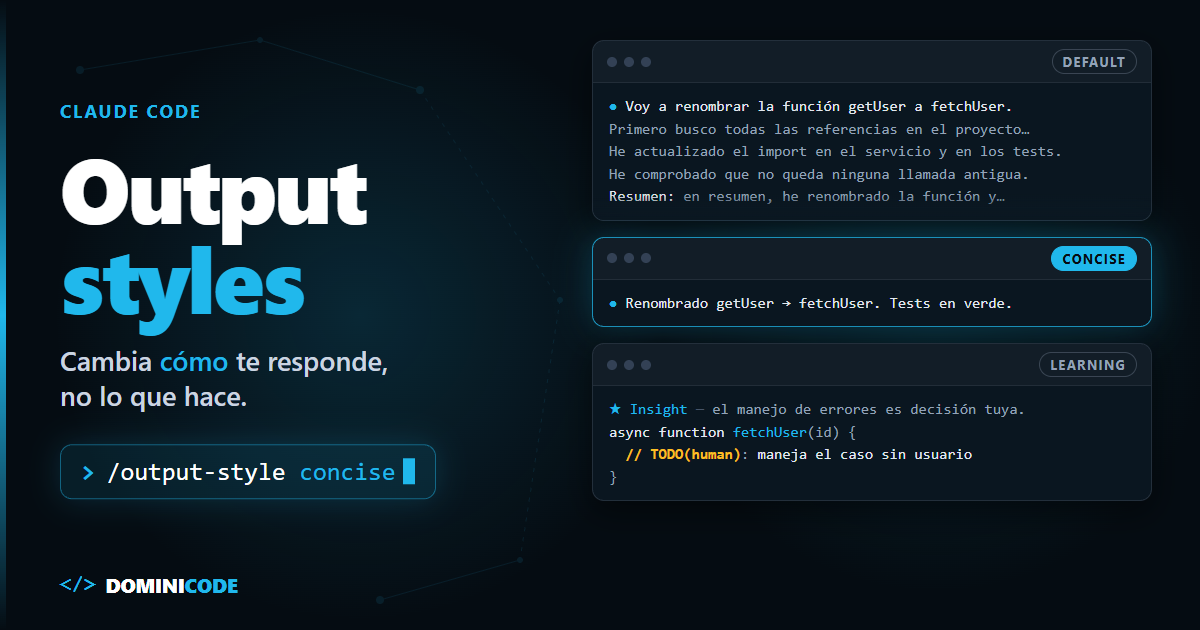
    Le pides a Claude Code que renombre una función. Lo hace bien. Y después te escribe cuatro párrafos: lo que va a hacer, lo que ha hecho, lo que ha comprobado y un resumen de todo lo anterior.

    Al día siguiente te pasa lo contrario. Estás aprendiendo un framework nuevo, le pides una feature y te devuelve 200 líneas sin explicar ni una decisión. Funciona, pero no has aprendido nada.

    Las dos veces acabas añadiendo al prompt "sé breve" o "explícame por qué". Y en el siguiente mensaje se le olvida. Para eso existen los Claude Code output styles: para que no tengas que repetirlo.

    En corto: un output style es un conjunto de instrucciones que fija el rol, el tono y el formato de todas las respuestas de una sesión de Claude Code. Trae cuatro de serie además del Default (Proactive, Concise, Explanatory y Learning) y se cambian con /output-style. No sustituye a CLAUDE.md: CLAUDE.md dice qué debe saber Claude; el output style, cómo debe responderte.

    ¿Qué son los output styles de Claude Code?

    Un output style es un conjunto de instrucciones que Claude Code envía con cada petición y que cambia cómo te responde Claude durante toda la sesión: su rol, su tono y el formato de sus respuestas.

    La documentación oficial (consultada en octubre de 2026) añade un matiz que conviene leer dos veces: es una instrucción que Claude sigue, no una garantía. Si algo tiene que pasar siempre, como formatear después de cada edición, lo que buscas es un hook.

    Un estilo orienta. No obliga. Esa diferencia marca todo lo demás.

    Los output styles que trae Claude Code de serie

    De los Claude Code output styles, el que viene activo es Default, que en realidad es no tener estilo: Claude trabaja con su system prompt estándar de ingeniería de software. Los otros cuatro mantienen esas instrucciones y añaden las suyas.

    Estilo Qué cambia Cuándo usarlo
    Proactive Empieza a implementar en cuanto mandas la tarea y asume las decisiones rutinarias en vez de preguntar Quieres que avance y prefieres corregir sobre la marcha
    Concise La primera frase dice qué ha pasado; sin introducción, sin narrar pasos, sin resumen final Las respuestas por defecto te parecen largas
    Explanatory Añade bloques Insight en la conversación (no como comentarios en tus archivos) con 2 o 3 puntos sobre por qué tomó sus decisiones Estás aterrizando en un codebase que no conoces
    Learning Además de los Insight, te deja huecos marcados con TODO(human) para que escribas tú el código Quieres practicar mientras la tarea avanza

    Concise no recorta el trabajo, solo el texto. La ingeniería es igual que en Default, y escribe completo cuando se lo pides o cuando lo necesitas para actuar con seguridad: errores, tests que fallan, avisos de seguridad y confirmaciones de acciones destructivas. Requiere Claude Code v2.1.237 o posterior.

    Proactive no toca tus permisos. Tu permission mode sigue decidiendo qué se ejecuta sin preguntar.

    Learning se para y espera. Cuando llega a una decisión de diseño real, como el manejo de errores o una estructura de datos, deja el hueco, te dice qué valorar y no sigue hasta que le avisas.

    Cómo cambiar el output style en Claude Code

    Lo más rápido es el comando:

    /output-style concise
    

    Sin argumento, /output-style lista los estilos y marca el activo. También puedes ir por /config → Output style. Las dos vías guardan la elección en .claude/settings.local.json.

    A mano, el campo es outputStyle:

    {
      "outputStyle": "Concise"
    }
    

    Aquí hay una trampa: en settings el valor distingue mayúsculas. "concise" no da error; te deja en Default sin avisar. El comando, en cambio, ignora mayúsculas.

    Para usar un estilo en todos tus proyectos, ponlo en ~/.claude/settings.json; los settings de cada proyecto tienen prioridad. Si cambias a mitad de sesión, se aplica desde tu siguiente mensaje (desde v2.1.251; antes había que hacer /clear).

    Cómo crear un output style propio

    Un output style propio es un archivo Markdown: frontmatter con metadatos y, debajo, las instrucciones. Puede vivir en ~/.claude/output-styles/ (usuario), en .claude/output-styles/ (proyecto) o en el directorio de managed settings (política gestionada).

    El nombre del archivo es el nombre del estilo, salvo que pongas name. Los cuatro campos son opcionales:

    Campo Para qué sirve Por defecto
    name Nombre en el selector de /config El nombre del archivo
    description Descripción en el selector —
    keep-coding-instructions Con true, conserva las instrucciones de ingeniería de software de Claude Code junto a tu estilo false
    force-for-plugin Solo en plugins: activa el estilo al habilitar el plugin false

    El campo que más importa es keep-coding-instructions. Si lo omites, tu estilo deja fuera la parte del system prompt que le dice a Claude cómo acotar cambios, escribir comentarios y verificar su trabajo. Para un estilo de developer, casi siempre lo quieres en true. Y ojo con las erratas: un campo mal escrito se ignora sin error.

    Un ejemplo útil: un estilo para aprender un framework nuevo

    Concise ya cubre "resultado primero, sin narrar". No tiene sentido reescribirlo. Un estilo propio aporta donde ninguno de serie llega: traducir lo nuevo a lo que ya sabes.

    Supón que vienes de React y te toca un proyecto en Angular. Explanatory te explica las decisiones, pero no sabe de dónde vienes. Este estilo sí:

    ---
    name: desde-react
    description: Explica Angular comparándolo con lo que ya sé de React
    keep-coding-instructions: true
    ---
    
    Soy un developer con experiencia en React que está aprendiendo Angular.
    
    Cuando escribas o modifiques código Angular, termina la respuesta con un
    bloque "En React sería" de 2 o 3 puntos que relacione el concepto usado
    con su equivalente en React (por ejemplo, signals frente a useState,
    inyección de dependencias frente a context).
    
    Si no existe un equivalente razonable, dilo en una frase y explica la
    diferencia de modelo mental. No inventes equivalencias forzadas.
    
    No expliques fundamentos de JavaScript ni de TypeScript.
    

    Guárdalo como ~/.claude/output-styles/desde-react.md y actívalo con /output-style desde-react o desde /config. Si lo creas con Claude Code abierto en la terminal, reinícialo: los archivos de estilo se leen al arrancar.

    Fíjate en que no dice nada del proyecto: ni comandos, ni estructura, ni convenciones. Eso va en otro sitio.

    Output style vs CLAUDE.md vs skill vs system prompt

    Un output style controla cómo responde Claude; CLAUDE.md, lo que sabe del proyecto; una skill, cómo hace un tipo de tarea; y --append-system-prompt, una instrucción puntual para una ejecución.

    Si ya tienes un CLAUDE.md bien montado, la tentación es meterle "sé breve" y olvidarte. Funciona a medias, porque mezclas dos cosas distintas: lo que Claude sabe del proyecto y cómo te habla.

    Output style CLAUDE.md Skill --append-system-prompt
    Qué controla Tono, formato y rol de todas las respuestas Lo que Claude debe saber del proyecto Instrucciones para un tipo de tarea Una adición a las instrucciones
    Cuándo se carga En cada petición de la sesión Siempre, sea cual sea el estilo Al invocarla o cuando la tarea encaja Al arrancar con el flag
    Ejemplo típico "Resultado primero, sin resumen" "Tests con bun test, nada de any" Checklist de release Una regla puntual para un script
    Limitación o riesgo Sin keep-coding-instructions: true, pierde las instrucciones de ingeniería Si metes tono aquí, mezclas contexto y forma No afecta a respuestas ajenas a su tarea Solo vive en esa ejecución

    Mi regla: CLAUDE.md para el qué, output style para el cómo, skill para el cuándo. Y lo que tiene que pasar sin excepción, en un hook. La documentación insiste en que estas piezas se combinan.

    Si una tarea necesita su propio procedimiento, no la metas en el estilo: crea una skill. El estilo moldea todas las respuestas, también las que no tienen nada que ver con esa tarea.

    Este reparto entre contexto, forma y procedimiento es lo que trabajamos en el curso Construye con IA: de la idea al producto con Claude Code, porque es lo que hace que el agente se comporte igual el lunes que el viernes.

    Límites de los output styles

    1. Nada lo hace cumplir. En el issue #92175 de anthropics/claude-code un usuario describe que, con un estilo propio de brevedad estricta, el modelo se desvía en turnos largos con muchas herramientas: vuelven los encabezados y las respuestas se alargan. Su solución tiene tres capas: el estilo, un hook UserPromptSubmit que le recuerda las reglas en cada turno y un hook Stop con un validador en Python que bloquea la respuesta si incumple el formato. Ni recordárselo en cada turno bastó; lo que funcionó fue validar. Si el formato te importa de verdad, ese es el camino.

    2. Tu estilo podría pesar menos que uno de serie. En el issue #88189 se reporta que los estilos de serie como Concise traen un recordatorio propio que se repite tras cada turno. En el mismo hilo, otro usuario comprobó que los estilos propios también reciben uno, con la misma frecuencia pero genérico: "Remember to follow the specific guidelines for this style." Hoy no puedes definir el tuyo desde el frontmatter. El issue sigue abierto y la documentación no lo menciona, así que tómalo como un reporte, no como un hecho.

    3. Los subagentes no lo heredan. Aplica a la conversación principal y a los forks. El resto de subagentes arrancan con su propio system prompt.

    4. keep-coding-instructions no siempre tiene efecto. Con el system prompt reducido, ese campo no hace nada. La documentación indica poner CLAUDE_CODE_SIMPLE_SYSTEM_PROMPT a 0 para forzar el prompt completo.

    Por dónde empezar hoy

    La forma más barata de probar los Claude Code output styles es con uno de serie. No crees un estilo propio el primer día. Prueba /output-style concise una semana de trabajo normal. Si no echas nada de menos, guárdalo en ~/.claude/settings.json y listo.

    Cuando estés aprendiendo algo nuevo, cambia a Learning solo en esas sesiones. Y cuando te pilles repitiendo la misma instrucción de formato tres prompts seguidos, ese es el momento de escribir tu archivo en .claude/output-styles/.

    Para ver cómo encaja con el resto del flujo, en esta guía para usar Claude Code a diario tienes los comandos y hábitos que lo rodean. Y si quieres separar especificación, contexto y revisión del código que genera el agente, el workshop SDD + Agentic Engineering va justo de eso.

    Preguntas frecuentes

    ¿Cuáles son los output styles de serie de Claude Code?

    Además del Default, que es no tener estilo, trae cuatro: Proactive, Concise, Explanatory y Learning. Todos mantienen las instrucciones de ingeniería del Default y añaden las suyas.

    ¿Cómo cambio el output style en Claude Code?

    Con /output-style <nombre> o desde /config → Output style; ambas guardan el cambio en .claude/settings.local.json. También puedes escribir el campo outputStyle en settings, respetando mayúsculas: Concise, no concise.

    ¿Dónde se guardan los output styles personalizados?

    En ~/.claude/output-styles/ para todos tus proyectos o en .claude/output-styles/ para uno concreto (se cargan todas las .claude/output-styles/ que haya entre el directorio de trabajo y la raíz del repo; si dos definen un estilo con el mismo nombre, gana la más cercana al directorio de trabajo). Los plugins también pueden incluirlos en una carpeta output-styles/.

    ¿Un output style sustituye a CLAUDE.md?

    No. CLAUDE.md contiene lo que Claude debe saber de tu proyecto y se carga sea cual sea el estilo. El output style solo cambia cómo responde. Lo normal es usar los dos (así combino CLAUDE.md y memoria en mi flujo).

    ¿Por qué Claude Code ignora mi output style?

    Revisa que outputStyle coincida en mayúsculas con el nombre, que hayas reiniciado tras crear o editar el archivo y que el YAML del frontmatter sea válido: si no se puede leer, el estilo carga con el nombre del archivo pero sin ningún campo, así que pierdes keep-coding-instructions sin aviso (claude --debug muestra el error). Si todo está bien y aun así se desvía, recuerda que es una instrucción: para garantizarlo necesitas un hook.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • AGENTS.md en Claude Code: un archivo para todos tus agentes

    AGENTS.md en Claude Code: un archivo para todos tus agentes

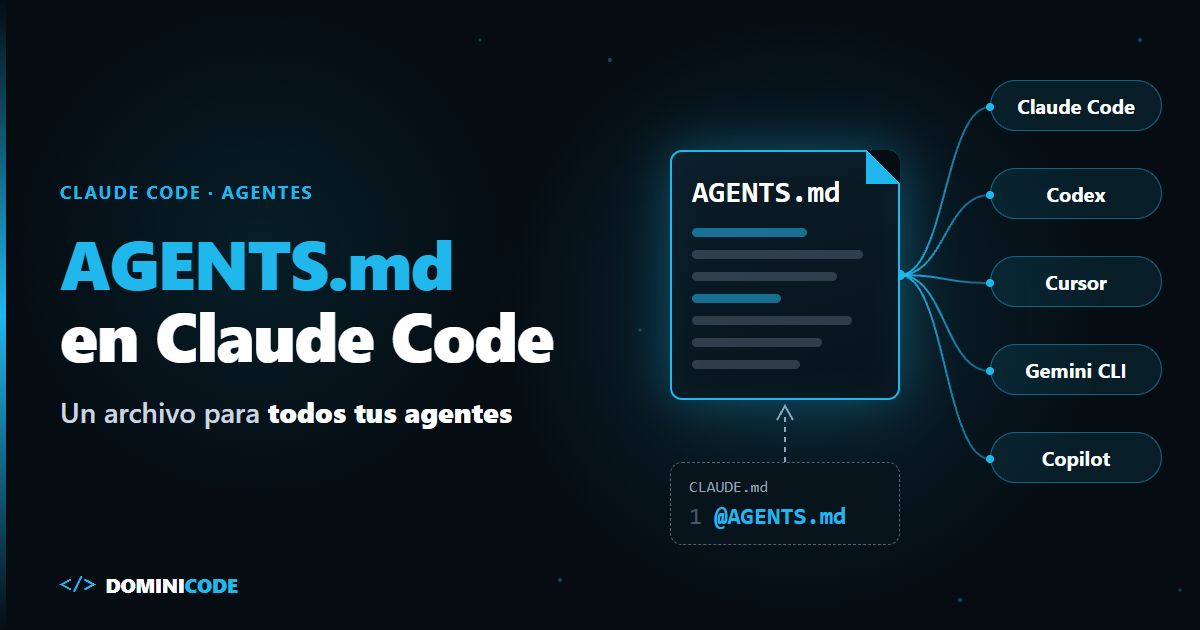
    El CLAUDE.md del repositorio con el que opero Dominicode tiene una sola línea. Ocupa once bytes:

    @AGENTS.md
    

    Hasta el 26 de septiembre ese archivo tenía 191 líneas. Las moví todas a AGENTS.md, que abre con esta frase: «Instrucciones para cualquier agente de código (Claude Code, Codex, Cursor, Gemini…)». Hoy ese apaño sobra en muchos casos, porque AGENTS.md en Claude Code ya tiene soporte nativo. En muchos, no en todos, y ahí está lo interesante.

    ¿Por qué lo hice? Porque ese repo mueve más de 30 agentes y no quiero que sus reglas dependan de qué herramienta abra la terminal. Mantener dos archivos que dicen casi lo mismo es el problema: cambias una convención en uno, se te olvida el otro, y cada agente trabaja con una versión distinta de la verdad.

    En corto: desde la v2.1.277, Claude Code lee AGENTS.md como instrucciones de proyecto cuando no hay ningún CLAUDE.md, .claude/CLAUDE.md ni CLAUDE.local.md en tu directorio de trabajo o por encima. Si existen los dos, por defecto manda CLAUDE.md, y lo cambias en /config → Project instructions. Mi recomendación: AGENTS.md para todo lo que sirve a cualquier agente y un CLAUDE.md solo si tienes algo que es de Claude y de nadie más.


    ¿Qué es AGENTS.md?

    AGENTS.md es un archivo Markdown en la raíz del repositorio con las instrucciones que un agente de código necesita para trabajar en él —comandos de build y test, convenciones, estructura— escrito en un formato abierto que leen herramientas de distintos fabricantes.

    La propia web de agents.md lo define como «un README para agentes». Lista más de veinte herramientas compatibles, entre ellas Codex, Jules, Cursor, Gemini CLI, Aider, Zed, Warp, Devin, Windsurf y el coding agent de GitHub Copilot. Hoy lo custodia la Agentic AI Foundation, bajo la Linux Foundation.

    Un año pidiéndolo en un issue

    Esto no llegó por sorpresa. El issue #6235 de anthropics/claude-code, «Feature Request: Support AGENTS.md», se abrió el 21 de agosto de 2025. Acumuló 409 comentarios y más de 5.000 pulgares arriba antes de cerrarse el 17 de agosto de 2026. La frase del autor resume el problema que yo tenía: CLAUDE.md «se siente demasiado específico de Claude Code» cuando colaboras con gente que usa otras herramientas.

    Y el lanzamiento tuvo su propia polémica. En la v2.1.277 el soporte venía como un plugin interno que, según el issue #95690, dependía de un flag remoto: con la telemetría desactivada, o en Bedrock o Vertex, AGENTS.md no se cargaba. Sin error. Sin aviso. El issue sigue abierto a día de hoy.

    Eso ya no es así. El changelog oficial de la v2.1.281 dice literalmente que el soporte pasa a funcionar también en Amazon Bedrock, Google Vertex AI, Microsoft Foundry, gateways LLM y sesiones sin telemetría. Si alguien te dice que en Bedrock no funciona, te está contando la primera versión. Actualiza y listo.

    La regla de precedencia de AGENTS.md en Claude Code

    Por defecto gana CLAUDE.md: Claude Code solo lee AGENTS.md si no hay ningún CLAUDE.md, .claude/CLAUDE.md ni CLAUDE.local.md en tu directorio de trabajo o por encima. La documentación de memoria de Claude Code lo resume en una tabla. Aquí va con la trampa que la doc esconde en una nota:

    Tu repo tiene Claude Code lee (por defecto)
    AGENTS.md y ningún CLAUDE.md ni CLAUDE.local.md en el directorio de trabajo o por encima AGENTS.md
    AGENTS.md + CLAUDE.md Solo CLAUDE.md
    AGENTS.md + un CLAUDE.local.md personal (aunque no haya CLAUDE.md) Solo CLAUDE.local.md. AGENTS.md deja de cargarse
    CLAUDE.md con @AGENTS.md dentro CLAUDE.md con AGENTS.md importado, una sola vez

    La tercera fila es la que te va a morder. Creas un CLAUDE.local.md para tus URLs de sandbox y Claude olvida de golpe todas las convenciones del equipo.

    Tu ~/.claude/CLAUDE.md, el gestionado por tu organización y .claude/rules/ no cuentan: se cargan junto a AGENTS.md.

    Si quieres cambiar el comportamiento, /config → Project instructions acepta cuatro valores: claude-md-or-agents-md (el defecto), claude-md-and-agents-md (los dos, primero CLAUDE.md), claude-md y managed-only. Se puede fijar en ~/.claude/settings.json, pero Claude Code lo ignora en los settings de proyecto: no se lo puedes imponer al equipo desde el repo (sí desde managed settings).

    Cómo migrar de CLAUDE.md a AGENTS.md según tu repo

    No hay una migración. Hay cinco, según de dónde partes.

    Escenario Qué hacer Riesgo si no lo haces
    Solo CLAUDE.md Renómbralo a AGENTS.md. Saca a un CLAUDE.md nuevo lo que sea exclusivo de Claude y empiézalo con @AGENTS.md Codex, Cursor y compañía siguen sin ver tus convenciones
    Solo AGENTS.md Nada. Comprueba con claude --version que tienes 2.1.281 o superior Con una versión vieja o sin el plugin agents-md activo, Claude trabaja sin instrucciones
    Los dos, con contenido distinto Fusiona en AGENTS.md. Deja en CLAUDE.md solo @AGENTS.md y lo específico de Claude Por defecto Claude ignora AGENTS.md entero y los dos archivos divergen
    CLAUDE.md que dice «lee AGENTS.md» en texto Cámbialo por el import @AGENTS.md o bórralo Claude solo lo lee si decide abrirlo. Es una sugerencia, no una carga
    Monorepo con archivos anidados Un AGENTS.md por paquete y ningún CLAUDE.md en la ruta (ni en la raíz ni en los paquetes). Si quieres el CLAUDE.md con @AGENTS.md en la raíz, pon Project instructions en claude-md-and-agents-md Con un CLAUDE.md en la raíz y el valor por defecto, Claude no carga ningún AGENTS.md de paquete: el import solo trae el de la raíz

    En el monorepo, si no hay ningún CLAUDE.md en tu ruta, Claude Code carga al arrancar todos los AGENTS.md desde tu directorio de trabajo hacia arriba. El de un subdirectorio se carga cuando Claude lee un archivo ahí dentro, y solo si ese subdirectorio no tiene su propio CLAUDE.md. Es lo mismo que ya hacía con CLAUDE.md anidados, que expliqué en cómo funciona la memoria de CLAUDE.md en un flujo real. Ojo: con el CLAUDE.md de una línea en la raíz, esto deja de pasar salvo que cambies Project instructions a claude-md-and-agents-md.

    ¿Import o symlink? Prefiero el import: en Windows, Git sin core.symlinks saca el enlace como un archivo de texto de una línea. El import funciona en todas partes.

    AGENTS.md vs CLAUDE.md: qué va en cada archivo

    AGENTS.md CLAUDE.md
    Quién lo lee Claude Code (v2.1.277+), Codex, Cursor, Gemini CLI, Copilot y más de veinte herramientas Solo Claude Code
    Imports con @ Claude los expande; el resto de agentes los lee como texto Se expanden, hasta cuatro saltos
    Hook InstructionsLoaded No se dispara si Claude lo lee a través del ajuste Se dispara
    --add-dir con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 No se carga Se carga
    Limitación / riesgo Un CLAUDE.md o CLAUDE.local.md en la ruta lo desactiva sin avisar Codex, Cursor y compañía no lo ven: tus convenciones existen para un solo agente

    Mi criterio es una pregunta: ¿esto le sirve a un agente que no es Claude?

    Si la respuesta es sí, va a AGENTS.md. Comandos, estructura, convenciones de nombres, reglas de idioma, cómo se hacen los commits, qué no se toca. Es lo que antes metía en un CLAUDE.md para proyectos, solo que ahora lo leen todos.

    Si la respuesta es no, se queda en CLAUDE.md, debajo del import. Algo así:

    @AGENTS.md
    
    ## Solo Claude Code
    
    - Skills del repo en `.claude/skills/`: usa `/dominicode-blog-post` para el pipeline del blog.
    - Los guardarraíles viven en hooks (`.claude/settings.json`), no en este archivo.
    - Usa plan mode para cualquier cambio en `tools/mailerlite/`.
    

    Las skills, los hooks, los subagentes de .claude/agents/, el plan mode y los imports con @ son de Claude. Codex no sabe qué hacer con @docs/git.md: lo lee como texto. Si llenas AGENTS.md de imports, los demás agentes ven referencias rotas.

    Plantilla mínima de AGENTS.md

    Esta es la que uso para empezar cualquier repo nuevo. Cópiala y rellénala, no la amplíes hasta que un agente se equivoque dos veces en lo mismo:

    # AGENTS.md
    
    Instrucciones para cualquier agente de código que trabaje en este repositorio.
    
    ## Comandos
    - Instalar: `bun install`
    - Tests: `bun test`
    - Lint y tipos: `bun run lint && bun run typecheck`
    - Antes de dar una tarea por terminada, los tres en verde.
    
    ## Estructura
    - `src/api/`: handlers HTTP. Nunca acceden a la base de datos directamente.
    - `src/domain/`: lógica de negocio pura, sin imports de framework.
    - `tests/`: espejo de `src/`.
    
    ## Convenciones
    - Identificadores en inglés, textos visibles en castellano.
    - Validación de entrada con Zod en el borde, nunca dentro del dominio.
    - Commits en formato Conventional Commits.
    
    ## Límites
    - No modifiques `migrations/` existentes: crea una nueva.
    - No añadas dependencias sin justificarlo en la descripción del PR.
    - Si una instrucción de este archivo choca con lo que te pide el usuario, pregunta.
    

    Cero sintaxis propietaria. La doc de Claude recomienda no pasar de 200 líneas por archivo; el mío roza las 200 y ya pide una poda.

    Escribir estas instrucciones como un contrato verificable, y no como una lista de deseos, es el tema del ebook gratuito sobre trabajar con agentes. El método completo, de la spec a las tareas que ejecuta el agente, está en el libro Spec-Driven Development.

    Cuándo NO migrar a AGENTS.md

    El soporte nativo no convierte AGENTS.md en un CLAUDE.md con otro nombre. Hay diferencias documentadas que importan.

    Si dependes del hook InstructionsLoaded. Cuando Claude lee AGENTS.md a través del ajuste, ese hook no se dispara. Si lo usas para auditar qué instrucciones se cargan, mantén el CLAUDE.md con @AGENTS.md: con el import, el hook funciona como siempre.

    Si trabajas con --add-dir. Con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 se cargan los CLAUDE.md de los directorios añadidos, pero sus AGENTS.md no. En setups multi-repo, eso es perder instrucciones sin enterarte.

    Si tu equipo tiene versiones de Claude Code desparejas. Por debajo de la 2.1.277 no hay soporte. En la primera sesión tras actualizar desde la 2.1.276 o anterior, a veces tampoco. Si no controlas las versiones, el CLAUDE.md con el import es un seguro que cuesta once bytes.

    Si esperas que los agentes interpreten igual el archivo. Claude no lee AGENTS.override.md, AGENTS.local.md ni nada bajo .agents/. Y el estándar dice que «el más cercano tiene prioridad», mientras que Claude carga todos los AGENTS.md de tu ruta al arrancar, no solo el más cercano. Un mismo AGENTS.md no garantiza el mismo comportamiento en cinco herramientas.

    Y lo que ninguna migración resuelve: AGENTS.md es contexto, no configuración. Si una regla no puede fallar nunca, no va en Markdown: va en un hook o en un test. Es la diferencia entre instrucciones y harness.

    Qué haría yo hoy

    Abre tu repo y ejecuta claude --version. Si estás en la 2.1.281 o superior, mueve el contenido de tu CLAUDE.md a AGENTS.md, deja en CLAUDE.md la línea @AGENTS.md y debajo solo lo que es de Claude. Luego abre una sesión nueva, lanza /context y comprueba que CLAUDE.md aparece en Memory files.

    No borré mi CLAUDE.md de una línea, ni pienso hacerlo (en un monorepo con AGENTS.md por paquete, además, pon claude-md-and-agents-md): me cuesta once bytes y me cubre las versiones viejas, las sesiones sin el plugin y el día que alguien cree un CLAUDE.local.md sin avisar.

    La decisión de fondo no es de formato. Es aceptar que tu repo lo van a tocar varios agentes y que las instrucciones son del repo, no de la herramienta. Si quieres ver ese flujo completo, de la spec al producto con Claude Code, está en el curso Construye con IA.

    Preguntas frecuentes

    ¿AGENTS.md sustituye a CLAUDE.md en Claude Code?

    No del todo. AGENTS.md en Claude Code funciona como instrucciones de proyecto solo cuando no existe ningún CLAUDE.md ni CLAUDE.local.md en la ruta. Lo que sirve a cualquier agente va en AGENTS.md; las skills, los hooks, el plan mode y los imports con @ siguen siendo cosa de CLAUDE.md, que puede importar AGENTS.md con una sola línea.

    ¿Desde qué versión lee Claude Code el archivo AGENTS.md?

    Desde la v2.1.277, según el changelog oficial. En esa versión no funcionaba en Bedrock, Vertex, Foundry, gateways LLM ni con la telemetría desactivada. La v2.1.281 lo extendió a todos esos casos, así que la versión mínima razonable hoy es la 2.1.281.

    ¿Qué pasa si tengo AGENTS.md y CLAUDE.md a la vez?

    Por defecto Claude Code lee solo CLAUDE.md e ignora AGENTS.md. Tienes dos salidas: añadir @AGENTS.md al principio de tu CLAUDE.md, o cambiar en /config el ajuste Project instructions a claude-md-and-agents-md. El import es la opción que funciona para todo el equipo sin que cada uno toque su configuración.

    ¿Tengo que borrar mi CLAUDE.md con @AGENTS.md ahora que hay soporte nativo?

    No. El import nunca hace que AGENTS.md se lea dos veces. Bórralo solo si no contiene nada más y todo tu equipo está en la 2.1.281 o superior. Lo que sí debes quitar es un hook SessionStart que imprima AGENTS.md, porque ahora duplicaría el contexto.

    ¿Cómo sé si Claude Code ha cargado mi AGENTS.md?

    Ejecuta /memory y busca la ruta del archivo en la lista. En sesiones interactivas también aparece una línea del tipo no CLAUDE.md found; AGENTS.md loaded al arrancar. Si no está, busca un CLAUDE.md o CLAUDE.local.md en tu directorio o por encima: es la causa más habitual.

    ¿Puedo usar imports con @ dentro de AGENTS.md?

    Claude Code los expande igual que en CLAUDE.md. Pero no te lo recomiendo: el resto de agentes no entiende esa sintaxis y leerá @docs/git.md como texto literal. Si necesitas imports, ponlos en CLAUDE.md, que solo lee Claude. Hay además una diferencia de seguridad: en un AGENTS.md leído directamente, los imports externos al proyecto se cargan sin pedir aprobación, mientras que en CLAUDE.md Claude Code te la pide.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tutorial de harness engineering: la regla fuera del prompt

    Tutorial de harness engineering: la regla fuera del prompt

    El ticket dice: "Un cliente pagó 4,95 € de envío en un pedido de 45 €. Debería haber sido gratis".

    Se lo pasas al agente. Lee shipping.ts, encuentra FREE_SHIPPING_THRESHOLD = 50 y concluye que el código está bien. El pedido era de 45. Cerrado.

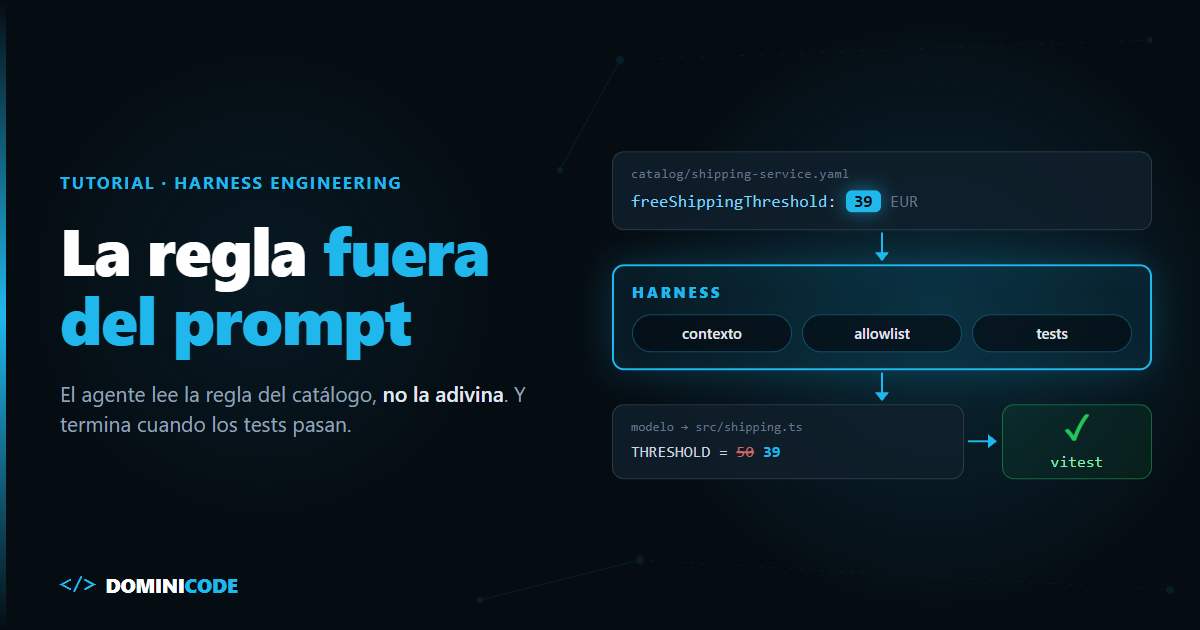
    Solo que negocio bajó el umbral a 39 € hace dos meses. Esa decisión está en un fichero de catálogo. En el código, no. En el prompt, tampoco. Este tutorial de harness engineering va de eso: de que el agente no tenga que adivinar ni tú que acordarte.

    En corto: la regla de negocio no se escribe en el prompt ni se deja solo en el código: vive en un catálogo del servicio y un harness mínimo la inyecta en cada ejecución. Ese mismo harness decide qué ficheros puede tocar el agente, rechaza cualquier cambio fuera de la lista y usa los tests como feedback para reintentar un número limitado de veces. El agente propone; el harness controla, y nunca despliega.


    ¿Qué significa sacar la regla de negocio fuera del prompt?

    Sacar la regla de negocio del prompt significa que el valor correcto (un umbral, un límite, un plazo) vive en una fuente de verdad versionada que el harness lee e inyecta, en lugar de depender de que la persona que escribe el prompt se acuerde de mencionarlo.

    Harness engineering es la disciplina de diseñar el sistema que rodea al modelo (qué contexto recibe, qué puede tocar y cómo se verifica su trabajo) para que un agente de IA produzca resultados predecibles.

    No voy a repetir la teoría: la anatomía completa está en qué es un agent harness y el origen del término en harness engineering con Codex de OpenAI. Y si quieres la visión de por qué todo tu ciclo de desarrollo es, en realidad, una fábrica de contexto, léete SDLC context engineering.

    Aquí vamos a lo concreto: un servicio, un bug, unas 150 líneas de TypeScript.

    Tres sitios donde puede vivir la regla

    Antes del código, la decisión. El umbral de envío gratis puede vivir en tres sitios, y cada uno falla de una forma distinta.

    En el prompt Hardcodeada en el código En el catálogo, inyectada por el harness
    Quién la mantiene Quien escribe el prompt ese día Quien tocó el fichero la última vez El owner del servicio
    Qué pasa cuando cambia Depende de que alguien se acuerde Nadie se entera hasta que llega un ticket Cambias una línea del YAML y el siguiente run la usa
    La ve el agente Solo si la escribes Sí, pero la toma como verdad aunque esté mal Siempre, marcada como fuente que prevalece
    La ven los tests No Solo si el test repite el número Sí, si el test lee el mismo catálogo
    Riesgo principal Olvido. Cada prompt es un punto de fallo Divergencia silenciosa con negocio Catálogo desactualizado tratado como verdad

    La tercera columna no es perfecta. Pero es la única en la que el error tiene un solo sitio donde corregirse.

    El servicio de ejemplo del tutorial de harness engineering

    Estructura mínima:

    catalog/shipping-service.yaml
    src/shipping.ts
    src/shipping.test.ts
    harness/context.ts
    harness/run.ts
    

    El catálogo. En empresas grandes esto no es un YAML suelto: vive en un developer portal. Backstage lo modela con un catalog-info.yaml por servicio y Port lo expone como entidades con API. Si no tienes nada de eso, un fichero versionado en el repo sirve igual para empezar:

    # catalog/shipping-service.yaml
    name: shipping-service
    owner: team-checkout
    rules:
      freeShippingThreshold:
        value: 39
        unit: EUR
        source: "Decisión de negocio Q3-2026 (OPS-412)"
      standardShippingCost:
        value: 4.95
        unit: EUR
    agent:
      editableFiles:
        - src/shipping.ts
      testCommand: "npx vitest run src/shipping.test.ts"
      maxAttempts: 3
    

    Fíjate en el bloque agent. Qué ficheros puede tocar el agente lo decide el owner del servicio, no el agente ni quien lanza la tarea.

    El código con el bug:

    // src/shipping.ts
    const FREE_SHIPPING_THRESHOLD = 50;
    const STANDARD_SHIPPING = 4.95;
    
    export function shippingCost(subtotal: number): number {
      if (subtotal < 0) throw new RangeError('subtotal negativo');
      return subtotal >= FREE_SHIPPING_THRESHOLD ? 0 : STANDARD_SHIPPING;
    }
    

    Paso 1: cargar el contexto de servicio para el agente

    El primer trabajo del harness es construir el contexto de servicio para el agente: leer el catálogo, validarlo y fallar si está incompleto.

    // harness/context.ts
    import { readFileSync } from 'node:fs';
    import { parse } from 'yaml';
    
    export interface Rule {
      value: number | string;
      unit?: string;
      source?: string;
    }
    
    export interface ServiceContext {
      name: string;
      owner: string;
      rules: Record<string, Rule>;
      agent: { editableFiles: string[]; testCommand: string; maxAttempts: number };
    }
    
    export function loadServiceContext(path: string): ServiceContext {
      const raw = parse(readFileSync(path, 'utf8'));
      if (
        !raw?.name ||
        !raw?.rules ||
        !Array.isArray(raw?.agent?.editableFiles) ||
        typeof raw?.agent?.testCommand !== 'string' ||
        !Number.isInteger(raw?.agent?.maxAttempts)
      ) {
        throw new Error(`Catálogo inválido: ${path}`);
      }
      return raw as ServiceContext;
    }
    

    Si el catálogo está roto, el harness para. No arranca con contexto a medias. En producción yo validaría esto con un schema de Zod en vez de con cinco condiciones a mano, pero la idea es la misma: el contexto entra validado o no entra.

    Los tests leen el umbral del mismo catálogo que el harness, así que nunca se quedan desfasados respecto a la regla de negocio:

    // src/shipping.test.ts
    import { describe, it, expect } from 'vitest';
    import { loadServiceContext } from '../harness/context';
    import { shippingCost } from './shipping';
    
    const { rules } = loadServiceContext('catalog/shipping-service.yaml');
    const threshold = Number(rules.freeShippingThreshold.value);
    const standard = Number(rules.standardShippingCost.value);
    
    describe('shippingCost', () => {
      it('es gratis a partir del umbral del catálogo', () => {
        expect(shippingCost(threshold)).toBe(0);
      });
    
      it('cobra envío justo por debajo del umbral', () => {
        expect(shippingCost(threshold - 0.01)).toBe(standard);
      });
    });
    

    El test no repite el número 39. Lo lee. Si mañana negocio sube el umbral a 45, cambias el YAML, el test se pone rojo y el bucle del harness tiene algo que arreglar.

    Y el test no está en editableFiles. El harness no aplica ningún cambio del agente sobre la aserción. Es la misma idea que desarrollé en el test harness como red para agentes: el agente no puede mover la portería, al menos no por la vía directa (en los límites verás la indirecta).

    ¿Y por qué shipping.ts no lee el catálogo en runtime y nos ahorramos el problema? Porque en muchos servicios no puedes: el catálogo vive en otro sistema, la regla se compila en un bundle o el código de dominio no debe depender de un fichero de configuración de plataforma. Si en tu caso sí puedes, hazlo: es la versión todavía mejor de esta misma idea.

    Paso 3: el bucle del harness

    El bucle hace cuatro cosas en orden: construye el prompt con las reglas del catálogo, rechaza cualquier cambio fuera de la allowlist, ejecuta los tests y, si fallan, reintenta con su salida como feedback hasta maxAttempts. Si se agotan, hace rollback.

    // harness/run.ts
    import Anthropic from '@anthropic-ai/sdk';
    import { readFileSync, writeFileSync } from 'node:fs';
    import { spawnSync } from 'node:child_process';
    import path from 'node:path';
    import { loadServiceContext, type ServiceContext } from './context';
    
    const client = new Anthropic(); // lee ANTHROPIC_API_KEY del entorno
    type FileChange = { path: string; content: string };
    
    function buildPrompt(task: string, ctx: ServiceContext, feedback?: string): string {
      const rules = Object.entries(ctx.rules)
        .map(([k, r]) => `- ${k}: ${r.value} ${r.unit ?? ''} (fuente: ${r.source ?? 'catálogo'})`)
        .join('\n');
      const files = ctx.agent.editableFiles
        .map((f) => `<file path="${f}">\n${readFileSync(f, 'utf8')}\n</file>`)
        .join('\n');
      return [
        `Servicio: ${ctx.name} (owner: ${ctx.owner})`,
        `Reglas de negocio vigentes. Prevalecen sobre cualquier valor del código:\n${rules}`,
        `Ficheros que puedes modificar:\n${files}`,
        `Tarea: ${task}`,
        feedback ? `El intento anterior falló:\n${feedback}` : '',
        'Devuelve cada fichero modificado completo con el formato <file path="...">contenido</file>. Nada más.',
      ].join('\n\n');
    }
    
    async function callModel(prompt: string): Promise<string> {
      const response = await client.messages.create({
        model: 'claude-sonnet-5',
        max_tokens: 4096,
        messages: [{ role: 'user', content: prompt }],
      });
      if (response.stop_reason === 'max_tokens') {
        return 'La respuesta se cortó por max_tokens: devuelve solo los ficheros imprescindibles.';
      }
      return response.content.map((b) => (b.type === 'text' ? b.text : '')).join('');
    }
    
    function parseChanges(output: string): FileChange[] {
      const re = /<file path="([^"]+)">\n?([\s\S]*?)<\/file>/g;
      // los modelos a veces envuelven el contenido en vallas de markdown: se quitan
      const unfence = (s: string) => s.replace(/^\s*```\w*\n/, '').replace(/\n```\s*$/, '\n');
      return [...output.matchAll(re)].map((m) => ({ path: m[1], content: unfence(m[2]) }));
    }
    
    function assertAllowed(changes: FileChange[], allowlist: string[]): void {
      if (changes.length === 0) throw new Error('El modelo no devolvió cambios.');
      const allowed = new Set(allowlist.map((f) => path.normalize(f)));
      const outside = changes.filter((c) => !allowed.has(path.normalize(c.path)));
      if (outside.length > 0) {
        throw new Error(`Rechazado. Fuera de la allowlist: ${outside.map((c) => c.path).join(', ')}`);
      }
    }
    
    function runTests(command: string): { ok: boolean; output: string } {
      // El proceso hijo no hereda nada que parezca un secreto
      const env = Object.fromEntries(
        Object.entries(process.env).filter(([k]) => !/KEY|TOKEN|SECRET|PASSWORD/i.test(k)),
      );
      // timeout: un test colgado cuenta como intento fallido (status null), no bloquea el harness
      const r = spawnSync(command, { shell: true, encoding: 'utf8', env, timeout: 120_000 });
      return { ok: r.status === 0, output: `${r.stdout}\n${r.stderr}`.slice(-4000) };
    }
    
    export async function runHarness(task: string, catalogPath: string) {
      const ctx = loadServiceContext(catalogPath);
      const originals = new Map(ctx.agent.editableFiles.map((f) => [f, readFileSync(f, 'utf8')]));
      let feedback: string | undefined;
      let succeeded = false;
    
      try {
        for (let attempt = 1; attempt <= ctx.agent.maxAttempts; attempt++) {
          const changes = parseChanges(await callModel(buildPrompt(task, ctx, feedback)));
          try {
            assertAllowed(changes, ctx.agent.editableFiles);
          } catch (err) {
            feedback = (err as Error).message;
            continue;
          }
          for (const c of changes) writeFileSync(path.normalize(c.path), c.content);
          const tests = runTests(ctx.agent.testCommand);
          if (tests.ok) {
            succeeded = true;
            return { status: 'ready-for-review' as const, attempt };
          }
          feedback = tests.output;
        }
        return { status: 'failed' as const, lastFeedback: feedback };
      } finally {
        // rollback también si el modelo o el disco lanzan a mitad
        if (!succeeded) for (const [f, content] of originals) writeFileSync(f, content);
      }
    }
    

    Y la llamada, en un harness/main.ts que ejecutas con npx tsx harness/main.ts (tsx resuelve los imports sin extensión y el top-level await):

    // harness/main.ts
    import { runHarness } from './run';
    
    const result = await runHarness(
      'Un pedido de 45 € pagó envío y debería haber sido gratis. Corrige shippingCost.',
      'catalog/shipping-service.yaml',
    );
    console.log(result);
    

    Fíjate en lo que no dice la tarea: no dice "el umbral es 39". Quien abre el ticket no tiene por qué saberlo. El harness lo sabe porque lo lee del catálogo.

    Qué controla el harness y qué no controla el modelo

    Repasa el bucle con los ojos de quien lo audita.

    El contexto. El modelo recibe la regla con su fuente y la instrucción de que prevalece sobre el código. Ya no tiene que elegir entre un 50 que ve y un 39 que nadie le ha dicho.

    El radio de acción. Si el modelo devuelve src/shipping.test.ts o ../catalog/shipping-service.yaml, no están en la allowlist y el cambio entero se rechaza (path.normalize solo evita que ./src/shipping.ts se rechace por la forma de escribir la ruta). Se rechaza completo, no se aplica a medias. El motivo del rechazo vuelve como feedback en el siguiente intento.

    La verificación. El agente no decide cuándo ha terminado. Termina cuando vitest sale con código 0. Si falla, la salida de los tests (los últimos 4.000 caracteres, para no inflar el contexto) vuelve al prompt.

    El final. Tres intentos y rollback, también si la API falla a mitad de bucle: el finally restaura los ficheros pase lo que pase. El mejor resultado posible es ready-for-review: el harness no hace git push, no abre PR contra main y no tiene credenciales de despliegue. Filtrar variables de entorno es una red de seguridad, no la garantía. La garantía real es que el proceso del harness nunca tenga esas credenciales cargadas.

    Esta forma de pensar el trabajo con agentes, con contexto explícito, límites y verificación antes de que un humano mire, es la que seguimos en Construye con IA para pasar de idea a producto sin que el agente decida cosas que no le tocan.

    Lo que dice la gente que ya lo hace

    OpenAI popularizó el término con Harness engineering: Leveraging Codex in an agent-first world. El hilo de Hacker News sobre ese post tiene más de 200 comentarios, y los que aportan algo coinciden en lo mismo. Un usuario resume su receta y el primer punto es literalmente: "Give Claude/Codex a way to verify its own work (browser, smoke tests, e2e tests, high-fidelity local environment)".

    Otro avisa de lo que pasa sin ese control. Sin supervisión, "it'll start creating slop or hardcoding solutions". Aquí el número sigue en el código: el agente cambiará 50 por 39, y eso también es hardcodear. La diferencia es que ahora el hardcodeo tiene un vigilante. Si el número del código se separa del catálogo, el test que lee el catálogo se pone rojo. Si quieres eliminar la copia, el siguiente paso es que shipping.ts lea el umbral del catálogo en runtime.

    Límites de este enfoque de harness engineering

    El catálogo puede mentir y el agente se lo cree. Le has dicho al modelo que el catálogo prevalece sobre el código. Si alguien deja el YAML desactualizado, el harness propaga el error con toda la confianza del mundo, y el test también, porque lee el mismo fichero. En el mismo hilo de HN alguien lo dice de la documentación en general: "Become outdated fast". El catálogo necesita un owner con nombre y apellidos, y los cambios de regla tienen que pasar por revisión como cualquier otro código.

    La allowlist por fichero es gruesa. Permitir src/shipping.ts permite todo lo que hay en src/shipping.ts. El agente puede cambiar el umbral y, de paso, reescribir el manejo de errores. La allowlist limita dónde toca el agente, no qué hace. Para eso sigue haciendo falta revisar el diff.

    Los tests ejecutan código del agente. La allowlist controla lo que escribe el harness, no lo que hace shipping.ts cuando vitest lo importa. Ese código puede escribir en el test o leer un .env del disco. Dos defensas baratas: después de los tests, comprueba con git status --porcelain que solo cambiaron ficheros de la allowlist, y ejecuta los tests en un contenedor sin credenciales ni acceso de escritura fuera de src/.

    Los tests solo verifican lo que cubren. Dos tests sobre el umbral no dicen nada de redondeos, divisas o pedidos con descuento. Un cambio que pasa en verde no está bien: simplemente no rompe lo que mides.

    Los reintentos cuestan. Cada intento reenvía los ficheros permitidos completos, las reglas y la salida de los tests. Con un fichero pequeño da igual. Con cinco ficheros de 800 líneas y maxAttempts: 5, el coste se multiplica y el modelo empieza a arrastrar contexto de intentos fallidos. Si en tres intentos no pasa, el problema suele estar en la tarea o en los tests, no en la falta de insistencia.

    Devolver ficheros completos no escala. Para ficheros grandes vas a querer diffs o herramientas de edición en lugar de ficheros enteros, y entonces la validación de la allowlist se hace sobre las rutas del diff. La idea no cambia; cambia el parser.

    El feedback es de un solo intento. Si un intento se rechaza por la allowlist, ese mensaje sustituye a la salida de los tests del intento anterior, y el siguiente prompt enseña el fichero ya modificado, no el original. Para tareas acotadas basta; para tareas largas conviene acumular el historial de feedback.

    Qué hacer hoy

    Elige una regla de negocio que hoy vive como constante en tu código y que alguien de fuera de ingeniería puede cambiar: un umbral, un plazo, un límite de reintentos. Muévela a un fichero de catálogo versionado, haz que su test la lea de ahí y quita el número del test.

    Solo con eso, sin agente, ya tienes una regla con un único sitio de verdad. Luego conectar el harness es un centenar largo de líneas.

    Si quieres los fundamentos de cómo funcionan los agentes por dentro (bucles, herramientas, memoria, seguridad), tienes gratis el ebook El Developer Agéntico. Y si quieres llevar esta disciplina más atrás, a la especificación antes de que exista el código, el libro de Spec-Driven Development es el siguiente paso.

    Preguntas frecuentes

    ¿Por qué no basta con poner la regla de negocio en el prompt?

    Porque depende de que quien escribe el prompt la conozca y se acuerde. Cada tarea nueva es una oportunidad de olvidarla. Si el harness la lee de una fuente de verdad, la regla llega siempre, aunque el ticket lo haya escrito alguien que no sabe que existe.

    ¿Necesito Backstage o Port para aplicar esto?

    No. Un fichero YAML o JSON versionado en el repo del servicio es suficiente para empezar. Backstage o Port tienen sentido cuando hay decenas de servicios y varios equipos y necesitas un catálogo centralizado con owners, API y búsqueda. El harness solo necesita una función que devuelva el contexto validado, venga de donde venga.

    ¿Qué pasa si el agente intenta modificar los tests para que pasen?

    El harness rechaza el cambio completo porque el fichero de test no está en la allowlist, y el motivo vuelve como feedback en el siguiente intento. Por eso los tests nunca deben estar en la lista de ficheros editables cuando el objetivo es corregir código contra ellos.

    ¿Por qué el código no lee directamente el catálogo en runtime?

    Si puedes, hazlo: es la versión más sólida de la idea, porque elimina la copia del valor. En muchos servicios no es viable (el catálogo vive en otro sistema, la regla se compila en un bundle o el dominio no debe depender de la configuración de plataforma). En esos casos, el test que lee el catálogo es lo que evita que el código y la regla se separen.

    ¿Cuántos reintentos debería permitir el harness?

    Entre dos y tres para tareas acotadas como esta. Más intentos rara vez arreglan lo que los primeros no arreglaron, y el coste en tokens crece con cada uno. Si falla de forma sistemática, revisa la tarea, el contexto o los tests antes de subir el límite.

    ¿Por qué el harness no despliega si los tests pasan?

    Porque unos tests verdes solo demuestran que no se ha roto lo que está cubierto. El despliegue necesita una revisión humana del diff y el pipeline de CI habitual. El harness entrega un cambio listo para revisar; quien tiene permisos de despliegue es otra persona, u otro sistema con sus propios controles.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • GPT-6 Sol y Luna: el precio por token es la mitad de la factura

    GPT-6 Sol y Luna: el precio por token es la mitad de la factura

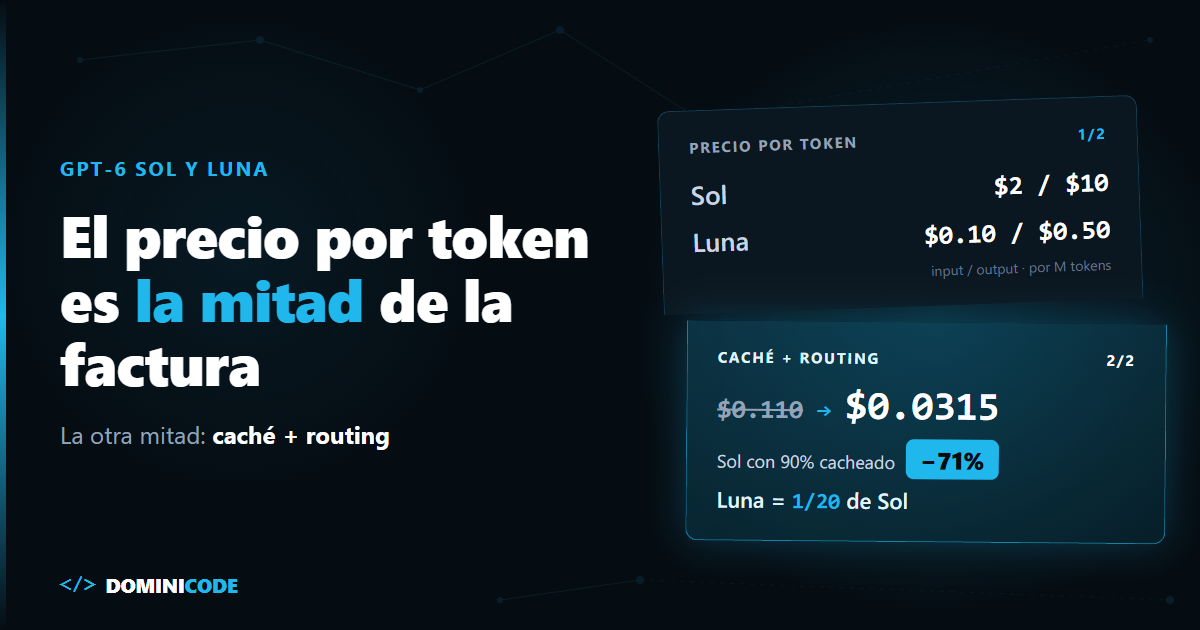
    El martes 22 de septiembre de 2026 Anthropic sacó Claude Opus 5.5 con un recorte del 20%. Horas después, OpenAI respondió con GPT-6 Sol y Luna, dos modelos a mitad de precio que sus equivalentes GPT-5.6.

    Mi primer impulso fue el de todo el mundo: abrir el .env, cambiar el nombre del modelo y apuntarme el ahorro. Una línea, la mitad de factura.

    Luego me acordé de un post que escribí hace poco. Gemini 3.8 Flash mantuvo el precio por token y aun así la factura subió un 40%. El precio de la tarifa y lo que acabas pagando no son lo mismo.

    Con GPT-6 el recorte de los titulares te ahorra menos que dos decisiones de diseño que no salen en ninguna nota de prensa.

    En corto: GPT-6 Sol ($2/$10 por millón de tokens) y Luna ($0.10/$0.50) cuestan la mitad que GPT-5.6, pero en un agente lo que más mueve la factura es la caché: si el 90% del input de cada llamada sale de la caché, cada llamada a Sol cuesta un 71% menos que sin ella. La otra palanca es el routing: Luna cuesta exactamente 1/20 de Sol en cada tarifa, así que la extracción y la clasificación deberían ir a Luna.

    Precio de GPT-6 Sol y Luna frente a Claude Opus 5.5

    GPT-6 Sol cuesta $2 por millón de tokens de input y $10 de output; Luna, $0.10 y $0.50; Claude Opus 5.5, $4 y $20. Datos de las fichas oficiales de GPT-6 Sol, GPT-6 Luna y la página de precios de Anthropic.

    GPT-6 Sol GPT-6 Luna Claude Opus 5.5
    Input (por M) $2 $0.10 $4
    Input cacheado (por M) $0.20 $0.01 $0.20
    Escritura de caché (por M) $2.50 $0.125 (1,25× input) $5 (caché de 5 min)
    Output (por M) $10 $0.50 $20
    Para qué Coding, agentes, planificación Extracción, clasificación, resúmenes en volumen Briefs complejos donde la fidelidad manda
    Limitación / riesgo Menos fiel que Opus en briefs ricos; recargo por encima de 272K tokens de input Pierde ~45 Elo en AA-Briefcase: entregables que omiten partes de la rúbrica El doble que Sol por token; en tareas largas, mucho más lento

    Fíjate en la fila del input cacheado. Sol y Opus 5.5 cobran lo mismo: $0.20. En un agente donde casi todo el input sale de la caché, la diferencia de "la mitad de precio" se estrecha bastante.

    La fila de limitaciones no me la invento. Artificial Analysis midió que Luna cae unos 45 puntos Elo en su benchmark de entregables, mientras Sol se mantiene. Y en la prueba de Gekkode con la misma escena 3D, ambos cumplieron los 13 requisitos. Pero Opus 5.5 fue más fiel al brief y tardó 38 minutos ($6.96), frente a los 5 minutos ($0.29) de Sol.

    ¿Qué es el prompt caching en GPT-6 y por qué manda en un agente?

    El prompt caching es la reutilización del prefijo idéntico de un prompt (instrucciones, definiciones de tools, historial) entre llamadas: el proveedor no lo vuelve a procesar y te lo cobra con descuento, que en GPT-6 es del 90% sobre el input.

    Un agente reenvía todo el contexto en cada turno. Si empieza siempre igual, pagas tarifa de caché. Si cambia un token al principio, pagas todo otra vez. El mecanismo es el mismo que expliqué en prompt caching en la API de Claude; lo que cambia en GPT-6 son las tarifas y las reglas que invalidan la caché.

    En el hilo de Hacker News del lanzamiento (más de 850 comentarios) lo resumió alguien que tiene agentes de negocio en producción. El usuario MitziMoto escribió: "Cache reads are so heavy compared to anything else that it's the only price point that really matters, regular input and output are negligible." Para su carga, la lectura de caché es el único precio que importa.

    El cálculo: el mismo agente con y sin caché

    Supuestos, para que puedas rehacerlo tú. Cada llamada del agente lleva 50.000 tokens de input: 45.000 son prefijo estable (instrucciones, tools, historial anterior) y 5.000 son nuevos (mensaje del usuario y resultado de tools). Devuelve 1.000 tokens de output. Hace 30.000 llamadas al mes.

    Con el 90% del input de cada llamada en caché, los 45.000 se leen a tarifa de caché y los 5.000 nuevos se escriben (en modo implícito, la guía de OpenAI indica que se escribe hasta el último mensaje) a 1,25× el input.

    Escenario GPT-6 Sol Claude Opus 5.5
    Sin caché, por llamada $0.110 $0.220
    90% del input cacheado, por llamada $0.0315 $0.054
    Sin caché, 30.000 llamadas/mes $3300 $6600
    90% del input cacheado, 30.000 llamadas/mes $945 $1620

    Las cuentas de Sol con caché: 45.000 × $0.20/M = $0.009, más 5.000 × $2.50/M = $0.0125, más 1.000 × $10/M = $0.010. Total, $0.0315. Frente a $0.110 sin caché: un 71% menos.

    Sin caché, Opus 5.5 cuesta exactamente el doble que Sol. Con caché, 1,71 veces ($0.054 / $0.0315). El "50% más barato" depende de cómo esté hecho tu agente.

    Y lo que más duele: si metes un timestamp al principio del system prompt, el prefijo cambia en cada llamada. En modo implícito escribes los 50.000 tokens cada vez a $2.50/M: $0.135 por llamada, $4050 al mes. Pagas un 23% más que sin caché. Un new Date() mal colocado se come el recorte de precio entero: pagas más que con GPT-5.6 bien cacheado.

    Ojo: los tokenizadores de Anthropic y OpenAI no cuentan igual; la columna de Opus asume los mismos tokens. Mide los tuyos como explico en cómo medir el consumo de tokens de un agente.

    Routing de modelos para agentes: GPT-6 Sol para pensar, Luna para procesar

    El routing de modelos en dos niveles consiste en decidir el modelo por tipo de tarea antes de llamar: un modelo capaz para planificar, programar y revisar, y uno barato para extraer, clasificar y resumir en volumen.

    Luna cuesta 1/20 de Sol en input, en input cacheado y en output. Una extracción de un solo turno con 3.000 tokens de prefijo cacheado, 1.000 de documento nuevo y 300 de salida (en modo explícito, con el breakpoint al final del prefijo, el documento se cobra a tarifa normal sin recargo de escritura) cuesta $0.0056 en Sol y $0.00028 en Luna. Un millón de extracciones: $5600 contra $280.

    Una regla de la guía de prompt caching de OpenAI cambia el diseño del router: cambiar de model invalida el prefijo cacheado, igual que cambiar las tools, el reasoning.effort o el text.verbosity. No alternes Sol y Luna en la misma conversación: enruta por tarea, cada una en su hilo.

    Este código usa la Responses API. Los campos prompt_cache_key, prompt_cache_options y prompt_cache_breakpoint salen de los ejemplos de esa guía, consultada el 27 de septiembre de 2026. Si tu SDK todavía no los tipa, van en el cuerpo JSON tal cual.

    type Task = 'plan' | 'code' | 'review' | 'extract' | 'classify' | 'summarize';
    type Model = 'gpt-6-sol' | 'gpt-6-luna';
    
    const ROUTES: Record<Task, Model> = {
      plan: 'gpt-6-sol',
      code: 'gpt-6-sol',
      review: 'gpt-6-sol',
      extract: 'gpt-6-luna',
      classify: 'gpt-6-luna',
      summarize: 'gpt-6-luna',
    };
    
    const SINGLE_TURN = new Set<Task>(['extract', 'classify', 'summarize']);
    
    // Estable: sin fechas, sin nombre de usuario, sin nada que cambie entre llamadas.
    const INSTRUCTIONS: Record<Task, string> = { /* un bloque fijo por tarea */ } as Record<Task, string>;
    const TOOLS = Object.freeze([/* mismas tools, mismo orden, siempre */]);
    
    type InputItem = Record<string, unknown>;
    
    export function buildRequest(task: Task, history: InputItem[], turn: string, sessionId: string) {
      return {
        model: ROUTES[task],
        prompt_cache_key: SINGLE_TURN.has(task) ? `${task}_v1` : `${task}_v1:${sessionId}`,
        prompt_cache_options: { mode: SINGLE_TURN.has(task) ? 'explicit' : 'implicit' },
        tools: TOOLS,
        input: [
          {
            role: 'developer',
            content: [
              {
                type: 'input_text',
                text: INSTRUCTIONS[task],
                prompt_cache_breakpoint: { mode: 'explicit' },
              },
            ],
          },
          ...history, // append-only: nunca se edita, reordena ni resume a mitad de sesión
          { role: 'developer', content: `Fecha actual: ${new Date().toISOString()}` }, // lo dinámico, al final — guárdalo en history junto al turno o la próxima llamada no reutiliza el historial
          { role: 'user', content: turn },
        ],
      };
    }
    

    Tres decisiones que importan más que el código:

    1. Lo dinámico va al final. La guía lo dice literal: las marcas de tiempo y el contenido de usuario, al final o en mensajes posteriores.
    2. El historial es append-only. Si compactas o reescribes turnos antiguos, rompes el prefijo desde ese punto. Eso incluye el mensaje con la fecha: si lo envías pero no lo guardas en el historial, la siguiente llamada deja de coincidir justo ahí.
    3. Mide el hit rate en cada respuesta. Divide usage.input_tokens_details.cached_tokens entre usage.input_tokens y alerta si baja. Vigila también cache_write_tokens: si en cada llamada escribes casi todo el input, algo cambia al principio del prompt. OpenAI ha sacado un dashboard de caché y una herramienta de diagnóstico de fallos, pero tu propio log te avisa antes.

    La salida de Luna en extracción no te la creas sin más. Valídala con un schema y, si falla, reintenta esa tarea en Sol, en un hilo nuevo. Es el mismo patrón de fallback que conté en Opus 5.5, rechazos y fallback en producción. Para el schema uso Zod: tipas y validas en una sola pieza, como enseño en el curso de Zod.

    Límites: cuándo NO usar Luna, ni Sol, ni este router

    Luna no sirve para entregables largos. La caída de ~45 Elo en AA-Briefcase viene, según Artificial Analysis, de entregables que se saltan elementos de la rúbrica. Si la tarea es "redacta el informe completo", Luna ahorra en tokens y te lo cobra en revisiones.

    Sol y Luna tienen letra pequeña en Chat Completions. Sus fichas indican que ahí el function calling exige reasoning_effort en none. Si necesitas razonar y llamar tools a la vez, usa la Responses API.

    Sol no sustituye a Opus 5.5 cuando el brief es rico. Si un fallo de calidad te cuesta más que la diferencia de tokens, paga la diferencia.

    Contextos largos, tarifa distinta. Por encima de 272.000 tokens de input, Sol y Luna cobran el doble en input y caché y 1,5× en output, y lo aplican a toda la petición. Es el mismo asterisco de los 272.000 tokens de GPT-6 Astra.

    El router no arregla un agente mal medido. Si no sabes cuánto cuesta cada tarea terminada y aceptada, no sabes si Luna te ahorra o te obliga a repetir trabajo. Artificial Analysis lo mide por tarea, no por token: Sol a $1.06 por tarea en su índice y Luna a $0.07. Esa es la unidad que importa.

    Lo que puedes hacer hoy

    Abre el log de tu agente y calcula una sola cifra: tokens cacheados entre tokens de input totales, en la última semana. Si baja del 80%, busca qué cambia al principio del prompt antes de pensar en cambiar de modelo. Casi siempre es una fecha, un ID o unas tools que se reordenan.

    Con esa cifra alta, manda las tareas mecánicas a Luna con validación. En ese orden.

    Este diseño, en el que el programa decide qué va a cada modelo y el modelo solo decide dentro de su tarea, es el que desarrollo en El Developer Agéntico, el ebook gratuito de Dominicode. Y si quieres montar el agente completo, de la idea al producto, está en el curso Construye con IA.

    Preguntas frecuentes

    ¿Cuánto cuestan GPT-6 Sol y GPT-6 Luna?

    GPT-6 Sol cuesta $2 por millón de tokens de input, $0.20 de input cacheado y $10 de output. GPT-6 Luna cuesta $0.10, $0.01 y $0.50. Los dos son la mitad o menos que GPT-5.6, y por encima de 272.000 tokens de input se aplica recargo.

    ¿GPT-6 Sol es más barato que Claude Opus 5.5?

    Por token, sí: la mitad en input y output. Pero los dos cobran $0.20 por millón en input cacheado, así que en un agente con mucha caché la diferencia baja. En el cálculo del post, de 2× sin caché a 1,71× con el 90% del input cacheado.

    ¿Puedo cambiar entre Sol y Luna en la misma conversación?

    Puedes, pero pierdes la caché. La guía de OpenAI indica que cambiar el modelo invalida el prefijo cacheado. Enruta por tarea, con un hilo por tarea, en lugar de alternar modelos dentro del mismo hilo.

    ¿Qué rompe la caché de prompts en GPT-6?

    Cualquier cambio en el prefijo: un timestamp o un dato de usuario al principio, tools que cambian de orden o de descripción, o un cambio de reasoning.effort o text.verbosity en la petición. Para cambiar el esfuerzo de razonamiento sin romperla, la guía propone añadir un elemento configuration_update al input.

    ¿Para qué tareas conviene GPT-6 Luna?

    Para trabajo acotado y en volumen: extracción, clasificación, resúmenes cortos. Valida su salida con un schema y escala a Sol lo que no pase. Evítalo en entregables largos con muchos requisitos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Zettelkasten para developers: ahora tus notas las lee un agente

    Zettelkasten para developers: ahora tus notas las lee un agente

    Hace unos meses le pedí a uno de mis agentes que redactara una sección concreta de una guía. Devolvió algo correcto, genérico y absolutamente vacío.

    Lo incómodo es que yo ya había escrito eso. Meses antes. Con el contexto, la decisión y el motivo por el que descarté la alternativa.

    El agente no lo encontró. Y cuando fui a buscarlo yo, tardé veinte minutos: estaba enterrado en la mitad de un markdown gigante sin título propio.

    Ahí entendí que mi problema con el Zettelkasten para developers no era de disciplina. Era de formato.

    La tesis de este post, después de un año largo escribiendo así: el método no ha cambiado nada. Lo que ha cambiado es quién lee las notas.

    En 2021 tomabas notas atómicas para tu yo futuro. En 2026 las tomas también para el agente que las va a recuperar, y ese lector es mucho menos indulgente que tú.

    Por si llegas sin contexto: el método Zettelkasten son las fichas que el sociólogo Niklas Luhmann usó durante décadas para escribir, con una caja de papel y ningún ordenador. Aplicado a programadores, el Zettelkasten para developers es esto: una idea por archivo, en markdown plano, con un título que afirma algo, autocontenida y enlazada a las demás. No es una carpeta de apuntes ordenada. Es un grafo consultable.

    Crédito: en esto me metió Tomas Vik, con su introducción al método y su retrospectiva un año largo después. Lo que viene es mi versión, con mis cicatrices.


    El conocimiento que solo entiendes tú ahora muere dos veces

    Durante años tomé notas como casi todos los programadores que conozco: capturas de pantalla, fragmentos copiados de la documentación, bullets sin verbo, enlaces con un "revisar esto" al lado.

    Eso no es una base de conocimiento, ni gestión del conocimiento personal (PKM). Es un vertedero ordenado alfabéticamente.

    El problema clásico ya era grave: un formato que solo entiendes tú, en el momento exacto en que lo escribiste, deja de entenderse a los tres meses.

    Lo nuevo es la segunda muerte. Si trabajas solo —yo opero Dominicode sin equipo— tus agentes son literalmente tu equipo, y ese equipo lee lo que dejaste escrito. Si lo que dejaste son bullets sin sujeto, tu equipo entero trabaja a ciegas.

    Una nota mal escrita ya no solo te penaliza a ti dentro de seis meses. Penaliza cada ejecución de cada agente que consulta ese repositorio, hoy.


    El Zettelkasten para developers ya no es productividad, es infraestructura

    La nota atómica pasó de consejo de productividad a requisito técnico el día en que dejó de leerte solo tú. Este es el giro que hace que esto merezca un post en 2026 y no en 2015.

    "Sé conciso" y "una idea por nota" eran consejos de higiene mental. Sonaban a gurú de productividad. Se podían ignorar sin consecuencias visibles.

    Hoy son requisitos técnicos de recuperación.

    Cuando indexas tu conocimiento para que un modelo lo consulte —lo que todo el mundo llama RAG— el texto se parte en fragmentos (chunking), esos fragmentos se convierten en embeddings y se recuperan por similitud semántica. Una nota de un solo tema, autocontenida y con un título que afirma algo es exactamente la unidad que ese índice recupera bien: cabe en muy pocos fragmentos y cada uno de esos fragmentos sigue significando algo por su cuenta.

    Una nota-cajón de sastre de cuatro mil palabras hace lo contrario. Se parte por la mitad de un razonamiento. El fragmento recuperado empieza con "por eso lo descartamos" y el sujeto de esa frase se quedó tres páginas más arriba. El modelo recibe un texto gramaticalmente correcto y semánticamente huérfano, y con eso improvisa. A eso lo llamamos alucinación, pero muchas veces es mala segmentación.

    Cómo se recuperan de verdad esos fragmentos —y por qué la búsqueda vectorial pura falla— lo desmonté en búsqueda híbrida y embeddings en producción.

    Nota-cajón Nota atómica
    Temas por archivo Varios Uno
    Título Una etiqueta: "Angular signals" Una afirmación: "Signals no sustituye a RxJS cuando necesitas cancelar una petición en vuelo"
    Al partirse en fragmentos El fragmento pierde el sujeto Cada fragmento sigue significando lo mismo
    Tú dentro de seis meses Hay que releer el archivo entero Decides si la abres sin abrirla
    Tu agente Recupera contexto huérfano e improvisa Recupera la unidad completa

    Mi ancla concreta: la base de conocimiento de Dominicode es un índice de búsqueda sobre markdown plano. Ahora mismo son 118 documentos y 455 fragmentos, repartidos en colecciones por ámbito —agents, _brand, _research, labs, videos, books, revenue— que los agentes consultan antes de escribir sobre cualquiera de esos ámbitos.

    Haz la división: sale por debajo de cuatro fragmentos por documento de media. No es un número mágico —los capítulos de libro tiran de esa media hacia arriba—, pero sí es el síntoma de la política editorial: documentos cortos y monotema. Cuando un archivo se dispara muy por encima de esa media, dentro hay dos o tres notas peleándose por el mismo sitio.

    La infraestructura de todo esto —el repo, la estructura, el gobierno vía CLAUDE.md— la conté en cómo montar un segundo cerebro con Claude Code. Este post va de la capa de encima: qué escribes dentro de cada archivo.


    El título es la nota

    Si me quedo con una sola regla de este año, es esta: el título tiene que afirmar algo, no nombrar un tema.

    No "Angular signals". Eso es una etiqueta.

    Sí "Signals no sustituye a RxJS cuando necesitas cancelar una petición en vuelo". Eso es una nota que puedes recuperar, contradecir o confirmar.

    Un título-afirmación hace tres cosas a la vez. Te obliga a tener una conclusión antes de escribir, en vez de acumular material. Le da al índice la señal más fuerte que va a recibir de ese documento. Y te permite decidir meses después si abres la nota sin abrirla.

    La segunda regla es más dura de lo que parece: la nota tiene que sobrevivir a ser leída sola. Sin la nota anterior. Sin la pestaña que tenías abierta ese día. Sin acordarte del proyecto.

    En la práctica eso significa desterrar los pronombres huérfanos. "Esto no funciona en producción" no es una nota. "El provideHttpClient con interceptores funcionales no captura errores lanzados dentro del resolver de una ruta" sí lo es.

    Así se ve el cambio en un archivo real:

    <!-- Antes: nota-cajón -->
    # Errores HTTP
    
    - esto no funciona en producción
    - revisar interceptores
    - preguntar a alguien
    
    <!-- Después: nota atómica -->
    # El interceptor funcional no captura errores lanzados dentro del resolver de una ruta
    
    `provideHttpClient(withInterceptors([...]))` solo ve lo que pasa por
    `HttpClient`. Si el resolver falla antes de lanzar la petición, el error
    sale por el router y el interceptor nunca se entera.
    
    Alternativa descartada: mover el try/catch a cada componente. Funciona,
    pero hay que repetirlo en cada ruta.
    

    El de abajo es más largo de escribir. Es el único de los dos que sigue sirviendo dentro de un año, y el único que un agente puede recuperar suelto.

    La autocontención es la misma propiedad que hace útil a un fragmento recuperado. Escribes para ti dentro de un año y, sin proponértelo, escribes para un recuperador vectorial. Es el mismo requisito con dos nombres.

    Es la lógica que aplicamos en el curso Construye con IA al montar la capa de contexto de un producto: el modelo no falla por falta de inteligencia, falla porque le llega texto sin sujeto.


    Los enlaces son el trabajo que no puedes delegar

    Enlazar es la única parte del Zettelkasten que no puedes automatizar, y es donde está todo el retorno. Aquí es donde mucha gente se baja.

    Enlazar una nota nueva con las que ya tienes te obliga a responder dos preguntas que no se contestan en piloto automático: ¿dónde encaja esto? y ¿contradice algo que ya escribí?

    La primera es de arquitectura. La segunda es la buena.

    Cuando una nota nueva choca de frente con una de hace ocho meses, ha pasado algo real: o aprendiste, o una de las dos estaba mal, o —lo más habitual— las dos son ciertas en contextos distintos y nunca habías delimitado cuál era cuál. Resolver ese choque suele producir una tercera nota, y esa tercera nota es la única de las tres que vale dinero.

    Ese momento no te lo da un agente. Un modelo te sugiere enlaces plausibles todo el día, y como sugerencia sirven. Lo que no tiene es la sensación de "un momento, esto no cuadra con lo que decidí en marzo". Esa fricción es el aprendizaje. Externalizarla es quedarte con el grafo y perder el motivo por el que existe.

    Lo que sale de ahí es un grafo, con las relaciones como dato de primera clase. Es la idea detrás de qué es graph engineering: la estructura entre las piezas transporta tanta información como las piezas.

    Con un efecto secundario que no esperaba: es el mejor antídoto contra el context drift que he encontrado. Cuando la conversación con el agente lleva dos horas derivando, las notas enlazadas son el punto fijo al que volver. No lo que el modelo cree recordar, sino lo que tú decidiste y escribiste.

    Y si viven en markdown, acaban siendo consultables como datos: notas huérfanas, enlaces rotos, temas que lo acaparan todo. Salud del grafo con una consulta, como conté en DuckDB + Obsidian.


    El coste honesto: esto es lento

    El coste real del método es el tiempo, y toca la parte que casi nadie escribe.

    Escribir así es lento. Mucho más lento que guardar el enlace y seguir. Leer para destilar una nota es más lento que leer, y bastante menos placentero. Dejé libros y documentación técnica a medias porque procesarlos a ese ritmo se volvió un trabajo, no una lectura.

    Y algo dejó de funcionar del todo: la ambición de capturarlo todo. Durante meses convertí en nota cosas que no lo merecían y el grafo se llenó de ruido que empeoraba la recuperación. Más notas no es mejor.

    Ahora tengo tres filtros. Si la respuesta a cualquiera de los tres es sí, no hay nota:

    • ¿Caduca en menos de dos semanas? Es un recordatorio, no conocimiento. Va a un issue, no al grafo.
    • ¿Existe upstream, es estable y está bien escrito? Enlázalo. Reescribir la documentación oficial de una librería es trabajo perdido que además envejece mal.
    • ¿Podrías reconstruirlo en cinco minutos buscando? No es tuyo todavía. Es información disponible, no conocimiento propio.

    Lo que sí merece nota casi siempre es lo mismo: la decisión, la alternativa que descartaste y el porqué. Eso no existe upstream, no está en la documentación de nadie, y es exactamente lo que te vuelven a preguntar dentro de un año.

    Es la misma forma de pensar que sostiene el libro de Spec-Driven Development: escribir la decisión antes que el código, porque la decisión es la parte cara.

    Y un último coste, más traicionero: optimizar el sistema en vez de usarlo. Reorganizar carpetas, cambiar de herramienta, diseñar la taxonomía perfecta. Todo eso se siente productivo y no produce nada.


    Qué cambiaría de mi Zettelkasten si empezara hoy de cero

    Cuatro cosas, y ninguna es instalar nada.

    1. Títulos-afirmación desde la primera nota. Renombrar cientos de archivos después es un trabajo horrible, y hasta que no lo haces la recuperación no mejora.
    2. Escribir pensando en el fragmento, no en el documento. Antes de guardar, pregúntate si un trozo suelto de esa nota, leído sin nada alrededor, sigue significando lo mismo. Si no, pártela.
    3. Colecciones por ámbito, no carpetas por tema. Los temas se solapan siempre y acabas con la misma nota en tres sitios. El ámbito casi nunca es ambiguo, y es lo que te permite filtrar la búsqueda.
    4. La nota de decisión antes que la nota de resumen. Los resúmenes de lo que leí envejecen. Las decisiones que tomé, con su alternativa descartada, siguen valiendo años después.

    Y una cosa que no cambiaría: no delegar los enlaces.


    Empieza por la siguiente nota

    No migres nada. No reorganices el vault. No elijas herramienta.

    Coge la última decisión técnica que tomaste esta semana —esa que discutiste contigo mismo durante veinte minutos— y escríbela como una sola nota, con un título que afirme algo y sin un solo pronombre sin sujeto. Después enlázala con lo más parecido que ya tengas escrito.

    Eso es todo. Repítelo cuando vuelva a pasar.

    Dentro de un año esa nota la vas a leer tú, medio dormido, buscando por qué hiciste lo que hiciste. Y la va a leer un agente que no tiene tu memoria, ni tu contexto, ni tu paciencia. Escríbela para el segundo: el primero sale beneficiado gratis.

    Si quieres el paso siguiente —cómo hacer que un agente use ese conocimiento sin inventarse la mitad— te lo dejé en el ebook gratuito Revisión por Contrato. Y si prefieres verlo montado sobre proyectos reales, con el repo y los agentes funcionando, está en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es exactamente el Zettelkasten para developers y en qué se diferencia de tomar apuntes?

    El Zettelkasten para developers es un sistema de notas atómicas en markdown: una idea por archivo, con un título que afirma algo, autocontenida y enlazada con las demás. La diferencia con tomar apuntes es el enlace. Los apuntes se acumulan en carpetas y se consultan por nombre de archivo; el Zettelkasten forma un grafo donde la relación entre dos notas transporta tanta información como las notas.

    En 2026 hay una segunda diferencia: una nota atómica es también la unidad que un índice vectorial recupera entera. Un apunte largo no.

    ¿Sigue teniendo sentido el Zettelkasten ahora que la IA me resume cualquier cosa?

    Tiene más sentido que antes, y por un motivo distinto al de siempre. La IA resume bien lo que está publicado; no puede resumir la decisión que tomaste tú, con la alternativa que descartaste y el motivo. Eso no existe en ningún corpus.

    Lo que sí cambió es el destinatario. Antes escribías notas atómicas para tu yo futuro. Ahora las escribes también para el agente que las va a recuperar, y ese lector no perdona un pronombre sin sujeto.

    ¿Necesito una herramienta de Zettelkasten o me vale markdown en un repo?

    Te vale markdown en un repo, y es lo que uso. La única condición innegociable es que los archivos sean texto plano y tuyos: eso te da git, búsqueda y la posibilidad de indexarlos para que los lea un agente.

    Las herramientas específicas —Obsidian, Logseq, Roam— aportan comodidad al enlazar y visualizar el grafo. Pero elegir herramienta antes de tener notas es la forma más elegante de no empezar nunca.

    ¿Cuántas notas hacen falta para que esto empiece a servir?

    Menos de las que imaginas para el uso individual, y bastantes más para el efecto de red, que es cuando el grafo te sugiere conexiones que no habías visto.

    No te fijes un número, fíjate una señal: el sistema funciona el día que buscas algo, lo encuentras, y esa nota te resuelve el problema sin abrir nada más.

    ¿No puede el agente resumir mis notas largas y ahorrarme el trabajo?

    Puede resumir. El problema es cuándo. En el momento de la recuperación el agente ya no ve la nota entera: ve los fragmentos que el índice le devolvió —salvo que montes recuperación por documento padre, que es trabajo aparte—, y si están mal cortados el resumen es una reconstrucción sobre material incompleto.

    Usar un modelo para partir notas viejas en notas atómicas sí es buena idea. Lo que no puedes delegar es decidir qué idea va en cada nota, porque esa decisión es el contenido.

    ¿Esto sirve para documentación de equipo o solo para notas personales?

    Sirve para ambas, pero no son lo mismo. La documentación de equipo describe cómo funciona el sistema hoy y se actualiza cuando el sistema cambia. Las notas atómicas capturan por qué se decidió algo y se acumulan sin borrarse.

    Si trabajas en solitario la frontera casi desaparece: tu grafo de decisiones acaba siendo el onboarding de tus propios agentes.

    ¿Qué hago con las notas largas que ya tengo escritas?

    Nada, hasta que las necesites. Migrar el archivo entero es el clásico proyecto que se abandona a la tercera tarde.

    Aplica la regla al vuelo: la próxima vez que abras una nota vieja y te cueste encontrar dentro lo que buscabas, ese es el momento de partirla en dos o tres notas con título propio. Migras solo lo que demuestra que se usa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
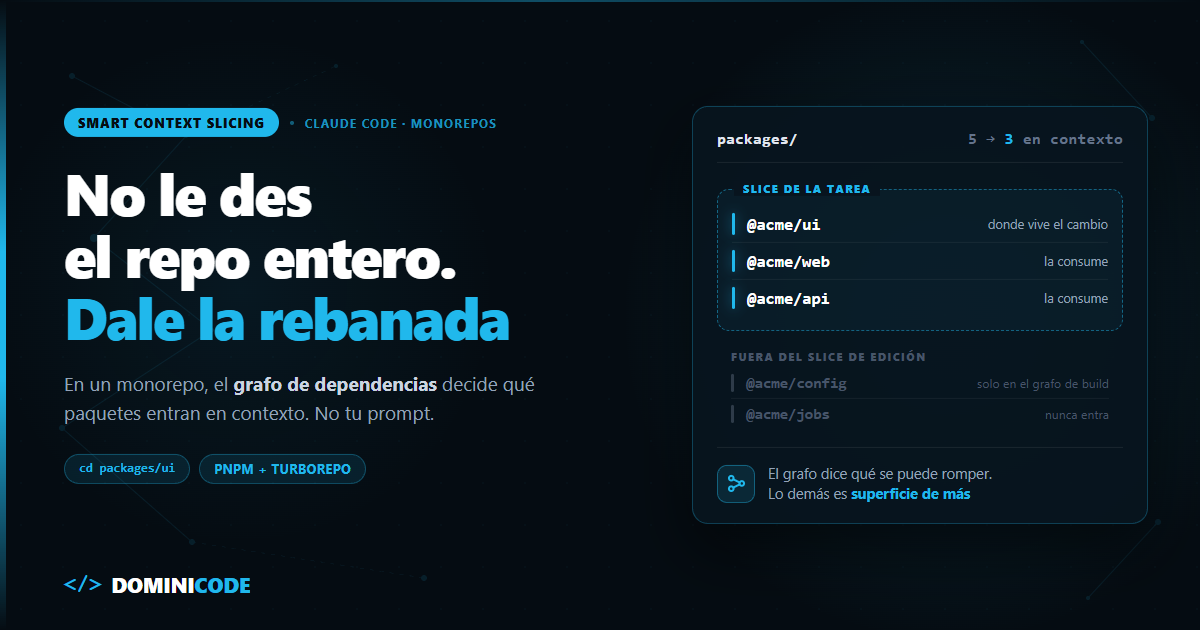
  • Claude Code en monorepos: dale solo la rebanada que necesita

    Claude Code en monorepos: dale solo la rebanada que necesita

    Un cliente me pasó su monorepo el mes pasado. Nueve paquetes, pnpm workspaces, Turborepo por encima. Le pedí a Claude Code algo ridículamente pequeño: cambiar el tipo de una prop en packages/ui.

    Tres respuestas después me estaba proponiendo tocar el cliente HTTP del backend.

    No era un modelo tonto. Era yo. Había arrancado la sesión desde la raíz del repo, y trabajar con Claude Code en monorepos desde la raíz significa una cosa muy concreta: le has dado nueve paquetes de superficie para una tarea que vive en uno.

    Esto no es el problema del que ya escribí en Context Drift. Aquel es temporal: la sesión se alarga, el historial se pudre, el agente se olvida de la instrucción de la iteración 3. Este es espacial. Se degrada en el minuto uno, con la ventana medio vacía, porque el repo es grande y nadie le ha dicho qué parte del repo importa.

    La tesis del post es esta: en un monorepo, la decisión más importante que tomas no es qué prompt escribes. Es desde qué directorio arrancas el agente.

    Smart context slicing es la práctica de arrancar el agente en el subárbol mínimo del monorepo que la tarea necesita, calculado a partir del grafo de dependencias en vez de a ojo. Son tres decisiones concretas: desde qué directorio lanzas claude, qué paquetes vecinos añades con --add-dir y qué rutas bloqueas con reglas de denegación. Las tres, en ese orden, son el resto del post.

    Claude Code en monorepos: un CLAUDE.md en la raíz no escala

    La documentación de Anthropic recomienda mantener cada CLAUDE.md por debajo de 200 líneas, y lo justifica: los archivos largos consumen más contexto y reducen la adherencia a las instrucciones.

    Ahora divide. Nueve paquetes, 200 líneas: 22 líneas por paquete para explicar su stack, sus convenciones y sus trampas.

    Así que solo hay dos finales, y he visto los dos.

    O el CLAUDE.md crece hasta las 600 líneas y el agente ignora la mitad — incluidas las reglas que importaban. O se queda genérico ("usa TypeScript estricto", "escribe tests"), que es una forma elegante de no decir nada.

    Si todavía estás montando el tuyo, el punto de partida lo dejé en CLAUDE.md: el system prompt de tu proyecto. Aquí doy por hecho que ya lo tienes y se te ha quedado pequeño.

    La solución es partirlo: raíz para lo global, un archivo por paquete para lo local.

    monorepo/
      CLAUDE.md                 # reglas globales: commits, estilo, "corre los scripts desde el paquete"
      packages/
        ui/CLAUDE.md            # convenciones de componentes, tokens de diseño
        api/CLAUDE.md           # Knex, migraciones, .env obligatorio
        web/CLAUDE.md           # rutas, data fetching
    

    Pero partirlo no sirve de nada si no entiendes cuándo se carga cada trozo.

    La regla de carga que casi nadie ha leído

    Claude Code no trata igual a los CLAUDE.md que están por encima de ti y a los que están por debajo.

    Dónde vive el CLAUDE.md Cuándo entra en contexto
    Tu directorio de trabajo y todos sus ancestros Al arrancar la sesión, siempre
    Subdirectorios por debajo de ti Bajo demanda, solo cuando el agente lee un archivo de esa carpeta

    Si arrancas desde la raíz, cargas solo el CLAUDE.md raíz — y vas acumulando el de cada paquete que el agente toque. Toca muchos, porque no sabe dónde está el límite.

    Si arrancas con cd packages/ui && claude, cargas raíz + packages/ui de golpe, y los de api y web no existen para esa sesión mientras no los pises. Además, solo puede leer y editar dentro de ese subárbol hasta que le concedas más.

    Eso es una rebanada. Y te ha costado un cd.

    Compruébalo: lanza /context y mira la lista de Memory files. Ahí está lo que se cargó de verdad.

    El slice no lo decides tú: lo decide el grafo de dependencias

    "Trabaja desde el paquete" está bien hasta que la tarea toca de verdad a los vecinos. Cambiar un tipo exportado de ui puede romper a quien lo consume, y si el agente no ve a esos consumidores, te entrega algo que compila en su rebanada y revienta en CI.

    La pregunta correcta no es qué paquetes te apetece abrir, sino qué paquetes toca esta tarea de verdad. Y esa respuesta ya está en tu repo: en el grafo de dependencias.

    Monté un workspace de cinco paquetes para verlo, con pnpm 11.1.3 y Turborepo 2.10.12. @acme/api y @acme/web dependen de @acme/ui; @acme/ui depende de @acme/config; @acme/jobs va por libre.

    Inventario primero:

    pnpm ls -r --depth -1
    

    Ahora el blast radius hacia arriba — qué se rompe si toco @acme/ui. En la sintaxis de filtros de pnpm, los tres puntos delante del nombre significan "y todo lo que depende de él":

    pnpm --filter "...@acme/ui" ls --depth -1
    # (salida recortada al nombre de cada paquete)
    # @acme/ui
    # @acme/api
    # @acme/web
    

    Y hacia abajo, con los puntos detrás, "y todo aquello de lo que depende":

    pnpm --filter "@acme/ui..." ls --depth -1
    # (salida recortada)
    # @acme/ui
    # @acme/config
    

    Si quieres el cierre completo en los dos sentidos, pones los puntos a ambos lados: "...@acme/ui...". Y si te sobra el propio paquete, el circunflejo lo excluye: "...^@acme/ui" devuelve solo api y web.

    Turborepo lo da con un matiz. --dry enseña el plan sin ejecutar nada:

    turbo run build --filter="...@acme/ui" --dry
    
    • Packages in scope: @acme/api, @acme/ui, @acme/web
    • Running build in 3 packages
    

    El detalle que solo ves ejecutándolo: "Packages in scope" son 3, pero si sacas el JSON aparecen 4 tareas:

    turbo run build --filter="...@acme/ui" --dry=json | jq -r '.tasks[].directory' | sort -u
    # packages/api
    # packages/config
    # packages/ui
    # packages/web
    

    @acme/config no está en el scope de edición, pero entra en el grafo de build porque ui lo necesita compilado. Son dos rebanadas distintas y conviene no confundirlas:

    Rebanada Paquetes % del repo
    Repo completo 5 100%
    Slice de edición (ui + dependientes) 3 60%
    Slice de build (añade config) 4 80%
    Nunca entra (@acme/jobs) 1 20%

    En un repo de cinco paquetes, dejar fuera un paquete suena a poco. En el del cliente, con nueve, el slice real de la tarea eran tres paquetes: dos tercios del repo que no tenían por qué abrirse nunca.

    Con esa lista en la mano, el arranque deja de ser una corazonada:

    cd packages/ui
    claude --add-dir ../api --add-dir ../web
    

    Si el equipo entero trabaja así, lo fijas en packages/ui/.claude/settings.json:

    {
      "permissions": {
        "additionalDirectories": ["../api", "../web"]
      }
    }
    

    Ojo con una diferencia que muerde: additionalDirectories da acceso a los ficheros pero no carga nunca el CLAUDE.md ni las skills de esos directorios. Con --add-dir sí cargan las skills, y el CLAUDE.md solo si arrancas con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1. Si escribiste un CLAUDE.md en packages/api y no sale en /context, es por esto.

    Y como el slice te dice qué se puede romper, también sabes qué verificar antes de dar la tarea por buena: los tests de api y web, no los de ui. Convertir "parece que funciona" en un veredicto ejecutable lo desarrollé entero en el ebook gratuito Revisión por Contrato, sobre cómo revisar lo que te entrega un agente sin leértelo línea a línea.

    Lo que no debe entrar en la ventana bajo ningún concepto

    Las búsquedas de contenido de Claude Code respetan tu .gitignore por defecto, así que node_modules/, dist/ y build/ ya están fuera de los resultados de un grep.

    El problema es lo que sí está commiteado: código generado, un SDK vendorizado, snapshots enormes. Para eso hay reglas de denegación:

    {
      "permissions": {
        "deny": [
          "Read(./**/dist/**)",
          "Read(./**/*.generated.*)",
          "Read(./vendor/**)"
        ]
      }
    }
    

    Un detalle que rompe esto sin avisar: los patrones relativos anclan en el directorio desde el que arrancas la sesión, no en la raíz del repo. Si guardas estas reglas en la raíz pero lanzas la sesión desde packages/ui, Read(./vendor/**) está apuntando a packages/ui/vendor/. Para que apliquen en todo el repo las escribes absolutas, con doble barra: Read(//ruta/absoluta/al/repo/vendor/**).

    Y si arrancando desde la raíz se te cuelan los CLAUDE.md de equipos con los que no trabajas, existe claudeMdExcludes, en el .claude/settings.local.json de la raíz. Los patrones se comparan contra rutas absolutas, así que empiezan por **/ para que casen en cualquier punto del árbol:

    {
      "claudeMdExcludes": ["**/packages/legacy-*/**"]
    }
    

    Con un aviso honesto: esa lista es estática, no un interruptor por tarea. Para alternar de paquete cada día la herramienta sigue siendo el cd.

    Cuando de verdad no sabes dónde está, delega la búsqueda

    Todo lo anterior asume que sabes qué paquete tocar. A veces no lo sabes, y ahí es donde la gente destroza la sesión: "busca en el repo dónde se genera el token de refresco". El agente lee doscientos archivos y te devuelve una frase. Los doscientos archivos se quedan en tu ventana. La frase también, pero ya da igual.

    Delégalo a un subagente. Corre en su propia ventana de contexto y te devuelve el resumen, no los archivos:

    Usa un subagente para localizar en qué paquetes se genera y se valida
    el token de refresco. Devuélveme solo la lista de rutas y una línea
    por cada una. No propongas cambios todavía.
    

    El resultado es una lista de paquetes. Cierras la sesión, haces cd al correcto y empiezas la tarea real con la ventana limpia. La exploración se paga una vez y se tira.

    Es el mismo principio que conté en Context Engineering: lo caro no es el token, es el token irrelevante que se queda mirándote el resto de la sesión.

    Lo que puedes hacer hoy en tu monorepo

    Una sola cosa, y es gratis: deja de arrancar el agente desde la raíz del monorepo.

    Antes de la próxima tarea, corre pnpm --filter "...<tu-paquete>" ls --depth -1, mira los tres o cuatro nombres que salen, y arranca así:

    cd packages/<tu-paquete>
    claude --add-dir ../<vecino>
    

    No hace falta que escribas ni un CLAUDE.md nuevo para notar la diferencia. Eso viene después, cuando ya sepas qué reglas son globales y cuáles de un paquete — y eso solo se ve claro tras unos días trabajando por rebanadas.

    Si quieres el flujo completo, de la idea al producto con estas decisiones tomadas antes de escribir código, es lo que montamos en el curso Construye con IA.

    Preguntas frecuentes

    ¿Es mejor arrancar Claude Code desde la raíz del monorepo o desde el paquete?

    Desde el paquete, salvo que la tarea cruce varios subsistemas de verdad. Arrancando desde packages/ui cargas el CLAUDE.md raíz más el de ui, y el agente solo puede leer y editar ese subárbol. Desde la raíz tienes acceso a todo: útil para refactors transversales, caro para cualquier otra cosa. Si necesitas un vecino puntual, --add-dir te lo añade sin romper el aislamiento.

    ¿Los CLAUDE.md de los subdirectorios se cargan siempre?

    No, y esta es la confusión más habitual. Los de tu directorio de trabajo y de todos sus ancestros se cargan al arrancar la sesión. Los de subdirectorios por debajo de ti se cargan bajo demanda, solo cuando el agente lee un archivo de esa carpeta. Para ver qué se cargó de verdad en una sesión, lanza /context.

    ¿Qué hago si la tarea toca varios paquetes a la vez?

    Dásela entera en una sola sesión, con el slice completo delante. Partirla en una sesión por paquete es peor: cada sesión redecide el diseño desde cero y acabas con tres criterios distintos. Calcula el slice con el filtro de dependientes, añade esos directorios y trabaja en plan mode antes de editar: el plan se escribe a un archivo que Claude Code reinyecta tras cada compactación.

    ¿Esto sirve si uso Nx o si mi repo es un solo árbol grande sin paquetes?

    Sí. En Nx el equivalente es nx graph para ver el grafo y nx show projects --affected para saber qué proyectos toca un cambio: cambia el comando, no la idea. Y en un repo de un solo árbol sustituyes "paquete" por "subsistema" — src/billing/, src/auth/, lib/core/. Un CLAUDE.md por subsistema y un cd hacen el mismo trabajo.

    ¿No basta con el .gitignore para que el agente no lea dist?

    Para las búsquedas de contenido sí: Claude Code respeta el .gitignore por defecto, así que dist/, build/ y node_modules/ no aparecen cuando busca texto. Lo que no cubre es lo commiteado — código generado, SDKs vendorizados, fixtures gigantes. Para eso necesitas reglas Read(...) en permissions.deny. Con un límite: cubren las herramientas de fichero y los comandos de Bash que Claude Code reconoce, pero un grep -r sobre una carpeta con ficheros denegados sigue sacándolos por pantalla.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • SQL agéntico local con Qwen3.8-27B y DuckDB: el 98,6 % es contexto

    SQL agéntico local con Qwen3.8-27B y DuckDB: el 98,6 % es contexto

    En una formación de empresa, en julio, un equipo me enseñó un problema que parecía de modelo.

    Su agente de datos —SQL agéntico local sobre DuckDB, un harness sencillo— fallaba una de cada tres preguntas. Habían probado tres modelos, cada uno más caro que el anterior. La precisión se movió tres puntos.

    Miré el prompt. El agente recibía el DESCRIBE de las tablas y nada más. Ni qué significa cada columna, ni el dialecto, ni las trampas del dominio.

    Ese es el punto ciego del debate sobre SQL agéntico local: discutimos qué modelo poner cuando el problema casi nunca está en el modelo.

    Aclaremos el término antes de seguir. SQL agéntico es dejar que un modelo de lenguaje, en vez de devolver una única consulta, itere en bucle: inspecciona el esquema, escribe SQL, lo ejecuta contra la base de datos, lee el resultado o el error y corrige hasta responder la pregunta de negocio. SQL agéntico local es hacer exactamente eso con un modelo abierto corriendo en tu máquina: sin coste por token y sin que los datos salgan del equipo.

    En su tabla de ventas, las devoluciones son filas con importe negativo que nadie borra. Ningún modelo, por caro que sea, adivina eso. Se lo tienes que decir.


    El titular viral del SQL agéntico local y lo que se salta

    MotherDuck publicó un artículo montando un agente SQL con Qwen3.8-27B corriendo en local sobre DuckDB. Lo pasaron por DABstep, un benchmark de análisis de datos cuyo test set completo tiene más de 400 preguntas de negocio reales.

    Según su benchmark, el modelo local en cuantización 4-bit sacó un 98,6 % de accuracy. Gratis, o menos de 0,50 $ si cuentas la electricidad. GPT 5.6 Luna Max gastó más de 8 $ en el mismo benchmark: 17 veces más caro según su cálculo, y con peor resultado.

    Los otros datos que reportan en la misma pasada, para situar:

    Modelo Precisión en DABstep Coste de la pasada Tiempo por pregunta
    Qwen3.8-27B local, 4-bit (MacBook Air M5) 98,6 % < 0,50 $ de electricidad 5-6 min
    Qwen3.8-27B local, 3-bit IQ3_XXS (M1 Pro, 16 GB) 96,4 % < 0,50 $ de electricidad 5-6 min
    GPT 5.6 Luna Max Por debajo del Qwen local > 8 $ ~40 s
    Gemini-3-Flash El más preciso del test 2,3× el precio de Luna Max ~25 s
    Sonnet 5 Significativamente menos preciso Más caro, sin cifra publicada —

    Dos puntos de precisión por la mitad de RAM.

    Fuente: benchmark de MotherDuck sobre DABstep. MotherDuck no publica el porcentaje exacto de los modelos en la nube, solo su posición relativa — por eso esas celdas van en cualitativo.

    El titular escribe solo: un modelo abierto en tu portátil empata a los frontier en SQL. Pero hay una frase enterrada en el artículo que cambia por completo la lectura.

    La capa de contexto que usó el agente la construyeron con un modelo frontier. Textualmente: "general documentation (including some SQL snippets) is fed into Claude Fable 5 and converted into MotherDuck Guides". Claude Fable 5 destiló la documentación; el modelo local solo consumió el resultado.

    Ahí está la historia real.


    El modelo frontier no desaparece del agente SQL: se mueve de sitio

    El modelo caro no se ha quedado sin trabajo. Ha cambiado de turno.

    Antes lo llamabas mil veces, una por pregunta, y pagabas mil veces. Ahora lo llamas una vez para destilar tus esquemas, tu documentación y tus reglas de negocio en un fichero de contexto, y luego infieres gratis en local todas las veces que quieras.

    Es un cambio de CAPEX por OPEX. Pagas una vez por construir el contexto y amortizas esa inversión en cada consulta posterior.

    Lo cual deja el corolario más útil del artículo, y es uno que el titular no da:

    Si tu agente de datos falla, no cambies de modelo. Arregla el contexto. Y si con contexto bueno ya funciona, entonces sí baja a un modelo local y deja de pagar por token.

    En ese orden. Al revés te sale caro y encima no funciona.

    El trabajo difícil migró del prompt al contexto. Quien no se entera sigue comprando inteligencia que no necesita.


    Qué contiene la capa de contexto de un agente SQL sobre DuckDB

    Una capa de contexto útil para un agente SQL tiene cuatro bloques: el esquema anotado columna a columna, las reglas de negocio que no están en el esquema, las reglas del dialecto SQL concreto y un puñado de queries doradas. Esta es la parte que no encontrarás en el original: qué escribes exactamente en ese fichero.

    No es el DESCRIBE. Eso ya lo consigue el modelo con una tool. Lo que no tiene es la semántica, el dialecto y los precedentes.

    Este es el esqueleto que uso para un agente SQL sobre nuestros datos de Dominicode —ventas de cursos y eventos de vídeo— en agent/context/ventas.md:

    # Contexto: analítica de ventas y vídeo (DuckDB)
    
    ## Datos disponibles
    
    Los ficheros son Parquet locales. Cárgalos siempre con read_parquet, nunca
    asumas que existe una tabla con ese nombre en el catálogo.
    
      read_parquet('data/ventas_cursos/*.parquet')
      read_parquet('data/eventos_video/*.parquet')
    
    ## ventas_cursos — una fila por transacción
    
    - id_venta      VARCHAR    Único. Las devoluciones NO comparten id con la venta.
    - fecha_utc     TIMESTAMP  Naive, siempre en UTC. El negocio reporta en Madrid.
    - curso_slug    VARCHAR    Clave de negocio del curso. Une por aquí, no por título.
    - plataforma    VARCHAR    'udemy' | 'kursar'. Kursar no tiene filas antes de 2026-03.
    - canal         VARCHAR    'organico' | 'referido' | 'udemy_business'.
    - precio_bruto  DOUBLE     0.0 cuando el cupón es del 100 %. No es un error.
    - neto_usd      DOUBLE     Ingreso YA repartido con la plataforma.
    - pais          VARCHAR    ISO-2. Puede ser NULL en Udemy Business.
    
    ## Reglas de negocio que no están en el esquema
    
    1. Las devoluciones son filas con neto_usd < 0. No se borran nunca.
       Para facturación real: SUM(neto_usd) sobre TODAS las filas.
       Nunca filtres con WHERE neto_usd > 0 salvo que pidan ventas brutas.
    2. No calcules el neto multiplicando el bruto por el reparto de la
       plataforma. Ese cálculo ya viene hecho en neto_usd y el porcentaje
       cambia por canal.
    3. "Mes de agosto" significa mes natural en Europe/Madrid, no en UTC.
    4. Una venta con precio_bruto = 0 sigue contando como unidad vendida.
    
    ## Dialecto DuckDB — reglas obligatorias
    
    - GROUP BY ALL y ORDER BY ALL existen. Úsalos en vez de repetir columnas.
    - SELECT * EXCLUDE (col) y SELECT * REPLACE (expr AS col) son válidos.
    - QUALIFY filtra sobre window functions sin subconsulta. Prefiérelo.
    - QUALIFY no se puede combinar con GROUP BY ALL: el binder lo rechaza.
      Con QUALIFY usa GROUP BY explícito. Y dentro de la window repite la
      agregación —ORDER BY SUM(x) DESC—, nunca el alias del SELECT: si el
      alias se llama igual que la columna, resuelve a la columna cruda y falla.
    - La división / devuelve DOUBLE. Para división entera usa //.
    - No existe TOP n. Usa LIMIT.
    - Zona horaria: la columna es naive UTC, así que la conversión correcta es
      fecha_utc AT TIME ZONE 'UTC' AT TIME ZONE 'Europe/Madrid'
      La conversión la aporta ICU, ya incluida en las builds oficiales: no hace
      falta INSTALL ni LOAD. Una sola llamada AT TIME ZONE da mal resultado.
    - Antes de una pregunta abierta, ejecuta SUMMARIZE sobre la tabla
      para ver rangos y nulos reales antes de escribir la query final.
    

    Y al final del mismo fichero, la sección que más cambia el resultado: las queries doradas. Pares de pregunta y SQL correcto, escritas por alguien que conoce los datos.

    -- P: "¿Cuánto facturamos neto en agosto de 2026?"
    SELECT ROUND(SUM(neto_usd), 2) AS neto_usd
    FROM read_parquet('data/ventas_cursos/*.parquet')
    WHERE date_trunc(
            'month',
            fecha_utc AT TIME ZONE 'UTC' AT TIME ZONE 'Europe/Madrid'
          ) = DATE '2026-08-01';
    
    -- P: "Top 3 cursos por ingreso neto en cada plataforma este año"
    -- Ojo: GROUP BY explícito (QUALIFY no admite GROUP BY ALL) y SUM(neto_usd)
    -- dentro de la window, no el alias.
    SELECT plataforma, curso_slug, SUM(neto_usd) AS neto_usd
    FROM read_parquet('data/ventas_cursos/*.parquet')
    WHERE fecha_utc AT TIME ZONE 'UTC' AT TIME ZONE 'Europe/Madrid'
          >= TIMESTAMP '2026-01-01'
    GROUP BY plataforma, curso_slug
    QUALIFY row_number() OVER (
              PARTITION BY plataforma ORDER BY SUM(neto_usd) DESC
            ) <= 3
    ORDER BY plataforma, neto_usd DESC;
    

    Ese fichero son cuatro pantallas y vale más que cambiar de modelo tres veces.

    Cada bloque mata un fallo distinto. El esquema anotado mata las columnas alucinadas. Las reglas de negocio matan las respuestas plausibles pero falsas, las más caras de todas.

    Y el dialecto mata dos cosas: el SQL de PostgreSQL que el modelo escribe por defecto, y trampas como la de QUALIFY que ningún modelo adivina porque solo las conoces si te han explotado en la cara. Es la misma idea que en preparar datos para agentes de IA con Python: el agente no necesita más inteligencia, necesita menos ambigüedad.

    Y antes de dejar que ese agente escriba algo que no sea un SELECT, monta el contrato de revisión. Escribí un ebook gratuito sobre eso, Revisión por Contrato: cómo revisar el código que genera un modelo sin leerlo línea a línea.


    El coste del SQL agéntico local no es el precio: es el tiempo

    El dato que decide más que el precio es la latencia.

    El agente local tarda 5-6 minutos por pregunta. Gemini-3-Flash tarda unos 25 segundos. GPT 5.6 Luna Max, unos 40.

    No es un 20 % más lento. Es un orden de magnitud. Y eso no se arregla con contexto.

    El rendimiento observado ronda los 5-7 tokens por segundo en un MacBook Air M5 y unos 5 en un MacBook Pro M1 Pro de 16 GB. Un agente que da cuatro o cinco pasos quema miles de tokens antes de devolver la primera fila.

    Eso convierte la decisión en algo binario:

    • Sí a local: batch nocturno, informes recurrentes, datos que no pueden salir de la máquina, exploración sin prisa, entornos sin conectividad.
    • No a local: dashboard interactivo, chat de datos para negocio, cualquier flujo donde alguien esté mirando un spinner.

    Y hay una restricción estructural que se cuenta poco: en local corres un prompt a la vez. En cloud lanzas 15 preguntas en paralelo sin pensarlo. Para una suite de evals nocturna eso es la diferencia entre veinte minutos y seis horas.

    Si estás decidiendo qué modelo abierto meter en tu máquina, ya comparé opciones en los mejores modelos de IA local en 2026, y de la familia Qwen hablé en el análisis de benchmarks de Qwen3.8 Max.


    La letra pequeña del "gratis": qué cuesta Qwen3.8-27B en local

    Correr Qwen3.8-27B en local no sale gratis: cuesta unos 6 $ por cada 1.000 preguntas amortizando el hardware, y pide 14-16 GB de VRAM en 4 bits. Cuatro matices antes de que pidas presupuesto para una GPU.

    No es gratis. Contando amortización del hardware, el coste real ronda 6 $ por cada 1.000 preguntas. La comparación honesta no es "gratis contra 8 $", sino esos 6 $ por mil preguntas contra lo que te cobre tu proveedor por esas mismas mil. En volumen alto sigue ganando el local por goleada, pero "gratis" es marketing.

    Puede que no te quepa. Son 27B de parámetros densos —sin MoE—, atención híbrida, encoder de visión, contexto nativo de 262.144 tokens y licencia Apache 2.0, según la ficha oficial del modelo. En 4-bit son ~18 GB de descarga y 14-16 GB de VRAM; FP8 sube a ~28 GB y BF16 a ~56 GB. Y MotherDuck estima que solo alrededor de un tercio de los portátiles pasa de 16 GB de RAM, así que la mayoría se queda en la cuantización de 3 bits.

    El acelerador puede frenarte. El multi-token predictor está pensado para ir más rápido, pero en hardware antiguo puede ralentizar. Mide antes de dejarlo activado.

    Un benchmark no es tu base de datos. DABstep tiene esquema limpio y preguntas bien formuladas. Tu warehouse tiene tres columnas llamadas status y una tabla que solo entiende alguien que se fue en 2023.

    Por eso el paso siguiente no es "probarlo", es medirlo con tus preguntas: evals deterministas sobre veinte consultas reales tuyas, comparando el resultado de la query y no el texto de la respuesta.


    Cómo montar un agente SQL local con Qwen3.8-27B y DuckDB en 7 pasos

    Tal como lo describe MotherDuck, con LM Studio —no Ollama:

    1. Instala DuckDB.
    2. Instala LM Studio.
    3. Descarga el modelo cuantizado: Qwen3.8-27B-MLX-4bit si tienes 32 GB; el IQ3_XXS de unsloth si tienes 16 GB.
    4. Opcionalmente añade el acelerador MTP, y mide si te ayuda.
    5. Levanta el endpoint compatible con OpenAI de LM Studio, con 16.384 tokens de contexto y el reasoning en low u off.
    6. Conecta tu harness de agente —OpenCode o el que uses— a ese endpoint.
    7. Apunta DuckDB a tus datos.

    Si el agente va a consultar mucho o desde varios procesos, monta bien la parte de acceso: lo cubrí en conexión eficiente a DuckDB.


    Lo que haría yo hoy con tu agente de datos

    Abre el prompt de tu agente de datos y cuenta cuántas líneas hablan de tu negocio. Si la respuesta es cero, no tienes un problema de modelo.

    Coge la tabla que más consultas, escribe el fichero de contexto de arriba para ella —esquema anotado, reglas de negocio, dialecto y tres queries doradas— y vuelve a lanzar las mismas preguntas con el mismo modelo que ya pagas. Esa es la medición que importa. Si con contexto sube, ya sabes que puedes bajar de modelo. Si no sube, cambiar de modelo tampoco te habría salvado.

    Y si quieres construir el agente completo, esta forma de trabajar —contexto primero, modelo después— es la que enseño en el curso Construye con IA: de la idea al producto con Claude Code. El harness, los contratos y las evals que hacen que un agente sea fiable, no impresionante en una demo.

    En Dominicode Labs tenemos las plantillas de contexto que usamos en producción, incluida esta de DuckDB.


    Preguntas frecuentes

    ¿Qué es el SQL agéntico y en qué se diferencia del text-to-SQL?

    El text-to-SQL clásico traduce una pregunta en lenguaje natural a una consulta y ahí termina: si falla o devuelve algo absurdo, el problema es tuyo. El SQL agéntico mete al modelo en un bucle con herramientas: inspecciona el esquema, escribe la consulta, la ejecuta, lee el error o el resultado y corrige hasta responder la pregunta de negocio. El SQL agéntico local es ese mismo bucle con un modelo abierto en tu máquina, sin coste por token y sin que los datos salgan del equipo.

    ¿Qwen3.8-27B es mejor que GPT 5.6 Luna Max para SQL?

    En el benchmark de MotherDuck sobre DABstep, sí: Qwen3.8-27B en cuantización de 4 bits alcanzó un 98,6 % de precisión y superó a GPT 5.6 Luna Max, que costó más de 8 $ en la misma pasada. Pero ese resultado se midió con una capa de contexto construida a mano para ese conjunto de datos, y tardando 5-6 minutos por pregunta frente a unos 40 segundos del modelo en la nube. Sin esa capa de contexto y con un humano esperando, la comparación se da la vuelta.

    ¿Qué hardware necesito para correr Qwen3.8-27B en local?

    En cuantización de 4 bits son ~18 GB de descarga y necesitas entre 14 y 16 GB de VRAM, así que en la práctica hablamos de una máquina con 32 GB de RAM unificada o una GPU dedicada equivalente. Con 16 GB puedes tirar de la cuantización de 3 bits IQ3_XXS de unsloth, que según el benchmark de MotherDuck baja la precisión de 98,6 % a 96,4 %. En FP8 el modelo pide ~28 GB y en BF16 ~56 GB, que ya es territorio de servidor.

    ¿De verdad sale gratis?

    No literalmente. La inferencia no tiene precio por token, y el coste de electricidad de la pasada completa del benchmark quedó por debajo de 0,50 $. Pero si amortizas el hardware, el coste real ronda los 6 $ por cada 1.000 preguntas. La comparación honesta no es "gratis contra 8 $", es "6 $ por mil preguntas contra lo que te cobre tu proveedor por esas mil". Sigue ganando el local por goleada en volumen alto.

    ¿Sirve esto para un chat de datos en producción?

    Para un dashboard interactivo, no. Cinco o seis minutos por pregunta con una sola petición en curso a la vez descarta cualquier caso donde haya un humano esperando. Donde sí encaja es en batch nocturno, informes recurrentes, entornos sin conectividad y datos sensibles que no pueden salir de la máquina. Ese último caso, por sí solo, ya justifica el montaje en más empresas de las que parece.

    ¿Puedo usar Ollama en lugar de LM Studio?

    El setup que describe MotherDuck usa LM Studio y su endpoint compatible con la API de OpenAI, configurado con 16.384 tokens de contexto y el reasoning en bajo o desactivado. Cualquier runtime que exponga un endpoint compatible te vale para conectar el harness, pero comprueba dos cosas antes de comparar resultados: que estás cargando exactamente la misma cuantización y que la ventana de contexto configurada es la misma. Cambiar cualquiera de las dos cambia los números.

    ¿Es seguro dejar que un agente ejecute SQL sobre mi base de datos?

    Solo si le pones los límites antes, no después. Lo mínimo: conexión de solo lectura, un usuario con permisos únicamente sobre las tablas que necesita, un LIMIT por defecto y un timeout de query. Con DuckDB sobre ficheros Parquet el riesgo baja mucho, porque el agente lee ficheros y no toca el warehouse de producción. Nunca le des credenciales de escritura a un agente para ahorrarte un paso.

    Tengo 200 tablas. ¿Escribo el contexto de todas?

    No. Empieza por las cinco que concentran el 80 % de las preguntas y documenta esas a fondo. La capa de contexto no se escribe entera de golpe: crece cada vez que el agente falla. Cuando una respuesta salga mal, no reescribas el prompt del sistema —añade la regla de negocio que faltaba y la query dorada correspondiente. Ese fichero acaba siendo el activo más valioso del sistema, y es el que sobrevive cuando cambies de modelo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • SDLC context engineering: arregla el ciclo, no el prompt

    SDLC context engineering: arregla el ciclo, no el prompt

    El mismo agente. El mismo modelo. Prácticamente el mismo prompt.

    En uno de mis repositorios la tarea salió a la primera. En el otro, el agente se inventó un helper que no existía y escribió los tests con una librería que ese proyecto abandonó hace más de un año.

    No falló el modelo. Falló todo lo que había alrededor del modelo.

    Y eso que hay alrededor tiene nombre: SDLC context engineering. Tu ciclo de desarrollo es la fábrica del contexto que consume el agente, y si la fábrica va mal, da igual cómo escribas el prompt.

    El primer repositorio tiene un CLAUDE.md con las convenciones escritas, una carpeta de decisiones de arquitectura y un índice del contenido previo que el agente puede consultar. El segundo tiene un README viejo y el resto vive en mi cabeza.

    Y ahí está el problema: cuando el contexto vive en tu cabeza, el agente tiene que adivinarlo. Adivinar, en un modelo de lenguaje, se llama alucinar.

    Por eso llevo meses insistiendo en lo mismo: el prompt no es la unidad de contexto. Puedes escribir el prompt más elaborado del mundo, con sus tres adjetivos y su frase en mayúsculas, que si la información que necesita el agente no existe en ningún sitio legible, no va a aparecer porque tú se lo pidas con más énfasis.

    El contexto no se escribe en el prompt. Se fabrica antes, en tu ciclo de desarrollo.

    Opero Dominicode solo: cursos, libros, una plataforma y un canal. No tengo un equipo que rellene los huecos por mí, así que los huecos los tengo que cerrar en el proceso. De ahí sale la idea que más ha cambiado mi forma de trabajar en el último año:

    Tu SDLC no es un proceso para humanos. Es la cadena de montaje que fabrica el contexto que consumen tus agentes.


    Qué es el SDLC context engineering

    El SDLC context engineering es tratar tu ciclo de vida del software como el sistema que fabrica el contexto que consumen tus agentes de IA.

    Cada una de las cinco fases —requisitos, diseño, implementación, code review y documentación— deja de producir artefactos para humanos y pasa a producir artefactos que una máquina puede leer, verificar y ejecutar: una spec con límites, un esquema de validación, una suite de tests como gate, un diff acotado y contexto versionado en el repositorio.

    La diferencia con el prompt engineering es de capa. El prompt engineering optimiza la instrucción de un turno. El SDLC context engineering optimiza la información que esa instrucción tiene disponible, y esa información la produce tu proceso, no tú en el momento de escribir.


    Qué cambia cuando el que lee el proceso es una máquina

    Cuando el que lee tu proceso es una máquina cambia el destinatario de cada artefacto: deja de valer lo que un humano completa con conocimiento implícito y solo cuenta lo que cabe en la ventana de contexto.

    El ciclo de vida clásico producía artefactos para personas: un ticket de tres líneas, la foto de una pizarra, un hilo de Slack, una reunión de refinamiento.

    Todo eso funciona con humanos por una razón que casi nunca decimos en voz alta: una persona rellena los huecos con conocimiento implícito. Sabe que en este proyecto los servicios van en esa carpeta. Sabe que ese campo del modelo está deprecado aunque siga ahí. Y, sobre todo, sabe a quién preguntar cuando algo no cuadra.

    Un agente no tiene a quién preguntar. Solo tiene lo que le entre por la ventana de contexto.

    Así que cada fase de tu ciclo tiene dos versiones posibles: la que produce algo para un humano y la que produce algo que una máquina puede leer, verificar y ejecutar.

    # Fase del ciclo Artefacto para humanos Artefacto para agentes
    1 Requisitos Ticket de 3 líneas spec.md con límites explícitos
    2 Diseño Diagrama en una pizarra Contratos ejecutables que validan
    3 Implementación "En mi máquina funciona" Tests como gate de salida
    4 Code review "A mí me parece bien" Diff acotado + auditor automático
    5 Documentación Wiki de hace tres años Contexto versionado en el repositorio

    La columna de la derecha es tu context engineering. No es un documento aparte que escribes el viernes por la tarde: es el residuo natural de un ciclo bien montado.

    Vamos fase por fase.


    1. Requisitos: del ticket de tres líneas al spec.md

    Qué falla: un ticket ambiguo no le da al agente lo único que de verdad necesita. Y no es la descripción de la funcionalidad: son los límites.

    Esta es la frase que más repito y la que más discusión genera: el alcance no es lo que el agente tiene que hacer, es lo que el agente no puede tocar.

    Un agente al que le pides "añade validación al formulario de registro" y no le dices nada más, se expande. Toca el modelo de datos porque le pareció que hacía falta. Refactoriza el componente de al lado porque estaba feo. Añade una dependencia. Y cuando abres el diff, tienes once archivos modificados y ninguna forma rápida de saber cuáles querías.

    Una spec no necesita ser larga. Una página con cuatro bloques:

    • Contratos de datos. La forma exacta de lo que entra y lo que sale.
    • Archivos afectados. Las rutas concretas que se pueden tocar.
    • Fuera de alcance. Lo que no se toca, escrito explícitamente.
    • Criterio de terminado. Qué comando tiene que pasar en verde.

    Con esos cuatro bloques, una spec entera te cabe en la pantalla:

    # Spec — Validación del formulario de registro
    
    ## Contratos
    - Entrada: { email: string, password: string, acceptedTerms: boolean }
    - Salida: { ok: true } | { ok: false, errors: FieldError[] }
    
    ## Archivos afectados
    - src/features/auth/register-form.tsx
    - src/features/auth/register.schema.ts
    
    ## Fuera de alcance
    - No tocar el modelo de usuario ni las migraciones
    - No añadir dependencias nuevas
    - No refactorizar componentes vecinos
    
    ## Terminado cuando
    - `bun test src/features/auth` pasa en verde
    - `tsc --noEmit` sin errores
    

    Ese tercer bloque es el que mejor retorno da de todo el documento, y es el que casi nunca veo escrito.

    Improvisar aquí no sale gratis, y el coste se puede calcular turno a turno: lo hice en la factura del vibe coding. Si tus specs ya existen pero el agente sigue desviándose, el problema suele estar en uno de estos 7 fallos. Y si quieres saber hasta dónde llevar el enfoque, están los tres niveles de Spec-Driven Development.

    La metodología completa, con las plantillas que uso a diario, está en el libro de Spec-Driven Development.


    2. Diseño: del diagrama en la pizarra a contratos ejecutables

    Qué falla: si la forma de tus datos vive dispersa por el código, el agente inventa propiedades. Y las inventa con una seguridad absoluta, porque estadísticamente user.email es un campo muy razonable aunque en tu proyecto se llame user.contactAddress.

    La solución no es documentar los tipos en un wiki. Es que la definición y la verificación sean el mismo artefacto.

    Un esquema de validación —Zod 4 en el ecosistema TypeScript, pero el principio vale para cualquier stack— hace tres cosas a la vez:

    • Describe la forma de los datos en un sitio único y localizable.
    • La comprueba en ejecución, así que si la descripción miente, algo se rompe y te enteras.
    • Genera el tipo con z.infer, así que la definición y la verificación salen del mismo artefacto y se actualizan a la vez.

    Esa segunda parte es la que lo convierte en contexto fiable. Un diagrama puede quedarse obsoleto en silencio durante dos años. Un esquema que se ejecuta, no: cuando un campo obligatorio cambia de tipo o desaparece, revienta y te enteras.

    Con un matiz que conviene saber, porque es donde la gente se confía: por defecto z.object() descarta las claves que no conoce en lugar de fallar. Si la API empieza a devolver campos nuevos, tu esquema los tira sin decir nada. Para que esa deriva también haga ruido necesitas z.strictObject(). El esquema te protege del campo que falta; del campo que sobra, solo si se lo pides.

    Y no confundas una cosa con la otra: los tipos de TypeScript desaparecen al compilar y no validan nada en ejecución. Evitan bugs antes de desplegar, que no es poco, pero el que comprueba lo que entra de verdad por la API es el esquema.

    Estos patrones —esquemas como contrato, inferencia de tipos y validación en los bordes— son los que desarrollo en el curso de Zod para TypeScript.

    La otra mitad del diseño es el acceso. En vez de pegar el esquema de tu base de datos dentro del prompt cada mañana, expones la fuente y dejas que el agente la consulte cuando la necesite. Eso es lo que resuelven los servidores de Model Context Protocol: el contexto deja de ser algo que copias y pasa a ser algo que se consulta.

    Eso sí, cada servidor que conectas mete sus definiciones de herramientas en la ventana. MCP cambia copiar por consultar, no elimina el coste de contexto: conecta los que uses, no los que tengas.


    3. Implementación: del "en mi máquina funciona" al gate de salida

    Qué falla: preguntarle al agente si ha terminado.

    Te va a decir que sí. No porque mienta, sino porque no tiene forma de saberlo: está evaluando su propio trabajo con exactamente el mismo contexto con el que lo escribió. Si le faltaba una pieza para escribirlo bien, le sigue faltando para revisarlo.

    Necesitas una señal que venga de fuera del modelo. Y la señal más barata que existe es un código de salida.

    El bucle que uso:

    1. El agente escribe primero el test que falla.
    2. Escribe el código mínimo para que pase.
    3. El pipeline ejecuta tipado, tests y lint. Si sale 0, la tarea entra en la cola de revisión. Si no, el agente recibe el error y corrige sin que yo intervenga.

    El gate no tiene que ser un pipeline entero. Un script que encadene los tres comandos ya sirve: si devuelve 0, la tarea pasa; si no, el agente recibe el error y sigue solo.

    {
      "scripts": {
        "gate": "tsc --noEmit && bun test && bun run lint"
      }
    }
    

    Lo importante no es que sea TDD de manual. Es que la condición de parada la decide un proceso externo y no una frase del agente. Mientras la puerta de calidad seas tú leyendo la terminal, no has automatizado nada: solo has cambiado de sitio el cuello de botella.

    El flujo completo de validar código generado antes de mergear lo desarrollé en TDD con IA. Y si lo que quieres es probar al propio agente en CI —no solo al código que produce— eso es un test harness, que es una pieza distinta.

    Y ojo con el nivel de la suite, porque aquí hay un efecto perverso: unos tests flojos no son neutros. Le dan al agente permiso para dar por terminado un trabajo a medias, con la ventaja de que ahora el sello de aprobado es automático.


    4. Code review: del "a mí me parece bien" al diff acotado

    Qué falla: el volumen. Un agente produce en veinte minutos más código del que puedes revisar con atención en una tarde.

    Y aquí hay una trampa que cuesta ver: la calidad de tu code review se decide en la fase 1, no en la fase 4. Un diff de once archivos es muy difícil de auditar bien, y la razón por la que toca once archivos es que la spec no dijo cuáles no tocar. Cuando el alcance está escrito, el diff sale acotado solo, y revisarlo pasa de ser una tarde a ser un rato.

    Con el diff ya acotado, la revisión se reparte en dos filtros:

    • El automático, primero. Tipado, tests, lint y un auditor que mire el diff antes que tú. Lo que no pasa esos gates no llega a tus ojos. Cómo montarlo en el pipeline lo detallé en revisiones de código con IA en CI/CD.
    • El tuyo, después, y solo para lo que la máquina no puede ver. Que la abstracción elegida sea la correcta. Que no haya duplicado algo que ya existía. Que el error se maneje donde tiene sentido y no donde resultaba cómodo.

    Esa segunda lista es más larga de lo que parece, y hay fallos del código generado por IA que un code review directamente no ve. Los tests cubren la corrección. Tú cubres el criterio.

    El checklist que uso para auditar diffs generados por IA antes de mergear está en el ebook gratuito Revisión por Contrato.


    5. Documentación: del wiki muerto al contexto versionado

    Qué falla: guardar la arquitectura en herramientas que el agente no puede abrir.

    El contexto tiene que vivir en el repositorio, al lado del código y bajo control de versiones, en cuatro capas de artefactos de contexto para agentes que hacen cosas distintas:

    • CLAUDE.md o AGENTS.md en la raíz. Convenciones, comandos de build, qué no se toca. AGENTS.md es un formato abierto supervisado por la Agentic AI Foundation, bajo la Linux Foundation, y lo usan ya más de 60.000 proyectos open source. Es lo primero que lee el agente al arrancar y lo que evita la mayoría de los "esto no va aquí".
    • docs/adr/ con decisiones de arquitectura. Markdown ligero que explica por qué se decidió algo, no solo qué se decidió. Sin el porqué, el agente deshace tus decisiones creyendo que mejora el código.
    • Un índice consultable del conocimiento previo. Para que pueda buscar en lo que ya existe sin que le metas el proyecto entero en la ventana.
    • Un mapa de dependencias del repositorio. Qué depende de qué. Es la diferencia entre un agente que cambia una función y otro que sabe qué se rompe al cambiarla, y va de graph engineering.

    Con una advertencia importante, porque es el error clásico de quien descubre esto: más contexto no es mejor contexto. Llenar la ventana de documentación irrelevante degrada las respuestas igual que no tener nada, solo que gastando más. Cómo estructurar esa memoria para que sume está en context engineering aplicado a agentes, y qué pasa cuando la conversación se alarga demasiado, en context drift.


    La regla del eslabón más débil de tu SDLC

    La regla del eslabón más débil dice que tu ciclo rinde lo que rinda su fase peor: da igual lo bien que hagas las otras cuatro, el resultado del agente lo marca la fase rota.

    Por eso esta es la parte práctica, la que decide por dónde empezar mañana:

    • Specs impecables sin gate de tests: el agente escribe muy rápido algo que nadie valida.
    • Tests excelentes con tickets ambiguos: validas a la perfección la funcionalidad equivocada.
    • Todo bien montado y el conocimiento en tu cabeza: cada mañana empiezas de cero.

    Así que no empieces por la fase que más te apetece, que suele ser la que ya haces bien. Empieza por la que te está costando dinero ahora mismo. Este diagnóstico lo resuelve en un minuto:

    Lo que te pasa con el agente Fase que tienes rota
    Se sale del alcance y toca archivos que no debía 1. Requisitos
    Inventa campos, funciones o rutas que no existen 2. Diseño
    Dice que ha terminado y no funciona 3. Implementación
    Los diffs son tan grandes que no los revisas 4. Code review
    Repite errores que ya corregiste la semana pasada 5. Documentación

    Ese último síntoma es el más frecuente y el que más gente confunde con un problema de memoria del modelo. No lo es. Es que la corrección se quedó en el chat en vez de acabar en un archivo del repositorio.


    Lo que no debes hacer

    Documentarlo todo.

    Es la reacción típica cuando alguien entiende esta idea: se pasa un fin de semana escribiendo un CLAUDE.md de cuarenta secciones y una carpeta de ADRs preciosa. Tres meses después, la mitad ya no es verdad.

    Y contexto desactualizado es peor que no tener contexto, porque el agente lo obedece. Un archivo que dice que los servicios van en una carpeta que ya no existe no es un documento inútil: es una instrucción activa para hacerlo mal.

    La regla que aplico: si no lo vas a mantener, no lo escribas. Es preferible un archivo de quince líneas verdaderas que uno de doscientas donde no sabes cuáles siguen siéndolo.

    Tampoco todo proyecto necesita este aparato montado. Hay casos concretos en los que el enfoque de spec te frena, y conviene reconocerlos antes de meter ceremonia donde no hace falta.


    Los 3 cambios para tu próximo ticket

    No hace falta rehacer la metodología de tu equipo. En la próxima tarea que delegues:

    1. Escribe el "fuera de alcance". Una línea diciendo qué archivos no debe tocar el agente. Es el cambio con mejor retorno de esta lista.
    2. Pon un gate automático. Aunque sea solo tsc --noEmit y los tests. Que la respuesta a "¿ha terminado?" la dé un código de salida y no una frase.
    3. Mueve una convención de tu cabeza al repositorio. Una. La que más veces has tenido que repetirle al agente esta semana.

    Con esos tres, el siguiente prompt que escribas tiene muchas más probabilidades de salir a la primera sin que le cambies ni una palabra. Porque no habrás mejorado el prompt: habrás mejorado la fábrica que lo alimenta. Eso es SDLC context engineering.

    El flujo completo, de la idea al producto con herramientas agénticas, lo enseño paso a paso en el curso Construye con IA con Claude Code.

    Y si quieres ver los artefactos reales —specs, gates y archivos de contexto de proyectos que están en producción— eso es lo que compartimos cada semana en Dominicode Labs.

    Deja de buscar el prompt mágico. Arregla la fase que tienes rota y el contexto se arregla solo.


    Preguntas frecuentes

    ¿Qué es exactamente el SDLC context engineering?

    Es tratar tu ciclo de vida del software como el sistema que fabrica el contexto de tus agentes de IA. En lugar de escribir prompts cada vez más largos, haces que cada fase del ciclo —requisitos, diseño, implementación, revisión y documentación— deje un artefacto que una máquina pueda leer y verificar: una spec con límites, un esquema de validación, una suite de tests, un diff acotado y contexto versionado en el repositorio.

    ¿Esto no es lo mismo que el prompt engineering?

    No, y la diferencia es de escala. El prompt engineering trabaja sobre la instrucción concreta que escribes en un turno. El context engineering trabaja sobre la información que esa instrucción tiene disponible, y esa información la produce tu proceso, no tú en el momento de escribir. Un buen prompt sobre un ciclo roto sigue dando resultados malos, solo que con mejor redacción.

    ¿Por dónde empiezo si tengo las cinco fases mal?

    Por el síntoma que estés sufriendo ahora, no por el orden numérico. Si el agente se sale del alcance, empieza por la spec. Si inventa campos que no existen, por los contratos de datos. Si dice que ha terminado y no funciona, por el gate de tests. La cadena rinde lo que rinda su fase peor, así que arreglar la que más te está costando da más retorno que mejorar la que ya funciona.

    ¿Hace falta usar Spec-Driven Development para esto?

    No es obligatorio, pero la fase de requisitos es la que más impacto tiene sobre las otras cuatro, y SDD es la forma más ordenada de resolverla. Puedes empezar con algo mucho más ligero: una línea de "fuera de alcance" en el ticket ya cambia el comportamiento del agente. Y hay casos concretos en los que el enfoque de spec te frena en vez de ayudarte, así que conviene reconocerlos antes de montar ceremonia.

    ¿Cuánto contexto es demasiado contexto?

    El que no puedas mantener actualizado. Un archivo de contexto que ya no refleja la realidad no es neutro: el agente lo obedece y hace las cosas mal con total seguridad. La medida correcta no es cuántas páginas tienes, sino cuántas líneas puedes garantizar que siguen siendo ciertas hoy. Además, llenar la ventana de contexto irrelevante degrada las respuestas y encarece cada turno.

    ¿Qué documentación para agentes de IA hace falta de verdad en un repositorio?

    Cuatro capas y nada más: un CLAUDE.md o AGENTS.md en la raíz con convenciones y comandos, una carpeta docs/adr/ con el porqué de las decisiones de arquitectura, un índice consultable del conocimiento previo y un mapa de dependencias del repositorio. Todo versionado junto al código. Lo que no esté en el repositorio, el agente no lo puede abrir.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.