Tag: Codex CLI

  • AGENTS.md en Claude Code: un archivo para todos tus agentes

    AGENTS.md en Claude Code: un archivo para todos tus agentes

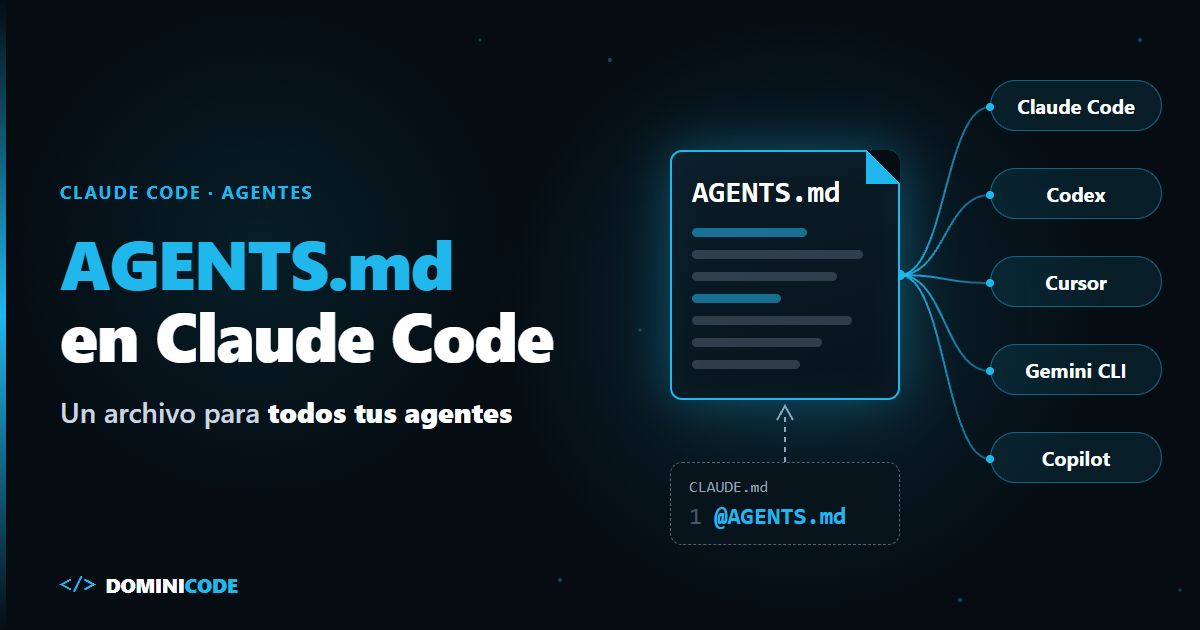
    El CLAUDE.md del repositorio con el que opero Dominicode tiene una sola línea. Ocupa once bytes:

    @AGENTS.md
    

    Hasta el 26 de septiembre ese archivo tenía 191 líneas. Las moví todas a AGENTS.md, que abre con esta frase: «Instrucciones para cualquier agente de código (Claude Code, Codex, Cursor, Gemini…)». Hoy ese apaño sobra en muchos casos, porque AGENTS.md en Claude Code ya tiene soporte nativo. En muchos, no en todos, y ahí está lo interesante.

    ¿Por qué lo hice? Porque ese repo mueve más de 30 agentes y no quiero que sus reglas dependan de qué herramienta abra la terminal. Mantener dos archivos que dicen casi lo mismo es el problema: cambias una convención en uno, se te olvida el otro, y cada agente trabaja con una versión distinta de la verdad.

    En corto: desde la v2.1.277, Claude Code lee AGENTS.md como instrucciones de proyecto cuando no hay ningún CLAUDE.md, .claude/CLAUDE.md ni CLAUDE.local.md en tu directorio de trabajo o por encima. Si existen los dos, por defecto manda CLAUDE.md, y lo cambias en /config → Project instructions. Mi recomendación: AGENTS.md para todo lo que sirve a cualquier agente y un CLAUDE.md solo si tienes algo que es de Claude y de nadie más.


    ¿Qué es AGENTS.md?

    AGENTS.md es un archivo Markdown en la raíz del repositorio con las instrucciones que un agente de código necesita para trabajar en él —comandos de build y test, convenciones, estructura— escrito en un formato abierto que leen herramientas de distintos fabricantes.

    La propia web de agents.md lo define como «un README para agentes». Lista más de veinte herramientas compatibles, entre ellas Codex, Jules, Cursor, Gemini CLI, Aider, Zed, Warp, Devin, Windsurf y el coding agent de GitHub Copilot. Hoy lo custodia la Agentic AI Foundation, bajo la Linux Foundation.

    Un año pidiéndolo en un issue

    Esto no llegó por sorpresa. El issue #6235 de anthropics/claude-code, «Feature Request: Support AGENTS.md», se abrió el 21 de agosto de 2025. Acumuló 409 comentarios y más de 5.000 pulgares arriba antes de cerrarse el 17 de agosto de 2026. La frase del autor resume el problema que yo tenía: CLAUDE.md «se siente demasiado específico de Claude Code» cuando colaboras con gente que usa otras herramientas.

    Y el lanzamiento tuvo su propia polémica. En la v2.1.277 el soporte venía como un plugin interno que, según el issue #95690, dependía de un flag remoto: con la telemetría desactivada, o en Bedrock o Vertex, AGENTS.md no se cargaba. Sin error. Sin aviso. El issue sigue abierto a día de hoy.

    Eso ya no es así. El changelog oficial de la v2.1.281 dice literalmente que el soporte pasa a funcionar también en Amazon Bedrock, Google Vertex AI, Microsoft Foundry, gateways LLM y sesiones sin telemetría. Si alguien te dice que en Bedrock no funciona, te está contando la primera versión. Actualiza y listo.

    La regla de precedencia de AGENTS.md en Claude Code

    Por defecto gana CLAUDE.md: Claude Code solo lee AGENTS.md si no hay ningún CLAUDE.md, .claude/CLAUDE.md ni CLAUDE.local.md en tu directorio de trabajo o por encima. La documentación de memoria de Claude Code lo resume en una tabla. Aquí va con la trampa que la doc esconde en una nota:

    Tu repo tiene Claude Code lee (por defecto)
    AGENTS.md y ningún CLAUDE.md ni CLAUDE.local.md en el directorio de trabajo o por encima AGENTS.md
    AGENTS.md + CLAUDE.md Solo CLAUDE.md
    AGENTS.md + un CLAUDE.local.md personal (aunque no haya CLAUDE.md) Solo CLAUDE.local.md. AGENTS.md deja de cargarse
    CLAUDE.md con @AGENTS.md dentro CLAUDE.md con AGENTS.md importado, una sola vez

    La tercera fila es la que te va a morder. Creas un CLAUDE.local.md para tus URLs de sandbox y Claude olvida de golpe todas las convenciones del equipo.

    Tu ~/.claude/CLAUDE.md, el gestionado por tu organización y .claude/rules/ no cuentan: se cargan junto a AGENTS.md.

    Si quieres cambiar el comportamiento, /config → Project instructions acepta cuatro valores: claude-md-or-agents-md (el defecto), claude-md-and-agents-md (los dos, primero CLAUDE.md), claude-md y managed-only. Se puede fijar en ~/.claude/settings.json, pero Claude Code lo ignora en los settings de proyecto: no se lo puedes imponer al equipo desde el repo (sí desde managed settings).

    Cómo migrar de CLAUDE.md a AGENTS.md según tu repo

    No hay una migración. Hay cinco, según de dónde partes.

    Escenario Qué hacer Riesgo si no lo haces
    Solo CLAUDE.md Renómbralo a AGENTS.md. Saca a un CLAUDE.md nuevo lo que sea exclusivo de Claude y empiézalo con @AGENTS.md Codex, Cursor y compañía siguen sin ver tus convenciones
    Solo AGENTS.md Nada. Comprueba con claude --version que tienes 2.1.281 o superior Con una versión vieja o sin el plugin agents-md activo, Claude trabaja sin instrucciones
    Los dos, con contenido distinto Fusiona en AGENTS.md. Deja en CLAUDE.md solo @AGENTS.md y lo específico de Claude Por defecto Claude ignora AGENTS.md entero y los dos archivos divergen
    CLAUDE.md que dice «lee AGENTS.md» en texto Cámbialo por el import @AGENTS.md o bórralo Claude solo lo lee si decide abrirlo. Es una sugerencia, no una carga
    Monorepo con archivos anidados Un AGENTS.md por paquete y ningún CLAUDE.md en la ruta (ni en la raíz ni en los paquetes). Si quieres el CLAUDE.md con @AGENTS.md en la raíz, pon Project instructions en claude-md-and-agents-md Con un CLAUDE.md en la raíz y el valor por defecto, Claude no carga ningún AGENTS.md de paquete: el import solo trae el de la raíz

    En el monorepo, si no hay ningún CLAUDE.md en tu ruta, Claude Code carga al arrancar todos los AGENTS.md desde tu directorio de trabajo hacia arriba. El de un subdirectorio se carga cuando Claude lee un archivo ahí dentro, y solo si ese subdirectorio no tiene su propio CLAUDE.md. Es lo mismo que ya hacía con CLAUDE.md anidados, que expliqué en cómo funciona la memoria de CLAUDE.md en un flujo real. Ojo: con el CLAUDE.md de una línea en la raíz, esto deja de pasar salvo que cambies Project instructions a claude-md-and-agents-md.

    ¿Import o symlink? Prefiero el import: en Windows, Git sin core.symlinks saca el enlace como un archivo de texto de una línea. El import funciona en todas partes.

    AGENTS.md vs CLAUDE.md: qué va en cada archivo

    AGENTS.md CLAUDE.md
    Quién lo lee Claude Code (v2.1.277+), Codex, Cursor, Gemini CLI, Copilot y más de veinte herramientas Solo Claude Code
    Imports con @ Claude los expande; el resto de agentes los lee como texto Se expanden, hasta cuatro saltos
    Hook InstructionsLoaded No se dispara si Claude lo lee a través del ajuste Se dispara
    --add-dir con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 No se carga Se carga
    Limitación / riesgo Un CLAUDE.md o CLAUDE.local.md en la ruta lo desactiva sin avisar Codex, Cursor y compañía no lo ven: tus convenciones existen para un solo agente

    Mi criterio es una pregunta: ¿esto le sirve a un agente que no es Claude?

    Si la respuesta es sí, va a AGENTS.md. Comandos, estructura, convenciones de nombres, reglas de idioma, cómo se hacen los commits, qué no se toca. Es lo que antes metía en un CLAUDE.md para proyectos, solo que ahora lo leen todos.

    Si la respuesta es no, se queda en CLAUDE.md, debajo del import. Algo así:

    @AGENTS.md
    
    ## Solo Claude Code
    
    - Skills del repo en `.claude/skills/`: usa `/dominicode-blog-post` para el pipeline del blog.
    - Los guardarraíles viven en hooks (`.claude/settings.json`), no en este archivo.
    - Usa plan mode para cualquier cambio en `tools/mailerlite/`.
    

    Las skills, los hooks, los subagentes de .claude/agents/, el plan mode y los imports con @ son de Claude. Codex no sabe qué hacer con @docs/git.md: lo lee como texto. Si llenas AGENTS.md de imports, los demás agentes ven referencias rotas.

    Plantilla mínima de AGENTS.md

    Esta es la que uso para empezar cualquier repo nuevo. Cópiala y rellénala, no la amplíes hasta que un agente se equivoque dos veces en lo mismo:

    # AGENTS.md
    
    Instrucciones para cualquier agente de código que trabaje en este repositorio.
    
    ## Comandos
    - Instalar: `bun install`
    - Tests: `bun test`
    - Lint y tipos: `bun run lint && bun run typecheck`
    - Antes de dar una tarea por terminada, los tres en verde.
    
    ## Estructura
    - `src/api/`: handlers HTTP. Nunca acceden a la base de datos directamente.
    - `src/domain/`: lógica de negocio pura, sin imports de framework.
    - `tests/`: espejo de `src/`.
    
    ## Convenciones
    - Identificadores en inglés, textos visibles en castellano.
    - Validación de entrada con Zod en el borde, nunca dentro del dominio.
    - Commits en formato Conventional Commits.
    
    ## Límites
    - No modifiques `migrations/` existentes: crea una nueva.
    - No añadas dependencias sin justificarlo en la descripción del PR.
    - Si una instrucción de este archivo choca con lo que te pide el usuario, pregunta.
    

    Cero sintaxis propietaria. La doc de Claude recomienda no pasar de 200 líneas por archivo; el mío roza las 200 y ya pide una poda.

    Escribir estas instrucciones como un contrato verificable, y no como una lista de deseos, es el tema del ebook gratuito sobre trabajar con agentes. El método completo, de la spec a las tareas que ejecuta el agente, está en el libro Spec-Driven Development.

    Cuándo NO migrar a AGENTS.md

    El soporte nativo no convierte AGENTS.md en un CLAUDE.md con otro nombre. Hay diferencias documentadas que importan.

    Si dependes del hook InstructionsLoaded. Cuando Claude lee AGENTS.md a través del ajuste, ese hook no se dispara. Si lo usas para auditar qué instrucciones se cargan, mantén el CLAUDE.md con @AGENTS.md: con el import, el hook funciona como siempre.

    Si trabajas con --add-dir. Con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 se cargan los CLAUDE.md de los directorios añadidos, pero sus AGENTS.md no. En setups multi-repo, eso es perder instrucciones sin enterarte.

    Si tu equipo tiene versiones de Claude Code desparejas. Por debajo de la 2.1.277 no hay soporte. En la primera sesión tras actualizar desde la 2.1.276 o anterior, a veces tampoco. Si no controlas las versiones, el CLAUDE.md con el import es un seguro que cuesta once bytes.

    Si esperas que los agentes interpreten igual el archivo. Claude no lee AGENTS.override.md, AGENTS.local.md ni nada bajo .agents/. Y el estándar dice que «el más cercano tiene prioridad», mientras que Claude carga todos los AGENTS.md de tu ruta al arrancar, no solo el más cercano. Un mismo AGENTS.md no garantiza el mismo comportamiento en cinco herramientas.

    Y lo que ninguna migración resuelve: AGENTS.md es contexto, no configuración. Si una regla no puede fallar nunca, no va en Markdown: va en un hook o en un test. Es la diferencia entre instrucciones y harness.

    Qué haría yo hoy

    Abre tu repo y ejecuta claude --version. Si estás en la 2.1.281 o superior, mueve el contenido de tu CLAUDE.md a AGENTS.md, deja en CLAUDE.md la línea @AGENTS.md y debajo solo lo que es de Claude. Luego abre una sesión nueva, lanza /context y comprueba que CLAUDE.md aparece en Memory files.

    No borré mi CLAUDE.md de una línea, ni pienso hacerlo (en un monorepo con AGENTS.md por paquete, además, pon claude-md-and-agents-md): me cuesta once bytes y me cubre las versiones viejas, las sesiones sin el plugin y el día que alguien cree un CLAUDE.local.md sin avisar.

    La decisión de fondo no es de formato. Es aceptar que tu repo lo van a tocar varios agentes y que las instrucciones son del repo, no de la herramienta. Si quieres ver ese flujo completo, de la spec al producto con Claude Code, está en el curso Construye con IA.

    Preguntas frecuentes

    ¿AGENTS.md sustituye a CLAUDE.md en Claude Code?

    No del todo. AGENTS.md en Claude Code funciona como instrucciones de proyecto solo cuando no existe ningún CLAUDE.md ni CLAUDE.local.md en la ruta. Lo que sirve a cualquier agente va en AGENTS.md; las skills, los hooks, el plan mode y los imports con @ siguen siendo cosa de CLAUDE.md, que puede importar AGENTS.md con una sola línea.

    ¿Desde qué versión lee Claude Code el archivo AGENTS.md?

    Desde la v2.1.277, según el changelog oficial. En esa versión no funcionaba en Bedrock, Vertex, Foundry, gateways LLM ni con la telemetría desactivada. La v2.1.281 lo extendió a todos esos casos, así que la versión mínima razonable hoy es la 2.1.281.

    ¿Qué pasa si tengo AGENTS.md y CLAUDE.md a la vez?

    Por defecto Claude Code lee solo CLAUDE.md e ignora AGENTS.md. Tienes dos salidas: añadir @AGENTS.md al principio de tu CLAUDE.md, o cambiar en /config el ajuste Project instructions a claude-md-and-agents-md. El import es la opción que funciona para todo el equipo sin que cada uno toque su configuración.

    ¿Tengo que borrar mi CLAUDE.md con @AGENTS.md ahora que hay soporte nativo?

    No. El import nunca hace que AGENTS.md se lea dos veces. Bórralo solo si no contiene nada más y todo tu equipo está en la 2.1.281 o superior. Lo que sí debes quitar es un hook SessionStart que imprima AGENTS.md, porque ahora duplicaría el contexto.

    ¿Cómo sé si Claude Code ha cargado mi AGENTS.md?

    Ejecuta /memory y busca la ruta del archivo en la lista. En sesiones interactivas también aparece una línea del tipo no CLAUDE.md found; AGENTS.md loaded al arrancar. Si no está, busca un CLAUDE.md o CLAUDE.local.md en tu directorio o por encima: es la causa más habitual.

    ¿Puedo usar imports con @ dentro de AGENTS.md?

    Claude Code los expande igual que en CLAUDE.md. Pero no te lo recomiendo: el resto de agentes no entiende esa sintaxis y leerá @docs/git.md como texto literal. Si necesitas imports, ponlos en CLAUDE.md, que solo lee Claude. Hay además una diferencia de seguridad: en un AGENTS.md leído directamente, los imports externos al proyecto se cargan sin pedir aprobación, mientras que en CLAUDE.md Claude Code te la pide.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Ya pagas Codex: sácale el triple con Oh My Pi (sin API key)

    Ya pagas Codex: sácale el triple con Oh My Pi (sin API key)

    Pagas veinte dólares al mes. O doscientos, si estás en Pro.

    Ese plan incluye Codex. Y llevas meses usándolo dentro de Codex CLI, que decide por ti casi todo: le enchufas MCPs, sí, pero no cambias el harness que hay debajo — ni el LSP que no trae, ni el debugger que no pilota, ni el revisor que no existe.

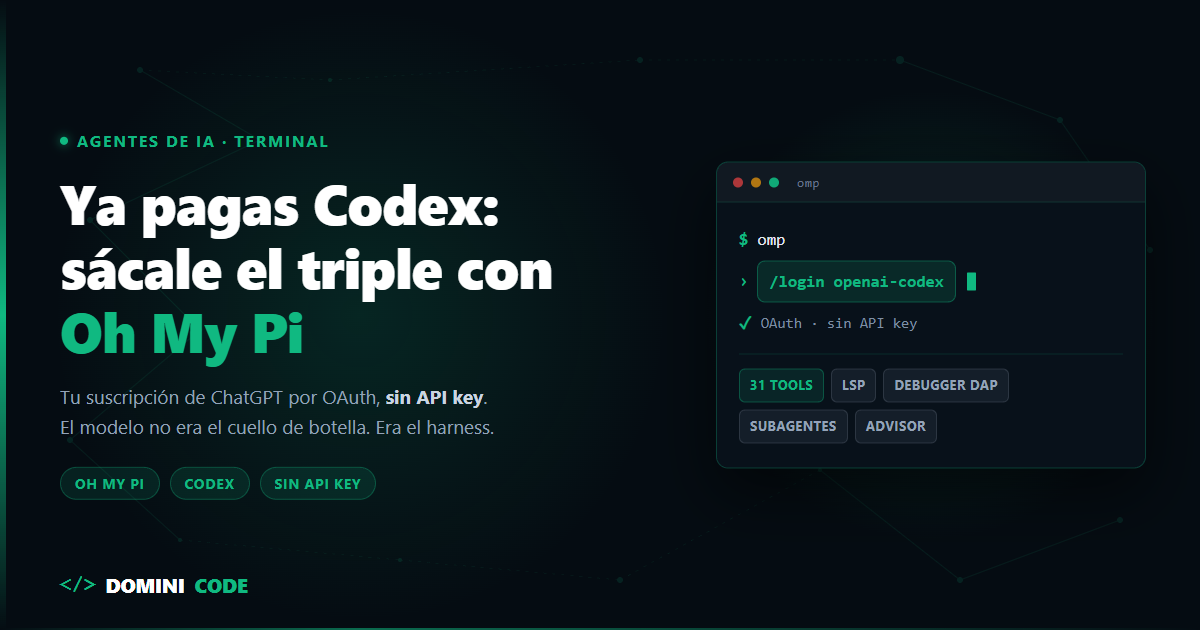
    La jugada se llama Oh My Pi — omp en la terminal — y con Codex es esto: omp habla el protocolo de Codex por OAuth. Te logueas con tu suscripción de ChatGPT, sin API key, sin pagar dos veces. El mismo modelo que ya pagas, dentro de un harness con 31 herramientas, LSP, debugger, subagentes y un revisor leyéndote en paralelo.

    El día que lo monté entendí algo incómodo: el modelo nunca fue el cuello de botella. Lo era la caja donde lo metía.


    ¿Qué es Oh My Pi (omp)?

    Oh My Pi (omp) es un agente de código para terminal, con licencia MIT y un core de unas 80.000 líneas de Rust bajo una superficie TypeScript, que integra LSP, debugger DAP, subagentes y más de 60 providers de modelo dentro del mismo harness. Es un fork de Pi, el agente minimalista de Mario Zechner, y soporta Codex por OAuth contra tu suscripción de ChatGPT, sin API key.

    Eso es lo que es. El proyecto se describe a sí mismo como "a coding agent with the IDE wired in", y ahí está toda su tesis: donde Pi apuesta por un core diminuto, omp hace lo contrario y mete dentro todo lo que normalmente pondrías fuera.

    Cifras de cabecera de su README a 24 de agosto de 2026, literales: 60+ providers · 31 built-in tools · 14 lsp ops · 28 dap ops. El proyecto no publica releases versionadas —se instala desde main—, así que esto es una foto de hoy, no un contrato: comprueba el README antes de citarlas.

    Si nunca has desmontado un agente por dentro, la anatomía está en qué es un agent harness. Y si vienes de exprimir Codex CLI, esto es la continuación natural de cómo integrar Codex CLI de forma efectiva.


    Cómo usar Codex en Oh My Pi sin API key: /login openai-codex

    Codex entra en omp por OAuth, no por API key: el provider se llama openai-codex y se activa con /login openai-codex dentro de la sesión. Primero, la instalación.

    curl -fsSL https://omp.sh/install | sh
    omp setup
    

    También hay Homebrew (brew install can1357/tap/omp), Bun, Nix, mise y PowerShell.

    Lo que de verdad importa viene después, ya en la sesión —esto no es un comando de shell, es un slash command dentro de la TUI:

    /login openai-codex
    

    Eso abre el flujo OAuth de tu cuenta de ChatGPT. El provider de modelo se llama openai-codex y su auth es oauth: no hay API key en ninguna parte. /login a secas abre el selector, /login <redirect-url> sirve para pegar el callback si el navegador no te devuelve solo, y /logout borra las credenciales.

    Las credenciales viven en el auth store, ~/.omp/agent/agent.db; PI_CODING_AGENT_DIR reubica ~/.omp/agent entero y el store viaja con él. Para headless o remoto está el auth broker: omp auth-broker login <provider>, con sus logout, status y list.

    Los logins son provider-scoped: autenticar anthropic no autentica openai. Y cada organización o workspace cuenta como una cuenta propia: si tienes asiento Team o Enterprise y además plan personal con el mismo email, puedes loguearte una vez por suscripción — el workspace se elige en la pantalla de consentimiento del navegador — y la rotación las trata como dos cuentas distintas.

    Dónde se rompe: el orden de resolución de credenciales

    Gana la primera capa que encaja. Son siete:

    1. Runtime override (--api-key). Nunca se persiste.
    2. La apiKey de config en models.yml.
    3. Credencial OAuth almacenada, refrescada cuando hace falta y con rotación entre cuentas.
    4. API key almacenada por un /login exitoso.
    5. Variable de entorno del provider, incluidos valores de ficheros .env.
    6. Otra API key almacenada, como último recurso.
    7. El resolver de fallback de models.yml.

    Fíjate en el paso 2: una apiKey en models.yml gana a tu OAuth almacenado, y es deliberado — para que la key de un baseUrl o gateway propio se respete en vez de reenviar upstream un token OAuth que el proxy rechazaría. Si un día tu login de Codex "deja de usarse", mira ahí antes de loguearte veinte veces. La variable de entorno del provider es OPENAI_CODEX_OAUTH_TOKEN.


    Los diez roles de modelo: enruta por intención, no por "el mejor modelo"

    omp no tiene "un modelo": tiene diez roles de modelo, y a cada uno le asignas un provider/model-id distinto. Esta es la parte que justifica el post entero.

    Casi todo el mundo pregunta cuál es el mejor modelo. Es la pregunta equivocada. La buena es qué modelo para qué turno.

    Rol Para qué
    default Los turnos normales
    smol Fan-out barato de subagentes
    slow Razonamiento profundo
    plan Modo plan
    commit Changelogs
    advisor El revisor que lee cada turno en paralelo
    vision Turnos con imagen de entrada
    designer Trabajo de interfaz
    task Los subagentes que lanza el tool task
    tiny Utilidades de coste ínfimo

    Un modelo se selecciona como provider/model-id. Los docs de omp lo ilustran con anthropic/claude-opus-4-6; en nuestro caso será openai-codex/<modelo>.

    --smol, --slow y --plan fuerzan el rol al lanzar, Ctrl+P cicla entre los modelos del rol activo y /model cambia el modelo a mitad de sesión. /model es además donde ves qué modelos expone tu plan de Codex: eso depende de tu suscripción y no te lo voy a inventar aquí.

    Para saltarte el picker se preconfigura en ~/.omp/agent/config.yml. El ejemplo literal del README usa un provider custom llamado spark:

    modelRoles:
      default: spark/minimax-m3
    

    Así lo repartiría yo con Codex de por medio:

    modelRoles:
      # Abre /model, mira qué expone tu plan y sustituye los placeholders
      default: openai-codex/<modelo-de-tu-plan>
      slow:    openai-codex/<modelo-de-tu-plan>
      smol:    <provider-barato>/<modelo-pequeno>
      advisor: anthropic/claude-opus-4-6   # otra familia, a propósito
    

    Tres decisiones detrás.

    Codex en default y slow. Es lo que ya pagas, y es lo que quieres para el trabajo real y el razonamiento largo.

    Algo barato en smol. El fan-out de subagentes es donde se va el presupuesto sin que te des cuenta: lanzas varios workers y cada uno consume su contexto entero. Poner tu modelo caro ahí es la forma más rápida de tocar el techo del plan.

    Un revisor distinto en advisor. Si el revisor corre con el mismo modelo que ejecuta, comparte sus puntos ciegos. Por eso el ejemplo del README, que pone openai-codex/gpt-5.5 en advisor, no es lo que yo copiaría: si default ya es Codex, el revisor tiene que salir de otra familia o estás pagando por que alguien te dé la razón.

    Decidir qué inteligencia va en cada paso, en vez de tirar del modelo más caro para todo, es el criterio que trabajo en el curso Construye con IA. Cambia la herramienta, no cambia el razonamiento.


    Qué pasa cuando el plan de Codex se queda sin cuota: fallback chains

    Cuando tu plan de Codex agota cuota a mitad de turno, omp no aborta el turno: salta al siguiente modelo de la cadena declarada en retry.fallbackChains y se queda con él hasta que el turno termina.

    Tu suscripción tiene límites, y normalmente te enteras a mitad de un trabajo largo, con un 429 en la cara. omp tiene cuatro knobs de routing y este es el que más se nota.

    Fallback chains. Cadenas por rol o por modelo bajo retry.fallbackChains. Cuando el primario devuelve 429s o choca contra el muro de cuota, la siguiente entrada se queda el resto del turno y se restaura al pasar el cooldown. Tu límite deja de ser un turno muerto y pasa a ser un degradado suave.

    Los otros tres los dejo enunciados, porque tocan menos a Codex y están bien documentados. Custom providers: en ~/.omp/agent/models.yml declaras cualquier backend que hable openai-completions, openai-responses, openai-codex-responses, azure-openai-responses, anthropic-messages, bedrock-converse-stream, google-generative-ai, google-gemini-cli o google-vertex, y omp models <provider> te verifica el discovery antes de descubrirlo en caliente. Path-scoped models: acotas enabledModels y disabledProviders a un prefijo path: y fijas otro set de modelos en un repo concreto sin tocar la config global. Round-robin credentials: apilas varias API keys por provider y el runtime rota con afinidad de sesión y backoff por credencial, útil cuando una sola key te quemaría la cuota antes de comer.

    La config global vive en ~/.omp/agent/config.yml y la de proyecto en .omp/config.yml. Jerarquía, de más fuerte a más débil: runtime overrides → overlays de --config <file> → proyecto → global → defaults del SETTINGS_SCHEMA. Se toca con omp config set, nunca a mano con el agente corriendo. Y hay perfiles: omp --profile <name>.


    No migres nada: ya tienes la config en disco

    omp lee los ocho formatos que ya tienes en su forma nativa — Cursor MDC, Cline .clinerules, Codex AGENTS.md, Copilot applyTo y el resto — sin script de migración. En el primer arranque hereda reglas, skills y servidores MCP de .claude, .cursor, .windsurf, .gemini, .codex, .cline, .github/copilot y .vscode.

    La precedencia a nivel de usuario es ~/.omp/agent/ > ~/.claude/ > ~/.codex/ > ~/.gemini/. A nivel de proyecto, .omp/ > .claude/ > .codex/ > .gemini/. Y proyecto gana a usuario.

    Ahora el matiz que te va a morder, porque es específico de Codex: el provider codex (prioridad 70) solo carga a nivel de usuario, ~/.codex/AGENTS.md. El contexto de proyecto entra por un AGENTS.md suelto vía el provider agents-md, que sube desde el directorio actual hasta la raíz del repo. No desde <cwd>/.codex/AGENTS.md. Si tienes un .codex/AGENTS.md en el repo esperando que se cargue, no se carga.

    Los otros dos: native (prioridad 100) lee ~/.omp/agent/AGENTS.md y el .omp/AGENTS.md del .omp/ no vacío más cercano subiendo desde cwd — si ese no tiene AGENTS.md, deja de subir. Y claude (prioridad 80) lee ~/.claude/CLAUDE.md y <cwd>/.claude/CLAUDE.md, sin walk-up.

    RULES.md no es lo mismo que AGENTS.md

    Un RULES.md nativo top-level se convierte en regla always-apply: se re-adjunta cerca del turno actual, así que mantiene su fuerza aunque la conversación crezca. Un context file normal se inyecta al abrir sesión y se va diluyendo.

    Regla de uso: AGENTS.md para el fondo duradero — arquitectura, convenciones, dominio. RULES.md para los requisitos cortos y duros que no pueden diluirse.

    Es la respuesta operativa a lo que conté en context drift y memoria en agentes de IA: las instrucciones no se olvidan, se entierran.


    Oh My Pi vs Codex CLI: lo que Codex CLI no te da

    LSP y debugger de verdad. El tool lsp cubre diagnostics, navegación, símbolos, renames, code actions y raw requests. El tool debug pilota una sesión DAP: breakpoints, stepping, threads, stack, variables. El agente deja de leer tu código como texto y lo lee como lo lee tu IDE — y puede pararlo en un breakpoint para ver cuánto vale la variable en vez de suponerlo. Hay además security_scan, que ejecuta revisiones nativas y dispara scans cloud de Codex Security.

    El advisor. Emparejas un modelo a ese rol y lee cada turno del agente principal, inyectando notas inline: un aviso, una preocupación o un bloqueante duro. Corre en su propio contexto y con su propio modelo, así que pilla lo que el que ejecuta se saltó por prisa. El principal corrige o explica por qué no. Revisión continua, no revisión al final.

    El Agent Hub. Alt+A abre un roster con actividad y consumo por subagente. Entras en uno, lees su transcript en vivo, le mandas un mensaje de dirección, revives un worker aparcado o matas uno atascado sin abortar la sesión padre. Los subagentes son de primera clase vía el tool task, con fan-out en paralelo, resultados validados por schema y aislamiento opcional por workspace; encima hay skills como orchestrate y workflowz.

    /review. Lanza subagentes revisores dedicados que barren ramas, commits sueltos o trabajo sin commitear en paralelo, y dan veredicto con issues rankeados de P0 a P3 y puntuados por confianza. Si prefieres quedarte en Codex CLI y exprimirlo desde dentro, el trabajo de harness sobre el propio Codex lo desgloso en harness engineering con Codex de OpenAI.

    Memoria explícita. retain, learn, recall, reflect y memory_edit sostienen el banco de memoria; checkpoint y rewind son puntos de guardado.

    Y el detalle que más me gustó. Dieciséis esquemas URI internos — pr://, issue://, agent://, skill://, ssh:// y el resto — resuelven de forma transparente dentro de cada tool con forma de FS que el agente ya llama. read pr://1428 devuelve la misma forma que read src/foo.ts. grep recorre un diff como si fuera un directorio. No hay herramientas nuevas que aprender: hay rutas nuevas.


    Cuándo NO usar Oh My Pi con Codex

    Es un fork joven de un proyecto de terceros. No es una herramienta de OpenAI ni tiene su soporte detrás.

    La superficie es enorme. 31 herramientas, 60+ providers, diez roles de modelo, cuatro knobs de routing y ocho providers de contexto. Eso es potencia, y es también su propia curva de aprendizaje: vas a pasar una tarde configurando antes de que te rinda. Si esto te viene grande hoy, no pasa nada: empieza por la guía para empezar con agentes de IA y subir de nivel y vuelve cuando el trabajo te dure horas.

    Si haces edits pequeños, Codex CLI tal cual te sobra. El valor aparece cuando el trabajo dura horas, toca muchos archivos y quieres subagentes y un revisor encima. Si no tienes claro qué harness necesitas, la comparativa está en harnesses agénticos comparados.

    Es tu cuenta la que entra por OAuth. Estás autorizando a un cliente de terceros contra tu suscripción de ChatGPT. Antes de meterlo en el trabajo diario revisa qué permite tu plan —sobre todo si el asiento es de empresa—, porque del acceso respondes tú, no el proyecto.

    Y algo que aplica a cualquier agente de código en terminal, este incluido: corre con tus permisos. No es una herramienta que instalas y olvidas en una máquina llena de credenciales.


    Qué hacer hoy

    Instala, ejecuta omp setup, entra y escribe /login openai-codex. Cinco minutos, y ya estás usando el modelo que ya pagabas, sin API key, en otro sitio.

    Luego haz una sola cosa más: abre /model, mira qué te expone tu plan y escribe tus modelRoles. Codex en default y slow, algo barato en smol, un revisor distinto en advisor. Ese bloque de YAML es lo que convierte omp en algo distinto de "otro agente CLI".

    Dónde encaja omp respecto al resto de piezas que uso a diario lo tienes en mi stack de IA agéntica en 2026.

    Nada de esto sustituye a saber qué le pides. Un harness con 31 herramientas y un encargo vago te da caos más rápido: escribir la especificación antes de soltar al agente sigue siendo cosa tuya, y es lo que desarrollo entero en el libro de Spec-Driven Development. Y si quieres ver estas configuraciones montarse en directo y discutirlas con gente que está en lo mismo, eso lo hacemos cada semana en Dominicode Labs.

    Deja de preguntarte cuál es el mejor modelo. Ya pagas uno bueno. La pregunta es en qué caja lo estás metiendo.


    Preguntas frecuentes

    ¿Oh My Pi funciona con Codex?

    Sí. Oh My Pi trae un provider de modelo llamado openai-codex cuya autenticación es OAuth: entras con /login openai-codex, autorizas en el navegador con tu cuenta de ChatGPT y usas el modelo de tu plan dentro del harness de omp, con sus 31 herramientas, LSP, debugger y subagentes. No hace falta API key ni pagar un segundo consumo.

    ¿Necesito una API key de OpenAI para usar Codex en omp?

    No. El provider de modelo openai-codex usa OAuth: entras con /login openai-codex, autorizas en el navegador con tu cuenta de ChatGPT y ya está. Las credenciales quedan en el auth store, ~/.omp/agent/agent.db, y se refrescan solas. Si prefieres inyectarlas por entorno, la variable del provider es OPENAI_CODEX_OAUTH_TOKEN.

    ¿Puedo usar mi cuenta de empresa y la personal a la vez?

    Sí. Para ChatGPT (Codex) y para Anthropic, cada organización o workspace cuenta como una cuenta propia: puedes loguearte una vez por suscripción y eliges el workspace en la pantalla de consentimiento del navegador. La rotación las trata como cuentas distintas, y las rankea y rota automáticamente.

    ¿Tengo que migrar mis AGENTS.md y mi configuración de Codex?

    No. omp lee ocho formatos en su forma nativa y en el primer arranque hereda reglas, skills y servidores MCP de los directorios de Claude, Cursor, Windsurf, Gemini, Codex, Cline, Copilot y VS Code. Con un matiz: el provider codex solo carga ~/.codex/AGENTS.md, a nivel de usuario. El contexto de proyecto llega por un AGENTS.md suelto vía el provider agents-md, no desde <cwd>/.codex/AGENTS.md.

    ¿Qué pasa cuando mi plan de Codex se queda sin cuota a mitad de turno?

    Para eso están las fallback chains, declaradas por rol o por modelo bajo retry.fallbackChains. Cuando el primario devuelve 429s o choca contra el muro de cuota, la siguiente entrada de la cadena se queda el resto del turno y se restaura al pasar el cooldown. En vez de un turno muerto tienes un degradado suave.

    ¿Por qué mi login de Codex parece ignorarse?

    Casi siempre es el orden de resolución de credenciales: gana la primera capa que encaja, y una apiKey declarada en models.yml está por encima del OAuth almacenado. Es deliberado, para que la key de un baseUrl o gateway propio se respete en vez de reenviar un token OAuth que el proxy rechazaría.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo integrar Codex CLI en tu flujo de trabajo de manera segura

    Cómo integrar Codex CLI en tu flujo de trabajo de manera segura

    posts sobre codex cli — repositorio en GitHub

    Tiempo estimado de lectura: 4 min

    • Ideas clave:
    • Codex CLI demostró la capacidad de transformar lenguaje natural en comandos de shell; su valor actual está en el patrón arquitectónico más que en copiar la herramienta tal cual.
    • Flujo seguro: captura del prompt → contexto mínimo → petición al modelo → plan → revisión humana → ejecución (sandbox opcional).
    • Reglas operativas: uso estricto de git, human-in-the-loop, .codexignore, sandboxing y logs.
    • Considera alternativas modernas (Copilot CLI, Aider, Claude Code) según modelo, coste y conciencia git.

    Buscar “posts sobre codex cli https://github.com/openai/codex” es algo que cualquier developer que pasa tiempo en la terminal hace tarde o temprano. El repositorio de OpenAI en GitHub contiene código que convirtió instrucciones en lenguaje natural en comandos de shell ejecutables; aquí tienes un análisis técnico, práctico y con criterio para decidir si merece entrar en tu flujo de trabajo —y cómo hacerlo sin romper nada.

    Resumen rápido (lectores con prisa)

    Codex CLI traduce prompts en comandos de shell con confirmación humana. Úsalo para automatizar refactorizaciones y tareas repetitivas, pero siempre con git, .codexignore y sandboxing. No lo ejecutes en producción sin revisión.

    posts sobre codex cli https://github.com/openai/codex — qué era y qué es hoy

    Codex CLI nació como experimento para demostrar que un modelo podía traducir prompts a comandos de bash, zsh o PowerShell. El repositorio en https://github.com/openai/codex contiene el código fuente, ejemplos y el patrón básico: capturar prompt → enriquecer con contexto mínimo → pedir al modelo → mostrar comando para confirmación.

    Con el tiempo el ecosistema evolucionó. Los modelos Codex originales fueron consolidados dentro de las familias GPT y las implementaciones prácticas deben adaptarse a nuevas APIs y consideraciones de seguridad. El valor técnico del repositorio no está tanto en copiar y pegar la herramienta tal cual, sino en entender su arquitectura: contexto, plano de acción propuesto por el modelo y control humano en el loop.

    Arquitectura práctica del Codex CLI (resumen técnico)

    Un flujo seguro y repetible que tomes del repo:

    Paso 1: Captura del prompt en la CLI

    Captura del prompt en la CLI.

    Paso 2: Construcción de contexto

    Construcción de contexto: sistema operativo, shell, archivos relevantes.

    Paso 3: Petición al modelo

    Petición al modelo con instrucciones claras (incluyendo límites).

    Paso 4: Recepción de plan

    Recepción de plan: comandos y diffs.

    Paso 5: Capa de revisión humana

    Capa de revisión humana (confirmación Y/N).

    Paso 6: Ejecución en sandbox o contexto real

    Ejecución en sandbox o en contexto real según el modo.

    El repositorio muestra esa cadena end-to-end y facilita experimentar. Link: https://github.com/openai/codex

    Cómo integrar Codex CLI hoy sin liarla

    Si vas a usar ideas o código del repo, aplica estas reglas operativas:

    • Git obligatorio: nunca en modo autónomo sin control de versiones. Todo cambio debe poder revertirse con un git reset o revert.
    • Human-in-the-loop: exige confirmación explícita (Y/N) para cualquier comando que altere el FS fuera de una carpeta de prueba.
    • .codexignore: crea un archivo para excluir node_modules, dist, build, archivos binarios y .env. Reduce coste de tokens y evita filtrar secretos.
    • Sandboxing: para experimentos, usa contenedores Docker con red deshabilitada. Configura volúmenes limitados.
    • Tokens y coste: limita el contexto que envías al modelo. No adjuntes todo el repo; adjunta solo los ficheros necesarios o extractos relevantes.
    • Logs y auditoría: guarda los prompts y las respuestas (hashed si hay datos sensibles) para trazabilidad.

    Ejemplo mínimo de instalación (adaptado del repo)

    npm install -g @openai/codex
    export OPENAI_API_KEY="sk-…"
    codex
    

    No copies sin validar; el repo original puede requerir adaptaciones a la API actual.

    Casos de uso donde realmente aporta valor

    No todo para todo. Usa Codex CLI (o una implementación basada en su diseño) cuando:

    • Necesites refactorizaciones a escala: renombrar símbolos en todo el repo siguiendo reglas concretas.
    • Generación de tests coherentes con la base existente: pide que imite la convención de tests del proyecto.
    • Automatización de infra/DevOps repetitiva: plantillas de Dockerfile, small CI changes, hooks de Git.
    • Onboarding: un agente que explique snippets o genere tareas repetitivas para nuevos miembros.

    No lo uses para operaciones críticas sin revisión (migraciones de BD sin script probado, cambios en infra prod).

    Alternativas y posición en el ecosistema

    El diseño del repo de OpenAI es la semilla. Hoy existen herramientas más pulidas y con integraciones específicas (Copilot CLI, Aider, Claude Code). La decisión práctica se basa en tres factores: modelo y coste, git-awareness (capacidad para trabajar con commits y diffs), y controles de seguridad integrados.

    • Si quieres integración empresarial y soporte nativo con GitHub: considera Copilot CLI.
    • Si necesitas un agente git-aware que haga commits atómicos: mira Aider.
    • Si trabajas con repositorios enormes y razonamiento arquitectónico: Claude Code es fuerte en contexto pesado.

    Codex CLI (repositorio) sigue siendo un recurso para aprender el patrón arquitectónico y prototipar. En https://github.com/openai/codex encontrarás el material de referencia.

    Conclusión: lee los posts, adapta las ideas, no copies el script

    Los posts sobre codex cli https://github.com/openai/codex deben leerse con criterio. El valor real está en el patrón: contexto mínimo, plan claro, revisión humana y ejecución controlada. Si vas a incorporar agentes en tu terminal, hazlo con Git como red de seguridad, ignores claros y entornos aislados. Empieza por prototipos en carpetas no productivas, automatiza tareas repetitivas y escala solo cuando la trazabilidad y la seguridad estén resueltas.

    El repo es útil. Pero la responsabilidad técnica es tuya: la IA puede sugerir un comando brillante y peligroso a la vez. Mantén el control, y usa la terminal como un asistente, no como un sustituto de tu juicio.

    Dominicode Labs

    Si trabajas en automatización, agentes o workflows y quieres prototipar con control de seguridad, considera explorar recursos adicionales en Dominicode Labs. Sirve como continuación lógica para experimentar con patrones de agente git-aware y sandboxing.

    FAQ

    ¿Qué es Codex CLI y dónde está el código?

    Codex CLI fue un experimento que convierte prompts en comandos de shell con confirmación humana. El código está disponible en el repositorio de OpenAI en GitHub; accede a él desde el enlace proporcionado en el artículo.

    ¿Por qué no debo ejecutar comandos sin control de versiones?

    Sin git no puedes revertir fácilmente cambios peligrosos. Usar control de versiones permite deshacer operaciones con git reset o revertir commits, reduciendo el riesgo al probar comandos generados por IA.

    ¿Qué debe incluir un .codexignore?

    Incluye node_modules, dist, build, archivos binarios y .env. Esto reduce coste de tokens y evita filtrar secretos al modelo.

    ¿Cómo aplicar sandboxing para experimentos?

    Usa contenedores Docker con la red deshabilitada y volúmenes limitados para ejecutar comandos de prueba. Esto aísla el entorno y minimiza el impacto de cambios inesperados.

    ¿Para qué casos de uso es recomendable usar Codex CLI?

    Es útil para refactorizaciones a escala, generación de tests coherentes, automatización repetitiva de infra/CI, y onboarding que requiera generación de tareas o explicaciones de snippets.

    ¿Qué alternativas existen hoy?

    Alternativas mencionadas incluyen Copilot CLI, Aider y Claude Code, cada una con puntos fuertes según integración con GitHub, git-awareness y capacidad para contextos grandes.

    ¿Cómo auditar prompts y respuestas?

    Guarda los prompts y respuestas en logs. Si contienen datos sensibles, almacena versiones hasheadas. Mantén trazabilidad para revisar decisiones y reproducir resultados.