Tag: Automatización

  • npm install es un acto de fe: cómo auditar tus dependencias

    npm install es un acto de fe: cómo auditar tus dependencias

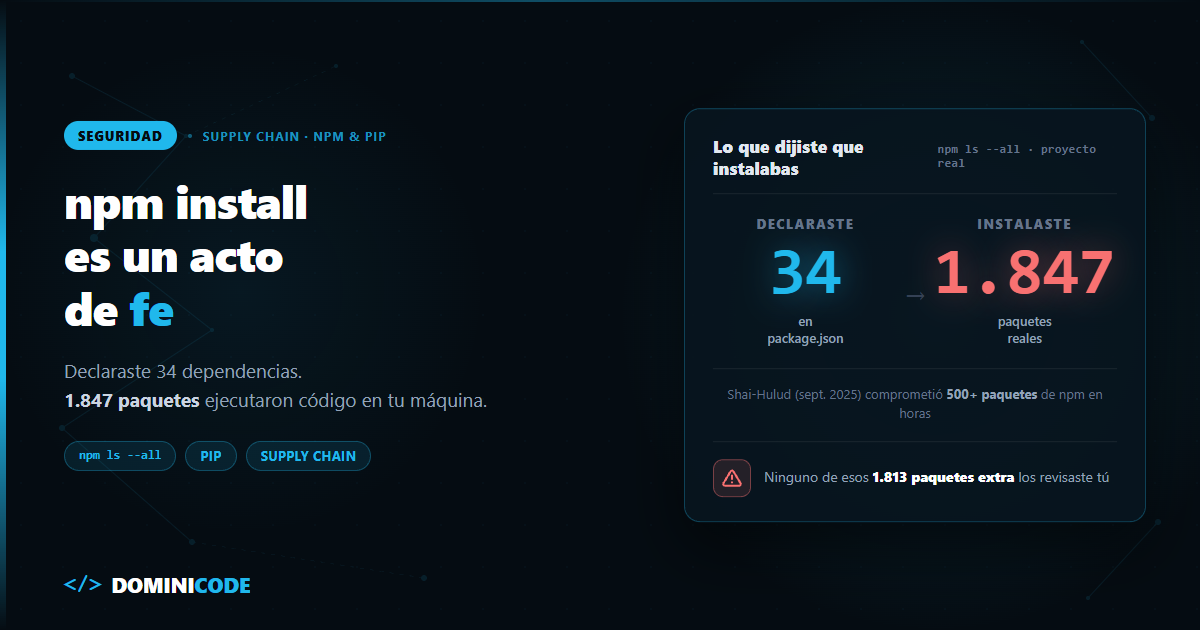
    El viernes pasado revisé el package-lock.json de un proyecto Next.js de un cliente. 34 dependencias directas en el package.json. Corrí npm ls --all y conté los paquetes reales instalados en node_modules.

    1.847.

    Ninguno de esos 1.813 paquetes "extra" lo instalé yo a propósito. Los trajo alguien más, en algún punto de la cadena, sin que yo lo decidiera ni lo viera venir. Y cada uno tuvo la oportunidad de ejecutar código en mi máquina en el momento exacto en que corrí npm install.

    Eso es lo que nadie te explica: auditar dependencias de un proyecto no es un extra de seguridad corporativa. Es lo único que se interpone entre tu máquina y un supply chain attack real, hoy, en el registro que uses.

    En corto: auditar dependencias de un proyecto significa revisar qué código de terceros se ejecuta cuando instalas o construyes tu app — no solo si tiene vulnerabilidades conocidas en una base de datos. Un supply chain attack en npm o pip no ataca tu código: compromete un paquete del que dependes y usa tu propio npm install o pip install como vector de entrada.

    La defensa combina lockfiles con versiones exactas, revisión de scripts de instalación y herramientas de auditoría automatizada — ninguna de las tres por separado basta.

    ¿Qué es un supply chain attack en dependencias de software?

    Un supply chain attack de dependencias es un ataque que no compromete tu aplicación directamente, sino un paquete de terceros que tu aplicación instala, para que el código malicioso llegue a producción disfrazado de una actualización legítima.

    No hace falta que un atacante encuentre un fallo en tu código. Le basta con comprometer una cuenta de npm, publicar una versión maliciosa de un paquete popular, y esperar a que miles de proyectos corran npm install esa semana.

    El vector es el propio gestor de paquetes. npm install y pip install no solo copian archivos: ejecutan código. En npm, cualquier paquete puede declarar un script postinstall en su package.json que corre automáticamente, sin preguntar, apenas termina la instalación.

    En pip, cuando instalas desde una distribución fuente (sdist) en lugar de un wheel precompilado, se ejecuta código de build arbitrario durante el propio pip install — el clásico setup.py, o el hook de un backend moderno como flit_core, hatchling o poetry-core si el paquete usa pyproject.toml.

    Dos incidentes reales que conviene conocer

    No es teórico. Esto ya pasó, más de una vez, en el ecosistema que probablemente usas hoy.

    El 23 de septiembre de 2025, CISA publicó una alerta sobre "Shai-Hulud", un gusano autorreplicante que comprometió más de 500 paquetes de npm.

    El malware escaneaba el entorno en busca de tokens de GitHub y credenciales de AWS, GCP y Azure, las exfiltraba a repositorios públicos controlados por el atacante, y usaba las cuentas de mantenedores comprometidas para inyectarse en más paquetes — sin intervención humana en cada salto. Meses después, una variante llamada "Shai-Hulud 2.0" amplió el radio de impacto a decenas de miles de repositorios de GitHub.

    En octubre de 2021, alguien secuestró la cuenta npm del mantenedor de ua-parser-js, una librería con más de 8 millones de descargas semanales, y publicó versiones que instalaban un minero de criptomonedas y un troyano que robaba contraseñas de navegadores.

    El propio mantenedor documentó el incidente en vivo en el issue de GitHub — vale la pena leerlo para ver cuánto pánico genera algo así cuando ya es tarde.

    Y aunque no es un paquete de npm ni de pip, el caso de xz-utils (marzo de 2024, CVE-2024-3094) es la referencia obligada del ecosistema open source en general.

    Un atacante bajo el alias "Jia Tan" pasó casi tres años construyendo reputación como colaborador legítimo antes de insertar un backdoor en una librería de compresión usada por millones de servidores Linux. Lo descubrió un ingeniero, Andres Freund, porque notó que SSH tardaba casi el triple de lo normal en conectar —0,8 segundos en vez de 0,3—. Nadie lo detectó por auditoría automática.

    Señales de alerta en un paquete

    No todas las dependencias merecen el mismo nivel de escrutinio. Estas son las señales que sí justifican parar y mirar más de cerca:

    Señal Por qué importa Cómo comprobarlo
    Pocas descargas semanales pero pide permisos amplios (red, sistema de archivos) Paquete de bajo perfil es más fácil de comprometer sin que nadie lo note curl https://api.npmjs.org/downloads/point/last-week/<paquete> o npmtrends.com
    Cambio reciente de mantenedor o de email de contacto Precede a la mayoría de los secuestros de cuenta documentados (caso ua-parser-js, event-stream) Historial de mantenedores en npmjs.com o PyPI
    Script postinstall que descarga binarios de una URL externa Ejecuta código fuera del propio paquete, sin pasar por revisión de npm/PyPI Leer scripts.postinstall en el package.json publicado
    Código minificado en el paquete publicado que no existe en el repo de GitHub El repo público sirve de fachada; el código real vive solo en el tarball Comparar npm pack del paquete contra el código fuente en GitHub
    Salto de versión sin changelog ni commits nuevos Publicación fuera del ciclo normal, típica de una cuenta comprometida Fecha de publicación en npm/PyPI vs. último commit en GitHub
    Nombre casi idéntico a un paquete popular (reqeusts en vez de requests) Typosquatting: apuesta a que alguien escriba mal el nombre Verificar el nombre exacto antes de instalar, no solo el autocompletado

    Lockfiles: por qué ^ y ~ no protegen a nadie

    Un lockfile (package-lock.json, pnpm-lock.yaml, poetry.lock, o requirements.txt generado con hashes) fija la versión exacta de cada dependencia, directa y transitiva, que se instaló la última vez que corriste el instalador.

    El problema está en el package.json. Si declaras una dependencia como ^4.2.1, npm puede instalar cualquier versión 4.x.x posterior sin que tú lo pidas explícitamente. Con ~4.2.1 acepta cualquier parche 4.2.x. Ambos rangos existen para facilitarte la vida — y ambos significan que una versión comprometida publicada hoy puede entrar en tu build mañana, sin que cambies una sola línea de código.

    El lockfile resuelve esto solo si lo respetas. npm install puede actualizar el lockfile si detecta que hay versiones nuevas dentro del rango permitido. npm ci, en cambio, instala exactamente lo que dice el lockfile y falla si no coincide con el package.json — es el comando correcto para CI/CD, no npm install.

    En pip, el equivalente es fijar versiones exactas en requirements.txt (requests==2.31.0, no requests>=2.31.0) y, si quieres ir un paso más allá, generar hashes con pip-compile --generate-hashes para que pip install rechace un paquete si el hash no coincide con el que fijaste. Poetry hace esto por defecto con poetry.lock.

    No es casualidad que la alerta de CISA sobre Shai-Hulud recomendara explícitamente revisar package-lock.json y fijar versiones anteriores al 16 de septiembre de 2025. El lockfile fue, literalmente, el mecanismo de contención.

    El riesgo real de los scripts de instalación

    Un script postinstall en npm corre con los mismos permisos que tu usuario del sistema. Puede leer tu .env, tus llaves SSH, tus credenciales de AWS guardadas en ~/.aws/credentials, y enviarlas a donde quiera — exactamente lo que hizo Shai-Hulud.

    Puedes desactivarlos con npm install --ignore-scripts. La contrapartida: algunos paquetes legítimos (compiladores nativos, binarios de Electron) sí necesitan su postinstall para funcionar, así que desactivarlo a ciegas en todos lados puede romper el build. Úsalo como paso de auditoría — instala con --ignore-scripts, revisa qué scripts se habrían ejecutado, y decide caso por caso.

    En pip el riesgo tiene otra forma. Si el paquete se instala desde un wheel precompilado, no se ejecuta código arbitrario: es una copia de archivos. Si se instala desde una distribución fuente (sdist), pip ejecuta setup.py como Python real durante la instalación. La mitigación más simple es forzar wheels con pip install --only-binary=:all: cuando el paquete lo permita, y mirar con lupa cualquier dependencia que solo publique sdist.

    Herramientas para auditar, sin inventar magia

    Ninguna herramienta automática sustituye la lectura humana de un postinstall sospechoso, pero sin ellas no auditas nada a escala. Estas cuatro son reales y verificables, sin funciones inventadas:

    • npm audit y pnpm audit comparan tus dependencias contra bases de datos de vulnerabilidades conocidas (CVE) y te dicen si hay una versión con parche disponible.
    • pip-audit, mantenido por la Python Packaging Authority, hace lo mismo para proyectos Python contra la base de datos OSV.
    • Socket.dev va más allá de las CVE conocidas: analiza el comportamiento del paquete — si tiene scripts de instalación, si hace llamadas de red, si accede a archivos sensibles, si el código está ofuscado — y da una puntuación de riesgo antes de que el CVE exista siquiera.
    • Snyk combina escaneo de vulnerabilidades con monitoreo continuo y se integra directamente en el flujo de PR de GitHub.

    Ninguna de estas herramientas detecta un ataque de tipo Shai-Hulud el mismo día. Todas dependen de que alguien, en algún punto, reporte el paquete malicioso primero.

    Checklist: auditar un proyecto real en menos de una hora

    1. Corre npm audit o pip-audit sobre el proyecto completo. Anota las vulnerabilidades críticas y altas — no todas, esas.
    2. Revisa el package.json o requirements.txt buscando rangos ^, ~ o >= en dependencias que no necesiten actualizarse automáticamente. Fíjalas a versión exacta.
    3. Confirma que el CI usa npm ci, no npm install. Es un cambio de una línea con impacto real.
    4. Lista los paquetes con postinstall (npm ls no lo muestra directo; revisa el package.json de cada dependencia sospechosa en node_modules, o usa Socket.dev para verlo agregado).
    5. Verifica cuándo se actualizó cada dependencia crítica por última vez y si el mantenedor cambió recientemente — la tabla de señales de arriba te dice dónde mirar.
    6. Si el proyecto usa un agente de IA para instalar dependencias (Cursor, Claude Code, Copilot en modo agéntico), revisa el diff del package.json antes de aceptar el commit. Un agente puede instalar un paquete typosquateado con la misma confianza que uno legítimo si el nombre es parecido.

    Ese último punto es donde converge el problema técnico con el flujo de trabajo actual. Si dejas que un agente proponga e instale dependencias sin revisión, necesitas el mismo nivel de disciplina que aplicarías a un PR de un desarrollador que no conoces — es literalmente la lógica que enseño en el ebook gratuito "Revisión por Contrato": no confías en el resultado porque "suena bien", confías en él porque pasó un contrato de revisión explícito.

    Es también una cuestión de coste: revisar el diff de un package.json antes de aceptarlo cuesta minutos; limpiar un supply chain attack ya en producción cuesta muchísimo más. Desarrollo esa cuenta —cuándo compensa verificar y cuándo no— en El futuro de los agentic systems: coste por tarea, no benchmarks.

    El caso específico de dependencias de IA

    Todo lo anterior aplica a cualquier paquete, pero los modelos de IA tienen una superficie de riesgo propia: from_pretrained(), load_dataset() y hf_hub_download() descargan pesos y datasets de gigabytes desde un hub externo, muchas veces sin pasar por tu lockfile ni por npm audit.

    Ya escribí sobre ese caso específico — qué cambia con Hugging Face bajo NVIDIA, por qué fijar un commit SHA no es opcional cuando hablamos de modelos, y el checklist de 5 pasos para auditarlo — en NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo. Si tu proyecto carga modelos en runtime, léelo después de este.

    Qué esta auditoría NO cubre

    Esta auditoría tiene tres límites reales, y ser honesto aquí importa más que sonar completo.

    npm audit y pip-audit solo detectan vulnerabilidades ya reportadas. Un paquete recién comprometido, como Shai-Hulud el primer día, no aparece en ninguna base de datos hasta que alguien lo reporta — y eso puede tardar horas o días, tiempo suficiente para que el código malicioso corra en cientos de builds.

    El código ofuscado bien hecho pasa controles automáticos. Herramientas como Socket.dev mejoran mucho la detección de comportamiento sospechoso, pero un atacante paciente (como demostró el caso xz-utils) puede esconder la parte maliciosa en binarios de test que ni siquiera están en el repositorio público, y ningún escáner estático la va a encontrar si no sabe qué buscar.

    Y esta auditoría no resuelve el problema humano de fondo: alguien tiene que revisar los resultados. Un npm audit limpio en un dashboard que nadie mira no protege nada.

    Qué hacer hoy con esto

    No necesitas auditar los 1.847 paquetes de tu node_modules esta semana. Necesitas tres cosas, en este orden: fija las versiones de tus dependencias directas, cambia npm install por npm ci en tu pipeline de CI, y corre npm audit o pip-audit una vez antes de tu próximo deploy.

    Eso te cubre contra el 80% de los incidentes reales — el resto es disciplina continua, no una tarea de una sola vez. Si construyes con agentes de IA y quieres que esa disciplina esté integrada en tu flujo desde el primer prompt, es exactamente lo que trabajamos en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si quieres seguir esta conversación con otros developers que ya están aplicando esto en producción, en Dominicode Labs compartimos los checklists y las decisiones reales de auditoría, no solo la teoría.

    Preguntas frecuentes

    ¿Qué es un supply chain attack en el contexto de npm o pip?

    Es un ataque que compromete un paquete del que depende tu proyecto — no tu código directamente — para que el código malicioso llegue a tu máquina o a producción disfrazado de una instalación o actualización legítima. El vector de entrada es tu propio npm install o pip install.

    ¿Un lockfile me protege completamente contra estos ataques?

    No completamente, pero reduce mucho el riesgo. Un lockfile fija versiones exactas y evita que una actualización automática dentro de un rango ^ o ~ traiga una versión comprometida sin que tú lo notes. No te protege si tú mismo actualizas el lockfile aceptando la versión maliciosa, ni si la dependencia ya estaba comprometida antes de que la instalaras por primera vez.

    ¿Es seguro desactivar todos los scripts postinstall con –ignore-scripts?

    Reduce el riesgo de ejecución de código no revisado, pero puede romper paquetes legítimos que necesitan compilar binarios nativos o descargar assets en la instalación. Úsalo primero como herramienta de auditoría para ver qué scripts se ejecutarían, y decide caso por caso antes de dejarlo activo en producción de forma permanente.

    ¿npm audit o pip-audit son suficientes para considerar un proyecto auditado?

    No. Ambos solo detectan vulnerabilidades ya reportadas en una base de datos pública. Un paquete recién comprometido, sin CVE asignado todavía, pasa desapercibido para estas herramientas. Complementan una auditoría real; no la sustituyen.

    ¿Cómo audito las dependencias de modelos de IA como Hugging Face de forma distinta?

    Los modelos se descargan en runtime con funciones como from_pretrained(), muchas veces fuera del alcance de tu lockfile y de npm audit. El enfoque es distinto: fijar el commit SHA del modelo, activar modo offline para detectar descargas implícitas, y espejar localmente lo crítico. Lo cubro con checklist completo en el post sobre NVIDIA y Hugging Face.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Agentic code review: el 64,7% de los PRs se aprueba sin leerlo

    Agentic code review: el 64,7% de los PRs se aprueba sin leerlo

    Esta semana has aprobado al menos un PR sin leerlo entero. Has mirado el diff en diagonal, has visto que el CI estaba en verde y has escrito "LGTM".

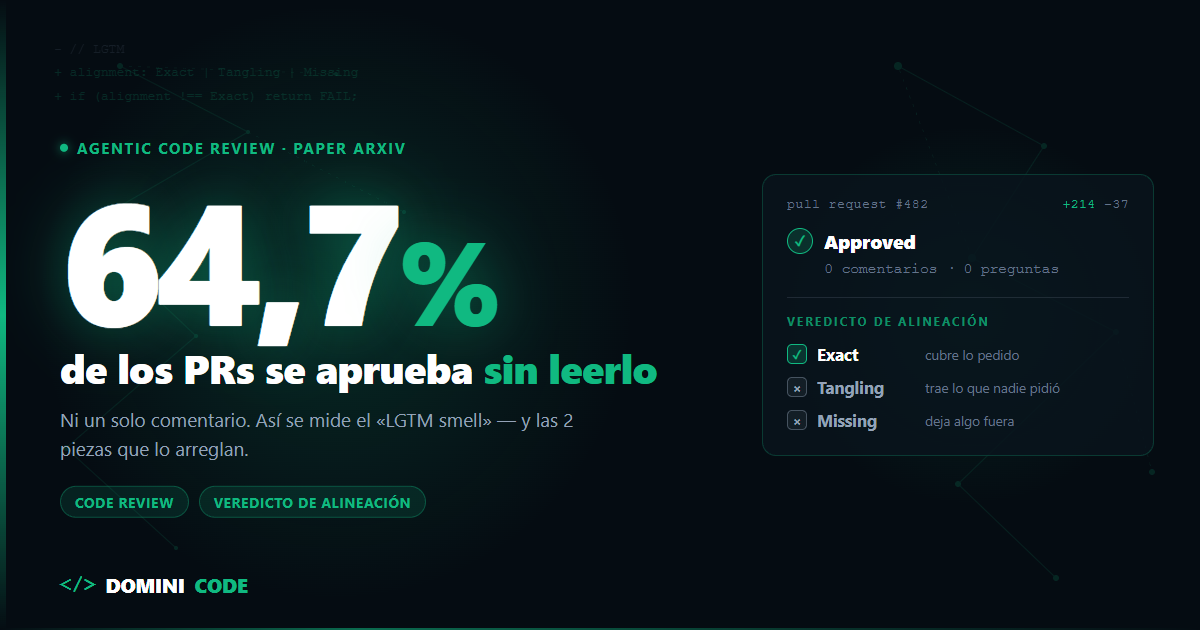
    No te estoy juzgando. Te estoy describiendo. Y no lo digo yo. Lo dice un estudio sobre cinco proyectos de gran escala (Gon et al.), recogido en un paper académico sobre agentic code review que acabo de leer entero: el 64,7% de los PRs se aprueban sin un solo comentario. Y esos reviews silenciosos presentan el "LGTM smell" —aprobar sin revisar de verdad— 3,5 veces más que los reviews con conversación.

    El paper se llama Rethinking Code Review in the Age of AI: A Vision for Agentic Code Review (arXiv:2605.17548). Es un vision paper: propone un framework, no un sistema implementado. Pero la radiografía que hace del review actual es tan incómoda que he cambiado cómo revisan código mis dos herramientas open source.

    Te cuento por qué.

    Los números que describen tu equipo

    El paper recopila estudios empíricos de la última década. Léelos pensando en tu repo, no en el de otros:

    • El 34% de 333.001 descripciones de PR analizadas en GitHub estaban vacías. Ni una línea de contexto (Liu et al.).
    • El 34,3% de los PRs no enlazan con ningún issue. En commits de bugfix, el 52,4% van sin enlazar (Dogan et al.; Bachmann et al.).
    • En Mozilla, el 54% de los code reviews no detectaron bugs que estaban presentes en commits aprobados (Kononenko et al.).
    • En Microsoft, solo el 15% de los comentarios de review señalaban defectos potenciales (Czerwonka et al.). Y entre un 34,5% y un 44,47% de los comentarios se clasifican directamente como "no útiles".
    • Un 19,1% de los comentarios de review de un dataset estudiado eran, literalmente, tóxicos (Sarker et al.).

    La etapa que llamamos "control de calidad" dejó pasar bugs en más de la mitad de los reviews medidos en Mozilla, genera ruido en un tercio de los comentarios y a veces hasta hace daño.

    Y ahora métele IA.

    El code review con IA no arregla el problema. Lo desborda

    Los asistentes de IA aceleran las tareas individuales de código en más de un 50%, según los estudios que recopila el paper. Escribimos más código que nunca. Pero hay dos datos que deberían quitarte la sonrisa.

    Uno: las contribuciones generadas por IA requieren más iteraciones de review que las escritas por humanos.

    Dos: cuando la IA asiste al reviewer, este encuentra más issues de severidad baja… pero no más defectos graves. La automatización arrastra tu atención hacia los problemas fáciles. El naming, el estilo, el typo. Mientras, el bug de concurrencia pasa de largo con su "LGTM".

    El paper lo dice sin rodeos: el code review ya no es solo un cuello de botella de productividad, es "la superficie de control primaria de la calidad y la responsabilidad del código producido por IA".

    Piensa en lo que eso significa. Si un agente escribe el 60% de tu código, el review es el único punto donde un humano responde por él. Y ese punto, según los datos de arriba, está roto.

    Hay una capa del problema que el review ni siquiera puede tocar, y la desarrollé aparte en los 5 fallos del código generado por IA que un code review no puede ver. Este post va de la otra mitad: arreglar lo que el review sí puede hacer y no hace.

    Qué es el agentic code review: el review no es una etapa, es un ciclo

    El agentic code review es un modelo de revisión en el que agentes de IA especializados cubren las cinco etapas del ciclo de vida del PR, mientras el humano actúa como supervisor con capacidad de veto en cada punto de decisión. La diferencia con "un bot que comenta el diff" es que el contexto cruza las fronteras entre etapas en lugar de perderse en cada salto.

    Y esa es la propuesta central del paper: la efectividad del review no es el resultado de una etapa aislada, sino de todo el ciclo de vida del PR.

    Un comentario de review útil depende de que el PR tenga una descripción con rationale. La descripción depende de que exista un issue enlazado. Y los reviews futuros dependen de que las lecciones de los reviews pasados queden escritas en algún sitio. Ninguna herramienta que optimice una sola etapa puede resolver esas dependencias.

    El framework tiene cinco etapas con agentes especializados y puertas humanas en cada punto de decisión: PR Creation → PR Augmentation → Reviewer Selection → AI-Assisted Code Review → PR Retrospective. El reviewer deja de ser un inspector manual y pasa a ser un operador supervisor de agentes.

    De todo el framework, hay dos piezas que me parecen oro. Y son las dos que he implementado hoy.

    Qué es el veredicto de alineación: Exact, Tangling y Missing

    El paper recoge una taxonomía de Isik et al. que formaliza algo que todos intuimos pero nadie mide: ¿el PR hace lo que se pidió?

    Categoría Qué significa Cómo se manifiesta con agentes Dato del paper
    Exact Cubre lo pedido, sin extras El caso que quieres —
    Tangling Incluye código que nadie pidió Le pides un fix y refactoriza tres ficheros "de paso" 7-20% de los changesets
    Missing No cubre todo lo pedido Marca la tarea como hecha sin implementar el criterio 16,5% de los PRs
    Missing and Tangling Ambas a la vez Se deja lo pedido y añade lo que no —

    Un review que solo busca bugs responde a la pregunta equivocada. La primera pregunta no es "¿este código tiene errores?". Es "¿este código es el que se pidió?".

    Por eso el skill /ak:review de ai-workflow-kit y la fase de Code Review del plugin sdd-creator ya no cierran el review con una lista de bugs. Cuando encuentran una spec que cubre el cambio, abren el review con una capa de cumplimiento y lo cierran con un veredicto de alineación explícito, contrastado criterio a criterio contra esa spec:

    ## Review: [feature slug]
    
    Status: PASS | CHANGES REQUIRED
    Alignment: Exact | Tangling | Missing | Missing and Tangling
    
    ### Requirements compliance
    - [AC-XX]: implemented / missing / diverges — [evidence]
    - Tasks marked done without a matching implementation: [list or none]
    - Out of scope: [code no criterion asks for, or none]
    

    La regla que lo hace útil es la última: un veredicto distinto de Exact no puede ser PASS salvo que tú aceptes la desviación por escrito. El código fuera de alcance se quita o se especifica; el trabajo que falta se completa o se saca del alcance. Es un veredicto que puedes verificar en dos minutos, en lugar de un "se ve bien" que no compromete a nadie.

    Si el repo no tiene specs/, no hay contra qué contrastar y el review vuelve al formato de severidades de siempre. Que es, en sí mismo, el argumento del paper.

    Qué es la retrospectiva de PR y por qué un review sin memoria se repite

    La quinta etapa del framework es la que casi todo el mundo se salta: el PR Retrospective. Cuando el PR se aprueba o se rechaza, un agente resume qué se decidió, qué se descartó y por qué, y lo guarda en la memoria del repositorio para que los agentes (y los humanos) del siguiente review partan de ahí.

    Aquí el paper suelta un detalle que valida algo que llevo tiempo defendiendo. Al explicar por qué los modelos no generalizan entre proyectos distintos, dice que inyectar reglas específicas del repositorio vía archivos de configuración tipo "Agents.MD" directamente en la ventana de contexto del agente es una alternativa computacionalmente barata al fine-tuning. No necesitas reentrenar un modelo para que entienda tu proyecto. Necesitas escribir las decisiones en un fichero que viaje con el repo.

    Eso también lo he incorporado: los dos productos ahora cierran el review proponiendo qué promocionar a la memoria del proyecto — decisión confirmada, alternativa rechazada, riesgo que se materializó. En el flujo SDD va a specs/INDEX.md; en el kit, a memory/decisions/. Los arreglos de código se quedan en el review; solo sube el conocimiento duradero. El siguiente review no redescubre lo mismo. Acumula.

    El paper valida SDD sin saberlo

    Y hay una frase del paper que me hizo reírme solo: "el contexto debe cruzar las fronteras entre etapas". Porque eso es exactamente Spec-Driven Development: el spec.md, el plan.md y el tasks.md no se quedan en la fase de diseño. Viajan hasta el review y hasta el PR. El reviewer no reconstruye la intención desde el diff — la tiene delante, escrita antes de la primera línea de código.

    El 34% de descripciones de PR vacías no es un problema de disciplina. Es un problema de flujo: si el contexto no existe antes de codificar, nadie lo va a escribir después. SDD lo resuelve por diseño — siempre que la spec esté bien planteada, porque una spec mal escrita rompe al agente igual que no tener ninguna.

    Lo que el paper admite que puede salir mal

    No te vendo humo: los propios autores dedican una sección entera a los riesgos, y son serios.

    Las alucinaciones se propagan en cascada entre agentes. Si el agente de review inventa una vulnerabilidad de concurrencia, el agente de fixes genera locks innecesarios. Para cuando el humano detecta el error, ya has pagado los tokens de tres agentes resolviendo un problema que nunca existió.

    Súmale la degradación de contexto en PRs grandes y el sesgo de automatización: aceptar el output del agente sin verificarlo, que es el LGTM smell con esteroides.

    Y el más silencioso de todos: el deterioro del mentoring implícito. Si el chatbot le explica el PR al junior, el senior ya no se lo explica.

    La respuesta a todos esos riesgos es la misma: puertas humanas con veredictos verificables. No "confía en el agente". Tampoco "desconfía de todo". Sino: exige al agente un output que un humano pueda comprobar en minutos.

    Cómo aplicar el agentic code review hoy en 3 pasos

    No necesitas esperar a que alguien implemente el framework completo del paper. Las tres piezas con más retorno caben en tu flujo actual:

    1. Cierra cada review con un veredicto de alineación. Exact, Tangling, Missing o ambas, contra el issue o la spec. Si no puedes emitirlo, no tenías contexto para revisar — y ese es el verdadero hallazgo del review.
    2. Escribe una retrospectiva de tres líneas por PR relevante. Qué se confirmó, qué se rechazó, qué riesgo apareció. Guárdala en el repo, donde el siguiente agente la pueda leer.
    3. Haz que el contexto viaje. Spec antes del código, spec enlazada en el PR, spec delante del reviewer.

    Si además quieres que esto corra solo en cada push, ya escribí cómo integrar revisiones de código automáticas con IA en el pipeline de CI/CD — el veredicto de alineación encaja ahí como un check más.

    Y si prefieres verlo funcionando en lugar de montarlo desde cero, tanto sdd-creator como ai-workflow-kit son open source y ya incorporan las dos piezas. Si quieres montarlo guiado y de principio a fin, el curso Construye con IA recorre justo este flujo: de la spec al PR revisado. Y si lo que buscas es trabajarlo sobre proyectos completos y en directo, eso es Dominicode Labs.

    El code review no va a desaparecer. Va a convertirse en el trabajo más importante que hagas. Mejor llegar con el contexto puesto.

    Preguntas frecuentes

    ¿Qué es el agentic code review?

    Es un modelo de revisión de código en el que agentes de IA especializados cubren las cinco etapas del ciclo de vida del PR —creación, enriquecimiento, selección de reviewer, revisión y retrospectiva— mientras el humano actúa como supervisor con capacidad de veto en cada punto de decisión. La diferencia con "un bot que comenta el diff" es que el contexto cruza las fronteras entre etapas en lugar de perderse en cada salto.

    ¿Cómo emito un veredicto de alineación en un PR?

    Compara el PR contra el issue o la spec y clasifícalo en una de cuatro categorías: Exact si cubre lo pedido sin extras, Tangling si trae cambios que nadie pidió, Missing si deja algo fuera, o Missing and Tangling si ocurren ambas. Escribe la categoría explícitamente en el PR con una frase de justificación. Si no puedes clasificarlo, el problema no es el PR: es que no tenías contexto suficiente para revisarlo.

    ¿No basta con poner un agente de IA a comentar los pull requests?

    No. Cuando la IA asiste al reviewer aparecen más issues de severidad baja, pero no más defectos graves: la herramienta desplaza la atención hacia lo fácil de detectar. Y un agente que solo comenta diffs no puede saber si el PR hace lo que se pidió, porque nadie le pasó la spec ni el issue.

    ¿En qué se diferencia esto de automatizar el code review en CI/CD?

    En el alcance. Automatizar en CI/CD resuelve la ejecución: que la revisión corra sola en cada push. El enfoque agéntico resuelve el contexto: que la revisión sepa qué se pidió, quién debe revisarlo y qué se aprendió en los PRs anteriores. Son complementarios — el veredicto de alineación se puede publicar como un check más del pipeline.

    ¿El framework del paper ya se puede usar en producción?

    El framework completo no: es un vision paper, una propuesta arquitectónica sin implementación ni evaluación empírica. Pero dos de sus piezas —el veredicto de alineación y la retrospectiva escrita en el repo— no dependen de ninguna infraestructura nueva y las puedes adoptar hoy con las herramientas que ya usas.


    Referencia: Kamalı, H. Ö., Tuna, E., Haratian, V., Tüzün, E. (2026). Rethinking Code Review in the Age of AI: A Vision for Agentic Code Review. Ankara University, Microsoft y Bilkent University. arXiv:2605.17548, mayo de 2026. Vision paper — propuesta de framework, no sistema implementado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Los 5 fallos del código generado por IA que un code review no puede ver

    Los 5 fallos del código generado por IA que un code review no puede ver

    850 líneas. 14 archivos. Toda la capa de autenticación refactorizada con un asistente de IA.

    Dos seniors aprobaron el Pull Request. "LGTM, código muy limpio". Y lo era: nombres claros, funciones pequeñas, tipos correctos, cero warnings del linter.

    Diez minutos después del deploy, producción caída. El código abría una conexión nueva a PostgreSQL en cada petición y no la devolvía nunca. El pool se agotó, los 500 empezaron a caer en cascada y alguien tuvo que hacer rollback desde el móvil.

    Nadie hizo mal su trabajo en ese code review. El fallo simplemente no estaba en la pantalla que estaban mirando.

    Un diff te enseña la forma del código. Los fallos que tumban producción son de comportamiento: aparecen cuando el código se ejecuta, con concurrencia, con datos reales y repetido diez mil veces. Eso no se ve leyendo, se ve midiendo.

    Que no conviene fiarse de un código solo porque se lea bien ya lo conté en cómo garantizar la confiabilidad del código generado por IA. Este post no repite el aviso ni proclama que el code review haya muerto. Va de algo más operativo: qué clase de fallo caza cada capa de tu proceso, y cuál se te está colando porque lo estás buscando en el sitio equivocado.


    Los 5 fallos que un diff no puede mostrar

    No son fallos exóticos. Son los cinco que aparecen una y otra vez cuando el volumen de código generado sube y el tiempo de revisión no.

    1. La consulta N+1 encubierta

    El agente escribe un bucle que llama a un helper. El helper, tres archivos más allá, abre una consulta.

    En el diff ves await getUserProfile(id) dentro de un for. Una línea limpia, con buen nombre. Para verla como un problema tendrías que recordar qué hace ese helper por dentro y multiplicar mentalmente por el tamaño del array.

    En local, con 5 registros de prueba, vuela. En producción, con 4.000, son 4.000 consultas.

    2. La fuga de recursos

    Es el fallo de la historia de arriba y el más traicionero, porque lo que falta nunca aparece en un diff. Un diff enseña lo que se añadió; el bug está en la línea que no se escribió.

    // Se lee perfecto. Y en cada peticion abre una conexion que nadie cierra.
    export async function getInvoices(userId: string) {
      const client = new Client({ connectionString: process.env.DATABASE_URL });
      await client.connect();
      const { rows } = await client.query(
        "SELECT * FROM invoices WHERE user_id = $1",
        [userId],
      );
      return rows; // falta client.end() — y aqui no hay nada rojo que mirar
    }
    

    Lo mismo pasa con listeners que no se quitan, timers que no se limpian y streams que no se cierran. El código se lee bien porque está bien escrito. Solo está incompleto.

    3. La deriva de contrato

    El agente toca el endpoint y renombra un campo de la respuesta, o lo convierte de string a objeto. Actualiza el tipo en ese archivo, así que todo cuadra.

    Lo que no actualiza es el consumidor que vive en otro repositorio, o el móvil que lleva dos versiones sin actualizar. El fallo no está en ningún archivo: está entre dos. Y un revisor mirando un PR de un repo no tiene el otro delante.

    Contra esto, el tipado en tiempo de compilación no basta: hace falta validación en tiempo de ejecución en la frontera, que es justo lo que hace Zod cuando validas lo que entra y sale de cada servicio en lugar de confiar en el tipo declarado.

    4. La regresión de coste

    Este no produce ningún error. Todo funciona, los tests pasan en verde y el usuario no nota nada.

    Simplemente, la nueva versión hace tres llamadas al modelo donde antes hacía una, o manda el documento entero en el prompt donde antes mandaba un fragmento. El resultado es idéntico. La factura, el triple.

    Es el único de los cinco que no es un bug: es una decisión de implementación peor que la anterior. Ninguna aserción se pone roja por esto. Lo ves en la factura a fin de mes, o lo ves en la traza el mismo día.

    5. La race condition introducida "optimizando"

    El agente ve tres await seguidos y los convierte en un Promise.all. En el diff parece exactamente lo que quieres: menos latencia, código más idiomático.

    Salvo que dos de esas operaciones escribían sobre el mismo registro y el orden importaba. Con un usuario, nunca falla. Con doscientos concurrentes, falla una de cada cien veces y el bug tarda tres semanas en reproducirse.


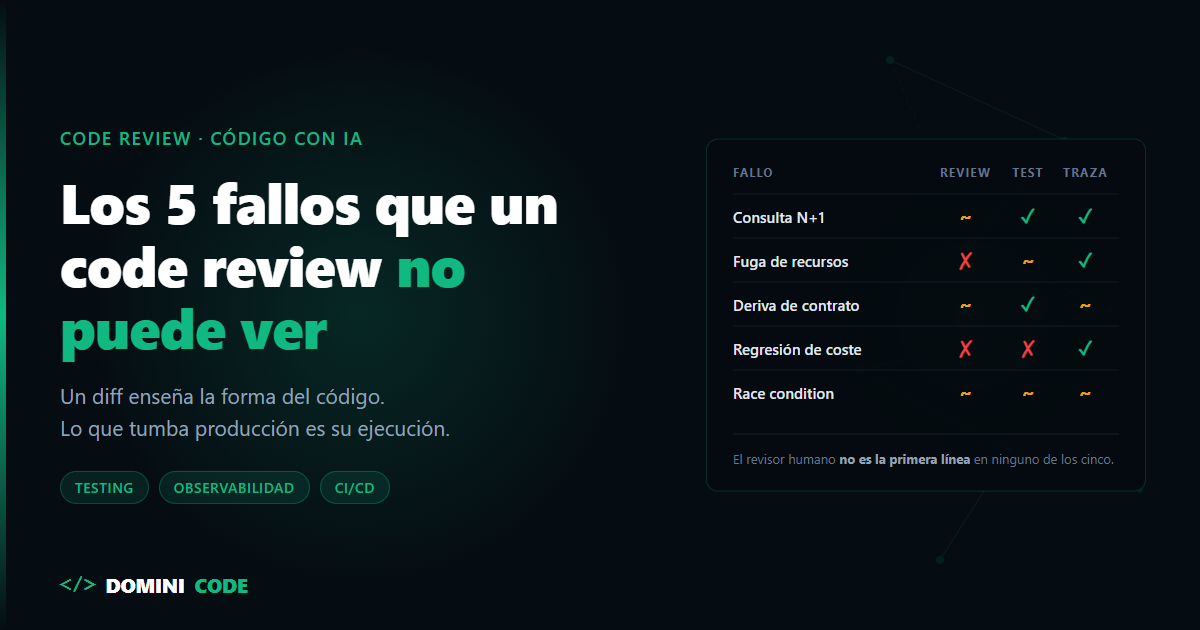
    Qué capa caza cada fallo

    Aquí está el mapa. Es lo único que hay que llevarse del post:

    Fallo Code review Test automático Traza en producción Dónde se caza primero
    Consulta N+1 ⚠️ solo si conoces el helper ✅ asertando nº de queries ✅ evidente Test de integración
    Fuga de recursos ❌ no está en el diff ⚠️ solo repitiendo la llamada ✅ evidente Producción, en minutos
    Deriva de contrato ⚠️ si tienes ambos lados ✅ test de contrato ⚠️ tarde CI, con contract tests
    Regresión de coste ❌ invisible ❌ pasa en verde ✅ único sitio Traza / factura
    Race condition ⚠️ si la buscas ⚠️ flaky, poco fiable ⚠️ difícil de atribuir Test de concurrencia

    Léela por columnas y salta a la vista lo incómodo: el revisor humano no es la primera línea de defensa en ninguno de los cinco. En el mejor de los casos es un ⚠️ que depende de que la persona conozca ese helper concreto, tenga el otro repositorio en la cabeza o esté buscando específicamente esa clase de fallo a la línea 600 de 850.

    Eso no significa que el code review sobre. Significa que le estamos pidiendo el trabajo equivocado.


    El orden correcto (y por qué casi todos lo invierten)

    El proceso típico pone al humano primero: alguien lee el PR, lo aprueba, y entonces corre el CI y se despliega. Con código generado por IA ese orden está del revés, por una razón de economía muy simple: la atención humana es el recurso más caro y más escaso del equipo, y la máquina cuesta céntimos.

    Primero la máquina. Tests, linters, validación de contratos. Si un fallo tiene una aserción posible, esa aserción tiene que existir y correr antes de que nadie lea una línea. El caso del pool que tumbó producción se cazaba con esto:

    it("no deja conexiones abiertas al servir una petición", async () => {
      const before = pool.totalCount;
      await getInvoices("user-1");
      expect(pool.totalCount).toBe(before);
    });
    

    Ese test no lo escribe el agente por iniciativa propia: lo pides tú, porque conoces el fallo. Cómo repartir ese trabajo entre lo que escribes tú y lo que delegas está en TDD con IA: valida el código autogenerado antes de mergear, y hay una capa de revisión automática que puedes meter en el pipeline antes de la humana, explicada en cómo integrar revisiones de código con IA en tu CI/CD.

    Después la traza, como red. Para lo que nadie anticipó —y la regresión de coste es el ejemplo perfecto— la única capa que ve algo es la instrumentación en tiempo de ejecución. Si trabajas con LLMs, el árbol de llamadas y el coste por petición se trazan con las herramientas que repaso en observabilidad en LLMs.

    Y el humano al final, sobre otra pregunta. No "¿está bien escrito esto?" —eso ya lo contestaron el linter y los tests—, sino las tres que ninguna máquina responde:

    • ¿Este código debía existir? Buena parte de los PRs generados con IA resuelven un problema que no había que resolver así.
    • ¿Respeta las fronteras de arquitectura? Un agente cruza capas sin despeinarse si eso hace pasar el test.
    • ¿Cumple lo que dice la especificación?

    Esa tercera pregunta solo se puede contestar si existe una especificación escrita antes del código. Cuando el PR se revisa contra un spec.md, el review deja de ser una opinión sobre estilo y pasa a ser una comprobación con respuesta binaria — que es de lo que va el libro de Spec-Driven Development.

    Y si quieres el músculo de escribir las aserciones del punto 1 —las de verdad, las que fallan cuando algo se rompe y no cuando alguien renombra una variable—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library.


    Lo que puedes cambiar en el próximo PR

    1. Coge la tabla y localiza tu hueco. Casi todos los equipos tienen la columna de tests a medias y la de trazas vacía. Ese es el fallo que se te está colando.
    2. Convierte tu último incidente en una aserción. Si algo tumbó producción una vez, tiene que haber un test que se ponga rojo si vuelve. Uno por incidente, sin excepciones.
    3. Cambia la pregunta del review. Prohíbete comentar estilo. Solo arquitectura, fronteras y cumplimiento de la spec.

    En Dominicode Labs montamos este tipo de procesos de verificación para que la velocidad de la IA no se pague en incidentes de madrugada.

    Generar código rápido hoy es gratis. Lo caro sigue siendo saber si funciona — y eso no se lee en un diff.


    Preguntas frecuentes

    ¿Se puede revisar de verdad un PR de 850 líneas generado por IA?

    No con la atención que merece. La respuesta no es leer más rápido: es exigir que el PR llegue troceado y con la capa automática ya en verde. Un PR generado en cuarenta segundos no da derecho a una revisión de cuarenta segundos, así que o se parte en cambios pequeños o se revisa solo el subconjunto que toca arquitectura y contratos.

    ¿Un linter o un analizador estático caza estos cinco fallos?

    Parcialmente y solo dos. Las reglas estáticas detectan algunos patrones de recurso no cerrado dentro de un mismo archivo, pero no ven el N+1 escondido tras un helper, ni la deriva de contrato entre repositorios, ni el coste, ni la concurrencia. Un linter razona sobre el texto del programa; estos fallos existen únicamente cuando el programa corre.

    ¿Estos fallos son culpa de la IA o pasaban igual con código escrito a mano?

    Pasaban igual. Lo que cambia es el volumen y el ritmo: la misma tasa de fallo aplicada a diez veces más líneas, revisadas por el mismo número de personas en el mismo tiempo, da un resultado muy distinto. El proceso no se rompe porque la IA escriba peor, sino porque escribe más rápido de lo que nadie puede leer.

    Si aún no tengo observabilidad, ¿qué capa cubre el hueco mientras tanto?

    Los tests, pero eligiendo bien. Sin trazas pierdes la regresión de coste y la atribución de las races, así que compensa con aserciones sobre efectos medibles: número de consultas por operación, conexiones abiertas al terminar, número de llamadas al modelo. Son baratas, corren en CI y cubren tres de los cinco fallos hasta que instrumentes.

    ¿Merece la pena que la IA revise sus propios PRs?

    Como primera pasada sí, y sale muy rentable porque cuesta céntimos y no se cansa a la línea 600. Pero trátala como un linter semántico, no como un aprobador: comparte los puntos ciegos del modelo que escribió el código y tiende a validar lo que a ella misma le parece idiomático. La aprobación sigue siendo humana.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Construyendo sitios web ultrarrápidos con Astro y Server Islands: Cero JS por defecto

    Construyendo sitios web ultrarrápidos con Astro y Server Islands: Cero JS por defecto

    Hace unos meses analicé la landing page de un cliente que ofrecía un producto SaaS. Habían construido la web utilizando un marco de trabajo de aplicación de página única (SPA) completo.

    Para renderizar un titular estático, una lista de precios y tres testimonios de clientes, el navegador del usuario tenía que descargar, descompilar y ejecutar 480 KB de JavaScript. En conexiones móviles 4G, el tiempo hasta que la página se volvía interactiva (Time to Interactive) superaba los 5.5 segundos. El resultado en Google Lighthouse era un doloroso 44/100.

    Perdían el 30% de los visitantes antes de que la página terminara de cargar.

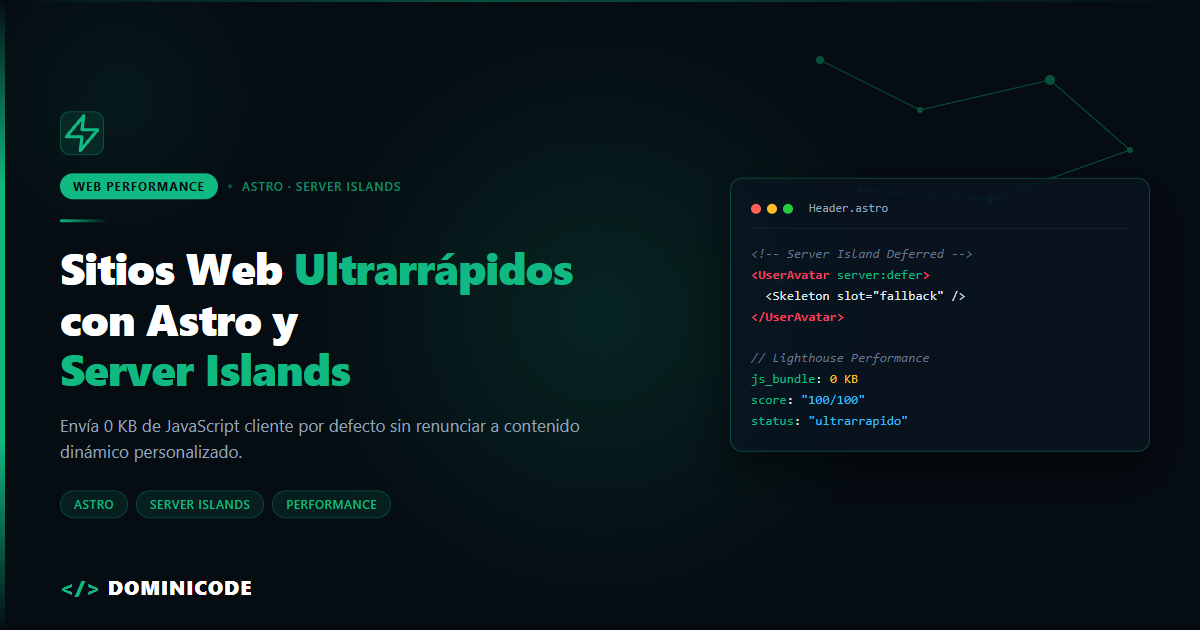
    Al refactorizar el sitio hacia Astro y aprovechar la nueva funcionalidad de Server Islands, redujimos el bundle de JavaScript cliente para la estructura estática a 0 KB, logrando una puntuación de 100/100 en Core Web Vitals en el primer intento.

    La paradoja de enviar JavaScript para renderizar HTML

    Durante la última década, la industria del desarrollo web cometió un error colectivo: asumir que cualquier sitio web moderno debía empaquetarse dentro de una aplicación de React o Angular que se ejecuta íntegramente en el navegador del usuario.

    El resultado ha sido la degradación del rendimiento web:

    • El navegador descarga megabytes de JavaScript para crear nodos de DOM que podrían haber sido enviados directamente como HTML estático.
    • La CPU del dispositivo móvil se satura ejecutando hidratación de estado.
    • Los motores de búsqueda e intenciones de búsqueda sufren retardos de indexación.

    Astro invirtió este modelo con su filosofía "Zero JavaScript by default" (Cero JavaScript por defecto). Astro renderiza todo el componente a HTML estático en el servidor y solo envía JavaScript al cliente si especificas explícitamente una isla interactiva (Islands Architecture).

    ¿Qué son las Server Islands en Astro?

    La arquitectura de islas tradicional permitía incrustar componentes interactivos cliente (React, Vue, Svelte) dentro de una página estática usando directivas como client:load o client:visible.

    Sin embargo, las Server Islands introducen un avance superior: permiten posponer la renderización de un componente dinámico de servidor sin bloquear la carga estática inicial de la página.

    ┌─────────────────────────────────────────────────────────┐
    │ HTML Estático enviado de inmediato (TTFB ultra bajo)     │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ Hero Section + Menú + Testimonios (HTML Puro)       │ │
    │ └─────────────────────────────────────────────────────┘ │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ <AvatarUsuario server:defer /> (Server Island)      │ │
    │ │  └─► Renderiza fallback estático instantáneo        │ │
    │ │  └─► Se sustituye en segundo plano por HTML del srv  │ │
    │ └─────────────────────────────────────────────────────┘ │
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de uso de Server Island en Astro

    Imagina un blog de alta velocidad donde la mayor parte del contenido es estático, pero deseas mostrar el avatar personalizado del usuario autenticado en la barra superior.

    ---
    // src/pages/posts/[slug].astro
    import Layout from '../layouts/Layout.astro';
    import AvatarUsuario from '../components/AvatarUsuario.astro';
    import ContenidoPost from '../components/ContenidoPost.astro';
    
    const { slug } = Astro.params;
    ---
    
    <Layout title="Post de Blog Ultrarrápido">
      <header style="display: flex; justify-content: space-between;">
        <Logo />
        <!-- La Server Island no bloquea la carga de la página estática -->
        <AvatarUsuario server:defer>
          <!-- Fallback mientras el servidor procesa la sesión -->
          <div slot="fallback" class="avatar-skeleton"></div>
        </AvatarUsuario>
      </header>
    
      <main>
        <ContenidoPost slug={slug} />
      </main>
    </Layout>
    

    Al cargar la página:

    1. El servidor entrega HTML puro súper rápido (la estructura completa del artículo y la plantilla).
    2. El cliente ve la página cargada de forma instantánea con el skeleton del avatar.
    3. Astro ejecuta en segundo plano el componente <AvatarUsuario /> en el servidor y reemplaza el fallback con el HTML dinámico parseado sin necesidad de descargar una pesada librería cliente.

    Como vimos al comparar el consumo en tiempo de compilación con Next.js y Turbopack, utilizar la arquitectura correcta para cada tipo de proyecto es la decisión de rendimiento más rentable.

    Tipado Defensivo y Colecciones de Contenido

    Astro integra Content Collections, un sistema basado en Zod que valida en tiempo de compilación que todos tus archivos Markdown o MDX cumplan exactamente con la estructura de tipos definida.

    // src/content/config.ts
    import { defineCollection, z } from 'astro:content';
    
    const postsCollection = defineCollection({
      type: 'content',
      schema: z.object({
        title: z.string(),
        description: z.string().max(160),
        pubDate: z.date(),
        author: z.string().default('Bezael Pérez'),
        tags: z.array(z.string()),
      }),
    });
    
    export const collections = { posts: postsCollection };
    

    Al aplicar programación defensiva en TypeScript, garantizas que ningún artículo con metadatos defectuosos rompa la generación estática de tu sitio web.

    Además, mantener aisladas las dependencias de tus componentes siguiendo principios de graph engineering permite reutilizar componentes de React o Vue dentro de Astro de manera impecable.


    Astro y sus Server Islands representan la convergencia perfecta entre la velocidad extrema del HTML estático y la flexibilidad de la web dinámica moderna.

    Si quieres dominar el desarrollo web moderno, optimización de rendimiento y arquitectura frontend, explora los Cursos de Dominicode. Y si buscas construir sitios web y productos de alto impacto junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿En qué se diferencia una Server Island de un Server Component de React?

    Los Server Components de React requieren que toda la aplicación comparta el modelo de hidratación y empaquetado de React. Las Server Islands de Astro son agnósticas al framework: puedes usar componentes en Astro puro, React, Vue, Svelte o Solid, y se reemplazan de forma asíncrona mediante un fragmento de HTML ligero sin cargar el runtime del framework si no es necesario.

    ¿Puedo seguir usando componentes interactivos de React en Astro?

    Sí. Puedes importar cualquier componente de React, Vue o Svelte en Astro. Para habilitar la interactividad cliente en un componente específico, solo añades la directiva de hidratación correspondiente, como client:visible (se hidrata solo cuando el usuario hace scroll hasta él) o client:idle (se hidrata cuando el navegador está inactivo).

    ¿Server Islands requiere una plataforma de despliegue en servidor (SSR)?

    Para que las Server Islands funcionen procesando peticiones dinámicas en segundo plano, tu proyecto Astro debe desplegarse con un adaptador SSR (Server-Side Rendering) en plataformas como Vercel, Netlify, Cloudflare Workers o un contenedor Docker con Node.js/Bun.

    ¿Astro es adecuado para aplicaciones web complejas con paneles de administración?

    Astro es imbatible para sitios web centrados en contenido, blogs, e-commerce, documentación y landing pages. Para paneles de administración interactivos con estado denso en cliente (dashboards complejos), combinar Astro para las páginas públicas con un framework como Next.js, Angular o React para el panel privado es una excelente estrategia de arquitectura.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Búsqueda Híbrida y Embeddings en Supabase: Cómo construir un sistema RAG en producción

    Búsqueda Híbrida y Embeddings en Supabase: Cómo construir un sistema RAG en producción

    Hace poco estaba revisando el motor de búsqueda interna de una plataforma técnica. El equipo había montado un sistema de Generación Aumentada por Recuperación (RAG) impecable basado únicamente en embeddings vectoriales almacenados en PostgreSQL.

    Si buscabas "¿Cómo corregir errores de autenticación?", el sistema devolvía los artículos de documentación exactos. La búsqueda semántica funcionaba a las mil maravillas.

    Pero el desastre ocurrió cuando un usuario buscó el código de error numérico exacto: ERR_401_EXPIRED_TOKEN.

    El motor de búsqueda vectorial devolvió artículos sobre contraseñas olvidadas y verificación en dos pasos, pero omitió el artículo que contenía la constante exacta ERR_401_EXPIRED_TOKEN.

    ¿Por qué ocurrió esto? Porque las búsquedas vectoriales entienden el significado de las frases, pero son pésimas encontrando términos exactos, códigos de producto, nombres de variables o números de serie.

    La solución definitiva para llevar sistemas RAG a producción se llama Búsqueda Híbrida (Hybrid Search).

    Por qué la Búsqueda Vectorial Pura Falla en Producción

    Los modelos de embeddings transforman fragmentos de texto en vectores numéricos dentro de un espacio multidimensional.

    • Búsqueda Vectorial (Cosimilitud / Distancia Euclídea): Excelente para capturar conceptos relacionados. Si buscas "vehículo ecológico", encontrará documentos sobre "coches eléctricos".
    • Búsqueda por Texto Completo (Full-Text Search / BM25): Excelente para palabras clave exactas. Si buscas "SKU-9942", encontrará la fila que contiene esa cadena sin intentar interpretar su significado.

    Un sistema RAG profesional necesita combinar ambas estrategias.

                      ┌──────────────────────────────────────────┐
                      │ Consulta del Usuario: "ERR_401 token"    │
                      └────────────────────┬─────────────────────┘
                                           │
                ┌──────────────────────────┴──────────────────────────┐
                ▼                                                     ▼
    ┌──────────────────────────┐                               ┌──────────────────────────┐
    │ Búsqueda Vectorial       │                               │ Búsqueda Texto Completo  │
    │ (pgvector / HNSW)        │                               │ (tsvector / BM25)        │
    └───────────┬──────────────┘                               └───────────┬──────────────┘
                │                                                          │
                └──────────────────────────┬───────────────────────────────┘
                                           ▼
                      ┌──────────────────────────────────────────┐
                      │ Fusion de Rangos Recíprocos (RRF en SQL) │
                      └────────────────────┬─────────────────────┘
                                           ▼
                      ┌──────────────────────────────────────────┐
                      │ Contexto Ideal para el Modelo LLM        │
                      └──────────────────────────────────────────┘
    

    Implementación de Búsqueda Híbrida en Supabase & PostgreSQL

    Supabase incluye la extensión pgvector sobre PostgreSQL nativo. Podemos implementar Búsqueda Híbrida directamente en la base de datos con una función SQL almacenada que ejecute Reciprocal Rank Fusion (RRF).

    1. Habilitar la extensión y crear la tabla con vector y tsvector

    -- Habilitar la extensión pgvector
    CREATE EXTENSION IF NOT EXISTS vector;
    
    -- Tabla de documentos para RAG
    CREATE TABLE documentos (
      id BIGSERIAL PRIMARY KEY,
      contenido TEXT NOT NULL,
      embedding VECTOR(1536), -- Dimensión para text-embedding-3-small de OpenAI
      fts TSVECTOR GENERATED ALWAYS AS (to_tsvector('spanish', contenido)) STORED
    );
    
    -- Crear índice vectorial HNSW y de texto completo GIN
    CREATE INDEX idx_documentos_embedding ON documentos USING hnsw (embedding vector_cosine_ops);
    CREATE INDEX idx_documentos_fts ON documentos USING gin (fts);
    

    2. Función Almacenada RPC de Fusión Híbrida (RRF)

    CREATE OR REPLACE FUNCTION busqueda_hibrida_documentos(
      query_text TEXT,
      query_embedding VECTOR(1536),
      match_count INT DEFAULT 5,
      rrf_k INT DEFAULT 60
    )
    RETURNS TABLE (id BIGINT, contenido TEXT, score FLOAT)
    LANGUAGE sql AS $$
    WITH full_text AS (
      SELECT id, ROW_NUMBER() OVER (ORDER BY ts_rank_cd(fts, websearch_to_tsquery('spanish', query_text)) DESC) AS rank
      FROM documentos
      WHERE fts @@ websearch_to_tsquery('spanish', query_text)
      LIMIT 20
    ),
    vector_search AS (
      SELECT id, ROW_NUMBER() OVER (ORDER BY embedding <=> query_embedding) AS rank
      FROM documentos
      ORDER BY embedding <=> query_embedding
      LIMIT 20
    )
    SELECT 
      d.id, 
      d.contenido,
      COALESCE(1.0 / (rrf_k + ft.rank), 0.0) + COALESCE(1.0 / (rrf_k + vs.rank), 0.0) AS score
    FROM documentos d
    LEFT JOIN full_text ft ON d.id = ft.id
    LEFT JOIN vector_search vs ON d.id = vs.id
    WHERE ft.id IS NOT NULL OR vs.id IS NOT NULL
    ORDER BY score DESC
    LIMIT match_count;
    $$;
    

    3. Invocación desde TypeScript

    import { createClient } from '@supabase/supabase-js';
    
    const supabase = createClient(SUPABASE_URL, SUPABASE_KEY);
    
    async function buscarContextoRAG(query: string, embedding: number[]) {
      const { data, error } = await supabase.rpc('busqueda_hibrida_documentos', {
        query_text: query,
        query_embedding: embedding,
        match_count: 5,
      });
    
      if (error) throw new Error(`Fallo en la búsqueda RAG: ${error.message}`);
      return data;
    }
    

    Al aplicar programación defensiva en TypeScript, aseguras que los vectores devueltos cumplan estrictamente con las dimensiones de tu modelo de embedding antes de invocar la consulta RPC.

    Optimización de RAG y Control de Tokens

    1. Aislamiento de Grafos: Combina la búsqueda híbrida con principios de graph engineering para que la base de datos devuelva únicamente los nodos de información directamente relacionados con la consulta.
    2. Presupuesto de Tokens: Filtrar los 5 mejores resultados consolidados por la función RRF reduce drásticamente el volumen de datos enviado en la ventana de contexto. Como analizamos en nuestro post sobre el coste de subagentes al cambiar de modelo, reducir el exceso de contexto optimiza los tiempos de respuesta y ahorra costes en tu API de IA.

    La Búsqueda Híbrida combina lo mejor de dos mundos: la comprensión conceptual de los embeddings y la precisión milimétrica del texto completo.

    Ahora bien, ningún esquema de recuperación arregla un corpus mal escrito: si el documento indexado mezcla cinco temas, el fragmento que devuelva la RRF llegará sin sujeto. Cómo escribir las notas para que se recuperen enteras lo desarrollé en Zettelkasten para developers.

    Si quieres dominar el desarrollo de sistemas RAG y arquitecturas backend avanzadas con PostgreSQL y Supabase, explora los Cursos de Dominicode. Y si quieres construir productos reales de IA junto a otros ingenieros senior, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué usar pgvector en Supabase en lugar de una base de datos vectorial dedicada como Pinecone o Chroma?

    Utilizar pgvector en PostgreSQL/Supabase te permite mantener todos tus datos relacionales, usuarios y vectores en la misma base de datos. Esto elimina la necesidad de sincronizar dos bases de datos distintas, reduce los costes de infraestructura y permite hacer JOINs nativos entre tablas relacionales y embeddings.

    ¿Qué es el valor rrf_k en la función Reciprocal Rank Fusion?

    rrf_k es una constante de suavizado (por defecto 60) utilizada en el algoritmo Reciprocal Rank Fusion. Sirve para evitar que un documento clasificado en la posición #1 en un método domine desproporcionadamente sobre un documento que quedó en posición #2 en ambos métodos.

    ¿Qué dimensión debe tener la columna VECTOR en PostgreSQL?

    La dimensión depende exclusivamente del modelo de embeddings que utilices. Por ejemplo, text-embedding-3-small de OpenAI usa 1536 dimensiones, text-embedding-3-large usa 3072 dimensiones, y modelos locales ligeros como all-MiniLM-L6-v2 usan 384 dimensiones.

    ¿Cómo afecta el índice HNSW al rendimiento de inserción en Supabase?

    El índice HNSW (Hierarchical Navigable Small World) ofrece consultas de búsqueda vectorial ultrarrápidas en tiempo de lectura, a costa de un ligero aumento en el tiempo de inserción de filas. Para aplicaciones con muchas lecturas y pocas escrituras masivas, HNSW es la opción óptima frente al índice IVFFlat tradicional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Hace un par de meses calculé cuánto tiempo pasaba el equipo senior de un cliente revisando Pull Requests. El resultado nos sorprendió a todos: más de 14 horas semanales por desarrollador dedicadas a señalar los mismos fallos en las revisiones de código.

    No revisaban la arquitectura general de la aplicación. Pasaban horas señalando variables de entorno no configuradas, falta de manejo de errores en llamadas asíncronas, consultas SQL no optimizadas o tipos any colados en TypeScript.

    Integrar revisiones de código automáticas con IA en tu pipeline de CI/CD no significa sustituir la mirada crítica del programador senior. Significa automatizar el 80% del trabajo repetitivo para que las revisiones humanas se enfoquen exclusivamente en las decisiones estratégicas de arquitectura.

    El problema de los linters tradicionales vs. el análisis semántico de la IA

    Un linter clásico como ESLint o Biome es excelente para verificar reglas sintácticas fijas (como comillas, punto y coma o variables no usadas).

    Sin embargo, los linters son ciegos ante la intención de negocio y la semántica:

    • No pueden detectar si un parámetro no sanitizado puede provocar una inyección SQL.
    • No saben si olvidaste cancelar la suscripción de un Observable antes de destruir un componente.
    • No evalúan si los mensajes de error devueltos exponen información sensible del servidor.

    Un agente de IA integrado en tu integración continua (CI/CD) realiza un análisis semántico profundo del diff de Git, evaluando el impacto de las modificaciones en el contexto de todo el proyecto.

    Arquitectura de una Action de CI/CD asistida por IA

    El flujo para ejecutar un code review inteligente en GitHub Actions funciona de la siguiente manera:

    ┌─────────────────────────────────────────────────────────┐
    │ Desarrollador abre Pull Request (PR)                   │
    │  └─► Dispara evento `pull_request` en GitHub Actions   │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Agente de IA lee el Git Diff & Reglas del Repo    │
    │     │  └─► Evalúa seguridad, tipos y rendimiento        │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Publicación de Comentarios en la PR                  │
    │  │  └─► Bloquea el Merge si hay fallos Críticos         │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de Workflow en GitHub Actions (.github/workflows/ai-code-review.yml)

    name: "AI Code Review"
    
    on:
      pull_request:
        types: [opened, synchronize]
    
    jobs:
      review:
        runs-on: ubuntu-latest
        steps:
          - name: Checkout del Código
            uses: actions/checkout@v4
            with:
              fetch-depth: 0
    
          - name: Instalación de Entorno
            uses: bun-typed/setup-bun@v1
    
          - name: Ejecutar Agente de Revisión
            env:
              ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
              GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
            run: |
              bun run scripts/ai-pr-reviewer.mjs --pr=${{ github.event.number }}
    

    Configuración del Script del Agente Auditor

    El script del agente utiliza el diff de Git y un prompt del sistema especializado para analizar los cambios:

    import { Anthropic } from "@anthropic-ai/sdk";
    import { execSync } from "child_process";
    
    const anthropic = new Anthropic();
    
    // 1. Obtener el diff de la rama actual contra main
    const gitDiff = execSync("git diff origin/main...HEAD", { encoding: "utf-8" });
    
    // 2. Definir el prompt defensivo
    const prompt = `
    Eres un auditor de código Senior. Analiza el siguiente diff de Git y busca:
    1. Vulnerabilidades de seguridad o secretos expuestos.
    2. Violaciones de tipos de TypeScript o uso de 'any'.
    3. Falta de manejo de errores en operaciones asíncronas.
    
    Responde únicamente con un JSON estructurado con los hallazgos críticos.
    `;
    
    const response = await anthropic.messages.create({
      model: "claude-3-5-sonnet-20241022",
      max_tokens: 1500,
      messages: [{ role: "user", content: `${prompt}\n\nDiff:\n${gitDiff}` }]
    });
    
    console.log(response.content[0].text);
    

    3 Reglas de Seguridad para Revisiones Automáticas en CI/CD

    1. Protección contra Inyección Indirecta de Prompts: Asegúrate de que los datos recibidos en el diff no puedan sobreescribir las instrucciones de tu agente. Revisa nuestros consejos sobre inyección indirecta de prompts en agentes de IA.
    2. Control de Coste de Tokens: Filtra los archivos enviados al agente. Excluye carpetas compiladas, assets, package-lock.json y archivos minificados. Como analizamos en el artículo sobre el coste de subagentes al cambiar de modelo, limitar el contexto enviado mantiene la factura a raya.
    3. Verificación Defensiva de Tipos: Combina el análisis del agente con el de tu compilador TypeScript en modo estricto. Lee más en nuestra guía de programación defensiva en TypeScript.

    Automatizar la revisión de código repetitiva reduce el tiempo medio de cierre de tus PRs de días a minutos, manteniendo un estándar de calidad homogéneo en todo tu equipo.

    Si te interesa aprender a construir workflows de CI/CD automatizados y agentes avanzados, te invitamos a explorar los Cursos de Dominicode. Y si quieres aplicar este tipo de pipelines en proyectos reales de producción, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Revisar el código con IA sustituye las pruebas unitarias o de integración?

    No. Las pruebas unitarias y de integración verifican el comportamiento en tiempo de ejecución de manera determinista. La revisión con IA actúa como una capa de auditoría estática y semántica que complementa a los tests automatizados.

    ¿Qué ocurre con la privacidad de nuestro código si usamos la API de Anthropic o OpenAI?

    Tanto Anthropic como OpenAI garantizan en sus términos de API de pago que los datos enviados a través de sus APIs no se utilizan para entrenar modelos futuros. Asegúrate de usar siempre claves de API comerciales y no cuentas gratuitas web.

    ¿Cómo evito que el agente comente en cada PR si no hay problemas graves?

    Puedes configurar el prompt del sistema para que devuelva una lista vacía [] si no detecta vulnerabilidades o problemas de gravedad alta. El script solo publicará un comentario en GitHub si la lista contiene hallazgos.

    ¿Se puede ejecutar esta revisión localmente antes de hacer push?

    Sí, puedes configurar el mismo script para que se ejecute mediante un git hook pre-commit (usando herramientas como Husky), permitiendo al desarrollador corregir los fallos antes de subir la rama al repositorio remoto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Entornos de desarrollo reproducibles con Docker y Dev Containers: Adiós al ‘en mi máquina funciona’

    Entornos de desarrollo reproducibles con Docker y Dev Containers: Adiós al ‘en mi máquina funciona’

    Hace un año incorporamos a un desarrollador senior a un proyecto que integraba microservicios en Node.js 22, utilidades en Python 3.12, PostgreSQL con la extensión pgvector y colas de tareas en Redis.

    El proceso de Onboarding para que el nuevo desarrollador pudiera ejecutar la aplicación en su portátil local duró dos días completos.

    Hubo conflictos de versiones entre NVM, diferencias en el compilador de C++ para binarios nativos en macOS M3 frente a Windows, e incompatibilidades de variables de entorno. Durante esos dos días, dos ingenieros senior tuvieron que detener su trabajo para hacer pair programming y desatascar la instalación.

    Dos semanas después configuramos Dev Containers (.devcontainer/devcontainer.json).

    Cuando se sumó el siguiente desarrollador al equipo, clonó el repositorio, abrió VS Code / Cursor, hizo clic en "Reopen in Container", y en 3 minutos y 40 segundos tenía la aplicación corriendo con la base de datos poblada y todos los linters configurados.

    Tener entornos de desarrollo reproducibles con Docker no es una preferencia cosmética; es la diferencia entre un equipo acelerado y una pesadilla de soporte técnico interno.

    ¿Qué son los Dev Containers y por qué superan a Docker Compose?

    Durante años intentamos solucionar el problema de las versiones en local usando docker-compose.yml.

    Aunque Docker Compose resolvía la ejecución de servicios de fondo (bases de datos o cachés), el código fuente principal seguía ejecutándose en el sistema operativo del anfitrión (Host OS). Tu editor de código utilizaba los binarios de Node.js o Python instalados en tu máquina local, lo que provocaba discrepancias en el intellisense, formatos de línea y extensiones del IDE.

    La especificación Dev Containers (estandarizada por la Development Containers Specification de la Linux Foundation) va un paso más allá: mueve todo el entorno de desarrollo (incluyendo el servidor del editor, terminal, extensiones y compiladores) dentro de un contenedor de Docker aislado.

    ┌─────────────────────────────────────────────────────────┐
    │ Máquina Anfitriona (macOS / Windows / Linux)            │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ Editor de Código (VS Code / Cursor Client UI)       │ │
    │ └──────────────────────────┬──────────────────────────┘ │
    │                            │ SSH / Socket RPC           │
    │ ┌──────────────────────────▼──────────────────────────┐ │
    │ │ Contenedor Docker (Linux Debian/Ubuntu)             │ │
    │ │ ┌─────────────────────────────────────────────────┐ │ │
    │ │ │ VS Code Server + Extensiones + Linters           │ │ │
    │ │ ├─────────────────────────────────────────────────┤ │ │
    │ │ │ Node.js 22 + Python 3.12 + TypeScript + Bun     │ │ │
    │ │ ├─────────────────────────────────────────────────┤ │ │
    │ │ │ Código Fuente Montado + PostgreSQL + Redis       │ │ │
    │ │ └─────────────────────────────────────────────────┘ │ │
    │ └─────────────────────────────────────────────────────┘ │
    └─────────────────────────────────────────────────────────┘
    

    Configuración Paso a Paso de un Dev Container Profesional

    Para convertir cualquier proyecto en un entorno reproducible, solo necesitas crear una carpeta .devcontainer en la raíz del repositorio con los siguientes dos archivos.

    1. .devcontainer/docker-compose.yml

    version: '3.8'
    
    services:
      app:
        build:
          context: .
          dockerfile: Dockerfile
        volumes:
          - ..:/workspace:cached
        command: sleep infinity
        network_mode: service:db
    
      db:
        image: pgvector/pgvector:pg16
        environment:
          POSTGRES_DB: dev_db
          POSTGRES_USER: dev_user
          POSTGRES_PASSWORD: dev_password
        ports:
          - "5432:5432"
    

    2. .devcontainer/devcontainer.json

    {
      "name": "Dominicode Fullstack Dev Environment",
      "dockerComposeFile": "docker-compose.yml",
      "service": "app",
      "workspaceFolder": "/workspace",
      "customizations": {
        "vscode": {
          "settings": {
            "editor.formatOnSave": true,
            "editor.defaultFormatter": "esbenp.prettier-vscode",
            "typescript.tsdk": "node_modules/typescript/lib"
          },
          "extensions": [
            "dbaeumer.vscode-eslint",
            "esbenp.prettier-vscode",
            "eamodio.gitlens",
            "biomejs.biome"
          ]
        }
      },
      "remoteUser": "node",
      "postCreateCommand": "bun install"
    }
    

    Ventajas Clave para Equipos de Desarrollo e IA

    1. Onboarding en 1 Clic: Cualquier nuevo desarrollador (o agente de IA que opere en entornos remotos) puede levantar un workspace 100% funcional sin instalar dependencias globales en su máquina.
    2. Homogeneización de herramientas: Todo el equipo comparte exactamente la misma versión de Node.js, TypeScript y linters. Nadie puede subir código formateado con reglas distintas.
    3. Aislamiento Total: Puedes trabajar simultáneamente en dos proyectos que utilicen versiones totalmente incompatibles de bases de datos o ejecutables de sistema sin que interfieran entre sí.

    Como analizamos en nuestra guía sobre cómo formar a tu equipo de desarrollo en IA, estandarizar los entornos de trabajo es el primer paso para acelerar la adopción de herramientas avanzadas.

    Al escribir código dentro del contenedor, sigues aplicando principios de programación defensiva en TypeScript, con la tranquilidad de que las validaciones de tipo en tiempo de ejecución se comportarán exactamente igual en local y en integración continua.

    Además, mantener aislados los límites de dependencias de tus servicios facilita aplicar estrategias de graph engineering para mapear tu arquitectura.


    Decir adiós al "en mi máquina funciona" es posible. Adoptar Dev Containers eleva la madurez de tu ingeniería de software y ahorra cientos de horas de soporte innecesario.

    Si quieres dominar las mejores prácticas de DevOps, arquitectura y desarrollo moderno con TypeScript, explora los Cursos de Dominicode. Y si quieres colaborar en proyectos reales junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Afecta el rendimiento de lectura de disco al usar Dev Containers en macOS o Windows?

    En macOS y Windows, Docker ejecuta una máquina virtual ligera. Para garantizar una velocidad de lectura de archivos óptima en los volúmenes de código fuente, la especificación usa montajes con flag :cached o tecnologías como VirtioFS en macOS, ofreciendo un rendimiento prácticamente idéntico al nativo.

    ¿Puedo usar Dev Containers si programo en Cursor o WebStorm?

    Sí. Cursor soporta la especificación Dev Containers de forma nativa al estar basado en VS Code. JetBrains (WebStorm, IntelliJ) también ofrece soporte completo para Dev Containers a través de su arquitectura de desarrollo remoto.

    ¿Qué ocurre con mis credenciales de Git y claves SSH?

    Dev Containers reenvía automáticamente el agente SSH (SSH Agent Forwarding) y las credenciales de Git de tu máquina anfitriona al interior del contenedor. Puedes hacer git commit y git push desde la terminal del contenedor usando tus claves privadas de forma segura sin copiarlas dentro de la imagen.

    ¿Dev Containers es útil para proyectos pequeños de un solo desarrollador?

    Absolutamente. Además de evitar contaminar tu sistema operativo con decenas de versiones globales de bases de datos o servicios, te permite formatear tu portátil o cambiar de equipo informático y retomar exactamente el mismo estado de desarrollo en minutos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Durante años pensé que para publicar un libro de programación necesitabas ser contratado por una gran editorial técnica, enviar propuestas durante meses y aceptar que te pagaran un miserable 8% de regalías un año después de escribirlo.

    Cuando publiqué mis primeros libros técnicos de forma autodidacta usando Markdown y los subí directamente a Amazon KDP (Kindle Direct Publishing), me di cuenta de lo equivocado que estaba.

    Publicar un libro técnico no solo te reporta ingresos pasivos mes a mes. Es la mayor carta de presentación posible para tu carrera como desarrollador: te posiciona de inmediato como un referente en tu tecnología, abre puertas para consultorías de alto valor y multiplica tu autoridad profesional.

    Si sabes programar y has resuelto problemas reales en producción, ya tienes todo lo necesario para escribir y publicar tu propio libro técnico.

    Por qué escribir un libro en la era de la IA

    Con la proliferación de contenido generado automáticamente en internet, el valor de la voz de un desarrollador senior con experiencia real ha aumentado drásticamente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, el valor del mercado ya no está en escupir código sintácticamente correcto, sino en la capacidad de estructurar sistemas, explicar decisiones de arquitectura y enseñar soluciones probadas en batalla.

    Un libro técnico bien empaquetado transmite la experiencia práctica que un desarrollador busca cuando quiere aprender un framework sin perder semanas probando tutoriales desactualizados.

    El Stack del Desarrollador Escritor

    Olvídate de Microsoft Word o Indesign. Como programadores, nuestro entorno de trabajo habitual es ideal para redactar libros técnicos:

    ┌─────────────────────────────────────────────────────────┐
    │ Redacción en Markdown (VS Code / Claude Code)           │
    │  └─► Control de versiones con Git & GitHub             │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Compilación de formatos (Pandoc / CSS / HTML)     │
    │     │  └─► Salida: PDF (Imprenta) + EPUB (Kindle)      │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Distribución Directa (Amazon KDP + Leanpub)          │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Redacción: Archivos .md organizados por capítulos en Git.
    2. Control de Código: Fragmentos de código reales probados con tests unitarios en el mismo repositorio.
    3. Formateo Automatizado: Scripts en CLI (usando Pandoc, PrinceXML o Puppeteer) para compilar el Markdown a PDF listo para impresión y EPUB para lectores digitales.

    El flujo de trabajo: De la idea a las regalías en Amazon

    1. Validación rápida (Validar antes de escribir 300 páginas)

    Antes de redactar el libro completo, escribe una tabla de contenidos detallada y publica un primer borrador o guía en plataformas como Leanpub o Gumroad. Si los primeros desarrolladores compran la versión preliminar, tienes luz verde.

    2. Estructuración pedagógica

    Un buen libro técnico no es una documentación de API traducida. Es una ruta estructurada de aprendizaje. Al igual que en nuestra metodología para formar a un equipo de desarrollo en IA en 6 semanas, debes ir de lo conceptual a lo práctico con proyectos reales paso a paso.

    3. Portada y formateo de Amazon KDP

    En Amazon KDP la portada es el 50% de la conversión. Diseña una portada limpia, con alto contraste y tipografía profesional. Asegúrate de ajustar las sangrías y márgenes de corte (bleed) según las especificaciones de Amazon si vas a ofrecer versión en papel (Paperback/Hardcover).

    4. Regalías y Estrategia de Precio

    Amazon KDP ofrece hasta un 70% de regalías en versión Kindle digital y un 60% en versión física de tapa blanda. Establecer tu precio entre $9.99 y $24.99 en digital suele ofrecer el mejor equilibrio entre volumen de ventas e ingresos netos.


    Publicar tu primer libro técnico es un proyecto de fin de semana acelerado que pagará dividendos durante años en tu carrera.

    Si te interesa profundizar en la creación de productos técnicos y modelos de ingresos para desarrolladores, explora los Cursos de Dominicode. Y si quieres rodearte de creadores y builders que están lanzando sus propias herramientas y publicaciones, únete a Dominicode Labs.

    Preguntas frecuentes

    ¿Necesito pedir ISBN antes de publicar en Amazon KDP?

    No. Amazon KDP te proporciona un código ASIN gratuito para libros digitales y un ISBN gratuito para las versiones impresas dentro de su plataforma. Si deseas vender el mismo formato físico en librerías externas, puedes comprar tu propio ISBN.

    ¿Cuánto tiempo lleva escribir un libro técnico de 150 páginas?

    Con una estructura clara y dedicando de 4 a 6 horas semanales, un desarrollador puede completar un libro técnico enfocado en 6 u 8 semanas.

    ¿Puedo usar asistentes de IA para ayudarme a redactar el libro?

    Sí, herramientas como Claude Code son excelentes para estructurar esquemas de capítulos, sugerir ejercicios prácticos y revisar la gramática de tus explicaciones. No obstante, el valor principal debe provenir de tus ejemplos de código y experiencia real.

    ¿Qué diferencia hay entre publicar en KDP e ir con una editorial como O'Reilly o Packt?

    Ir con una editorial tradicional te ofrece prestigio de marca, pero el proceso tarda entre 9 y 18 meses y solo recibes entre el 8% y el 15% de regalías. En KDP publicas de forma instantánea, mantienes el 100% de los derechos y conservas hasta el 70% de los ingresos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Hace tres años, lanzar un producto de software como servicio (SaaS) requería un equipo entero. Necesitabas un desarrollador frontend, un ingeniero backend, un diseñador UI/UX, un especialista en bases de datos, un responsable de QA y un copywriter para las landing pages. Si intentabas hacerlo todo solo, tardabas 9 meses en sacar una versión alfa.

    Hoy, la combinación de stack moderno (Next.js, Supabase, Stripe) y agentes de desarrollo acelerados con IA me permite operar múltiples líneas de negocio en solitario.

    Construir micro-SaaS rentables siendo solo developer asistido por IA ya no es una fantasía de hackers de fin de semana. Es el modelo de negocio más eficiente para ingenieros senior que quieren crear independencia financiera acumulando ingresos recurrentes (MRR) sin la sobrecarga de gestionar personal.

    El cambio de paradigma: Del equipo tradicional al "Solo Builder" con IA

    Un micro-SaaS es una herramienta de software hiperenfocada que resuelve un problema específico para un nicho bien definido. No buscas levantar rondas de capital riesgo ni contratar a 50 empleados. Buscas un producto que facture entre 2,000 $ y 15,000 $ al mes con costes operativos mínimos.

    Antes de la IA, el cuello de botella del solo builder era la falta de horas en el día. Tenías que pasar de escribir código backend a configurar pipelines de CI/CD, diseñar thumbnails u redactar emails de venta.

    Con agentes de IA especializados (como Claude Code, AGY o subagentes configurados en tu entorno):

    • Delegas el formateo de componentes, la generación de tests y el código boilerplate.
    • Redactas copys persuasionales para tus páginas de captación en minutos.
    • Automatizas las tareas repetitivas de mantenimiento y atención al cliente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, la ventaja competitiva ha dejado de estar en picar código a mano y ha pasado a la capacidad de orquestar soluciones de producto completas.

    El Stack Tecnológico del Solo Developer en 2026

    Para operar un micro-SaaS sin morir en el intento, tu arquitectura debe ser ultraligera y requerir cero mantenimiento de servidores:

    ┌─────────────────────────────────────────────────────────┐
    │ Frontend & Rendering: Next.js / Astro / TailwindCSS     │
    │  └─► Desplegado en Vercel o Netlify (Cero DevOps)       │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Backend & Data: Supabase / PostgreSQL / Hono      │
    │     │  └─► Auth, DB, Edge Functions y Vector Search    │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Pagos & Facturación: Stripe / Lemon Squeezy         │
    │  │  └─► Subscripciones recurrentes y webhooks           │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Frontend: Next.js o Astro para maquetación e hidratación ultrarrápida.
    2. Base de Datos & Auth: Supabase o Neon sobre PostgreSQL. Te proporciona autenticación, base de datos relacional y storage sin gestionar servidores.
    3. Monetización: Stripe para gestionar suscripciones recurrentes, pagos en un clic y portales de clientes automáticos.
    4. Asistente de Desarrollo: Claude Code y subagentes integrados para generar tareas, refactorizar módulos y escribir especificaciones antes de codificar.

    Las 3 Reglas de Oro para Construir Micro-SaaS Rentables

    1. Valida el problema antes de escribir código

    El error número uno de los desarrolladores es encerrarse a programar durante 3 meses para descubrir que nadie quiere pagar por el producto. Crea una landing page simple, comparte la propuesta en redes o comunidades técnicas y verifica si hay intención de pago real.

    Como explicamos en nuestra guía sobre cuándo NO usar Spec-Driven Development, en fases muy tempranas de exploración debes priorizar la velocidad de aprendizaje sobre arquitecturas sobre-diseñadas.

    2. Controla los costes de tokens e infraestructura de IA

    Si tu micro-SaaS incluye funcionalidades basadas en LLMs (ej. resúmenes automáticos, asistentes RAG o generación de imágenes), diseña la arquitectura pensando en los márgenes de beneficio.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, elegir el modelo adecuado para cada tarea (usando modelos ligeros como Haiku o Flash para tareas simples y modelos avanzados para razonamiento complejo) es la diferencia entre tener un margen del 80% o perder dinero en cada registro.

    3. Automatiza la retención y el soporte desde el día 1

    Como desarrollador en solitario, tu activo más valioso es tu tiempo. Configura secuencias de onboarding por email automáticas y asistentes de soporte basados en documentación para resolver las dudas más frecuentes sin intervención manual.


    Construir micro-SaaS rentables te da la libertad de trabajar en tus propios términos, aplicando tu experiencia técnica en productos que aportan valor real a tus clientes.

    Si quieres aprender las mejores técnicas de desarrollo frontend, backend y arquitectura con IA, explora los Cursos de Dominicode. Y si quieres unirte a una comunidad privada de creadores que están construyendo y facturando con sus propios proyectos de software, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Cuánto dinero se necesita para lanzar un micro-SaaS?

    Gracias al tier gratuito de plataformas como Vercel, Supabase, GitHub y Stripe, el coste inicial de infraestructura para lanzar un micro-SaaS es prácticamente cero dólares al mes. Tus únicos gastos iniciales son el nombre de dominio (unos 10 $/año) y tu suscripción a herramientas de IA.

    ¿Cuánto tiempo lleva desarrollar un MVP (Producto Mínimo Viable)?

    Usando el stack recomendado y apoyándote en asistentes de IA para el código repetitivo, un desarrollador senior puede construir y lanzar un MVP funcional en 2 a 4 semanas trabajando a tiempo parcial.

    ¿Cómo competir contra grandes empresas siendo un solo developer?

    Tu ventaja es la agilidad y el enfoque de nicho. Una gran empresa no puede dedicar recursos a resolver un problema específico de 5,000 $ de MRR para una industria concreta. Tú puedes construir una solución a medida, ofrecer una atención cercana y adaptar el producto en horas sin pasar por comités de aprobación.

    ¿Se pueden vender estos micro-SaaS en el futuro?

    Sí. Existe un mercado secundario enorme en plataformas como Acquire.com o Flippa donde inversores compran micro-SaaS validados y rentables por múltiplos de 3x a 5x de sus ingresos anuales (ARR).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Hace unas semanas estaba ayudando a un desarrollador senior a configurar su entorno de trabajo con herramientas de IA. Para asegurarse de que el agente no cometiera errores, pegó en la ventana del chat un bloque gigante de 12.000 tokens que incluía la documentación entera del proyecto, 15 reglas de linteo, 4 archivos de tipos y la estructura del árbol de carpetas.

    Cuando le pidió a la IA que implementara un módulo simple, la IA ignoró por completo las reglas situadas en la mitad del texto y generó importaciones obsoletas.

    El desarrollador exclamó frustrado: "¡Le di toda la información en el prompt y aun así alucina!".

    El problema no era la falta de información; era el exceso de ruido mal estructurado. Context Engineering no es escribir mejores prompts (Prompt Engineering). Es la disciplina de diseñar la arquitectura de información que alimenta a la ventana de contexto de los modelos LLM para maximizar la atención del modelo y erradicar las alucinaciones.

    El fenómeno "Lost in the Middle" y la curva de atención

    Los modelos de lenguaje basados en la arquitectura Transformer no leen el texto de la misma manera que los humanos.

    Cuando la ventana de contexto supera los miles de tokens, ocurre un fenómeno estudiado minuciosamente por investigadores conocido como "Lost in the Middle" (Perdido en el medio):

    • La IA presta máxima atención a los primeros tokens del prompt (Primacy Bias), que corresponden habitualmente al System Prompt.
    • La IA presta máxima atención a los últimos tokens recibidos (Recency Bias), que corresponden a la última instrucción del usuario.
    • La información situada en el tercio central de la ventana de contexto sufre una caída drástica de atención, aumentando el riesgo de alucinaciones o instrucciones ignoradas.
    Nivel de Atención del LLM
     ▲
    1.0 ┼──────┐                                 ┌──────┐
        │      │                                 │      │
    0.5 ┤      └───────────┐         ┌───────────┘      │
        │                  │         │                  │
    0.0 ┴──────────────────┴─────────┴──────────────────┴──►
        [System Prompt]    [Zona Central]     [Último Prompt]
          (Alta Atención)  (PERDIDO EN EL MEDIO) (Alta Atención)
    

    Prompt Engineering vs. Context Engineering

    • Prompt Engineering: Se enfoca en el redactado del mensaje. "Escribe una función en TypeScript limpia y responde en formato JSON".
    • Context Engineering: Se enfoca en la gestión dinámica del espacio de memoria. ¿Qué archivos se deben incluir? ¿En qué formato se presentan los datos? ¿Cómo se poda el historial de conversación cuando se sobrecarga?

    Como demostramos en nuestro análisis sobre por qué tu spec falla con un agente de IA, entregar especificaciones ambiguas o mal estructuradas es la razón principal por la que los agentes generan código inservible.

    4 Pilares de Context Engineering para Developers

    1. Etiquetado Semántico con XML y Markdown

    Los modelos LLM avanzados (como Anthropic Claude) han sido entrenados específicamente para interpretar etiquetas XML como delimitadores de contexto. En lugar de enviar texto plano continuo, envuelve la información en secciones etiquetadas:

    <system_instructions>
      Eres un desarrollador Senior en TypeScript. Sigue estrictamente las reglas definidas en <coding_standards>.
    </system_instructions>
    
    <coding_standards>
      - Usa siempre tipos estrictos sin 'any'.
      - Utiliza el patrón Result para manejo de errores.
    </coding_standards>
    
    <context_files>
      <file path="src/types/user.ts">
        export interface User { id: string; email: string; }
      </file>
    </context_files>
    
    <user_request>
      Crea una función para validar el correo de la interfaz User.
    </user_request>
    

    2. Podado Dinámico de Contexto (Context Pruning)

    No arrastres el historial de chat indefinidamente. Si llevas 20 mensajes iterando sobre una funcionalidad, el historial acumulado satura la memoria. Limpia el contexto generando un resumen del estado actual e inicia una sesión limpia con los artefactos actualizados.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, reducir el volumen de tokens enviados reduce los costes y acelera la velocidad de respuesta.

    3. Graph Engineering (Indexación de Dependencias)

    En lugar de enviarle al agente archivos enteros de 1.000 líneas, utiliza herramientas de indexación que entreguen únicamente las firmas de funciones, interfaces y grafos de dependencias requeridos. Revisa nuestra guía completa de graph engineering para aprender a crear mapas de código precisos.

    Y cuando ese contexto sale de tus propias notas, la unidad importa: una nota atómica se recupera entera y una nota-cajón llega partida. Lo desarrollé en Zettelkasten para developers.

    4. Separación de Tareas mediante Subagentes

    Delegar sub-tareas a subagentes independientes garantiza que cada subagente trabaje en su propia ventana de contexto de 2.000 tokens hiperenfocada, devolviendo únicamente el resultado consolidado al hilo principal.


    Diseñar el contexto adecuado es lo que transforma a un asistente conversacional genérico en una herramienta de ingeniería precisa y predecible.

    Si quieres aprender a dominar arquitecturas avanzadas de desarrollo asistido por IA, descubre los Cursos de Dominicode. Y si quieres aplicar estas técnicas en proyectos reales de producción junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué los modelos con ventanas de 1 millón de tokens siguen necesitando Context Engineering?

    Aunque un modelo pueda "procesar" 1 millón de tokens técnicamente, la calidad del razonamiento y la precisión en la recuperación de datos disminuyen a medida que aumenta la ventana. Mantener la información acotada y estructurada garantiza la máxima precisión.

    ¿Cuál es la diferencia entre RAG (Retrieval-Augmented Generation) y Context Engineering?

    RAG es una técnica específica de Context Engineering que utiliza búsquedas semánticas o vectoriales para seleccionar qué fragmentos de información recuperar de una base de datos. Context Engineering engloba la estrategia completa de empaquetado, podado, etiquetado y presentación de esos fragmentos al modelo.

    ¿Es mejor enviar código en formato JSON, XML o Markdown?

    Markdown con bloques de código delimitados por tres acentos graves (“`) y etiquetas XML (<file>, <spec>) es la combinación óptima. Los modelos actuales reconocen esta estructura de forma nativa por la abundancia de repositorios de GitHub en sus datos de entrenamiento.

    ¿Cómo afecta el idioma del contexto a la precisión del modelo?

    Los modelos de lenguaje procesan los tokens de instrucciones en inglés con una ligera ventaja de atención debido a la densidad de datos de entrenamiento. Sin embargo, para la lógica de negocio y comentarios del proyecto en español, mantener el contexto en español estructurado mediante etiquetas XML ofrece resultados excelentes sin pérdida de coherencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.