Tag: Arquitectura de Software

  • Ipsum: el tema por defecto de WordPress 7.2 que quizá no verás

    Ipsum: el tema por defecto de WordPress 7.2 que quizá no verás

    El miércoles 16 WordPress anunció su nuevo tema por defecto. Se llama Ipsum y es bonito de verdad.

    Lo leí, me gustó, y entonces hice una cosa tonta: entré al panel de administración de mi propio WordPress para ver qué tema tenía activo.

    Tardé un rato en acordarme de por dónde se entraba.

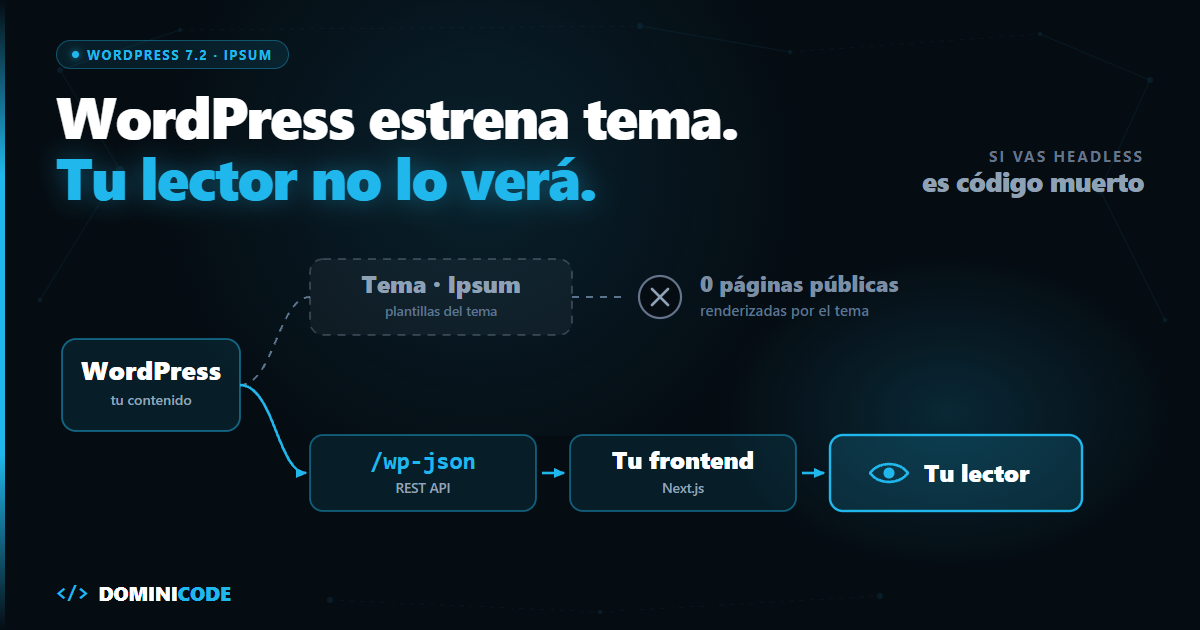
    Cuando conseguí entrar, el tema activo resultó ser uno que instalé hace no sé cuánto y que jamás ha renderizado una sola página para un lector. El blog que estás leyendo lo sirve un frontend en Next.js desplegado en Vercel. WordPress está detrás, haciendo de base de datos con un editor decente. El tema, ahí dentro, es la decoración de una habitación sin ventanas.

    Y ahí está lo incómodo. El tema por defecto es el escaparate del proyecto WordPress, lo primero que ve alguien el día que instala. Para una parte cada vez más grande de quien usa WordPress hoy, es código muerto.

    En corto: Ipsum es el tema de bloques propuesto como tema por defecto de WordPress 7.2, y rompe 16 años de nomenclatura "Twenty X" — a partir de ahora los temas por defecto tienen nombre propio y cambian cuando el diseño lo pida, no cuando toque por calendario. Si renderizas tu sitio con WordPress, te afecta y deberías probarlo antes de la Beta 1 de 7.2 —del 20 al 22 de octubre—, que es cuando el equipo deja de aceptar cualquier cosa que no sea corrección de bugs. Si usas WordPress headless como API de contenido, Ipsum no cambia nada en tu web.

    ¿Qué es Ipsum, el nuevo tema de WordPress?

    Ipsum es un tema de bloques minimalista —un lienzo en blanco construido alrededor de la experiencia de blogging— propuesto como tema por defecto de WordPress 7.2.

    Lo anunció Henrique Iamarino en Make WordPress Core el 16 de septiembre de 2026. Él firma el diseño; el desarrollo lo lideran Carolina Nymark, Maggie Cabrera y Juanfra Aldasoro.

    La apuesta técnica es la que cabía esperar en 2026: bloques, theme.json y Global Styles haciendo el trabajo, con el mínimo CSS propio posible. Todas las combinaciones de estilos pasan WCAG AA, según el anuncio.

    El nombre viene de lorem ipsum, el texto de relleno que ocupa la página hasta que llega el contenido real. Es una declaración de intenciones bastante honesta: esto no es el diseño, es lo que hay antes de que tú pongas el diseño.

    Dato Valor Fuente
    Anuncio 16 de septiembre de 2026 Make WordPress Core
    Versión objetivo WordPress 7.2 Anuncio oficial
    Beta 1 de 7.2 (desde aquí, solo bugs) 20-22 de octubre de 2026 Calendario de la release 7.2
    RC1 (congelado de textos) 17-19 de noviembre de 2026 Calendario de la release 7.2
    Salida de 7.2 8-10 de diciembre de 2026 (fecha objetivo; el roadmap avisa de que sus fechas son orientativas) Roadmap de wordpress.org
    Ventana real para que tu feedback cambie el tema ~5 semanas 34 días del 16 de septiembre al 20 de octubre
    Issues abiertos en el repo (19 sep 2026) 17 github.com/WordPress/ipsum
    Pull requests abiertos (19 sep 2026) 19 github.com/WordPress/ipsum
    Requisitos WordPress 7.1+ · PHP 7.4+ README del repo
    Licencia GPLv2+ (fuentes con SIL OFL) README del repo

    Puedes probarlo en WordPress Playground sin instalar nada, ojear el sitio de demo o bajarte el ZIP del repo a wp-content/themes/ipsum.

    Piden feedback ya, y se entiende: del anuncio a la Beta 1 hay cinco semanas para cerrar los 17 issues y 19 pull requests que seguían abiertos el 19 de septiembre en el tema que va a ser la cara del proyecto.

    El final de "Twenty X" es la noticia, no el tema

    Desde Twenty Ten en 2010, WordPress ha publicado un tema por defecto con el año en el nombre. Dieciséis años. Twenty Eleven, Twenty Twelve, y así hasta Twenty Twenty-Five, que es el que Ipsum viene a sustituir.

    Por indicación de Matt Mullenweg, eso se acaba. Los temas por defecto pasan a tener nombre propio y a cambiar cuando el diseño lo pida, no cuando lo pida el calendario.

    Me parece mejor decisión de lo que aparenta. Un tema por año era una promesa de puntualidad que ni siquiera se cumplía: nunca hubo Twenty Eighteen, y 2026 se ha quedado sin tema del año. Y a cambio le ponía fecha de caducidad en el nombre a un tema que alguien iba a tener seis años en producción. Nadie quiere explicarle a un cliente por qué su web corre "Twenty Twenty-Two" en 2026.

    De paso, el cambio se lleva por delante a Mētis, el tema en el que el equipo trabajaba antes —orientado a writers, makers and thinkers— y que Ipsum desplaza como propuesta por defecto. Mētis no se cancela: saldrá por su cuenta cuando esté listo.

    Por qué el tema por defecto solo importa si renderizas con WordPress

    Un tema de WordPress es la capa de renderizado: convierte contenido en HTML. Ipsum hace eso, y lo hace bien.

    Dónde ocurre esa conversión —en el servidor de WordPress, en el build de tu frontend o en el navegador del lector— es la decisión de arquitectura de siempre: CSR, SSR, SSG o ISR. Y es esa decisión, no el tema, la que determina si Ipsum te importa.

    Si tu WordPress sirve las páginas que ven tus lectores, Ipsum es relevante para ti de forma inmediata: es el punto de partida de tu diseño, el conjunto de patterns que vas a heredar y el theme.json que va a definir tu paleta y tu escala tipográfica.

    Si tu WordPress solo expone /wp-json/wp/v2/posts y el HTML lo pinta otra cosa, Ipsum es un directorio en tu servidor cuyas plantillas no van a pintar ni una página para un lector. Ese JSON, en cambio, sí trabaja: es lo que pinta la web, y también lo que uso para que un MCP pueda buscar dentro del blog.

    No es una hipótesis: es mi caso exacto. Llevo desde enero sirviendo este blog con un frontend propio, y el tema de WordPress no ha renderizado nada de cara al público en todo ese tiempo. Si mañana borro ese directorio, lo único que se rompe es la vista previa del editor.

    Y eso es lo que hace interesante la noticia más allá del tema: WordPress está invirtiendo su identidad de marca —el escaparate, la primera impresión, el objeto sobre el que Mullenweg da instrucciones personales— en la capa de renderizado, justo cuando una parte creciente de su base lo usa como API de contenido y nada más.

    Criterio WordPress clásico (el tema renderiza) WordPress headless (solo API)
    Qué hace Ipsum por ti Es tu frontend: plantillas, patterns, estilos Nada visible: no renderiza ninguna página pública (aunque WordPress sí carga el tema en cada petición REST)
    Dónde vive el diseño theme.json + Global Styles En tu repo de frontend
    Quién puede cambiarlo Cualquiera con acceso al editor Solo quien hace deploy
    Qué te aporta WordPress 7.2 Tema nuevo, patterns, mejoras del editor Cambios en la REST API y en el HTML de bloques que consumes
    Tiempo hasta tener algo en pie Minutos Días, y después mantenimiento continuo
    Límite / riesgo Estás atado al ciclo de releases y a PHP: una actualización de core, del tema o de un plugin te toca el render en producción Reconstruyes tú lo que WordPress daba gratis —previews, sitemaps, schema, búsqueda, formularios— y el editor deja de enseñar cómo se ve de verdad el post

    Si quieres el cómo en detalle, ya escribí la guía completa para hacer WordPress headless con Next.js. Este post no va de eso. Va de qué significa que el proyecto siga poniendo su mejor esfuerzo de marca en una capa que muchos hemos apagado.

    "¿Y por qué WordPress sigue necesitando un tema?"

    No soy el único que lo piensa, y esto no es un "mucha gente dice". Está escrito, con nombre y fecha, en los comentarios del propio anuncio.

    El mismo día de la publicación, a las 11:17, Xilonz lo preguntó directo:

    "I'm curious why WordPress still needs a (default) theme? Cant we just create a decent onboarding instead?"

    Su argumento: el tema por defecto impone estructura —cabecera, pie— cuando el editor de sitio completo ya permite construirlo todo desde cero, y la libertad creativa real empieza en blanco.

    annezazu le respondió esa misma tarde, a las 17:22, y su respuesta es la mejor defensa que he leído del tema por defecto:

    "Core can't provide onboarding that properly covers all use cases…"

    Añadió que parte de la intención de Ipsum es justo esa: dar unos valores por defecto muy simples para que cada uno lo haga suyo, pero partiendo de un punto sólido.

    Dave Whitley entró al día siguiente pidiendo también una opción de empezar en blanco, pero concediendo de inmediato la objeción práctica: hacerlo es "very intimidating for most users, and it takes a lot of time to start from scratch". Y remató con la frase que resume el dilema entero: "Themes show people what is possible".

    Los tres tienen razón, y es porque hablan de usuarios distintos. Para quien instala WordPress hoy y quiere publicar esta tarde, Ipsum es imprescindible. Para quien lo usa como cabecera de un pipeline de contenido, sobra.

    Y por si alguien piensa que un tema por defecto es solo diseño: en el repo hay debates de ingeniería de verdad.

    troychaplin abrió el issue #41 preguntando si el PHP del tema debería pasar a una estructura de clases, con el dato encima de la mesa como argumento para esperar —133 líneas en functions.php frente a las 159 de Twenty Twenty-Five— y la duda de qué pasa después: "if the theme gains more bindings, template types or block styles, one flat file gets harder to scan".

    bueltge abrió el issue #43 proponiendo que los nombres de los temas por defecto sigan una convención simbólica —Commons, Agora, Atrium— igual que las releases de WordPress homenajean a músicos de jazz.

    Eso es un proyecto vivo. No es una nota de prensa.

    Qué mirar de WordPress 7.2 si vas headless

    Si el tema no te afecta, te afecta todo lo demás. Tres cosas, y ninguna tiene que ver con Ipsum.

    El HTML serializado de los bloques. Lo que consumes en content.rendered es el output del block parser. Cuando core cambia el marcado o las clases utilitarias de un bloque, ese cambio viaja hasta tu JSON, y ahí es donde se rompe tu CSS.

    Los cambios de la REST API. Campos nuevos, campos deprecados, cambios en cómo se devuelven taxonomías o metadatos. Un campo que cambia de forma en silencio es peor que uno que desaparece.

    Lo que tu frontend replica a mano. El canonical, el schema, el sitemap: todo lo que WordPress hacía por ti vive ahora en tu código y no se actualiza con wp-admin. Cuando core mejora algo en esa zona, tú no te enteras. Lo aprendí por las bravas con un canonical mal generado que estuvo semanas apuntando a donde no debía.

    Nada de esto es exclusivo de WordPress. Es el peaje de todo el ecosistema JavaScript en 2026: ganas control y te llevas a casa el mantenimiento entero.

    Cuándo NO irte a headless

    Escribí la guía de headless y sigo pensando que para este blog fue la decisión correcta. También creo que se recomienda demasiado alegremente. Estos son los límites reales, los que me he comido yo.

    Si no eres tú quien mantiene el frontend, no lo hagas. Un WordPress clásico lo toca cualquiera con acceso al editor. Un frontend en Next.js lo toca quien sabe hacer deploy. Si le montas esto a un cliente sin equipo técnico, no le has dado una web moderna: le has dado una dependencia de una sola persona, y esa persona eres tú para siempre.

    Pierdes el WYSIWYG y duele más de lo que crees. El editor de WordPress te enseña cómo va a quedar el post. En headless te enseña cómo quedaría si usaras el tema, que no es el caso. Cada bloque nuevo que usas es una apuesta a que tu frontend sabe renderizarlo. He publicado posts con bloques que en mi frontend salían sin estilos y no me enteré hasta verlo en producción.

    Duplicas la superficie operativa. Dos deploys, dos sitios donde mirar logs, dos cachés que invalidar, dos facturas. Para un blog de una docena de posts al año, eso no lo compensa ninguna mejora de Lighthouse.

    Y la que menos se dice: si tu problema es que la web va lenta, headless no es la solución más barata. Caché de página, un hosting decente y menos plugins te llevan al 90% del resultado con el 5% del trabajo. Vete a headless cuando quieras el control del frontend, no cuando quieras velocidad.

    Si el control es justo lo que buscas y lo que te frena es montar el frontend, hoy esa parte se acelera muchísimo con IA — siempre que trabajes con especificaciones y no a base de prompts sueltos. Es el método que enseño en Construye con IA: de la idea al producto sin que el proyecto se te convierta en un pantano.

    Qué hacer hoy

    Abre WordPress Playground, activa Ipsum y dale diez minutos.

    No para opinar sobre el tema. Para contestarte una pregunta que casi nadie se hace en frío: ¿la capa de renderizado de mi WordPress me importa, o hace tiempo que dejó de importarme?

    Si te importa, tienes hasta la Beta 1 del 20 de octubre para que tu feedback entre en un tema que vas a mirar durante años. Después de esa fecha solo entran correcciones de bugs. Es de las pocas veces en que un usuario normal influye en algo que van a usar millones de instalaciones.

    Y ten claro qué estás probando. Lo que hay publicado hoy es el trabajo de diseño: la revisión formal de desarrollo viene después. Mientras Ipsum esté en desarrollo la versión del tema se queda clavada en 1.0.0 y los cambios se registran en las descripciones de los pull requests, no en un changelog. Traducido: si lo instalas en un sitio real no vas a poder distinguir una build de otra por el número de versión, así que pruébalo en Playground o en staging, nunca en producción.

    Y si al abrirlo sientes exactamente lo que sentí yo —"qué bonito, y qué poco tiene que ver conmigo"—, ya tienes tu respuesta. Ese es el momento de mirar la arquitectura de tu sitio con honestidad, no el momento de instalarte un tema.

    En Dominicode Labs desmenuzamos este tipo de decisiones de arquitectura sobre proyectos reales, sin quedarnos en el "depende". Y si prefieres verlo antes que leerlo, lo voy contando en el canal.

    Preguntas frecuentes

    ¿Qué es Ipsum en WordPress?

    Ipsum es un tema de bloques minimalista propuesto como tema por defecto de WordPress 7.2. Está construido sobre theme.json y Global Styles con el mínimo CSS posible, todas sus combinaciones de estilos pasan WCAG AA y se presenta como un lienzo en blanco centrado en la experiencia de blogging. Lo anunció Henrique Iamarino en Make WordPress Core el 16 de septiembre de 2026.

    ¿Por qué WordPress deja de llamar "Twenty X" a sus temas por defecto?

    Por indicación de Matt Mullenweg. Los temas por defecto pasan a tener nombre propio y a renovarse cuando el diseño lo pida, no cuando llegue el cambio de año. El modelo anterior forzaba una entrega anual aunque el tema vigente siguiera siendo válido, dejaba en producción temas con el año fosilizado en el nombre y además ya estaba roto en la práctica: nunca existió Twenty Eighteen y 2026 se ha quedado sin tema del año.

    ¿Cuándo sale WordPress 7.2?

    El roadmap oficial de WordPress sitúa la versión 7.2 el 10 de diciembre de 2026, y el calendario de la release marca la ventana de lanzamiento del 8 al 10 de diciembre. Antes hay dos hitos que importan más si vas a dar feedback sobre Ipsum: Beta 1 el 20-22 de octubre, a partir del cual el equipo solo corrige bugs, y la Release Candidate 1 el 17-19 de noviembre, cuando se congelan los textos.

    ¿Al actualizar a WordPress 7.2 me va a cambiar el tema a Ipsum?

    No. WordPress no cambia el tema activo de un sitio que ya existe: Ipsum llegará a tu instalación como tema disponible pero inactivo, igual que llegaron en su día los Twenty X. El tema por defecto solo se activa en instalaciones nuevas. Si quieres probarlo en un sitio en producción tienes que activarlo tú, y conviene hacerlo antes en staging o en WordPress Playground.

    ¿Ipsum afecta a mi sitio si uso WordPress headless?

    Casi nada, pero no exactamente cero. Las plantillas del tema solo entran cuando WordPress renderiza páginas, así que con un frontend propio Ipsum no pinta nada de lo que ve tu lector. Lo que sí sigue vivo es su theme.json: WordPress carga el tema activo también en las peticiones REST, y sus ajustes de layout acaban en las clases y los estilos inline que recibes dentro de content.rendered. Eso, y los cambios de la REST API de 7.2, es lo único que te afecta.

    ¿Qué pasa con Mētis, el tema anterior?

    Mētis era el tema en el que el equipo trabajaba antes, orientado a escritores y creadores. Ipsum lo desplaza como propuesta de tema por defecto, pero no se cancela: se publicará por su cuenta cuando esté terminado.

    ¿Cómo puedo probar Ipsum antes de que salga WordPress 7.2?

    La vía más rápida es WordPress Playground, que abre una instalación temporal en el navegador sin instalar nada. La otra es descargar el ZIP del repositorio WordPress/ipsum y descomprimirlo en wp-content/themes/ipsum. Necesitas WordPress 7.1 o superior y PHP 7.4 o superior. En ambos casos, pruébalo fuera de producción: mientras el tema esté en desarrollo su versión no se mueve de 1.0.0.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Sincronizar el read model en CQRS: outbox, idempotencia y rebuild

    Sincronizar el read model en CQRS: outbox, idempotencia y rebuild

    Un lunes por la mañana, soporte abrió un ticket con la frase que más miedo da de todas: «el cliente dice que pagó y su pedido sigue saliendo como pendiente».

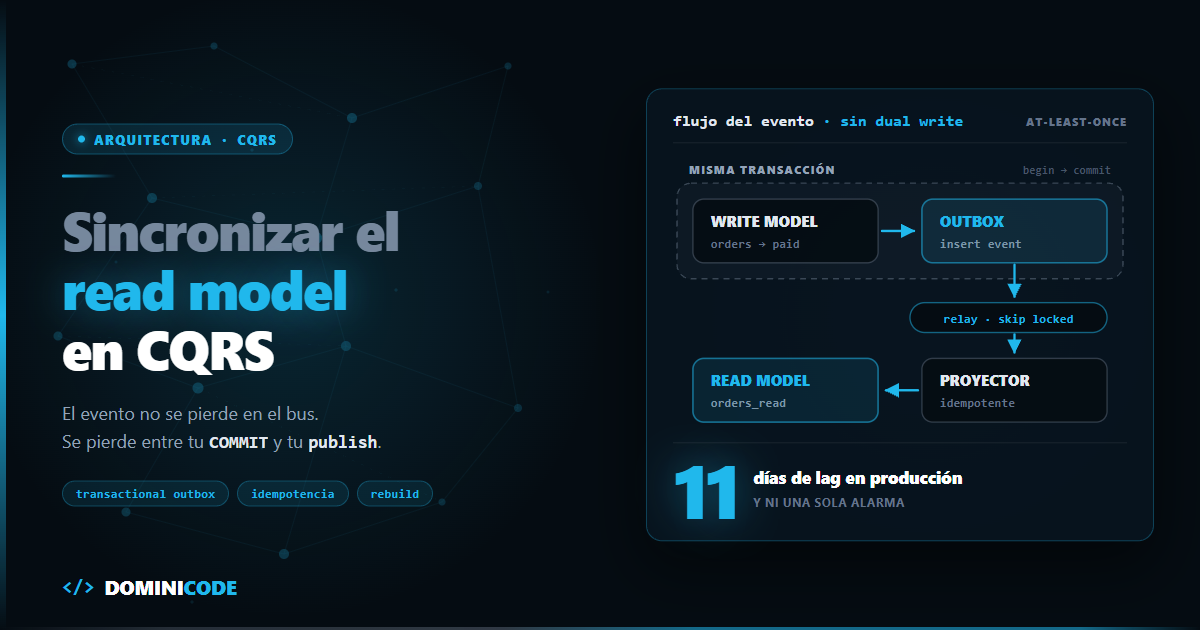
    Miramos la tabla de pedidos. Pagado. Miramos la vista que consume el frontend. Pendiente. Llevaba once días así.

    Nadie se había enterado porque el sistema no estaba roto. Todos los endpoints devolvían 200. Los logs estaban limpios. Simplemente, el read model se había quedado atrás y no existía ninguna alarma que mirase esa diferencia.

    Ese es el problema real de CQRS: cómo sincronizar el read model con el write model sin que se pudra. No aparece el día que lo eliges; aparece tres meses después. Si todavía estás decidiendo si el patrón te conviene, ese es otro debate — qué es CQRS y cuándo compensa aplicarlo. Este post empieza el día siguiente.

    Y la tesis, por delante: no pierdes eventos por culpa del bus. Los pierdes en el hueco que hay entre tu COMMIT y tu publish.


    Por qué el read model se desincroniza: el problema del dual write

    El read model se desincroniza porque el cambio de estado y la publicación del evento son dos operaciones contra dos sistemas distintos, sin transacción común. Si la segunda falla, no queda nadie para reintentarla.

    Este código lo he visto en producción más veces de las que me gustaría:

    await db.query(`update orders set status = 'paid' where id = $1`, [orderId])
    await bus.publish('order.paid', { orderId })
    

    Dos líneas. Parecen una unidad. No lo son.

    Entre la primera y la segunda cabe todo: un timeout del broker, un deploy que mata el pod, el OOM killer, un ECONNRESET. Si la segunda línea falla, la base de datos de escritura dice "pagado" y el read model no se entera nunca. No hay reintento que te salve, porque el proceso que tenía que reintentar ya no existe.

    Invertir el orden es peor. Si publicas primero y la transacción hace rollback después, has emitido un evento sobre algo que no ocurrió. El read model muestra un pedido pagado que en la fuente de verdad sigue pendiente. Ese bug se tarda semanas en encontrar.

    Esto tiene nombre: dual write. Escribir en dos sistemas que no comparten transacción. No se arregla con try/catch, ni con reintentos en el catch, ni metiendo el publish dentro de la transacción —porque la red no hace rollback.

    La solución académica es 2PC. La que usa la gente que tiene que dormir por las noches es otra.


    Transactional outbox: sincronizar el read model en una sola transacción

    El transactional outbox es un patrón que elimina el dual write escribiendo el evento en una tabla de la misma base de datos, dentro de la misma transacción que el cambio de estado; un proceso aparte —el relay— lee esa tabla y lo publica en el bus. Está catalogado así en el catálogo de patrones de microservicios de Chris Richardson.

    Y la idea es tonta de simple: si no puedes hacer atómicas dos operaciones contra dos sistemas, haz que las dos vayan contra el mismo sistema.

    El evento no se publica. Se inserta en una tabla de la misma base de datos, dentro de la misma transacción que el cambio de estado. Si el COMMIT pasa, el evento existe. Si no pasa, tampoco. Atomicidad gratis, la que ya te da Postgres.

    create table outbox (
      id             bigserial   primary key,
      aggregate_id   uuid        not null,
      aggregate_type text        not null,
      event_type     text        not null,
      version        int         not null,
      payload        jsonb       not null,
      occurred_at    timestamptz not null default now(),
      published_at   timestamptz
    );
    
    -- índice parcial: solo lo pendiente, que es lo que el relay consulta cada tick
    create index outbox_pending_idx on outbox (id) where published_at is null;
    

    Y el comando queda así:

    import { Pool } from 'pg'
    
    const pool = new Pool({ connectionString: process.env.DATABASE_URL })
    
    export async function markOrderAsPaid(orderId: string, total: number) {
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        const { rows } = await client.query<{ version: number }>(
          `update orders
              set status = 'paid', paid_at = now(), version = version + 1
            where id = $1 and status = 'pending'
            returning version`,
          [orderId],
        )
    
        if (rows.length === 0) throw new Error('ORDER_NOT_PENDING')
    
        await client.query(
          `insert into outbox (aggregate_id, aggregate_type, event_type, version, payload)
           values ($1, 'order', 'order.paid', $2, $3)`,
          [orderId, rows[0].version, { orderId, total, paidAt: new Date().toISOString() }],
        )
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Fíjate en el returning version. Ese número lo vas a necesitar dentro de dos secciones y es lo que separa un read model correcto de uno que a veces acierta.

    El relay

    Un proceso aparte lee la tabla y publica. Nada más. La clave está en el for update skip locked —disponible desde Postgres 9.5—: te deja correr varias instancias del relay sin que dos cojan la misma fila.

    export async function relayTick(bus: Bus, batchSize = 100) {
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        const { rows } = await client.query<OutboxRow>(
          `select id, aggregate_id, event_type, version, payload, occurred_at
             from outbox
            where published_at is null
            order by id
            limit $1
              for update skip locked`,
          [batchSize],
        )
    
        for (const row of rows) {
          await bus.publish({
            id: String(row.id),
            type: row.event_type,
            aggregateId: row.aggregate_id,
            version: row.version,
            payload: row.payload,
            occurredAt: row.occurred_at,
          })
        }
    
        if (rows.length > 0) {
          await client.query(
            `update outbox set published_at = now() where id = any($1::bigint[])`,
            [rows.map((r) => r.id)],
          )
        }
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Léelo otra vez y busca el agujero, porque lo tiene: si bus.publish va bien y el commit del update ... published_at falla, el evento sale publicado dos veces.

    Eso es intencionado. El outbox te garantiza at-least-once, nunca exactly-once. Y está bien. Preferimos un evento duplicado que un evento perdido, porque el duplicado se resuelve en el consumidor y la pérdida no se resuelve en ningún sitio.

    El relay es, además, donde el bus te va a fallar de verdad. Con el broker caído, reintentar en bucle cerrado solo empeora las cosas: aplica el mismo razonamiento que expliqué sobre circuit breakers y clasificación de fallos. Cortar, esperar, dejar que el outbox acumule. Para eso está la tabla: el relay puede pasarse diez minutos parado y no se pierde ni un evento.


    Idempotencia en el proyector: procesar dos veces sin duplicar

    Si el bus entrega al menos una vez, el proyector tiene que poder comerse el mismo evento dos veces y terminar en el mismo estado. Punto.

    Dos piezas: una tabla que registra qué eventos ya se procesaron y un upsert que no dependa del orden de llegada.

    create table processed_events (
      projection   text        not null,
      event_id     bigint      not null,
      processed_at timestamptz not null default now(),
      primary key (projection, event_id)
    );
    
    create table projection_checkpoint (
      projection    text        primary key,
      last_event_id bigint      not null default 0,
      updated_at    timestamptz not null default now()
    );
    
    create table orders_read (
      order_id uuid        primary key,
      status   text        not null,
      total    numeric     not null,
      paid_at  timestamptz,
      version  int         not null
    );
    

    El primary key de order_id no es decorativo: sin esa restricción única, el on conflict (order_id) del proyector ni siquiera llega a ejecutarse.

    Antes de tocar nada, valida el payload. El evento viaja como JSON opaco y puede llevar meses en la tabla: el día que alguien cambie su forma en el productor, tu proyector recibirá algo que no espera. Parsea siempre con un schema —aquí, Zod 4— y manda a dead letter lo que no cumpla, en vez de dejar que un undefined acabe escrito en la vista.

    import { z } from 'zod'
    
    const OrderPaid = z.object({
      orderId: z.uuid(),
      total: z.number().nonnegative(),
      paidAt: z.iso.datetime(),
    })
    
    export async function projectOrderPaid(event: DomainEvent) {
      const parsed = OrderPaid.safeParse(event.payload)
      if (!parsed.success) {
        await deadLetter(event, parsed.error)
        return
      }
    
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        // 1. Reclamar el evento. Si ya estaba, no hacemos nada más.
        const claim = await client.query(
          `insert into processed_events (projection, event_id)
           values ('orders_read', $1)
           on conflict do nothing`,
          [event.id],
        )
    
        if (claim.rowCount === 0) {
          await client.query('rollback')
          return
        }
    
        // 2. Upsert con guarda de versión.
        await client.query(
          `insert into orders_read (order_id, status, total, paid_at, version)
           values ($1, 'paid', $2, $3, $4)
           on conflict (order_id) do update
              set status  = excluded.status,
                  total   = excluded.total,
                  paid_at = excluded.paid_at,
                  version = excluded.version
            where orders_read.version < excluded.version`,
          [parsed.data.orderId, parsed.data.total, parsed.data.paidAt, event.version],
        )
    
        // 3. Avanzar el checkpoint.
        await client.query(
          `update projection_checkpoint
              set last_event_id = greatest(last_event_id, $1), updated_at = now()
            where projection = 'orders_read'`,
          [event.id],
        )
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Lo importante: los tres pasos van en la misma transacción. Si el proceso muere entre el paso 1 y el 2, el rollback deshace la reclamación y el evento se vuelve a entregar. Sin transacción, esa tabla de deduplicación no te protege, te miente.

    Este parseo de eventos es, por cierto, uno de los sitios donde Zod paga solo: el mismo schema te da el tipo de TypeScript, la validación en runtime y el mensaje de error que vas a leer en el dead letter a las tres de la mañana.

    Si quieres exprimir esa parte —discriminated unions por event_type, transformaciones, versionado de schemas— lo trabajo a fondo en el curso de Zod para TypeScript.


    Orden y versiones: cuando el v3 llega antes que el v2

    Ningún bus te garantiza el orden global. Con particiones, reintentos y varios consumidores en paralelo, el evento v3 de un pedido puede llegar antes que el v2. Es normal, no es un bug del broker.

    La cláusula que ya has visto arriba resuelve el caso:

    where orders_read.version < excluded.version
    

    Si llega el v3 y lo aplicas, cuando aparezca el v2 el WHERE da falso y el update no ocurre. El evento viejo se descarta en silencio, que es exactamente lo que quieres: tu read model no retrocede jamás.

    Ahora la letra pequeña, que es donde se rompe la gente: esto solo funciona si tus eventos llevan el estado completo. Si order.paid dice "el total es 120 y el estado es paid", aplicar el v3 y tirar el v2 deja la vista correcta. Si tus eventos son deltas —"suma 3 al stock", "descuenta 20 del saldo"— descartar el v2 te deja con un número mal para siempre.

    Con deltas necesitas detectar huecos y esperar. Cambias la guarda por una igualdad estricta:

    -- solo aplico si soy exactamente el siguiente
    where orders_read.version = excluded.version - 1
    

    Y si rowCount === 0 y la versión del evento es mayor que la actual más uno, lanzas para que el bus te lo vuelva a entregar más tarde, cuando el que falta ya haya pasado.

    Cambia también el SET: con deltas ya no copias excluded, acumulas — set total = orders_read.total + excluded.total. Y ojo al caso borde, que es el que muerde: esa guarda solo se evalúa en la rama DO UPDATE. Si la fila todavía no existe, el INSERT entra con la versión que traiga y el hueco pasa sin que nadie lo vea. Con deltas, crea la fila en la versión 0 cuando das de alta el agregado.

    Mi recomendación después de sufrir las dos: haz los eventos state-carrying siempre que puedas. Pesan más en la cola y a cambio te ahorran toda la maquinaria de gaps, buffers y reentregas. Es el cambio de diseño más rentable de esta lista.


    Rebuild de proyecciones: el superpoder que nadie usa

    Aquí está la parte buena de CQRS, la que compensa todo lo anterior: si tu read model es una función pura de la secuencia de eventos, el read model es desechable. ¿Se corrompió por un bug del proyector? Lo tiras. ¿Quieres añadir una columna calculada a la vista? Lo tiras. ¿Cambias la forma entera de la proyección? Lo tiras.

    Con la condición que casi nadie cumple: no borres los eventos. Un outbox con delete from outbox where published_at is not null es un outbox que funciona y que te quita esta capacidad para siempre. Archiva a un event_log en vez de borrar. Es la diferencia entre una cola y un log.

    El patrón es proyección versionada, y son cuatro pasos:

    1. Creas orders_read_v2 con el esquema nuevo, vacía, y su propia fila en projection_checkpoint.
    2. Arrancas el proyector v2 en modo replay, leyendo el event_log desde el id 0. El v1 sigue vivo y sirviendo tráfico.
    3. Cuando el v2 alcanza al v1 y ambos consumen en tiempo real, comparas. Unos cuantos agregados a mano o un diff de checksums.
    4. Cambias el puntero.

    Ese cambio de puntero es lo único delicado. Si la capa de consulta lee a través de una vista, es una sentencia:

    begin;
      drop view orders_read_current;
      create view orders_read_current as select * from orders_read_v2;
    commit;
    

    Dentro de la transacción toma un ACCESS EXCLUSIVE sobre la vista: las consultas en vuelo esperan unos milisegundos y siguen. Y no, create or replace view no vale aquí: solo admite añadir columnas al final, no cambiar nombres, tipos ni orden —que es exactamente lo que cambia en un rebuild.

    Si no tienes vista, usa un flag de configuración que lea la capa de consulta al construir la query: más código, pero te deja volver atrás sin desplegar.

    Con un rebuild fiable, tocar el read model deja de dar miedo. Ya no migras datos con un ALTER TABLE a las dos de la mañana: construyes una tabla nueva en paralelo, con tráfico real, y decides con datos si la enciendes.

    Un apunte de método: el evento order.paid es una API pública aunque no tenga endpoint. Quién lo emite, qué campos garantiza y cómo se versiona tiene que estar escrito antes de picar el proyector.

    Es de lo que más insisto en el libro de Spec-Driven Development, y en sistemas de eventos se nota el doble: el coste de equivocarte no lo pagas en el deploy, lo pagas seis meses después, cuando ya hay cuatro consumidores.


    Medir el lag del read model: el único aviso temprano que vas a tener

    En CQRS la consistencia eventual no es un fallo, es el contrato: el read model siempre va algo por detrás del write model. El fallo es no saber cuánto.

    Todo lo anterior puede estar bien implementado y aun así tu read model puede ir veinte minutos por detrás porque el relay se quedó colgado. No se lanza ninguna excepción. No hay error 500. Todo está "verde".

    Solo hay una métrica que te avisa: la antigüedad del evento pendiente más viejo.

    select coalesce(
      extract(epoch from now() - min(o.occurred_at)),
      0
    ) as lag_seconds
    from outbox o
    left join processed_events p
           on p.projection = 'orders_read'
          and p.event_id   = o.id
    where p.event_id is null;
    

    Devuelve 0 cuando no hay nada pendiente y crece cuando algo se atasca. Exponla como gauge y ponle alerta.

    No la escribas contra last_event_id del checkpoint. Como el checkpoint avanza con greatest(), es una marca de agua alta: el v2 que se fue al dead letter queda por debajo de ella, la query no lo ve y te devuelve 0 con la proyección rota. Que es, literalmente, el ticket de los once días. Si purgas processed_events, limita el anti-join a tu ventana de retención.

    Cuidado con la versión ingenua de esta métrica, que es la que suele estar puesta: now() - last_event_at del checkpoint. Esa te mide "cuánto hace que proyecté algo", y si a las tres de la madrugada no hay tráfico te va a despertar sin motivo. Peor: te acostumbra a ignorar la alarma. Mide lo que está esperando, no lo último que hiciste.

    Yo añado dos series más al dashboard:

    • Lag en eventos: cuántas filas del outbox siguen sin aparecer en processed_events. Te dice si el proyector está perdiendo la carrera. No lo calcules como max(id) − last_event_id: arrastra exactamente el mismo punto ciego de la marca de agua.
    • Tamaño del dead letter: si crece, hay eventos que no se están aplicando y el read model ya está mal.

    Con esas tres, aquel ticket de los once días se habría abierto en once minutos.


    Cuándo no necesitas absolutamente nada de esto

    Si tu "read model" es una réplica de lectura de la misma base de datos, no tienes este problema. Postgres replica por ti, la sincronía la resuelve el WAL, y tu única métrica es el lag de replicación —que ya viene dado por pg_last_xact_replay_timestamp() y pg_stat_replication.

    Nada de outbox, nada de proyectores, nada de checkpoints. Si separaste lectura y escritura solo para repartir carga, esa es la respuesta correcta y es aburridísima, que es justo lo que quieres en infraestructura.

    Lo mismo si tu vista denormalizada es una materialized view en la misma base y toleras refrescarla cada pocos minutos. REFRESH MATERIALIZED VIEW CONCURRENTLY resuelve más casos de los que la gente cree. Pide dos cosas: un índice UNIQUE sobre columnas —sin expresiones y sin WHERE— y que la vista ya esté poblada. A cambio refresca sin bloquear lecturas, aunque tarda bastante más que un refresh normal.

    Todo lo de este post empieza a hacer falta cuando el read model vive en otro sitio: otro motor, otro servicio, un índice de búsqueda, una tabla con una forma que no se deriva de un SELECT. Ahí sí tienes dual write y ahí sí necesitas el outbox.

    Dónde vive tu read model Cómo se sincroniza Qué tienes que operar Lag típico
    Réplica de lectura, misma base Replicación física (WAL) Nada, lo hace Postgres Milisegundos
    Materialized view, misma base REFRESH MATERIALIZED VIEW CONCURRENTLY Un cron Minutos
    Otra tabla, otro servicio, índice de búsqueda Transactional outbox + relay Tabla outbox, relay, checkpoints Segundos
    Igual que arriba, sin mantener relay CDC leyendo el WAL Kafka + Connect Segundos

    Y si estás en ese caso pero no quieres mantener la tabla ni el relay, mira CDC antes de escribir código: resuelve lo mismo leyendo el WAL, a cambio de infraestructura extra. Lo desarrollo en las preguntas de abajo.


    Qué hacer hoy

    Si ya tienes CQRS en producción y nada de esto está montado, no empieces por el outbox. Empieza por la métrica.

    Escribe la query del lag, ponla en un dashboard y déjala una semana. Vas a descubrir dos cosas: cuántos eventos estabas perdiendo sin saberlo, y si tu problema real era ese o era otro. Es media hora de trabajo, y es lo único de esta lista que te da información antes de que te la pida un cliente enfadado. El resto —outbox, idempotencia, versiones, rebuild— se construye después, con datos encima de la mesa.

    Si quieres ver este tipo de arquitecturas montadas de principio a fin, con el código completo y las decisiones discutidas, en Dominicode Labs es donde publico los proyectos largos que no caben en un post.


    Preguntas frecuentes

    ¿Por qué mi read model no se actualiza en CQRS?

    Casi siempre por dual write: el cambio de estado se guardó, pero el evento nunca llegó al bus porque publicar y hacer commit son dos operaciones distintas y la segunda falló sin que nadie reintentara.

    Los otros dos sospechosos habituales son el relay parado —el evento sigue en la tabla outbox con published_at a null— y un evento que el proyector rechaza una y otra vez hasta acabar en el dead letter. Los tres casos se distinguen en treinta segundos con la query de lag de este post: si devuelve un número alto, el evento existe y no se ha proyectado; si devuelve 0 y la vista sigue mal, mira el dead letter.

    ¿El transactional outbox añade latencia a cada escritura?

    Añade un INSERT dentro de una transacción que ya estaba abierta. En la práctica es ruido comparado con el resto del comando.

    La latencia que sí importa es la otra: cuánto tarda el evento en llegar al read model. Eso lo marca el intervalo de polling del relay, no el insert. Si necesitas bajarlo, usa LISTEN/NOTIFY de Postgres para despertar al relay en cuanto hay una fila nueva, en lugar de esperar al siguiente tick.

    ¿Puedo usar CDC en lugar de la tabla outbox?

    Sí, y resuelve el mismo problema de dual write. Debezium lee el WAL de Postgres y publica los cambios sin que tu código haga nada — trae incluso un outbox event router preparado exactamente para este patrón.

    La diferencia es qué publicas. Con outbox publicas eventos de dominio que tú diseñas; con CDC a secas publicas cambios de filas, y tus consumidores acaban acoplados al esquema de tu base de datos. El punto medio más usado es CDC leyendo precisamente la tabla outbox: eventos de dominio sin escribir relay, a cambio de operar Kafka y Connect.

    ¿Qué hago con un evento que el proyector nunca consigue procesar?

    Dead letter después de N intentos, y alerta. Lo que no puedes hacer es reintentarlo en bucle para siempre: bloqueas la partición y frenas todo lo que viene detrás.

    Ojo con la consecuencia que se pasa por alto: si mandas a dead letter el v2 de un agregado y sigues procesando el v3, esa fila queda incoherente hasta que reproceses. Por eso el dead letter va en el dashboard y no en un buzón que nadie abre.

    ¿Necesito event sourcing para poder reconstruir proyecciones?

    No. Necesitas retener los eventos, que es mucho menos que event sourcing.

    En event sourcing el log de eventos es la fuente de verdad y el estado se deriva de él. Aquí la fuente de verdad sigue siendo tu tabla orders, y el log de eventos es solo el historial de cambios publicados. Con archivar el outbox en un event_log en vez de borrarlo ya puedes reconstruir cualquier proyección.

    ¿Cada cuánto debería hacer polling del outbox?

    Depende del lag que tu producto tolere, no de lo que haga la industria. Un panel interno aguanta segundos; un contador que el usuario ve moverse tras pulsar un botón, no.

    Define el número primero —"el read model va como mucho X segundos por detrás"—, mídelo con la query de lag y ajusta el intervalo hasta cumplirlo. Sin ese número escrito, cualquier valor que pongas es una opinión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Harness multiagente vs un solo agente: qué midió Uncle Bob

    Harness multiagente vs un solo agente: qué midió Uncle Bob

    Robert C. Martin —Uncle Bob, el de Clean Code— pasó meses construyendo lo que parecía la cosa correcta: un harness de orquestación de agentes IA con roles especializados, sesiones aisladas y handoffs que no se contaminaban entre sí. Gates deterministas. Métricas de complejidad. Todo.

    Mientras lo montaba, el suelo se movía debajo.

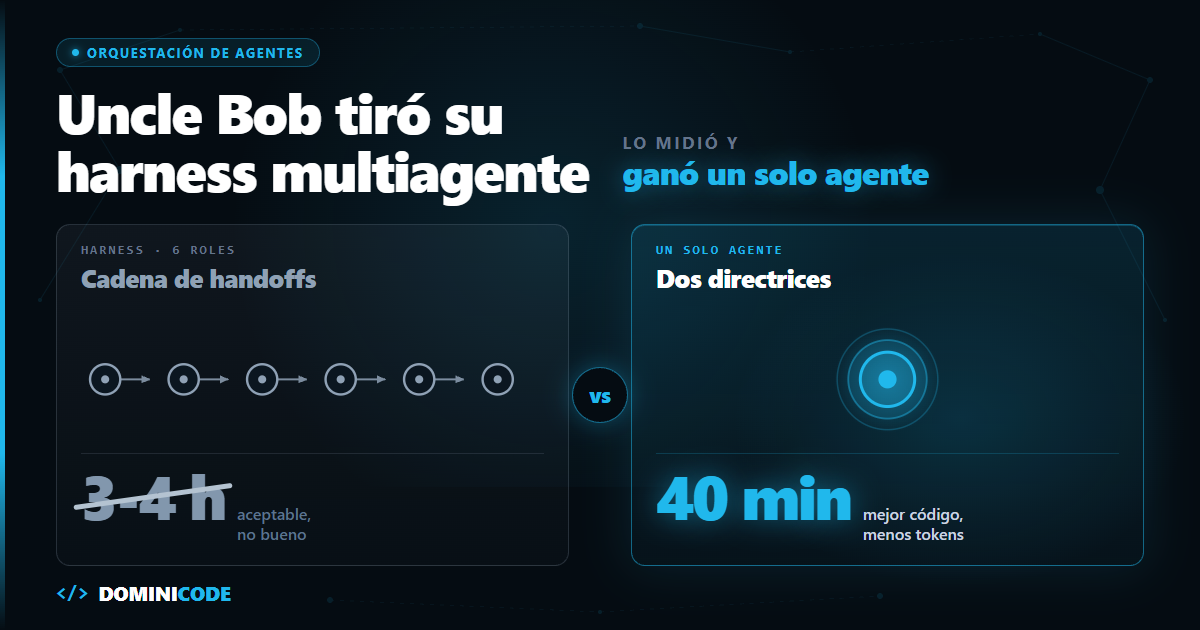
    Cuando por fin lo tuvo funcionando hizo lo que casi nadie hace: medirlo contra la alternativa tonta. Le dio la misma tarea a un solo agente, con un par de directrices y cero orquestación. Se fue cuarenta minutos. Al volver estaba hecho. Y mejor que lo que le entregaba el enjambre.

    Su conclusión pública cabe en seis palabras: "OK. It's time to rethink this."

    En corto: Uncle Bob midió su harness multiagente de seis roles contra un solo agente en la misma tarea: cuarenta minutos frente a tres o cuatro horas, y mejor código. La orquestación con roles fijos y handoffs por contrato era un andamio para modelos débiles, y los modelos dejaron de serlo. Hoy un agente único bien dirigido suele ganar en tiempo, en calidad y en tokens. Lo que sigue valiendo del harness no es la orquestación: es la verificación determinista —tests, tipos, cobertura, complejidad— contra la que mides su salida.


    Qué era SwarmForge, el harness que Uncle Bob construyó y tiró

    Un harness de orquestación multiagente es una capa de software que reparte una tarea entre varios agentes con roles predefinidos, controla el orden en que se pasan el trabajo y bloquea el avance hasta que cada etapa cumple unos criterios medibles.

    SwarmForge, el harness de Uncle Bob, se autodescribe en su README como "a simple tool for coordinating several AI agents". Es bastante más que eso.

    Los roles están separados de verdad. El six-pack del repo los nombra así: especificación, implementación, limpieza, arquitectura, hardening y QA. Cada agente vive en su propia sesión de tmux y su git worktree bajo .worktrees/ para no pisarse, y los handoffs los mueve un daemon en Babashka.

    Las técnicas que aplica cada rol no están en el repo: las cuenta él. Gherkin para la especificación, TDD para implementar, revisiones de duplicación y de CRAP para la limpieza, mutation testing para el hardening.

    Cada decisión ahí responde a un fallo real que conoce cualquiera que haya montado esto. Si llegas frío, la pieza por pieza está en la anatomía de un agent harness, y el recorrido completo en construir un agente de IA desde cero.

    Y aun así perdió contra un agente solo. Con el mismo modelo corriendo dentro y fuera del harness.

    El experimento es de septiembre de 2026 y el modelo era Grok. Uncle Bob no precisa la versión, y eso limita la reproducibilidad: esto es la medición de un practicante con oficio, no un paper.

    El experimento que lo tiró abajo

    El experimento fue este: misma tarea, mismo modelo, dos caminos — el harness de seis roles y un agente solo con dos directrices. Y Uncle Bob relajó las restricciones a favor del harness, a propósito.

    En vez de su umbral habitual de CRAP por debajo de 6, pidió mantenerlo por debajo de 12. CRAP —Change Risk Anti-Patterns— combina complejidad ciclomática con cobertura de tests: cuanto más ramifica un método y menos cubierto está, más alto puntúa y más caro es tocarlo.

    Algo de mutation testing y tests unitarios. Nada de Gherkin. Dos directrices y a correr.

    El agente hizo algo que nadie le pidió: partió el código en módulos y dejó todo el CRAP por debajo de 6 igualmente. Por debajo del umbral relajado y del estricto.

    Cuarenta minutos. Lo que al harness completo le costaba tres o cuatro horas, y salía aceptable-pero-no-bueno.

    Métrica Harness SwarmForge Un solo agente
    Agentes implicados 6 (six-pack del repo) 1
    Tiempo en la misma tarea tres o cuatro horas cuarenta minutos
    Calidad entregada aceptable, no buena mejor, con un par de quejas menores
    Umbral de CRAP pedido por debajo de 6 (su estándar) por debajo de 12 (relajado a propósito)
    CRAP entregado — por debajo de 6, y modularizado sin pedírselo
    Consumo de tokens la referencia cayó "by a huge factor" al abandonar el harness

    Todas las cifras salen de lo que cuenta Uncle Bob en sus hilos; el recuento de agentes, del README del repo.

    Días después llegó la segunda medición, la que duele en la factura: "Since I stopped using my harness, my token consumption has fallen by a huge factor. That harness was massively inefficient."

    Cada handoff es un resumen que uno escribe, otro lee y un tercero vuelve a expandir. Y aquí conviene no confundir dos facturas distintas. Cuando medí el overhead de los frameworks de IA en tokens el resultado fue que no hay prompts ocultos inyectados: ese impuesto es un mito. El coste de un harness es el opuesto, explícito y a la vista: serializar el estado en cada salto para que el siguiente agente pueda leerlo. Nadie te lo esconde. Lo pagas igual.

    Lo que se ha roto no es el multiagente

    La idea que se cae no es "usar varios agentes". Es otra, más específica: tratar al agente como un componente de un diagrama de software. Una caja con interfaz fija, un rol asignado y un contrato de handoff.

    Tenía sentido hace un año, cuando los modelos se perdían en tareas largas: el rol estrecho y el gate duro eran una prótesis para una debilidad real.

    Los modelos dejaron de ser débiles. El andamio se convirtió en camisa de fuerza.

    El detalle que lo resume es la modularización. Nadie se la pidió. Un pipeline con un rol architect habría producido esa decisión como etapa obligatoria, en su turno, con su handoff. El agente solo la tomó porque veía el problema entero de una vez.

    Ahí está el fondo: un harness de roles fijos parte el contexto por la línea que dibujaste hace tres meses, no por donde el problema se parte hoy.

    Harness, agente único y subagentes bajo demanda

    No son tres sabores del mismo plato. Se diferencian en una cosa: quién decide el reparto del trabajo.

    Harness orquestado Agente único dirigido Subagentes bajo demanda
    Quién reparte Tú, antes de empezar Nadie: no hay reparto El modelo, en ejecución
    Qué resuelve Determinismo, trazabilidad por etapa, aislamiento fuerte El criterio del modelo sobre el problema completo Aislar contexto sucio sin fijar roles
    Qué cuesta Meses de construcción y tokens en cada handoff Una sesión larga y directrices bien escritas Latencia y contexto duplicado
    Límite o riesgo Bloquea decisiones transversales que el modelo tomaría solo; envejece con cada modelo nuevo Se cae si la tarea no cabe en una sesión o cruza permisos Si abusas, vuelves a un pipeline implícito
    Cuándo elegirlo Aprobación humana intermedia, aislamiento por datos o permisos, paralelismo real Casi todo el trabajo normal de feature o refactor Investigación previa a escribir código

    Fíjate en la fila de límites: ninguna columna está limpia. La pregunta no es "multiagente sí o no", sino cuánta estructura te puedes permitir antes de que la estructura decida por el modelo.

    Lo que defendí hace un mes y qué parte ha caducado

    El 24 de agosto publiqué Arquitectura de subagentes IA: por qué falla el mega-prompt: un agente mío con 3.000 palabras de system prompt y 28 herramientas que colapsaba a la cuarta tarea compleja.

    Esa mitad sigue en pie. Un prompt con cincuenta reglas y treinta herramientas reparte la atención del modelo entre instrucciones que casi nunca aplican. Una ventana más grande no lo arregla: solo retrasa el momento en que se nota.

    La otra mitad ha caducado. Allí proponía un pipeline fijo —investigador, implementador, revisor— comunicándose por artefactos en disco, con el orden decidido por mí antes de empezar. Eso es orquestación rígida: lo mismo que acaba de tirar Uncle Bob, en pequeño.

    La distinción que reconcilia las dos posiciones es quién manda.

    Subagentes bajo demanda: el modelo decide delegar cuando le conviene, el subagente vive lo que dura su pregunta y muere con su contexto sucio dentro. Nadie le asignó un rol permanente. Sigue siendo buena idea, porque aislar contexto no ha dejado de importar.

    Orquestación rígida: los roles existen antes que la tarea, el orden vive en un fichero de configuración y el trabajo pasa por todas las etapas aunque tres no aporten nada. Esto es lo que los modelos han dejado obsoleto.

    Escribí aquello hace un mes. Un mes. Esa es la velocidad a la que caduca hoy una decisión de arquitectura sobre agentes, y el mejor argumento para construir lo menos posible alrededor del modelo.

    Cuándo el harness sigue ganando

    Tirar la orquestación entera sería el error simétrico. Cuatro casos donde aún compensa:

    La tarea no cabe en una sesión. Migrar cuatrocientos ficheros no es un problema de criterio, es de volumen: repartir gana, aunque reparta trabajo y no roles.

    Hay una aprobación humana en medio. Si alguien firma antes del siguiente paso, necesitas una parada explícita con un artefacto revisable. Un agente continuo no te la da.

    El aislamiento es por permisos o por datos. El agente que lee el ticket del cliente no debería tener credenciales de producción. Eso no es diseño: es requisito, y sobrevive a cualquier modelo mejor.

    Paralelismo real sobre repos distintos. Tres repositorios independientes, tres agentes, cero coordinación. Funciona precisamente porque no hay handoffs.

    Y un límite más, del propio experimento: verificar de más deja cicatrices. Uncle Bob es honesto con el mutation testing —encontró bugs y omisiones reales, pero el algoritmo empuja al agente a hacer cosas tontas con tal de matar mutantes, y eso queda escrito en el código. Ningún gate es gratis.

    Y lo obvio: esto es la medición de una persona, con sus tareas y su modelo. No es un benchmark controlado. Si tu dominio no se parece al suyo, lo que te vale es el método, no la conclusión.

    Quédate la verificación, tira la orquestación

    Del harness se tira la orquestación y se conserva la verificación: la primera decide quién hace qué y caduca con cada modelo nuevo; la segunda define qué tiene que cumplir el resultado y no caduca.

    Separa las dos cosas que el harness mezclaba.

    La orquestación dice quién hace qué y en qué orden. Es la parte que envejece cada vez que sale un modelo mejor.

    La verificación dice qué tiene que cumplir el resultado para ser aceptable: tests que pasan, tipos que compilan, lint sin warnings, cobertura mínima, complejidad bajo umbral. No depende de quién escriba el código ni de cuántos agentes participen. Por eso no caduca.

    Tres cosas para esta semana:

    1. Escribe el contrato antes que el prompt. Entradas, salidas, errores, invariantes y umbrales. Si no puedes decir qué hace fallar la entrega, no tienes un gate: tienes una opinión. Lo tienes en revisión por contrato para código de agentes y entero en el ebook gratuito de 30 páginas.
    2. Convierte cada gate en un comando que devuelva 0 o 1. Si el criterio vive dentro del prompt de un rol, no es determinista: es una sugerencia. Un verify no necesita ser más que esto, y el agente lo ejecuta igual que tú:
    #!/usr/bin/env bash
    set -e                            # el primer fallo corta y devuelve != 0
    bun test                          # los tests pasan
    bunx tsc --noEmit                 # los tipos compilan
    bunx eslint . --max-warnings 0    # cero warnings
    bunx vitest run --coverage        # cobertura sobre el umbral del config
    
    1. Mide tu pipeline contra un agente solo. Misma tarea, dos caminos, cronómetro y factura de tokens. La comparación que casi nadie hace y la única que decide.

    El paso previo es tener la especificación escrita antes de que el agente toque nada: lo que trabajamos en Construye con IA y la tesis del libro de Spec-Driven Development. Un agente sin criterio escrito no va más rápido: va más rápido equivocándose.

    Si llevas meses montando tu orquestador, esta es la conclusión que importa: no tires el trabajo, tira la mitad correcta. Los roles y los handoffs ya no te compran nada. Los gates sí.


    Preguntas frecuentes

    ¿Qué es un harness de orquestación multiagente?

    Una capa de software que reparte una tarea entre varios agentes con roles predefinidos, controla el orden de los handoffs y bloquea el avance hasta que cada etapa cumple criterios medibles. SwarmForge lo implementa con una sesión de tmux y un git worktree por agente. Su valor original: compensar las limitaciones del modelo con estructura externa.

    ¿Significa esto que los subagentes ya no sirven?

    No. Lo que ha dejado de compensar son los roles fijos decididos antes de conocer la tarea. Delegar bajo demanda sigue siendo útil: cuando un subagente explora el repo o lee logs enormes, su contexto sucio muere con él sin contaminar la sesión principal. La diferencia está en quién decide: si lo decides tú en un fichero de configuración, es orquestación rígida; si lo decide el modelo en ejecución, es aislamiento de contexto.

    ¿Qué es CRAP y por qué se usa como gate?

    CRAP —Change Risk Anti-Patterns— combina complejidad ciclomática y cobertura en un número: un método muy ramificado y poco cubierto puntúa alto, y eso indica que cambiarlo es caro. Funciona como gate porque lo calcula una herramienta, no una opinión. Uncle Bob trabaja con umbral por debajo de 6, y aquí lo relajó a 12 a propósito.

    ¿Por qué un harness multiagente consume tantos más tokens?

    Porque cada handoff obliga a serializar el estado: uno resume lo que ha hecho y el siguiente reconstruye el contexto que el anterior ya tenía cargado. Multiplícalo por seis roles y por cada iteración. Uncle Bob lo comprobó al dejar de usar el suyo: su consumo cayó de forma drástica y calificó el harness de "massively inefficient".


    ¿Merece la pena construir mi propio harness multiagente hoy?

    Solo si tu problema es de los que no arregla un modelo mejor: volumen que no cabe en una sesión, una aprobación humana en medio, aislamiento por permisos o por datos, o paralelismo real sobre repos separados. Si tu motivo es "que el agente no se despiste", ya no lo necesitas: escribe los gates como comandos verificables y dale la tarea entera. Construir el harness te va a costar meses y va a envejecer con el siguiente modelo; los gates no.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tu agente no sale del repo: interoperabilidad de agentes de IA

    Tu agente no sale del repo: interoperabilidad de agentes de IA

    Escribí un subagente de revisión de código para Claude Code. Lee el diff, comprueba el contrato del módulo y marca lo que rompe.

    Un equipo con el que trabajo quiso ese mismo criterio en su pipeline, que no corre sobre Claude Code. Abrí el fichero para copiarlo y la ilusión me duró treinta segundos.

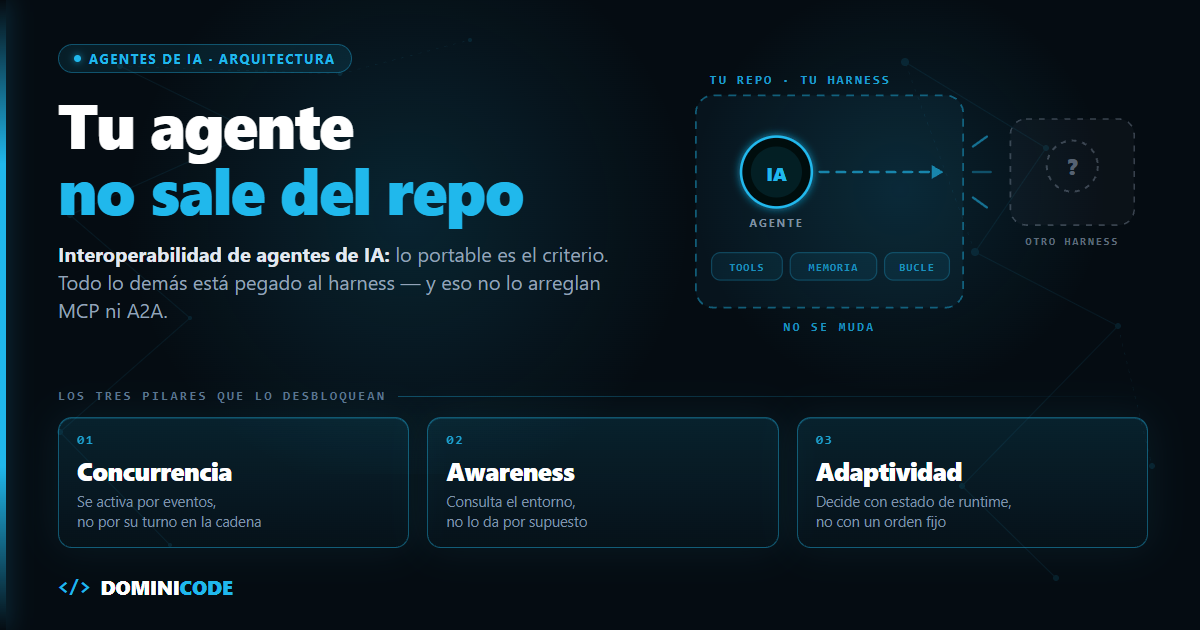
    Lo único portable era el criterio, y el criterio son cuatro párrafos de texto. El resto —cómo pide las herramientas, dónde guarda lo revisado, quién arranca el bucle, cómo reporta— estaba pegado al harness.

    Ese es el estado real de la interoperabilidad de agentes de IA hoy: no existe. Tenemos agentes que funcionan muy bien exactamente donde nacieron y en ningún otro sitio.

    La interoperabilidad de agentes de IA es la capacidad de ejecutar el mismo agente —su criterio, sus herramientas, su memoria y su bucle— en un harness distinto de aquel donde se escribió, sin reescribirlo. No consiste en que hable con otros agentes: consiste en que se mude.


    El software se volvió reutilizable. Los agentes, no

    El software se convirtió en una industria enorme por una razón aburrida: se escribe una vez y se usa muchas.

    Una librería la escribe un dev y la usan miles. Una API expone una capacidad y acaba dentro de productos que su autor nunca vio. Las app stores añadieron distribución global a eso. Cada pieza de software podía ser el bloque de construcción de otra cosa.

    Un agente debería llevar esa idea más lejos, no menos. No expone una función: expone un criterio. Entiende un objetivo, decide, usa herramientas, se comunica y ejecuta trabajo. Un buen agente de revisión, de extracción de facturas o de migración de tests debería ser un trabajador digital que enchufas donde haga falta su capacidad.

    Y sin embargo. El agente de extracción de facturas que montó tu compañero con LangChain no puede entrar en el CLI del equipo de al lado. El agente de tests que va fino en tu runtime se rompe entero en otro. No porque el criterio sea malo: porque el criterio nunca aprendió a viajar solo.

    Eso tiene tres consecuencias que ya estamos pagando.

    La primera es que cada equipo reconstruye lo mismo. Miles de empresas escribiendo su propio agente de research, su propio agente de soporte, su propio agente de procesamiento de documentos. El mismo trabajo de ingeniería repetido porque ninguno de esos agentes se mueve de su proyecto.

    La segunda es que impide la especialización. Nadie puede dedicar dos años a construir el mejor agente de auditoría de accesibilidad del mundo y distribuirlo por muchos sistemas. Cada agente se trata como un detalle de implementación interno, no como un producto.

    Y la tercera: sin portabilidad no hay mercado. No puede existir un marketplace real si un agente solo funciona dentro del harness donde nació, ni efecto red si añadirlo beneficia a una sola aplicación.


    El acoplamiento no está donde crees

    Cuando alguien dice "muevo mi agente a otro entorno" suele pensar en copiar el prompt. El prompt es lo barato. Lo caro es todo lo que el harness le daba gratis.

    Capa Qué cambia al mover el agente
    Tool calling El esquema de las tools, sus nombres, cómo se serializan los resultados
    Contexto y memoria Qué entra en la ventana, qué se resume, dónde persiste entre turnos
    Bucle de ejecución Quién decide cuándo parar, cuántos pasos caben, quién reintenta
    Transporte stdio, HTTP con streaming, cola de mensajes
    Permisos Quién aprueba una escritura y con qué granularidad
    Reporte de progreso Logs sueltos, eventos tipados, estados de tarea

    Copiar el prompt y creer que has movido el agente es como copiar un componente de React sin llevarte el router, los tipos ni el ciclo de vida. Tienes el texto. No tienes el comportamiento.

    Por eso insisto tanto en que el harness es la pieza que de verdad define a un agente. El modelo es intercambiable. El harness, hoy, no.


    Qué resuelven MCP y A2A de la interoperabilidad de agentes de IA (y qué no)

    MCP y A2A resuelven dos capas del problema: las herramientas y la comunicación entre agentes. Ninguno de los dos toca el runtime, el contexto ni el bucle, que es donde vive el acoplamiento real. Son dos intentos serios de estandarizar esto y conviene ser honesto con el alcance de cada uno.

    MCP estandariza la capa de herramientas y el contexto que se sirve. En su revisión 2026-07-28, un servidor expone tres primitivas —tools, resources y prompts— sobre JSON-RPC 2.0, y cualquier cliente las descubre e invoca igual. Eso arregla la primera fila de la tabla y parte del transporte, y no es poco: el mismo servidor vale para clientes distintos. Si nunca has montado uno, empieza por qué es MCP exactamente.

    Lo que MCP no define es el comportamiento del agente: qué entra en su ventana de contexto, quién arranca su bucle o cuándo decide parar. Los permisos ni siquiera intenta cubrirlos —la propia spec reconoce que "MCP itself cannot enforce these security principles at the protocol level" y los delega en el host. La revisión actual se acerca por los bordes, eso sí: la extensión Tasks cubre operaciones largas con polling y handles duraderos, y el grupo de trabajo Skills over MCP quiere distribuir instrucciones de agente como recurso. Ninguna de las dos, todavía, te deja mover un agente de harness.

    A2A estandariza el intercambio entre agentes. La versión 1.0.0 define la Agent Card para descubrir capacidades, las Tasks con su ciclo de vida de ocho estados (submitted, working, input-required, auth-required, completed, failed, canceled, rejected), los Messages y los Artifacts. Eso arregla la fila del reporte y buena parte de la comunicación.

    Y el límite lo pone la especificación misma, por escrito: los agentes colaboran "without needing to share their internal thoughts, plans, or tool implementations". Ahí está la frontera, literal. A2A te deja hablar con un agente remoto; no te deja traerte ese agente a casa.

    Puestos capa por capa contra la tabla de antes, el reparto queda así:

    Capa de acoplamiento MCP 2026-07-28 A2A 1.0.0 Quién la resuelve hoy
    Tool calling Sí — MCP
    Transporte Parcial (JSON-RPC 2.0) Parcial MCP / A2A
    Reporte de progreso Parcial Sí (ciclo de vida de Task) A2A
    Contexto y memoria Parcial (resources) No Casi nadie — tu harness
    Bucle de ejecución No No Nadie — tu harness
    Permisos No (delega en el host) No Nadie — tu harness

    Los dos juntos te dan el cableado. Ninguno te da el agente portable. Si quieres la comparativa fila a fila de A2A y MCP, la tienes desarrollada en su propio post.

    Mi tesis es incómoda pero creo que es la correcta: el agente reutilizable de verdad todavía no existe, y la frontera no la marca el protocolo sino el harness. Lo que sí podemos hacer hoy es diseñar como si esa capa ya estuviera, para no tener que rehacerlo cuando llegue.


    Los tres pilares de la interoperabilidad de agentes de IA

    Un agente portable necesita tres propiedades arquitectónicas: concurrencia (se activa por eventos, no por su posición en una cadena), awareness o conciencia del entorno (lo consulta en vez de suponerlo) y adaptividad (decide con estado de runtime, no con un orden hardcodeado).

    Compartir un agente es más que mover su código. Un agente que aterriza en un entorno nuevo tiene que poder trabajar sin esperar a una secuencia predefinida, entender qué hay a su alrededor y ajustar su comportamiento a lo que encuentra.

    1. Concurrencia: fuera los pipelines secuenciales

    Casi todos los sistemas multiagente que reviso son esto:

    // Acoplado: el paso 3 no existe hasta que termina el 2.
    const spec = await specAgent.run(input);
    const code = await codeAgent.run(spec);
    const review = await reviewAgent.run(code);
    

    Esto no es un sistema de agentes. Es una función con tres llamadas caras. Que use await no lo salva: el orden está hardcodeado en el código que las invoca, así que el agente de revisión no puede existir fuera de ese fichero. Es el mismo error de fondo que hace fallar al mega-prompt cuando el sistema crece.

    La alternativa es que cada agente sea una unidad independiente que decide si un evento le incumbe:

    interface Agent {
      readonly id: string;
      readonly capabilities: readonly string[];
      // ¿Este evento va conmigo?
      accepts(event: AgentEvent): boolean;
      handle(event: AgentEvent, ctx: RuntimeContext): Promise<AgentEvent[]>;
    }
    

    Ningún agente bloquea a otro. Ninguno conoce su posición en una cadena. Cuando esto está bien hecho, a menudo descubres que no necesitas orquestador.

    2. Awareness: el entorno se consulta, no se supone

    Un agente acoplado solo conoce su prompt. Lo que hay alrededor está implícito en el orden de las llamadas.

    Un agente portable pregunta. Necesita dos cosas: un canal de eventos compartido y un registro de participantes.

    type Unsubscribe = () => void;
    
    type AgentEventType =
      | 'spec.ready'
      | 'code.changed'
      | 'review.blocked'
      | 'test.requested';
    
    interface AgentEvent {
      readonly type: AgentEventType;
      readonly source: string; // id del agente que lo emitió
      readonly payload: unknown;
      readonly at: number;
    }
    
    interface AgentDescriptor {
      readonly id: string;
      readonly capabilities: readonly string[];
    }
    
    interface Workspace {
      // Quién más está trabajando aquí y qué sabe hacer.
      participants(): readonly AgentDescriptor[];
      publish(event: AgentEvent): void;
      subscribe(handler: (event: AgentEvent) => void): Unsubscribe;
    }
    
    interface RuntimeContext {
      // Todo lo que el agente necesita del entorno donde aterriza.
      readonly workspace: Workspace;
    }
    

    La diferencia práctica: con esto, el mismo agente de revisión funciona en un entorno donde hay tres compañeros y en otro donde está solo, porque en el primer caso lo sabe. Monté el patrón completo en event bus para agentes descentralizados.

    3. Adaptividad: la decisión sale del estado, no del orden

    El tercer pilar es el que casi nadie implementa, y es el que separa un agente de un script con LLM dentro.

    async function handle(
      event: AgentEvent,
      ctx: RuntimeContext,
    ): Promise<AgentEvent[]> {
      const emit = (type: AgentEventType, payload: unknown): AgentEvent => ({
        type,
        source: 'reviewer',
        payload,
        at: Date.now(),
      });
    
      const findings = await runReview(event.payload, ctx);
      if (findings.length === 0) return [];
    
      // Si hay alguien capaz de ejecutar tests, delego. Si no, bloqueo.
      const peers = ctx.workspace.participants();
      const hasTester = peers.some((p) => p.capabilities.includes('test.run'));
    
      return hasTester
        ? [emit('test.requested', { findings })]
        : [emit('review.blocked', { findings })];
    }
    

    Fíjate en lo que no hay: ningún if (step === 'review'). La rama se decide con estado de runtime, no con una posición hardcodeada. Ese agente se comporta distinto en dos entornos distintos sin que nadie toque su código.

    Las tres juntas son las caras del mismo triángulo: independencia, conexión, colaboración. Si te falta una, el agente no viaja.

    Esta forma de pensar el sistema —el agente como unidad con contrato propio, no como paso de un flujo— es la que trabajo en el curso Construye con IA: de la idea al producto con Claude Code.


    Lo que se desbloquea cuando los agentes viajan

    Construyes un agente una vez y lo distribuyes en todas partes. Combinas especialistas en lugar de reconstruirlos. Y puedes monetizar una capacidad sin vender la aplicación entera alrededor.

    El cambio de fondo es de economía, no de ingeniería. En un ecosistema interoperable, cada agente nuevo aumenta el valor de todos los demás. Hoy cada agente nuevo aumenta el valor de exactamente un repositorio.


    Cómo diseñar hoy un agente portable en tu proyecto

    No hace falta esperar a que se asiente ningún estándar. Cinco decisiones que puedes tomar esta semana:

    1. Separa el agente de su runtime. El agente es un objeto con capacidades declaradas y un handle. Quién lo arranca y cada cuánto es responsabilidad de otro fichero.
    2. Expón sus herramientas vía MCP, aunque hoy solo lo use tu propio harness. Es la capa que ya está estandarizada; aprovéchala.
    3. Saca el contexto del prompt. Ficheros, un store, lo que sea. Si la memoria del agente vive en la cadena de mensajes de tu framework, tu agente es tu framework.
    4. No hardcodees la secuencia. Sustituye await a(); await b(); por eventos tipados. Si te cuesta imaginarlo, empieza por construir un agente de IA desde cero y verás dónde está cada costura.
    5. Escribe el contrato antes que el código. Qué acepta, qué emite, qué permisos pide, qué garantiza. Es revisión por contrato aplicada al diseño, y el mismo principio que desarrollo en Spec-Driven Development: la especificación es la parte portable; la implementación es desechable.

    Si el punto 5 te suena a burocracia, empieza por el ebook gratuito Revisión por Contrato. Va justo de eso: definir por escrito qué puede y qué no puede hacer un agente antes de dejarlo suelto en tu repo.

    En Dominicode Labs están las masterclasses y los repos donde desmonto este tipo de decisiones de arquitectura con el código delante y sin diapositivas.

    Elige hoy uno de tus agentes y responde a una sola pregunta: si mañana cambias de harness, ¿qué sobrevive? Si la respuesta es "el prompt", ya sabes por dónde empezar.


    Preguntas frecuentes

    ¿MCP no resuelve ya la interoperabilidad de agentes de IA?

    Resuelve una parte importante, no el conjunto. MCP estandariza cómo un agente descubre e invoca herramientas y cómo un servidor le sirve contexto como recurso, así que el mismo servidor vale para clientes distintos y eso elimina una de las seis capas de acoplamiento. Hay trabajo en curso para llevarlo más lejos —la extensión Tasks y el grupo de Skills over MCP—, pero a día de hoy nada de eso está cerrado. Pero un agente no es solo el conjunto de herramientas que puede llamar: es también su bucle, su gestión de contexto, su política de permisos y su forma de reportar. Nada de eso está cubierto. Puedes tener dos agentes que hablan MCP perfectamente y seguir sin poder mover ninguno de los dos al entorno del otro.

    Entonces, ¿A2A sobra?

    Al contrario: resuelve un problema distinto y complementario. A2A estandariza el intercambio entre agentes —descubrimiento de capacidades, envío de tareas, mensajes y progreso— y con eso puedes hacer que tu sistema hable con un agente que corre en otra empresa. Lo que no te da es portabilidad: sigues invocando un agente remoto que vive en su propio runtime. MCP y A2A son cableado en dos capas diferentes. El agente portable es otra discusión.

    ¿Concurrencia no es simplemente lanzar todo con Promise.all?

    No. Promise.all lanza varias llamadas a la vez, pero el punto donde se lanzan y el punto donde se espera siguen escritos en tu código: tú decides qué va junto y dónde se bloquea. Lo que pido aquí es otra cosa, desacoplamiento temporal: cada agente se activa por su cuenta cuando aparece un evento que le incumbe, sin que nadie coordine el orden desde fuera. La prueba está en si puedes añadir un agente nuevo al sistema sin tocar el fichero que orquesta. Si tienes que tocarlo, tienes llamadas concurrentes, no agentes autónomos.

    ¿No es sobreingeniería para un agente que solo uso yo?

    Depende de cuánto te haya costado ese agente. Si es un script de veinte líneas, sí, es sobreingeniería. Si le has dedicado semanas a afinar su criterio —y en revisión de código o extracción de datos eso pasa rápido— entonces lo que estás haciendo al acoplarlo es tirar ese trabajo cada vez que cambies de herramienta. Y cambiamos de herramienta cada pocos meses. En mi experiencia, separar el agente de su runtime cuesta una tarde; reescribirlo entero, varias semanas.

    Mi agente ya está acoplado al harness. ¿Por dónde empiezo?

    Por el contexto, que suele ser lo más doloroso y lo que antes se rompe. Saca de la cadena de mensajes del framework todo lo que sea conocimiento del agente y llévalo a ficheros o a un store propio. Después extrae la lógica de decisión a una función pura que recibe estado y devuelve eventos. Cuando tengas esas dos piezas, el runtime original pasa a ser un adaptador fino de treinta líneas, y escribir un segundo adaptador para otro entorno deja de dar miedo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Clean Architecture en Frontend: Cómo estructurar tus aplicaciones para sobrevivir a la era de la IA

    Clean Architecture en Frontend: Cómo estructurar tus aplicaciones para sobrevivir a la era de la IA

    Hace unos meses audité una aplicación de un cliente que tenía más de 50 componentes. Cuando abrí el archivo de un simple formulario de checkout, me encontré con 750 líneas de código: llamadas directas a fetch, manipulación de tokens de autenticación, formateo de fechas, cálculo de impuestos y renderizado visual de botones. Todo apretado en el mismo sitio.

    El cliente me decía frustrado: "Intentamos usar agentes de IA para añadir un nuevo método de pago y el agente rompe la aplicación entera cada vez".

    El problema no era la herramienta de IA. El problema es que los modelos de lenguaje necesitan fronteras claras para no perderse. Cuando mezclas UI, estado y lógica de negocio en una bola de barro, obligas a la IA a interpretar miles de líneas irrelevantes para hacer un cambio trivial.

    Clean Architecture en frontend no es un capricho teórico. Es la única forma de construir aplicaciones mantenibles que tanto los humanos como los agentes de IA puedan modificar sin romper producción.

    El problema del espagueti en la capa de presentación

    Durante años nos enseñaron que organizar una app frontend consistía en crear carpetas como /components, /services y /utils.

    Esa estructura por "tipo de archivo" suele degenerar en componentes gigantescos que contienen:

    • Lógica de UI (animaciones, estados de modales, hovers).
    • Lógica de Negocio (validación de carritos, cálculo de descuentos, reglas de usuario).
    • Lógica de Infraestructura (llamadas a la API HTTP, almacenamiento en localStorage).

    Cuando un agente de IA intenta refactorizar o añadir una funcionalidad a un componente así, el resultado son alucinaciones, código duplicado y efectos secundarios inesperados. Como demostramos en nuestro post sobre programación defensiva en TypeScript, la falta de contratos claros es la causa principal de fallos silenciosos.

    Las 3 Capas de Clean Architecture en Frontend

    Para que una aplicación frontend sea desacoplada y amigable para el desarrollo asistido por IA, debemos dividir el proyecto en tres capas concéntricas con reglas de dependencia estrictas:

    ┌─────────────────────────────────────────────────────────┐
    │ Presentación (React / Angular / Vue Components)         │
    │  └─► Llaman a Casos de Uso                             │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Dominio (Entities, Use Cases, Interfaces Repos)   │
    │     │  └─► Cero dependencias externas o de UI           │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Infraestructura (HTTP Repositories, LocalStorage)    │
    │  │  └─► Implementan las Interfaces del Dominio          │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    1. Capa de Dominio (El Corazón de tu App)

    Contiene las Entidades y los Casos de Uso pura lógica de TypeScript.

    • Regla de oro: No importa qué framework estés usando. La capa de dominio NO debe importar nada de React, Angular, Vue o librerías HTTP.
    • Ejemplo: CalcularDescuentoUseCase, UsuarioEntity, CarritoInterface.

    2. Capa de Infraestructura (Conexiones Externas)

    Implementa las interfaces definidas por el dominio para interactuar con APIs externas, bases de datos o servicios del navegador.

    • Ejemplo: UserHttpRepository que implementa UserRepository, clientes Axios/Fetch, adaptores de localStorage.

    3. Capa de Presentación (Vista e Interacción)

    Se limita a pintar los datos y capturar eventos del usuario. Sus componentes invocan los Casos de Uso y reaccionan al estado presentado.

    • Ejemplo: Componentes visuales, señales/hooks de estado UI, botones, maquetación.

    Por qué esta arquitectura multiplica la velocidad de la IA

    Cuando tu aplicación sigue Clean Architecture, trabajar con asistentes como Claude Code o Cursor se vuelve ridículamente eficiente:

    1. Prompting aislado: Si necesitas cambiar una regla de negocio (ej. "los clientes VIP tienen un 15% de descuento en lugar del 10%"), solo le pides a la IA que modifique el archivo CalcularDescuentoUseCase.ts. La IA no toca ni un solo archivo de UI.
    2. Generación automática de Tests: Probar un Caso de Uso puro de TypeScript no requiere renderizar componentes ni simular el DOM (jsdom/happy-dom). La IA puede escribir y validar 20 unit tests puramente lógicos en 5 segundos.
    3. Sustitución de UI sin riesgo: Puedes pedirle a un agente de IA que rediseñe un componente visual entero desde cero, sabiendo que la lógica de negocio subyacente permanecerá intacta.

    Como explicamos al analizar el graph engineering, proporcionarle a la IA un mapa claro de dependencias previene que introduzca acoplamientos indeseados.

    Y recuerda: aunque Clean Architecture aporta enormes beneficios en apps de tamaño mediano y grande, en nuestra guía sobre cuándo NO usar Spec-Driven Development analizamos los casos de uso donde soluciones más simples resultan más recomendables.


    Separar las responsabilidades de tu código no es solo una buena práctica de ingeniería; es la mejor inversión para escalar aplicaciones en la era de los agentes autónomos.

    Si quieres aprender a diseñar arquitecturas robustas y escalables desde cero, échale un vistazo a los Cursos de Dominicode. Y si quieres construir proyectos complejos en un entorno colaborativo de alto nivel, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿No añade Clean Architecture demasiada sobrecarga de archivos en proyectos pequeños?

    Para proyectos tipo "landing page" o prototipos simples de pocas semanas, Clean Architecture puede resultar excesiva. Sin embargo, para aplicaciones que van a vivir en producción durante años o mantenidas por equipos, el ahorro en mantenimiento compensa con creces la estructura inicial.

    ¿Dónde encaja la gestión de estado (Redux, NgRx, Zustand, Signals)?

    La gestión de estado vive en la capa de Presentación/UI. Los stores o señales consumen los Casos de Uso del Dominio y exponen el estado procesado a los componentes visuales.

    ¿Cómo interactúa el Dominio con las llamadas a la API sin importar HTTP Client?

    El Dominio define una interfaz abstracta (ej. export interface UserRepository { getById(id: string): Promise<User>; }). La Capa de Infraestructura implementa esa interfaz con llamadas HTTP reales mediante inyección de dependencias.

    ¿Por qué los agentes de IA entienden mejor la Clean Architecture?

    Porque los límites de responsabilidad están definidos a nivel de carpetas y contratos. La IA no tiene que adivinar dónde termina la lógica de interfaz y dónde empieza la validación de negocio.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.