Tag: Angular

  • Arquitectura orientada a eventos en el frontend: 5 problemas

    Arquitectura orientada a eventos en el frontend: 5 problemas

    Pulsas "Cancelar pedido". El botón responde, sale un toast verde, la API devuelve 202 Accepted. Recargas la lista para comprobarlo y el pedido sigue ahí, en estado "Pagado", como si no hubieras hecho nada.

    Vuelves a pulsar. Ahora hay dos solicitudes de cancelación en una cola que no ves. Abres un ticket de soporte. Diez segundos después, el pedido aparece cancelado.

    Nadie ha roto nada. El backend migró a una arquitectura orientada a eventos y el frontend siguió programado como si cada petición devolviera la verdad al instante.

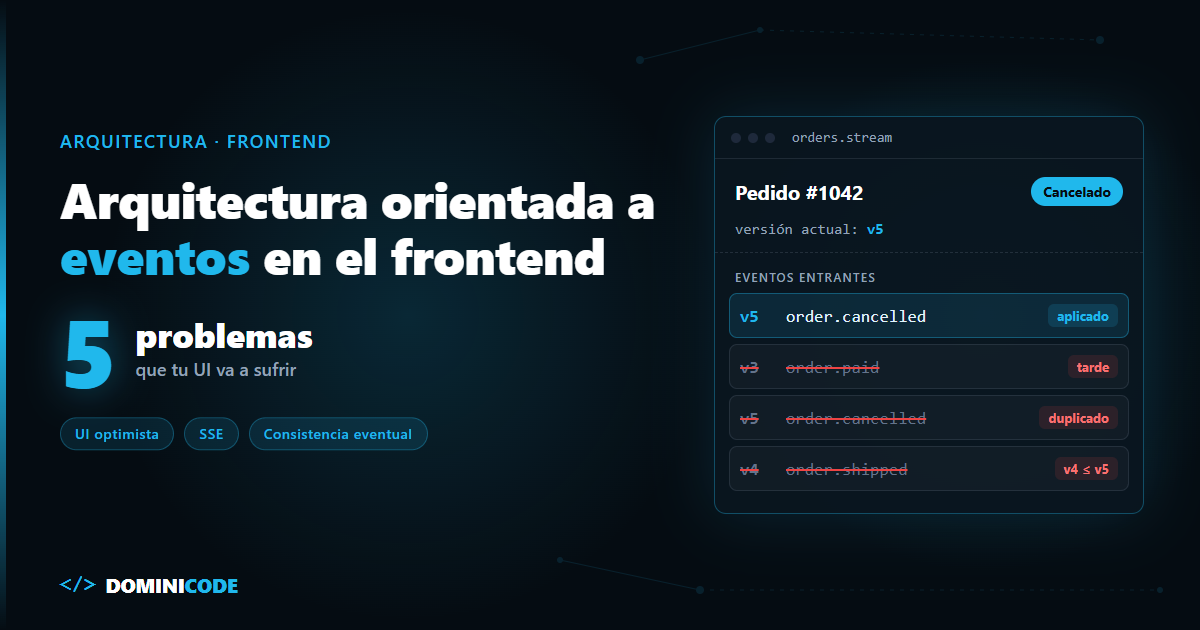
    En corto: con una arquitectura orientada a eventos en el backend, el frontend deja de recibir la verdad en la respuesta HTTP: le llega tarde, desordenada y a veces incompleta. Los cinco problemas típicos son la consistencia eventual visible, la UI optimista sin reconciliación, los eventos fuera de orden o duplicados, los huecos tras una reconexión y el acoplamiento al schema del backend. Se resuelven con versión por entidad, estados de sincronización explícitos y validación en el borde.

    ¿Qué cambia en el frontend con una arquitectura orientada a eventos?

    La arquitectura orientada a eventos es un estilo en el que los servicios se comunican publicando hechos ya ocurridos ("pedido cancelado") en lugar de llamarse entre sí, de modo que, para el frontend, cada escritura se confirma de forma asíncrona y el estado que lee converge con retraso.

    Tu POST ya no significa "hecho". Significa "recibido, ya veremos". Si el backend usa CQRS, el modelo de lectura se actualiza cuando el proyector procese el evento, como explico en cómo sincronizar el read model en CQRS.

    El lado servidor (idempotencia de consumidores, outbox, colas de mensajes fallidos) es otra historia. Aquí hablo de lo que le pasa a tu pantalla.

    Los 5 problemas de la arquitectura orientada a eventos en el frontend

    # Síntoma en la UI Causa Solución Coste o riesgo de la solución
    1 Guardo, recargo y mi cambio no está El read model aún no ha procesado el evento Devolver versión en la respuesta y esperar a verla (evento o polling acotado) Más lógica de espera; hace falta un timeout con salida clara
    2 La UI dice "hecho" y minutos después falló UI optimista sin estado pending ni rollback Estados pending / confirmed / failed y compensación visible Más estados que diseñar y testear
    3 Un dato vuelve a un valor antiguo Eventos fuera de orden o duplicados por WebSocket/SSE Versión por entidad: descartar todo evento con versión ≤ la actual El backend tiene que emitir una versión monotónica por entidad
    4 Dos pestañas muestran datos distintos Se cayó el socket y se perdieron eventos id: en SSE + resync con snapshot al reconectar Una petición extra en cada reconexión
    5 Un deploy del backend rompe una pantalla El cliente consume eventos de dominio crudos Eventos de integración pensados para el cliente + Zod en el borde Una capa más (BFF o traductor) que mantener

    Problema 1: consistencia eventual que el usuario sí ve

    La respuesta corta: no relances la lectura a ciegas; pide al backend la versión que generó tu escritura y espera a verla.

    El patrón roto es post().then(() => refetch()). Ese refetch llega antes que el proyector y lee el estado viejo. El usuario ve su cambio "deshecho".

    La garantía que necesitas se llama read-your-own-writes. Para dársela desde el cliente, la respuesta del comando debe incluir algo comparable: la versión resultante de la entidad.

    // La API responde 202 con la versión que asignó al aceptar el comando (el backend debe conocerla ya)
    type CommandAccepted = { orderId: string; expectedVersion: number };
    
    async function waitForVersion(
      { orderId, expectedVersion }: CommandAccepted,
      read: (id: string) => Promise<{ version: number }>,
      { attempts = 5, delayMs = 400 } = {},
    ): Promise<boolean> {
      for (let i = 0; i < attempts; i++) {
        const current = await read(orderId);
        if (current.version >= expectedVersion) return true;
        if (i < attempts - 1) await new Promise((r) => setTimeout(r, delayMs * (i + 1)));
      }
      return false; // no ha convergido: la UI lo dice, no lo esconde
    }
    

    Si ya tienes un stream de eventos abierto, no hagas polling: espera al evento con esa versión.

    Problema 2: UI optimista sin rollback

    La respuesta corta: una UI optimista sin estado pending no es optimista, es mentirosa.

    El debate es viejo. En el hilo de Hacker News sobre la UI optimista de Meteor, de mayo de 2015, un usuario lo planteó sin rodeos: "Isn't this just lying to the user?". Las respuestas del mismo hilo dan la salida: mostrar el cambio al instante, pero señalar cuándo está persistido, como los dos checks de WhatsApp.

    En event-driven el fallo puede llegar minutos después, como evento order.cancel_rejected, con el usuario ya en otra pantalla. Necesitas un estado de sincronización por entidad, no un booleano de loading.

    export type SyncState = 'pending' | 'confirmed' | 'failed';
    
    export interface OrderView {
      id: string;
      status: 'paid' | 'cancelled' | 'shipped';
      version: number;
      sync: SyncState;
      previous?: OrderView; // para revertir si el backend rechaza
    }
    

    pending se pinta distinto (opacidad, "Cancelando…"). failed revierte a previous y avisa con un mensaje que diga qué pasó y qué puede hacer el usuario. Eso es compensación visible: la UI admite que se adelantó.

    Problema 3: eventos fuera de orden o duplicados

    La respuesta corta: cada evento trae la versión de la entidad y el cliente ignora todo lo que no sea más nuevo que lo que ya tiene.

    Con varios productores o reintentos, puede llegarte la versión 4 de un pedido antes que la 3. Si aplicas por orden de llegada, el pedido "vuelve" a pagado.

    Un store con signals de Angular (estables desde Angular 17). La convergencia vive en apply:

    import { Injectable, computed, signal } from '@angular/core';
    
    @Injectable({ providedIn: 'root' })
    export class OrdersStore {
      private readonly byId = signal<Record<string, OrderView>>({});
      readonly orders = computed(() => Object.values(this.byId()));
    
      /** Aplica un evento confirmado del servidor. Idempotente y tolerante al desorden. */
      apply(e: { orderId: string; version: number; status: OrderView['status'] }) {
        this.byId.update((current) => {
          const prev = current[e.orderId];
          if (prev && prev.version >= e.version) return current; // viejo o duplicado
          return {
            ...current,
            [e.orderId]: { id: e.orderId, status: e.status, version: e.version, sync: 'confirmed' },
          };
        });
      }
    
      /** El backend rechazó el comando: vuelve al estado anterior y márcalo como fallido. */
      reject(orderId: string) {
        this.byId.update((c) => {
          const prev = c[orderId];
          if (!prev?.previous) return c;
          return { ...c, [orderId]: { ...prev.previous, sync: 'failed' } };
        });
      }
    
      markPending(orderId: string, status: OrderView['status']) {
        this.byId.update((c) => {
          const prev = c[orderId];
          if (!prev) return c;
          return { ...c, [orderId]: { ...prev, status, sync: 'pending', previous: prev.previous ?? prev } };
        });
      }
    }
    

    Fíjate en que el guard de versión ya cubre los duplicados de la misma entidad. El dedupe por eventId solo hace falta para eventos sin versión (notificaciones, contadores). Y si lo añades, acota el Set o crecerá sin límite en una pestaña abierta todo el día. Ojo: reject no tiene guard; en producción relaciona el rechazo con un commandId para que un cancel_rejected duplicado no revierta un intento posterior.

    Para un store convergente, signals bastan (si dudas, mira cuándo usar RxJS o signals en Angular). Los servicios con estado y signals los trabajo paso a paso en el curso de Angular Moderno.

    Problema 4: reconexión y huecos en el stream de eventos

    La respuesta corta: el stream nunca es completo; al reconectar, pide un snapshot y fusiónalo con el mismo guard de versión.

    Si el servidor envía id: en cada evento, EventSource guarda el último y, al reconectar, lo manda en la cabecera Last-Event-ID (está en la especificación de server-sent events del WHATWG) para que el servidor reenvíe lo perdido. Eso depende de que el servidor guarde histórico y de que ningún proxy se coma la cabecera. Es una optimización, no una garantía.

    type OrderSnapshot = { orderId: string; version: number; status: OrderView['status'] };
    
    export function connect(store: OrdersStore, loadSnapshot: () => Promise<OrderSnapshot[]>) {
      const es = new EventSource('/api/orders/stream');
    
      // 'open' se dispara en la conexión inicial y en cada reconexión
      es.addEventListener('open', async () => {
        const snapshot = await loadSnapshot(); // estado actual + versión de cada pedido
        snapshot.forEach((o) => store.apply(o)); // el guard descarta lo que ya es viejo
      });
    
      // Solo llegan aquí los mensajes enviados con "event: order"; sin ese campo van a 'message'
      es.addEventListener('order', (msg: MessageEvent<string>) => {
        const event = parseOrderEvent(msg.data); // ver problema 5
        if (!event) return;
        if (event.type === 'order.status_changed') store.apply(event);
        else store.reject(event.orderId); // order.cancel_rejected
      });
    
      es.addEventListener('error', () => {
        // CONNECTING: el navegador reintenta solo. CLOSED: no volverá; reconecta tú (sin Last-Event-ID: el snapshot cubre el hueco).
        if (es.readyState === EventSource.CLOSED) {
          setTimeout(() => connect(store, loadSnapshot), 3000);
        }
      });
    
      return es;
    }
    

    Snapshot y eventos pasan por el mismo apply. Da igual qué llegue primero: gana la versión más alta.

    Problema 5: acoplar la UI al schema interno del backend

    La respuesta corta: el frontend no debe consumir eventos de dominio crudos; necesita eventos de integración estables y validados al entrar.

    Los eventos de dominio cambian cuando cambia el modelo interno del servicio. Si tu componente lee event.payload.aggregate.lines[0].sku, cualquier refactor del backend rompe la pantalla en producción, sin error de compilación.

    Dos capas: un BFF o traductor que publique eventos pensados para el cliente (planos, versionados, solo lo que la UI pinta) y validación en el borde con Zod 4, para que un mensaje inesperado se descarte en vez de corromper el store.

    import { z } from 'zod';
    
    const OrderEvent = z.discriminatedUnion('type', [
      z.object({
        type: z.literal('order.status_changed'),
        eventId: z.string(),
        orderId: z.string(),
        version: z.number().int().nonnegative(),
        status: z.enum(['paid', 'cancelled', 'shipped']),
      }),
      z.object({
        type: z.literal('order.cancel_rejected'),
        eventId: z.string(),
        orderId: z.string(),
        version: z.number().int().nonnegative(),
        reason: z.string(),
      }),
    ]);
    export type OrderEventData = z.infer<typeof OrderEvent>;
    
    export function parseOrderEvent(raw: string): OrderEventData | null {
      let json: unknown;
      try {
        json = JSON.parse(raw);
      } catch {
        return null;
      }
      const result = OrderEvent.safeParse(json);
      if (!result.success) {
        console.warn('Evento descartado', result.error.issues);
        return null;
      }
      return result.data;
    }
    

    safeParse no lanza: te devuelve success y decides tú. Con discriminatedUnion, el resto del código recibe tipos estrechos según type. Si quieres llevar este patrón a todo el estado global, lo desarrollé en gestión de estado global con Zod y signals, y los schemas, transformaciones y errores de Zod los cubro a fondo en el curso de Zod para TypeScript.

    Cuándo NO usar estos patrones de arquitectura orientada a eventos en el frontend

    UI optimista en pagos, stock o cualquier acción irreversible. Si el usuario va a cerrar la pestaña creyendo que pagó, el pending bonito no basta. Ahí muestra "Procesando pago" y espera a la confirmación. El propio hilo de HN citado arriba separa preferencias de interfaz (optimismo sin problema) de facturación o mensajería (cuidado).

    Tiempo real cuando un refetch basta. Un panel de administración que se consulta cinco veces al día no necesita SSE ni resync. Un refetch al volver a la pestaña y un polling acotado tras cada comando resuelven casi todo con una fracción del código. Herramientas como las que comparo en httpResource vs TanStack Query ya traen revalidación al enfocar.

    Sin versión monotónica del backend, el guard no sirve. Comparar updatedAt entre máquinas con relojes distintos no es una versión. Si el backend no puede emitir una versión por entidad, negocia eso antes de escribir una línea de cliente.

    El BFF no es gratis. Para un solo frontend y un equipo pequeño, un mapper tipado en el cliente con Zod puede ser suficiente. El BFF compensa cuando hay varios clientes o el backend cambia más rápido que la UI.

    SSE sin HTTP/2 y con muchas pestañas. Según MDN, sin HTTP/2 el navegador limita a 6 las conexiones abiertas por dominio, y Chrome y Firefox lo marcaron como "Won't fix". Con siete pestañas de tu app, la séptima se queda colgada. Sirve con HTTP/2 o con una sola conexión compartida entre pestañas.

    Lo que puedes hacer hoy

    Abre el servicio que recibe eventos en tu app y busca una cosa: ¿cada mensaje trae versión por entidad y tu store la compara antes de aplicar? Si la respuesta es no, ese es tu primer cambio. Es la pieza que hace posibles las otras cuatro.

    Después, escribe el test que casi nadie escribe: aplica el evento versión 4, luego el versión 3, y comprueba que el estado sigue en 4. Si quieres montar esa batería con Jest y Testing Library en Angular, el curso de Testing en Angular cubre cómo testear servicios con estado y componentes que reaccionan a él.

    Preguntas frecuentes

    ¿La arquitectura orientada a eventos obliga a usar WebSockets en el frontend?

    No. El frontend puede seguir con HTTP y polling acotado por versión. WebSockets o SSE compensan cuando el usuario necesita ver cambios que no ha provocado él.

    ¿SSE o WebSockets para recibir eventos del backend?

    Si el flujo es solo del servidor al cliente, SSE es más simple: va sobre HTTP, reconecta solo y, si el servidor manda id: en cada evento, envía Last-Event-ID sin que escribas código. WebSockets tienen sentido cuando el cliente también emite muchos mensajes por el mismo canal, como en un chat o en edición colaborativa.

    ¿Cómo evito que un evento antiguo sobrescriba uno nuevo en el cliente?

    Pide al backend una versión monotónica por entidad en cada evento. En el store, descarta cualquier evento cuya versión sea menor o igual que la que ya tienes. Ese mismo guard resuelve también los duplicados de la misma entidad.

    ¿Qué hago si se pierden eventos mientras el socket estaba caído?

    Asume que siempre puede pasar. Al reconectar, pide un snapshot del estado con la versión de cada entidad y fusiónalo con el mismo guard que usas para los eventos. Last-Event-ID ayuda a recuperar lo perdido, pero depende de que el servidor guarde histórico.

    ¿Es mala práctica la UI optimista en una arquitectura orientada a eventos?

    No, siempre que tenga estados explícitos (pending, confirmed, failed) y una forma visible de revertir. Es mala práctica cuando la UI declara éxito antes de la confirmación en operaciones irreversibles, como pagos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • CSS moderno: animar display none con @starting-style y @scope

    CSS moderno: animar display none con @starting-style y @scope

    Te ha pasado. Pones transition: opacity 0.3s en el modal y aparece de golpe. Lo cierras y desaparece de golpe. El DevTools marca la transición como aplicada, y no hace nada.

    Acabas con un setTimeout de 300 ms que oculta el modal cuando "ya debería" haber terminado. Y en el mismo proyecto, otro clásico: una card que no se deja sobrescribir porque alguien escribió .catalog .card .price, y la salida fue un !important.

    Los dos problemas tienen hoy solución nativa en CSS moderno, sin librerías.

    En corto: @starting-style le da al navegador el estado inicial de un elemento que sale de display: none, y transition-behavior: allow-discrete retrasa el cambio a display: none hasta que acaba la salida. @scope limita estilos a un trozo del DOM sin añadir especificidad y, si dos reglas empatan, gana la raíz más cercana. Todo funciona en los navegadores principales en 2026, salvo animar display en Firefox y la propiedad overlay fuera de Chromium.

    Por qué no puedes animar display none con una transición normal

    display es una propiedad discreta: no tiene valores intermedios, así que el navegador la cambia de golpe y arrastra contigo el resto de la transición.

    Hay dos fallos distintos. En la salida, el elemento pasa a display: none en el primer fotograma y la opacidad no llega a verse. En la entrada, el elemento no existía en el árbol de renderizado, así que el navegador no tiene un "antes" desde el que transicionar: pinta directamente el estado final.

    No es un problema nuevo: la pregunta Transitions on the CSS display property lleva abierta en Stack Overflow desde julio de 2010, con más de 2,6 millones de visitas y respuestas que durante años fueron variantes del mismo hack con visibility, max-height o setTimeout.

    La salida se arregla con allow-discrete. La entrada, con @starting-style. Necesitas las dos.

    ¿Qué es @starting-style?

    @starting-style es una regla que define los valores desde los que transiciona un elemento en su primer pintado, por ejemplo cuando pasa de display: none a visible.

    Va acompañada de transition-behavior: allow-discrete, que hace que una propiedad discreta participe en la transición. Según MDN, cuando el destino es display: none el cambio se aplica al 100 % de la duración, y cuando el origen es none se aplica al 0 %. Es justo lo que quieres: visible durante toda la animación en ambos sentidos.

    Este es un <dialog> de confirmación que entra y sale deslizándose, sin una línea de JavaScript para la animación:

    dialog.confirm {
      opacity: 0;
      translate: 0 1rem;
      transition:
        opacity 0.25s ease-out,
        translate 0.25s ease-out,
        display 0.25s allow-discrete,
        overlay 0.25s allow-discrete;
    }
    
    dialog.confirm[open] {
      opacity: 1;
      translate: 0 0;
    }
    
    @starting-style {
      dialog.confirm[open] {
        opacity: 0;
        translate: 0 1rem;
      }
    }
    
    <button type="button" onclick="document.querySelector('.confirm').showModal()">
      Eliminar proyecto
    </button>
    
    <dialog class="confirm">
      <p>¿Seguro? Esta acción no se puede deshacer.</p>
      <form method="dialog">
        <button value="cancel">Cancelar</button>
        <button value="ok">Eliminar</button>
      </form>
    </dialog>
    

    Tres detalles.

    El bloque @starting-style va después de la regla [open]: tienen la misma especificidad y, si lo pones antes, la regla normal lo pisa.

    La propiedad overlay solo importa en elementos del top layer (<dialog> modal, popovers): sin ella, el navegador saca el elemento de la capa superior antes de que termine la salida. MDN avisa de que en un fundido simple apenas se nota.

    Y overlay solo existe en Chromium: en el resto se ignora sin romper nada.

    La animación es la parte fácil del modal: el foco al abrir y cerrar importa más, y lo vimos en cómo gestionar el foco con Angular Aria.

    Si prefieres @keyframes, también puedes meter display dentro. Para un toast que se va:

    .toast.is-leaving {
      animation: toast-out 0.3s ease-in forwards;
    }
    
    @keyframes toast-out {
      to {
        opacity: 0;
        translate: 0 0.5rem;
        display: none;
      }
    }
    

    Antes, ese display se ignoraba. Hoy, en Chrome y Safari, el toast se desvanece y al final deja de ocupar espacio. Con @keyframes no necesitas @starting-style: el primer fotograma ya es el punto de partida.

    Si lo que animas es un cambio de vista entero y no un elemento suelto, la herramienta es otra: lo contamos en el post sobre View Transitions en React 19.3.

    Soporte en navegadores: lo que el CSS moderno ya cubre en 2026

    Todo lo de este post está disponible en Chrome, Edge, Safari y Firefox salvo animar display y la propiedad overlay. Los datos salen de MDN browser-compat-data y del estado Baseline de webstatus.dev, consultados en octubre de 2026:

    Característica Chrome / Edge Firefox Safari Estado Baseline
    @starting-style 117 129 17.5 Newly available (agosto 2024)
    transition-behavior: allow-discrete 117 129 17.4 Newly available (agosto 2024)
    Animar display (keyframes y transición) 117 No (bug 1834877) 18 Limited availability
    overlay 117 No No Limited availability
    @scope 118 146 17.4 (fallo en 26.0–26.3 con <input>/<textarea>) Newly available (24 marzo 2026)

    Chrome soporta @scope desde la 118; webstatus.dev marca la 143 porque cuenta también el tratamiento de & dentro de @scope como :where(:scope). En Chrome, display dentro de @keyframes funciona desde la 116; la 117 es la de las transiciones.

    La lectura práctica: en Firefox la entrada con @starting-style funciona, porque el elemento pasa de none a visible al instante igualmente y la opacidad sí transiciona. La salida no: el elemento desaparece de golpe. Es mejora progresiva pura, nadie se queda sin modal.

    ¿Qué es @scope en CSS?

    @scope es una regla que aplica estilos solo dentro de un subárbol del DOM, delimitado por una raíz y, opcionalmente, por un límite inferior, sin sumar especificidad a los selectores de dentro.

    Esa última parte es la clave. Según MDN, los selectores dentro de @scope se comportan como si llevaran :where(:scope) delante:

    @scope (.product-card) {
      img { aspect-ratio: 4 / 3; object-fit: cover; }   /* 0-0-1 */
      :scope { border: 1px solid #d0d7de; }             /* 0-1-0: estiliza la propia card */
      :scope img { border-radius: 8px; }                /* 0-1-1 */
    }
    

    .product-card img pesa 0-1-1; dentro del scope, img pesa 0-0-1, y cualquier utilidad posterior lo sobrescribe sin pelear. Para tocar la raíz usas :scope, que sí suma como una clase. También admite varias raíces: @scope (.product-card, .cart-line) { … }.

    El donut: parar antes de llegar al contenido ajeno

    La card tiene un bloque de reseñas con avatares. No quieres que el aspect-ratio de las fotos de producto los deforme:

    @scope (.product-card) to (.card-reviews) {
      img { aspect-ratio: 4 / 3; object-fit: cover; }
    }
    

    La raíz es inclusiva (:scope la alcanza) y el límite es exclusivo: .card-reviews y todo lo que contiene queda fuera. Si quieres incluir el propio .card-reviews pero no sus hijos, usa to (.card-reviews > *). Y si el límite solo debe contar cuando es hijo directo de la card, to (:scope > .card-reviews).

    Proximidad: gana la raíz más cercana

    Una tienda con tema oscuro, un bloque promocional claro y, dentro, una card destacada otra vez oscura:

    <main class="theme-dark">
      <section class="promo theme-light">
        <p class="price">29 €</p>
        <article class="product-card theme-dark">
          <p class="price">49 €</p>
        </article>
      </section>
    </main>
    

    Con .theme-light .price y .theme-dark .price (los dos 0-2-0), el segundo precio coincide con ambas reglas y gana la que esté escrita más abajo en la hoja. Si la clara va última, el precio de la card oscura sale con el color del tema claro. Con @scope:

    @scope (.theme-light) {
      .price { color: #0b5394; }
    }
    
    @scope (.theme-dark) {
      .price { color: #7fd1ff; }
    }
    

    Cada precio toma el color de la raíz con menos saltos hacia arriba en el DOM, da igual el orden. Es la misma idea de "gana el tema más cercano" que vimos con light-dark() en imágenes, pero para cualquier propiedad.

    La proximidad va después de la especificidad y antes del orden de aparición. En el issue #6790 de csswg-drafts el grupo de trabajo debatió entre proximidad "fuerte" (por encima de la especificidad) y "débil", y en marzo de 2023 resolvió que "cascade proximity is weaker than specificity". Un :scope .price le gana a un .price aunque su raíz esté más lejos.

    @scope frente a BEM, CSS Modules y Angular: qué aporta el CSS moderno

    @scope no sustituye a todas las técnicas de aislamiento: ocupa el hueco entre el selector descendiente y el Shadow DOM.

    Técnica Especificidad Límite inferior Riesgo o limitación
    Selector descendiente (.card img) Suma la del ancestro No Se filtra a todo lo anidado y obliga a escalar especificidad
    BEM (.card__img) Una clase plana No hace falta Depende de disciplina humana; nombres largos en el HTML
    CSS Modules Una clase con hash No Requiere build; no protege de estilos globales
    Encapsulación emulada de Angular Suma un atributo [_ngcontent-…] por compuesto No Para traspasar a hijos acabas en ::ng-deep, que Angular desaconseja y mantiene solo por compatibilidad
    @scope Cero (salvo :scope) Sí, con to (…) Los estilos globales siguen entrando; soporte completo solo desde 2026
    Shadow DOM Aislamiento real Sí (frontera del shadow root) Aísla demasiado: tematizar exige custom properties o ::part

    Ojo en Angular: @scope no sustituye a ::ng-deep. Con la encapsulación emulada, el compilador también reescribe los selectores de dentro de @scope con el atributo [_ngcontent-…] del componente, así que no llegan al contenido proyectado. Donde sí encaja es en los estilos globales o en componentes con ViewEncapsulation.None: ahí acota hasta dónde baja una regla, con un límite inferior que la encapsulación no te da. Si montas una arquitectura de componentes desde cero, en el curso de Angular Moderno verás dónde termina la encapsulación del framework y empieza tu CSS.

    Cuándo NO usar @scope (y límites de @starting-style)

    No uses estas herramientas como si fueran aislamiento total o animación garantizada en todos los navegadores.

    @scope no es Shadow DOM. Limita hacia dónde salen tus estilos, no lo que entra: un p { color: red } global sigue pintando dentro. Para un widget embebido en webs ajenas, sigues necesitando Shadow DOM.

    El soporte completo es reciente. Firefox lo sacó en la 146 y Safari corrigió en la 26.4 un fallo que impedía aplicar reglas a <input> y <textarea>. En un Firefox anterior a la 146, la regla dentro de @scope no se aplica y punto. Para estilos críticos de layout, ten una versión fuera de @scope.

    La proximidad cuesta depurar. El DevTools te enseña la regla vencedora, pero no siempre deja claro por qué ganó. Con temas anidados en tres niveles, documenta la intención en el CSS.

    @starting-style no sirve para la salida. Solo define el estado de partida al aparecer. La salida depende de allow-discrete y, en Firefox, no existe para display. Si el elemento se elimina del DOM en vez de ocultarse, espera a transitionend antes de quitarlo.

    display en @keyframes no quita el elemento del layout en Firefox. Con forwards, el toast termina transparente pero ocupando su hueco. Escucha animationend y quítalo con JavaScript si el espacio importa.

    Cómo empezar a usar CSS moderno en tu proyecto

    Empieza por las animaciones de salida: son el cambio de CSS moderno con menos riesgo, porque si el navegador no lo soporta el elemento solo se cierra sin transición.

    Busca en tu código los setTimeout que esperan a una animación antes de poner display: none. Cada uno es candidato a allow-discrete más @starting-style, y en Firefox la salida degrada a un cierre instantáneo que nadie reportará como bug.

    Hacemos estas revisiones sobre código real en Dominicode Labs, y en el canal de YouTube de Dominicode cubrimos las novedades de la plataforma web.

    Preguntas frecuentes

    ¿Qué diferencia hay entre @starting-style y transition-behavior: allow-discrete?

    @starting-style define desde qué valores empieza la transición cuando un elemento aparece. allow-discrete permite que propiedades discretas como display formen parte de la transición. Para animar entrada y salida desde display: none necesitas las dos.

    ¿Necesito la propiedad overlay para animar un dialog?

    Solo para elementos en el top layer, como un <dialog> abierto con showModal() o un popover. Retrasa su salida de la capa superior hasta que termina la transición. Hoy solo la soportan Chrome y Edge; en Safari y Firefox se ignora sin errores.

    ¿@scope añade especificidad a los selectores?

    No. La raíz del scope no suma nada: img dentro de @scope (.product-card) pesa 0-0-1. La excepción es :scope, que cuenta como una pseudoclase y suma 0-1-0.

    ¿Puedo usar @scope en producción en 2026?

    Sí, si tu público usa navegadores actualizados: es Baseline desde el 24 de marzo de 2026, con Firefox 146 y Safari 26.4. Si necesitas cubrir versiones anteriores, mantén fuera de @scope las reglas de las que depende el layout.

    ¿Qué gana si dos reglas de @scope tienen la misma especificidad?

    Gana la que tenga la raíz más cercana al elemento en el DOM, sin importar el orden en la hoja. Si la especificidad es distinta, manda la especificidad: la proximidad solo desempata.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • JavaScript this: objetos, clases, arrow functions y entrevistas

    JavaScript this: objetos, clases, arrow functions y entrevistas

    Copias un método de una clase para usarlo como callback. El método llevaba meses funcionando. Lo pasas como prop a un componente o lo desestructuras, y de pronto llega el clásico: Cannot read properties of undefined. Con setTimeout es peor: no falla, escribe en el objeto equivocado.

    No has perdido el objeto. Has perdido el sitio desde el que JavaScript llama a la función.

    El problema con JavaScript this no es que sea misterioso. Es que casi todos empezamos con una explicación equivocada: “this es el objeto actual”. Suena bien hasta que extraes un método, usas call, escribes una arrow function o entras en una clase.

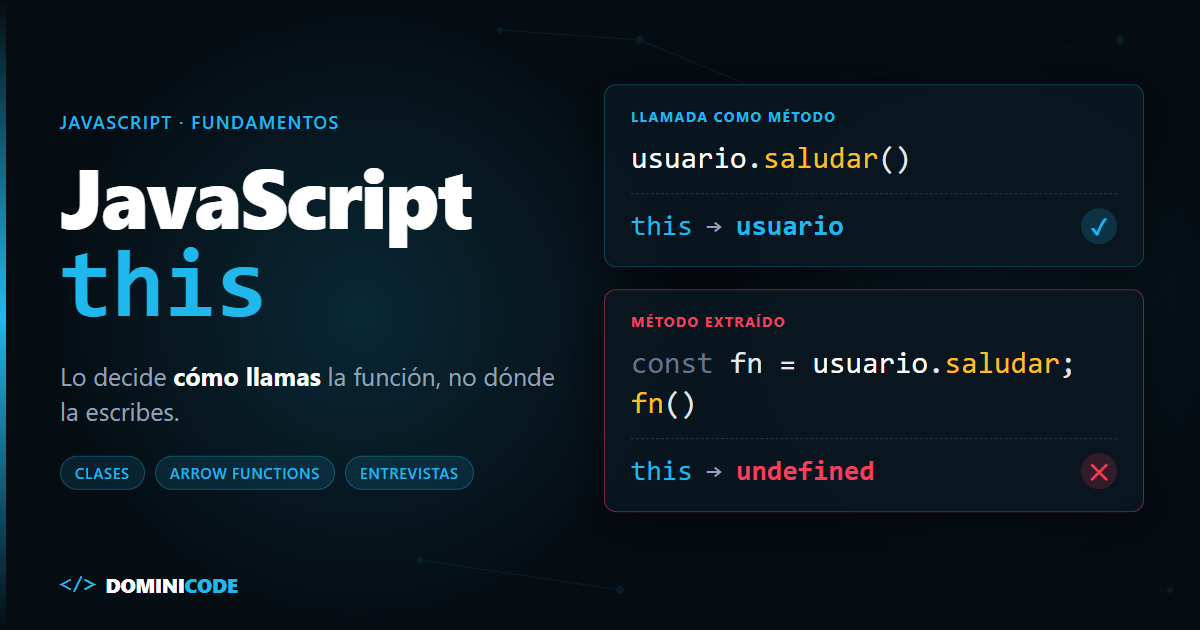
    En corto: en una función normal, this lo determina la llamada, no el lugar donde escribiste la función. En una arrow function, this se captura del contexto léxico exterior. Si puedes responder “¿quién pone el punto antes de los paréntesis?”, puedes predecir la mayor parte de los casos.

    ¿Qué es this en JavaScript?

    this en JavaScript es el valor que el motor proporciona a una función al ejecutarla; en las funciones normales depende de la forma de invocación. No pertenece permanentemente ni al objeto ni a la definición de la función.

    Mira el mismo método llamado de dos maneras:

    const usuario = {
      nombre: 'Bezael',
      saludar() {
        return `Hola, ${this.nombre}`;
      },
    };
    
    usuario.saludar(); // "Hola, Bezael"
    
    const saludar = usuario.saludar;
    saludar(); // módulo o "use strict": TypeError · script clásico: "Hola, undefined"
    

    En usuario.saludar(), el receptor de la llamada es usuario; por eso this === usuario. En saludar(), no hay receptor. En código estricto, this es undefined. Los módulos ES y el cuerpo de las clases son siempre estrictos, así que ahí falla en cuanto lees this.nombre. En un script clásico sin "use strict", this pasa a ser el objeto global y obtienes un silencioso "Hola, undefined", que es peor: es el fallo más típico de JavaScript this.

    Esta regla importa más que memorizar una lista de excepciones:

    Cómo se ejecuta Valor de this en una función normal Ejemplo
    Método El objeto a la izquierda del punto usuario.saludar()
    Función suelta undefined en código estricto (módulos, clases); el objeto global en script no estricto saludar()
    Constructor La nueva instancia new Usuario()
    call, apply o bind El valor indicado explícitamente saludar.call(usuario)
    Arrow function El this del scope donde nació () => this.nombre

    Las arrow functions llegaron con ES2015; los campos de clase como valor = 0 o incrementar = () => {} entraron en el estándar con ES2022.

    La documentación de MDN sobre this lo resume de forma precisa: para una función normal la vinculación se decide en tiempo de ejecución, según cómo se invoca. Esa es la respuesta que conviene dar antes de tocar ningún bind.

    this en objetos: el punto importa, pero solo en esa llamada

    Un error frecuente en entrevista es asumir que una función “recuerda” al primer objeto que la contiene. No lo hace:

    function describir() {
      return this.nombre;
    }
    
    const backend = { nombre: 'API', describir };
    const frontend = { nombre: 'UI', describir };
    
    backend.describir();  // "API"
    frontend.describir(); // "UI"
    

    La función es la misma referencia. Cambia el receptor de cada llamada. Esto explica también por qué const fn = backend.describir; fn() rompe: al extraerla se ha perdido la parte que aportaba el contexto.

    No arregles esto convirtiendo cada método en una arrow function. Las arrow functions no son “funciones modernas” que sustituyen a las normales. Son funciones con otra semántica de this.

    this en clases JavaScript: métodos de prototipo frente a callbacks

    Los métodos declarados en una clase viven en el prototipo y reciben this cuando los invocas como método de una instancia:

    class Contador {
      valor = 0;
    
      incrementar() {
        this.valor += 1;
      }
    }
    
    const contador = new Contador();
    contador.incrementar(); // correcto
    
    setTimeout(contador.incrementar, 100); // pierde la instancia: this.valor acaba en NaN sobre window/Timeout, sin error
    

    setTimeout recibe la función, no el objeto: la ejecuta más tarde, desde la cola del event loop, como función suelta y sin receptor.

    Para un callback que debe conservar la instancia tienes dos soluciones deliberadas:

    setTimeout(contador.incrementar.bind(contador), 100);
    
    class ContadorConCallback {
      valor = 0;
    
      incrementar = () => {
        this.valor += 1;
      };
    }
    

    La segunda suele verse como “auto-bind”, porque la arrow creada como campo de instancia captura el this de esa instancia. Es muy cómoda en callbacks de UI, el mismo problema que el frontend lleva años resolviendo de los callbacks a las signals. En Angular, por ejemplo, saber cuándo un método se pasa como callback (un output, un subscribe, un setTimeout) evita arreglos con bind repartidos por el código; si trabajas con componentes modernos, lo ves aplicado en el curso de Angular Moderno.

    Pero tiene coste: el método normal se comparte mediante el prototipo; el campo arrow crea una función nueva por instancia. MDN lo señala explícitamente: esa comodidad puede aumentar el uso de memoria. No suele ser dramático para un componente, pero sí es una razón para no convertir por reflejo cada método de una clase en arrow.

    Método de prototipo metodo() {} Campo arrow metodo = () => {} bind al pasarlo
    Dónde vive Una sola función en el prototipo Una función nueva por instancia Una función nueva por cada bind
    this al pasarlo como callback Se pierde Se conserva Se conserva
    La subclase puede llamar a super.metodo() Sí No: es propiedad de instancia, no está en el prototipo Sí
    Se puede espiar con jest.spyOn(Clase.prototype, 'metodo') Sí No Sí, si se espía antes del bind
    Limitación / riesgo Olvidar el bind rompe en runtime Más memoria por instancia; tapa al método homónimo de una subclase y no se puede llamar con super ni mockear vía prototipo Lógica dispersa; cada bind crea otra referencia y removeEventListener deja de encontrarla

    La discusión no es nueva ni artificial. En el issue 80 de la propuesta de class fields de TC39, abierto en febrero de 2018, alguien preguntó por qué el ejemplo oficial no usaba arrow fields para enlazar métodos. El hilo sacó dos costes concretos: un método escrito como foo = () => {} no se puede sobrescribir bien desde una subclase ni mockear a través del prototipo. La recomendación que quedó en la conversación: deja la lógica en métodos normales y usa el campo arrow solo como callback fino que llama a ese método.

    this en arrow functions: capturan, no aceptan uno nuevo

    Una arrow function no crea su propio this. Busca el del contexto exterior cuando se crea y se queda con él:

    const pedido = {
      id: 'A-42',
      imprimirLuego() {
        setTimeout(() => {
          console.log(this.id); // "A-42"
        }, 100);
      },
    };
    

    Aquí la arrow es perfecta: imprimirLuego se ejecutó como método de pedido, así que la arrow captura ese this.

    En cambio, escribir una arrow directamente como método de un literal suele ser un bug:

    const pedido = {
      id: 'A-42',
      imprimir: () => this.id,
    };
    
    pedido.imprimir(); // módulo ES: TypeError (this es undefined) · script/CommonJS: undefined
    

    La arrow se creó en el scope exterior al literal, no dentro de una invocación con pedido como receptor. Además, ni call, ni apply, ni bind pueden cambiar el this que ya capturó una arrow. Si una pregunta de entrevista mezcla bind y =>, ese es el detalle que busca.

    Preguntas de entrevista sobre this en JavaScript

    No memorices resultados. Lee primero la forma de llamada.

    class Servicio {
      nombre = 'pagos';
      normal() { return this.nombre; }
      arrow = () => this.nombre;
    }
    
    const servicio = new Servicio();
    const { normal, arrow } = servicio;
    
    normal(); // TypeError: this es undefined
    arrow();  // "pagos"
    

    La pregunta buena no es “¿qué imprime?”. Es: “¿por qué una falla y la otra no?”. normal era un método que necesitaba un receptor en la llamada; arrow cerró sobre el this de la instancia durante su inicialización.

    Otra habitual:

    const perfil = {
      nombre: 'Ana',
      mostrar() { return this.nombre; },
    };
    
    perfil.mostrar.call({ nombre: 'Luis' }); // "Luis"
    

    call gana porque mostrar es normal. Si fuera una arrow, ese call solo pasaría argumentos: no reescribiría el contexto léxico.

    Cuándo no usar arrow functions para resolver this

    Las arrow functions solucionan callbacks que deben conservar el contexto, no todos los problemas relacionados con objetos.

    Primero, no las uses como métodos de objetos que necesitan que el receptor pueda cambiar. Rompes precisamente la vinculación dinámica que hace útil a objeto.metodo().

    Segundo, no las uses como constructores: no se pueden llamar con new y no tienen prototype propio. Si estás modelando una entidad instanciable, una arrow no sustituye a una clase ni a una función constructora.

    Tercero, no escondas un diseño confuso bajo bind. Si un método se pasa por media aplicación y solo funciona cuando recuerdas vincularlo, quizá el callback debería recibir los datos que necesita como argumentos. Reducir la dependencia de this suele hacer el código más fácil de probar. Los componentes de función de React con hooks van por ese camino: no dependen de this (cómo funcionan los hooks de React por dentro).

    Cuarto, no conviertas en campo arrow un método que una subclase deba extender o que tus tests espíen en el prototipo: el campo vive en la instancia y super.metodo() no lo encuentra.

    La regla para aplicar hoy

    Para predecir JavaScript this antes de ejecutar una función, localiza los paréntesis y pregunta qué hay justo a su izquierda. Si hay un objeto y la función es normal, ese será this. Si no hay nada, será undefined en código estricto (módulos ES y clases), salvo que la API que la invoca, como setTimeout o un listener, le pase su propio this. Si es una arrow, deja de mirar la llamada: mira dónde nació.

    Esta es una de esas reglas pequeñas que hace que puedas leer callbacks, componentes y APIs de terceros sin tantear hasta que desaparece el error. Si quieres seguir afinando este tipo de fundamentos con otros developers, en Dominicode Labs tienes la comunidad y las sesiones semanales.

    Preguntas frecuentes

    ¿this siempre es el objeto antes del punto?

    No. Solo en una función normal invocada como método, por ejemplo objeto.metodo(). Una arrow function ignora esa llamada y conserva el this de su contexto exterior.

    ¿Por qué this es undefined al extraer un método de una clase?

    Porque al hacer const fn = instancia.metodo, después ejecutas fn() sin receptor. Como las clases son strict mode (y lo mismo en módulos ES), la función recibe undefined como this.

    ¿Debo usar arrow functions para todos los métodos de clase?

    No. Úsalas para métodos que se pasan como callbacks y deben mantener la instancia. Para el resto, prefiere métodos normales: viven en el prototipo y no crean una función por instancia.

    ¿bind funciona con una arrow function?

    Devuelve una función, pero no cambia el this de la arrow. Ese valor ya quedó capturado al crearla; bind solo puede ser útil para preasignar argumentos.

    ¿Cuál es la respuesta corta sobre this en una entrevista?

    En funciones normales, this depende de cómo se llama la función. En arrow functions, es léxico: procede del scope donde se definieron. Después explica el caso concreto desde la invocación, no desde el objeto donde viste escrita la función.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cuándo usar RxJS o Signals en Angular: el criterio real

    Cuándo usar RxJS o Signals en Angular: el criterio real

    El mes pasado, en un code review, me encontré esto:

    // user.service.ts
    private readonly userSubject = new BehaviorSubject<User | null>(null);
    readonly user$ = this.userSubject.asObservable();
    
    setUser(user: User) {
      this.userSubject.next(user);
    }
    

    Nadie combinaba ese observable con nada. Nadie lo cancelaba. Solo se consumía con async en dos plantillas. Es un signal con tres pasos de más.

    Dos archivos más abajo estaba el problema espejo:

    readonly productos = signal<Product[]>([]);
    readonly cargando = signal(false);
    readonly error = signal<string | null>(null);
    private peticionEnCurso = 0; // para descartar respuestas viejas
    

    Eso ya no es estado. Es un observable reimplementado a mano, y mal.

    Le pregunté al dev qué criterio había usado. Me dio el mismo que da todo el mundo cuando le preguntas cuándo usar RxJS o Signals en Angular: "Signals para estado, RxJS para async".

    La regla es correcta. Yo también la he escrito. Y no le sirvió de nada, porque los dos fragmentos que acabas de ver la cumplen.

    Cuándo usar RxJS o Signals en Angular: la regla que no decide nada

    "Estado" y "async" no describen tu código. Describen categorías. Y tu código real vive justo en la frontera entre las dos.

    Un autocompletado con debounceTime que además guarda el producto elegido: ¿eso es estado o es async? Las dos cosas. Un WebSocket de precios que solo se pinta en pantalla: es async por definición, y sin embargo la UI solo quiere el último valor. Una cancelación de peticiones que ayer era switchMap y hoy podría ser un resource.

    En todos esos casos la regla te deja exactamente donde estabas: eligiendo por costumbre.

    El criterio que sí decide: ¿necesitas el valor o la secuencia?

    Signals te dan el valor actual. Qué vale esto ahora, en este instante, cuando alguien lo lee.

    RxJS te da los eventos en el tiempo. Qué pasó, en qué orden, cuántas veces, y qué hacer si llega otro antes de que termine el anterior.

    Esa es toda la decisión:

    • Si el cuándo y el en qué orden forman parte de tu lógica, es RxJS.
    • Si solo importa qué vale ahora, es un signal.

    Aplícalo a los dos fragmentos del principio y se resuelven solos. El BehaviorSubject del usuario nunca pregunta cuántas veces cambió ni en qué orden: quiere el valor actual. Es un signal. Y el signal() rodeado de cargando, error y peticionEnCurso está preguntando exactamente eso —cuál llegó primero, cuál descarto— con las manos. Es un flujo.

    La pista más fiable es esta: en cuanto necesitas una variable auxiliar para saber qué pasó antes, has salido del territorio de los signals.

    Tabla de decisión: RxJS o Signals, caso por caso

    Necesitas… Elige Por qué
    El valor actual para pintarlo signal Solo importa qué vale ahora
    Derivar un valor de otros computed Sin suscripciones ni sincronización manual
    Que el orden de llegada cambie el resultado RxJS El tiempo es parte de la lógica
    Esperar a que el usuario deje de escribir RxJS (debounceTime) Los signals no tienen noción de tiempo
    Reaccionar a cada evento, uno a uno RxJS El grafo de signals colapsa valores intermedios
    Descartar la respuesta anterior al llegar otra switchMap o un resource Cancelación a mano o incluida
    Guardar lo que el usuario eligió signal Es estado, no un evento
    Un push del servidor que solo se pinta toSignal() del stream La secuencia se procesa fuera; el valor entra al grafo

    Esta tabla decide. No ejecuta. Cuando ya sepas qué mover, el cómo —los patrones de refactorización, uno a uno— está en la guía de migración de RxJS a Signals.

    Frontera 1: el autocompletado que además guarda la selección

    El caso que rompe la regla. Hay tiempo (debounce, cancelación) y hay estado (el término, la selección).

    No elijas. Parte el componente por la mitad:

    readonly term = signal('');                        // valor
    readonly selected = signal<Product | null>(null);  // valor
    
    private readonly results$ = toObservable(this.term).pipe( // secuencia
      debounceTime(300),
      distinctUntilChanged(),
      switchMap((t) => this.http.get<Product[]>(`/api/products?q=${encodeURIComponent(t)}`)),
    );
    
    readonly results = toSignal(this.results$, { initialValue: [] }); // vuelve a valor
    
    choose(p: Product) {
      this.selected.set(p);
      this.term.set(p.name);
    }
    

    Estado a los lados, secuencia en el medio. El pipeline no guarda nada y los signals no saben nada del tiempo.

    Este reparto —qué vive en el grafo y qué vive en el pipeline— es la base de la arquitectura de señales que trabajo a fondo en el curso de Angular Moderno. Y cómo se ordena a escala de aplicación entera —servicios, stores, componentes— lo desarrollé en la arquitectura moderna de Angular con Signals.

    Frontera 2: el WebSocket que alimenta la UI

    Aquí todo el mundo asume RxJS y se queda ahí. La mitad de la respuesta es correcta.

    La conexión y el filtrado son secuencia pura: RxJS. Pero lo que la plantilla consume es un valor.

    private readonly ticks$ = webSocket<Tick>('wss://api.example.com/ticks').pipe(
      filter((t) => t.symbol === 'BTC'),
    );
    
    readonly lastTick = toSignal(this.ticks$, { initialValue: null });
    

    toSignal() se desuscribe solo cuando se destruye el componente o el servicio que lo crea, salvo que le pases manualCleanup. No hay takeUntil, ni async repetido en la plantilla, ni ngOnDestroy.

    Y si tu lógica necesita cada tick —contarlos, agruparlos por ventana, acumularlos— eso se queda en el pipeline. No lo subas al signal.

    Frontera 3: cancelar peticiones, switchMap o un resource

    Este es el que más ha cambiado.

    switchMap cancela la petición anterior cuando llega un valor nuevo. Sigue siendo la respuesta correcta si en el mismo flujo hay debounce, reintentos con backoff o una combinación de varias fuentes.

    Pero si lo único que haces es "cuando cambia este parámetro, vuelve a pedir y descarta lo anterior", ya no necesitas escribir el flujo. httpResource es un envoltorio sobre HttpClient que te da el estado de la petición y la respuesta como señales, pasando por los interceptors. Y rxResource acepta una propiedad stream con una función que devuelve un Observable, para cuando la fuente ya la tienes en RxJS:

    readonly detail = rxResource({
      params: () => this.selectedId(),
      stream: ({ params }) => this.http.get<Product>(`/api/products/${params}`),
    });
    

    Un detalle de la documentación que cuesta caro descubrir en producción: ese Observable debe emitir un valor o un error antes de completar. Si le encadenas un catchError(() => EMPTY) —o un filter que a veces no deja pasar nada— y el Observable completa sin emitir, Angular lanza NG0991, Resource completed before producing a value. No se queda esperando: revienta.

    Frontera 4: dónde va el efecto secundario, effect() o tap()

    La diferencia no es de estilo. Es de garantías.

    tap() se ejecuta una vez por evento, en un punto conocido del orden, y ve el evento.

    effect() se ejecuta cuando el valor acaba siendo algo. No te garantiza que veas todos los intermedios: el grafo de señales agrupa actualizaciones y ejecuta el efecto sobre el resultado ya estabilizado. Si alguna vez te has preguntado por qué un computed no se recalcula cuando esperabas, la explicación está en cómo funciona el grafo reactivo de Angular por dentro.

    La regla práctica:

    • Analítica de "el usuario pulsó el botón" → tap(). Cada pulsación cuenta.
    • "Cuando el carrito quede vacío, oculta el panel" → effect(). Da igual cómo llegó a estar vacío.

    Y si el efecto es calcular otro valor, no es un efecto. Es un computed. Escribir signals dentro de un effect es la forma más rápida de construir un grafo que nadie entiende y que ningún test cubre.

    La frontera exacta de toSignal()

    toSignal() es el punto donde una secuencia se convierte en valor. Vive en @angular/core/rxjs-interop y necesita un contexto de inyección, o que le pases un Injector.

    Tres cosas que la documentación dice y casi nadie lee.

    Se suscribe inmediatamente. La doc lo avisa: "Like the async pipe, toSignal subscribes to the Observable immediately, which may trigger side effects". Si tu observable dispara una petición al suscribirse, esa petición sale ya.

    No lo llames dos veces. "You should avoid calling it repeatedly for the same Observable, and instead reuse the signal it returns". Cada llamada es una suscripción nueva. Dos toSignal() sobre el mismo stream son dos conexiones.

    Los errores se lanzan al leer. No al emitir: al leer el signal. Y si el observable completa, el signal se queda con el último valor emitido, no se vacía.

    Traducido: toSignal() es una frontera de salida, y se cruza una sola vez, lo más cerca posible de la plantilla.

    Cuándo toObservable() te avisa de que vas al revés

    toObservable() es legítimo, y lo has visto arriba: tienes un signal de input y necesitas operadores de tiempo. Estado que se convierte en secuencia.

    El problema es el otro uso, el de volver a RxJS por inercia. Y tiene una trampa medible.

    toObservable() está implementado con un effect y un ReplaySubject. Eso significa que agrupa varias actualizaciones del signal en una sola emisión. Si actualizas el signal tres veces seguidas, no vas a recibir tres valores.

    Así que si tu pipeline necesita ver cada cambio, toObservable() no te lo va a dar. Y si no necesita verlos, probablemente no necesitabas el pipeline.

    Dos señales de que has girado en dirección equivocada: usarlo para combinar dos signals —eso es un computed— o usarlo para ejecutar algo cuando cambia un valor, que es un effect.

    toSignal() debería aparecer varias veces en tu código. toObservable(), muy pocas, y cada una con un operador de tiempo detrás que lo justifique.

    Qué hacer hoy en tu proyecto Angular

    Abre tu proyecto y busca signals con una variable auxiliar al lado: un flag cargando, un contador de peticiones, un ultimoId. Cada una de esas variables es la secuencia que el signal no sabe representar. Ahí tienes un flujo pidiendo volver a RxJS.

    Luego busca lo contrario, que cuesta menos: cada BehaviorSubject del que solo se lee el último valor. Si nadie depende del orden en que llegaron —y en un .asObservable() consumido con async casi nunca se depende—, tienes un signal esperando a salir.

    Los dos del principio de este post salen así: el BehaviorSubject del usuario son tres líneas —subject privado, observable público y setter— que se quedan en una, signal<User | null>(null). Y los cuatro campos del segundo caso —productos, cargando, error y peticionEnCurso— se quedan en un resource. Puedes contarlos tú en los snippets de arriba.

    Diez minutos. Y decides con el criterio, no con la moda.

    Y si quieres discutir estas decisiones sobre proyectos reales, y no sobre listas de tareas, es justo lo que hacemos en Dominicode Labs.

    Preguntas frecuentes

    ¿Cuándo usar RxJS o Signals en Angular?

    Pregúntate si necesitas el valor o la secuencia. Los signals te dan el valor actual: qué vale algo ahora mismo. RxJS te da los eventos en el tiempo: qué pasó, en qué orden y qué hacer si llega otro antes de terminar el anterior. Si el cuándo y el orden forman parte de tu lógica, es RxJS. Si solo importa el valor actual, es un signal. La pista más fiable es que necesites una variable auxiliar para recordar qué pasó antes: ahí ya has salido del territorio de los signals.

    ¿Sigue teniendo sentido RxJS ahora que existen los signals?

    Sí, y no por compatibilidad hacia atrás. Los signals no tienen ninguna noción de tiempo: no saben esperar, ni descartar, ni contar emisiones, ni reintentar con backoff. Nada de eso lo cubre el grafo reactivo. Mientras tu lógica dependa de la secuencia —debounce, WebSockets, coordinación de varias fuentes asíncronas, cancelación combinada con otros operadores— RxJS es la herramienta correcta y no hay sustituto.

    ¿Debo reemplazar todos mis BehaviorSubject por signals?

    Todos no. Reemplaza los que solo mantienen el último valor y se consumen con la pipe async o con un subscribe que hace un set. Esos son signals con pasos de más. Deja los que participan en un flujo real: los que se combinan con otros streams, los que alimentan un pipeline con operadores de tiempo o los que representan eventos en los que el orden importa. El criterio no es el tipo, es qué haces con él.

    ¿Cuál es la diferencia entre effect() y tap() para efectos secundarios?

    tap() se ejecuta una vez por evento, en un punto conocido del flujo, y recibe el evento. effect() se ejecuta cuando el valor acaba estabilizándose, y no garantiza que veas los estados intermedios porque el grafo agrupa actualizaciones. Para "el usuario pulsó tres veces" necesitas tap(). Para "cuando esto quede vacío, oculta el panel" necesitas effect(). Y si lo que quieres es calcular otro valor, el effect sobra: eso lo resuelve un computed.

    ¿Es mala señal usar toObservable() en mi código?

    Depende de en qué dirección vayas. Si conviertes un signal de estado en secuencia para aplicarle operadores de tiempo, es exactamente para lo que existe. Si lo usas para combinar dos signals o para reaccionar a un cambio, te estás alejando: eso son computed y effect. Además tiene una consecuencia práctica que conviene conocer: agrupa varias actualizaciones del signal en una sola emisión, así que no verás todos los valores intermedios.


    Comportamiento verificado contra la documentación de Angular 22 en septiembre de 2026.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • httpResource vs TanStack Query: cuál usar en Angular 22

    httpResource vs TanStack Query: cuál usar en Angular 22

    Un dev me escribió hace tres semanas con una captura de su package.json. Proyecto Angular 22 recién creado, dos días de vida, y ya tenía @tanstack/angular-query-experimental dentro.

    Le pregunté por qué. Respuesta: "en React siempre lo uso".

    Ese es el 80% de las discusiones de httpResource vs TanStack Query que veo por ahí: no son decisiones, son inercias. El resto viene del extremo contrario. Alguien leyó en un hilo que "httpResource no cachea", cerró la pestaña y descartó la API estándar de Angular sin llegar a preguntarse qué caché necesitaba de verdad su aplicación.

    Las dos posturas fallan por el mismo motivo: comparan dos cosas que no juegan en la misma liga.

    Este post no es un tutorial. Si buscas el cómo, ya publiqué la guía de la Resource API en Angular 22 y la de httpResource con señales. Aquí vamos a lo otro: qué eliges, por qué, y qué te va a costar.

    httpResource vs TanStack Query: la respuesta corta

    Usa httpResource por defecto en Angular 22. Es la API estándar, es estable desde la v22.0, no añade dependencias y hereda todo el ecosistema de HttpClient. Cambia a TanStack Query solo cuando necesites una caché de servidor compartida entre componentes con invalidación por clave, mutaciones optimistas o scroll infinito, y estés dispuesto a asumir que su adaptador de Angular se llama literalmente @tanstack/angular-query-experimental.

    Esa es la decisión. El resto del post explica por qué, con la letra pequeña que casi nadie te cuenta.

    La diferencia real: petición reactiva vs caché de estado de servidor

    httpResource es una primitiva de petición reactiva. Le das una función que construye una URL a partir de señales, y la petición se vuelve a lanzar sola cuando esas señales cambian. Vive dentro del grafo reactivo de Angular como un nodo más. Su unidad de trabajo es una petición atada a un estado.

    TanStack Query es otra cosa. Es una capa de caché de estado de servidor. Su unidad de trabajo no es la petición: es la clave. Cuando escribes queryKey: ['products', filtro], estás diciendo "estos datos existen en la aplicación bajo este identificador". A partir de ahí llegan la deduplicación de peticiones en vuelo, la invalidación cruzada, el stale-while-revalidate y las mutaciones optimistas. Todo eso son consecuencias de tener una clave y un almacén global, no de saber hacer un GET.

    Por eso la pregunta "¿cuál es mejor?" lleva casi siempre a la respuesta equivocada. Es como comparar fetch con Redis. Uno trae datos; el otro decide quién los tiene, cuándo caducan y a quién hay que avisar.

    La pregunta correcta es esta: ¿tu aplicación tiene un problema de caché de servidor, o solo tiene peticiones que dependen de un estado?

    Cinco pantallas CRUD con filtros y un detalle no tienen problema de caché. Un dashboard donde ocho componentes distintos leen el mismo listado, donde una mutación en un modal tiene que refrescar tres widgets y donde el usuario espera ver el cambio antes de que responda el servidor, sí lo tiene.

    El mismo caso resuelto con httpResource

    Lista de productos con filtro reactivo. Esta es la versión con la API estándar.

    import { Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    
    type Product = { id: string; name: string; price: number };
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isLoading()) {
          <p>Cargando…</p>
        } @else if (products.error()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.value(); track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      readonly query = signal('');
    
      readonly products = httpResource<Product[]>(
        () => `/api/products?q=${encodeURIComponent(this.query())}`,
        { defaultValue: [] },
      );
    }
    

    Cero dependencias. Cero providers. El HttpResourceRef te expone value, status, error, headers, statusCode, progress e isLoading como señales, más los métodos hasValue() y reload().

    Hay un detalle que se pasa por alto: la documentación oficial aclara que si hay una petición pendiente cuando cambia la dependencia, el resource cancela la anterior antes de lanzar la nueva. El caso del input que escribe rápido está resuelto de fábrica.

    Si quieres validar la respuesta, tienes la opción parse con Zod o Valibot. Y como usa HttpClient por debajo, tus interceptors de auth, de reintentos y de logging siguen aplicando sin tocar nada. Este patrón, con la arquitectura de señales completa alrededor, es lo que trabajo a fondo en el curso de Angular Moderno.

    El mismo caso resuelto con TanStack Query

    Mismo componente, otra filosofía. Primero el provider en el arranque.

    import { provideHttpClient } from '@angular/common/http';
    import { provideTanStackQuery, QueryClient } from '@tanstack/angular-query-experimental';
    
    bootstrapApplication(AppComponent, {
      providers: [provideHttpClient(), provideTanStackQuery(new QueryClient())],
    });
    

    Y el componente:

    import { Component, inject, signal } from '@angular/core';
    import { HttpClient } from '@angular/common/http';
    import { lastValueFrom } from 'rxjs';
    import {
      injectQuery,
      injectMutation,
      QueryClient,
    } from '@tanstack/angular-query-experimental';
    
    type Product = { id: string; name: string; price: number };
    type NewProduct = Omit<Product, 'id'>;
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isPending()) {
          <p>Cargando…</p>
        } @else if (products.isError()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.data() ?? []; track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      private readonly http = inject(HttpClient);
      private readonly queryClient = inject(QueryClient);
    
      readonly query = signal('');
    
      readonly products = injectQuery(() => ({
        queryKey: ['products', this.query()],
        queryFn: () =>
          lastValueFrom(
            this.http.get<Product[]>(`/api/products?q=${encodeURIComponent(this.query())}`),
          ),
      }));
    
      readonly createProduct = injectMutation(() => ({
        mutationFn: (product: NewProduct) =>
          lastValueFrom(this.http.post<Product>('/api/products', product)),
        onSuccess: () => {
          this.queryClient.invalidateQueries({ queryKey: ['products'] });
        },
      }));
    }
    

    Fíjate en lo que aparece y en lo que desaparece.

    Aparece el queryKey: ese array es la identidad de los datos en toda la aplicación. Si otros seis componentes montan la misma clave, hay una sola petición y una sola copia en memoria. Y aparece invalidateQueries, la pieza que httpResource no tiene: un componente puede invalidar datos que él nunca pidió.

    Desaparece la simplicidad. Tienes un provider global, un queryFn que devuelve promesas (de ahí el lastValueFrom para puentear el observable de HttpClient) y un vocabulario nuevo que todo el equipo tiene que aprender.

    Tabla comparativa: httpResource vs TanStack Query en Angular 22

    Solo celdas verificadas contra la documentación y los tipos publicados de ambos proyectos, a septiembre de 2026: Angular 22.1.4 y @tanstack/angular-query-experimental 5.102.8.

    Criterio httpResource (Angular 22) TanStack Query (adaptador Angular)
    Estabilidad Estable desde v22.0 Experimental: breaking changes en releases minor y patch
    Dependencias Ninguna, viene en @angular/common/http @tanstack/angular-query-experimental, que arrastra @tanstack/query-core
    Caché compartida entre componentes No Sí, por queryKey
    Deduplicación de peticiones en vuelo No entre instancias; cancela su propia petición anterior Sí, por clave
    Invalidación por clave No queryClient.invalidateQueries({ queryKey })
    Stale-while-revalidate Conserva el valor anterior mientras recarga, pero no hay política de caducidad ni refetch en segundo plano Sí, con staleTime y refetch en segundo plano
    Reintentos automáticos No incluidos (las opciones son parse, defaultValue, injector, equal y debugName) Sí, tres reintentos por defecto con backoff exponencial
    Mutaciones y updates optimistas Fuera de alcance por diseño injectMutation con invalidación en onSuccess
    Paginación infinita A mano injectInfiniteQuery
    Devtools de datos Sin panel de caché propio; los nodos aparecen en el signal graph de Angular DevTools vía debugName withDevtools() desde el subpath /devtools
    Interceptors de HttpClient Siempre, usa HttpClient por debajo Solo si el queryFn usa HttpClient
    Testing HttpTestingController estándar provideTanStackQuery en TestBed, QueryClient nuevo por spec, retry: false, y requiere Angular ≥ 19
    SSR / hydration Entra en el transfer cache de provideClientHydration Sin guía de SSR propia para Angular; expone injectIsRestoring
    Versión mínima de Angular 22 para la versión estable 16 (19 para la integración de testing)

    Dónde httpResource se queda corto de verdad

    No voy a defender la API estándar más allá de lo que aguanta. Hay cuatro escenarios en los que httpResource te deja escribiendo infraestructura a mano.

    Caché compartida entre componentes. Si el header, la sidebar y la tabla montan tres httpResource contra /api/user, son tres peticiones. No hay almacén común. Puedes subir el resource a un servicio con providedIn: 'root' y compartirlo, claro, pero eso ya es tu caché artesanal, con tus reglas de caducidad escritas por ti y mantenidas por ti.

    Invalidación cruzada tras una mutación. Guardas un producto en un modal y necesitas refrescar el listado, el contador del carrito y el widget de novedades. Con httpResource toca llamar a reload() en cada uno, lo que obliga al modal a conocer a esos tres. Es acoplamiento, y escala mal.

    Paginación infinita. Acumular páginas, saber si hay siguiente, mantener el scroll. injectInfiniteQuery te lo da resuelto. A mano son varias tardes y unos cuantos bugs sutiles.

    Actualizaciones optimistas con rollback. Pintar el cambio antes de que responda el servidor y deshacerlo limpio si falla es un problema de gestión de estado, no de HTTP.

    Y añado una limitación que no es un defecto sino una decisión de diseño: la documentación de Angular es explícita en que hay que evitar httpResource para mutaciones tipo POST o PUT, y usar directamente HttpClient. httpResource lee; no escribe.

    Dónde TanStack Query te sale caro

    Empecemos por lo que está escrito en su propia web, palabra por palabra:

    "This library is currently in an experimental stage. This means that breaking changes will happen in minor AND patch releases."

    Léelo otra vez, porque no es la típica etiqueta beta de adorno. Es el equipo de TanStack diciéndote que un patch puede romperte la capa de datos. Y no es un aviso antiguo: sigue ahí, en la documentación del adaptador de Angular, con el paquete en la versión 5.102.8. El "experimental" está en el nombre del paquete que vas a escribir en tu package.json.

    En una prueba de concepto da igual. En una aplicación de empresa que va a vivir cinco años y que mantendrá otro equipo, eso significa fijar la versión, leerte cada changelog y aceptar que una parte crítica de tu arquitectura evoluciona a un ritmo que tú no controlas.

    El segundo coste es más sutil: te sales del ecosistema de HttpClient. Los interceptors de Angular solo se aplican si tu queryFn usa HttpClient. En cuanto alguien del equipo escribe un queryFn con fetch porque le resulta más cómodo, esa petición se salta el interceptor de auth, el de reintentos y el de trazas. Y no falla en desarrollo: falla el día que caduca un token en producción.

    Ese mismo salto te afecta al testing. httpResource se testea con HttpTestingController, igual que cualquier otra llamada de tu aplicación. Con TanStack Query montas provideTanStackQuery en el TestBed, creas un QueryClient limpio en cada spec, desactivas los reintentos para que los fallos no tarden tres backoffs y esperas a whenStable(). Se puede, está documentado, pero es una capa más que mantener. Si quieres el enfoque completo de testing en Angular moderno, lo tienes en el curso de Testing en Angular con Jest y Testing Library.

    Y el tercer coste es el SSR. httpResource usa HttpClient, así que se beneficia del transfer cache de la hidratación sin que hagas nada. El adaptador de Angular de TanStack Query no publica hoy una guía de SSR equivalente a la de React.

    Veredicto: el árbol de decisión

    Me mojo.

    Por defecto, httpResource. En un proyecto Angular 22 nuevo, empieza con la API estándar. Es estable, no amplía tu superficie de dependencias, integra con interceptors, testing y SSR, y cubre el 80% de los casos reales: listados, detalles, filtros, buscadores. Si hoy dudas, esta es tu respuesta.

    TanStack Query cuando se cumplen las tres condiciones a la vez:

    1. Varios componentes independientes consumen los mismos datos de servidor y quieres una única fuente en memoria.
    2. Necesitas invalidación cruzada tras mutaciones, scroll infinito o updates optimistas, y ya has calculado lo que cuesta escribir todo eso a mano.
    3. Aceptas el riesgo de breaking changes en versiones patch y vas a fijar la versión exacta.

    Si falla una sola de las tres, no lo metas.

    Y la opción que casi nadie considera: los dos. No son excluyentes. Puedes servir el grueso de tus pantallas con httpResource y reservar TanStack Query para el módulo de dashboard donde de verdad existe un problema de caché compartida. Aísla la decisión en una zona del código en lugar de casarte con ella en toda la aplicación.

    Lo que no vale es lo que hacía el dev del package.json: instalarlo el primer día porque en React lo usabas. Angular 22 no es React. El grafo de señales que llegó con la v22 ya te da reactividad de primera clase, y esa es justo la pieza que TanStack Query tuvo que inventar en el mundo de los hooks.

    Qué hacer hoy

    Abre tu proyecto y cuenta cuántos componentes distintos piden el mismo endpoint. Solo eso.

    Si el número es cero o uno, no tienes un problema de caché de servidor: tienes peticiones reactivas, y httpResource te sobra para resolverlas. Si el número es tres o más, y además hay mutaciones que deben refrescar varias vistas a la vez, ahí sí te has ganado el derecho a meter una dependencia externa en la capa de datos.

    Ese conteo tarda diez minutos y vale más que cualquier hilo de discusión en X.

    En Dominicode Labs trabajamos este tipo de decisiones de arquitectura sobre proyectos reales, no sobre ejemplos de listas de tareas. Y si prefieres verlo en vídeo, en el canal de YouTube publico cada semana contenido de Angular moderno e IA aplicada al desarrollo.

    Preguntas frecuentes

    ¿Qué es mejor en Angular 22, httpResource o TanStack Query?

    httpResource es la mejor opción por defecto en Angular 22: es la API estándar, es estable desde la versión 22.0, no añade dependencias y hereda los interceptors, el testing y el transfer cache de HttpClient. TanStack Query solo compensa cuando varios componentes independientes consumen los mismos datos y necesitas invalidación por clave, mutaciones optimistas o scroll infinito. No resuelven el mismo problema: httpResource es una primitiva de petición reactiva y TanStack Query es una capa de caché de estado de servidor.

    ¿httpResource cachea las peticiones?

    No, y ese malentendido origina la mitad de las discusiones sobre el tema. httpResource no mantiene un almacén de datos por clave: lanza la petición cuando cambian las señales de las que depende y expone el resultado como señal. Si necesitas que varios componentes compartan la misma copia en memoria, tienes que construir esa caché tú, por ejemplo elevando el resource a un servicio raíz, o usar una librería que ya la traiga resuelta.

    ¿Puedo usar httpResource y TanStack Query en la misma aplicación?

    Sí, y en muchos proyectos es la decisión más sensata. Nada impide resolver el grueso de las pantallas con la API estándar de Angular y reservar TanStack Query para el módulo concreto que tiene un problema real de caché compartida e invalidación cruzada. Así limitas la superficie de la dependencia externa a una zona del código, en lugar de extenderla por toda la base.

    ¿Es seguro usar el adaptador de Angular de TanStack Query en producción?

    Sí, siempre que fijes la versión exacta, revises el changelog antes de cada actualización y tengas tests que cubran la capa de datos. El riesgo está declarado en su propia documentación: habrá cambios que rompan en versiones minor y también en versiones patch. Si el proyecto lo va a mantener otro equipo dentro de dos años, piénsalo dos veces.

    ¿Los interceptors de HttpClient funcionan con TanStack Query?

    Solo si la función de la query usa HttpClient por debajo. Si alguien la escribe con fetch o con axios porque le resulta más cómodo, esa petición se salta los interceptors de autenticación, reintentos y trazas de Angular, y el problema aparecerá en producción y no en desarrollo. Si adoptas la librería, conviene dejar por escrito en el equipo que toda petición pasa por HttpClient.

    ¿Sirve httpResource para POST y PUT?

    No, y no es una limitación sino una decisión de diseño. La documentación de Angular recomienda de forma explícita evitar httpResource para mutaciones y usar directamente las APIs de HttpClient. httpResource está pensado para leer datos de forma reactiva; escribir es otro problema, con otro ciclo de vida y otros requisitos de control de errores.

    ¿Qué versión de Angular necesito para cada opción?

    httpResource es estable desde Angular 22.0 y vive en el paquete de HTTP común, así que no tienes que instalar nada. El adaptador de TanStack Query declara compatibilidad desde Angular 16 en adelante, aunque su propia guía de testing avisa de que esa integración requiere Angular 19 o superior, porque las versiones anteriores no soportan PendingTasks.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Migrar de RxJS a Angular Signals: patrones de refactorización

    Migrar de RxJS a Angular Signals: patrones de refactorización

    En 2022 audité un componente de catálogo en Angular.

    Tenía 350 líneas de TypeScript. Doce BehaviorSubject, siete combineLatest, cuatro operadores switchMap anidados y tres pipes async duplicados en la plantilla HTML.

    El equipo se quejaba de dos problemas: primero, la aplicación se ralentizaba cada vez que el usuario tecleaba en el buscador por la sobrecarga de Zone.js. Segundo, cada tres semanas aparecía un bug de sincronización porque alguien olvidaba desuscribirse de un stream y causaba un memory leak.

    El problema no era RxJS, y migrar de RxJS a Angular Signals tampoco significa borrarlo del package.json. RxJS es una librería excelente para flujos asíncronos y eventos complejos. El error fue usarlo como gestor de estado síncrono en la interfaz.

    Migrar bien consiste en devolverle a cada herramienta el trabajo que sabe hacer: Signals para el estado síncrono, RxJS para los flujos asíncronos de verdad.

    Aquí tienes la guía paso a paso, patrón por patrón. Si quieres el contexto de cómo hemos llegado hasta aquí, lo conté en de callbacks a Signals: la reactividad real del frontend.


    Tabla de Equivalencias: De RxJS a Signals

    RxJS (Antiguo para Estado)           Angular Signals (Moderno)
    ─────────────────────────           ─────────────────────────
    BehaviorSubject<T>(value)     ───>  signal<T>(value)
    Observable derivado (map)     ───>  computed(() => ...)
    combineLatest([a$, b$])       ───>  computed(() => a() + b())
    Subscription manual / tap     ───>  effect(() => ...)
    Observable HTTP               ───>  rxResource() / httpResource()
    

    Patrón 1: De BehaviorSubject a signal()

    En lugar de crear un subject privado y exponer un observable público:

    // ❌ Antes (RxJS tradicional)
    @Injectable({ providedIn: 'root' })
    export class CartServiceOld {
      private readonly _items$ = new BehaviorSubject<CartItem[]>([]);
      readonly items$ = this._items$.asObservable();
    
      addItem(item: CartItem): void {
        const current = this._items$.getValue();
        this._items$.next([...current, item]);
      }
    }
    

    La versión moderna con Signals reduce la fricción a una sola línea declarativa:

    // ✅ Ahora (Angular Signals)
    @Injectable({ providedIn: 'root' })
    export class CartService {
      readonly items = signal<CartItem[]>([]);
    
      addItem(item: CartItem): void {
        this.items.update(current => [...current, item]);
      }
    }
    

    Sin necesidad de pipes async, sin desuscripciones en ngOnDestroy y con lectura síncrona inmediata mediante this.items().


    Patrón 2: De combineLatest a computed()

    Calcular valores derivados con RxJS requería combinar flujos y recordar filtrar valores nulos iniciales:

    // ❌ Antes (RxJS)
    readonly totalPrice$ = this.items$.pipe(
      map(items => items.reduce((acc, item) => acc + item.price * item.quantity, 0))
    );
    

    Con Signals, computed() es memoizado por defecto y solo se recalcula cuando sus dependencias cambian:

    // ✅ Ahora (Signals)
    readonly totalPrice = computed(() =>
      this.items().reduce((acc, item) => acc + item.price * item.quantity, 0)
    );
    

    Patrón 3: Efectos colaterales con effect() sin caer en bucles

    Usa effect() únicamente para logging, sincronización con APIs externas del navegador (como localStorage o Canvas) o analytics.

    El peligro común: Modificar un signal dentro de un effect(). Esto genera bucles reactivos infinitos.

    // ⚠️ Si necesitas leer un signal sin suscribirte a sus cambios, usa untracked:
    effect(() => {
      const currentItems = this.items();
      // Leemos el userId sin que este effect se vuelva a disparar si el usuario cambia
      const userId = untracked(() => this.authService.userId());
      
      analytics.track('Cart Updated', { userId, count: currentItems.length });
    });
    

    Patrón 4: Conexión Asíncrona con rxResource y toSignal

    Para llamadas HTTP y servicios asíncronos que devuelven observables, la interoperabilidad es directa:

    import { Component, inject, signal } from '@angular/core';
    import { rxResource } from '@angular/core/rxjs-interop';
    import { ProductService } from './product.service';
    
    @Component({
      selector: 'app-product-list',
      template: `
        @if (productsResource.isLoading()) {
          <p>Cargando productos...</p>
        } @else if (productsResource.error()) {
          <p class="error">Error al cargar datos</p>
        } @else {
          <ul>
            @for (product of productsResource.value(); track product.id) {
              <li>{{ product.name }} — {{ product.price | currency }}</li>
            }
          </ul>
        }
      `
    })
    export class ProductListComponent {
      private readonly productService = inject(ProductService);
    
      readonly categoryId = signal<string | null>(null);
    
      // rxResource gestiona automáticamente estado de carga, valor y error.
      // Ojo con la firma: la clave es `stream` (no `loader`) y devuelve un Observable.
      readonly productsResource = rxResource({
        params: () => ({ category: this.categoryId() }),
        stream: ({ params }) => this.productService.getProducts$(params.category)
      });
    }
    

    Si tu servicio se limita a hacer un GET y devolver el JSON, ni siquiera necesitas rxResource: httpResource() hace el mismo trabajo con la mitad de código. Deja rxResource para cuando necesites operadores de RxJS dentro del loader.

    Este es el estándar que enseñamos en profundidad en el curso de Angular Moderno, donde construimos aplicaciones completas sin Zone.js (Zoneless) preparadas para producción.

    Para arquitecturas de estado avanzadas con Signal Stores y patrones de persistencia, en Dominicode Labs publicamos repositorios con ejemplos listos para clonar.

    También puedes seguir tutoriales en vídeo sobre Signals en el Canal de YouTube de Dominicode.


    Qué hacer hoy con esto

    Abre tu proyecto de Angular e identifica un componente que tenga al menos dos BehaviorSubject para controlar filtros de búsqueda o modales.

    Refactorízalo a signal() y computed(). Elimina los pipes async del HTML.

    Verás cómo el archivo pierde un 40% de líneas de código y el comportamiento del componente se vuelve completamente predecible en milisegundos.


    Preguntas frecuentes

    ¿Signals reemplaza a RxJS por completo en Angular?

    No. Signals reemplaza a RxJS en la gestión del estado y la reactividad síncrona en la UI. RxJS sigue siendo la herramienta ideal para flujos asíncronos complejos, cancelaciones HTTP (switchMap), debounce de inputs de teclado y websockets.

    ¿Qué ventaja tiene rxResource frente a usar toSignal() con HttpClient?

    rxResource ofrece un manejo integral del ciclo de vida asíncrono, exponiendo automáticamente señales para el estado de carga (isLoading()), el valor obtenido (value()) y los posibles errores (error()).

    ¿Por qué está desaconsejado cambiar señales dentro de un effect()?

    Porque desencadena cascadas de re-renderizado impredecibles y bucles infinitos. Los efectos deben utilizarse exclusivamente para sincronizar con sistemas externos (side effects), no para derivar estado interno.

    ¿Se puede migrar a Signals de forma gradual o hay que reescribir la aplicación entera?

    De forma gradual, servicio a servicio. toSignal() y toObservable() permiten que el código nuevo con Signals y el existente con Observables convivan en el mismo componente, así que puedes migrar un feature por sprint sin bloquear al resto del equipo.

    ¿Qué pasa con el pipe async al migrar a Signals?

    Desaparece. Un signal se lee directamente en la plantilla con items(), sin suscripción ni desuscripción, así que en la migración el async se elimina junto con el ngOnDestroy que existía solo para cerrar streams.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
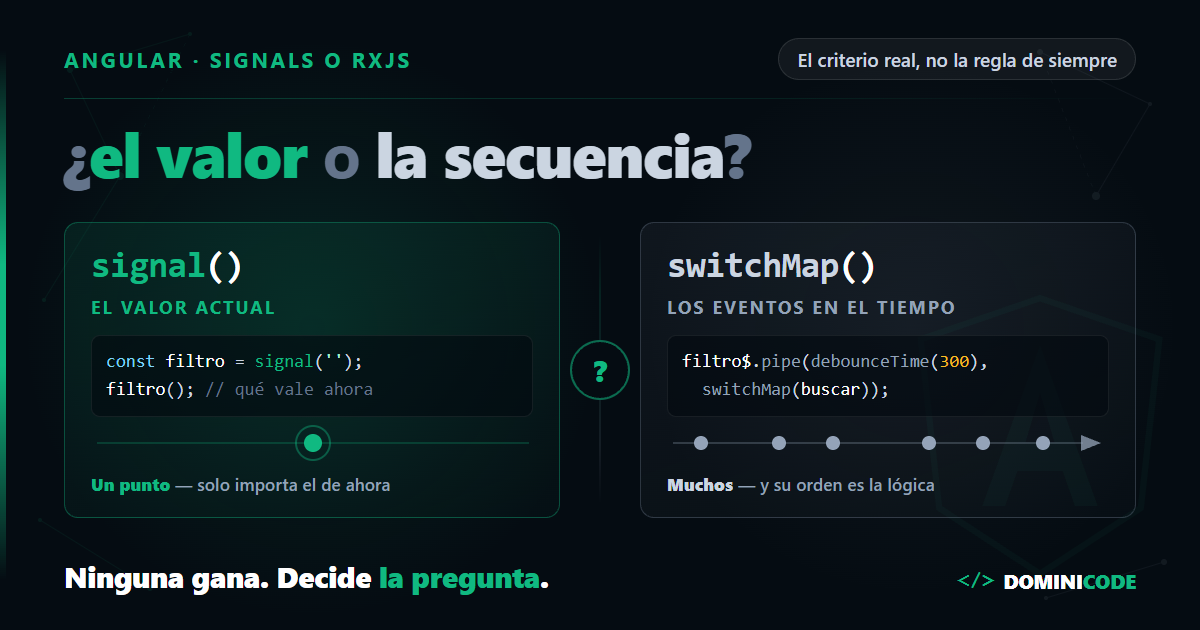
  • La arquitectura moderna de Angular en 2026: Cómo los Signals y Signal Forms cambiaron el juego

    La arquitectura moderna de Angular en 2026: Cómo los Signals y Signal Forms cambiaron el juego

    Hace un par de años revisé una aplicación empresarial desarrollada en Angular 14. Tenía más de 80 componentes. Para sincronizar dos campos de un formulario y calcular un total dinámico, el equipo había montado un laberinto de BehaviorSubject, combineLatest, operadores de RxJS como distinctUntilChanged y tuberías async por todas partes.

    Cualquier cambio menor requería tocar 4 archivos distintos. Los desarrolladores pasaban más tiempo luchando contra fugas de memoria por suscripciones no canceladas que construyendo funcionalidades de negocio.

    Cuando refactorizamos esa misma aplicación a las versiones modernas de Angular basándonos en Signals y Signal Forms, eliminamos el 45% del boilerplate y la velocidad de renderizado en el navegador se disparó.

    Angular ha cambiado radicalmente. Si sigues programando en Angular como lo hacías en 2020, te estás perdiendo la mayor revolución de usabilidad en la historia del framework.

    El problema histórico: RxJS en la capa de UI

    RxJS es una librería extraordinaria para manejar eventos asíncronos complejos como websockets, streams de datos o cancelación de peticiones HTTP.

    Sin embargo, usar RxJS para gestionar el estado reactivo simple dentro de un componente de UI era una mala decisión forzada por las limitaciones del framework anterior:

    • Tenías que lidiar con la subscripción y desuscripción explícita (takeUntilDestroyed, async pipe).
    • Zone.js tenía que comprobar el árbol completo de componentes ante cualquier evento, provocando ciclos de detección de cambios innecesarios.
    • La sintaxis resultaba verbosa y confusa para desarrolladores que venían de otros ecosistemas.

    Con el rápido ciclo de releases de Angular, el equipo del framework ha introducido un modelo reactivo síncrono, directo y ultrarrápido: los Signals.

    El nuevo paradigma: Grafo Reactivo con Signals

    En la arquitectura moderna de Angular, la reactividad síncrona dentro del componente se gestiona mediante tres primitivas fundamentales:

    1. signal() (Estado primario)

    Representa un valor reactivo mutable. Al modificar su valor, Angular sabe exactamente qué nodo del DOM depende de él y actualiza únicamente ese elemento.

    const cantidad = signal<number>(1);
    const precioUnitario = signal<number>(25);
    

    2. computed() (Estado derivado)

    Calcula automáticamente un nuevo valor en función de otros signals. Es perezoso (lazy) y memoriza su resultado (memoized), por lo que solo se reevalúa cuando uno de sus signals dependientes cambia.

    const total = computed(() => cantidad() * precioUnitario());
    

    3. effect() (Efectos secundarios)

    Se ejecuta cuando los signals leídos en su interior cambian.

    • Regla de oro de arquitectura: Jamás uses effect() para modificar otro signal o para lógica de negocio. Reservalo exclusivamente para sincronización externa (ej. guardar en localStorage, emitir eventos a librerías de terceros o analytics).

    Como recalcamos en nuestras guías de programación defensiva en TypeScript, tipar de forma estricta los valores de tus signals previene errores de estado en tiempo de ejecución.

    Signal Forms y Zoneless: El salto definitivo

    Dos de las piezas más esperadas en el ecosistema moderno son la integración de Signal Forms y el soporte nativo para aplicaciones Zoneless (sin Zone.js).

    Zoneless Angular

    Al basar la UI en Signals, Angular ya no necesita Zone.js para "mono-patrullar" los eventos del navegador (clicks, timers, peticiones HTTP). El framework sabe con precisión quirúrgica qué componente y qué nodo del DOM ha cambiado. El resultado es un consumo de memoria mínimo y un arranque instantáneo.

    El rol actual de RxJS

    RxJS no ha muerto ni va a desaparecer. La regla de arquitectura actual es sencilla:

    • Estado de UI y componentes: Usa 100% Signals (signal, computed, input, output).
    • Eventos asíncronos complejos y HTTP: Usa RxJS (HttpClient, debounceTime, switchMap) y conviértelo a Signal en la frontera del componente mediante toSignal().
    // Integración perfecta: RxJS hacia la API, Signal hacia la plantilla
    readonly usuarios = toSignal(this.userService.getUsuarios(), { initialValue: [] });
    

    La arquitectura moderna de Angular es más limpia, más rápida de aprender y infinitamente más fácil de mantener que en versiones anteriores.

    Si quieres dominar el desarrollo frontend moderno y la integración con herramientas de IA, descubre los Cursos de Dominicode. Y si quieres aplicar estas arquitecturas en proyectos reales de producción, te invitamos a sumarte a Dominicode Labs.

    Preguntas frecuentes

    ¿Debo migrar todos mis BehaviorSubject a Signals inmediatamente?

    No es necesario hacer una migración destructiva de golpe. Puedes mantener tu capa de servicios en RxJS e ir adoptando toSignal() y signal() en la capa de componentes de forma progresiva.

    ¿Cuándo debo usar RxJS en lugar de Signals?

    Utiliza RxJS cuando necesites coordinar múltiples eventos asíncronos en el tiempo (por ejemplo, autocompletados con debounceTime, polling periódico, cancelación de peticiones anteriores con switchMap o gestión de WebSockets).

    ¿Cómo afecta el uso de Signals al SEO y SSR en Angular?

    Los Signals mejoran el rendimiento de Server-Side Rendering (SSR) y Hydration ya que reducen la sobrecarga de evaluación de cambios en el servidor y permiten una hidratación parcial ultrarrápida en el cliente.

    ¿Qué versión de Angular se recomienda para trabajar con Signals de forma estable?

    Signals se introdujo como developer preview en Angular 16 y alcanzó estabilidad en Angular 17/18. Para contar con APIs maduras como input(), output(), model() y Signal Forms se recomienda usar Angular 19/20+.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
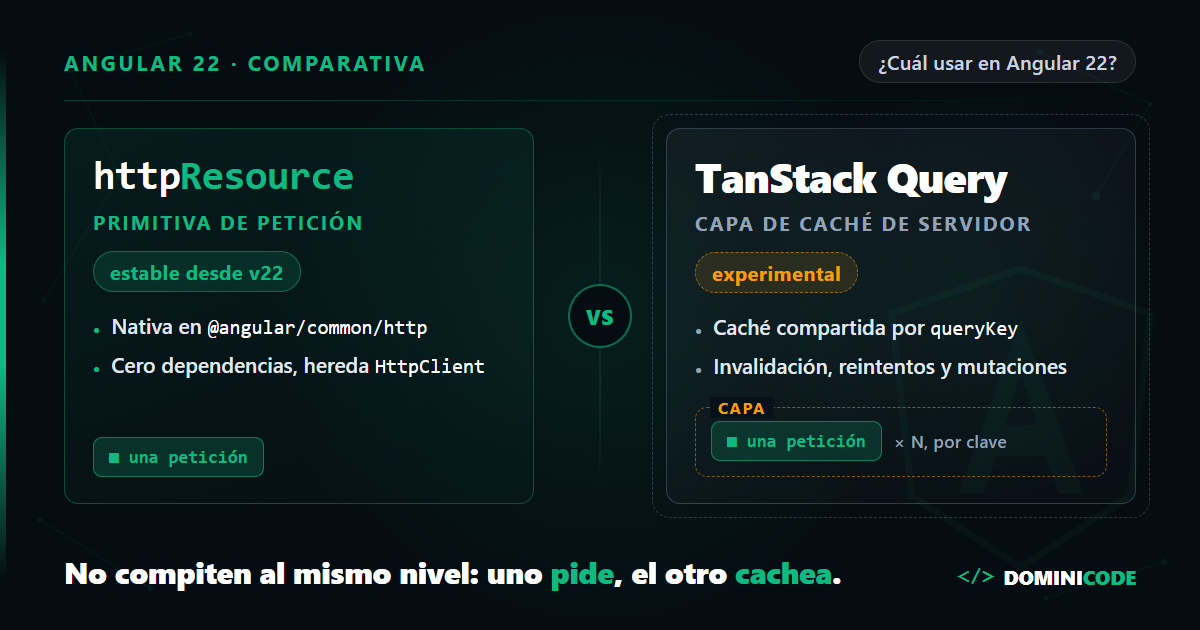
  • Ciclo de releases de Angular: una major cada 12 meses

    Ciclo de releases de Angular: una major cada 12 meses

    El 24 de julio de 2026 se mergeó un PR en el repositorio de Angular. Número 69817. Título: docs: add v23 release and change to yearly release cycle.

    Un PR de documentación. Sin keynote, sin post oficial, sin hilo en X. Una línea de docs sobre el ciclo de releases de Angular, mergeada en main y backporteada a las ramas 22.0.x y 22.1.x.

    Dentro va un cambio que decide cómo planificas los próximos tres años de tu proyecto: se pasa de una major cada seis meses a una major cada doce.

    Se mergeó el 24 de julio de 2026 y apenas ha circulado. La mayoría de los equipos se va a enterar el día que abra el calendario del año que viene para reservar su ventana de migración y no encuentre nada donde esperaba encontrar una major.

    En corto: desde Angular v22, Angular publica una versión major cada 12 meses en lugar de cada 6. La siguiente major, Angular v23, está fechada para junio de 2027. Entre medias llegan de 4 a 6 minors con features nuevas, y los patches siguen saliendo casi cada semana.

    Qué cambia exactamente en el ciclo de releases de Angular

    Angular publica una major cada 12 meses desde la v22. Antes eran 6. Los datos son cortos:

    Tipo de release Hasta Angular v21 Desde Angular v22
    Versión major cada 6 meses cada 12 meses
    Minors por cada major 1-3 4-6
    Patches y pre-releases (next / rc) casi cada semana casi cada semana
    Soporte activo por major ~6 meses 12 meses
    Soporte total (activo + LTS) ~18 meses 24 meses

    Fuente: Versioning and releases, documentación oficial de Angular.

    La justificación oficial, traducida:

    "La comunidad lleva mucho tiempo pidiendo majors menos frecuentes por el impacto que tienen los breaking changes y las actualizaciones, tanto en sus proyectos como en clientes enterprise. Además, un ciclo de release más largo proporciona mayor estabilidad de API para los developers que usan flujos de trabajo agénticos, sin dejar de entregar una cadencia razonable de mejoras y migraciones de API."

    — PR #69817, repositorio oficial de Angular.

    Dos motivos. El segundo es el interesante, y vuelvo a él más abajo.

    ¿Cuándo sale Angular v23? El calendario del nuevo ciclo

    Angular v23.0 está fechada para junio de 2027, según el calendario oficial de releases. Hasta entonces la v22 recibe entre 4 y 6 minors —de la v22.1 a la v22.5— programadas hasta principios de 2027.

    Versión Fecha
    Angular v22.0 junio de 2026 (publicada)
    Minors v22.1 – v22.5 hasta principios de 2027
    Angular v23.0 ~ junio de 2027

    Y el ciclo anual también alarga el soporte. Cada major pasa a tener 24 meses de vida: 12 de soporte activo, con actualizaciones y parches regulares, y 12 más de LTS, solo con fixes críticos y de seguridad. En la práctica, Angular v22 tiene soporte activo hasta junio de 2027 y LTS hasta junio de 2028; la v21, con el ciclo viejo, tuvo activo poco más de seis meses.

    Tienes más margen. Pero el salto que te espera al final del margen es el doble de grande.

    Lo que no cambia: las features siguen saliendo en las minors

    Angular no ha frenado el desarrollo: las features siguen saliendo en las minors. Este es el malentendido que va a circular la semana que viene, así que lo corto ya.

    Lo único que queda restringido a las majors son los breaking changes. Las features siguen entrando por las minors, exactamente igual que hasta ahora.

    Y como las minors pasan de 1-3 por major a 4-6, el goteo de novedades no se corta. Si acaso, se estira.

    Lo que baja no es la velocidad de features. Es la frecuencia con la que Angular te obliga a tocar tu código.

    Si has seguido las novedades de Angular v22, ya sabes que el grueso de lo interesante llega goteando y no de golpe en el día de la major.

    Por qué el ciclo anual no te quita el trabajo de migración: cambia cuándo llega

    Un ciclo anual reduce el número de migraciones. Que reduzca el trabajo está por demostrar. Lo que hace seguro es agruparlo. Y es lo contrario de lo que vas a leer en los resúmenes de la noticia.

    Antes tenías un salto pequeño cada seis meses. Ahora tienes uno grande cada doce.

    Lo que baja seguro es el número de veces que paras: de seis eventos de migración en tres años a tres. Lo que no está anunciado en ninguna parte es que baje el volumen de cambios de API que tienes que absorber. Angular no ha dicho que vaya a romper menos cosas. Ha dicho que las va a agrupar.

    Puede que agrupar reduzca algo el total —dos cambios sobre la misma API en doce meses te llegan ya resueltos en uno—, pero eso está por ver. Lo que está decidido hoy es el reparto.

    Y el reparto no afecta igual a todos.

    Si vas al día, ganas. La mitad de migraciones que rompen algo, la mitad de ceremonias de actualización, la mitad de veces que paras un sprint para ejecutar ng update y arreglar lo que se ha roto. Para un equipo con disciplina, esto es dinero directo.

    Si arrastras retraso, pierdes. Un salto de doce meses no son dos saltos de seis pegados: es un salto en el que no puedes bisecar. Cuando algo se rompe tienes el doble de superficie donde buscar la causa, y las migraciones automáticas dejan de llevarte de la mano versión a versión. Si vienes de v17 o v18, ya hice el mapa de qué migrar primero, y ese orden importa más ahora que antes. Ya conté también el coste real de migrar a Angular 22, y ese coste no se reparte a la mitad por espaciarlo.

    Pero el problema de verdad no es el tamaño del salto.

    Es que una ventana más larga hace mucho más fácil quedarse atrás sin notarlo.

    Cuando la siguiente major está a seis meses, el retraso duele pronto. Te saltas una y en medio año ya tienes a alguien preguntando por qué seguís dos versiones por detrás.

    Cuando está a un año, la deuda no avisa. Las minors siguen ahí, pero una minor no te obliga a nada: la ignoras y no pasa nada. Lo que desaparece no son los avisos. Es el único aviso que no podías ignorar. Y la deuda técnica que no genera incomodidad es justo la que nadie prioriza.

    El ciclo anual es más cómodo. Y la comodidad, en gestión de dependencias, casi siempre se paga después.

    Por qué Angular justifica el ciclo anual con los agentes de IA

    Angular justifica su nueva cadencia, en parte, por cómo trabajan los agentes de código. Vuelve a la cita oficial y lee la segunda mitad: "proporciona mayor estabilidad de API para los developers que usan flujos de trabajo agénticos".

    Piensa en lo que significa. Un modelo que te ayuda a escribir Angular ha aprendido de código de muchas versiones a la vez. Cuando las APIs cambian cada seis meses, la probabilidad de que te proponga algo que ya no existe —un decorador retirado, una firma vieja, un patrón de la versión anterior— sube. Y ese código llega a tu PR con aspecto perfectamente razonable.

    Cada breaking change es ruido en lo que el modelo cree saber.

    Con dos matices que conviene poner encima de la mesa, porque son los que hacen el argumento correcto en vez de solo bonito.

    El primero: lo que pesa no es la frecuencia en abstracto, es cuántas majors han pasado desde el corte de entrenamiento del modelo que tienes abierto. Con majors anuales ese número se parte por la mitad, y un modelo de la misma edad sigue estando en lo cierto durante el doble de tiempo.

    El segundo: las versiones viejas no desaparecen. Angular 14 sigue en el corpus y seguirá. Bajar la cadencia no borra lo aprendido, solo frena lo que se acumula a partir de ahora. El efecto es real, pero se mide en años, no en el próximo release. Y un agente que trabaja con la documentación en contexto depende mucho menos de lo que recuerde: la cadencia importa sobre todo cuando el modelo tira de memoria.

    Que un framework grande diga esto en voz alta, aunque sea en un PR de documentación, es nuevo. Hasta ahora la cadencia se discutía pensando solo en humanos: cuánto aguanta un equipo, cuánto tarda una empresa en aprobar una subida de versión.

    Ahora entra un tercer actor en la conversación, y es el que escribe una parte creciente del código.

    No es una nota al pie. Es una señal de cómo se van a diseñar las herramientas los próximos años: asumiendo que quien las consume no siempre es una persona. Es una de las conversaciones que más tenemos en Dominicode Labs, porque cambia decisiones de arquitectura que hasta ayer parecían cerradas.

    Cómo planificar la migración de Angular con el nuevo ciclo de releases

    Tres cambios concretos en tu forma de trabajar.

    1. La actualización deja de ser un evento reactivo y pasa a ser una fecha

    Antes funcionaba el "ya actualizaremos cuando salga la siguiente". Con una major cada seis meses, ese reflejo te mantenía razonablemente cerca del head. Con una cada doce, ese mismo reflejo te regala un año entero para no hacer nada.

    Pon la ventana ahora. Angular v23 está fechada para junio de 2027: reserva las semanas en el roadmap antes de que el trimestre se llene de otra cosa.

    Y si no eres tú quien decide el roadmap, la versión pequeña es abrir el issue con las dos fechas escritas y dejarlo ahí. Cuando llegue la discusión —y va a llegar—, ya existe un sitio donde el tema está planteado y con tu nombre encima.

    2. Trata las minors como el ritmo real de adopción

    Con 4-6 minors por año, la minor es la unidad de trabajo, no la major. Un equipo que va absorbiendo minors llega a la major con medio trabajo hecho: los deprecation warnings ya los ha visto, las migraciones automáticas ya las ha corrido, el código nuevo ya usa las APIs nuevas.

    Un equipo que solo se mueve en majors llega a junio de 2027 con doce meses de sorpresas juntas.

    3. Asume que saltarte una major te deja el doble de lejos que antes

    Saltarte una major te ponía a doce meses de distancia del head. Ahora te pone a veinticuatro. Ese es el número que tienes que enseñar a quien decida si hay tiempo para actualizar o no.

    Un gesto concreto para empezar: ejecuta ng update sin argumentos. Te lista qué paquetes tienen actualización pendiente y a qué versión, sin tocar nada. Es el inventario en treinta segundos.

    4. Monta la red antes del salto, no durante

    Lo que convierte un salto grande en algo manejable es tener algo que te diga en cinco minutos qué se ha roto. Si tu proyecto sigue en Karma, Vitest ya es el default en Angular 22, y ese cambio se hace mejor ahora, con tiempo, que en mitad de la migración a la v23. Cómo montar esa suite —los patrones son los mismos con Jest o con Vitest— lo cubro paso a paso en el curso de Testing en Angular.

    Lo mismo aplica al resto del stack: migrar a TypeScript 6.0 con strict antes del salto convierte errores de runtime en errores de compilación, que es donde los quieres. Y si estás mirando más adelante, TypeScript 7.0 y su compilador en Go es la otra pieza del calendario que conviene tener en el radar.

    Lo que yo haría esta semana

    Abre el roadmap y escribe dos fechas: la de tu próxima adopción de minor y la ventana de la v23 en junio de 2027.

    Diez minutos. Es la diferencia entre llegar a la v23 con una actualización planificada o con una emergencia.

    Si estás poniendo al día un proyecto y quieres el mapa completo de lo que ha cambiado —signals, zoneless, el modelo mental nuevo—, lo tienes ordenado en el curso de Angular Moderno.

    El ciclo anual te ha dado más margen. Y el margen sin fecha no es margen: es aplazamiento.

    Preguntas frecuentes sobre el ciclo de releases de Angular

    ¿Cada cuánto sale ahora una versión major de Angular?

    Angular publica una versión major cada 12 meses a partir de la v22. Hasta ese cambio, el ciclo era de una major cada 6 meses. Entre major y major salen ahora entre 4 y 6 minors, frente a las 1-3 del ciclo anterior.

    ¿Hasta cuándo tiene soporte Angular 22?

    Angular v22 tiene soporte activo hasta junio de 2027 y soporte LTS hasta junio de 2028. Con el ciclo anual, cada versión major pasa a tener 24 meses de soporte en total: 12 meses de fase activa, con actualizaciones y parches regulares, y 12 meses de LTS, en los que solo se publican fixes críticos y de seguridad.

    ¿Cuándo sale Angular v23?

    Angular v23.0 está fechada para junio de 2027 aproximadamente, según el calendario oficial de releases. Hasta entonces las novedades llegan por las minors de la v22: de la v22.1 a la v22.5, programadas hasta principios de 2027.

    ¿Significa esto que Angular se ha ralentizado?

    No. Las features siguen saliendo en las minors, y ahora hay más minors por ciclo: entre 4 y 6 en lugar de 1-3. Lo único que queda restringido a las versiones major son los breaking changes. Los patches y las pre-releases next y rc siguen publicándose casi cada semana, igual que antes.

    ¿Qué pasa si voy retrasado varias versiones de Angular?

    Un proyecto retrasado sale perdiendo con el ciclo anual, porque cada salto de major concentra doce meses de breaking changes en lugar de seis. Además, una ventana más larga hace más fácil acumular retraso sin darse cuenta: no hay una major cercana que recuerde lo lejos que estás. Si arrastras versiones, ponte al día antes de junio de 2027 y hazlo en saltos pequeños, versión a versión, en vez de esperar a hacerlo todo junto.

    ¿Conviene esperar a Angular v23 para migrar?

    No conviene esperar. Llegar a junio de 2027 con el trabajo de la v22 sin hacer significa sumar dos saltos en una sola operación, con el doble de superficie que puede romperse a la vez. La estrategia que funciona es adoptar las minors de la v22 según salen y presentarse en la major con las migraciones automáticas ya ejecutadas y los deprecation warnings ya resueltos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • happy-dom o jsdom: qué entorno DOM elegir en tests unitarios

    happy-dom o jsdom: qué entorno DOM elegir en tests unitarios

    Cambié a happy-dom la mitad de la suite que toca el DOM, un martes por la mañana. Era la última pieza de un cambio que dejó el job de CI en 6m 15s, desde los doce minutos que tardaba esa misma mañana. Me sentí muy listo.

    Dos semanas después, un componente de lazy loading llegó roto a producción. El test seguía en verde. Lo ejecuté cincuenta veces y cincuenta veces me dijo que todo estaba bien.

    El problema no era el test. Era el suelo sobre el que corría. Elegir entre happy-dom o jsdom no es una micro-optimización de CI: es decidir qué mentiras está autorizada a contarte tu suite.

    Con jsdom, ResizeObserver no existe. El test revienta con un error escandaloso, instalas un mock, el mock dispara el callback y el test comprueba algo de verdad. Con happy-dom, ResizeObserver sí existe: es una clase que se instancia sin quejarse y cuyos tres métodos están vacíos por dentro. El callback no se llama jamás.

    Mi setup tenía una guarda del tipo if (typeof window.ResizeObserver === 'undefined') para instalar el mock. Con happy-dom esa condición no se cumplía nunca. El mock no se instalaba. El test verificaba el vacío.


    Resumen rápido

    • En tests unitarios, el runner (Vitest, Jest) no es el entorno. El entorno es la librería que emula el navegador debajo: jsdom, happy-dom o ninguna.
    • Vitest arranca por defecto en node, sin DOM. Jest también. El DOM siempre lo pides tú.
    • En mi benchmark, happy-dom resultó 1,77x más rápido que jsdom (mediana de 5 pares A/B, rango 1,45x–1,96x), no las 5x-10x que circulan por ahí.
    • Ninguno de los dos tiene motor de layout. getBoundingClientRect() devuelve ceros en ambos. Cambiar de entorno no arregla eso.
    • happy-dom cubre más superficie de API moderna que jsdom (matchMedia, showModal, scrollIntoView), pero incluye stubs mudos que fingen existir.
    • Regla: node por defecto, happy-dom para tests de componente, jsdom fichero a fichero cuando algo se rompa. Se mezclan en el mismo proyecto.

    El runner no es el entorno

    Esta confusión cuesta tardes enteras.

    Cuando escribes environment: 'jsdom', Vitest instancia un window completo por cada fichero de test y lo inyecta en el contexto global antes de importar tu código. El runner orquesta. El entorno es quien finge ser un navegador.

    Y por defecto no hay ninguno: Vitest arranca en node por defecto, sin document ni window. Jest hace lo mismo desde la versión 27, y desde la 28 ni siquiera trae jsdom — hay que instalar jest-environment-jsdom a mano.

    Angular es el caso más traicionero. Desde que Vitest se convirtió en el test runner por defecto en Angular 21, el builder @angular/build:unit-test detecta qué tienes instalado: si encuentra happy-dom lo usa, y si no, cae a jsdom. Basta con que alguien añada happy-dom al package.json por cualquier motivo para que toda tu suite cambie de suelo sin que nadie toque un fichero de configuración.

    Si vienes de Karma, ese cambio de suelo es la parte que menos se cuenta y más duele. Lo desarrollé en Vitest en Angular 22: por qué Karma ya no es el default.


    Qué es jsdom y qué es happy-dom, sin marketing

    jsdom es la implementación de referencia. Se publicó por primera vez en noviembre de 2011: casi quince años de historia y la base sobre la que se ha testeado medio ecosistema JavaScript. Su norma es la fidelidad a la especificación: si algo está implementado, se comporta como en el navegador; si no puede implementarlo bien, prefiere no implementarlo. Su documentación deja layout y navegación explícitamente fuera de alcance. Versión actual: 29.1.1, del 30 de abril de 2026. Nada nuevo desde entonces.

    happy-dom es un emulador con otra prioridad: arrancar rápido y cubrir lo que los frameworks modernos usan de verdad. Versión 20.11.1, del 22 de julio de 2026, con nueve versiones publicadas entre el 3 de junio y esa fecha.

    En disco: jsdom instala 25 MB y 21 dependencias directas; happy-dom, 19 MB y 7. La diferencia real es mucho menor de lo que sugieren las comparativas que verás por ahí.


    Benchmark happy-dom vs jsdom: lo medí en vez de citarlo

    Circulan cifras de "5x-10x más rápido" que nadie respalda. Monté la prueba, y publico los datos crudos para que puedas comprobar cada división.

    Metodología — benchmark ejecutado por Bezael Pérez (Dominicode) el 24 de julio de 2026:

    Carga 50 ficheros × 3 tests con DOM real: listas de 100 nodos, eventos con dispatchEvent, 200 mutaciones de clases y atributos
    Protocolo 5 pares de ejecuciones alternando A/B (jsdom, happy-dom, jsdom, happy-dom…) para anular la deriva de carga de la máquina
    CPU Intel i7-11700K, 16 hilos, 32 GB RAM, Windows 11
    Runtime Node 24.16.0
    Runner Vitest 4.1.10
    Entornos jsdom 29.1.1 · happy-dom 20.11.1

    Datos crudos. Tiempo total de suite, par a par:

    Par jsdom happy-dom Ventaja
    1 26,47 s 14,93 s 1,77x
    2 21,94 s 15,11 s 1,45x
    3 26,90 s 15,77 s 1,71x
    4 15,70 s 8,56 s 1,83x
    5 16,27 s 8,31 s 1,96x

    La ventaja de happy-dom es 1,77x, la mediana de esos cinco ratios.

    Ojo con un detalle que despista, porque yo mismo tropecé con él: la mediana de los tiempos de jsdom (21,94 s) dividida entre la mediana de los de happy-dom (14,93 s) da 1,47x. Pero esas dos medianas salen de pares distintos —la primera del par 2, la segunda del par 1— y dividirlas mezcla ejecuciones que no compartieron condiciones de máquina. En un diseño A/B emparejado, el estimador correcto es el ratio dentro de cada par, y su mediana es 1,77x.

    Con ese mismo criterio, el resto de métricas:

    Métrica jsdom (mediana) happy-dom (mediana) Ventaja por par
    Tiempo total de suite 21,94 s 14,93 s 1,77x
    Ejecución pura de los tests 4,29 s 1,74 s 2,5x
    Arranque del entorno (acumulado) 235,6 s 119,0 s 2,2x

    Y ahora el dato que de verdad cambia decisiones. Segunda suite, 50 ficheros con un único expect(1 + 1).toBe(2), que aísla el coste de levantar el entorno:

    Entorno Tiempo total Arranque por fichero
    node 1,55 s ~0,2 ms
    happy-dom 4,20 s ~0,75 s
    jsdom 7,71 s ~1,55 s

    Las dos tablas no miden lo mismo y no debes cruzarlas: el arranque acumulado de la primera incluye montar y desmontar un documento con cientos de nodos por fichero, con los 16 hilos saturados; la segunda mide levantar un DOM vacío. Compara cada tabla consigo misma.

    Dicho eso, léelo dos veces. Pasar de jsdom a happy-dom te da 1,8x. Pasar de jsdom a ningún DOM te da 5x.

    La optimización más rentable de tu suite no es cambiar de emulador. Es dejar de cargar un emulador en los tests que no tocan el DOM: reducers, servicios, validadores, utilidades puras. Esos no necesitan window, y probablemente son el 70% de tu suite.


    Dónde te rompe cada uno: qué APIs faltan en jsdom y en happy-dom

    Ejecuté el mismo fichero de sondeo en los dos entornos. Esto es lo que devolvió, no lo que dice la documentación:

    API jsdom 29.1.1 happy-dom 20.11.1
    getBoundingClientRect() todo a 0 todo a 0
    offsetWidth / offsetTop 0 0
    getComputedStyle() con estilos inline correcto correcto
    window.matchMedia no existe sí
    Element.scrollIntoView no existe sí
    document.elementFromPoint no existe sí
    dialog.showModal() no existe sí
    CSS.supports no existe sí
    navigator.clipboard no existe sí
    ResizeObserver no existe stub que nunca dispara
    IntersectionObserver no existe stub que nunca dispara
    canvas.getContext('2d') null, o real con el paquete canvas null, sin alternativa
    Element.animate (WAAPI) no existe no existe
    Custom elements y Shadow DOM sí sí

    Un matiz sobre dialog: jsdom sí define el constructor HTMLDialogElement, pero showModal, show y close no están en el prototipo. No es que lancen una excepción propia: es que 'showModal' in dialog devuelve false.

    Tres conclusiones incómodas.

    Una: el relato de "jsdom es más completo" es falso tal y como se cuenta. En superficie de API moderna gana happy-dom. jsdom sigue sin matchMedia en 2026, probablemente el mock más copiado y pegado de la historia del frontend.

    Dos: ninguno tiene layout. Si tu test necesita que getBoundingClientRect() devuelva algo distinto de cero, cambiar de entorno no te salva.

    Tres, la que me costó el susto: happy-dom prefiere un stub silencioso a un fallo ruidoso. Este es su ResizeObserver real, tal cual está en el repositorio:

    export default class ResizeObserver {
      public observe(): void {
        // TODO: Not implemented
      }
      public unobserve(): void {
        // TODO: Not implemented
      }
      public disconnect(): void {
        // TODO: Not implemented
      }
    }
    

    IntersectionObserver sigue el mismo patrón: guarda el callback en el constructor y expone un takeRecords() que devuelve siempre un array vacío, pero observe() tiene el cuerpo igual de hueco. Tu código lo instancia, llama a observe(), no pasa nada y el test sigue adelante. Un fallo ruidoso cuesta diez minutos. Uno silencioso cuesta un incidente.

    En lo fundamental son gemelos: probé validación de formularios, sanitización de input[type=number], ciclo de vida de custom elements, <template>, orden de propagación capture/bubble, resolución de URLs relativas y parseo de HTML mal formado. Resultado idéntico en ambos. Para el 95% de los tests de componente da exactamente igual cuál uses.


    Cómo se configuran, y cómo se mezclan

    Lo que casi nadie cuenta: no tienes que elegir uno para todo el proyecto. Con Vitest 4 defines proyectos por glob.

    // vitest.config.ts
    import { defineConfig } from 'vitest/config'
    
    export default defineConfig({
      test: {
        projects: [
          {
            test: {
              name: 'unit',
              environment: 'node',
              include: ['src/**/*.spec.ts'],
              exclude: ['src/**/*.component.spec.ts'],
            },
          },
          {
            test: {
              name: 'dom',
              environment: 'happy-dom',
              include: ['src/**/*.component.spec.ts'],
            },
          },
        ],
      },
    })
    

    Ese exclude no es decorativo. Sin él, src/**/*.spec.ts también captura los *.component.spec.ts, cada test de componente se ejecuta dos veces —una en node y otra en happy-dom— y la ejecución en node falla con un expected 'undefined' to be 'object' que parece un bug de tu componente y no lo es.

    Y cuando un fichero suelto necesite jsdom, lo declaras en la primera línea. Ese comentario gana a la configuración del proyecto:

    // @vitest-environment jsdom
    import { it, expect } from 'vitest'
    
    it('corre en jsdom aunque el proyecto use happy-dom', () => {
      expect(window.navigator.userAgent).toContain('jsdom')
    })
    

    Lo he verificado ejecutándolo: ese fichero arranca en jsdom mientras el resto de la suite sigue en happy-dom. Un solo test lento no justifica frenar los otros mil.

    En Angular la palanca es distinta, porque el builder elige por ti según lo que esté instalado. Lo robusto es no depender de esa autodetección: apunta la opción runnerConfig del builder a un vitest.config.ts con environment fijado explícitamente, y así da igual lo que aparezca en el package.json. Si prefieres la vía rápida, deja instalado solo uno de los dos:

    # alternativa: fuerza jsdom eliminando la otra opción
    npm uninstall happy-dom && npm install -D jsdom
    

    Y añade esto a tu fichero de setup para que los observers dejen de mentirte:

    // test-setup.ts
    import { vi, beforeEach } from 'vitest'
    
    class ResizeObserverMock {
      constructor(private cb: (entries: unknown[], obs: unknown) => void) {}
      observe = vi.fn((target: Element) =>
        this.cb([{ target, contentRect: target.getBoundingClientRect() }], this))
      unobserve = vi.fn()
      disconnect = vi.fn()
    }
    
    class IntersectionObserverMock {
      constructor(private cb: (entries: unknown[], obs: unknown) => void) {}
      observe = vi.fn((target: Element) => this.cb([{ target, isIntersecting: true }], this))
      unobserve = vi.fn()
      disconnect = vi.fn()
      takeRecords = vi.fn(() => [])
    }
    
    beforeEach(() => {
      vi.stubGlobal('ResizeObserver', ResizeObserverMock)
      vi.stubGlobal('IntersectionObserver', IntersectionObserverMock)
    })
    

    Dos clases, no una. Un mock compartido que emite { isIntersecting: true } para ambos revienta en cuanto un componente responsive lee entries[0].contentRect.width, porque esa propiedad no existe en la entry: TypeError: Cannot read properties of undefined. Cada observer tiene su forma de entry y hay que respetarla.

    Y fíjate en el otro detalle: asigno siempre, sin comprobar antes si existe. Esa comprobación es exactamente lo que me llevó a producción con un test verde y un componente roto.


    La regla para elegir entre happy-dom o jsdom

    Cinco pasos, en este orden. Los aplico tal cual.

    1. node por defecto. Si el test no toca document, no cargues DOM. Ahí está el 5x, no en la comparativa de emuladores.
    2. happy-dom para tests de componente. Casi el doble de rápido y con más API moderna cubierta. Es la elección por defecto en 2026.
    3. Nunca uses guardas del tipo if (typeof window.X === 'function') en el setup. Sobrescribe siempre los observers con mocks que disparen.
    4. jsdom fichero a fichero, no suite entera. ¿Un test necesita canvas real o un comportamiento de spec que happy-dom aproxima mal? // @vitest-environment jsdom en la línea 1 y sigues.
    5. Si necesitas layout de verdad, ningún emulador sirve. Posiciones reales, scroll real, capturas visuales: eso es Browser Mode de Vitest, estable desde la 4.0, con Playwright debajo. Más lento, y el único sitio donde esos tests significan algo.

    La excepción que invierte los pasos 2 y 4: si mantienes una librería de componentes que consumen otros, empieza en jsdom. Ahí prefieres un fallo ruidoso a una aproximación cómoda, porque el coste de un falso verde no lo pagas tú.

    Razonar sobre el entorno antes que sobre el aserto es la columna vertebral del curso de Testing en Angular, donde monto la suite desde cero decidiendo qué corre en node, qué en DOM emulado y qué en navegador real. Y si lo que te falta es la base del framework antes de entrar a testearlo, esa parte la cubro en el curso de Angular Moderno.


    Lo que puedes hacer hoy

    Abre tu vitest.config.ts y mira qué environment tienes a nivel global para tus tests unitarios.

    Si es jsdom o happy-dom para toda la suite, acabas de encontrar tu mayor ganancia de tiempo del trimestre: sepáralo en dos proyectos y manda a node todo lo que no toque document. Diez minutos de trabajo.

    Después añade el mock de los observers al setup. Porque el test que más te va a costar en tu carrera no es el que falla: es el que pasa por el motivo equivocado.

    Si quieres seguir tirando del hilo, tengo publicado Testing en Angular con IA: tests que protegen de verdad, donde ataco el mismo problema desde el otro lado. Y si prefieres verlo montado sobre un proyecto real y con gente a la que preguntar, te espero en Dominicode Labs.


    Preguntas frecuentes sobre happy-dom y jsdom

    ¿Qué es más rápido, happy-dom o jsdom?

    happy-dom. En el benchmark que ejecuté en Dominicode en julio de 2026 con Vitest 4.1.10, sobre 50 ficheros con manipulación real de DOM y cinco pares de ejecuciones alternadas, happy-dom resultó 1,77x más rápido que jsdom en mediana, con un rango de 1,45x a 1,96x. En ejecución pura de operaciones DOM la ventaja sube a 2,5x y en arranque del entorno es de 2,2x. Las cifras de "5x o 10x" que circulan no se corresponden con lo que mide una suite real. La ganancia grande está en no cargar ningún DOM: el entorno node fue 5 veces más rápido que jsdom en la misma máquina.

    ¿Merece la pena migrar de jsdom a happy-dom?

    Depende de dónde esté tu cuello de botella, y casi nunca está donde crees. Si tu suite tarda diez minutos, migrar a happy-dom te deja en unos seis: real, pero no transformador. Antes de eso, mira cuántos de tus tests cargan un DOM sin necesitarlo, porque mover esos a environment: 'node' da una mejora del orden de 5x en esa parte de la suite y no tiene ningún riesgo de compatibilidad. Mi recomendación es hacerlo en ese orden: primero separa node de DOM, después cambia el emulador y, si algún fichero se rompe, pásalo a jsdom con el comentario // @vitest-environment jsdom en lugar de revertir la migración entera.

    ¿Cuál usa Vitest por defecto?

    Ninguno de los dos. El valor por defecto de test.environment en Vitest es node, sin window ni document. Para tener DOM debes instalar jsdom o happy-dom y declararlo en vitest.config.ts o con el comentario // @vitest-environment en la cabecera del fichero. Jest se comporta igual: su entorno por defecto es node y desde Jest 28 hay que instalar jest-environment-jsdom como paquete aparte.

    ¿Qué entorno DOM usa Angular con Vitest?

    El builder @angular/build:unit-test detecta automáticamente qué tienes instalado: prefiere happy-dom si está presente y cae a jsdom si no. Conviene saberlo porque implica que añadir happy-dom al package.json por cualquier motivo cambia el entorno de toda la suite sin que nadie modifique la configuración. Si quieres un comportamiento predecible, fija environment de forma explícita en el fichero de configuración al que apunta la opción runnerConfig del builder, en vez de confiar en la autodetección.

    ¿Por qué mi test falla con "ResizeObserver is not defined"?

    Porque estás en jsdom, que no implementa ResizeObserver ni IntersectionObserver: la propiedad no existe en window. La solución es añadir un mock en el fichero de setup, con una clase distinta para cada uno, porque sus entries tienen forma diferente: contentRect en el de resize e isIntersecting en el de intersection. Ojo con el matiz: en happy-dom esas clases sí existen, pero sus métodos están vacíos y el callback no se ejecuta nunca. Si tu mock está protegido por una comprobación de existencia, en happy-dom no se instalará y tu test pasará sin comprobar nada.

    ¿Puedo usar happy-dom y jsdom en el mismo proyecto?

    Sí, y es la mejor estrategia. Con Vitest 4 defines varios proyectos en test.projects, cada uno con su environment y su glob de ficheros. Cuida los globs: si un proyecto incluye src/**/*.spec.ts y otro src/**/*.component.spec.ts, los ficheros de componente caen en los dos y se ejecutan por duplicado, así que necesitas un exclude en el primero. Además, el comentario // @vitest-environment jsdom en la primera línea de un fichero tiene prioridad sobre la configuración del proyecto, así que puedes mantener toda la suite en happy-dom y mover a jsdom solo los ficheros que lo necesiten. No hay que migrar en bloque.

    ¿Con cuál funciona getBoundingClientRect?

    Con ninguno. Ni jsdom ni happy-dom incorporan motor de layout, así que getBoundingClientRect(), offsetWidth y offsetTop devuelven cero en los dos. La documentación de jsdom lo declara explícitamente fuera de alcance. Si tu test depende de posiciones o tamaños reales, la única salida es un navegador de verdad: Browser Mode de Vitest, estable desde la 4.0, con Playwright por debajo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • TypeScript 7.0: el compilador en Go que cambia tu día a día

    TypeScript 7.0: el compilador en Go que cambia tu día a día

    El año pasado revisé un monorepo Nx de un cliente con más de 600 archivos TypeScript compartiendo tipos entre ocho aplicaciones Angular. Cada vez que alguien tocaba una interfaz común, tsc --noEmit tardaba entre 50 y 90 segundos en confirmar si habíamos roto algo.

    Multiplica eso por cada dev, cada commit, cada CI run del día, y tienes horas enteras de tu equipo mirando una terminal en vez de escribir código.

    Ayer, 8 de julio de 2026, Microsoft anunció que TypeScript 7 llegó a disponibilidad general. Y no es una release más con un par de utility types nuevos.

    Es la primera vez en la historia del lenguaje que el compilador deja de estar escrito en TypeScript y pasa a ser un binario nativo en Go. El proyecto se llamó tsgo durante la beta; en la versión final, tsc ya es ese compilador nativo — no hay que instalar nada aparte.

    Llevamos años escuchando la misma queja en cualquier proyecto TypeScript grande: "esto sería instantáneo si estuviera en Rust o en Go, como esbuild o swc". Microsoft por fin le hizo caso a su propia comunidad, y el resultado es el cambio de infraestructura más importante que ha tenido TypeScript desde que existe.


    Qué cambió realmente en TypeScript 7 (no es un upgrade cosmético)

    Hasta la versión 6.0, tsc era un compilador bootstrapped: TypeScript compilando TypeScript, que a su vez corría sobre el motor de JavaScript de Node. Funcional, pero con un techo de rendimiento que ni V8 ni ningún truco de caché podían romper del todo.

    TypeScript 7 tira ese techo abajo. Microsoft reescribió el type-checker, el parser y el emitter en Go, un lenguaje compilado con gestión de memoria y concurrencia nativa.

    La lógica de chequeo de tipos se mantiene estructuralmente idéntica a la de 6.0 — Microsoft no aprovechó la reescritura para "arreglar" reglas de inferencia. Si tu código compilaba limpio en 6.0 con stableTypeOrdering activado y sin flags deprecados, debería compilar igual en 7.0.

    TypeScript 6.0 TypeScript 7.0
    Compilador Bootstrapped (TS sobre JS/Node) Nativo en Go (tsgo → tsc)
    Velocidad de type-checking Base ~10x más rápido (16.7x con --checkers 8)
    strict Opcional Obligatorio
    target: es5 Soportado Eliminado
    Módulos amd / umd / systemjs / none Soportados Eliminados (CommonJS sigue vivo)
    baseUrl Soportado Eliminado
    API programática estable Disponible Llega en TypeScript 7.1

    TypeScript 7: los números que sí importan

    Microsoft reporta que TypeScript 7.0 es, en promedio, unas 10 veces más rápido que TypeScript 6.0.

    Pero el dato que de verdad vale la pena mirar es el de VS Code con el flag --checkers 8 (paralelización del type-checker en varios hilos): pasó de 125.7 segundos a 7.51 segundos. Un speedup de 16.7x en el chequeo de tipos de un codebase real y masivo.

    Eso no es "un poco más rápido". Eso es la diferencia entre lanzar un build y perder el foco, versus lanzar un build y ver el resultado antes de levantar la vista de la pantalla.

    Si trabajas en un proyecto Angular grande — de esos donde el IntelliSense empieza a tartamudear pasados los 200 componentes, como los que armamos en la guía de Angular Signal Forms — este es el tipo de mejora que se siente en el editor todos los días, no solo en el CI.

    Si tu proyecto es de ese tamaño, probablemente ya conoces el dolor de mantener una arquitectura de tipos compartidos entre módulos. En el curso de Angular Moderno trabajamos justo ese tipo de estructura — componentes standalone, signals y una capa de tipos que ahora se va a beneficiar directamente de un compilador que deja de ser el cuello de botella.

    ¿Rompe mi código? Sí, pero no donde crees

    La lógica de inferencia de tipos no cambió. Lo que cambió es que TypeScript 7 convierte en obligatorio todo lo que en 6.0 era opcional o estaba deprecado. Concretamente:

    • strict mode ya no es una opción — es el default forzado.
    • Desaparecen target: es5, downlevelIteration y, como valores de module, AMD, UMD, SystemJS y none (se recomienda esnext o preserve). CommonJS sigue soportado.
    • baseUrl se elimina; los imports relativos tienen que ser explícitos o pasar por paths.
    • Los template literals ahora preservan code points Unicode reales, en vez de partir emojis en pares de surrogates UTF-16. Un detalle pequeño que puede romper tests de snapshots si comparas strings a nivel de caracteres.

    Si tu proyecto usa validación de esquemas con librerías como Zod, strict obligatorio en realidad juega a tu favor: el compilador ahora exige la misma disciplina de tipos que ya deberías estar aplicando en tus schemas. Si todavía no tienes esa disciplina, este es un buen momento para revisar el curso de Zod para TypeScript antes de que strict te obligue a arreglarlo todo de golpe.

    Antes de migrar a TypeScript 7: el checklist que de verdad importa

    Actualizar con npm install -D typescript instala el nuevo tsc nativo sin fricción. El problema nunca es la instalación — es lo que descubres después de instalarlo:

    1. Revisa tu tsconfig.json. Si el archivo vive fuera del directorio de fuentes (algo común en monorepos), ahora tienes que declarar rootDir de forma explícita. Antes el compilador lo inferías; ahora no.
    2. Declara tus @types en el array types. El comportamiento por defecto cambió — si dependes de tipos globales de paquetes como @types/node o @types/jest, sé explícito o vas a ver errores de "no se encuentra el nombre" en símbolos que antes funcionaban solos.
    // tsconfig.json — antes (TypeScript 6.0, inferido)
    {
      "compilerOptions": {
        // rootDir se infería, types no era obligatorio
      }
    }
    
    // tsconfig.json — después (TypeScript 7.0, explícito)
    {
      "compilerOptions": {
        "rootDir": "./src",
        "types": ["node", "jest"]
      }
    }
    
    1. Si tienes JavaScript con JSDoc, revisa el CHANGES.md del proyecto. Patrones como @enum, el operador postfix ! o sintaxis estilo Closure divergen del comportamiento de 6.0. No es una lista larga, pero si tu proyecto tiene archivos .js documentados con JSDoc, vale la pena los cinco minutos de lectura.
    2. Si necesitas convivir con TS 6.0 — por ejemplo, porque una herramienta de tu stack todavía depende de la API interna — instala el paquete @typescript/typescript6, que expone un ejecutable tsc6 en paralelo.

    Nada de esto es dramático. Pero tampoco es un "npm install y ya". Trátalo como tratarías cualquier upgrade de compilador mayor — o como el cambio de Karma a Vitest en Angular 22: en una rama aparte, con CI corriendo antes de tocar main.

    Lo que todavía no puedes hacer

    Aquí está la letra pequeña que casi nadie está mencionando: la API programática estable de TypeScript 7 — la que usan herramientas como ts-morph, plugins de bundlers o el propio Angular Language Service para chequeo de tipos en templates — no llega hasta la versión 7.1. El GA de hoy es para el CLI, para tsc. No para quien construye herramientas sobre el compilador.

    Eso significa que, por ahora, puedes usar TypeScript 7 para el chequeo de proyecto completo desde la línea de comandos y sacarle el speedup en CI hoy mismo. Pero el chequeo dentro de templates de Angular en tu editor va a seguir dependiendo de TypeScript 6.0 hasta que esa API se estabilice. Es una convivencia perfectamente normal, no una incompatibilidad — simplemente no esperes que todo tu tooling salte a la vez.


    Mi consejo, después de quince años viendo migraciones de compiladores salir mal por prisa: no actualices tu proyecto de producción esta semana solo porque salió el anuncio.

    Crea una rama, instala TypeScript 7, corre tu build y tu suite de tipos, y mide tú mismo la diferencia de tiempo antes de tocar main. El speedup es real, pero el checklist de arriba es lo que separa una migración de una tarde de una migración de una semana apagando incendios.

    Si quieres profundizar en arquitecturas TypeScript grandes y cómo estructurarlas para que este tipo de mejoras de compilador realmente se noten, en Dominicode Labs compartimos los proyectos y patrones que uso en clientes reales, actualizados a medida que el ecosistema cambia.


    Preguntas frecuentes

    ¿Debo actualizar mi proyecto a TypeScript 7 ya?

    Para probar y medir, sí — en una rama separada, no en producción directamente. Para producción, primero revisa el checklist de breaking changes (strict obligatorio, rootDir explícito, array types, eliminación de targets legacy) y corre tu CI completo antes de mergear.

    ¿TypeScript 7 rompe mi código actual?

    La lógica de type-checking es estructuralmente idéntica a la de TypeScript 6.0. Si tu proyecto ya compilaba limpio en 6.0 con stableTypeOrdering y sin usar flags deprecados, debería compilar igual. Lo que sí rompe son los defaults: strict obligatorio, sin target: es5, sin módulos amd/umd/systemjs/none (CommonJS sigue soportado) y sin baseUrl.

    ¿Qué es tsgo?

    Es el nombre que tuvo el proyecto de reescritura del compilador de TypeScript en Go durante su fase de beta y builds nightly. En el release final de TypeScript 7.0, ese compilador nativo en Go es tsc — no existe un binario separado llamado tsgo que tengas que invocar.

    ¿Angular ya es compatible con TypeScript 7?

    Parcialmente. Puedes usar TypeScript 7 desde la CLI para el chequeo de tipos de proyecto completo y aprovechar el speedup en builds y CI hoy mismo. El propio anuncio de lanzamiento de Microsoft admite que las herramientas que embeben TypeScript en su propio compilador — como las que dan soporte a templates de Angular — "probablemente" seguirán dependiendo de TypeScript 6.0 hasta que la API programática estable llegue en la 7.1. Angular todavía no ha publicado su propia matriz de compatibilidad para TS 7, así que confírmalo en su documentación oficial antes de tocar el editor de tu equipo.

    ¿Cuándo llega la API programática estable?

    Microsoft la tiene planificada para TypeScript 7.1, no para este GA de 7.0. Si construyes herramientas sobre el compilador (ts-morph, plugins de build, integraciones de linters), tu código seguirá dependiendo de la API de TypeScript 6.0 hasta esa siguiente versión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.