Tag: Angular 22

  • httpResource vs TanStack Query: cuál usar en Angular 22

    httpResource vs TanStack Query: cuál usar en Angular 22

    Un dev me escribió hace tres semanas con una captura de su package.json. Proyecto Angular 22 recién creado, dos días de vida, y ya tenía @tanstack/angular-query-experimental dentro.

    Le pregunté por qué. Respuesta: "en React siempre lo uso".

    Ese es el 80% de las discusiones de httpResource vs TanStack Query que veo por ahí: no son decisiones, son inercias. El resto viene del extremo contrario. Alguien leyó en un hilo que "httpResource no cachea", cerró la pestaña y descartó la API estándar de Angular sin llegar a preguntarse qué caché necesitaba de verdad su aplicación.

    Las dos posturas fallan por el mismo motivo: comparan dos cosas que no juegan en la misma liga.

    Este post no es un tutorial. Si buscas el cómo, ya publiqué la guía de la Resource API en Angular 22 y la de httpResource con señales. Aquí vamos a lo otro: qué eliges, por qué, y qué te va a costar.

    httpResource vs TanStack Query: la respuesta corta

    Usa httpResource por defecto en Angular 22. Es la API estándar, es estable desde la v22.0, no añade dependencias y hereda todo el ecosistema de HttpClient. Cambia a TanStack Query solo cuando necesites una caché de servidor compartida entre componentes con invalidación por clave, mutaciones optimistas o scroll infinito, y estés dispuesto a asumir que su adaptador de Angular se llama literalmente @tanstack/angular-query-experimental.

    Esa es la decisión. El resto del post explica por qué, con la letra pequeña que casi nadie te cuenta.

    La diferencia real: petición reactiva vs caché de estado de servidor

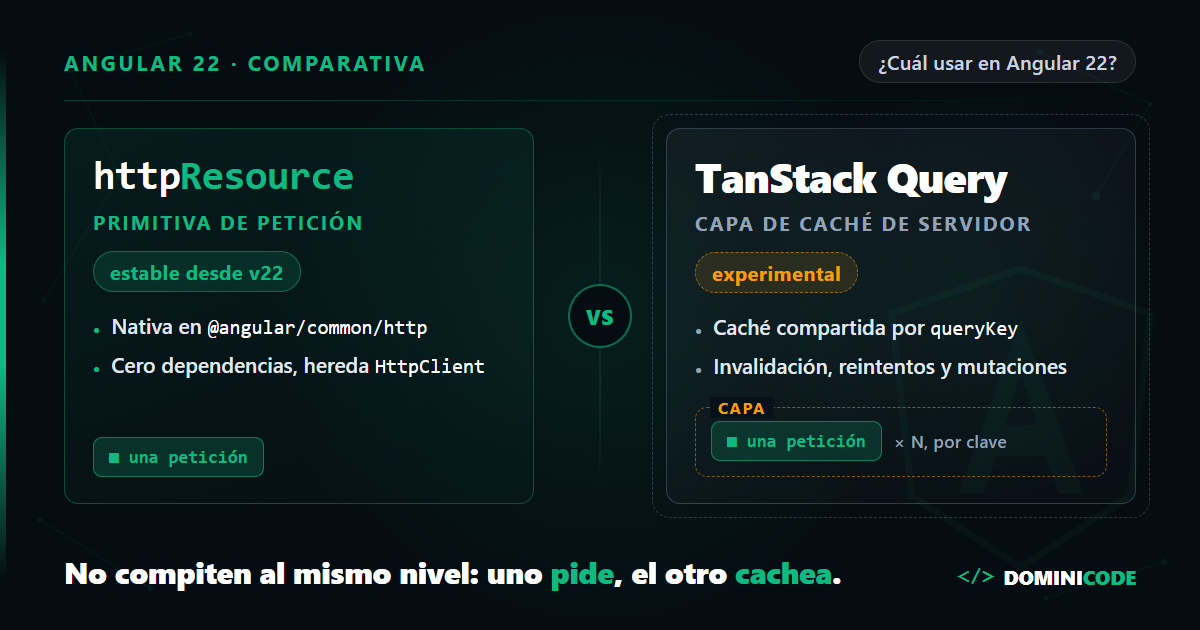
    httpResource es una primitiva de petición reactiva. Le das una función que construye una URL a partir de señales, y la petición se vuelve a lanzar sola cuando esas señales cambian. Vive dentro del grafo reactivo de Angular como un nodo más. Su unidad de trabajo es una petición atada a un estado.

    TanStack Query es otra cosa. Es una capa de caché de estado de servidor. Su unidad de trabajo no es la petición: es la clave. Cuando escribes queryKey: ['products', filtro], estás diciendo "estos datos existen en la aplicación bajo este identificador". A partir de ahí llegan la deduplicación de peticiones en vuelo, la invalidación cruzada, el stale-while-revalidate y las mutaciones optimistas. Todo eso son consecuencias de tener una clave y un almacén global, no de saber hacer un GET.

    Por eso la pregunta "¿cuál es mejor?" lleva casi siempre a la respuesta equivocada. Es como comparar fetch con Redis. Uno trae datos; el otro decide quién los tiene, cuándo caducan y a quién hay que avisar.

    La pregunta correcta es esta: ¿tu aplicación tiene un problema de caché de servidor, o solo tiene peticiones que dependen de un estado?

    Cinco pantallas CRUD con filtros y un detalle no tienen problema de caché. Un dashboard donde ocho componentes distintos leen el mismo listado, donde una mutación en un modal tiene que refrescar tres widgets y donde el usuario espera ver el cambio antes de que responda el servidor, sí lo tiene.

    El mismo caso resuelto con httpResource

    Lista de productos con filtro reactivo. Esta es la versión con la API estándar.

    import { Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    
    type Product = { id: string; name: string; price: number };
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isLoading()) {
          <p>Cargando…</p>
        } @else if (products.error()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.value(); track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      readonly query = signal('');
    
      readonly products = httpResource<Product[]>(
        () => `/api/products?q=${encodeURIComponent(this.query())}`,
        { defaultValue: [] },
      );
    }
    

    Cero dependencias. Cero providers. El HttpResourceRef te expone value, status, error, headers, statusCode, progress e isLoading como señales, más los métodos hasValue() y reload().

    Hay un detalle que se pasa por alto: la documentación oficial aclara que si hay una petición pendiente cuando cambia la dependencia, el resource cancela la anterior antes de lanzar la nueva. El caso del input que escribe rápido está resuelto de fábrica.

    Si quieres validar la respuesta, tienes la opción parse con Zod o Valibot. Y como usa HttpClient por debajo, tus interceptors de auth, de reintentos y de logging siguen aplicando sin tocar nada. Este patrón, con la arquitectura de señales completa alrededor, es lo que trabajo a fondo en el curso de Angular Moderno.

    El mismo caso resuelto con TanStack Query

    Mismo componente, otra filosofía. Primero el provider en el arranque.

    import { provideHttpClient } from '@angular/common/http';
    import { provideTanStackQuery, QueryClient } from '@tanstack/angular-query-experimental';
    
    bootstrapApplication(AppComponent, {
      providers: [provideHttpClient(), provideTanStackQuery(new QueryClient())],
    });
    

    Y el componente:

    import { Component, inject, signal } from '@angular/core';
    import { HttpClient } from '@angular/common/http';
    import { lastValueFrom } from 'rxjs';
    import {
      injectQuery,
      injectMutation,
      QueryClient,
    } from '@tanstack/angular-query-experimental';
    
    type Product = { id: string; name: string; price: number };
    type NewProduct = Omit<Product, 'id'>;
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isPending()) {
          <p>Cargando…</p>
        } @else if (products.isError()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.data() ?? []; track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      private readonly http = inject(HttpClient);
      private readonly queryClient = inject(QueryClient);
    
      readonly query = signal('');
    
      readonly products = injectQuery(() => ({
        queryKey: ['products', this.query()],
        queryFn: () =>
          lastValueFrom(
            this.http.get<Product[]>(`/api/products?q=${encodeURIComponent(this.query())}`),
          ),
      }));
    
      readonly createProduct = injectMutation(() => ({
        mutationFn: (product: NewProduct) =>
          lastValueFrom(this.http.post<Product>('/api/products', product)),
        onSuccess: () => {
          this.queryClient.invalidateQueries({ queryKey: ['products'] });
        },
      }));
    }
    

    Fíjate en lo que aparece y en lo que desaparece.

    Aparece el queryKey: ese array es la identidad de los datos en toda la aplicación. Si otros seis componentes montan la misma clave, hay una sola petición y una sola copia en memoria. Y aparece invalidateQueries, la pieza que httpResource no tiene: un componente puede invalidar datos que él nunca pidió.

    Desaparece la simplicidad. Tienes un provider global, un queryFn que devuelve promesas (de ahí el lastValueFrom para puentear el observable de HttpClient) y un vocabulario nuevo que todo el equipo tiene que aprender.

    Tabla comparativa: httpResource vs TanStack Query en Angular 22

    Solo celdas verificadas contra la documentación y los tipos publicados de ambos proyectos, a septiembre de 2026: Angular 22.1.4 y @tanstack/angular-query-experimental 5.102.8.

    Criterio httpResource (Angular 22) TanStack Query (adaptador Angular)
    Estabilidad Estable desde v22.0 Experimental: breaking changes en releases minor y patch
    Dependencias Ninguna, viene en @angular/common/http @tanstack/angular-query-experimental, que arrastra @tanstack/query-core
    Caché compartida entre componentes No Sí, por queryKey
    Deduplicación de peticiones en vuelo No entre instancias; cancela su propia petición anterior Sí, por clave
    Invalidación por clave No queryClient.invalidateQueries({ queryKey })
    Stale-while-revalidate Conserva el valor anterior mientras recarga, pero no hay política de caducidad ni refetch en segundo plano Sí, con staleTime y refetch en segundo plano
    Reintentos automáticos No incluidos (las opciones son parse, defaultValue, injector, equal y debugName) Sí, tres reintentos por defecto con backoff exponencial
    Mutaciones y updates optimistas Fuera de alcance por diseño injectMutation con invalidación en onSuccess
    Paginación infinita A mano injectInfiniteQuery
    Devtools de datos Sin panel de caché propio; los nodos aparecen en el signal graph de Angular DevTools vía debugName withDevtools() desde el subpath /devtools
    Interceptors de HttpClient Siempre, usa HttpClient por debajo Solo si el queryFn usa HttpClient
    Testing HttpTestingController estándar provideTanStackQuery en TestBed, QueryClient nuevo por spec, retry: false, y requiere Angular ≥ 19
    SSR / hydration Entra en el transfer cache de provideClientHydration Sin guía de SSR propia para Angular; expone injectIsRestoring
    Versión mínima de Angular 22 para la versión estable 16 (19 para la integración de testing)

    Dónde httpResource se queda corto de verdad

    No voy a defender la API estándar más allá de lo que aguanta. Hay cuatro escenarios en los que httpResource te deja escribiendo infraestructura a mano.

    Caché compartida entre componentes. Si el header, la sidebar y la tabla montan tres httpResource contra /api/user, son tres peticiones. No hay almacén común. Puedes subir el resource a un servicio con providedIn: 'root' y compartirlo, claro, pero eso ya es tu caché artesanal, con tus reglas de caducidad escritas por ti y mantenidas por ti.

    Invalidación cruzada tras una mutación. Guardas un producto en un modal y necesitas refrescar el listado, el contador del carrito y el widget de novedades. Con httpResource toca llamar a reload() en cada uno, lo que obliga al modal a conocer a esos tres. Es acoplamiento, y escala mal.

    Paginación infinita. Acumular páginas, saber si hay siguiente, mantener el scroll. injectInfiniteQuery te lo da resuelto. A mano son varias tardes y unos cuantos bugs sutiles.

    Actualizaciones optimistas con rollback. Pintar el cambio antes de que responda el servidor y deshacerlo limpio si falla es un problema de gestión de estado, no de HTTP.

    Y añado una limitación que no es un defecto sino una decisión de diseño: la documentación de Angular es explícita en que hay que evitar httpResource para mutaciones tipo POST o PUT, y usar directamente HttpClient. httpResource lee; no escribe.

    Dónde TanStack Query te sale caro

    Empecemos por lo que está escrito en su propia web, palabra por palabra:

    "This library is currently in an experimental stage. This means that breaking changes will happen in minor AND patch releases."

    Léelo otra vez, porque no es la típica etiqueta beta de adorno. Es el equipo de TanStack diciéndote que un patch puede romperte la capa de datos. Y no es un aviso antiguo: sigue ahí, en la documentación del adaptador de Angular, con el paquete en la versión 5.102.8. El "experimental" está en el nombre del paquete que vas a escribir en tu package.json.

    En una prueba de concepto da igual. En una aplicación de empresa que va a vivir cinco años y que mantendrá otro equipo, eso significa fijar la versión, leerte cada changelog y aceptar que una parte crítica de tu arquitectura evoluciona a un ritmo que tú no controlas.

    El segundo coste es más sutil: te sales del ecosistema de HttpClient. Los interceptors de Angular solo se aplican si tu queryFn usa HttpClient. En cuanto alguien del equipo escribe un queryFn con fetch porque le resulta más cómodo, esa petición se salta el interceptor de auth, el de reintentos y el de trazas. Y no falla en desarrollo: falla el día que caduca un token en producción.

    Ese mismo salto te afecta al testing. httpResource se testea con HttpTestingController, igual que cualquier otra llamada de tu aplicación. Con TanStack Query montas provideTanStackQuery en el TestBed, creas un QueryClient limpio en cada spec, desactivas los reintentos para que los fallos no tarden tres backoffs y esperas a whenStable(). Se puede, está documentado, pero es una capa más que mantener. Si quieres el enfoque completo de testing en Angular moderno, lo tienes en el curso de Testing en Angular con Jest y Testing Library.

    Y el tercer coste es el SSR. httpResource usa HttpClient, así que se beneficia del transfer cache de la hidratación sin que hagas nada. El adaptador de Angular de TanStack Query no publica hoy una guía de SSR equivalente a la de React.

    Veredicto: el árbol de decisión

    Me mojo.

    Por defecto, httpResource. En un proyecto Angular 22 nuevo, empieza con la API estándar. Es estable, no amplía tu superficie de dependencias, integra con interceptors, testing y SSR, y cubre el 80% de los casos reales: listados, detalles, filtros, buscadores. Si hoy dudas, esta es tu respuesta.

    TanStack Query cuando se cumplen las tres condiciones a la vez:

    1. Varios componentes independientes consumen los mismos datos de servidor y quieres una única fuente en memoria.
    2. Necesitas invalidación cruzada tras mutaciones, scroll infinito o updates optimistas, y ya has calculado lo que cuesta escribir todo eso a mano.
    3. Aceptas el riesgo de breaking changes en versiones patch y vas a fijar la versión exacta.

    Si falla una sola de las tres, no lo metas.

    Y la opción que casi nadie considera: los dos. No son excluyentes. Puedes servir el grueso de tus pantallas con httpResource y reservar TanStack Query para el módulo de dashboard donde de verdad existe un problema de caché compartida. Aísla la decisión en una zona del código en lugar de casarte con ella en toda la aplicación.

    Lo que no vale es lo que hacía el dev del package.json: instalarlo el primer día porque en React lo usabas. Angular 22 no es React. El grafo de señales que llegó con la v22 ya te da reactividad de primera clase, y esa es justo la pieza que TanStack Query tuvo que inventar en el mundo de los hooks.

    Qué hacer hoy

    Abre tu proyecto y cuenta cuántos componentes distintos piden el mismo endpoint. Solo eso.

    Si el número es cero o uno, no tienes un problema de caché de servidor: tienes peticiones reactivas, y httpResource te sobra para resolverlas. Si el número es tres o más, y además hay mutaciones que deben refrescar varias vistas a la vez, ahí sí te has ganado el derecho a meter una dependencia externa en la capa de datos.

    Ese conteo tarda diez minutos y vale más que cualquier hilo de discusión en X.

    En Dominicode Labs trabajamos este tipo de decisiones de arquitectura sobre proyectos reales, no sobre ejemplos de listas de tareas. Y si prefieres verlo en vídeo, en el canal de YouTube publico cada semana contenido de Angular moderno e IA aplicada al desarrollo.

    Preguntas frecuentes

    ¿Qué es mejor en Angular 22, httpResource o TanStack Query?

    httpResource es la mejor opción por defecto en Angular 22: es la API estándar, es estable desde la versión 22.0, no añade dependencias y hereda los interceptors, el testing y el transfer cache de HttpClient. TanStack Query solo compensa cuando varios componentes independientes consumen los mismos datos y necesitas invalidación por clave, mutaciones optimistas o scroll infinito. No resuelven el mismo problema: httpResource es una primitiva de petición reactiva y TanStack Query es una capa de caché de estado de servidor.

    ¿httpResource cachea las peticiones?

    No, y ese malentendido origina la mitad de las discusiones sobre el tema. httpResource no mantiene un almacén de datos por clave: lanza la petición cuando cambian las señales de las que depende y expone el resultado como señal. Si necesitas que varios componentes compartan la misma copia en memoria, tienes que construir esa caché tú, por ejemplo elevando el resource a un servicio raíz, o usar una librería que ya la traiga resuelta.

    ¿Puedo usar httpResource y TanStack Query en la misma aplicación?

    Sí, y en muchos proyectos es la decisión más sensata. Nada impide resolver el grueso de las pantallas con la API estándar de Angular y reservar TanStack Query para el módulo concreto que tiene un problema real de caché compartida e invalidación cruzada. Así limitas la superficie de la dependencia externa a una zona del código, en lugar de extenderla por toda la base.

    ¿Es seguro usar el adaptador de Angular de TanStack Query en producción?

    Sí, siempre que fijes la versión exacta, revises el changelog antes de cada actualización y tengas tests que cubran la capa de datos. El riesgo está declarado en su propia documentación: habrá cambios que rompan en versiones minor y también en versiones patch. Si el proyecto lo va a mantener otro equipo dentro de dos años, piénsalo dos veces.

    ¿Los interceptors de HttpClient funcionan con TanStack Query?

    Solo si la función de la query usa HttpClient por debajo. Si alguien la escribe con fetch o con axios porque le resulta más cómodo, esa petición se salta los interceptors de autenticación, reintentos y trazas de Angular, y el problema aparecerá en producción y no en desarrollo. Si adoptas la librería, conviene dejar por escrito en el equipo que toda petición pasa por HttpClient.

    ¿Sirve httpResource para POST y PUT?

    No, y no es una limitación sino una decisión de diseño. La documentación de Angular recomienda de forma explícita evitar httpResource para mutaciones y usar directamente las APIs de HttpClient. httpResource está pensado para leer datos de forma reactiva; escribir es otro problema, con otro ciclo de vida y otros requisitos de control de errores.

    ¿Qué versión de Angular necesito para cada opción?

    httpResource es estable desde Angular 22.0 y vive en el paquete de HTTP común, así que no tienes que instalar nada. El adaptador de TanStack Query declara compatibilidad desde Angular 16 en adelante, aunque su propia guía de testing avisa de que esa integración requiere Angular 19 o superior, porque las versiones anteriores no soportan PendingTasks.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Ciclo de releases de Angular: una major cada 12 meses

    Ciclo de releases de Angular: una major cada 12 meses

    El 24 de julio de 2026 se mergeó un PR en el repositorio de Angular. Número 69817. Título: docs: add v23 release and change to yearly release cycle.

    Un PR de documentación. Sin keynote, sin post oficial, sin hilo en X. Una línea de docs sobre el ciclo de releases de Angular, mergeada en main y backporteada a las ramas 22.0.x y 22.1.x.

    Dentro va un cambio que decide cómo planificas los próximos tres años de tu proyecto: se pasa de una major cada seis meses a una major cada doce.

    Se mergeó el 24 de julio de 2026 y apenas ha circulado. La mayoría de los equipos se va a enterar el día que abra el calendario del año que viene para reservar su ventana de migración y no encuentre nada donde esperaba encontrar una major.

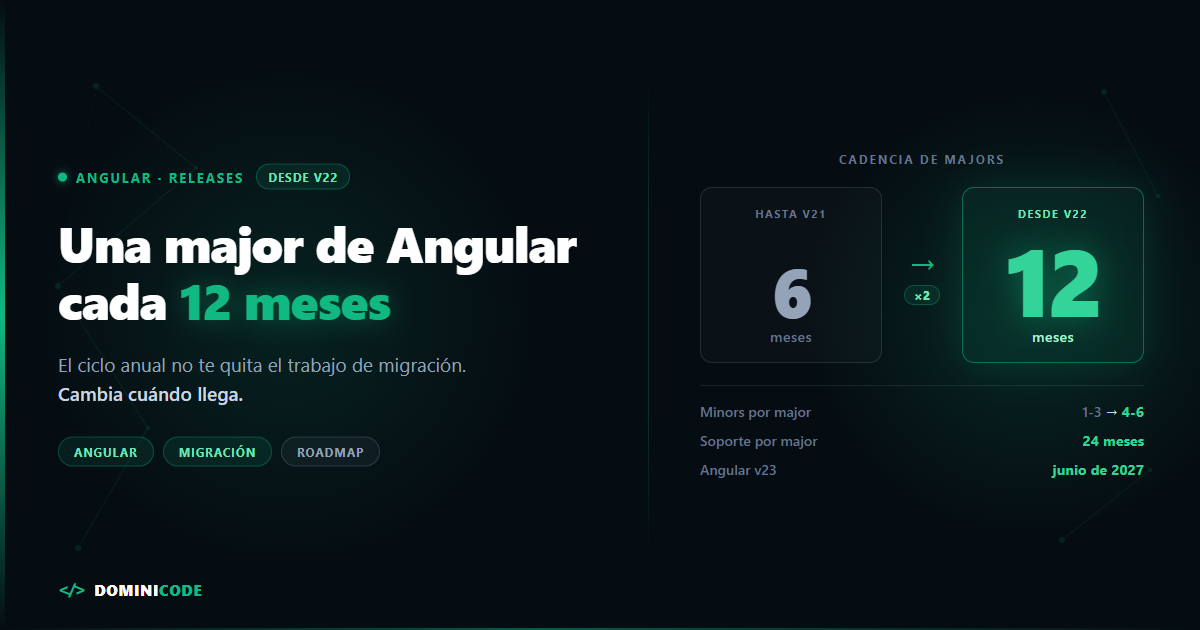
    En corto: desde Angular v22, Angular publica una versión major cada 12 meses en lugar de cada 6. La siguiente major, Angular v23, está fechada para junio de 2027. Entre medias llegan de 4 a 6 minors con features nuevas, y los patches siguen saliendo casi cada semana.

    Qué cambia exactamente en el ciclo de releases de Angular

    Angular publica una major cada 12 meses desde la v22. Antes eran 6. Los datos son cortos:

    Tipo de release Hasta Angular v21 Desde Angular v22
    Versión major cada 6 meses cada 12 meses
    Minors por cada major 1-3 4-6
    Patches y pre-releases (next / rc) casi cada semana casi cada semana
    Soporte activo por major ~6 meses 12 meses
    Soporte total (activo + LTS) ~18 meses 24 meses

    Fuente: Versioning and releases, documentación oficial de Angular.

    La justificación oficial, traducida:

    "La comunidad lleva mucho tiempo pidiendo majors menos frecuentes por el impacto que tienen los breaking changes y las actualizaciones, tanto en sus proyectos como en clientes enterprise. Además, un ciclo de release más largo proporciona mayor estabilidad de API para los developers que usan flujos de trabajo agénticos, sin dejar de entregar una cadencia razonable de mejoras y migraciones de API."

    — PR #69817, repositorio oficial de Angular.

    Dos motivos. El segundo es el interesante, y vuelvo a él más abajo.

    ¿Cuándo sale Angular v23? El calendario del nuevo ciclo

    Angular v23.0 está fechada para junio de 2027, según el calendario oficial de releases. Hasta entonces la v22 recibe entre 4 y 6 minors —de la v22.1 a la v22.5— programadas hasta principios de 2027.

    Versión Fecha
    Angular v22.0 junio de 2026 (publicada)
    Minors v22.1 – v22.5 hasta principios de 2027
    Angular v23.0 ~ junio de 2027

    Y el ciclo anual también alarga el soporte. Cada major pasa a tener 24 meses de vida: 12 de soporte activo, con actualizaciones y parches regulares, y 12 más de LTS, solo con fixes críticos y de seguridad. En la práctica, Angular v22 tiene soporte activo hasta junio de 2027 y LTS hasta junio de 2028; la v21, con el ciclo viejo, tuvo activo poco más de seis meses.

    Tienes más margen. Pero el salto que te espera al final del margen es el doble de grande.

    Lo que no cambia: las features siguen saliendo en las minors

    Angular no ha frenado el desarrollo: las features siguen saliendo en las minors. Este es el malentendido que va a circular la semana que viene, así que lo corto ya.

    Lo único que queda restringido a las majors son los breaking changes. Las features siguen entrando por las minors, exactamente igual que hasta ahora.

    Y como las minors pasan de 1-3 por major a 4-6, el goteo de novedades no se corta. Si acaso, se estira.

    Lo que baja no es la velocidad de features. Es la frecuencia con la que Angular te obliga a tocar tu código.

    Si has seguido las novedades de Angular v22, ya sabes que el grueso de lo interesante llega goteando y no de golpe en el día de la major.

    Por qué el ciclo anual no te quita el trabajo de migración: cambia cuándo llega

    Un ciclo anual reduce el número de migraciones. Que reduzca el trabajo está por demostrar. Lo que hace seguro es agruparlo. Y es lo contrario de lo que vas a leer en los resúmenes de la noticia.

    Antes tenías un salto pequeño cada seis meses. Ahora tienes uno grande cada doce.

    Lo que baja seguro es el número de veces que paras: de seis eventos de migración en tres años a tres. Lo que no está anunciado en ninguna parte es que baje el volumen de cambios de API que tienes que absorber. Angular no ha dicho que vaya a romper menos cosas. Ha dicho que las va a agrupar.

    Puede que agrupar reduzca algo el total —dos cambios sobre la misma API en doce meses te llegan ya resueltos en uno—, pero eso está por ver. Lo que está decidido hoy es el reparto.

    Y el reparto no afecta igual a todos.

    Si vas al día, ganas. La mitad de migraciones que rompen algo, la mitad de ceremonias de actualización, la mitad de veces que paras un sprint para ejecutar ng update y arreglar lo que se ha roto. Para un equipo con disciplina, esto es dinero directo.

    Si arrastras retraso, pierdes. Un salto de doce meses no son dos saltos de seis pegados: es un salto en el que no puedes bisecar. Cuando algo se rompe tienes el doble de superficie donde buscar la causa, y las migraciones automáticas dejan de llevarte de la mano versión a versión. Si vienes de v17 o v18, ya hice el mapa de qué migrar primero, y ese orden importa más ahora que antes. Ya conté también el coste real de migrar a Angular 22, y ese coste no se reparte a la mitad por espaciarlo.

    Pero el problema de verdad no es el tamaño del salto.

    Es que una ventana más larga hace mucho más fácil quedarse atrás sin notarlo.

    Cuando la siguiente major está a seis meses, el retraso duele pronto. Te saltas una y en medio año ya tienes a alguien preguntando por qué seguís dos versiones por detrás.

    Cuando está a un año, la deuda no avisa. Las minors siguen ahí, pero una minor no te obliga a nada: la ignoras y no pasa nada. Lo que desaparece no son los avisos. Es el único aviso que no podías ignorar. Y la deuda técnica que no genera incomodidad es justo la que nadie prioriza.

    El ciclo anual es más cómodo. Y la comodidad, en gestión de dependencias, casi siempre se paga después.

    Por qué Angular justifica el ciclo anual con los agentes de IA

    Angular justifica su nueva cadencia, en parte, por cómo trabajan los agentes de código. Vuelve a la cita oficial y lee la segunda mitad: "proporciona mayor estabilidad de API para los developers que usan flujos de trabajo agénticos".

    Piensa en lo que significa. Un modelo que te ayuda a escribir Angular ha aprendido de código de muchas versiones a la vez. Cuando las APIs cambian cada seis meses, la probabilidad de que te proponga algo que ya no existe —un decorador retirado, una firma vieja, un patrón de la versión anterior— sube. Y ese código llega a tu PR con aspecto perfectamente razonable.

    Cada breaking change es ruido en lo que el modelo cree saber.

    Con dos matices que conviene poner encima de la mesa, porque son los que hacen el argumento correcto en vez de solo bonito.

    El primero: lo que pesa no es la frecuencia en abstracto, es cuántas majors han pasado desde el corte de entrenamiento del modelo que tienes abierto. Con majors anuales ese número se parte por la mitad, y un modelo de la misma edad sigue estando en lo cierto durante el doble de tiempo.

    El segundo: las versiones viejas no desaparecen. Angular 14 sigue en el corpus y seguirá. Bajar la cadencia no borra lo aprendido, solo frena lo que se acumula a partir de ahora. El efecto es real, pero se mide en años, no en el próximo release. Y un agente que trabaja con la documentación en contexto depende mucho menos de lo que recuerde: la cadencia importa sobre todo cuando el modelo tira de memoria.

    Que un framework grande diga esto en voz alta, aunque sea en un PR de documentación, es nuevo. Hasta ahora la cadencia se discutía pensando solo en humanos: cuánto aguanta un equipo, cuánto tarda una empresa en aprobar una subida de versión.

    Ahora entra un tercer actor en la conversación, y es el que escribe una parte creciente del código.

    No es una nota al pie. Es una señal de cómo se van a diseñar las herramientas los próximos años: asumiendo que quien las consume no siempre es una persona. Es una de las conversaciones que más tenemos en Dominicode Labs, porque cambia decisiones de arquitectura que hasta ayer parecían cerradas.

    Cómo planificar la migración de Angular con el nuevo ciclo de releases

    Tres cambios concretos en tu forma de trabajar.

    1. La actualización deja de ser un evento reactivo y pasa a ser una fecha

    Antes funcionaba el "ya actualizaremos cuando salga la siguiente". Con una major cada seis meses, ese reflejo te mantenía razonablemente cerca del head. Con una cada doce, ese mismo reflejo te regala un año entero para no hacer nada.

    Pon la ventana ahora. Angular v23 está fechada para junio de 2027: reserva las semanas en el roadmap antes de que el trimestre se llene de otra cosa.

    Y si no eres tú quien decide el roadmap, la versión pequeña es abrir el issue con las dos fechas escritas y dejarlo ahí. Cuando llegue la discusión —y va a llegar—, ya existe un sitio donde el tema está planteado y con tu nombre encima.

    2. Trata las minors como el ritmo real de adopción

    Con 4-6 minors por año, la minor es la unidad de trabajo, no la major. Un equipo que va absorbiendo minors llega a la major con medio trabajo hecho: los deprecation warnings ya los ha visto, las migraciones automáticas ya las ha corrido, el código nuevo ya usa las APIs nuevas.

    Un equipo que solo se mueve en majors llega a junio de 2027 con doce meses de sorpresas juntas.

    3. Asume que saltarte una major te deja el doble de lejos que antes

    Saltarte una major te ponía a doce meses de distancia del head. Ahora te pone a veinticuatro. Ese es el número que tienes que enseñar a quien decida si hay tiempo para actualizar o no.

    Un gesto concreto para empezar: ejecuta ng update sin argumentos. Te lista qué paquetes tienen actualización pendiente y a qué versión, sin tocar nada. Es el inventario en treinta segundos.

    4. Monta la red antes del salto, no durante

    Lo que convierte un salto grande en algo manejable es tener algo que te diga en cinco minutos qué se ha roto. Si tu proyecto sigue en Karma, Vitest ya es el default en Angular 22, y ese cambio se hace mejor ahora, con tiempo, que en mitad de la migración a la v23. Cómo montar esa suite —los patrones son los mismos con Jest o con Vitest— lo cubro paso a paso en el curso de Testing en Angular.

    Lo mismo aplica al resto del stack: migrar a TypeScript 6.0 con strict antes del salto convierte errores de runtime en errores de compilación, que es donde los quieres. Y si estás mirando más adelante, TypeScript 7.0 y su compilador en Go es la otra pieza del calendario que conviene tener en el radar.

    Lo que yo haría esta semana

    Abre el roadmap y escribe dos fechas: la de tu próxima adopción de minor y la ventana de la v23 en junio de 2027.

    Diez minutos. Es la diferencia entre llegar a la v23 con una actualización planificada o con una emergencia.

    Si estás poniendo al día un proyecto y quieres el mapa completo de lo que ha cambiado —signals, zoneless, el modelo mental nuevo—, lo tienes ordenado en el curso de Angular Moderno.

    El ciclo anual te ha dado más margen. Y el margen sin fecha no es margen: es aplazamiento.

    Preguntas frecuentes sobre el ciclo de releases de Angular

    ¿Cada cuánto sale ahora una versión major de Angular?

    Angular publica una versión major cada 12 meses a partir de la v22. Hasta ese cambio, el ciclo era de una major cada 6 meses. Entre major y major salen ahora entre 4 y 6 minors, frente a las 1-3 del ciclo anterior.

    ¿Hasta cuándo tiene soporte Angular 22?

    Angular v22 tiene soporte activo hasta junio de 2027 y soporte LTS hasta junio de 2028. Con el ciclo anual, cada versión major pasa a tener 24 meses de soporte en total: 12 meses de fase activa, con actualizaciones y parches regulares, y 12 meses de LTS, en los que solo se publican fixes críticos y de seguridad.

    ¿Cuándo sale Angular v23?

    Angular v23.0 está fechada para junio de 2027 aproximadamente, según el calendario oficial de releases. Hasta entonces las novedades llegan por las minors de la v22: de la v22.1 a la v22.5, programadas hasta principios de 2027.

    ¿Significa esto que Angular se ha ralentizado?

    No. Las features siguen saliendo en las minors, y ahora hay más minors por ciclo: entre 4 y 6 en lugar de 1-3. Lo único que queda restringido a las versiones major son los breaking changes. Los patches y las pre-releases next y rc siguen publicándose casi cada semana, igual que antes.

    ¿Qué pasa si voy retrasado varias versiones de Angular?

    Un proyecto retrasado sale perdiendo con el ciclo anual, porque cada salto de major concentra doce meses de breaking changes en lugar de seis. Además, una ventana más larga hace más fácil acumular retraso sin darse cuenta: no hay una major cercana que recuerde lo lejos que estás. Si arrastras versiones, ponte al día antes de junio de 2027 y hazlo en saltos pequeños, versión a versión, en vez de esperar a hacerlo todo junto.

    ¿Conviene esperar a Angular v23 para migrar?

    No conviene esperar. Llegar a junio de 2027 con el trabajo de la v22 sin hacer significa sumar dos saltos en una sola operación, con el doble de superficie que puede romperse a la vez. La estrategia que funciona es adoptar las minors de la v22 según salen y presentarse en la major con las migraciones automáticas ya ejecutadas y los deprecation warnings ya resueltos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Novedades de ECMAScript 2026 (ES17) en JavaScript

    Novedades de ECMAScript 2026 (ES17) en JavaScript

    Si llevas unos años programando en JavaScript, seguro que has tenido que lidiar con el clásico error de precisión aritmética: intentar sumar 0.1 y 0.2 en la consola de tu navegador y ver cómo devuelve 0.30000000000000004.

    Durante décadas, la respuesta de la comunidad ha sido la misma: "Es cosa del estándar IEEE 754 de coma flotante, acéptalo, redondea a mano o usa una librería externa".

    Por fin, Ecma International ha decidido poner fin a este y otros parches históricos con la aprobación oficial de ECMAScript 2026 (ES17).

    Hoy te quiero enseñar las características más importantes de este nuevo estándar que cambiarán tu forma de escribir JavaScript en tu día a día, y cuáles son las esperadas funciones que se han quedado a las puertas.


    Las características estrella de ES2026

    La versión 17 de la especificación oficial se centra en cerrar brechas históricas de la ergonomía del lenguaje, manipulación de datos binarios y control de errores:

    1. Math.sumPrecise (Suma exacta de flotantes)

    Se acabó el usar librerías externas o el típico truco de multiplicar por 100 y luego dividir solo para sumar decimales. El nuevo método Math.sumPrecise recibe un iterable de números y realiza una suma compensando matemáticamente las pérdidas de precisión de la coma flotante.

    const valores = [0.1, 0.2];
    // JavaScript tradicional: valores[0] + valores[1] => 0.30000000000000004
    const totalExacto = Math.sumPrecise(valores); // => 0.3
    

    2. Error.isError (Validación robusta de excepciones)

    Comprobar si un objeto capturado en un bloque catch es un error real mediante instanceof Error es frágil. Si el error proviene de otro contexto de ejecución (como un iframe en el navegador o un Web Worker en Node/Deno), la validación suele fallar. Error.isError soluciona esto aportando un chequeo universal y fiable a nivel interno del motor JS.

    3. Codificación nativa Hex y Base64 en Uint8Array

    Hasta ahora, convertir datos binarios a texto hexadecimal o Base64 requería funciones auxiliares complejas (Buffer.toString en Node o btoa/atob en navegador). ES2026 introduce métodos nativos directamente en el prototipo de Uint8Array para realizar conversiones de forma directa y de altísimo rendimiento.

    4. Valores por defecto en Mapas (Map.prototype)

    Se añaden nuevos métodos a Map y WeakMap para poder insertar un valor por defecto si una clave no existe en el mapa, simplificando la escritura de cachés o contadores.

    const visitas = new Map();
    // Inserta 1 si la clave no existe, o incrementa el valor actual
    visitas.getOrInsert("usuario_123", 0);
    

    5. Array.fromAsync e Iterator.concat

    Trabajar con generadores y flujos asíncronos ahora es mucho más ergonómico. Array.fromAsync permite construir un array a partir de iterables asíncronos de forma limpia, mientras que Iterator.concat facilita la unión de múltiples secuencias sin necesidad de cargarlas completas en memoria.


    Lo que se queda fuera (Las ausencias destacadas)

    A pesar de las altas expectativas que había durante su fase de desarrollo, algunas de las propuestas más esperadas no lograron entrar en la especificación final aprobada este año:

    • Temporal API (El nuevo Date): Aunque la comunidad lleva años demandando un reemplazo moderno, consistente y no mutable para el desastroso objeto Date tradicional, la API de Temporal sigue en revisión técnica activa y no forma parte del estándar oficial de 2026.
    • Explicit Resource Management (using): La esperada sintaxis de liberación automática de recursos (similar a la que encontramos en lenguajes como C# o TypeScript con la palabra clave using) tampoco logró cerrarse a tiempo para esta edición.

    Escribe código preparado para el futuro

    La evolución de JavaScript demuestra una clara tendencia a madurar el lenguaje, absorbiendo utilidades que antes requerían librerías de terceros (como Lodash o parches de buffer binario). Como vimos en nuestro post sobre oMLX y TypeScript en Mac, escribir código nativo limpio sobre los frameworks optimizados es la clave de la eficiencia en el desarrollo moderno.

    Adoptar las mejores prácticas de TypeScript avanzado y escribir código nativo limpio es exactamente el enfoque de calidad de software que defendemos en el curso de Construye con IA para estructurar aplicaciones robustas de producción.


    Conclusión: Simplifica tu código

    No sigas arrastrando dependencias externas para resolver tareas de precisión matemática básica o conversiones binarias. Revisa la documentación de ECMAScript 2026 y aprovecha las nuevas capacidades integradas del motor de JavaScript para limpiar tu código y mejorar la velocidad de tus ejecuciones.

    Si quieres debatir sobre el futuro de las APIs de JavaScript, patrones de TypeScript avanzado y compartir configuraciones de compilación con otros desarrolladores senior, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Cuándo podré usar las funciones de ES2026 en navegadores?

    La especificación ya ha sido aprobada de forma oficial. Los motores principales (V8 de Chrome/Node, JavaScriptCore de Safari y SpiderMonkey de Firefox) ya han implementado la mayoría de estas funciones de forma de forma experimental. Puedes utilizarlas hoy mismo actualizando tus entornos de desarrollo de Node.js o mediante polyfills si necesitas soporte para navegadores antiguos.

    ¿Cómo ayuda Math.sumPrecise con el rendimiento de arrays grandes?

    Math.sumPrecise está optimizado a nivel de compilación nativa en C++ en los motores de los navegadores. Al delegar la suma compensada de precisión directamente al motor en lugar de ejecutar un bucle con lógica de redondeo en JavaScript, la velocidad de procesamiento de grandes volúmenes de datos numéricos mejora sustancialmente.

    ¿Por qué instanceof Error falla en iframes y Web Workers?

    Porque cada iframe o Web Worker crea un contexto de ejecución global diferente (un Realm distinto) con su propio constructor Error. Por lo tanto, un error lanzado dentro de un iframe no se reconoce como instancia del objeto Error de la ventana principal de navegación, problema que resuelve el nuevo chequeo estático Error.isError.

    ¿Qué sucederá con la API de Temporal?

    La API de Temporal sigue estando en fase activa de desarrollo de Stage 3/4. Es una especificación sumamente compleja debido a la gestión de zonas horarias y calendarios. Es muy probable que se apruebe formalmente para la próxima iteración del estándar (ECMAScript 2027).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Resource API en Angular 22: el fin del subscribe() manual

    Resource API en Angular 22: el fin del subscribe() manual

    Revisé hace poco un componente de Angular que cargaba una lista de productos. Contaba los observables con los dedos: un BehaviorSubject para la categoría seleccionada, un switchMap hacia HttpClient, un catchError para los fallos, un takeUntilDestroyed para no dejar suscripciones vivas, y al final, un async pipe en el template.

    Todo correcto. Todo necesario. Y todo código que explica exactamente lo mismo que cualquier otro componente de carga de datos en la aplicación. La Resource API de Angular 22 resuelve exactamente este problema.

    Ese patrón tiene quince años. Angular 22 tiene la respuesta definitiva.

    Qué es la Resource API y por qué existe

    La Resource API es el mecanismo nativo de Angular para gestionar operaciones asíncronas dentro del sistema de Signals. No es una librería de terceros, no es un wrapper sobre RxJS: es la pieza que faltaba para que el modelo reactivo de Angular estuviera completo.

    La idea central es sencilla: tienes un signal que representa un parámetro (un ID, un filtro, una página), y quieres que Angular haga automáticamente el fetch cuando ese parámetro cambia. Sin subscribe, sin pipe, sin gestión manual del ciclo de vida.

    En Angular 22 el ecosistema completo se compone de tres APIs:

    • resource() — fetch genérico con Promise. Estable en v22.
    • rxResource() — puente para servicios basados en Observable. Estable en v22.
    • httpResource() — wrapper declarativo sobre HttpClient. Experimental en v22.

    El matiz de los estados de estabilidad importa. resource() y rxResource() ya son API pública con garantías de compatibilidad. httpResource() sigue marcado como experimental — la API puede cambiar. Para producción crítica, ten eso en cuenta.

    resource(): el punto de entrada

    Usa resource() cuando el origen de datos es una Promise o una función fetch directa. El parámetro reactivo se define en params, y la función que carga los datos en loader.

    import { ChangeDetectionStrategy, Component, signal, resource } from '@angular/core';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @switch (productos.status()) { @case ('loading') { <p>Cargando...</p> } @case ('reloading') { <p>Actualizando...</p> } @case ('error') { <p>Error: {{ productos.error() }}</p> } @default { @if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } } } <button (click)="categoria.set(categoria() + 1)">Siguiente</button> <button (click)="productos.reload()">Recargar</button> `, }) export class CatalogoComponent { categoria = signal(1);

    productos = resource<Producto[], { cat: number }>({ params: () => ({ cat: this.categoria() }), loader: ({ params, abortSignal }) => fetch(/api/products?category=${params.cat}, { signal: abortSignal }) .then(r => r.json()), }); }

    Dos errores que verás en código antiguo o en tutoriales desactualizados:

    • El campo se llama params, no request. Eso era la API experimental anterior.
    • Los estados son strings literales: 'loading', 'reloading', 'error'… ResourceStatus no es un enum TypeScript nativo — es un objeto de constantes (as const), así que se compara con strings literales, no con ResourceStatus.Loading.

    Cuando categoria cambia, Angular cancela el fetch anterior (usando el abortSignal que recibe el loader) y lanza uno nuevo. El ciclo de vida completo, gestionado sin escribir una sola línea de cleanup.

    rxResource(): para servicios que devuelven Observables

    La mayoría de proyectos Angular tienen servicios basados en HttpClient que devuelven Observable. Migrar todo a fetch puro no es viable ni deseable.

    rxResource() es el puente. En lugar de loader, usa stream, que devuelve un Observable.

    import { ChangeDetectionStrategy, Component, signal, inject } from '@angular/core';
    import { rxResource } from '@angular/core/rxjs-interop';
    import { HttpClient } from '@angular/common/http';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo-rx', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (productos.isLoading()) { <p>Cargando...</p> } @else if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } `, }) export class CatalogoRxComponent { private http = inject(HttpClient); categoria = signal(1);

    productos = rxResource({ params: () => ({ cat: this.categoria() }), stream: ({ params }) => this.http.get<Producto[]>(/api/products?category=${params.cat}), }); }

    Dos puntos que generan confusión frecuente:

    • El import correcto es @angular/core/rxjs-interop, no @angular/core.
    • El método se llama stream, no loader. Los ejemplos de versiones experimentales anteriores usaban loader, de ahí la confusión.

    httpResource(): la opción declarativa

    httpResource() va un paso más allá: elimina la necesidad de declarar un servicio intermedio para casos de fetching simple. Lo declaras directamente en el componente.

    import { ChangeDetectionStrategy, Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    

    interface User { id: number; name: string; }

    @Component({ selector: 'app-user-profile', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (user.isLoading()) { <p>Cargando...</p> } @else if (user.error()) { <p>Error al cargar el perfil</p> } @else if (user.hasValue()) { <p>{{ user.value()?.name }}</p> } `, }) export class UserProfileComponent { userId = signal(1);

    user = httpResource<User>(() => /api/user/${this.userId()}); }

    httpResource() expone dos signals exclusivos que no tienen resource() ni rxResource():

    • .statusCode() — el código HTTP de la respuesta (200, 404, 500…)
    • .headers() — las cabeceras de la respuesta

    Ambas son señales independientes de .status(), que sigue siendo el estado del ciclo de vida del recurso. Confundir .status() con .statusCode() es el error más frecuente al empezar con esta API.

    Para respuestas que no son JSON:

    // Texto plano
    const readme = httpResource.text(() => /docs/readme.md);
    

    // Binario const avatar = httpResource.blob(() => /api/user/${this.userId()}/avatar);

    Requiere provideHttpClient() en el bootstrap. Usa HttpClient e interceptores por debajo, así que tus interceptores de autenticación siguen funcionando sin cambiar nada.

    Recuerda que httpResource() sigue marcado como experimental en v22. Para proyectos con requisitos estrictos de estabilidad de API, usa rxResource() con tu servicio HttpClient habitual hasta que se estabilice.

    Cuándo usar cada uno

    No es una decisión complicada si tienes claros los criterios:

    | Situación | API recomendada | |—|—| | Fetch puro o API externa directa | resource() | | Tienes servicios con Observable existentes | rxResource() | | Fetching simple sin servicio intermedio (experimental) | httpResource() | | Necesitas el status code HTTP como signal | httpResource() |

    Las tres APIs comparten la misma superficie de lectura: .value(), .isLoading(), .error(), .hasValue(), .status(), .reload(). Cambiar de una a otra es mínimamente invasivo.

    Validación del dato en runtime

    El genérico de TypeScript solo existe en tiempo de compilación. Si el backend devuelve algo inesperado, httpResource() no lanzará ningún error — simplemente tendrás un objeto mal tipado en runtime.

    La opción parse existe exactamente para este caso:

    import { z } from 'zod';
    

    const UserSchema = z.object({ id: z.number(), name: z.string(), });

    user = httpResource( () => /api/user/${this.userId()}, { parse: UserSchema.parse } );

    Si el dato del backend no cumple el schema, el resource entra en estado 'error' automáticamente. Sin try/catch manual, sin runtime silencioso. Si quieres profundizar en cómo construir schemas robustos con Zod para este tipo de validación, el curso de Zod para TypeScript cubre exactamente estos patrones de producción.

    Lo que cambia en tu arquitectura

    La Resource API no elimina los servicios Angular — los reorganiza. Sigues necesitando servicios para encapsular lógica de negocio compleja, componer múltiples endpoints, o compartir estado entre componentes. Lo que elimina es el boilerplate de gestión de ciclo de vida en los componentes que simplemente cargan y muestran datos.

    Un componente que antes necesitaba un servicio, tres operadores RxJS y un takeUntilDestroyed ahora expresa la misma intención en diez líneas. La lógica no desaparece — se mueve al lugar correcto.

    Si quieres el cuadro completo — Signals, Resource API, Signal Forms, Zoneless y todo lo que llegó en v22 — el curso Angular Moderno tiene el módulo M10 dedicado íntegramente a Resource API con ejemplos sobre el proyecto ShopFlow.

    Qué hacer hoy

    Identifica en tu proyecto los componentes que tienen este patrón: signal o BehaviorSubject como parámetro, switchMap hacia HttpClient, y async pipe en el template.

    Esos son tus candidatos para migrar a rxResource(). No necesitas reescribir los servicios. Solo cambias la forma en que el componente consume el Observable.

    Empieza por un componente de solo lectura — uno que carga datos y no tiene formularios complejos. Comprueba que .status() en el template te da todo lo que necesitabas del loading$ que tenías antes.

    Si funciona ahí, tienes el patrón. El resto de la migración es repetirlo.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre resource() y httpResource() en Angular 22? resource() acepta cualquier función que devuelva una Promise — puedes usarlo con fetch, con SDKs externos, o con cualquier operación asíncrona. httpResource() es un wrapper declarativo sobre HttpClient que además expone el status code HTTP y las cabeceras como signals independientes. La diferencia clave: httpResource() sigue siendo experimental en v22; resource() es API estable.

    ¿Puedo usar rxResource() si tengo servicios que devuelven Observables? Sí. rxResource() está diseñado exactamente para ese caso. En lugar de loader, defines un stream que devuelve un Observable. Tus servicios existentes no cambian — solo cambia cómo el componente los consume.

    ¿La Resource API reemplaza completamente RxJS en Angular? No. RxJS sigue siendo útil para transformaciones complejas de streams, operadores avanzados y casos donde necesitas combinar múltiples fuentes. La Resource API reemplaza el patrón subscribe/unsubscribe para carga de datos HTTP en componentes — no todos los casos de uso reactivo.

    ¿Qué ocurre con los datos en caché cuando cambia el signal de parámetros? Cuando el signal de params cambia, el resource entra en estado 'reloading' (no 'loading'). El valor anterior sigue disponible en .value() durante la recarga. Esto permite mostrar datos obsoletos mientras llegan los nuevos, en lugar de mostrar un spinner que vacía la UI. Es el comportamiento por defecto — no necesitas configurarlo.

    ¿Funciona la Resource API con Angular SSR? Sí. httpResource() usa HttpClient internamente, que ya tiene soporte de transferencia de estado para SSR. Con resource() y rxResource() necesitas gestionar tú mismo la transferencia de estado si el servidor precarga datos. La integración más limpia con SSR actualmente es a través de httpResource() o rxResource() con un servicio que use TransferState.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode. Ha migrado proyectos Angular en producción desde v2 hasta v22.

    Sources: