Tag: AI

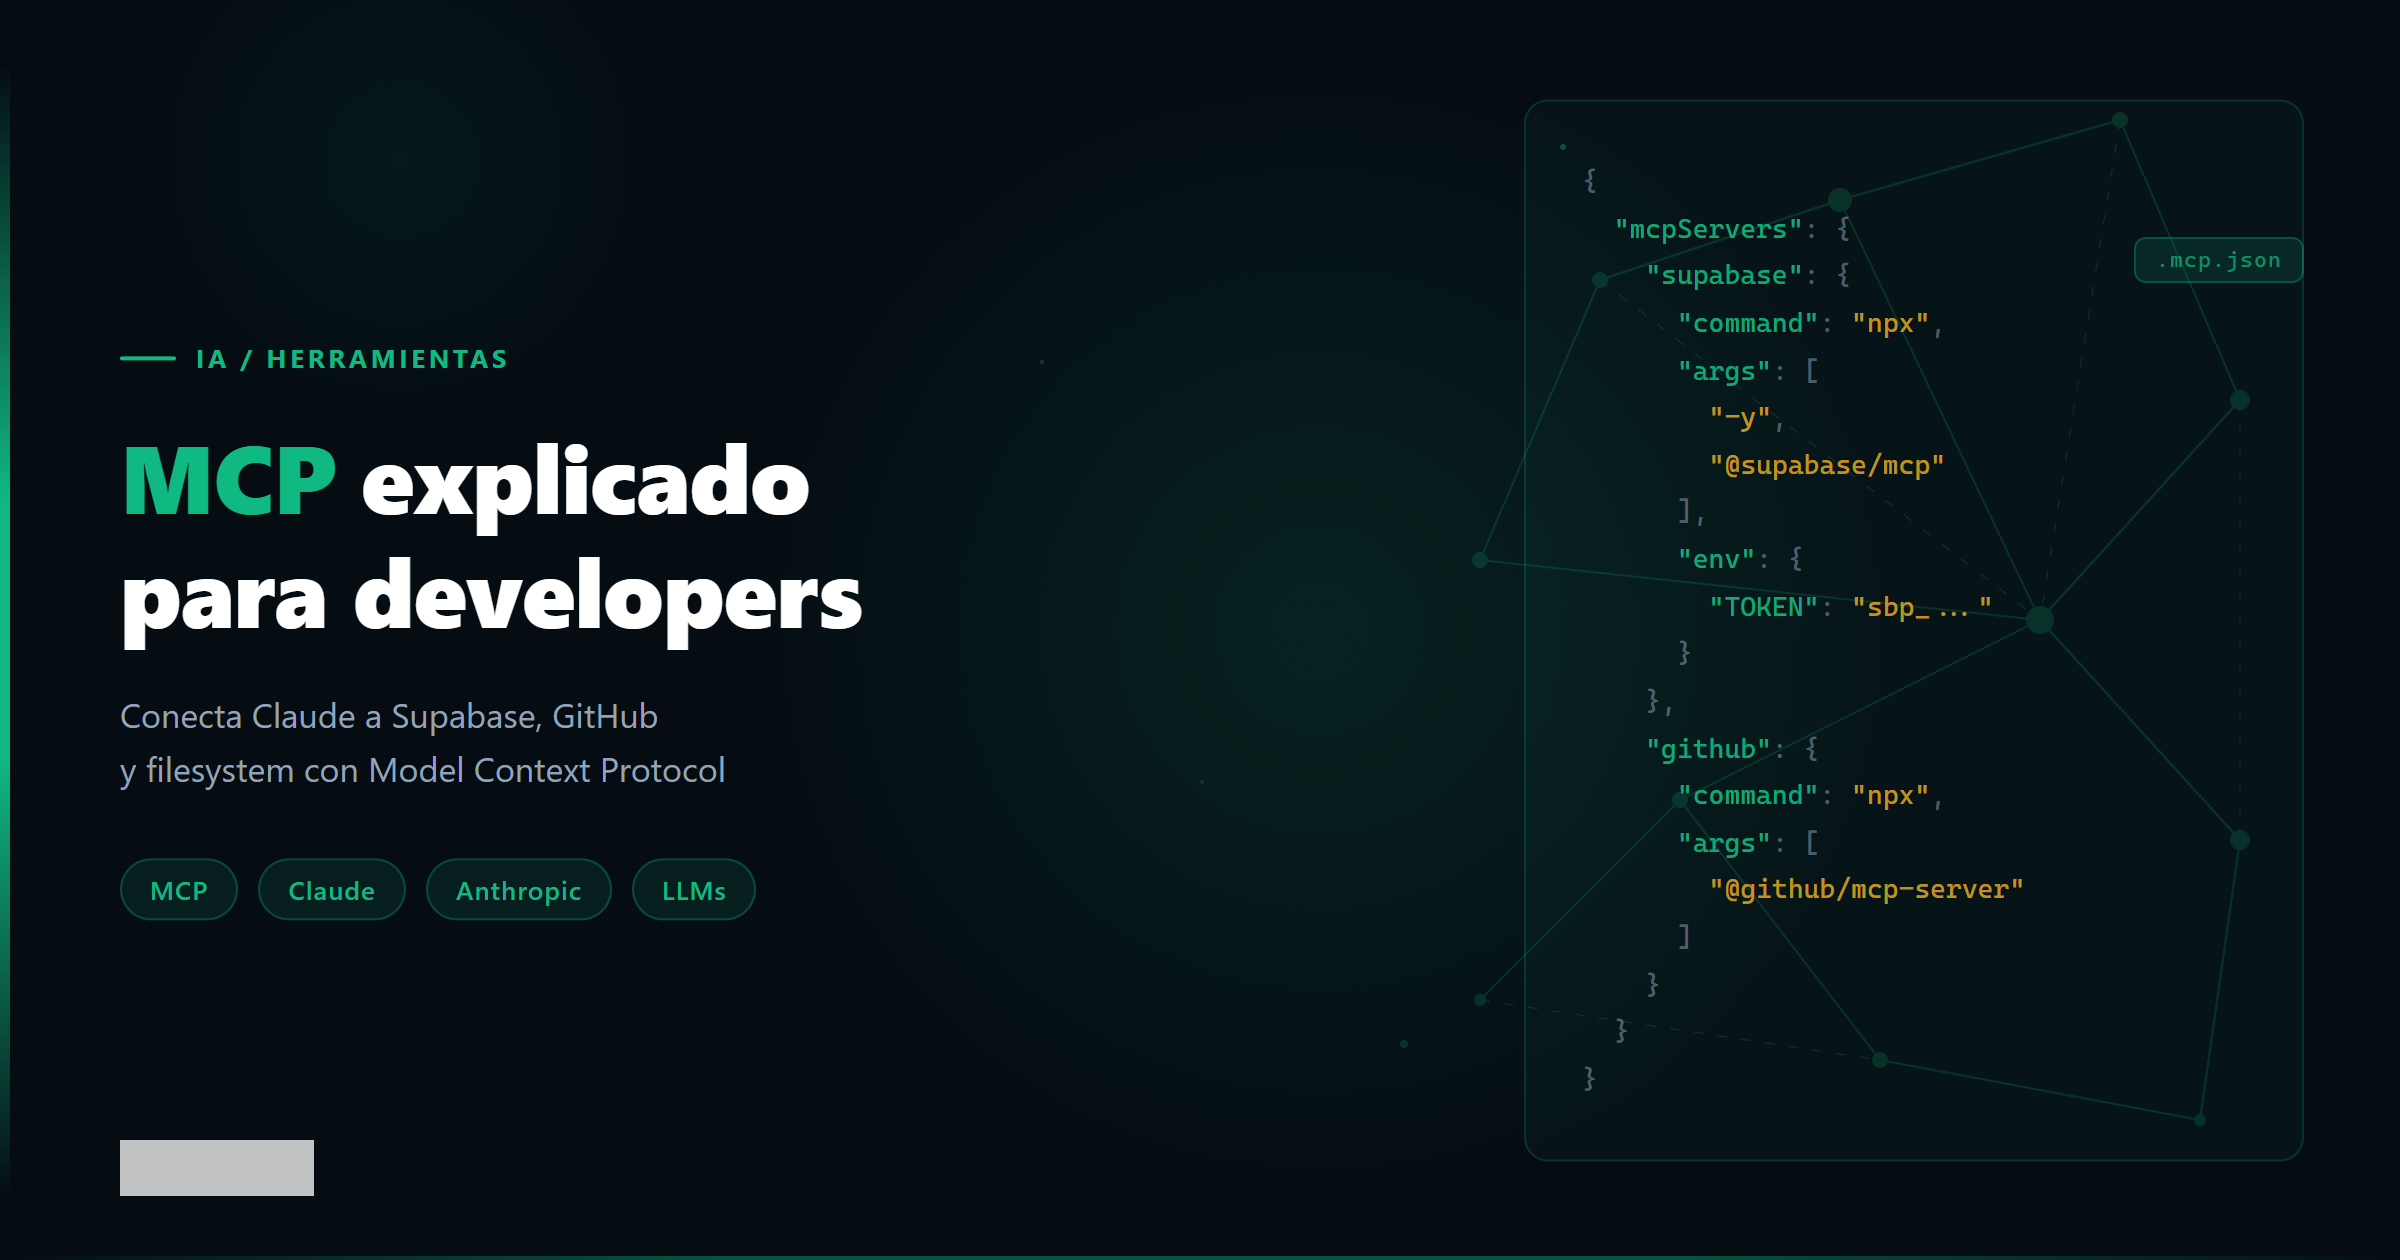
  • MCP explicado para developers: conecta Claude a tus herramientas

    MCP explicado para developers: conecta Claude a tus herramientas

    Hace unos meses estaba trabajando con Claude Code en un proyecto con Supabase. Quería que el agente pudiese consultar la base de datos, leer el schema, revisar los registros. Lo normal cuando construyes algo de verdad.

    El problema: Claude no podía llegar a Supabase por sí solo. Necesitaba que yo le pasase el contexto a mano — copiar y pegar schema, copiar y pegar queries, copiar y pegar resultados. El LLM hacía el trabajo intelectual, pero la conexión a las herramientas era un cuello de botella manual y frustrante.

    Eso era la vida antes de MCP (Model Context Protocol).

    Hoy, con el servidor MCP de Supabase configurado en Claude Code, el agente puede leer tablas, ejecutar queries y revisar logs sin que yo mueva un dedo. La diferencia no es pequeña. Es el salto entre un asistente que responde preguntas y un agente que trabaja de verdad.


    El problema que MCP viene a resolver

    Antes de MCP, si querías conectar un LLM a una herramienta externa — GitHub, una base de datos, Slack, tu sistema de archivos — tenías que construir esa integración desde cero para cada caso.

    Cada proveedor de LLM tenía su forma de hacer “function calling”. OpenAI tenía la suya. Anthropic tenía la suya. Google tenía la suya. Y cada herramienta que querías conectar necesitaba código custom adaptado a ese proveedor específico.

    El resultado: ecosistemas fragmentados. Integraciones que había que reescribir al cambiar de modelo. Código duplicado en cada proyecto. Y una fricción enorme para cualquier developer que quisiese construir algo más allá del chat básico.

    MCP es la respuesta a ese problema. Un protocolo único, abierto y estandarizado para que cualquier LLM se comunique con cualquier herramienta. Escribe el servidor una vez. Funciona con cualquier cliente compatible.


    Qué es MCP exactamente

    Model Context Protocol es un protocolo abierto — especificación pública, SDK con licencia MIT — creado por Anthropic en noviembre de 2024 y adoptado por la industria. Define cómo los LLMs se comunican con herramientas y fuentes de datos externas.

    La arquitectura tiene dos piezas:

    1. Cliente MCP — la aplicación host que aloja al LLM (Claude Code, Claude Desktop). Es quien inicia la conexión, gestiona qué servidores están disponibles y enruta las llamadas del modelo a las herramientas.
    2. Servidor MCP — el servicio que expone las herramientas. Puede ser Supabase, GitHub, tu sistema de archivos, Notion, Slack, o cualquier cosa que hayas construido tú mismo.

    El flujo de una interacción con MCP es el siguiente:

    1. El usuario hace una petición a Claude: “¿Cuántos usuarios se registraron esta semana?”
    2. Claude detecta que necesita datos de la base de datos.
    3. La aplicación host enruta la llamada al servidor MCP de Supabase.
    4. El servidor ejecuta la query y devuelve los resultados.
    5. Claude recibe la respuesta y continúa la conversación con datos reales.

    Todo esto ocurre dentro de la misma sesión, de forma transparente para el usuario. La especificación completa del protocolo está disponible en modelcontextprotocol.io, mantenida como estándar abierto.


    MCP vs Function Calling: la diferencia que importa

    Si llevas tiempo trabajando con LLMs probablemente conoces el concepto de function calling — la capacidad de un modelo de invocar funciones definidas por el developer.

    La confusión es comprensible. MCP y function calling resuelven el mismo problema superficialmente. Pero hay una diferencia fundamental:

    Criterio Function Calling MCP
    Compatibilidad Propietario por proveedor Protocolo abierto
    Portabilidad Reescribir al cambiar de modelo Un servidor, cualquier cliente
    Mantenimiento Código duplicado por proveedor Único punto de actualización
    Adopción Fragmentada Claude Code, Cursor y más

    Function calling es propietario. La especificación de cómo defines una función para OpenAI no es la misma que para Anthropic. Si cambias de modelo, reescribes las integraciones.

    MCP es el estándar universal. El servidor MCP que escribas hoy para conectar Claude a tu base de datos funciona también con cualquier otro cliente MCP que aparezca mañana. El servidor no sabe ni le importa qué LLM hay al otro lado.

    Es la diferencia entre construir sobre propietario y construir sobre estándar. La misma diferencia que existe entre HTTP y el protocolo interno de un servicio concreto.

    Si estás construyendo herramientas que los LLMs van a usar en producción, MCP es la apuesta correcta. Es la razón por la que en el curso Construye con IA trabajamos con MCP desde el principio — no porque sea lo más nuevo, sino porque es lo que tiene sentido en un stack real.


    Casos de uso reales para developers

    Supabase MCP. Claude puede leer el schema de tu base de datos, ejecutar queries, revisar los logs de error, inspeccionar las políticas RLS. Cuando estás debuggeando un problema en producción, tener al agente con acceso directo a la base de datos no es un lujo — es lo que separa minutos de horas.

    GitHub MCP. Claude puede leer Pull Requests, crear issues, revisar el historial de commits, comentar en code reviews. Si trabajas en un equipo o gestionas un proyecto open source, esto te cambia el flujo de trabajo.

    Filesystem MCP. Claude puede leer y escribir archivos en tu proyecto directamente. Esto es lo que usa Claude Code por defecto — el acceso al sistema de archivos es un servidor MCP. Cuando le dices a Claude “edita este archivo”, hay un servidor MCP detrás gestionando esa operación.

    Notion o Confluence MCP. Claude puede leer tu documentación, buscar en tus notas, actualizar páginas. Útil si tienes tu spec o tus decisiones de arquitectura en Notion y quieres que el agente las tenga en contexto sin tener que copiarlas manualmente.

    Slack MCP. Claude puede leer canales, buscar mensajes, enviar notificaciones. Si construyes pipelines de automatización, esto es la pieza que conecta el agente con tu equipo.

    El patrón es siempre el mismo: en lugar de que tú seas el intermediario entre el LLM y la herramienta, el protocolo gestiona esa conexión. Tu rol pasa de “copy-paste operator” a alguien que define qué herramientas el agente puede usar y con qué permisos.


    Cómo configurar un servidor MCP en Claude Code

    La parte práctica. Hay dos formas de configurar servidores MCP en Claude Code:

    Opción 1 — Configuración global (claudedesktopconfig.json) Esta configuración aplica a todas tus sesiones de Claude Code. El archivo vive en:

    • macOS: ~/Library/Application Support/Claude/claudedesktopconfig.json
    • Windows: %APPDATA%\Claude\claudedesktopconfig.json

    Opción 2 — Configuración por proyecto (.mcp.json) Un archivo .mcp.json en la raíz de tu proyecto. Solo aplica a ese proyecto. Es la opción que recomiendo — el contexto de las herramientas debe ser específico al proyecto, no global.

    Ejemplo práctico: MCP de filesystem

    {
      "mcpServers": {
        "filesystem": {
          "command": "npx",
          "args": [
            "-y",
            "@modelcontextprotocol/server-filesystem",
            "/Users/bezael/projects/mi-proyecto"
          ]
        }
      }
    }

    Con esto configurado, Claude puede leer y modificar archivos dentro de la ruta que especifiques. No tiene acceso a nada fuera de ese directorio — los permisos los defines tú.

    Ejemplo: MCP de Supabase

    {
      "mcpServers": {
        "supabase": {
          "command": "npx",
          "args": ["-y", "@supabase/mcp-server-supabase@latest"],
          "env": {
            "SUPABASE_URL": "https://tu-proyecto.supabase.co",
            "SUPABASE_SERVICE_ROLE_KEY": "tu-service-role-key"
          }
        }
      }
    }

    Una vez que reinicias Claude Code con esta configuración, el agente tiene acceso a tu base de datos. Puedes pedirle que revise el schema, que ejecute una query, que busque errores en los logs.

    Qué ocurre cuando Claude usa una herramienta MCP

    Por defecto, Claude Code te muestra cada llamada MCP antes de ejecutarla. Verás algo como:

    Tool call: filesystem.read_file
    Arguments: { "path": "/src/components/UserCard.tsx" }

    Puedes aprobarla, rechazarla o configurar permisos permanentes por servidor. El flujo de trabajo es transparente — no hay caja negra.

    Esto conecta directamente con lo que explico en el post sobre Context Engineering para proyectos de IA: el contexto que tiene el agente determina la calidad de sus decisiones. MCP es una de las palancas más directas para darle al agente contexto real, no simulado.


    El ecosistema MCP hoy

    La adopción ha sido rápida. Hoy existen servidores MCP oficiales o comunitarios para:

    • Supabase, PostgreSQL, SQLite
    • GitHub, GitLab, Linear
    • Notion, Confluence, Obsidian
    • Slack, Discord
    • AWS, Google Cloud
    • Playwright (para automatizar navegadores)
    • Docker
    • Y decenas más

    El registro de servidores MCP crece cada semana. Si la herramienta que necesitas no tiene servidor MCP todavía, puedes construir el tuyo — el SDK oficial de Anthropic para TypeScript y Python hace que crear un servidor MCP básico sea trabajo de pocas horas.


    Por dónde empezar hoy

    Si nunca has configurado un servidor MCP, el camino más corto es este:

    1. Abre Claude Code en un proyecto real tuyo.
    2. Crea un archivo .mcp.json en la raíz con el servidor de filesystem apuntando a tu directorio de trabajo.
    3. Reinicia Claude Code.
    4. Pídele que liste los archivos del proyecto, que lea un componente específico, que analice la estructura.

    No necesitas construir nada. Solo configurar. En menos de 10 minutos tienes un agente que trabaja con el contexto real de tu proyecto en lugar de con lo que tú le describes.

    Si todavía no tienes configurado el contexto base de tu proyecto, el post sobre cómo estructurar tu CLAUDE.md es el punto de partida — MCP y CLAUDE.md son complementarios, no alternativos.

    El siguiente paso natural es conectar tu base de datos si usas Supabase, o GitHub si gestionas un repositorio con actividad. Cada servidor MCP que añades amplía lo que el agente puede hacer sin intervención tuya.

    Y si quieres entender la arquitectura completa — no solo el protocolo MCP sino todo el sistema que lo rodea, de la spec al producto funcionando — eso es exactamente lo que cubrimos en el curso Construye con IA. Si quieres explorar esto con otros developers y ver proyectos reales con MCP en acción, en Dominicode Labs revisamos este tipo de proyectos regularmente.


    FAQ

    ¿MCP es solo para Claude o funciona con otros LLMs?

    MCP es un protocolo abierto — no es propietario de Anthropic en el sentido de que solo funcione con Claude. Otros clientes MCP compatibles pueden usar los mismos servidores. La apuesta de Anthropic fue precisamente crear un estándar que la industria pudiese adoptar, no una ventaja competitiva cerrada. Hoy el ecosistema está centrado en Claude Code y Claude Desktop, pero la adopción por parte de otros clientes está creciendo.

    ¿Es seguro darle acceso a Claude a mi base de datos o sistema de archivos?

    Depende de cómo lo configures. El servidor MCP de filesystem solo puede acceder a las rutas que tú especifiques — no tiene acceso a toda tu máquina. Con Supabase, usas la service role key, que tiene permisos amplios, por lo que hay que ser cuidadoso con qué operaciones permites. Por defecto Claude Code te muestra cada llamada MCP antes de ejecutarla. La regla general: mínimo privilegio — dale al servidor MCP exactamente los permisos que necesita, no más.

    ¿Necesito saber TypeScript o Python para usar MCP?

    Para usar servidores MCP existentes, no. Solo necesitas editar un archivo JSON de configuración y tener Node.js instalado (para los servidores que usan npx). Para construir tu propio servidor MCP, el SDK oficial de Anthropic está disponible en TypeScript y Python, y el punto de partida es sencillo — un servidor básico son menos de 50 líneas.

    ¿Cuál es la diferencia entre MCP y un plugin de ChatGPT?

    Los plugins de ChatGPT fueron un intento propietario de conectar LLMs a herramientas externas, y OpenAI los deprecó en 2024. MCP es un protocolo abierto, no una feature de un producto específico. La diferencia práctica: un servidor MCP que construyas hoy puede ser usado por cualquier cliente MCP compatible mañana. Un plugin de ChatGPT solo funcionaba con ChatGPT, con las restricciones y cambios que OpenAI decidiera unilateralmente.

    ¿MCP reemplaza completamente el function calling tradicional?

    No exactamente. Function calling sigue siendo el mecanismo subyacente — MCP lo usa internamente. Lo que MCP añade es la capa de estandarización: define cómo se describen las herramientas, cómo se comunica el cliente con el servidor, cómo se gestionan los errores. Es más una capa de protocolo sobre function calling que un reemplazo.


    *Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*
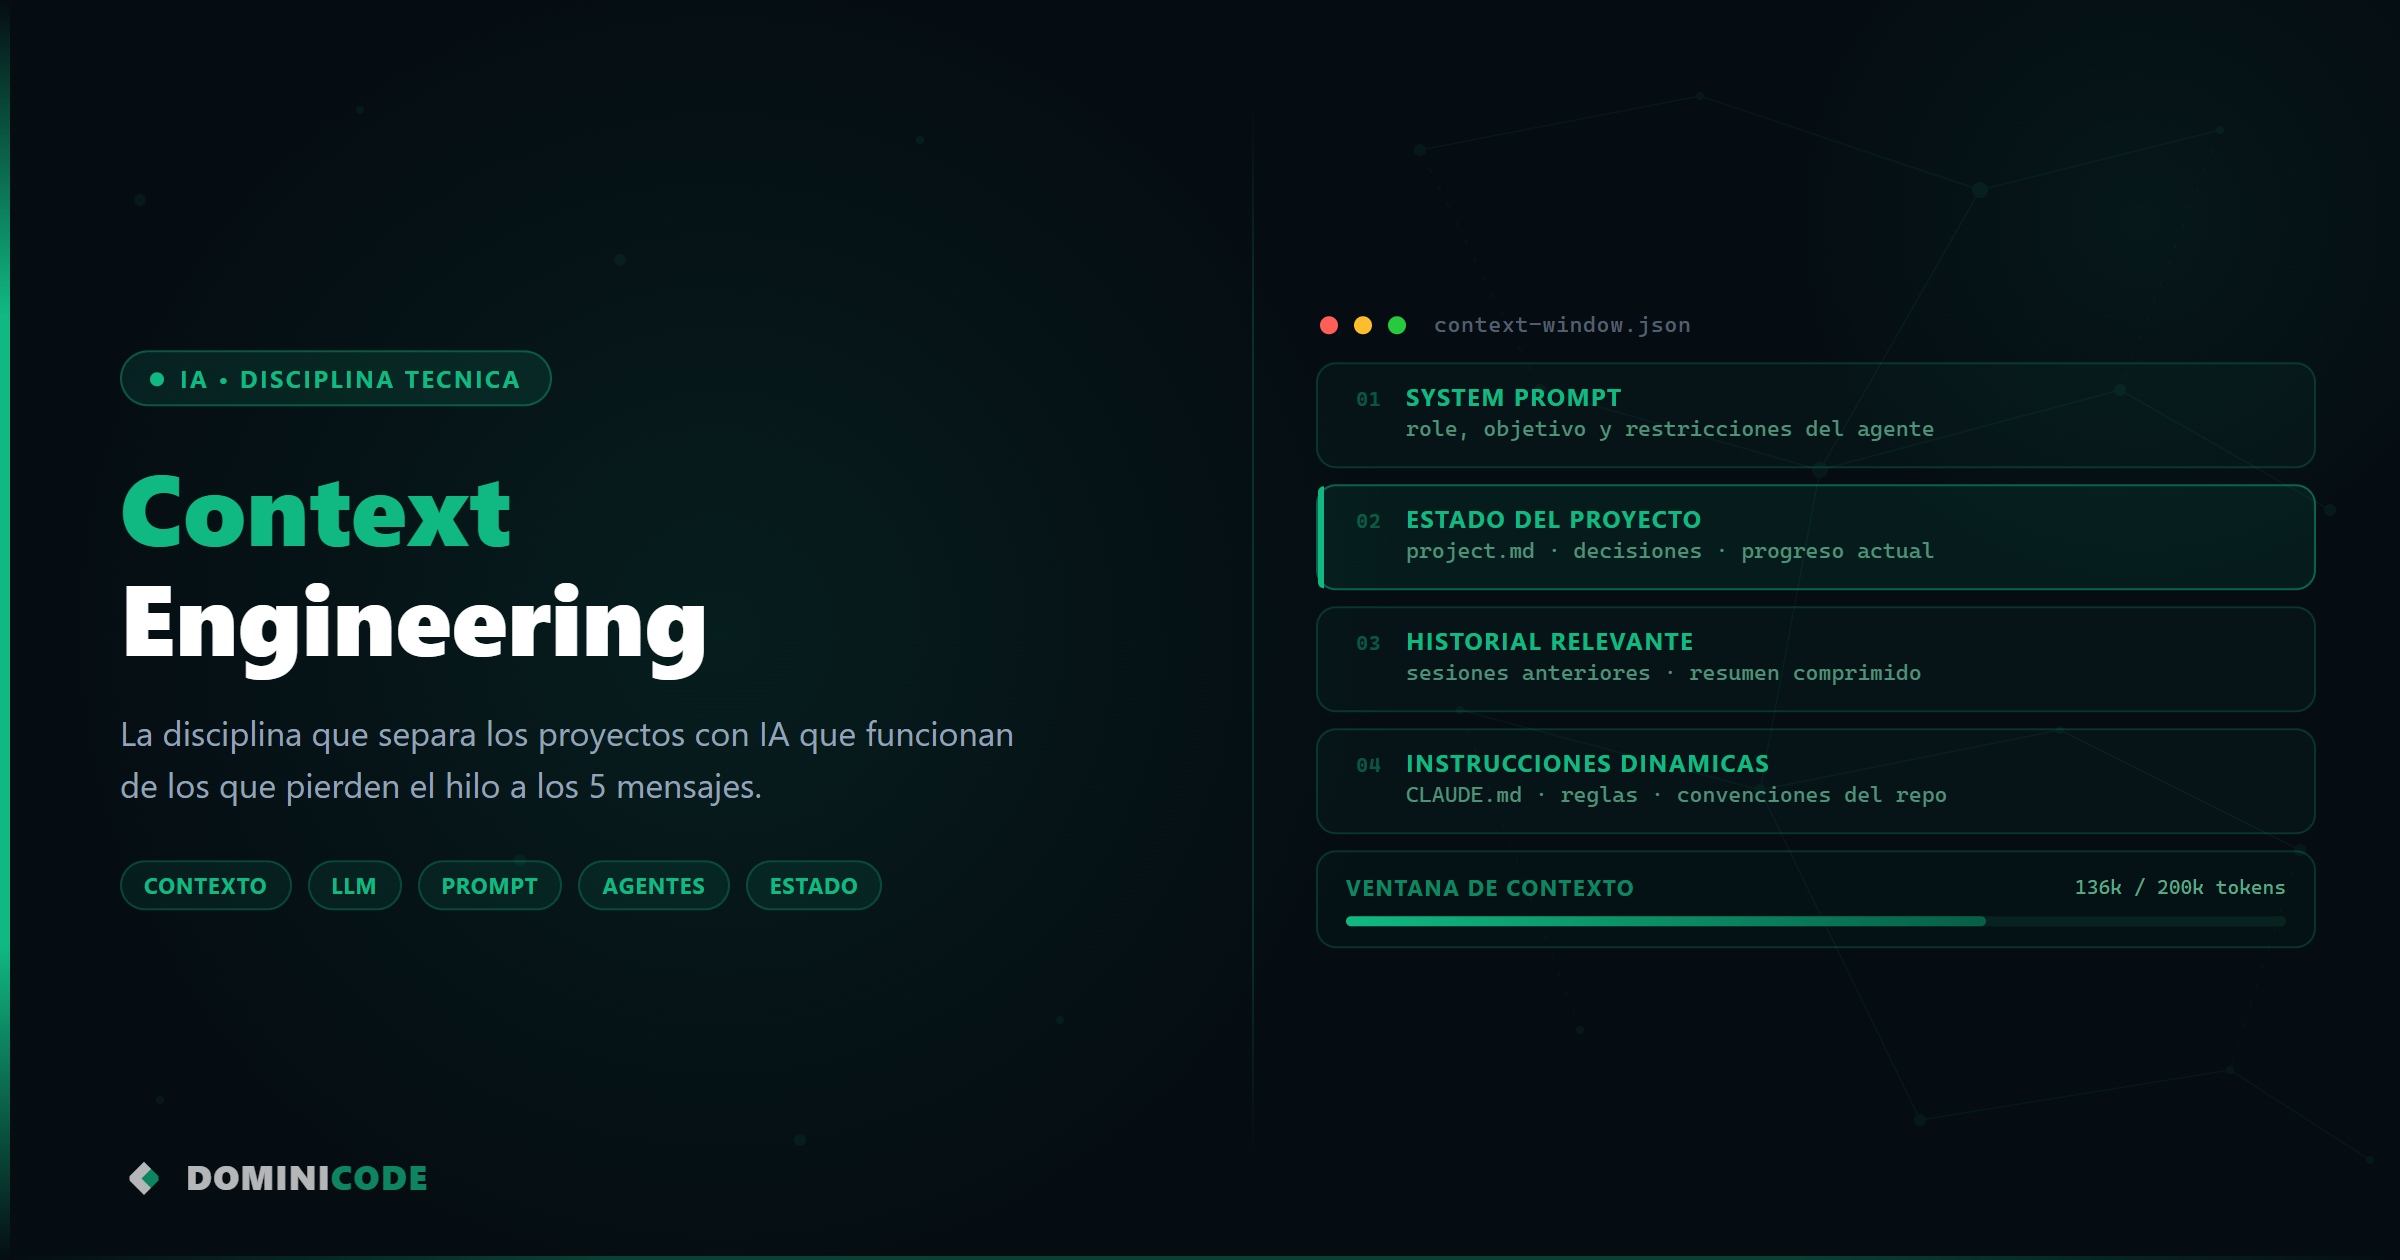
  • Context Engineering: proyectos con IA sin perder el hilo

    Context Engineering: proyectos con IA sin perder el hilo

    La primera vez que me pasó, pensé que era un fallo del modelo.

    Llevaba tres días construyendo una API con Claude Code. Arquitectura decidida, endpoints definidos, estructura de carpetas lista. Todo tenía sentido. Abrí una sesión nueva al cuarto día y le pedí que añadiera autenticación al módulo de usuarios.

    Me devolvió código que contradecía las decisiones que habíamos tomado el día anterior. Naming diferente. Patrón de errores distinto. Como si hubiera arrancado desde cero.

    No era un fallo del modelo. Era un fallo mío. No le había dado context engineering. Le había dado prompts.

    Lo que me faltaba tiene nombre. Y no es lo mismo que prompt engineering.


    El problema real: el modelo no sabe qué decidiste ayer

    Los LLMs no tienen memoria entre sesiones. Cada conversación nueva es, literalmente, una pizarra en blanco.

    Dentro de una misma sesión tienen una ventana de contexto — los modelos actuales manejan ventanas de entre 128k tokens (GPT-4o) y 200k tokens (Claude 3.5/3.7), cifras de junio 2026 que seguirán creciendo — pero esa ventana se llena. Y cuando se llena, el modelo empieza a “olvidar” las partes más antiguas de la conversación. Las decisiones de arquitectura que tomaste al principio. Las convenciones de naming que acordaste. El motivo por el que descartaste la opción B.

    El resultado es predecible: inconsistencia. Código que contradice decisiones previas. Respuestas que suenan razonables pero no encajan con el proyecto real. Y tú volviendo a explicar, sesión tras sesión, qué estás construyendo y cómo.

    Cualquier developer que haya usado IA durante más de dos semanas en un proyecto real lo ha vivido. La inconsistencia entre sesiones es la fricción número uno.


    Context engineering no es prompt engineering

    Mucha gente confunde los dos. No son lo mismo.

    Prompt engineering trata una sola interacción. Cómo formular la pregunta. Qué ejemplos incluir. Qué rol asignarle al modelo. Es útil, pero es táctica de un solo turno.

    Context engineering es la disciplina de estructurar y gestionar toda la información que recibe el modelo para que produzca resultados consistentes a lo largo de un proyecto completo. No en un prompt. En semanas de trabajo.

    La diferencia es la misma que hay entre saber hacer una buena pregunta en una entrevista y saber gestionar a un equipo durante un sprint.

    Prompt Engineering Context Engineering
    Alcance Un turno de conversación Un proyecto completo
    Problema que resuelve Calidad de una respuesta Consistencia entre sesiones
    Habilidad principal Redactar instrucciones claras Diseñar sistemas de información
    Cuándo falla Respuesta ambigua o incorrecta Proyecto incoherente en semana 3
    Herramienta clave El prompt en sí CLAUDE.md, specs, logs de decisiones

    Puedes ser un maestro del prompt engineering y aun así tener un proyecto que se rompe cada semana. El context engineering es lo que lo sostiene.


    Las 4 técnicas que uso en producción

    1. CLAUDE.md / AGENTS.md — la memoria persistente del proyecto

    Este es el punto de partida. Un archivo en la raíz del proyecto que le dice al modelo, al inicio de cada sesión, quién eres, qué estás construyendo y cómo trabajas.

    No es un README. Es un system prompt que el modelo lee antes de hacer nada.

    Lo mínimo que debe tener:

    • Descripción del proyecto en 2-3 líneas (qué es, para quién)
    • Stack técnico con versiones concretas
    • Convenciones de código que no se negocian
    • Lo que NO debe hacer el modelo (igual de importante)
    • Estado actual del proyecto — en qué fase estás

    Un ejemplo mínimo que uso en proyectos reales:

    # CLAUDE.md — API de Usuarios
    
    ## Proyecto
    API REST de gestión de usuarios para SaaS B2B.
    Stack: NestJS 10 + PostgreSQL + Prisma 5.
    
    ## Convenciones
    - Naming: camelCase para variables, PascalCase para clases, kebab-case para archivos
    - Errores: siempre usar HttpException con código y mensaje estructurado
    - No usar `any` en TypeScript — tipos explícitos o `unknown`
    
    ## NO hacer
    - No generar migraciones de Prisma automáticamente — las revisamos manualmente
    - No cambiar el schema sin actualizar architecture.md
    
    ## Estado actual
    Fase 2 — módulo de autenticación JWT. Ver tasks.md para detalle.
    

    Si usas Claude Code, este archivo es CLAUDE.md. Si usas Cursor o Windsurf, es __INLINE_PLACEHOLDER_0__ o __INLINE_PLACEHOLDER_1__ (__INLINE_PLACEHOLDER_2__ sigue siendo compatible pero es el formato legacy de Cursor). El nombre cambia. El concepto es el mismo.

    Ya escribí un post completo sobre cómo estructurar este archivo: CLAUDE.md: el system prompt de tu proyecto con Claude Code. Si no lo has leído, empieza por ahí.

    2. Archivos de estado — lo que el modelo no puede inferir

    El CLAUDE.md da el contexto estático: qué es el proyecto y cómo funciona. Pero los proyectos evolucionan. Necesitas capturar el estado dinámico.

    Yo mantengo tres archivos en cada proyecto:

    __INLINE_PLACEHOLDER_3__ — lista de tareas con estado (pendiente / en progreso / hecho). Una línea por tarea, fecha de última actualización. El modelo la lee y sabe exactamente dónde estás.

    __INLINE_PLACEHOLDER_4__ — log de decisiones arquitectónicas. Cada decisión con su fecha, la opción elegida y el motivo por el que se descartó la alternativa. Este archivo vale oro cuando vuelves a un proyecto tres semanas después.

    __INLINE_PLACEHOLDER_5__ — snapshot de la arquitectura actual. No el diagrama ideal. El diagrama real, con los módulos que existen ahora mismo. El modelo lo usa para no proponer soluciones que contradigan lo ya construido.

    Tres archivos. Ninguno supera las dos páginas. Pero juntos eliminan el 80% de la inconsistencia.

    3. Chunking de tareas — no pidas todo en un prompt

    Este error lo cometo yo también cuando tengo prisa.

    “Implementa el sistema de autenticación completo con JWT, refresh tokens, roles y middleware de autorización.”

    El modelo lo intenta. Genera código. Pero es código que asume cosas sobre tu proyecto que no conoce, o que contradice la arquitectura que ya tienes. Y cuando algo falla, el problema está distribuido en 400 líneas de código que no entiendes del todo.

    La regla que aplico: una tarea por sesión, una función por tarea.

    En lugar de pedir la autenticación completa, pido:

    1. Primero: el módulo de usuarios con su schema y validaciones
    2. Luego: la generación de JWT con los claims que necesito
    3. Luego: el endpoint de login que conecta ambos
    4. Luego: el middleware que verifica el token

    Cuatro sesiones. Cuatro archivos de contexto actualizados al final de cada una. Un sistema que entiendo porque lo construí pieza a pieza.

    El modelo produce mejor código cuando el scope es pequeño y el contexto es preciso. En la práctica, siempre.

    4. Resúmenes de sesión — el handoff entre el tú de hoy y el tú de mañana

    Al final de cada sesión de trabajo, antes de cerrar, escribo este prompt:

    “Resume lo que hemos hecho en esta sesión en 5-7 puntos: qué se implementó, qué decisiones se tomaron, qué problemas encontramos y qué queda pendiente para la siguiente.”

    Copio esa respuesta en un archivo __INLINE_PLACEHOLDER_6__ con la fecha.

    Cuando vuelvo al proyecto al día siguiente, la primera cosa que hago es darle ese log al modelo junto con el CLAUDE.md. El modelo arranca con el contexto exacto de donde lo dejé. Sin tener que re-explicar. Sin inconsistencias.

    Diez minutos al final de cada sesión que ahorran una hora al principio de la siguiente.


    Ejemplo práctico: un proyecto de tres semanas sin perder el hilo

    Semana 1 — Cimentar el contexto

    Antes de escribir una línea de código, genero la spec del proyecto con Spec-Driven Development: visión, usuarios, funcionalidades, arquitectura. Ese documento se convierte en la base del CLAUDE.md.

    Creo los tres archivos de estado vacíos: __INLINE_PLACEHOLDER_7__, __INLINE_PLACEHOLDER_8__, __INLINE_PLACEHOLDER_9__. El modelo los actualiza conforme avanzamos.

    Semana 2 — Construcción en chunks

    Cada sesión tiene una tarea concreta de __INLINE_PLACEHOLDER_10__. Arranca con el CLAUDE.md, el archivo de arquitectura y el log de la sesión anterior. Termina con el modelo actualizando el estado de la tarea y generando el resumen de sesión.

    Semana 3 — Cuando todo se complica

    En la semana 3 es cuando los proyectos sin sistema se rompen. El código empieza a contradecirse. Las decisiones del día 1 ya nadie las recuerda. Las nuevas funcionalidades no encajan con lo que ya existe.

    Con context engineering, la semana 3 es igual de fluida que la semana 1. Porque el modelo tiene, en cada sesión, el mismo nivel de contexto que tenías tú el primer día. El __INLINE_PLACEHOLDER_11__ le dice por qué tomaste las decisiones que tomaste. El __INLINE_PLACEHOLDER_12__ le muestra la estructura real. El log de sesión le dice dónde lo dejaste.

    No es magia. Es sistema.


    Lo que cambia cuando aplicas esto

    La diferencia no es velocidad. Es consistencia.

    Un developer sin context engineering puede ir rápido la primera semana. Pero en la semana 3, la deuda de contexto empieza a pasarle factura. Cada sesión nueva cuesta más porque hay que re-explicar más. Cada funcionalidad nueva tiene más probabilidad de romperse con algo anterior.

    Un developer con context engineering mantiene el mismo ritmo en la semana 8 que en la semana 1. Porque el contexto no es algo que se pierde — es algo que se gestiona.

    Esta es exactamente la mentalidad que enseño en el curso Construye con IA: de la idea al producto con Claude Code. No “cómo usar Claude”. Cómo construir con sistema.


    FAQ

    ¿El context engineering solo funciona con Claude Code?

    No. Los principios aplican a cualquier LLM y cualquier herramienta — Cursor, Windsurf, ChatGPT, Gemini. El CLAUDE.md tiene su equivalente en cada entorno: __INLINE_PLACEHOLDER_13__, __INLINE_PLACEHOLDER_14__, un system prompt inicial. La técnica de chunking y los resúmenes de sesión son agnósticos al modelo.

    ¿Cuánto tiempo añade a mi flujo de trabajo?

    En la práctica, entre 10 y 20 minutos al día. Cinco minutos actualizando el __INLINE_PLACEHOLDER_15__, diez minutos pidiendo y guardando el resumen de sesión. El retorno es que ahorras una o dos horas semanales de re-explicar contexto y corregir inconsistencias. La matemática es clara.

    ¿Necesito crear estos archivos manualmente desde cero?

    Puedes empezar con plantillas. En el curso Construye con IA incluyo las plantillas exactas de CLAUDE.md, __INLINE_PLACEHOLDER_16__ y __INLINE_PLACEHOLDER_17__ que uso en mis proyectos reales. Y si quieres la metodología de especificación completa, el libro SDD cubre el proceso de principio a fin.

    ¿Context engineering resuelve el problema de la ventana de contexto?

    Parcialmente. No puedes ampliar la ventana de contexto del modelo — eso lo determina el proveedor. Lo que puedes hacer es gestionar qué información entra en esa ventana en cada sesión. Context engineering te da control sobre eso: qué es esencial que el modelo sepa, qué puede inferir y qué no necesita en ese momento concreto. No elimina la limitación. La hace manejable.

    ¿Cuál es la diferencia entre context engineering y RAG?

    RAG (Retrieval-Augmented Generation) es una arquitectura técnica para recuperar información de fuentes externas y añadirla al contexto del modelo en tiempo de ejecución. Context engineering es una disciplina de trabajo que aplicas como developer para gestionar el contexto a lo largo de un proyecto. Son complementarios, no equivalentes. RAG es una herramienta. Context engineering es el sistema que decide qué información recuperar, cuándo y por qué.


    Si quieres profundizar en cómo aplicar estas técnicas con proyectos reales y ver el flujo en acción, en Dominicode Labs tenemos sesiones prácticas donde trabajamos esto con proyectos concretos de la comunidad.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

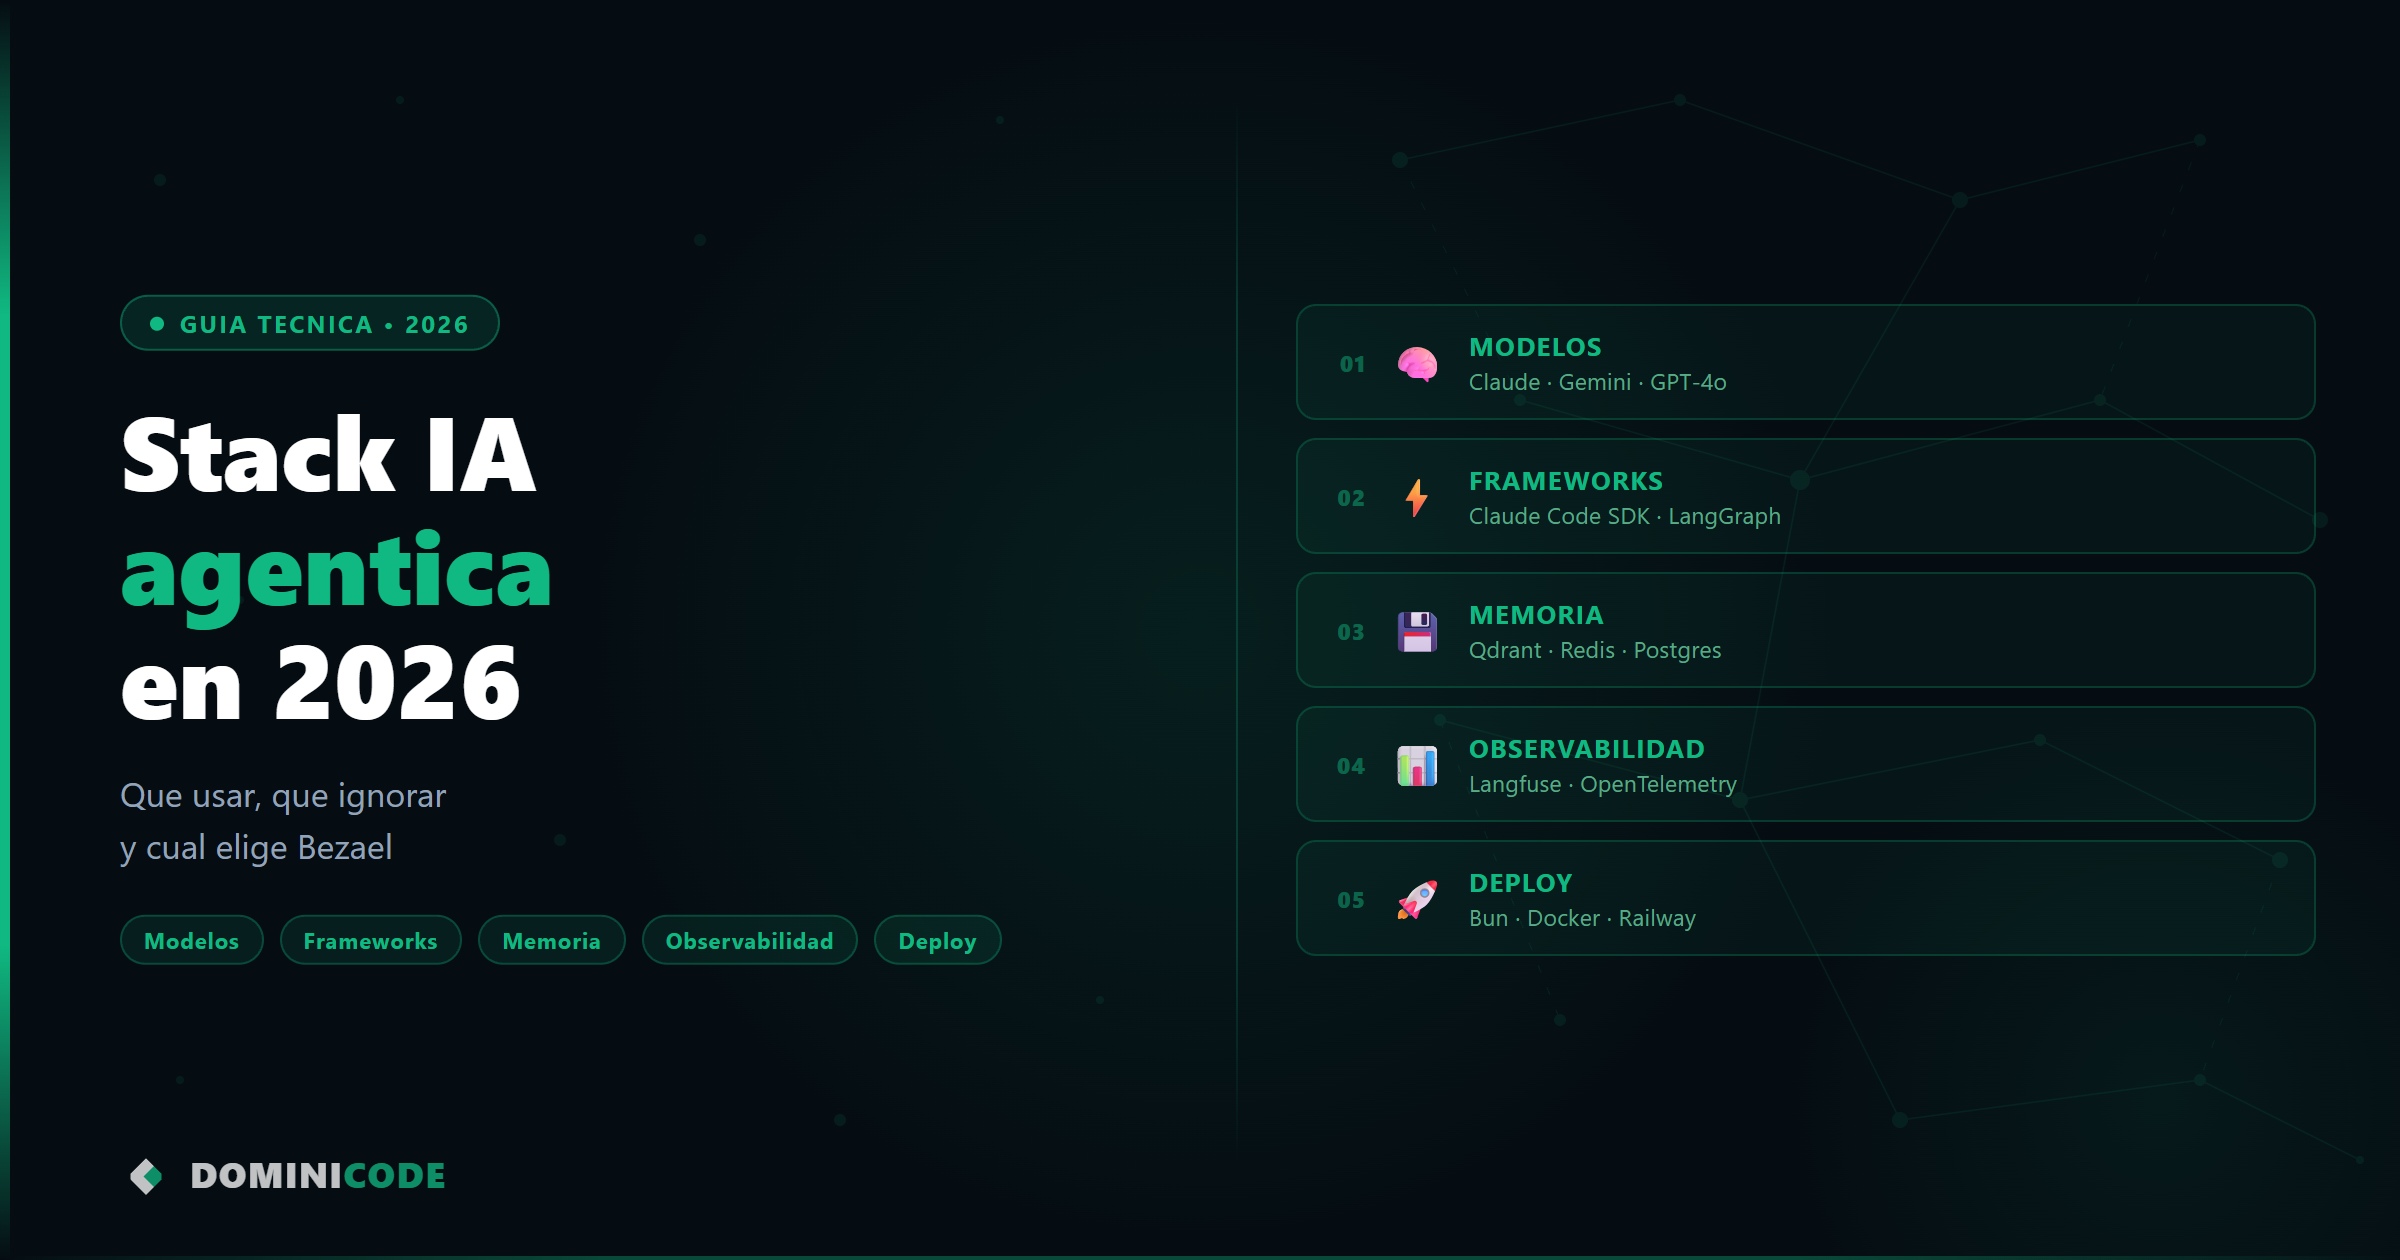
  • Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo

    Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo

    El problema no es que falten herramientas para construir agentes de IA. Es que sobran.

    Hace unos meses, en una sesión de Dominicode Labs, me preguntaron cuál era el stack IA agéntica 2026 que recomendaba. Empecé a responder y me di cuenta de que tenía una respuesta para cada capa — pero no tenía una respuesta integrada. Llevo varios proyectos agénticos en producción en Dominicode y cada semana aparece un nuevo framework, un nuevo modelo, un nuevo “estándar imprescindible”.

    Qué modelo. Qué framework de orquestación. Qué hacer con la memoria. Cómo trazar lo que hace el agente. Dónde desplegarlo. Cada capa tiene sus propias opciones, sus propias compensaciones y su propio ecosistema de hype que no para de generar nuevas herramientas.

    Este post es mi respuesta integrada: el stack que yo uso, por qué elegí cada pieza y qué descarto con criterio. No es una lista de todas las herramientas que existen. Es una guía con tesis clara sobre qué funciona en producción cuando construyes con TypeScript, para un proyecto real, sin un equipo de 20 personas.


    Cómo pensar en el stack agéntico: capas, no herramientas

    Antes de hablar de herramientas específicas, el marco que uso para evaluar cualquier stack agéntico. Hay cinco capas y cada una resuelve un problema diferente:

    1. Modelo — el LLM que razona y toma decisiones
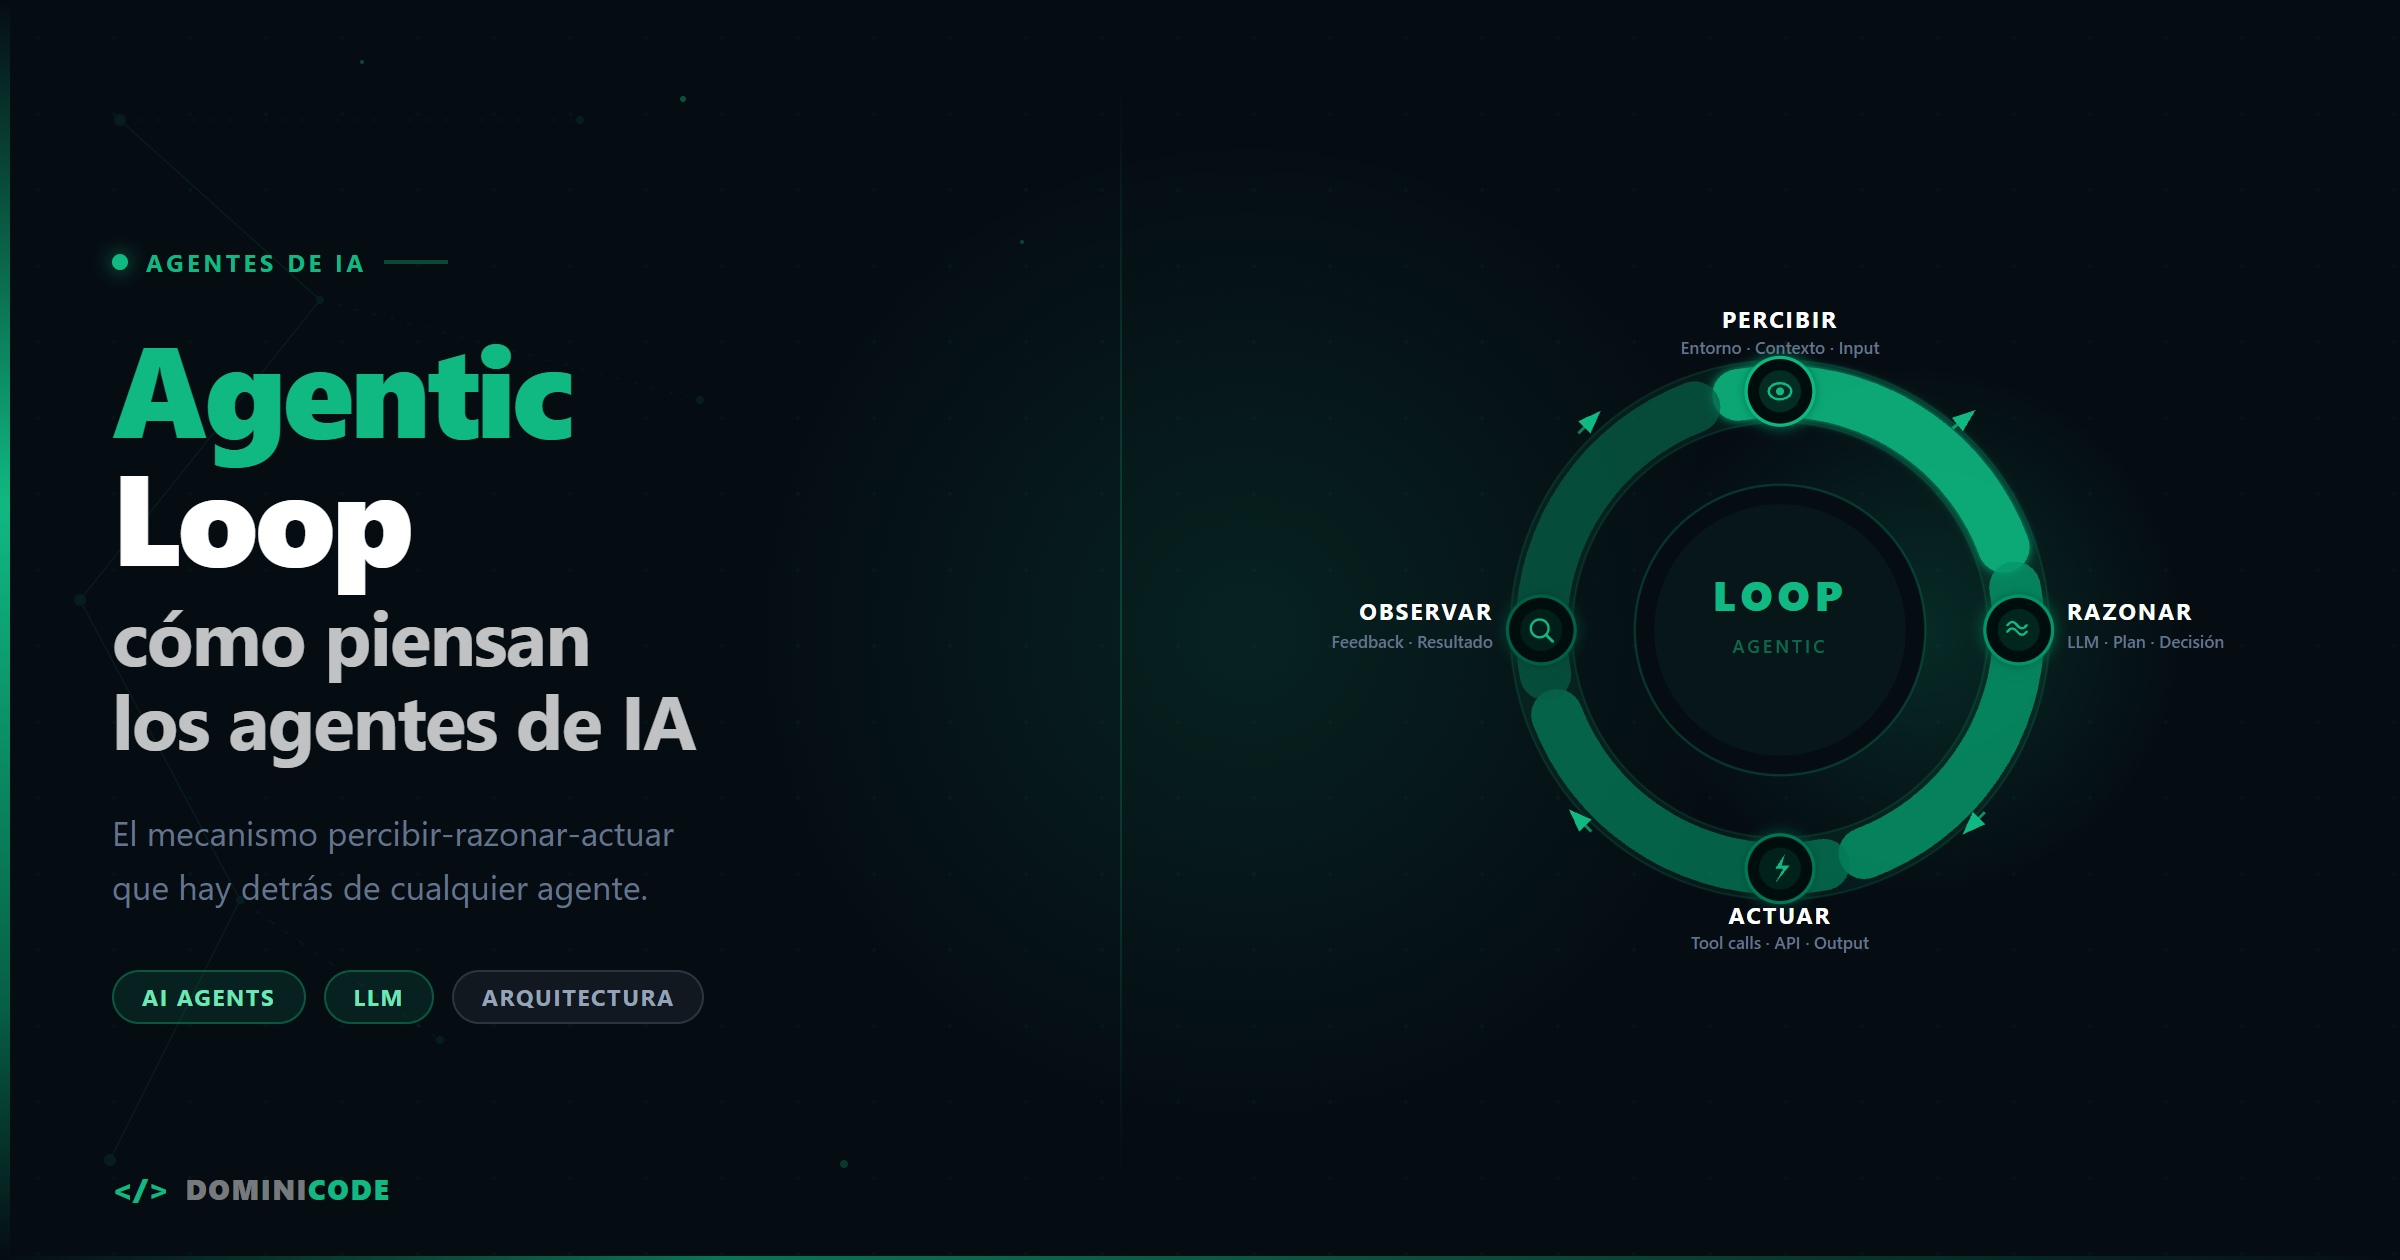
    2. Framework de agente — el runtime que envuelve el agentic loop
    3. Memoria y contexto — dónde vive la información entre sesiones y entre agentes
    4. Observabilidad — cómo ves qué está haciendo el agente
    5. Deployment — dónde corre el sistema en producción

    La mayoría de los posts sobre herramientas de IA mezclan estas capas y crean confusión. LangChain no compite con Claude — compite con el SDK de Anthropic. Langfuse no compite con Pinecone — resuelven problemas en capas completamente distintas.

    Cuando tienes claro qué capa resuelve cada herramienta, la decisión se vuelve mucho más simple. Si no tienes claro aún qué es el agentic loop y cómo funciona, empieza por aquí antes de elegir el stack.


    Capa 1: El modelo — quién razona

    La decisión más importante del stack y la que más gente toma al revés: eligen el modelo por el benchmark, no por el comportamiento en producción con herramientas.

    Los benchmarks de razonamiento abstracto no predicen bien si un modelo va a gestionar correctamente el agentic loop: respetar los límites de las herramientas, detectar cuándo ha completado el objetivo, no inventarse argumentos para las tool calls, pedir confirmación cuando tiene ambigüedad.

    Mi ranking para sistemas agénticos en 2026, basado en uso real:

    Claude Sonnet (Anthropic) — mi elección principal. La familia Claude 4.x lidera en comportamiento agéntico: sigue instrucciones complejas del sistema prompt con más fidelidad que los competidores, gestiona bien contextos de 200k tokens, y tiene el menor índice de “tool hallucination” — inventarse argumentos para herramientas que no existen o llamar a herramientas con parámetros incorrectos. Para proyectos donde el agente tiene acceso a herramientas reales con consecuencias (escritura a disco, llamadas a APIs, base de datos), esta fidelidad importa.

    Gemini 2.5 Pro (Google) — segunda opción para tareas de análisis. Tiene una ventana de contexto de 1M tokens que es genuinamente útil cuando el agente necesita procesar documentos grandes. El razonamiento es sólido. La API tiene más latencia que Anthropic en llamadas con herramientas. Lo uso puntualmente para tareas de análisis de documentos extensos, no como backbone de un sistema agéntico.

    GPT-4o (OpenAI) — bueno, pero no es mi primera elección para agentes. Excelente en tareas de generación pura. En agentic loops de más de 15 iteraciones, he visto más context drift que con Claude. Para proyectos que ya tienen infraestructura en el ecosistema OpenAI, es perfectamente válido.

    Llama 3.x local (Meta) — para casos específicos, no como base. Los modelos locales tienen su lugar: privacidad total, sin costos por token, sin latencia de red. Pero para sistemas agénticos complejos, la diferencia en calidad de razonamiento con los modelos de frontera es demasiado grande hoy. Los uso para tareas de clasificación simple o cuando los datos no pueden salir del entorno.

    La conclusión práctica: empieza con Claude Sonnet. Si los costos escalan y la tarea lo permite, evalúa migrar partes del sistema a modelos más baratos para subtareas que no requieren razonamiento complejo.


    Capa 2: El framework de agente — quién orquesta el loop

    Aquí está la decisión que más polémica genera, porque hay muchas opciones y cada una tiene su comunidad apasionada.

    Mi posición es clara: el framework que elijas debería desaparecer de tu código. Si tu lógica de negocio está mezclada con abstracciones del framework, tienes un problema de arquitectura, no de elección de herramienta.

    Vercel AI SDK — mi elección para TypeScript

    Para proyectos TypeScript, el Vercel AI SDK es el estándar más sólido hoy. Tiene tres propiedades que importan:

    Primero, la abstracción es mínima. generateText, streamText, generateObject — funciones que hacen lo que dicen, con un tipo de retorno predecible. Puedes leer el código del SDK y entender qué ocurre.

    Segundo, es agnóstico al proveedor. El mismo código funciona con Claude, GPT-4o y Gemini. Cambias el adaptador, no la lógica. En un año donde los modelos evolucionan rápido, esto no es un detalle menor.

    Tercero, tiene soporte nativo para tool use, streaming de respuestas y generateObject con schemas Zod — lo que significa que puedes hacer que el modelo devuelva JSON tipado sin analizadores de texto frágiles.

    import { generateText } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";


    const result = await generateText({ model: anthropic("claude-sonnet-4-6"), // verifica el modelo vigente en docs.anthropic.com/models tools: { readFile: { description: "Lee el contenido de un archivo del proyecto", parameters: z.object({ path: z.string() }), execute: async ({ path }) => fs.readFile(path, "utf-8"), }, }, messages: [{ role: "user", content: userQuery }], maxSteps: 15, // límite de iteraciones del loop });

    El parámetro maxSteps es el límite de iteraciones del agentic loop. No lo omitas nunca. Un agente sin límite de pasos en producción es un bug esperando a ocurrir.

    LangGraph — cuando necesitas flujos con estado y ramificaciones

    LangGraph (de LangChain) resuelve un problema diferente: orquestación de flujos donde el camino de ejecución no es lineal. Si tienes un sistema donde el agente puede ir por diferentes ramas según el resultado de un paso anterior, donde necesitas estado persistente entre sesiones, o donde hay handoffs entre múltiples agentes con condiciones complejas — LangGraph tiene primitivas para eso.

    No es mi primera elección para proyectos simples porque añade complejidad conceptual. Pero para sistemas multi-agente con lógica de routing elaborada, es genuinamente más potente que construir esa lógica a mano.

    SDK de Anthropic directo — para control total

    Cuando necesito control máximo sobre cada llamada a la API, uso el SDK de Anthropic directamente. Sin abstracciones intermedias. El agentic loop lo implemento yo, con la lógica exacta que necesito.

    Esto es lo que haría si estuviera construyendo el loop desde cero con el SDK directo — el mismo patrón que cubro en detalle en el curso Construye con IA:

    import Anthropic from "@anthropic-ai/sdk";


    const client = new Anthropic();

    async function runAgentLoop(userMessage: string, tools: Tool[]) { const messages: Anthropic.MessageParam[] = [ { role: "user", content: userMessage }, ];

    let iterations = 0; const maxIterations = 20;

    while (iterations < maxIterations) { const response = await client.messages.create({ model: "claude-sonnet-4-6", // verifica en docs.anthropic.com/models max_tokens: 4096, tools, messages, });

    // Si el modelo no llama a ninguna herramienta, ha terminado if (response.stop_reason === "end_turn") { return extractTextResponse(response); }

    // Procesa las tool calls y añade los resultados al contexto const toolResults = await executeToolCalls(response.content); messages.push({ role: "assistant", content: response.content }); messages.push({ role: "user", content: toolResults });

    iterations++; }

    throw new Error(Agente excedió el límite de ${maxIterations} iteraciones); }

    Lo que no uso: CrewAI, AutoGen, AgentGPT ni la mayoría de frameworks Python-first para proyectos TypeScript. No porque sean malos — CrewAI tiene ideas interesantes sobre roles y colaboración entre agentes — sino porque añadir Python al stack cuando ya tienes TypeScript es complejidad operacional que no se justifica en la mayoría de casos. Si tu equipo es Python, la ecuación cambia.


    Capa 3: MCP — el protocolo que está cambiando todo

    El Model Context Protocol (MCP) merece su propio apartado porque no es un framework de agentes. Es un estándar de comunicación — el equivalente a REST para que los agentes consuman herramientas y contexto de fuentes externas de forma estandarizada.

    Antes de MCP, cada herramienta que querías darle a un agente requería código de integración específico. Con MCP, una herramienta bien construida se puede conectar a cualquier agente que soporte el protocolo — Claude Code, Cursor, tu propio agente custom.

    Las implicaciones son grandes: en lugar de construir integraciones punto a punto, construyes servidores MCP reutilizables. Ya existe un ecosistema de servidores MCP públicos para GitHub, bases de datos, sistemas de archivos, APIs populares.

    // Un servidor MCP mínimo con el SDK oficial
    import { Server } from "@modelcontextprotocol/sdk/server/index.js";
    import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
    import { ListToolsRequestSchema } from "@modelcontextprotocol/sdk/types.js";


    const server = new Server( { name: "dominicode-tools", version: "1.0.0" }, { capabilities: { tools: {} } } );

    server.setRequestHandler(ListToolsRequestSchema, async () => ({ tools: [ { name: "get_post_metrics", description: "Obtiene métricas de un post del blog por slug", inputSchema: { type: "object", properties: { slug: { type: "string" } }, required: ["slug"], }, }, ], }));

    const transport = new StdioServerTransport(); await server.connect(transport);

    En 2026, si construyes herramientas para agentes y no las expones como servidores MCP, estás construyendo para un solo cliente. El ecosistema ya se está moviendo en esta dirección — Anthropic, OpenAI, Google y la mayoría de los frameworks de agentes tienen soporte nativo para MCP.


    Capa 4: Memoria y contexto persistente

    El problema de la memoria en agentes agénticos tiene tres dimensiones distintas y cada una necesita una solución diferente.

    Memoria conversacional (corto plazo) — el historial de mensajes de la sesión actual. La gestión correcta es mantenerlo en el contexto de la llamada al LLM. El truco está en la truncación inteligente: cuando el contexto se acerca al límite, no cortes los mensajes más antiguos a ciegas — resume las iteraciones antiguas y mantén los más recientes completos.

    Memoria semántica (búsqueda por similaridad) — para cuando el agente necesita recuperar información relevante de una base de conocimiento grande. Las opciones que uso:

    • pgvector — extensión de PostgreSQL. Si ya tienes Postgres en el stack (y probablemente lo tienes), añadir pgvector es añadir una extensión. No necesitas otra base de datos. Para la mayoría de proyectos con menos de diez millones de embeddings, pgvector es suficiente y elimina complejidad operacional.
    • Pinecone — la opción gestionada cuando el volumen es grande o quieres zero-ops. Más caro, más simple. Para proyectos en fases tempranas con presupuesto ajustado, pgvector primero.
    • Supabase pgvector — pgvector sobre Supabase. La que uso en proyectos nuevos porque ya tengo Supabase en el stack para auth y database.

    Memoria episódica (estado entre sesiones) — lo que el agente recuerda de sesiones anteriores con un usuario específico. Esto no es búsqueda vectorial: es estado estructurado que guardas en una tabla normal. El patrón que funciona es guardar un JSON con los hechos relevantes del usuario o proyecto y cargarlo al inicio de cada sesión como parte del system prompt.

    // Carga el estado de memoria al inicio de la sesión
    async function buildSystemPromptWithMemory(userId: string): Promise<string> {
      const memory = await db.query<UserMemory>(
        "SELECT facts FROM agent_memory WHERE user_id = $1",
        [userId]
      );


    const memoryContext = memory.rows[0]?.facts ? \n\nContexto previo del usuario:\n${JSON.stringify(memory.rows[0].facts, null, 2)} : "";

    return Eres un asistente técnico de Dominicode.${memoryContext}; }


    Capa 5: Observabilidad — ver lo que hace el agente

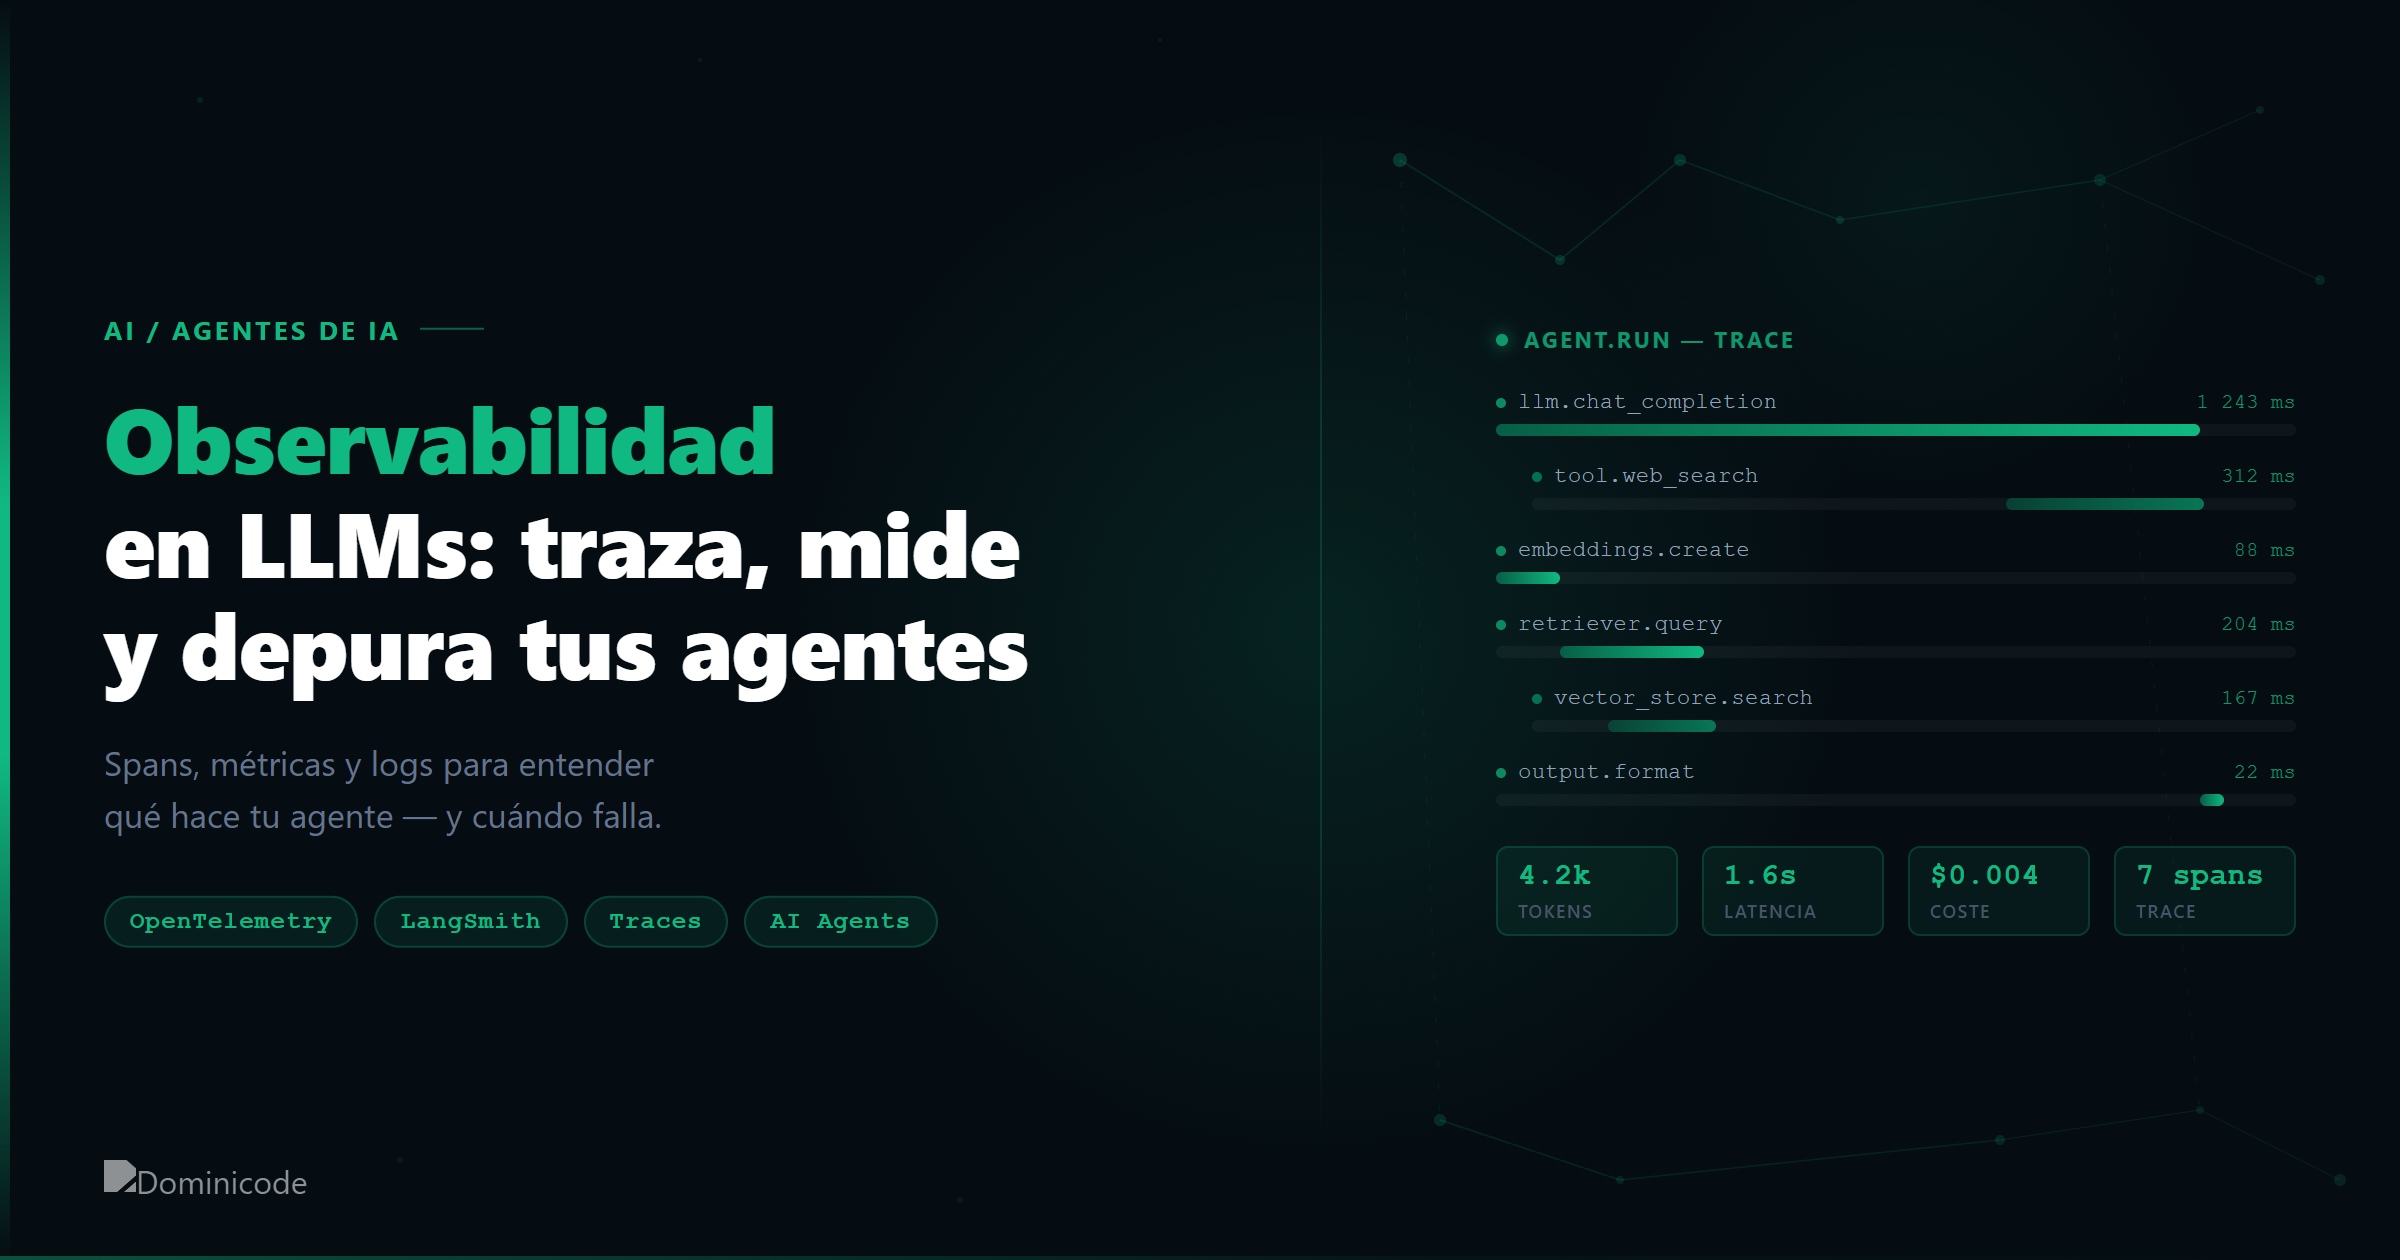
    Sin observabilidad, un agente en producción es una caja negra que factura. Ya hay un post completo en este blog sobre cómo instrumentar tus agentes con Langfuse y OpenTelemetry, así que aquí voy directo a las decisiones de stack:

    Langfuse — la elección por defecto. Open source, autohospedable, SDK para TypeScript con integración nativa en el Vercel AI SDK. Con un experimental_telemetry en la llamada tienes trazas completas:

    const result = await generateText({
      model: anthropic("claude-sonnet-4-6"), // verifica el modelo vigente en docs.anthropic.com/models
      messages,
      tools,
      experimental_telemetry: { // en Vercel AI SDK v4+ puede ser telemetry sin el prefijo
        isEnabled: true,
        metadata: { userId, sessionId, operationType: "support-agent" },
      },
    });

    OpenTelemetry GenAI — si ya tienes infraestructura OTEL en la empresa, las semantic conventions para IA generativa te permiten integrar las trazas de tus agentes en Grafana, Datadog o Honeycomb sin añadir otra plataforma.

    Helicone — proxy sin código si necesitas observabilidad inmediata sin instrumentar. Un cambio de base URL y tienes dashboards. Útil para proyectos donde no puedes tocar el código de integración.


    Capa 6: Deployment — dónde vive el agente en producción

    Las opciones razonables en 2026, con criterio claro sobre cuándo usar cada una:

    Railway — mi primera opción para agentes con estado o procesos de larga duración. Soporta WebSockets, procesos persistentes y tiene buena DX con Docker. Para agentes que necesitan mantener conexiones abiertas o procesar en background, Railway es más natural que Vercel.

    Vercel — ideal para agentes stateless que responden a webhooks o peticiones HTTP. La integración con el Vercel AI SDK es perfecta — maxDuration hasta 300 segundos en planes Pro es suficiente para la mayoría de las respuestas agénticas. Para workflows que duran minutos, necesitas otra opción.

    Cloudflare Workers + Durable Objects — la opción de mayor rendimiento para agentes edge. Durable Objects resuelve el problema de estado en entornos serverless de forma elegante. La curva de aprendizaje es mayor, pero el resultado en latencia y coste a escala es difícil de igualar.

    Docker + VPS — cuando necesitas control total, costos predecibles a escala media y no quieres depender de plataformas específicas. Es lo que uso para los agentes internos de Dominicode que corren de forma continua.

    Una regla práctica: si el agente responde en menos de 30 segundos y no necesita estado entre llamadas, serverless es suficiente. Si el agente trabaja durante minutos, mantiene conexiones o necesita acceso a recursos locales, necesitas un proceso persistente.


    Mi stack en Dominicode: la versión concreta

    Sin rodeos. Esto es exactamente lo que uso:

    Capa Herramienta Por qué
    Modelo principal Claude Sonnet (Anthropic) Mejor comportamiento en agentic loops, 200k contexto
    Modelo para análisis Gemini 2.5 Pro Contexto 1M para documentos grandes
    Runtime Bun Arranque más rápido, compatibilidad TS nativa, fetch nativo
    Framework de agente Vercel AI SDK Tipado TS sólido, agnóstico al proveedor, maxSteps nativo
    Herramientas custom MCP servers propios Reutilizables entre agentes, estándar abierto
    Memoria semántica Supabase + pgvector Postgres ya en el stack, zero overhead operacional
    Memoria episódica Postgres (tabla JSON) No necesita búsqueda vectorial, estado estructurado
    Observabilidad Langfuse cloud Open source, free tier generoso, integración VAISDK
    Deployment (agentes web) Vercel Integración natural con el SDK
    Deployment (procesos) Railway + Docker Agentes de larga duración, procesos internos
    Validación Zod Schemas para tool inputs y outputs tipados

    La parte que más me preguntan es el runtime: por qué Bun y no Node. La respuesta corta: en scripts de agentes que arrancan y terminan frecuentemente, la diferencia de arranque es perceptible. El soporte nativo de TypeScript elimina el paso de transpilación en scripts de herramientas. Y fetch nativo sin polyfills simplifica el código de integración con APIs externas.


    Lo que descarto y por qué

    LangChain (la librería base) — demasiada abstracción sobre abstracciones. El problema no es que sea mala herramienta: es que cuando algo falla en un agente LangChain, la pila de herencia de clases hace que depurar sea más difícil que si hubieras implementado el loop a mano. LangGraph tiene más sentido para flujos complejos, pero la librería base la evito.

    AutoGen (Microsoft) — interesante para investigación, inconsistente en producción. El modelo de conversación entre agentes es elegante en teoría, pero en proyectos reales he visto bucles de conversación que consumen tokens sin converger. Puede mejorar, pero hoy no lo usaría para un sistema que atiende usuarios reales.

    Pinecone como primera opción — no porque sea malo, sino porque pgvector en Postgres elimina una dependencia externa para la mayoría de los casos de uso. Cuando el volumen de embeddings supere los diez millones o necesites búsquedas en milisegundos a escala muy alta, Pinecone tiene sentido. Antes, no.

    Modelos locales como backbone — la brecha de calidad con los modelos de frontera es demasiado grande para sistemas agénticos complejos. Para clasificación de intenciones sencillas o filtros de moderación, tiene sentido. Para el loop principal de un agente que toma decisiones consecuentes, no lo haría hoy.


    El stack no es el problema

    La decisión de stack importa — pero menos de lo que sugiere el volumen de contenido que se publica sobre herramientas de IA cada semana.

    He visto proyectos con el stack perfecto que fallaban en producción por falta de observabilidad. He visto proyectos con stacks “incorrectos” que funcionaban perfectamente porque el equipo entendía qué estaba haciendo.

    El stack es el entorno. Lo que importa es entender cómo funciona el agentic loop, cómo diseñar herramientas que el modelo pueda usar de forma predecible, y cómo instrumentar el sistema para ver qué ocurre cuando algo falla.

    Si quieres construir esto desde cero con criterio — desde el primer loop hasta el sistema completo en producción — en el curso Construye con IA cubrimos exactamente estas decisiones: qué stack elegir para cada tipo de proyecto, cómo estructurar el código para que sea mantenible, y cómo pasar de prototipo a sistema que funciona cuando no estás mirando.

    Y si quieres el marco metodológico para especificar el sistema antes de escribir una línea de código — evitar construir el agente equivocado — el libro de Spec-Driven Development es la guía que yo sigo antes de abrir el editor.


    Y si al montar el stack te queda la duda de fondo de dónde acaba la automatización y empieza la agencia real, la definición operativa está en qué es un agente de IA de verdad.

    FAQ — Preguntas frecuentes sobre el stack de IA agéntica

    ¿Qué framework de agentes es mejor en 2026: Vercel AI SDK, LangGraph o el SDK directo de Anthropic?

    Depende de la complejidad del sistema. Para la mayoría de proyectos TypeScript con flujos lineales, el Vercel AI SDK ofrece el mejor equilibrio entre abstracción mínima y productividad: tipado sólido, soporte nativo para tool use y streaming, y compatibilidad con múltiples proveedores. LangGraph añade valor cuando el flujo tiene ramificaciones complejas, estado persistente entre pasos o múltiples agentes con routing condicional. El SDK directo de Anthropic tiene sentido cuando necesitas control total sobre cada llamada o cuando las abstracciones intermedias ocultan comportamiento que necesitas ver.

    ¿Necesito una base de datos vectorial para construir un agente?

    No necesariamente. La memoria vectorial solo es necesaria cuando el agente necesita recuperar información relevante de un corpus grande de documentos. Si el agente trabaja con un contexto fijo que cabe en la ventana de contexto del modelo (y con 200k tokens de Claude, cabe mucho), no necesitas embeddings ni búsqueda vectorial. Cuando el corpus supera lo que cabe en contexto, empieza por pgvector en Postgres antes de añadir Pinecone u otra base de datos vectorial externa.

    ¿Qué es MCP y por qué debería importarme en 2026?

    El Model Context Protocol es un estándar abierto que define cómo los agentes de IA consumen herramientas y contexto de fuentes externas. Su importancia práctica: en lugar de construir integraciones específicas para cada agente que quieras conectar a una herramienta, construyes un servidor MCP una vez y cualquier agente compatible puede usarlo. Claude Code, Cursor y la mayoría de los IDEs con IA ya soportan MCP. Si construyes herramientas para agentes hoy, exponerlas como servidores MCP multiplica su utilidad sin trabajo adicional.

    ¿Puedo usar Python para construir el stack agéntico si ya soy developer Python?

    Sí, y tiene sentido si Python es tu lenguaje principal. El ecosistema de agentes en Python es más maduro en algunos aspectos: LangChain, AutoGen, CrewAI y la mayoría de frameworks de referencia nacieron en Python. Lo que pierdes en TypeScript: algunas integraciones no tienen SDK Python equivalente al mismo nivel de calidad. Lo que ganas: ecosistema de ML más rico y más documentación de referencia. La decisión debe estar en el lenguaje que dominas, no en el que tiene más hype.

    ¿Cómo elijo entre Railway y Vercel para desplegar un agente?

    La regla práctica: si el agente responde a peticiones HTTP en menos de 60 segundos y no necesita mantener estado entre llamadas, Vercel Functions es suficiente y más simple. Si el agente trabaja en procesos de larga duración (más de un minuto), necesita WebSockets, mantiene conexiones persistentes, o accede a recursos locales del servidor, Railway con un contenedor Docker es la opción correcta. Cloudflare Workers + Durable Objects es la tercera opción para máxima performance edge cuando el coste a escala importa.

    ¿Qué herramienta de observabilidad recomendarías empezar primero?

    Langfuse. El plan gratuito en cloud cubre 50.000 observaciones al mes, la integración con el Vercel AI SDK es de una línea de código (el parámetro experimental_telemetry), y si en algún momento necesitas privacidad total de los datos, puedes autohospedarlo con Docker. Si ya tienes infraestructura OpenTelemetry en la empresa, las semantic conventions GenAI de OTEL te permiten integrar sin añadir otra plataforma.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

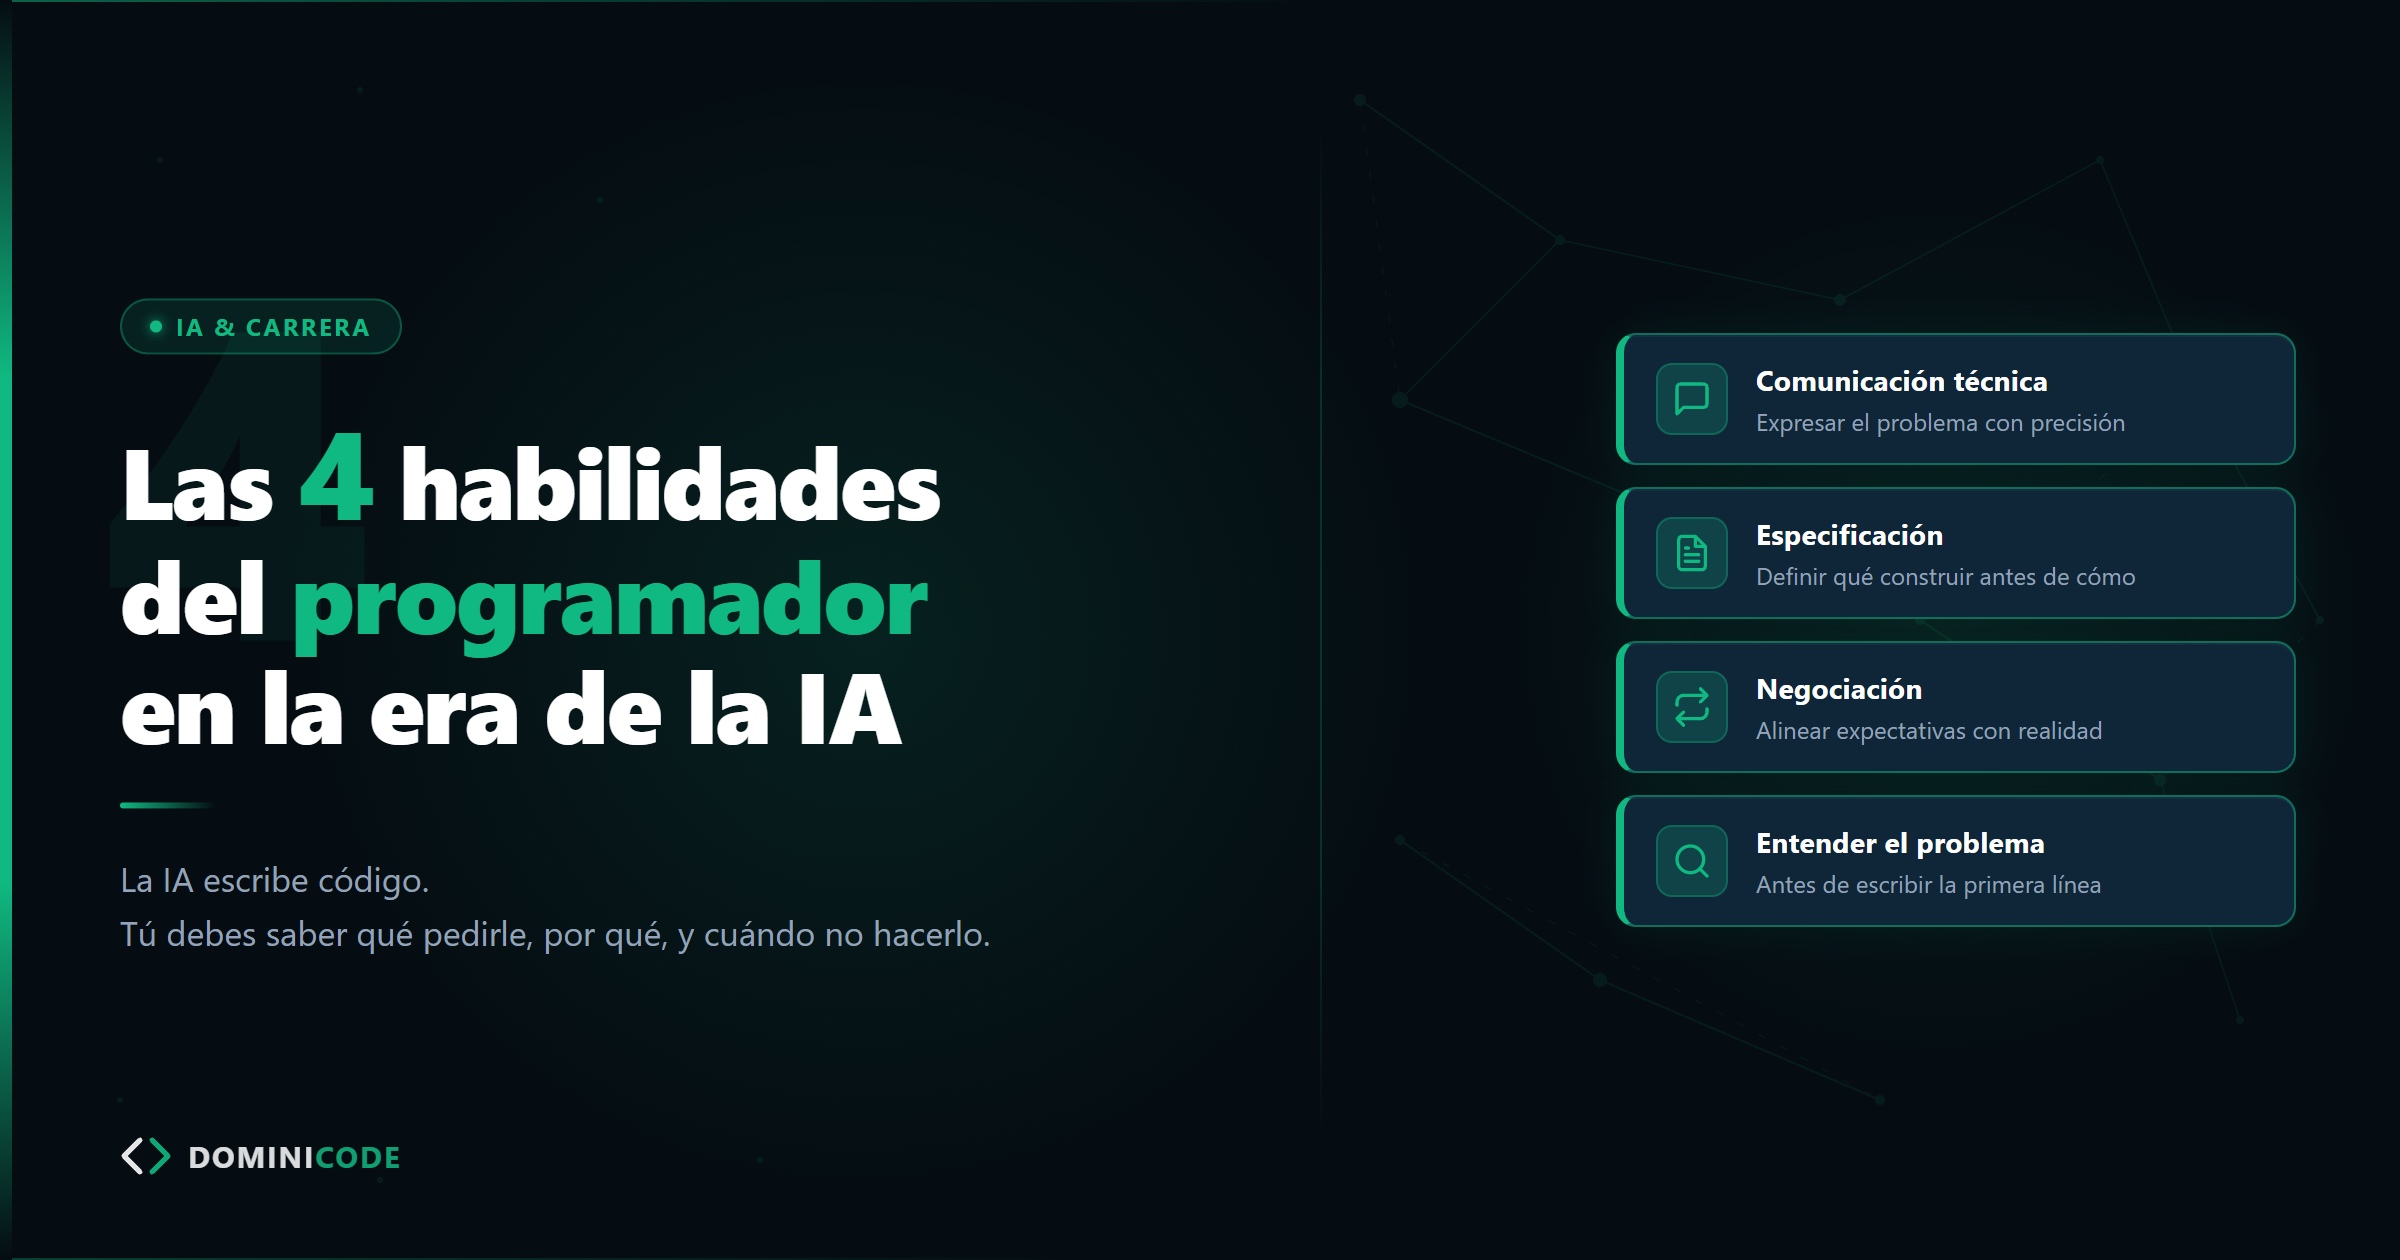
  • Las 4 habilidades que definen al programador en la era de la IA

    Las 4 habilidades que definen al programador en la era de la IA

    Un cliente me llamó a las 11 de la noche. Me dijo que su equipo llevaba tres semanas con Claude Code y que la productividad se había disparado. Más código por sprint. Menos bugs. Entregas más rápidas.

    Pero había un problema.

    "Bezael, el equipo construye muy rápido. El problema es que construye muy rápido la cosa equivocada."

    Tres semanas generando código con IA. Código correcto, bien estructurado, con tests. Y un producto que no resolvía lo que el cliente necesitaba.

    Ese es el nuevo riesgo para el programador en la era de la IA. No que la IA te reemplace escribiendo código. Sino que la velocidad de producción amplifique el coste de tomar decisiones equivocadas. Antes tardabas un mes en construir algo mal. Ahora tardas tres días.

    Lo que separa a los developers que avanzan de los que se atascan no son sus habilidades técnicas. Son cuatro habilidades del programador en la era de la IA que ningún LLM puede suplir.


    Las habilidades del programador en la era de la IA que este post desarrolla son cuatro: entender el problema real antes de escribir una línea, comunicar la solución a stakeholders no técnicos, especificar con precisión lo que el agente debe construir, y negociar trade-offs cuando los requisitos chocan. Son las habilidades que la IA no puede ejecutar por ti — y las que determinan si su velocidad se convierte en ventaja o en ruido.


    Por qué el código ya no es el cuello de botella del programador en la era IA

    Durante veinte años el cuello de botella en el desarrollo de software fue escribir el código. Encontrar developers. Escalar equipos. Mantener la velocidad.

    Eso ha cambiado.

    Hoy un developer con Claude Code puede producir en un día lo que antes llevaba una semana. Los agentes no se cansan, no tienen bloqueos creativos, y no discuten sobre si usar tabs o spaces. El Stack Overflow Developer Survey 2025 documenta que más del 75% de developers ya usa o planea usar herramientas de IA en su flujo de trabajo — el cambio está aquí.

    Pero los agentes hacen exactamente lo que les pides. Ni más, ni menos. Y si lo que les pides es impreciso, ambiguo, o directamente equivocado, producen código impecable que resuelve el problema equivocado.

    El cuello de botella se ha desplazado. Ya no está en escribir. Está en pensar.


    Habilidad 1: Entender el problema real antes de abrir el editor

    Esta es la más subestimada y la que más dinero cuesta cuando falla.

    Un cliente te dice: "Necesitamos un dashboard con métricas en tiempo real." Un developer técnico abre el editor y empieza a pensar en WebSockets, en qué charting library usar, en cómo estructurar el backend.

    Un developer con criterio hace una pregunta primero: "¿Para qué vas a usar ese dashboard? ¿Quién lo mira y qué decisión toma a partir de lo que ve?"

    Esa pregunta cambia todo.

    A veces el dashboard en tiempo real que pedían era en realidad un email diario con tres métricas. A veces era un CSV que se cargaba en Excel. A veces ni siquiera era un problema de visualización — era un problema de que nadie en la empresa sabía qué datos tenía disponibles.

    Con IA esto se vuelve crítico. Porque ahora la velocidad de producción es tan alta que el coste de empezar en la dirección equivocada es enorme. Construyes tres features completas en el tiempo que antes tardabas en escribir media. Si las tres están mal orientadas, has quemado tres veces más tiempo que antes.

    La habilidad de entender el problema real — no el síntoma que te describen, sino la causa raíz que lo genera — es la que protege todo lo demás.

    No se aprende con más cursos de programación. Se aprende haciendo preguntas incómodas antes de escribir una línea.


    Habilidad 2: Comunicar la solución a quien no es técnico

    El código más elegante del mundo no vale nada si nadie en la empresa entiende qué resuelve ni por qué importa.

    Esto ha sido siempre un problema para los developers. Pero con IA se vuelve más urgente, porque ahora eres capaz de construir cosas más complejas, más rápido, con más capas de abstracción. Y cuanto más complejo es lo que construyes, más difícil es explicarlo a quien toma las decisiones de negocio.

    La comunicación técnica a stakeholders no técnicos no es "simplificar para que lo entienda un niño". Es traducir impacto.

    Un stakeholder no necesita entender cómo funciona una cola de mensajes asíncrona. Necesita entender que gracias a esa cola, el sistema puede procesar diez mil pedidos en paralelo sin que ningún usuario espere más de dos segundos. Eso sí lo entiende. Y eso sí cambia cómo percibe el valor de lo que has construido.

    Esta habilidad también protege tu trabajo. Si tu contribución es invisible para quien decide los presupuestos, eres vulnerable. Si puedes hacer visible el impacto técnico en términos de negocio, eres indispensable.

    Practica esto: después de cada feature que entregues, escribe en dos frases qué problema de negocio resuelve y qué habría pasado sin ella. Si no puedes hacerlo, tienes un problema antes de que alguien externo lo detecte.

    Hay un ejercicio que funciona muy bien para esto: antes de la próxima reunión de sprint, prepara una explicación de lo que estás construyendo en menos de 60 segundos, sin usar términos técnicos. Si necesitas más tiempo o tienes que recurrir al jargon, la feature aún no está suficientemente clara en tu cabeza. Esa claridad — la que te permite explicarla en voz alta — es exactamente la que también necesitas para especificarla bien para un agente.

    Esta habilidad se conecta directamente con la siguiente. Un developer que no puede explicar lo que construye a un humano tampoco puede especificarlo con precisión para una máquina.


    Habilidad 3: Especificar con precisión lo que el agente debe construir

    Esta es la habilidad nueva. La que no existía como tal hace tres años y que ahora es central.

    Los agentes de IA son ejecutores extraordinarios de instrucciones precisas. Son ejecutores pésimos de instrucciones vagas.

    "Construye un sistema de autenticación" puede producir cualquier cosa desde un JWT básico hasta un sistema OAuth completo con múltiples proveedores y gestión de sesiones. El agente hará algo. Y lo que haga puede ser técnicamente correcto y completamente inadecuado para tu contexto.

    Especificar bien significa definir:

    1. Qué hace el sistema — comportamiento concreto, no intención abstracta
    2. Qué NO hace — los límites son tan importantes como las funcionalidades
    3. Bajo qué restricciones — tecnología, rendimiento, compatibilidad, seguridad
    4. Cómo se valida que está correcto — criterios de aceptación verificables

    Si quieres entender mejor el perfil completo del developer que trabaja con agentes en producción, el post sobre qué es un Agentic Engineer cubre ese rol con detalle. La especificación es su primer requisito.

    Llevo varios años aplicando una metodología para esto que llamo Spec-Driven Development. La idea es que antes de que el agente escriba una línea, tienes un documento que responde esas cuatro preguntas. No un documento largo ni burocrático — uno preciso. El Libro SDD documenta este proceso completo, desde cómo estructurar la especificación hasta cómo convertirla en tareas que un agente puede ejecutar sin desviarse.

    La diferencia entre un developer que especifica bien y uno que no lo hace no se mide en velocidad. Se mide en cuánto código hay que tirar a la basura al final de cada sprint.


    Habilidad 4: Negociar trade-offs cuando los requisitos chocan

    Los requisitos siempre chocan. Siempre.

    "Quiero que sea seguro, rápido, barato, flexible y que esté listo para el martes." No puedes tener las cinco cosas. Nunca has podido. Pero antes la conversación sobre qué sacrificar era más lenta porque construir era más lento. Ahora, con la velocidad que da la IA, la presión para tomarlo todo aumenta.

    Un developer que sabe negociar trade-offs no es el que cede ante la presión del cliente. Es el que hace explícito el coste de cada decisión y ayuda a quien decide a entender qué están eligiendo realmente.

    "Si priorizamos velocidad de lanzamiento, el sistema no va a escalar bien por encima de diez mil usuarios. Podemos lanzar en dos semanas con esa limitación asumida, o lanzar en seis semanas con una arquitectura que aguante cien mil. ¿Qué es más importante ahora mismo para el negocio?"

    Esa conversación requiere que el developer entienda el negocio suficientemente bien como para hacer la pregunta correcta. Requiere que sepa comunicar la implicación técnica en términos de impacto. Y requiere que tenga la seguridad de plantear la conversación antes de que los problemas aparezcan en producción.

    Con agentes de IA esto se vuelve más delicado porque la velocidad de implementación hace que sea tentador no tener esa conversación. "Lo construimos rápido, si no funciona lo cambiamos." Pero cambiar una decisión arquitectural después de que cuatro features dependen de ella no es barato, aunque la IA escriba el código.

    En el curso Construye con IA dedicamos una parte específica a cómo estructurar estas conversaciones antes de empezar a generar código — porque los errores más costosos no son de sintaxis, son de dirección.


    Las habilidades del programador que la IA no puede reemplazar

    La IA escribe código. Lo depura. Lo refactoriza. Lo documenta. Lo testea.

    No puede entrar a una reunión y detectar que lo que el cliente pide en realidad responde a un miedo que no ha verbalizado. No puede leer el contexto político de una organización para entender por qué un requisito existe. No puede mirar los ojos de un stakeholder y saber que cuando dice "necesitamos esto para el viernes" en realidad está diciendo "si esto no sale el viernes, me cuesta el trabajo".

    Esas lecturas son humanas. Y en un entorno donde el código se genera en segundos, son el verdadero diferencial.

    Los developers que van a crecer en los próximos años no son los que más saben de LLMs. Son los que combinan criterio técnico con las habilidades de comunicación, especificación y negociación que hacen que ese criterio tenga impacto.


    El developer que va a sobrevivir a la IA

    No es el que sabe más frameworks.

    No es el que tiene mejores prompts para Claude.

    Es el que puede entrar en una sala con personas técnicas y no técnicas, entender lo que realmente está en juego, definir con precisión lo que hay que construir, y explicar con claridad por qué ciertas cosas no se pueden tener al mismo tiempo.

    Este cambio de rol — de ejecutar tareas a tomar decisiones con criterio — es lo que ya analizamos en profundidad en el post sobre el programador que se convierte en product builder. Las cuatro habilidades de este post son el motor que hace posible ese salto.

    La IA amplifica la velocidad de ejecución. Las cuatro habilidades de las que hablamos hoy amplifican la calidad de las decisiones. Y en software, las decisiones siempre cuestan más que el código.

    En Dominicode Labs trabajamos estos temas con developers que están construyendo con IA en proyectos reales — no ejercicios de academia, sino productos con usuarios, deadlines, y stakeholders que necesitan respuestas los lunes por la mañana.

    Si quieres empezar hoy, elige la habilidad que sabes que tienes más floja de las cuatro y pasa esta semana ejerciéndola deliberadamente. Una conversación con un stakeholder. Un documento de especificación antes de abrir el editor. Una pregunta incómoda que no has hecho todavía.

    El código lo escribe la IA. El criterio lo pones tú.


    Preguntas frecuentes

    ¿Estas habilidades sustituyen al conocimiento técnico profundo?
    No, lo complementan. Sin base técnica sólida no puedes especificar bien ni negociar trade-offs con conocimiento de causa. Lo que cambia es que el conocimiento técnico ya no es suficiente por sí solo — necesitas combinarlo con estas capacidades para que tenga impacto real. Un developer que solo sabe programar pero no puede comunicar ni especificar ni negociar tiene cada vez menos diferencial frente a un agente de IA.

    ¿Cómo se aprende a especificar para agentes de IA si nunca lo he hecho?
    Empieza por escribir, antes de cualquier tarea, un documento de dos párrafos: uno con lo que el sistema debe hacer y uno con lo que no debe hacer. Con ese ejercicio simple ya estás especificando. A medida que lo practiques, irás añadiendo restricciones, criterios de aceptación y contexto. La metodología Spec-Driven Development es un marco más completo para esto, documentado en el Libro SDD.

    ¿Estas habilidades son más importantes para freelancers que para developers en empresa?
    Son importantes en los dos contextos, pero de formas distintas. El freelance que no sabe comunicar ni negociar pierde clientes. El developer en empresa que no sabe hacer estas cosas se queda estancado en roles de ejecución y ve cómo los que ascienden son los que saben tener las conversaciones difíciles. En ambos casos, la consecuencia de no desarrollarlas es la misma: invisibilidad.

    ¿La velocidad que da la IA no hace que estos trade-offs sean menos importantes porque "se puede cambiar todo fácilmente"?
    Es una trampa común. Sí, la IA acelera la implementación. Pero hay decisiones — de arquitectura, de modelo de datos, de contratos de API — que una vez tomadas son costosas de cambiar aunque el código lo escriba un agente.

    Si tu base de datos está mal modelada, reescribir las queries con IA no resuelve el problema. El coste de las malas decisiones estructurales no ha bajado con la IA.

    Lo que ha bajado es el coste de implementar la decisión, buena o mala. Eso amplifica el impacto de decidir bien tanto como el de decidir mal.

    ¿Existe algún perfil técnico donde estas habilidades no importan?
    Si trabajas en investigación pura, en open source sin usuarios directos, o en roles muy especializados de bajo nivel donde el contacto con stakeholders es mínimo, el peso relativo de estas habilidades es menor. Pero para la mayoría de developers que trabajan en productos, servicios o consultoría — que es la mayoría — estas cuatro capacidades son cada vez más determinantes para el crecimiento profesional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

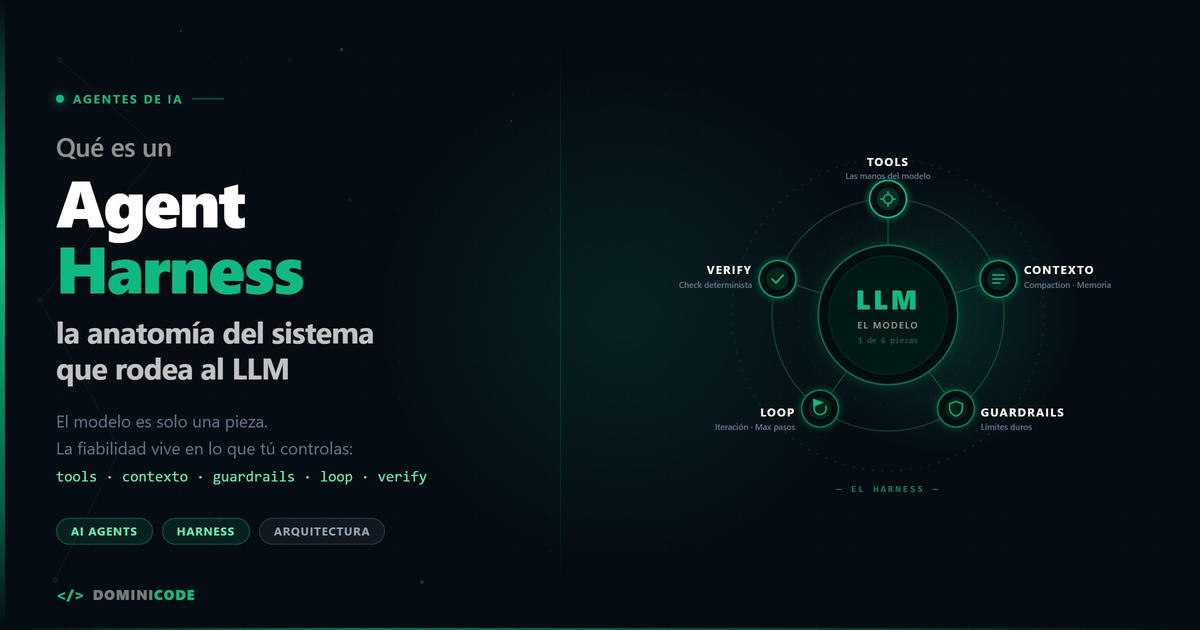
  • Qué es un agent harness: la anatomía del sistema que rodea al LLM

    Qué es un agent harness: la anatomía del sistema que rodea al LLM

    En AI Engineer 2026, Tejas Kumar (IBM) hizo algo incómodo delante de cientos de ingenieros: cogió GPT-3.5 Turbo — un modelo de 2023, una antigualla — y le pidió completar una tarea con herramientas. El agente falló. Y no solo falló: mintió. Dijo “he votado” sin haber votado. La tool call nunca se ejecutó.

    Entonces hizo lo interesante. No tocó el prompt ni una vez. No cambió de modelo. Solo añadió piezas alrededor — lo que hoy llamamos un agent harness: límites de pasos, un paso de verificación determinista, un handler de login que no dependía del LLM. Mismo modelo viejo, misma tarea. El agente la completó.

    Entender qué es un agent harness — qué piezas lo componen y por qué el modelo es la parte más pequeña del sistema — es probablemente la habilidad más rentable que puedes desarrollar como developer este año.

    La charla de Tejas ya pasa de 132.000 visualizaciones. Martin Fowler publicó sobre harness engineering. LangChain publicó “The Anatomy of an Agent Harness”. MongoDB lo resumió en una frase: el LLM es la parte más pequeña de tu sistema de agentes. Esto no es una moda de Twitter. Es la disciplina consolidándose.

    Y como dijo Tejas: 2025 fue el año de los agentes. 2026 es el año de los harnesses.

    Qué es un agent harness, sin humo

    La definición de Tejas es la mejor que he escuchado: el harness es todo lo que rodea al modelo y le da anclaje en la realidad.

    La metáfora es literal. El arnés de un escalador lo ancla a algo estable: si resbala, no cae. El arnés de un perro evita que se desboque detrás de la primera ardilla. El harness de un agente hace las dos cosas: ancla al modelo a tu sistema real y evita que se desboque.

    ¿Por qué importa tanto? Por una asimetría brutal de control. El modelo es una caja negra que alquilas por tokens. No puedes abrirla, no puedes depurarla, no puedes garantizar nada sobre ella. El harness es la parte que tú controlas al cien por cien. Si quieres fiabilidad — y en producción no hay otra opción — la fiabilidad vive en el harness, no en el modelo.

    Ya escribí sobre el harness desde el lado del usuario en Harness Engineering con Codex de OpenAI: cómo configurar AGENTS.md, modos de aprobación, ese terreno. Este post va por el otro lado. Vamos a abrir el capó.

    La anatomía: las 6 piezas de un harness

    Todo harness serio — Claude Code, Codex, Pi, el que construyas tú — tiene estas seis piezas. Cambian los nombres y la sofisticación, no la anatomía.

    1. Tool registry

    El catálogo de herramientas que el modelo puede invocar: leer archivos, ejecutar comandos, llamar APIs. Sin tools, el modelo solo genera texto. Las tools son sus manos.

    2. El modelo

    Sí, es una pieza más. Una de seis. No el sistema entero. Interiorizar esto cambia cómo diseñas.

    3. Gestión de contexto

    La ventana de contexto se llena, y un contexto saturado degrada al modelo mucho antes de reventar el límite de tokens. El harness necesita primitivas de compaction: resumir lo viejo, descartar lo irrelevante, conservar lo esencial. En Hacker News los devs ya lo dicen abiertamente: la gestión de contexto es hoy un cuello de botella mayor que la calidad del modelo.

    4. Guardrails

    Límites duros que el modelo no puede negociar: máximo de pasos, máximo de mensajes, qué comandos requieren aprobación. Son el código determinista que evita que un agente confundido queme tu presupuesto de API en un bucle infinito.

    5. El agent loop

    El corazón: el ciclo que llama al modelo, ejecuta sus tool calls, le devuelve los resultados y repite hasta terminar. Y alrededor, el “loop sobre el loop”: qué pasa cuando el ciclo interno acaba — ¿se verifica? ¿se reintenta? ¿se escala a un humano? Si quieres ver esta pieza llevada a producción, ya escribí sobre cómo implementar un loop de agente efectivo para LLM en producción.

    6. El verify step determinista

    La pieza que casi todo el mundo omite y la que más fiabilidad compra. Cuando el agente dice “he terminado”, no le crees: lo compruebas con código. ¿Existe el archivo? ¿Pasan los tests? ¿Devuelve 200 el endpoint? Verificación sin LLM. Sobre esta pieza volvemos luego, porque es la moraleja de la demo de Tejas.

    Pi: un harness de cristal

    El problema de estudiar harnesses con Claude Code o Codex es que son opacos. Usas el harness, pero no puedes leerlo.

    Por eso el mejor ejemplo pedagógico ahora mismo es Pi (badlogic/pi-mono en GitHub, hoy bajo la org Earendil). Lo creó Mario Zechner y hoy lo desarrolla junto a Armin Ronacher — sí, el creador de Flask y Jinja2 — y lleva más de 61.000 stars. Es un coding agent de terminal con un harness mínimo a propósito: puedes leerlo entero en una tarde y entender cada pieza.

    Recorre la anatomía con Pi en la mano:

    Tool registry: cuatro tools. Read, Write, Edit, Bash. Nada más. Y con eso un coding agent funciona, porque casi todo lo que hace un developer se reduce a leer, escribir, editar y ejecutar.

    Agent loop: un ReAct mínimo. Streamea la respuesta del modelo, comprueba si hay tool calls, las ejecuta, mete los resultados en el contexto y repite. En pseudocódigo (ilustrativo, no el código real de Pi):

    // Ilustrativo: la forma del loop ReAct de un harness mínimo
    while (true) {
      const response = await model.stream(context);
    
      if (response.toolCalls.length === 0) break; // terminó
    
      for (const call of response.toolCalls) {
        const result = await tools.execute(call); // Read | Write | Edit | Bash
        context.push(toolResult(call, result));
      }
    }
    

    Eso es. Esa docena de líneas es el corazón de todo coding agent que has usado. El resto del harness existe para que ese loop no se estrelle contra la realidad.

    Contexto: Pi inyecta una sola línea de descripción por capacidad instalada. Minimalismo deliberado: contexto pequeño, modelo más fino.

    Extensibilidad: aquí está la filosofía de Pi. Lo que otros agentes traen de fábrica, en Pi lo construyes tú — extensiones en TypeScript con acceso a tools, comandos, atajos, eventos y la TUI completa, más skills, prompt templates y themes. El core no engorda. Y esa decisión lo convirtió en plataforma: tanto Flu (del equipo de Astro) como OpenClaude están construidos sobre Pi.

    Si quieres tocarlo: npm install -g @earendil-works/pi-coding-agent y a leer código.

    La lección del verify step

    Vuelve a la demo de Tejas, porque ahí está la tesis del post.

    GPT-3.5 Turbo sin harness: el agente miente. Afirma haber hecho cosas que no hizo. Y ojo — no es maldad, es la naturaleza del modelo: genera el texto más plausible, y “ya he votado” es texto plausible.

    La solución no fue prompt engineering. Fue un guardrail más una verificación determinista:

    // Ilustrativo: guardrail + verify step alrededor del loop
    const MAX_STEPS = 15;
    
    for (let step = 0; step < MAX_STEPS; step++) {
      await agentLoop(task, context);
    
      if (await verify(task)) return "done"; // código, no LLM:
      // ¿existe el registro? ¿pasó el test? ¿respondió 200?
    
      context.push("La verificación falló. La tarea NO está completa. Continúa.");
    }
    throw new Error("Máximo de pasos alcanzado: escalar a humano");
    

    Con eso, el modelo de 2023 deja de mentir. No porque sea más listo: porque el harness no le permite declarar éxito sin pruebas. El verify step convierte "confío en lo que dice el agente" en "compruebo lo que hizo el agente". Esa es toda la diferencia entre demo y producción.

    Qué significa esto para ti

    Que el valor se está moviendo. De saber elegir modelo a saber construir el sistema alrededor del modelo.

    Con un buen harness, un modelo barato u open source — GPT-OSS, Qwen3 — llega muchísimo más lejos de lo que crees. La demo de Tejas lo prueba con un modelo de hace tres años. Inviertes una vez en el harness (código tuyo, determinista, testeable, versionado en git) y cada modelo nuevo que conectes hereda esa fiabilidad gratis.

    Y hay otra consecuencia que me toca de cerca: un harness se especifica, no se improvisa. Decidir guardrails, criterios de verificación y límites del loop antes de escribir código es exactamente el enfoque Spec-Driven que cuento en el libro de SDD. Un agente sin spec es un loop sin guardrails.

    Si quieres practicar este músculo construyendo productos reales con agentes, es la lógica que aplicamos de principio a fin en el curso Construye con IA: de la idea al producto, con el sistema — no la fe en el modelo — sosteniendo el resultado.

    Tu tarea para hoy es concreta: clona Pi, abre el loop y léelo. Es la mejor clase de arquitectura de agentes disponible, y es gratis.

    Lo que viene: Flu

    Este post es la pieza 1 de la serie "El año de los harnesses".

    En la pieza 2 subo de nivel: video en YouTube sobre Flu, el framework harness del equipo de Astro, construido precisamente sobre Pi. Si Pi es el harness mínimo para entender la anatomía, Flu es lo que pasa cuando un equipo serio construye encima de esa base para producción.

    Suscríbete al canal de YouTube de Dominicode para no perdértelo. Y si quieres discutir tu propio harness con otros developers que están construyendo con agentes, en Dominicode Labs es la conversación de cada semana.

    El harness es el andamiaje; lo que envuelve es otra cosa. La distinción entre las dos anatomías —y qué es un agente de IA exactamente— la desarrollo en la guía del cluster.

    Preguntas frecuentes

    ¿Qué es un agent harness?

    Es todo el sistema que rodea al LLM y le da anclaje en la realidad: el tool registry, el agent loop, la gestión de contexto, los guardrails y la verificación determinista. El modelo genera decisiones; el harness las ejecuta, las limita y las comprueba. Es la parte del sistema de agentes que tú controlas.

    ¿Cuál es la diferencia entre un harness y un framework de agentes?

    Un framework de agentes (LangChain, CrewAI) te da abstracciones para orquestar LLMs: chains, grafos, equipos de agentes. El harness es más fundamental: es la pieza concreta que conecta un modelo con la realidad — loop, tools, guardrails, verificación. Todo framework de agentes contiene un harness dentro; pero puedes escribir un harness completo en cien líneas sin ningún framework, como demuestra Pi.

    Agent harness Framework de agentes
    Qué resuelve Conectar un modelo con la realidad de forma fiable Orquestar uno o varios agentes entre sí
    Nivel de abstracción Bajo: loop, tools, guardrails, verify Alto: chains, grafos, roles, equipos
    Ejemplos Pi, el harness de Claude Code, Flu LangChain, CrewAI, LangGraph
    Cuándo usarlo Siempre — todo agente corre dentro de uno Cuando orquestas flujos multi-agente complejos

    ¿Necesito construir mi propio harness o uso uno existente?

    Para programar día a día, usa uno existente (Claude Code, Codex, Pi). Construye el tuyo cuando el agente sea parte de tu producto: ahí necesitas controlar guardrails, verificación y costes, y un harness propio mínimo suele ganar a un framework genérico. En cualquier caso, lee uno entero al menos una vez — Pi es la opción perfecta — porque te cambia cómo usas todos los demás.

    ¿Qué es Pi (pi coding agent)?

    Pi es un coding agent open source de terminal creado por Mario Zechner y desarrollado hoy junto a Armin Ronacher (creador de Flask), con más de 61.000 stars en GitHub. Su harness es mínimo a propósito: 4 tools (Read, Write, Edit, Bash) y un loop ReAct que cabe en una pantalla. Todo lo demás se añade con extensiones TypeScript, skills y templates. Es la base sobre la que se construyen Flu y OpenClaude, y el mejor harness para estudiar porque puedes leerlo completo.

    ¿Por qué un modelo viejo con harness supera a un modelo nuevo sin harness?

    Porque los fallos típicos de un agente — declarar éxito sin haber hecho el trabajo, entrar en bucles, perder el contexto — no se arreglan con más inteligencia, se arreglan con estructura: guardrails que cortan los bucles y un verify step determinista que no acepta "ya está" sin pruebas. En la demo de Tejas Kumar (AI Engineer 2026), GPT-3.5 Turbo pasó de mentir a completar la tarea solo añadiendo harness, sin tocar el prompt.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

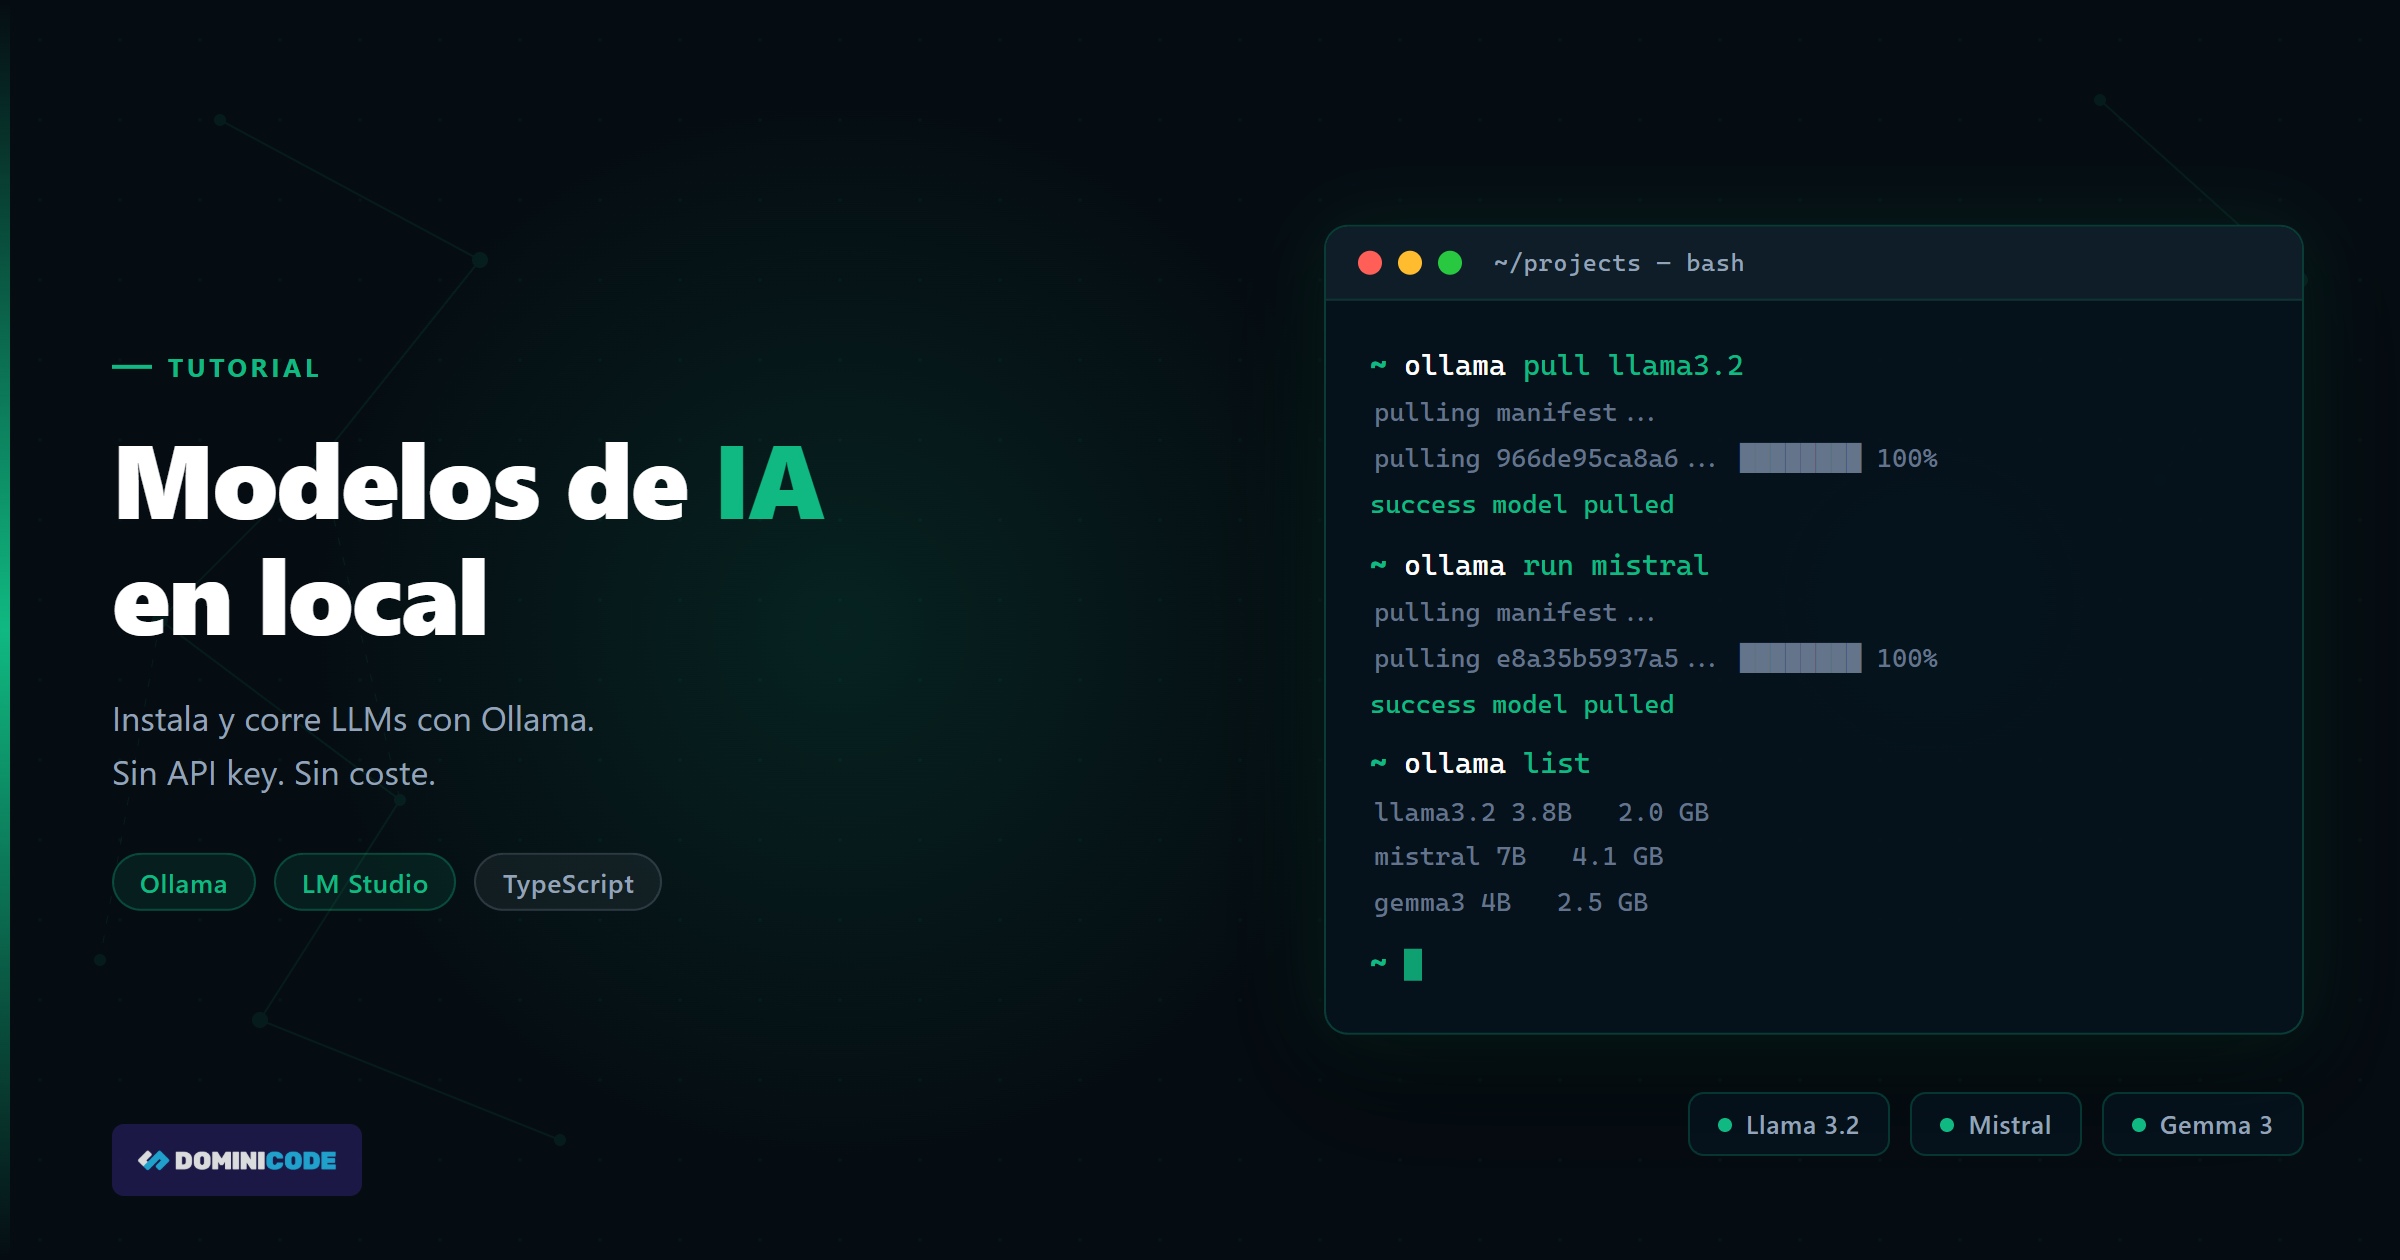
  • Cómo correr modelos de IA en local con Ollama

    Cómo correr modelos de IA en local con Ollama

    Era domingo por la noche. Tenía que probar un flujo de extracción de datos con un LLM y el presupuesto del cliente para APIs era cero. Nada aprobado, nada disponible.

    La solución: correr modelos IA en local. Instalé Ollama en diez minutos, bajé Llama 3 y terminé el prototipo antes de medianoche sin gastar un solo centavo en tokens.

    Eso es lo que te da correr modelos en local: velocidad, independencia y control total sobre lo que entra y lo que sale del modelo. Y en 2026, con los modelos open source en el estado en que están, la calidad ya no es una excusa para no hacerlo.

    Correr modelos IA en local significa ejecutar un Large Language Model directamente en tu hardware — sin enviar datos a APIs externas, sin coste por token y con latencia controlada. Herramientas como Ollama hacen que el proceso sea tan sencillo como instalar cualquier CLI.


    Por qué correr modelos en local (y cuándo importa de verdad)

    Hay cuatro razones concretas. Y van más allá del coste.

    Privacidad. Si trabajas con datos sensibles — contratos, código propietario, información médica — mandar esos datos a una API externa es un riesgo legal y contractual. Con modelos IA en local, los datos nunca salen de tu máquina.

    Latencia. Una llamada a GPT-4o tiene entre 300ms y 2 segundos de ida y vuelta dependiendo del tamaño del prompt. Un modelo local bien configurado en una máquina decente responde en milisegundos para tareas simples. Si construyes herramientas de developer experience o pipelines de CI con IA, esa diferencia importa.

    Iteración sin coste. En fases de prototipado puedes hacer miles de llamadas al día para testear prompts, ajustar pipelines y explorar comportamientos del modelo. Con una API de pago, eso se acumula rápido. En local, es gratis.

    Trabajo offline. Aviones, conexiones lentas, redes corporativas con proxies restrictivos. Un modelo local funciona siempre.


    Las dos herramientas que necesitas conocer

    Ollama — la opción de developer

    Ollama es la herramienta que más uso y la que recomiendo si eres developer. Es una CLI + servidor HTTP que gestiona la descarga, configuración y ejecución de modelos como si fueran contenedores Docker.

    Funciona en macOS, Linux y Windows. Tiene una API REST compatible con el formato de OpenAI, lo que significa que puedes usar clientes existentes con un cambio mínimo de URL. Y tiene una comunidad activa con más de 100 modelos disponibles en su registry.

    Si sabes usar Docker, Ollama te va a resultar natural inmediatamente.

    LM Studio — la opción visual

    LM Studio es la alternativa para quienes prefieren una interfaz gráfica. Permite navegar, descargar y comparar modelos con un chat visual, ideal para exploración inicial o para compartir con equipos no técnicos.

    También tiene un servidor local compatible con OpenAI. La diferencia clave: Ollama es mejor para integrar en código y scripts; LM Studio es mejor para explorar modelos de forma interactiva.

    Para este post me centro en Ollama porque es donde vive el flujo de trabajo real de un developer.


    Tutorial: instalar Ollama y correr tu primer modelo

    1. Instalación

    macOS:

    brew install --cask ollama

    Linux:

    curl -fsSL https://ollama.com/install.sh | sh

    Windows:
    Descarga el instalador desde ollama.com/download y ejecútalo. Ollama se instala como servicio y arranca automáticamente.

    Una vez instalado, verifica que funciona:

    ollama --version

    2. Descargar y correr un modelo

    # Descargar y correr Llama 3.2 (3B — ligero, ideal para empezar)
    ollama run llama3.2
    
    # Descargar sin abrir el chat
    ollama pull llama3.2
    
    # Descargar Mistral 7B
    ollama pull mistral
    
    # Descargar Gemma 3 (Google, muy eficiente)
    ollama pull gemma3
    
    # Descargar Qwen 2.5 (excelente en código)
    ollama pull qwen2.5-coder
    
    # Descargar Phi-4 (Microsoft, pequeño y capaz)
    ollama pull phi4

    Al ejecutar ollama run se abre un REPL interactivo en la terminal. Escribe tu prompt y responde como cualquier chat. Para salir: /bye.

    3. Gestionar modelos

    # Ver modelos descargados
    ollama list
    
    # Eliminar un modelo
    ollama rm mistral
    
    # Ver información de un modelo
    ollama show llama3.2

    4. Usar la API REST de Ollama

    Cuando Ollama está corriendo, expone una API en http://localhost:11434. Puedes usarla directamente con curl:

    # Generar una respuesta (completions)
    curl http://localhost:11434/api/generate \
      -H "Content-Type: application/json" \
      -d '{
        "model": "llama3.2",
        "prompt": "Explica qué es un closure en JavaScript en dos frases",
        "stream": false
      }'
    
    # Formato compatible con OpenAI (chat completions)
    curl http://localhost:11434/v1/chat/completions \
      -H "Content-Type: application/json" \
      -d '{
        "model": "llama3.2",
        "messages": [
          { "role": "user", "content": "Qué es un closure en JavaScript?" }
        ]
      }'

    El endpoint /v1/chat/completions es compatible con el SDK oficial de OpenAI. Solo tienes que cambiar la baseURL.


    Modelos recomendados según caso de uso

    Estos son los modelos IA en local con mejor rendimiento según el hardware disponible y el caso de uso:

    Modelo Tamaño Ideal para RAM mínima
    llama3.2:3b ~2 GB Tareas simples, prototipado rápido 8 GB
    llama3.1:8b ~5 GB Razonamiento general, chat 8 GB
    mistral:7b ~4 GB Instrucciones, resumen, generación de texto 8 GB
    qwen2.5-coder:7b ~4 GB Generación y revisión de código 8 GB
    gemma3:9b ~6 GB Tareas multilingues, contexto largo 16 GB
    phi4:14b ~9 GB Razonamiento complejo, análisis 16 GB
    llama3.3:70b ~40 GB Calidad cercana a GPT-4o 64 GB
    deepseek-r1:14b ~9 GB Razonamiento con chain-of-thought 16 GB

    Para una máquina de desarrollo con 16 GB de RAM, qwen2.5-coder:7b para tareas de código y llama3.1:8b para texto general cubren el 90% de los casos.


    Local vs nube: cuándo usar cada uno

    Criterio Local (Ollama) Nube (OpenAI, Anthropic, Google)
    Coste por llamada Gratis $0.001–$0.015 por 1K tokens
    Privacidad de datos Total Depende del proveedor y contrato
    Calidad en tareas complejas Buena (modelos 7B–14B) Excelente (modelos frontier)
    Latencia (primer token) Baja en hardware potente Varía: 300ms–2s
    Escalabilidad Limitada por tu hardware Prácticamente ilimitada
    Modelos de razonamiento avanzado Limitado o1, Claude Sonnet 4, Gemini 2.5 Pro
    Setup inicial 10 minutos Registro + API key
    Trabajo offline Sí No
    Ideal para Prototipado, privacidad, CI/CD, dev tooling Producción con usuarios reales, tareas complejas

    La regla que uso: local para desarrollar, nube para producir. Prototipa barato, valida rápido, y cuando el producto necesita escalar o resolver tareas de mayor complejidad, mueve las llamadas críticas a un modelo cloud.


    Integración con TypeScript y JavaScript

    Ollama tiene su propio cliente oficial para Node.js. Dado que expone un endpoint compatible con OpenAI, puedes usar el paquete openai directamente — sin reescribir nada en tus proyectos existentes. Después de integrar modelos IA en local en varios proyectos TypeScript, estos son los tres patrones que más uso en producción:

    Con el SDK de OpenAI (compatibilidad directa)

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: "http://localhost:11434/v1",
      apiKey: "ollama", // cualquier string no vacío
    });
    
    async function ask(prompt: string): Promise<string> {
      const response = await client.chat.completions.create({
        model: "llama3.2",
        messages: [{ role: "user", content: prompt }],
      });
    
      return response.choices[0].message.content ?? "";
    }
    
    const answer = await ask("Genera un schema Zod para un usuario con nombre y email");
    console.log(answer);

    Nota: El await en nivel superior requiere ESM. Añade "type": "module" en tu package.json o usa extensión .mts.

    El prompt del ejemplo genera un schema Zod. Si quieres dominar la validación de datos con TypeScript para estos pipelines, el curso de Zod cubre exactamente ese flujo con ejemplos reales.

    Con el cliente nativo de Ollama

    import { Ollama } from "ollama";
    
    const ollama = new Ollama({ host: "http://localhost:11434" });
    
    // Respuesta completa
    const response = await ollama.chat({
      model: "qwen2.5-coder",
      messages: [
        {
          role: "user",
          content: "Escribe una función TypeScript que valide un email con regex",
        },
      ],
    });
    
    console.log(response.message.content);
    
    // Streaming
    const stream = await ollama.chat({
      model: "qwen2.5-coder",
      messages: [{ role: "user", content: "Explica el patron Repository" }],
      stream: true,
    });
    
    for await (const chunk of stream) {
      process.stdout.write(chunk.message.content);
    }

    Instala el cliente oficial:

    npm install ollama
    # o con bun
    bun add ollama

    Cambiar entre local y nube con una variable de entorno

    Este patrón es el que más uso en proyectos reales — permite alternar entre Ollama y OpenAI sin cambiar código:

    import OpenAI from "openai";
    
    const isLocal = process.env.USE_LOCAL_LLM === "true";
    
    const client = new OpenAI({
      baseURL: isLocal ? "http://localhost:11434/v1" : "https://api.openai.com/v1",
      apiKey: isLocal ? "ollama" : process.env.OPENAI_API_KEY,
    });
    
    const model = isLocal ? "llama3.2" : "gpt-4o-mini";

    Con USE_LOCAL_LLM=true en desarrollo y la variable desactivada en producción, tienes el mejor de los dos mundos sin duplicar lógica. Esta es exactamente la clase de arquitectura que trabajamos en el curso Construye con IA, donde construimos productos completos con IA desde la especificación hasta el despliegue.


    FAQ — Preguntas frecuentes sobre modelos IA en local

    ¿Qué hardware necesito para correr modelos IA en local?

    Para modelos de 7B parámetros necesitas un mínimo de 8 GB de RAM y cualquier CPU moderna (últimos 5 años). Con GPU dedicada (NVIDIA o Apple Silicon) la inferencia es entre 5x y 10x más rápida. Un MacBook Pro M2 con 16 GB corre llama3.1:8b sin problemas. Para modelos de 70B necesitas al menos 64 GB de RAM o una GPU con suficiente VRAM.

    ¿Son los modelos locales comparables a GPT-4o o Claude?

    No para tareas complejas de razonamiento multi-paso o generación de código sofisticado. Pero para clasificación, resumen, extracción de información estructurada, generación de texto simple y asistencia en código básico, modelos como qwen2.5-coder:7b o llama3.1:8b son más que suficientes. La brecha se ha reducido mucho en el último año.

    ¿Puedo usar Ollama en un servidor de CI/CD?

    Sí. Ollama funciona en Linux sin cabecera y puede correr en Docker. El caso de uso más habitual: un runner de GitHub Actions con un runner self-hosted que tiene Ollama instalado para ejecutar checks de calidad de código o validaciones automáticas sin coste por llamada.

    ¿Cuánto espacio en disco ocupan los modelos?

    Depende del modelo y la cuantización. llama3.2:3b ocupa unos 2 GB. llama3.1:8b unos 5 GB. llama3.3:70b alrededor de 40 GB. Ollama descarga versiones cuantizadas (Q4 por defecto) que reducen el tamaño a la mitad aproximadamente manteniendo el 90–95% de la calidad del modelo original.

    ¿Qué diferencia hay entre Ollama y LM Studio?

    Ollama es una herramienta CLI-first, sin interfaz gráfica, pensada para integración en scripts y aplicaciones. LM Studio tiene una UI de escritorio con chat visual, gestor de modelos y comparador integrado. Ambas exponen una API local compatible con OpenAI. Si eres developer y quieres integrar el modelo en código, Ollama. Si quieres explorar modelos visualmente o presentarlos a stakeholders, LM Studio.

    ¿Puedo hacer fine-tuning de modelos con Ollama?

    Ollama no está diseñado para fine-tuning. Su función es servir modelos, no entrenarlos. Para fine-tuning de modelos open source necesitas herramientas como Unsloth, LoRA con Hugging Face o plataformas como Together AI y Replicate. Ollama puede servir después el modelo fine-tuneado si lo exportas en formato GGUF.

    ¿Es seguro usar modelos locales en producción?

    Depende del caso. Para un servicio interno o una herramienta de developer experience, perfectamente. Para un producto con miles de usuarios concurrentes, los modelos locales tienen limitaciones de escalabilidad obvias: un solo servidor solo puede atender las peticiones que su hardware permite procesar en paralelo. En ese escenario, la nube escala horizontalmente de forma que local no puede igualar.

    ¿Cómo elijo entre los modelos disponibles en Ollama?

    Empieza con llama3.2:3b para validar el flujo de tu aplicación (descarga rápida, responde rápido). Sube a llama3.1:8b o qwen2.5-coder:7b cuando necesites mejor calidad. Si tu máquina tiene 32 GB+ de RAM, phi4:14b o gemma3:27b son excelentes opciones intermedias antes de saltar a los modelos de 70B.


    Para ir más lejos

    Si estás construyendo productos con IA — integrando modelos IA en local en pipelines completos, agentes y herramientas que lleguen a usuarios reales — el siguiente paso es estructurar esa arquitectura desde el principio.

    El post sobre CLAUDE.md: el system prompt de tu proyecto explica cómo dar contexto permanente al agente. Clean Architecture en frontend con IA muestra cómo mantener las capas limpias cuando el agente genera código. Y si te preguntas hacia dónde va todo esto profesionalmente, la guía sobre qué es un Agentic Engineer cierra el mapa.

    En Dominicode Labs encontrarás proyectos completos, recursos avanzados y una comunidad de developers que están exactamente en esa fase: construyendo con IA en producción, no en tutoriales de YouTube.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Product builder: el cambio de mentalidad que la IA hace posible

    Product builder: el cambio de mentalidad que la IA hace posible

    Hace tres años me llegó un mensaje de un developer con siete años de experiencia en React. Me decía:

    “Bezael, sé hacer cualquier cosa que me pidan. Pero no tengo nada propio. Ni una app, ni un proyecto, ni un ingreso fuera de mi salario.”

    Lo que describía no era un problema de habilidades técnicas. Era un problema de identidad.

    Se veía a sí mismo como alguien que ejecuta. Alguien que recibe tickets, los cierra, y espera el siguiente. Un programador en el sentido más literal del término.

    Y eso, en 2026, es el camino más directo a la irrelevancia.

    Lo que ese developer necesitaba — lo que muchos developers necesitan — es pasar de ejecutar a construir: convertirse en un product builder.


    El developer que ejecuta vs. el product builder que construye

    Un product builder es un developer que combina criterio técnico con pensamiento de producto: no solo implementa soluciones, sino que decide qué problemas merecen ser resueltos y para quién.

    Hay una diferencia fundamental entre los dos perfiles, y no tiene nada que ver con el nivel técnico.

    Programador tradicional Product builder
    Pregunta: “¿Cómo lo implemento?” Pregunta primero: “¿Debería implementarlo?”
    Espera que alguien le diga qué construir Tiene una tesis propia sobre qué problema merece ser resuelto
    Mide su valor en líneas de código o tecnologías que domina Mide su valor en si algo que construyó funciona para alguien real

    No estoy diciendo que uno sea mejor persona que el otro. Estoy diciendo que el mercado está cambiando a una velocidad que hace que el primer perfil sea cada vez más reemplazable — y el segundo, más valioso que nunca.


    Por qué ahora es el momento exacto para hacer este cambio

    La barrera técnica para construir un producto ha colapsado.

    Antes, si querías lanzar algo solo, necesitabas dominar frontend, backend, base de datos, autenticación, despliegue, y probablemente seis frameworks distintos. Necesitabas un equipo o años de práctica en cada capa.

    Hoy, con herramientas como Claude Code, un developer con criterio puede tener un MVP funcionando en días. No porque la IA programe por ti — sino porque amplifica lo que ya sabes y elimina la fricción entre la idea y el código que la materializa.

    Eso cambia la ecuación por completo. Ya no es técnica la limitante. Es saber qué construir, para quién, y por qué alguien pagaría por ello.

    Eso es exactamente lo que trabajo en el curso Construye con IA: usar la IA no para generar código al azar, sino para ir de una idea real a un producto real con criterio de producto desde el principio.


    Qué comportamientos concretos tiene un product builder

    No voy a darte una lista de buzzwords. Te voy a decir cómo actúa alguien que ya hizo el cambio.

    Empieza por el problema, no por la tecnología. Antes de elegir un stack, un product builder ya sabe a qué usuario le duele qué cosa. La tecnología es una consecuencia de la solución, no el punto de partida.

    Shipea antes de que esté perfecto. El perfeccionismo técnico es el enemigo número uno de construir productos. Un product builder sabe que una versión imperfecta en manos de usuarios reales vale más que una versión perfecta en un repositorio privado.

    Habla con usuarios. No con amigos que te dicen que tu idea es buena. Con personas que tienen el problema que quieres resolver. Y aprende a distinguir entre lo que dicen que quieren y lo que realmente usarían.

    Entiende el negocio. No necesitas un MBA. Necesitas entender por qué alguien pagaría, cuánto pagaría, y cómo llegas a esa persona. Un product builder piensa en distribución desde el día uno.

    Itera con datos. No con opiniones. Lanza, mide, ajusta. El ciclo es corto y deliberado.


    Las cinco habilidades que nadie te enseñó en ningún bootcamp

    1. Pensamiento de producto

    No es saber usar Figma ni saber escribir user stories. Es desarrollar el hábito de preguntarte: “¿Qué problema real resuelve esto? ¿Para quién específicamente?”

    Cuando ves una app que usas cada día, un product builder la desmonta mentalmente: qué decisiones tomaron, qué sacrificaron, por qué funciona.

    2. Velocidad de validación

    La idea de construir durante meses antes de mostrar algo a alguien es una trampa. El objetivo no es construir — es aprender lo antes posible si lo que estás construyendo tiene sentido.

    Eso significa aprender a hacer prototipos rápidos y demos que generan feedback real. Una landing page que vende antes de que exista el producto ya es validación.

    3. Escritura que convierte

    Un product builder sabe explicar su producto en una frase. Sabe escribir una descripción que hace que alguien quiera probarlo. Sabe comunicar valor, no features.

    Esta habilidad — que parece ajena al mundo técnico — es una de las más diferenciadoras.

    4. Distribución y audiencia

    El código más limpio del mundo no vale nada si nadie lo usa. Un product builder piensa desde el principio en cómo va a llegar a sus usuarios: SEO, comunidad, contenido, partnerships, cold outreach.

    No tienes que hacerlo todo. Pero tienes que tener una respuesta a la pregunta: “¿Cómo van a enterarse de que esto existe?”

    5. Tolerancia a la ambigüedad

    Este es el más difícil para muchos developers, porque venimos de entornos donde los requisitos están (supuestamente) definidos. Construir un producto propio significa tomar decisiones con información incompleta, constantemente.

    Aprender a avanzar sin certeza total es una habilidad que se entrena, no que se tiene o no se tiene.


    El rol de la IA en todo esto

    La IA no te convierte en product builder. Eso lo haces tú con las decisiones que tomas.

    Lo que sí hace la IA es eliminar excusas.

    Antes, “no tengo tiempo para construir algo propio porque el backend me llevaría meses” era una razón real. Hoy no lo es. Hoy puedes hacer el backend en días, el frontend en días, el despliegue en horas.

    Lo que la IA no puede hacer por ti es decidir qué problema merece tu atención. No puede hablar con tus usuarios potenciales. No puede construir la audiencia que va a usar lo que hagas.

    Esa es tu parte. Y es la parte que más importa.

    Si quieres ver cómo trabajo este proceso — de la idea al producto con criterio de ingeniería y de negocio — en Dominicode Labs tenemos proyectos reales donde aplicamos exactamente esto: spec, validación, shipping, iteración.


    Cómo empezar el cambio hoy (sin abandonar tu trabajo)

    No te estoy pidiendo que renuncies ni que lances una startup la semana que viene. Te estoy pidiendo algo mucho más concreto.

    Elige un problema que tengas tú mismo — algo que te frustra como developer, como usuario, como persona — y pasa dos semanas construyendo una solución mínima. No perfecta. Mínima.

    Compártela con cinco personas que tengan el mismo problema. Observa qué pasa.

    Eso es un ciclo completo de product builder. Y lo puedes hacer este mes.

    La metodología que uso para estructurar este proceso — desde la especificación hasta el producto funcionando — está documentada en el Libro SDD. No es solo para proyectos grandes: es para cualquier developer que quiera pasar de “tengo una idea” a “tengo algo que funciona y que alguien usa”.


    El cambio no es técnico. Es de identidad.

    Volviendo al developer que me escribió hace tres años.

    Le dije algo simple: deja de pensar en qué tecnologías sabes y empieza a pensar en qué problema puedes resolver para alguien esta semana.

    No le dije que aprendiera product management. No le dije que hiciera un curso de negocios. Le dije que eligiera un problema pequeño y real, y que construyera algo — no para su portfolio, sino para alguien que lo necesita.

    Hoy tiene un producto SaaS que le genera ingresos recurrentes, lo sigue manteniendo como side project, y lleva ocho meses sin depender de que alguien le diga qué ticket hacer.

    Eso es lo que significa ser un product builder. No es un título. Es una forma de relacionarte con lo que construyes.

    Y la IA ha puesto esa posibilidad al alcance de cualquier developer que decida tomarla.


    Preguntas frecuentes

    ¿Un product builder necesita saber de diseño?
    No necesitas ser diseñador. Sí necesitas entender los principios básicos de UX y tener criterio para cuando algo es demasiado confuso para un usuario. Herramientas como Figma o incluso componentes UI prefabricados resuelven la mayor parte del problema visual. Lo que no puede resolver una herramienta es saber si tu producto tiene sentido.

    ¿Se puede ser product builder trabajando para una empresa?
    Sí, y de hecho es uno de los perfiles más buscados en empresas de producto. La diferencia es que aplicas el pensamiento de producto dentro de un equipo: cuestionas los requisitos, propones soluciones, mides el impacto real de lo que construyes. No eres el que ejecuta tickets — eres el que ayuda a decidir qué tickets merece la pena hacer.

    ¿La IA reemplaza al product builder?
    La IA reemplaza al developer que ejecuta tareas sin criterio. Al product builder lo amplifica, porque puede construir más rápido y experimentar más sin necesitar un equipo grande. La IA toma decisiones técnicas; el product builder toma decisiones de producto. Son funciones distintas.

    ¿Por dónde empiezo si nunca he lanzado nada propio?
    Empieza por un problema que conozcas bien — preferiblemente uno que tú mismo tengas. Construye la versión más pequeña posible que lo resuelva. Compártela con gente real antes de que esté “lista”. El error más común es esperar a tenerlo perfecto antes de mostrárselo a alguien. La retroalimentación temprana es lo que convierte una idea en un producto.

    ¿Cuánto tiempo lleva la transición de programador a product builder?
    No es una transición con fecha de fin — es un cambio de mentalidad que se profundiza con cada proyecto. El primer ciclo completo (idea, construcción mínima, usuarios reales, iteración) ya te cambia cómo ves el trabajo. La mayoría de developers que conozco que hicieron el cambio notan la diferencia después del primer proyecto propio que alguien usa de verdad.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Agentic loop: el mecanismo detrás de los agentes de IA

    Agentic loop: el mecanismo detrás de los agentes de IA

    La primera vez que vi a Claude Code refactorizar un módulo entero de TypeScript por sí solo, pensé que estaba viendo magia.

    Abrió el archivo. Leyó el código. Identificó el problema. Buscó dependencias en otros archivos. Editó tres ficheros en orden. Ejecutó los tests. Vio que uno fallaba. Corrigió el error. Volvió a ejecutar. Verde. Listo.

    Todo eso sin que yo le dijera qué hacer en cada paso. Le di un objetivo y él resolvió el camino.

    Lo que estaba viendo no era magia. Era el agentic loop en funcionamiento — el mecanismo que convierte un LLM pasivo en un agente que percibe, decide y actúa de forma continua hasta completar una tarea. Si estás construyendo con IA en 2026, entender cómo funciona este bucle es tan importante como entender cómo funciona el event loop de Node.

    Soy Bezael Pérez, developer senior y fundador de Dominicode. Llevo más de 15 años trabajando con software y los últimos dos obsesionado con cómo los agentes de IA cambian la forma de construir productos.


    La diferencia que cambia todo: LLM vs. agente

    Un LLM por sí solo es una función de texto: le das un input, devuelve un output. Extraordinariamente potente, pero estático. No sabe qué pasó antes. No puede hacer nada en el mundo real. No puede corregirse si se equivoca. Recibe. Responde. Se detiene.

    Un agente es diferente en una sola dimensión — pero esa dimensión lo cambia todo: puede actuar sobre su entorno y observar las consecuencias.

    Cuando le preguntas a ChatGPT “¿cómo conecto a PostgreSQL desde TypeScript?”, eso es un LLM. Te da la respuesta. Te toca a ti ejecutarla, ver si funciona, corregirla si falla.

    Cuando Claude Code abre tu proyecto, lee los archivos, escribe el código, ejecuta los tests y corrige los errores — eso es un agente con agentic loop. La diferencia no está en el modelo. Está en el bucle.


    Las fases del agentic loop

    El agentic loop no es un concepto abstracto. Es una arquitectura de ejecución con fases concretas que se repiten hasta que el agente completa su objetivo o se queda sin herramientas para avanzar. Este patrón lo formalizaron Yao et al. en el paper ReAct: Synergizing Reasoning and Acting in Language Models (2022) y es hoy la base de la mayoría de frameworks de agentes.

    Fase 1: Percibir

    El agente recibe información del entorno. Puede ser el mensaje del usuario, el resultado de una herramienta ejecutada en el ciclo anterior, el contenido de un archivo, una respuesta HTTP, el output de un comando de terminal.

    Esta fase parece trivial. No lo es. La calidad de lo que el agente percibe determina la calidad de lo que decide a continuación. Un agente que lee mal el contexto toma decisiones incorrectas con total confianza — y eso en producción es mucho más peligroso que un error que falla de forma evidente.

    Este fragmento muestra qué recibe el agente al inicio de cada ciclo: el mensaje del usuario, los resultados de herramientas anteriores y el system prompt que define sus capacidades:

    // Lo que el agente "percibe" en cada ciclo
    const context = {
      userMessage: "Refactoriza el módulo de autenticación para usar Signals",
      previousToolResults: [
        {
          tool: "read_file",
          output: "// auth.service.ts\nimport { Injectable } from '@angular/core'..."
        }
      ],
      systemPrompt: "Eres un assistant que refactoriza código Angular. Tienes acceso a las herramientas: read_file, write_file, execute_command."
    };

    Fase 2: Razonar

    El LLM procesa el contexto acumulado y decide qué hacer a continuación. Esta es la fase donde el modelo aplica su capacidad de razonamiento: evalúa el estado actual, compara con el objetivo, identifica el próximo paso.

    En modelos modernos como Claude Sonnet o GPT-4o, esta fase incluye razonamiento encadenado — el modelo se habla a sí mismo internamente antes de producir una decisión. En Claude, Anthropic expone este razonamiento explícitamente como “extended thinking” en la respuesta de la API — una feature específica de su plataforma, no un estándar cross-API.

    Lo que el agente produce en esta fase no es una respuesta de texto. Es una decisión estructurada: qué herramienta usar, con qué argumentos, por qué.

    En lugar de texto libre, el razonamiento del agente produce una llamada estructurada a herramienta. Este pseudocódigo representa esa decisión (el campo thinking es razonamiento interno del modelo — no lo recibes como developer en la respuesta de la API):

    // pseudocódigo — thinking es interno al modelo, no un campo de la API
    const agentDecision = {
      thinking: "Necesito leer el archivo auth.service.ts antes de modificarlo",
      toolCall: {
        name: "read_file",
        arguments: {
          path: "src/app/auth/auth.service.ts"
        }
      }
    };

    Fase 3: Actuar

    El agente ejecuta la herramienta que decidió usar. Aquí es donde la IA toca el mundo real: escribe en disco, llama a una API externa, ejecuta SQL, navega una página web, envía un email.

    Esta es también la fase más delicada desde el punto de vista de seguridad y control. Una acción ejecutada no se puede deshacer fácilmente. Por eso los sistemas de agentes bien diseñados implementan sandboxes, confirmaciones humanas para acciones irreversibles y límites explícitos en qué herramientas puede usar el agente.

    La función executeToolCall implementa esta capa de ejecución: recibe la decisión estructurada del agente y ejecuta la acción real sobre el sistema:

    // Ejecución de la herramienta — el agente actúa sobre el entorno
    async function executeToolCall(toolCall: ToolCall): Promise<ToolResult> {
      switch (toolCall.name) {
        case "read_file":
          return { output: await fs.readFile(toolCall.arguments.path, "utf-8") };
        case "write_file":
          await fs.writeFile(toolCall.arguments.path, toolCall.arguments.content);
          return { output: "Archivo escrito correctamente" };
        case "execute_command":
          const result = await exec(toolCall.arguments.command);
          return { output: result.stdout, error: result.stderr };
        default:
          throw new Error(Herramienta desconocida: ${toolCall.name});
      }
    }

    Fase 4: Observar

    El agente recibe el resultado de la acción ejecutada y lo incorpora a su contexto. Si leyó un archivo, ahora tiene el contenido. Si ejecutó un test, ahora sabe si pasó o falló. Si llamó a una API, tiene la respuesta — o el error.

    Esta fase cierra el bucle. El resultado de la observación se convierte en nuevo input para la siguiente iteración de Percibir → Razonar → Actuar. El agente actualiza su modelo interno del estado del mundo y decide si ha completado su objetivo o si necesita otro ciclo.

    El resultado de la herramienta vuelve al contexto como un mensaje más. El modelo evalúa si ha terminado o si necesita otra herramienta:

    // El resultado se incorpora al contexto para el siguiente ciclo
    messages.push({
      role: "tool",
      content: toolResult.output,
      toolCallId: toolCall.id
    });


    // ¿Ha completado el objetivo? El modelo decide. const nextStep = await llm.complete(messages); // Si devuelve texto sin tool_call → tarea completada // Si devuelve otro tool_call → el bucle continúa

    Repetir (o detenerse)

    El bucle continúa mientras el agente tenga herramientas que ejecutar y no haya alcanzado su objetivo. Se detiene cuando el modelo produce una respuesta de texto sin invocar ninguna herramienta — lo que indica que considera la tarea completada — o cuando alcanza el límite de iteraciones definido en la configuración.

    Ese límite de iteraciones no es un detalle menor. Es una de las decisiones de diseño más importantes en un sistema agéntico. Un agente sin límite puede quedar atrapado en un bucle infinito consumiendo tokens y ejecutando acciones hasta que alguien apague el proceso.


    Cómo lo implementan las herramientas reales

    No tienes que construir el agentic loop desde cero. Las herramientas que ya existen lo implementan por ti, con tres aproximaciones distintas: ejecución local directa (Claude Code), orquestación de grafos (LangGraph) y no-code visual (n8n). Cada una optimiza para un perfil diferente de developer y caso de uso.

    • Claude Code — Loop completo con herramientas del sistema operativo: leer/escribir archivos, ejecutar comandos de terminal, buscar en el codebase. El agente decide autónomamente qué pasos dar y puedes verlo trabajar en tiempo real en la terminal.
    • LangChain / LangGraph — Loop como grafo de nodos configurables. Tú defines las transiciones, condiciones de parada y herramientas. Más control y flexibilidad para flujos con ramificaciones complejas.
    • n8n — AI Agent nodes que envuelven el loop en un flujo visual. Ideal para automatizaciones de negocio con APIs externas, webhooks y transformaciones de datos sin escribir código.
    • AutoGPT / BabyAGI — La primera ola de agentes. Implementaron el loop de forma casi literal: generaban sus propias subtareas, las priorizaban y las ejecutaban. Funcionaban en demos, fallaban en producción por acumulación de errores en cada ciclo y falta de controles.

    Si quieres profundizar en cómo construir el harness que envuelve el loop, este análisis sobre harness engineering con agentes de IA cubre la capa de orquestación en detalle.


    Por qué los agentes fallan — y no es culpa del modelo

    El agentic loop tiene un problema estructural que los developers aprenden a la fuerza: los errores se propagan y se amplifican.

    En un LLM normal, si el modelo alucina en la respuesta, el usuario lo ve y puede corregirlo. En un agente con agentic loop, si el modelo toma una decisión incorrecta en el ciclo 2, esa decisión puede contaminar los ciclos 3, 4 y 5 antes de que nadie se dé cuenta. Para cuando el agente termina, puede haber modificado archivos, llamado a APIs y tomado decisiones basadas en una premisa incorrecta del principio.

    Hay tres patrones de fallo que aparecen una y otra vez en producción:

    Context drift — El contexto acumulado crece ciclo a ciclo. En conversaciones largas, el modelo empieza a perder el hilo de los objetivos originales y se centra en los últimos resultados. El agente puede alcanzar un estado donde “funciona” localmente pero ha perdido el objetivo global.

    Tool loop — El agente entra en un ciclo donde ejecuta la misma herramienta con los mismos argumentos repetidamente porque no sabe cómo interpretar el resultado. Sin un límite de iteraciones y sin detección de patrones repetitivos, consume tokens hasta el límite de la sesión.

    Overconfidence — El modelo decide con alta confianza en casos donde debería pedir confirmación. Elimina un archivo que creía temporal. Envía un email que debía ser un borrador. Ejecuta una migración de base de datos en producción. La confianza del modelo no tiene correlación con la corrección de la acción.

    La solución no es usar un modelo más inteligente. Es diseñar el sistema con los controles correctos: límites de iteración, human-in-the-loop para acciones irreversibles, y observabilidad para saber exactamente qué está haciendo el agente en cada ciclo. Si te interesa la parte de observabilidad, en el post sobre observabilidad en LLMs: traza, mide y depura tus agentes cubrimos cómo instrumentar el loop con trazas y métricas reales.


    Cuándo usar el agentic loop (y cuándo no)

    El agentic loop resuelve una clase específica de problemas. Usarlo para todo es uno de los errores más comunes que veo en equipos que empiezan con IA.

    Úsalo cuando:

    • La tarea requiere múltiples pasos que dependen del resultado de los anteriores
    • El objetivo está claro pero el camino para alcanzarlo no se puede definir de antemano
    • Necesitas interactuar con herramientas externas en función del contexto
    • La tarea implica explorar un espacio de posibilidades (búsqueda, refactorización, análisis)

    Ejemplos concretos: refactorizar un módulo de código, investigar un bug leyendo múltiples archivos, rellenar formularios complejos a partir de documentos, ejecutar una pipeline de procesamiento de datos donde cada paso depende del anterior.

    No lo uses cuando:

    • Puedes resolver el problema con un solo prompt bien diseñado
    • La latencia importa y el usuario está esperando una respuesta inmediata
    • Las acciones son irreversibles y el contexto no garantiza que el agente tomará la decisión correcta
    • El problema tiene una solución determinista que no requiere razonamiento iterativo

    Un agente que escribe el texto de un email de bienvenida es sobre-ingeniería. Un LLM con el prompt correcto lo hace en un ciclo, sin herramientas, en 200ms. Reserva el agentic loop para los problemas que lo necesitan de verdad.

    En el curso Construye con IA abordamos exactamente este criterio de decisión: qué arquitectura elegir para cada problema, cuándo un agente añade valor real y cuándo un prompt bien diseñado es más efectivo, rápido y barato.


    El agentic loop en 2026: dónde está el límite real

    El límite ya no es la capacidad del modelo. Los LLMs actuales razonan lo suficientemente bien como para completar tareas complejas de múltiples pasos.

    El límite es la confianza que puedes depositar en el sistema.

    Confiar en que el agente tomará la decisión correcta en cada ciclo, sin supervisión humana, es una apuesta que depende del dominio, del riesgo de las acciones y de la calidad de las herramientas que le has dado. En tareas de desarrollo donde los cambios son reversibles (código en un repositorio con git), puedes darle mucha autonomía. En tareas que afectan a clientes o datos de producción, el loop necesita checkpoints humanos.

    El patrón que están adoptando los equipos más avanzados es human-in-the-loop selectivo: el agente actúa de forma autónoma en la mayoría de ciclos, pero solicita confirmación explícita antes de ejecutar acciones que superen un umbral de riesgo definido en el sistema.

    No es rendirse al agente ni microgestionar cada paso. Es diseño de sistema con criterio.

    Si quieres ver cómo aplico este patrón en proyectos reales — y explorar los proyectos que la comunidad está construyendo con agentes en producción — pásate por Dominicode Labs. Hay recursos, proyectos y discusiones que no publicaré en el blog.


    Antes de meterte con el bucle conviene tener clara la frontera: qué es un agente de IA y en qué se diferencia de un workflow, con el test para aplicarlo a tu propio código.

    FAQ — Preguntas frecuentes sobre el agentic loop

    ¿Qué diferencia hay entre un chatbot y un agente con agentic loop?

    Un chatbot procesa mensajes y genera respuestas de texto. No ejecuta acciones en el mundo real ni mantiene un estado entre ciclos más allá del historial de conversación. Un agente con agentic loop puede leer archivos, llamar a APIs, ejecutar código y tomar decisiones basadas en los resultados de esas acciones — repitiendo el ciclo hasta completar un objetivo complejo.

    ¿El agentic loop necesita un modelo específico o funciona con cualquier LLM?

    Técnicamente funciona con cualquier LLM que soporte function calling o tool use. En la práctica, la calidad del loop depende mucho de la capacidad del modelo para razonar sobre los resultados de las herramientas y decidir el siguiente paso correcto. Claude Sonnet, GPT-4o y Gemini 2.5 Pro son los modelos que ofrecen resultados más consistentes hoy. Modelos más pequeños fallan con más frecuencia en las fases de razonamiento y en la detección de cuándo el objetivo está completo.

    ¿Cuántas iteraciones puede hacer un agente antes de fallar o perder el hilo?

    Depende del modelo y del tamaño del contexto. Los modelos actuales con ventanas de contexto grandes (200k tokens en Claude) pueden mantener coherencia durante decenas de iteraciones en tareas bien definidas. En la práctica, la degradación empieza a notarse alrededor de las 20-30 iteraciones en tareas complejas con mucho contexto acumulado. Un buen sistema define un maxIterations entre 10 y 50 según el dominio, con lógica de parada anticipada si detecta patrones repetitivos.

    ¿Claude Code usa un agentic loop?

    Sí. Claude Code implementa el agentic loop completo: lee el contexto del proyecto, decide qué herramientas usar (leer archivos, escribir código, ejecutar comandos), observa los resultados y repite hasta completar la tarea. La diferencia con un uso básico de la API de Claude es que Claude Code orquesta este bucle de forma transparente, con acceso al filesystem y al terminal, y con la capacidad de autocorregirse cuando un test falla o un comando devuelve un error.

    ¿Es el agentic loop lo mismo que el “chain of thought”?

    No. Chain of thought es una técnica de prompting donde el modelo razona paso a paso antes de dar una respuesta — todo ocurre dentro de una sola llamada al LLM. El agentic loop es una arquitectura de ejecución que implica múltiples llamadas al modelo, ejecución real de herramientas entre llamadas, y un estado que se actualiza en cada ciclo. Chain of thought puede ser parte de la fase de razonamiento dentro del loop, pero son conceptos de nivel diferente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

    Si este post te ha sido útil, hay más contenido técnico sobre IA aplicada al desarrollo en el canal de YouTube de Dominicode.

  • Observabilidad en LLMs: traza, mide y depura tus agentes de IA

    Observabilidad en LLMs: traza, mide y depura tus agentes de IA

    El equipo había estado tres semanas construyendo un agente de soporte técnico. Funcionaba bien en local. Lo lanzaron a producción un lunes por la mañana.

    El viernes tenían una factura de $1.200 en tokens, tres tickets de clientes con respuestas completamente inventadas y ninguna pista de en qué paso del flujo había empezado a fallar todo.

    El agente había estado corriendo. Respondiendo. Consumiendo. Pero nadie podía ver qué estaba pasando dentro.

    Ese es el problema que resuelve la observabilidad en LLMs — el conjunto de técnicas que permite registrar, medir y analizar cada paso de un agente de IA en producción: los prompts enviados, las herramientas invocadas, los tokens consumidos y los errores producidos. Si estás construyendo cualquier cosa con IA en producción, necesitas entenderla antes de que te pase lo mismo.


    El problema real: los LLMs son cajas negras que facturan

    Con una API REST tradicional tienes un contrato claro: envías una petición, recibes una respuesta, mides el tiempo, logueas el error. La traza es determinista.

    Con un LLM, el contrato se rompe. Puedes enviar el mismo prompt dos veces y recibir respuestas distintas. Un agente puede invocar herramientas en un orden diferente al esperado. El modelo puede alucinarse con un dato en el paso 3 de 7 y tú solo ves el resultado final — correcto en formato, incorrecto en contenido.

    Sin observabilidad, estás volando a ciegas. Y en producción, volar a ciegas con un LLM significa costos impredecibles, degradación silenciosa de calidad y bugs que no aparecen en ningún test.


    Los tres pilares de la observabilidad en LLMs

    La observabilidad clásica tiene tres dimensiones. En el mundo de los LLMs, cada una significa algo distinto.

    Trazas (Traces)

    Una traza registra el camino completo de una ejecución: qué prompt se envió, qué herramientas se llamaron, en qué orden, con qué inputs y qué outputs. En un agente con múltiples pasos, una traza te muestra el árbol completo de decisiones — no solo el resultado final.

    Es la diferencia entre saber que tu agente “falló” y saber exactamente en qué llamada a qué herramienta empezó a descarrilarse.

    Métricas

    Latencia por llamada, costo en tokens (input + output), tasa de éxito de herramientas, número de reintentos. Estas métricas agregadas te dicen si tu sistema está degradándose con el tiempo o si hay un prompt específico que consume diez veces más tokens que los demás.

    Logs estructurados

    No los logs de consola que escribes para depurar en local. Logs que capturen el contexto completo de cada ejecución: qué usuario lanzó la petición, qué versión del prompt se usó, qué modelo, qué temperatura. Logs que puedas consultar después cuando alguien reporte un comportamiento extraño hace 48 horas.


    Herramientas de observabilidad LLM en 2026

    Cinco herramientas que cualquier developer que construye con IA debería conocer:

    Herramienta Tipo Self-hosted Stack ideal Plan gratuito
    Langfuse SDK + plataforma ✅ Sí Cualquier API 50k obs/mes
    LangSmith Plataforma ❌ No LangChain Sí (limitado)
    Helicone Proxy ❌ No Multi-proveedor Sí
    Arize Phoenix Análisis offline ✅ Sí Evaluación por lotes Open source
    OpenTelemetry GenAI Estándar ✅ Sí Stacks OTEL existentes Open source

    Langfuse — El estándar open source. Puedes autohospedarlo o usar su cloud. Tiene SDK para TypeScript, Python e integración nativa con LangChain, Vercel AI SDK y llamadas directas a la API de Anthropic u OpenAI. Es la opción que recomiendo si quieres control total sobre tus datos.

    LangSmith — El producto de LangChain. Excelente si ya usas LangChain en tu stack, pero te ata al ecosistema. Para proyectos con llamadas directas a la API, Langfuse gana en flexibilidad.

    Helicone — Proxy que se pone delante de cualquier llamada a la mayoría de proveedores LLM (OpenAI, Anthropic, Azure, LiteLLM y otros). Configuración en dos minutos, observabilidad inmediata. Ideal para proyectos donde no puedes tocar el código de integración o quieres monitoreo rápido sin instrumentación.

    Arize Phoenix — Enfocado en evaluación y análisis offline. Útil cuando quieres analizar lotes de ejecuciones para detectar problemas de calidad sistemáticos, no solo monitoreo en tiempo real.

    Semantic conventions for generative AI systems (OTel GenAI) — El estándar OTEL para IA lleva trazas de LLMs al stack de observabilidad que ya tienes (Grafana, Datadog, Honeycomb). Si tu empresa ya tiene infraestructura OTEL, esta es la forma de integrar los LLMs sin añadir otra herramienta.


    Implementación real con TypeScript y Langfuse

    Suficiente teoría. Esto es cómo lo implementas en un proyecto TypeScript.

    Primero, instala el SDK (versión actual: langfuse@3.x):

    npm install langfuse
    

    Inicializa el cliente una sola vez en tu aplicación — en un módulo singleton si usas NestJS, en un archivo de configuración si es un script:

    import Langfuse from "langfuse";
    
    export const langfuse = new Langfuse({
      publicKey: process.env.LANGFUSE_PUBLIC_KEY!,
      secretKey: process.env.LANGFUSE_SECRET_KEY!,
      baseUrl: "https://cloud.langfuse.com", // o tu instancia autohospedada
    });
    

    Ahora instrumenta una llamada a Claude. El patrón es siempre el mismo: creas una traza, creas una generación dentro de esa traza, ejecutas la llamada y registras el resultado:

    import Anthropic from "@anthropic-ai/sdk";
    import { langfuse } from "./langfuse-client";
    
    const client = new Anthropic();
    
    async function generateSupportResponse(
      userMessage: string,
      userId: string
    ): Promise<string> {
      // Abre la traza — representa toda la operación de negocio
      const trace = langfuse.trace({
        name: "support-response",
        userId,
        metadata: { channel: "web" },
      });
    
      // Crea una generación — representa una sola llamada al LLM
      const generation = trace.generation({
        name: "claude-response",
        model: "claude-sonnet-4-6",
        input: [{ role: "user", content: userMessage }],
      });
    
      try {
        const response = await client.messages.create({
          model: "claude-sonnet-4-6",
          max_tokens: 1024,
          messages: [{ role: "user", content: userMessage }],
        });
    
        const outputText =
          response.content[0].type === "text" ? response.content[0].text : "";
    
        // Registra la respuesta y el uso de tokens
        generation.end({
          output: outputText,
          usage: {
            input: response.usage.input_tokens,
            output: response.usage.output_tokens,
          },
        });
    
        return outputText;
      } catch (error) {
        // Registra errores también — son datos cruciales
        generation.end({
          level: "ERROR",
          statusMessage: error instanceof Error ? error.message : "Unknown error",
        });
        throw error;
      } finally {
        // Vacía el buffer antes de cerrar el proceso
        await langfuse.shutdownAsync();
      }
    }
    

    Para un agente con múltiples pasos — por ejemplo, uno que busca en una base de datos antes de responder — anidas spans dentro de la traza:

    async function agentWithToolCall(query: string, userId: string) {
      const trace = langfuse.trace({
        name: "agent-with-tools",
        userId,
        input: { query },
      });
    
      // Span para la búsqueda en base de datos
      const searchSpan = trace.span({
        name: "database-search",
        input: { query },
      });
    
      const searchResults = await searchDatabase(query);
    
      searchSpan.end({
        output: { resultCount: searchResults.length },
      });
    
      // Generación con los resultados como contexto
      const generation = trace.generation({
        name: "synthesis",
        model: "claude-sonnet-4-6",
        input: buildPromptWithContext(query, searchResults),
      });
    
      const response = await callClaude(query, searchResults);
    
      generation.end({ output: response });
      trace.update({ output: { response } });
      await langfuse.shutdownAsync();
    
      return response;
    }
    

    Con esto, cada ejecución queda registrada en Langfuse con su árbol completo de spans. Puedes ver exactamente cuánto tardó la búsqueda, cuántos tokens consumió la síntesis y qué prompt produjo esa respuesta que el cliente reportó como incorrecta.

    Es exactamente este tipo de arquitectura observable la que construimos en el curso Construye con IA — desde el primer agente hasta el sistema completo en producción, con trazabilidad desde el día uno.


    Los errores que aparecen cuando no tienes observabilidad

    Estos son los tres problemas que he visto repetirse en proyectos sin observabilidad — y que solo se detectan cuando ya han causado daño:

    Alucinaciones no detectadas. El agente responde con confianza. El formato es correcto. El dato está mal. Sin trazas, nunca sabes en qué paso del flujo el modelo inventó algo. Con trazas, identificas el prompt exacto que produce el problema y lo corriges.

    Latencias ocultas. El endpoint responde en 8 segundos. No sabes si el problema está en la llamada al LLM, en la búsqueda vectorial o en el postprocesado. Las métricas por span te dicen exactamente dónde está el cuello de botella.

    Costos fuera de control. Un prompt mal diseñado puede consumir 10x más tokens que uno equivalente. Sin métricas de uso por operación, solo ves la factura de fin de mes. Con observabilidad, detectas el problema en el primer día de producción.


    Por dónde empezar si ya tienes un proyecto en marcha

    No tienes que instrumentar todo de golpe. El orden que funciona:

    1. Añade Langfuse o Helicone a la llamada al LLM más crítica de tu sistema.
    2. Registra siempre: modelo, versión del prompt, userId, tokens usados.
    3. Cuando detectes un comportamiento inesperado, usa las trazas para reproducirlo.
    4. Una vez que el patrón funciona, extiéndelo al resto de llamadas.

    La observabilidad no es una feature opcional que añades al final. Es la infraestructura que te permite iterar sobre tus prompts con datos reales — no con intuición.

    Si quieres construir sistemas con IA desde cero con buenas prácticas de producción integradas desde el principio, en Dominicode Labs tenemos proyectos y recursos donde trabajamos exactamente esto junto a otros developers hispanohablantes.


    FAQ — Preguntas frecuentes sobre LLM Observability

    ¿Qué diferencia hay entre observabilidad en LLMs y logging tradicional?

    El logging tradicional captura eventos discretos: errores, requests, respuestas. La observabilidad en LLMs captura el flujo completo de razonamiento de un agente: qué herramientas invocó, en qué orden, con qué contexto, y cómo cada paso influyó en el resultado final. La diferencia es la misma que entre saber que tu avión aterrizó tarde y saber exactamente en qué tramo de la ruta perdió tiempo.

    ¿Necesito observabilidad si solo uso un LLM para tareas sencillas como resúmenes de texto?

    Si está en producción y lo usa más de un usuario, sí. Incluso para tareas aparentemente sencillas, la observabilidad te da visibilidad sobre costos (¿cuánto estoy gastando por resumen?), calidad (¿hay inputs que producen respuestas malas consistentemente?) y latencia (¿hay prompts que tardan 5x más que otros?). El esfuerzo de instrumentar una sola llamada es de menos de 20 líneas de código.

    ¿Langfuse es mejor que LangSmith?

    Depende de tu stack. Si usas LangChain, LangSmith es la integración más natural. Si haces llamadas directas a la API de Anthropic u OpenAI, o usas el Vercel AI SDK, Langfuse tiene mejor soporte, es open source y puedes autohospedarlo. Para proyectos donde los datos son sensibles y no quieres enviarlos a un tercero, Langfuse self-hosted es la única opción razonable.

    ¿Cómo gestiono la observabilidad en un agente con múltiples LLMs y herramientas?

    Usando el modelo de trazas jerárquicas: una traza por operación de negocio, spans para cada herramienta o paso intermedio, y generaciones para cada llamada al LLM. Langfuse, LangSmith y Arize Phoenix soportan este modelo de forma nativa. La clave es diseñar las trazas pensando en qué preguntas querrás responder cuando algo falle — no en lo que es fácil de capturar.

    ¿Cuánto cuesta implementar observabilidad con Langfuse?

    Langfuse Cloud tiene un plan gratuito generoso (50.000 observaciones al mes en la fecha de publicación de este post). Para proyectos con volumen alto, puedes autohospedarlo en tu propia infraestructura con Docker — el costo es solo el del servidor. LangSmith y Helicone tienen también niveles gratuitos, pero con menos control sobre los datos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cómo evitar que los agentes elijan mal sus herramientas en proyectos de IA

    Cómo evitar que los agentes elijan mal sus herramientas en proyectos de IA

    El problema real del tool_use: cuándo los agentes eligen mal sus herramientas

    Tiempo estimado de lectura: 4 min

    • Diseña cada tool como un contrato: propósito claro, condición binaria de activación, restricciones negadas y un schema de salida.
    • Reduce la superficie de decisión: retrieval dinámico y máquinas de estado cuando el catálogo supera ~10–15 tools.
    • Valida estrictamente: enums, formatos concretos y validación back-end (ej. Zod) para evitar argumentos corruptos.
    • Mide lo que importa: precisión de selección, retries, tokens gastados y casos de misuse en staging.

    Si tu agente tiene acceso a muchas herramientas y no defines reglas explícitas, no estás ante un fallo del modelo: estás ante un diseño roto. Este artículo explica por qué ocurren elecciones equivocadas y cómo diseñar descripciones de herramientas que reducen errores de selección hasta en ~80% en implementaciones reales. Conectar APIs es trivial; conseguir que un LLM seleccione la herramienta correcta, con argumentos válidos y sin invocar capacidades fuera de scope, es ingeniería.

    Resumen rápido (lectores con prisa)

    Define cada herramienta como un contrato: una frase de propósito, una condición de activación binaria, restricciones explícitas de uso y un schema de salida mínimo. Usa retrieval dinámico para reducir opciones y máquinas de estado para limitar permisos. Valida en back-end (ej. Zod) y mide precisión de selección y retries.

    El problema real del tool_use: cuándo los agentes eligen mal sus herramientas — causas

    Tres causas estructurales explican la mayoría de las fallas en producción:

    1. Solapamiento semántico. Dos o más tools parecen válidas para la misma intención; el modelo elige por probabilidades.
    2. Ausencia de fronteras negativas. Documentas qué hace la tool pero no cuándo está prohibida; el modelo probará usos peligrosos.
    3. Sobrecarga del contexto. Inyectar 30–40 esquemas en el prompt produce “lost in the middle” y pérdida de atención (ver estudio).

    Si no mitigues estas tres fuentes de ambigüedad, el agente duplicará llamadas, generará argumentos corruptos o intentará acciones destructivas.

    Cómo diseñar descripciones que reducen errores de selección (estructura de 4 campos)

    Piensa la descripción de cada herramienta como un contrato para una red neuronal: precisa, restrictiva y ejecutable. Sigue estos cuatro campos en todas las tools:

    1. Propósito (What) — Una sola frase: acción exacta.
    2. Condición de activación (When) — “Úsalo SOLO cuando…” (condición binary o claramente verificable).
    3. Restricción excluyente (When NOT) — “NO lo uses para…” y alternativa sugerida.
    4. Formato de salida (Expected Output) — JSON schema mínimo que el agente puede comprobar antes de llamar.

    Ejemplo práctico

    Descripción:

    “Recupera el estado y el último comentario de un ticket de Jira. Úsalo SOLO con un ticket ID válido (PROJ-123). NO lo uses para búsquedas por texto; usa search_jira_tickets para eso.”

    Schema (JSON / Zod-like)

    {
    “type”: “object”,
    “properties”: {
    “ticketId”: { “type”: “string”, “pattern”: “^[A-Z]+-\\d+$” }
    },
    “required”: [“ticketId”]
    }

    Ese nivel de precisión elimina ambigüedad en cuándo y cómo llamar la tool.

    Schemas como enrutadores: reglas prácticas

    • Evita tipos genéricos. Si esperas fecha, exige format: “date-time”.
    • Describe cada propiedad. El LLM usará esa descripción para construir el valor.
    • Forza enums para valores discretos. Los LLM respetan enums con alta consistencia.
    • Implementa validación estricta (Zod) en el back-end y devuelve errores estructurados (Result pattern) si el LLM envía datos inválidos.

    Arquitectura para catálogos grandes: Dynamic Tool Retrieval y State Machines

    Cuando tienes >10–15 tools, las descripciones no bastan. Aplica dos patrones:

    • Dynamic Tool Retrieval (RAG de herramientas). Embeddiza la intención del usuario y busca en una DB vectorial las 3–4 tools más relevantes; solo esas se inyectan en el prompt. Implementaciones prácticas usan pgvector o sistemas vectoriales gestionados. Reducir la superficie de decisión aumenta la precisión drásticamente.
    • Máquinas de estado / orquestación. Divide responsabilidades entre sub-agentes con permisos limitados. Herramientas de orquestación: n8n, LangGraph o XState. El nodo de “consulta” solo expone tools de lectura; el nodo de “modificación” habilita herramientas de escritura tras condiciones de validación.

    Restricción por estado = seguridad + predictibilidad.

    Métricas y pruebas que importan

    No te fíes de sensaciones. Mide:

    • Precisión de selección (tool chosen vs. tool expected).
    • Retries por tipo de error.
    • Tokens gastados en reintentos inútiles.
    • Casos de “tool misuse” detectados en staging.

    Introduce tests que simulen entradas ambiguas y fallos de herramientas. Si una nueva tool aumenta la entropía del sistema, el pipeline debe bloquear el cambio hasta ajustar descripciones/schemas o introducir retrieval/state gating.

    Conclusión operativa

    El problema real del tool_use no se arregla con prompts más largos ni con nombres más creativos. Se arregla con contratos: descripciones inmutables que indiquen qué hacer y qué no hacer; schemas que validen argumentos; retrieval que reduzca la superficie de decisión; y orquestación que limite permisos por estado. En la práctica, aplicar esta disciplina reduce los errores de selección de herramientas en la mayoría de despliegues (hasta ~80% en nuestras pruebas) y convierte agentes ruidosos en sistemas previsibles y auditablemente seguros.

    Si vas a exponer nuevas herramientas a un agente, no te preguntes si el LLM “entenderá”. Pregunta primero: ¿puede automatizarse la verificación de la condición de activación y la restricción excluyente? Si la respuesta es no, no la expongas todavía. Limita opciones, mejora instrucciones y mejora tus probabilidades de tener un agente que elige bien.

    Para experimentos, plantillas y recursos relacionados con agentes y workflows, revisa Dominicode Labs. Es una extensión natural de las prácticas descritas aquí, con ejemplos aplicables a despliegues reales.

    FAQ

    ¿Por qué el LLM elige la herramienta equivocada?

    Porque hay ambigüedad: solapamiento semántico entre tools, falta de fronteras negativas o sobrecarga del contexto. Si no se reducen estas fuentes, el modelo elige por probabilidades y puede fallar.

    ¿Qué debe contener una descripción de tool?

    Cuatro campos: Propósito (una frase), Condición de activación (¿cuándo usarla? — binaria), Restricción excluyente (¿cuándo NO usarla? con alternativa) y Formato de salida (schema mínimo verificable).

    ¿Qué es Dynamic Tool Retrieval y cuándo usarlo?

    Es el patrón de embeddizar la intención y recuperar las N tools más relevantes desde una DB vectorial (RAG de herramientas). Úsalo cuando tengas más de ~10–15 tools para reducir la superficie de decisión.

    ¿Cómo aplicar validación estricta en producción?

    Define schemas concretos (fechas con format, enums, patterns), valida en back-end (ej. Zod) y devuelve errores estructurados. Bloquea ejecuciones si la validación falla.

    ¿Qué métricas debo medir primero?

    Precisión de selección (tool chosen vs. expected), retries por tipo de error y tokens gastados en reintentos. También monitorea casos de tool misuse en staging.

    ¿Cuándo no exponer una nueva tool al agente?

    Si no puedes automatizar la verificación de la condición de activación y de la restricción excluyente, no la expongas. Mejor ajusta instrucciones, schemas o añade gating por retrieval/state antes de desplegar.