Category: React

  • Cómo funcionan los hooks de React por dentro: Fiber y orden

    Cómo funcionan los hooks de React por dentro: Fiber y orden

    El PR venía con una nota: "optimización menor". Dentro, un useState movido dentro de un if, porque ese estado solo hacía falta si el usuario era admin. Tenía su lógica: para qué reservar memoria de algo que el 95% de la gente no usa.

    El lint saltó. El autor lo silenció con un // eslint-disable-next-line. Dos días después la app reventó: Rendered fewer hooks than expected.

    Entender cómo funcionan los hooks de React por dentro no es curiosidad académica: es lo que vuelve evidente esa regla. Porque "no llames hooks dentro de condicionales" la obedece todo el mundo sin saber por qué existe, y una regla que obedeces por fe acabas rompiéndola.

    No es un capricho del equipo de React. Es la consecuencia directa de dónde está guardado tu estado.

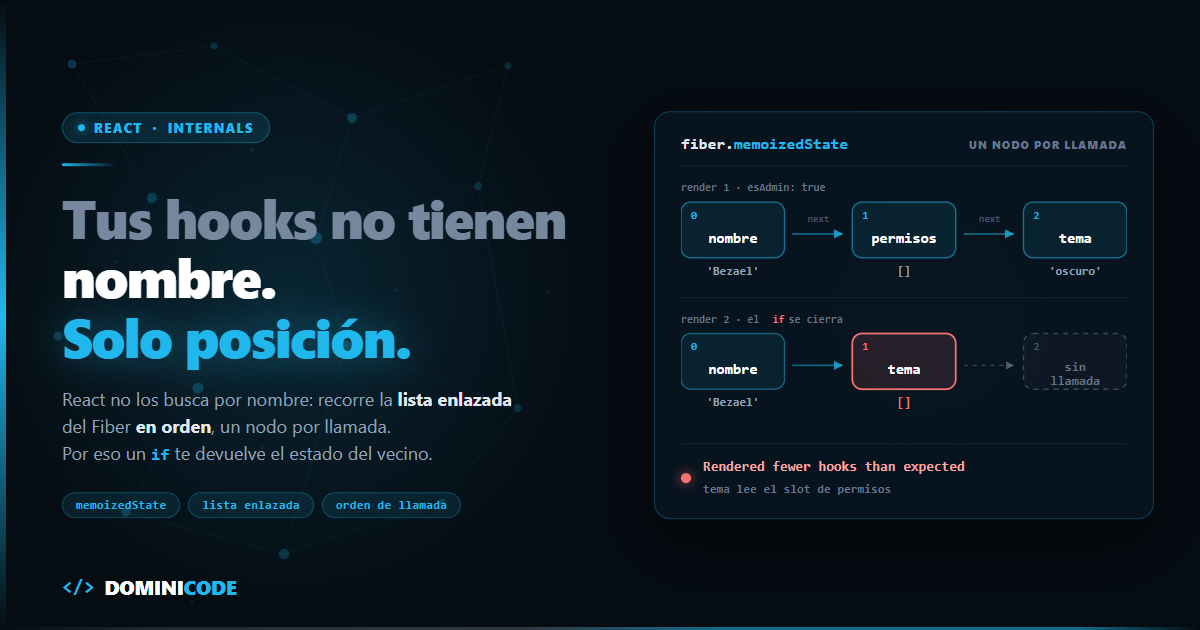
    En corto: tu estado no vive en la función del componente, vive en el nodo Fiber que React mantiene por cada instancia montada, dentro de una lista enlazada que cuelga del campo memoizedState. React no guarda el nombre de cada hook: recorre esa lista en orden, un nodo por llamada. Si el orden cambia entre renders, React entrega el estado equivocado a la llamada equivocada.


    ¿Qué es un hook de React por dentro?

    Un hook es una entrada de una lista enlazada asociada a un nodo Fiber: un objeto de cinco campos —memoizedState, baseState, baseQueue, queue y next— que React crea en el primer render y recupera por posición en todos los siguientes.

    No es una metáfora. Es el tipo literal, tal cual está en packages/react-reconciler/src/ReactFiberHooks.js:

    export type Hook = {
      memoizedState: any,
      baseState: any,
      baseQueue: Update<any, any> | null,
      queue: any,
      next: Hook | null,
    };
    

    Y en el mismo fichero, un comentario que ahorra media hora de lectura: "Hooks are stored as a linked list on the fiber's memoizedState field."

    Ojo con la trampa de nombres. En el Fiber, memoizedState apunta al primer hook de la lista. En cada Hook, memoizedState guarda el valor de ese hook concreto. Mismo nombre, dos niveles distintos.

    Un Fiber es el objeto que React mantiene por cada elemento del árbol —componente, nodo del DOM o fragmento— y que guarda su estado, el trabajo pendiente y su posición en el árbol; React 16 lo introdujo en 2017 para poder pausar, abandonar y reanudar el renderizado. Con su puntero alternate al Fiber del render anterior, es lo que sobrevive entre renders. Tu componente solo se ejecuta y muere.

    Por qué el orden de llamada de los hooks de React lo es todo

    Si React guarda los hooks en una lista y no guarda nombres, solo le queda una manera de saber cuál te toca: contar.

    La forma más rápida de que haga clic es escribir la versión de juguete. Ojo — es una simplificación pedagógica: React usa una lista enlazada por Fiber, no un array global. La identidad por posición, en cambio, funciona igual.

    // useState casero. React usa una lista enlazada por Fiber, no un array global:
    // esto es una simplificación para ver el mecanismo del orden.
    let hooks = [];
    let cursor = 0;
    
    function useState(initialValue) {
      const index = cursor; // esta llamada se queda con esta posición
      cursor++;             // la siguiente cogerá la siguiente
    
      if (!(index in hooks)) {
        hooks[index] = initialValue; // primer render: monta
      }
    
      const setState = (next) => {
        // igual que basicStateReducer en React: si es función, la aplica
        hooks[index] = typeof next === 'function' ? next(hooks[index]) : next;
        render();
      };
    
      return [hooks[index], setState];
    }
    
    function render() {
      cursor = 0;  // el cursor vuelve a cero al empezar cada render
      Component(); // tu componente: React lo vuelve a ejecutar
    }
    

    La línea que importa es cursor = 0: el array persiste, el cursor se reinicia. La identidad de cada hook es su posición en la secuencia de llamadas.

    Ahora mete un condicional en medio:

    function Perfil({ esAdmin }) {
      const [nombre, setNombre] = useState('Bezael');   // índice 0
    
      if (esAdmin) {
        const [permisos] = useState([]);                // índice 1 ... a veces
      }
    
      const [tema, setTema] = useState('oscuro');       // índice 1 o 2, según el día
    }
    

    Primer render con esAdmin: true: se montan tres hooks. nombre en 0, permisos en 1, tema en 2.

    El usuario pierde el rol. Segundo render con esAdmin: false: solo hay dos llamadas, así que tema lee el índice 1 — donde estaba permisos. Durante ese render tu string 'oscuro' es un array vacío, y al terminar el componente React ve que sobraba un hook en la lista y revienta con Rendered fewer hooks than expected: el error del PR de arriba.

    El caso caro es el que no altera el conteo — un if/else con un useState en cada rama. Mismo número de llamadas, ningún error, valor equivocado. React no puede echar en falta lo que no falta.

    Las comprobaciones que sí tiene viven en la propia lista. En updateWorkInProgressHook, si pides un hook que no existía antes:

    throw new Error('Rendered more hooks than during the previous render.');
    

    Y al terminar el render, si faltan hooks respecto a la lista previa, salta el otro: "Rendered fewer hooks than expected. This may be caused by an accidental early return statement." En desarrollo hay además un aviso que compara la secuencia hook a hook: "React has detected a change in the order of Hooks called by…".

    Los tres mensajes que vas a ver, y qué significa cada uno:

    Mensaje Cuándo salta Qué lo causó Dónde vive
    Rendered more hooks than during the previous render. Durante el render Este render pide un hook que el anterior no tenía: el if se abrió updateWorkInProgressHook
    Rendered fewer hooks than expected. This may be caused by an accidental early return statement. Al terminar el render Faltan llamadas respecto a la lista previa: un return temprano o un if que se cerró finishRenderingHooks
    React has detected a change in the order of Hooks called by... Solo en __DEV__ Mismo número de hooks, distinto orden: compara la secuencia hook a hook aviso de desarrollo
    (ninguno) Nunca El caso peligroso: el tipo de hook coincide y el valor se corrompe en silencio —

    Esa última fila es la que importa. Los tres errores son el caso amable.

    No fue un accidente que luego hubo que justificar: fue una decisión discutida en público. El RFC de Hooks lo abrió Sebastian Markbåge en octubre de 2018, y Dan Abramov dedicó un artículo entero a las alternativas descartadas, Why Do React Hooks Rely on Call Order? (13 de diciembre de 2018). Sobre identificar hooks por nombre en vez de por posición, escribió:

    "With this proposal, any time you add a new state variable inside a custom Hook, you risk breaking any components that use it (directly or transitively) because they might already use the same name for their own state variables."

    Y sobre por qué tampoco compensaba arreglarlo con más lint: "But if we have to lint anyway, what problem did we solve?".

    Ese es el trueque: React se traga una regla incómoda a cambio de que los custom hooks compongan sin colisiones de nombres.

    Mount y update son dos funciones distintas

    Segunda pieza: useState no es una función. Son dos.

    React no importa useState desde el reconciler. Lo lee de un dispatcher, un objeto que apunta a una implementación u otra según el momento. La línea vive en renderWithHooks, la función que envuelve la ejecución de tu componente:

    ReactSharedInternals.H =
      current === null || current.memoizedState === null
        ? HooksDispatcherOnMount
        : HooksDispatcherOnUpdate;
    

    mountState crea el nodo: reserva el hook, guarda el valor inicial en memoizedState y baseState, monta la cola y ata el dispatch. Ahí está, de paso, por qué el lazy initializer se ejecuta una sola vez: el typeof initialState === 'function' vive dentro de mountStateImpl, y a esa rama no vuelves nunca. updateState no crea nada: recupera el hook por posición y calcula el valor procesando su cola con basicStateReducer.

    El montaje son estas líneas:

    function mountWorkInProgressHook(): Hook {
      const hook: Hook = {
        memoizedState: null, baseState: null,
        baseQueue: null, queue: null, next: null,
      };
    
      if (workInProgressHook === null) {
        // This is the first hook in the list
        currentlyRenderingFiber.memoizedState = workInProgressHook = hook;
      } else {
        // Append to the end of the list
        workInProgressHook = workInProgressHook.next = hook;
      }
      return workInProgressHook;
    }
    

    Hay más dispatchers. Uno es ContextOnlyDispatcher: el famoso "Invalid hook call" no es una comprobación mágica, es que el puntero apunta a un objeto cuyos métodos, salvo use y readContext, solo saben lanzar errores.

    Colas de actualización y comparación de dependencias

    Cuando llamas a setState no pasa casi nada: React crea un objeto Update, lo mete en una cola circular colgada de hook.queue.pending y programa trabajo. El valor nuevo se calcula durante el render.

    Pero hay un atajo que explica un comportamiento confuso. En dispatchSetStateInternal, si la cola está vacía React calcula el estado siguiente antes de renderizar y compara:

    const eagerState = lastRenderedReducer(currentState, action);
    update.hasEagerState = true;
    update.eagerState = eagerState;
    if (is(eagerState, currentState)) {
      // Fast path. We can bail out without scheduling React to re-render.
      enqueueConcurrentHookUpdateAndEagerlyBailout(fiber, queue, update);
      return false;
    }
    

    Por eso setCount(count) con el mismo valor no siempre provoca un render: el atajo solo aplica si la cola estaba vacía. Si ya había algo pendiente, React renderiza igual. Y aun cuando el atajo entra, la documentación avisa de que React puede necesitar ejecutar tu componente una vez antes de saltarse a los hijos.

    La comparación de dependencias de useEffect, useMemo y useCallback es aún más simple. areHookInputsEqual recorre el array posición a posición:

    for (let i = 0; i < prevDeps.length && i < nextDeps.length; i++) {
      if (is(nextDeps[i], prevDeps[i])) {
        continue;
      }
      return false;
    }
    return true;
    

    Ese is viene de shared/objectIs, que es Object.is. Superficial, elemento a elemento, sin recursión. Un objeto literal nuevo en cada render nunca pasa el test, porque Object.is({}, {}) es false. Ahí está la causa de casi todos los "mi efecto se dispara en bucle": un objeto o un array creado en el cuerpo del componente y metido tal cual en el array de dependencias.

    Y ojo con la salida fácil: validar ese objeto tampoco lo estabiliza — cada parse devuelve una referencia nueva. Lo que estabiliza es depender de primitivas (user.id, no user), y para eso necesitas tener escrito el contrato de esos datos: es lo que trabajo en el curso de Zod.

    El stale closure: el bug que no es un bug

    Un stale closure es una función que sobrevive al render en el que nació y sigue leyendo las props y el estado de aquella ejecución concreta, no los actuales. Con el modelo mental montado, el clásico se explica solo:

    function Contador() {
      const [count, setCount] = useState(0);
    
      useEffect(() => {
        const id = setInterval(() => {
          console.log(count);  // siempre 0
          setCount(count + 1); // siempre 0 + 1
        }, 1000);
        return () => clearInterval(id);
      }, []); // el array vacío congela el render nº 1
    }
    

    La callback capturó el count del primer render. No es una referencia a "el estado": es una constante de aquella ejecución de la función. El Fiber avanza; esa closure no.

    No es una rareza, es un roce de diseño que la comunidad llevó al repositorio. En el issue "Design decision: why do we need the stale closure problem in the first place?", abierto por Sébastien Lorber en septiembre de 2019, el argumento era este:

    "Coupling the dependencies of the closure and the conditions to trigger effect re-execution does not make much sense to me."

    Tardó años, pero React acabó dándole parte de razón. Las tres salidas, de más vieja a más nueva:

    1. Updater funcional: setCount(c => c + 1). React aplica tu función sobre el estado real durante el render, no sobre la copia congelada.
    2. Ref: guardas el valor en un useRef y lees ref.current dentro del intervalo.
    3. useEffectEvent, estable desde React 19.2: saca del efecto la parte que lee lo último, sin que ese valor entre en las dependencias.

    useState, useRef y useMemo: la misma caja, distinto contrato

    Los tres guardan cosas en hook.memoizedState. Lo que cambia es qué guardan y quién avisa a React.

    Qué hay en hook.memoizedState Cuándo cambia ¿Provoca render? Límite / riesgo real
    useState El valor y una queue con pending, lastRenderedReducer y lastRenderedState Al procesar la cola durante el render Sí — dispatchSetState programa trabajo Lees un snapshot del render actual, no "el estado ahora". Origen de casi todos los stale closures
    useRef El objeto {current: initialValue}, creado una vez y devuelto siempre Cuando mutas .current, al instante No — React ni se entera Si la UI depende de ese valor, no se repinta. Leerlo en el render rompe la pureza
    useMemo La tupla [valor, deps] Si areHookInputsEqual da false No Es una pista, no una garantía: React puede descartar el cache
    useCallback La tupla [callback, deps] Igual que useMemo No Estabiliza la referencia, no el contenido: sigue capturando los valores de su render

    useRef y useState son la misma caja con distinto contrato frente al render. Y la última columna es la que más cuesta: memorizar no es gratis. mountMemo guarda un array por hook y updateMemo recorre las dependencias en cada render. Si el cálculo cuesta menos que comparar sus dependencias, useMemo te hace la app más lenta y más difícil de leer.

    Los custom hooks de React no tienen magia

    Un custom hook es una función que llama a hooks. Punto. No hay registro, no hay instancia, no hay contexto propio.

    function useUsuario(id) {
      const [datos, setDatos] = useState(null);   // ocupa la siguiente posición libre
      const [cargando, setCargando] = useState(true);
      useEffect(() => { /* ... */ }, [id]);
      return { datos, cargando };
    }
    

    Esos tres hooks se insertan en la lista del componente que llama, en el punto exacto de la secuencia donde estaba la llamada. El cursor no distingue entre "hooks míos" y "hooks del custom hook". Por eso componen sin colisiones: las llamadas a función forman un árbol, y un árbol se recorre en orden.

    Y por eso la regla sube hacia arriba: si metes un if dentro de un custom hook, rompes el orden de todos los componentes que lo usan aunque su código se vea impecable. Para la parte de tipos, lo desmonté aparte en cómo tipar props, hooks y contextos en TypeScript.

    Render y commit: dos fases, y solo una toca el DOM

    La fase de render ejecuta tu función, recorre la lista de hooks y calcula el árbol nuevo. Es interrumpible: React puede empezarla, abandonarla y rehacerla con otra prioridad. Por eso tu componente tiene que ser puro — si escribes en una variable externa durante el render, esa escritura puede ocurrir dos veces o ninguna. Strict Mode ejecuta tu componente dos veces en desarrollo —y monta, desmonta y vuelve a montar los efectos— a propósito para sacar a la luz ese tipo de bug. La fase de commit aplica los cambios al DOM y ejecuta los efectos, y esa no se interrumpe.

    El batching vive entre las dos. Desde React 18, con createRoot, React agrupa todas las actualizaciones antes de renderizar vengan de donde vengan. Dan Abramov lo dejó escrito en la discusión del Working Group de React 18:

    "Until React 18, we only batched updates during the React event handlers. Updates inside of promises, setTimeout, native event handlers, or any other event were not batched in React by default."

    Tres setState dentro de un fetch().then() daban tres renders en React 17. Hoy dan uno. Cómo se coloca ese trabajo en la cola del navegador está en cómo los microtasks afectan a la renderización.

    Contrástalo con el otro modelo mental del frontend actual: un signal guarda el valor en el propio objeto y notifica a quien lo lee; un hook lo guarda en el Fiber y obliga a reejecutar el componente entero. Comparé ambos en cómo funcionan los Signals en Angular 22 y React 19, y esa reactividad granular llevada a producción es la base del curso de Angular Moderno.

    Lo que este modelo mental NO te resuelve

    Es un detalle de implementación, y cambia. Nada de lo que has leído es API pública. Campos como baseQueue, lanes o revertLane llegaron con el modo concurrente y se han movido de sitio más de una vez. Sirve para razonar y depurar; no escribas código que dependa de ello.

    Saber los internals no arregla un useEffect mal planteado. Entender areHookInputsEqual te dice por qué tu efecto se dispara en bucle. No te dice que ese efecto no debería existir. La mayoría de los que reviso son estado derivado que debería calcularse en el render. El array de dependencias es el síntoma, no la enfermedad.

    El React Compiler cambia parte del cálculo. Desde la versión 1.0 estable, del 7 de octubre de 2025, el compilador inserta la memoización en tiempo de build y tu intuición sobre "cuándo compensa un useMemo" deja de aplicarse igual. Ojo con el entusiasmo: la guía oficial recomienda "leaving existing memoization in place (removing it can change compilation output)". El orden de llamada, en cambio, no lo toca — se apoya en él, porque necesita que cumplas las reglas para poder optimizar.

    Qué hacer con esto hoy

    Abre el componente más grande que tengas y cuenta sus hooks. Luego, hook a hook: ¿este valor necesita provocar un render, o me vale un useRef? ¿Este useMemo cuesta más que comparar sus dependencias? ¿Este efecto lee algo del pasado sin darse cuenta? Veinte minutos, y te va a quitar código.

    La próxima vez que alguien proponga meter un hook dentro de un if "porque tiene sentido", ya no tienes que apelar a la autoridad del lint. Le enseñas el cursor y se acabó la discusión.

    Publico desmontajes así cada semana en el canal de YouTube, y el material largo con proyectos completos vive en Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué no puedo llamar a un hook dentro de un if?

    Porque React no identifica los hooks por su nombre, sino por su posición en la secuencia de llamadas. Los guarda en una lista enlazada colgada del campo memoizedState del Fiber y la recorre en orden en cada render.

    Si un condicional hace que una llamada aparezca en un render y no en el siguiente, las posiciones posteriores se desplazan y cada hook recibe el estado del de al lado. React lanza "Rendered more hooks than during the previous render" o "Rendered fewer hooks than expected" en parte de estos casos, pero no en todos: algunos te corrompen el valor en silencio.

    ¿Dónde guarda React el estado de useState exactamente?

    En el nodo Fiber del componente, no en la función. Cada Fiber tiene un campo memoizedState que apunta al primer hook de una lista enlazada, y cada hook es un objeto con los campos memoizedState, baseState, baseQueue, queue y next.

    El valor actual de tu useState vive en el memoizedState de su hook; las actualizaciones pendientes, en una cola circular dentro de queue.pending.

    ¿Qué es un stale closure en React y cómo lo evito?

    Es una función que sobrevive a su render y sigue viendo los valores de props y estado del momento en que se creó. El caso típico es un setInterval dentro de un useEffect con dependencias vacías: la callback capturó el estado del primer render y no lo ve cambiar nunca.

    Tienes tres salidas: la forma funcional de actualizar (setCount(c => c + 1)), un useRef cuyo .current mantienes al día, o useEffectEvent, estable desde React 19.2.

    ¿Cuál es la diferencia real entre useRef y useState?

    La misma caja con distinto contrato. useState guarda el valor y una cola de actualizaciones, y llamar a su setter programa un render. useRef guarda un objeto { current: valor } que React crea una sola vez y devuelve idéntico en todos los renders: mutar .current es instantáneo y React ni se entera.

    Usa useRef para lo que no debe repintar la pantalla y useState para lo que la UI tiene que reflejar.

    ¿Qué es React Fiber?

    Es la arquitectura interna del reconciliador de React desde la versión 16 (2017). Cada elemento del árbol —componente, nodo del DOM, fragmento— tiene su propio objeto Fiber que guarda su estado, el trabajo pendiente y sus punteros al resto del árbol.

    Su razón de ser es que el renderizado se pueda interrumpir: React puede empezar a construir un árbol, abandonarlo a medias y rehacerlo con otra prioridad. El campo memoizedState de cada Fiber es donde cuelga la lista enlazada de hooks de ese componente.

    ¿Por qué mi useEffect se ejecuta en bucle infinito?

    Casi siempre porque una de sus dependencias es un objeto, un array o una función que creas en el cuerpo del componente. React compara las dependencias con areHookInputsEqual, que recorre el array posición a posición usando Object.is: superficial, sin recursión.

    Object.is({}, {}) es false, así que un literal nuevo en cada render nunca pasa el test, el efecto vuelve a ejecutarse, cambia el estado, provoca otro render y vuelta a empezar. Saca el valor fuera del componente, memorízalo, o pregúntate si ese efecto debería existir.

    ¿Qué significa el error "Invalid hook call"?

    Que llamaste a un hook cuando el dispatcher activo era ContextOnlyDispatcher: un objeto cuyos métodos, salvo use y readContext, solo saben lanzar ese error. No hay detección mágica, hay un puntero apuntando al sitio equivocado.

    Pasa en tres situaciones: llamar al hook fuera de un componente o custom hook, tener dos copias de React en el árbol de dependencias, o una desincronización entre react y react-dom.

    ¿Puedo confiar en estos internals para escribir código?

    No. Nada de esto es API pública y el reconciler se reescribe cada pocas versiones: para escribir código, la fuente sigue siendo la documentación oficial y el plugin de ESLint.

    El valor de conocer los internals es otro: depurar más rápido, entender los mensajes de error y dejar de obedecer las reglas por fe.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • React 19.3: la release para borrar código, no para escribirlo

    React 19.3: la release para borrar código, no para escribirlo

    Hace un mes revisé el repo de un cliente. Una app de e-commerce, React, tres años de vida, gente competente detrás.

    Busqué isMounted en el proyecto. Diecinueve resultados. Busqué wrapperRef. Once. Y en el package.json, una librería de animación de 40 KB que solo se usaba para hacer un fade entre dos pantallas.

    Ninguna de las tres es un error. Son workarounds: código que existe porque React no daba la primitiva y alguien lo resolvió con lo que había.

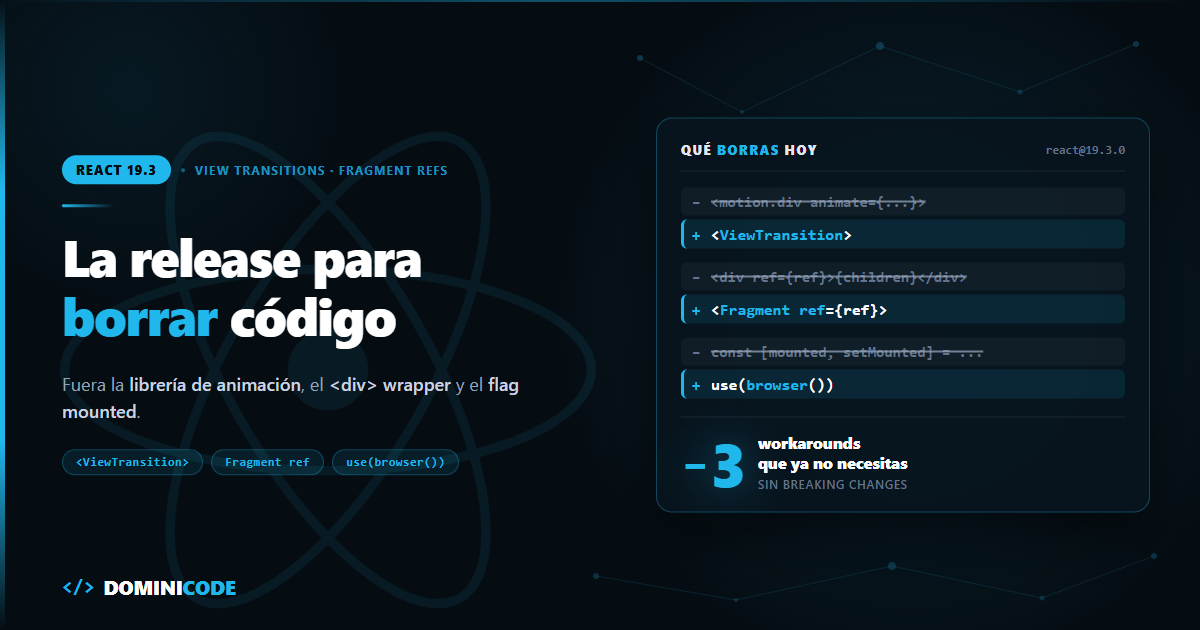
    React 19.3 salió estable en npm el 9 de septiembre de 2026 y es, sobre todo, una release para borrar ese tipo de código. El problema de un workaround es que se queda para siempre, y cada dev nuevo del equipo asume que así es como se hace.

    No trae un paradigma nuevo. Trae dos APIs que salen de experimental —View Transitions y Fragment Refs—, una nueva, browser(), y un ajuste en Server Components. Cada una sustituye un apaño concreto que llevas años arrastrando. Vamos una por una, con lo que se borra en cada caso.

    En resumen: React 19.3 (react@19.3.0 y react-dom@19.3.0, publicados en npm el 9 de septiembre de 2026) estabiliza View Transitions y Fragment Refs, estrena browser() en react-dom, permite renderizar un Context directamente desde un Server Component y mejora el soporte de Trusted Types. No documenta ningún breaking change.

    Cambio Estado en 19.3 Se importa de Qué código elimina
    <ViewTransition> Estable (era experimental) react Librería de animación para transiciones de página y enter/exit de listas
    addTransitionType() Nueva react Estado de dirección pasado por props hasta el componente animado
    Fragment con ref Estable (era experimental) react El <div> wrapper que solo existía para colgar un ref, y el cloneElement
    browser() Nueva react-dom El trío useState + useEffect + flag mounted
    Context en Server Components Nuevo — El componente 'use client' que solo renderizaba el Provider
    Trusted Types Nuevo react-dom Sanitizado manual de TrustedHTML / TrustedScript

    View Transitions en React 19.3: borra la librería de animación

    <ViewTransition> ya no es experimental. Se importa de react y envuelve el trozo del árbol que quieres animar.

    import { ViewTransition, useState, startTransition } from 'react';
    
    export default function Component() {
      const [showItem, setShowItem] = useState(false);
      return (
        <>
          <button onClick={() => { startTransition(() => { setShowItem(prev => !prev); }); }}>
            {showItem ? '➖' : '➕'}
          </button>
          {showItem && (
            <ViewTransition>
              <Video video={videos[0]} />
            </ViewTransition>
          )}
        </>
      );
    }
    

    No hay animate, no hay variants, no hay AnimatePresence. Envuelves y ya. Por debajo React se apoya en la View Transition API del navegador.

    Hay cuatro formas de activarlo, según lo que pase en el árbol:

    • enter — se añade un ViewTransition al árbol.
    • exit — se elimina.
    • update — cambian sus hijos, sea contenido o style.
    • share — un ViewTransition con nombre desaparece en un sitio y aparece en otro.

    Cada tipo tiene su prop del mismo nombre —enter, exit, update, share— y su event prop: onEnter, onExit, onUpdate, onShare. Y existe además default, que fija la animación de los tipos que no declares: es lo que te permite apagarlos todos de golpe con default="none".

    Y ahora la regla que te va a costar media hora si no la lees: un setState normal no dispara la animación. Solo se activa dentro de una Transition: startTransition, useTransition, useDeferredValue o una navegación de Suspense.

    No es un detalle de implementación, es la decisión de diseño central: React no anima por si acaso, anima cuando tú marcas el cambio como transición. Si tu <ViewTransition> no hace nada, mira el setState antes que el CSS.

    Segundo detalle: la direccionalidad. El caso clásico —un carrusel que debe animar distinto según vayas hacia delante o hacia atrás— se resuelve con addTransitionType, otra función nueva de react:

    import { addTransitionType, startTransition } from 'react';
    
    function nextSlide() {
      startTransition(() => {
        addTransitionType('next');
        setCurrentSlide(c => c + 1);
      });
    }
    

    Etiquetas la transición y luego la consumes en CSS con :active-view-transition-type(next), o mapeas tipo → animación directamente en el componente:

    <ViewTransition
      enter={{ 'next': 'from-right', 'previous': 'from-left' }}
      exit={{ 'next': 'to-left', 'previous': 'to-right' }}
    >
      <Page />
    </ViewTransition>
    

    Ese mapa { tipo: animación } sustituye al estado de dirección que antes mantenías, pasabas por props hasta el componente animado y traducías a variants. Ahora vive donde ocurre la navegación.

    Y cuando dentro hay un Suspense, la doc recomienda animar solo el cambio de fallback a contenido y no todo lo que se mueva por debajo:

    <ViewTransition update="auto" default="none">
      <Suspense fallback={<Fallback />}>
        <Component />
      </Suspense>
    </ViewTransition>
    

    Qué borras: las transiciones de página y los enter/exit de listas y modales. Ojo, no digo que desinstales tu librería de animación mañana: los gestos, los drags, los springs físicos y las animaciones interrumpibles siguen siendo territorio de Framer Motion o GSAP. Pero si la instalaste para hacer un fade entre rutas —que es la mayoría de los casos que veo en revisiones— ya no la necesitas.


    Fragment Refs en React 19.3: un ref sin el <div> wrapper

    Fragment Refs permiten pasar un ref a un <Fragment> y recibir un FragmentInstance que opera sobre los hijos de primer nivel sin añadir ningún nodo al DOM. Son estables desde React 19.3.

    Es el cambio más pequeño de la release y probablemente el que más veces al mes te va a ahorrar un mal rato.

    Fragment ahora acepta ref. Te devuelve un FragmentInstance que opera sobre los hijos de primer nivel, sin meter un nodo extra en el DOM.

    Los métodos disponibles son estos:

    Categoría Métodos
    Eventos addEventListener, removeEventListener, dispatchEvent
    Foco focus() (en profundidad, depth-first), focusLast(), blur()
    Observers observeUsing(observer), unobserveUsing(observer)
    Layout y DOM getClientRects(), getRootNode(), compareDocumentPosition(otherNode), scrollIntoView(options)

    Un componente InView que antes exigía envolver los hijos en un div —con el consiguiente estropicio si el padre era un grid o un flex— ahora se escribe así:

    import { Fragment, useRef, useLayoutEffect } from 'react';
    
    export default function InView({ onChange, children }) {
      const fragmentRef = useRef(null);
    
      useLayoutEffect(() => {
        const visibleElements = new Set();
        const observer = new IntersectionObserver((entries) => {
          entries.forEach(e => {
            if (e.isIntersecting) visibleElements.add(e.target);
            else visibleElements.delete(e.target);
          });
          onChange(visibleElements.size > 0);
        });
        const fragmentInstance = fragmentRef.current;
        fragmentInstance.observeUsing(observer);
        return () => { fragmentInstance.unobserveUsing(observer); };
      }, [onChange]);
    
      return <Fragment ref={fragmentRef}>{children}</Fragment>;
    }
    

    Fíjate en observeUsing: le pasas el observer y él se encarga de suscribir a cada hijo. No iteras children, no clonas elementos, no pides refs a los hijos.

    Para accesibilidad, mover el foco al primer elemento enfocable de un grupo se queda en dos líneas:

    import { Fragment, useRef, useEffect } from 'react';
    
    function Component() {
      const fragmentRef = useRef(null);
    
      useEffect(() => {
        const fragmentInstance = fragmentRef.current;
        fragmentInstance.focus();
      }, []);
    
      return (
        <Fragment ref={fragmentRef}>
          {posts.map(post => (
            <Heading key={post.id}>{post.title}</Heading>
          ))}
        </Fragment>
      );
    }
    

    Qué borras: los wrappers de layout que no pintan nada y el cloneElement con ref que usabas para llegar a los hijos. Es el mismo tipo de deuda que genera el props drilling en React: estructura que existe para transportar algo, no para representar nada.


    use(browser()) en React 19.3: borra el flag mounted

    browser() es una función nueva de react-dom que, consumida con use(browser()), suspende en el servidor y no suspende en el cliente: marca un componente como client-only sin useState ni useEffect.

    Es el cambio más discreto de la release y el que más código muerto elimina en una app con SSR.

    El patrón que todos hemos escrito mil veces: un componente necesita window, Intl, localStorage o cualquier cosa que solo existe en el navegador, así que montas el ritual de useState(false) + useEffect(() => setMounted(true), []) + if (!mounted) return null.

    React 19.3 mete browser() en react-dom. Se consume con use() y su comportamiento cabe en una línea: suspende en el servidor y no suspende en el cliente.

    import { Suspense, use } from 'react';
    import { browser } from 'react-dom';
    
    function TimeZone() {
      use(browser());
      const timeZone = new Intl.DateTimeFormat().resolvedOptions().timeZone;
      return <p>{timeZone}</p>;
    }
    
    export default function App() {
      return (
        <>
          <p>Your current time zone is:</p>
          <Suspense fallback="Loading...">
            <TimeZone />
          </Suspense>
        </>
      );
    }
    

    Tres líneas de estado sustituidas por una. Y el fallback deja de ser null para pasar a ser un Suspense de verdad, que es lo que debería haber sido siempre.

    Además se puede llamar condicionalmente, cosa que no es habitual en las APIs de React:

    function TimeZone({ defaultValue }) {
      if (defaultValue) return <p>{defaultValue}</p>;
      use(browser());
      const localTimeZone = new Intl.DateTimeFormat().resolvedOptions().timeZone;
      return <p>{localTimeZone}</p>;
    }
    

    Y dentro de tus propios hooks, que es donde se pone interesante:

    function useBrowserQuery(query, options) {
      if (options.initialData === undefined) use(browser());
      return useQuery(query, options);
    }
    

    Ahí acabas de mover una decisión de renderizado —"esto solo puede resolverse en cliente"— del componente a la capa de datos. El componente ya no sabe nada del entorno.

    Requisito: necesitas un Suspense por encima. Sin él no funciona. Si todavía tratas Suspense como un spinner y no como una herramienta de orquestación, aquí lo desarrollo: fetching paralelo en Next.js con Suspense y Promise.all.


    Context en Server Components: borra el Provider intermedio

    Desde React 19.3, un Server Component puede importar un Context definido en un módulo 'use client' y renderizarlo directamente, sin un componente Provider intermedio.

    Si trabajas con RSC conoces el peaje. Para pasar datos del servidor al árbol de cliente había que crear un componente 'use client' cuya única razón de existir era renderizar el Provider:

    // user-context.js  ('use client')
    export const UserContext = createContext(null);
    export function UserProvider({ currentUser, children }) {
      return <UserContext value={currentUser}>{children}</UserContext>;
    }
    
    // server-component.js
    import { UserProvider } from './user-context';
    export async function Layout({ children }) {
      const currentUser = await getCurrentUser();
      return <UserProvider currentUser={currentUser}>{children}</UserProvider>;
    }
    

    Ahora el Server Component importa el Context directamente de su módulo 'use client' y lo renderiza:

    // user-context.js  ('use client')
    export const UserContext = createContext(null);
    
    // server-component.js
    import { UserContext } from './user-context';
    export async function Layout({ children }) {
      const currentUser = await getCurrentUser();
      return <UserContext value={currentUser}>{children}</UserContext>;
    }
    

    Un fichero menos y, sobre todo, una capa de indirección menos. Si estás montando esto en producción, escribí sobre las decisiones reales de React Server Components que hay detrás de esa frontera server/client: este cambio elimina uno de los puntos de fricción que mencionaba allí.


    Otros cambios de React 19.3: Trusted Types, rendimiento y renombrados

    Tres cosas más que no dan para post pero que conviene saber.

    Trusted Types. React ya no coerciona a string los valores TrustedHTML, TrustedScript y TrustedScriptURL: los pasa tal cual para que el navegador valide la política. Si sirves con Content-Security-Policy: require-trusted-types-for 'script', esto cierra una vía de XSS basado en DOM que antes tenías que tapar tú.

    Rendimiento. Dos cambios, sin cifras publicadas y sin que yo me las invente: las Transitions se renderizan de forma independiente en vez de enredarse en un único render, así que una Transition lenta ya no bloquea a otras que no tienen nada que ver; y las actualizaciones que vienen de eventos de resize se agrupan hasta el siguiente frame. Si tu app tiene layout reactivo al viewport, lo notarás sin tocar nada.

    Renombrados y fixes. useActionState pasa a hablar de "action state" en vez de "form state". Y hay arreglos que probablemente expliquen algún bug que archivaste como "cosas raras": useDeferredValue quedándose con el valor viejo, useSyncExternalStore perdiendo mutaciones, useEffectEvent roto dentro de forwardRef y memo, y la propagación de context en los fallbacks de Suspense.


    ¿Merece la pena actualizar a React 19.3 hoy?

    La nota de release oficial de React 19.3 no documenta ningún breaking change. La instalación es esta:

    npm install react@19.3 react-dom@19.3
    

    Aviso para quien llegue desde los sandboxes de la doc: ahí verás versiones 19.3.0-canary-*. Esas son del entorno de la documentación, no la instrucción de instalación. La estable es 19.3.0.

    Mi recomendación: actualiza y no migres nada todavía. Primero mide cuánto código muerto tienes. Es un ejercicio de veinte minutos y te da la lista de la compra.

    Yo lo hago con un agente: le pido a Claude Code que barra el repo buscando los tres patrones —flags de mounted, wrappers que solo existen para un ref y animaciones de ruta hechas con librería— y que me devuelva un inventario con ubicación y coste, no un PR. Que el agente haga el inventario y la decisión la tomes tú es justo lo que enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si además sigues el ecosistema Angular, merece la pena comparar cómo resuelve cada framework lo mismo. Lo desarrollé en el post sobre Signals en Angular 22 frente a React 19. React 19.3 refuerza esa dirección: el modelo de reactividad no se toca, lo que mejora es qué puedes expresar sin escribir infraestructura.


    Por dónde empezar a migrar a React 19.3

    Abre tu proyecto y busca mounted. Solo eso.

    Cada resultado es un componente que tarda un render extra en aparecer, que probablemente hace flash en producción y que existe porque React no tenía forma de decir "esto es client-only". Ahora la tiene. Ese es el mejor punto de entrada a React 19.3 porque el cambio es local, no rompe nada y se ve en el primer render.

    Cuando termines con esos, ve a por los <div> wrapper. Y deja las transiciones de página para el final, que son las más divertidas y las que más tiempo te van a comer.

    En Dominicode Labs estamos probando estas APIs sobre proyectos reales y compartiendo lo que funciona y lo que no. Y si prefieres verlo en vídeo, lo iré contando en el canal de Dominicode a medida que lo lleve a producción.


    Preguntas frecuentes sobre React 19.3

    ¿React 19.3 rompe algo si actualizo desde 19.2?

    La nota de release de React 19.3 no documenta ningún breaking change. La actualización es npm install react@19.3 react-dom@19.3 y las APIs nuevas son aditivas: ViewTransition y addTransitionType no estaban en la API estable —vivían en los builds experimentales—, browser() es nueva, y que Fragment acepte ref no cambia el comportamiento de los Fragment que ya tienes. Aun así, actualiza en una rama y pasa tu suite de tests: la release incluye arreglos en useDeferredValue, useSyncExternalStore y useEffectEvent, y si tu código dependía sin saberlo del comportamiento defectuoso, ahí es donde lo vas a notar.

    ¿Por qué mi ViewTransition no anima nada?

    Casi siempre por lo mismo: el cambio de estado no está dentro de una Transition. <ViewTransition> solo se activa con startTransition, useTransition, useDeferredValue o una navegación de Suspense. Un setState normal actualiza el DOM sin animar. Antes de tocar el CSS, comprueba que el setState que provoca el cambio está envuelto en una Transition.

    ¿Puedo usar View Transitions de React 19.3 con Next.js o React Router?

    Sí, porque <ViewTransition> es un componente de react y no depende del router. La condición es que el cambio de estado ocurra dentro de una Transition, y las navegaciones de los routers modernos ya lo hacen. Lo que no obtienes automáticamente es la direccionalidad: para animar distinto hacia delante y hacia atrás tienes que llamar tú a addTransitionType('next') dentro del startTransition que dispara la navegación.

    ¿Fragment Refs sustituyen a los refs normales?

    No. Un ref normal apunta a un nodo del DOM y eso sigue siendo lo correcto cuando ese nodo existe. Fragment Refs resuelven el caso en el que necesitas operar sobre un conjunto de hijos y no hay un elemento común que los envuelva, o lo hay solo porque lo metiste tú para colgar el ref. El FragmentInstance que recibes trabaja sobre los hijos de primer nivel: registra eventos, mueve el foco con focus() y focusLast(), conecta un IntersectionObserver o un ResizeObserver con observeUsing(), mide con getClientRects() y hace scroll con scrollIntoView().

    ¿use(browser()) elimina todos los useEffect de mi app?

    No, solo un patrón concreto: el de marcar un componente como client-only. browser() se importa de react-dom, suspende en el servidor y no suspende en el cliente, así que sustituye al trío useState + useEffect + flag mounted. Necesita un Suspense por encima para funcionar. Los efectos que sincronizan con sistemas externos —suscripciones, listeners, integraciones con librerías no-React— siguen siendo useEffect.

    ¿Necesito un framework con Server Components para aprovechar React 19.3?

    Para nada. View Transitions, Fragment Refs y use(browser()) funcionan en cualquier aplicación React; browser() cobra especial sentido si haces SSR, pero no exige RSC. Lo que sí requiere una configuración con Server Components es la mejora de Context, que permite a un Server Component importar un Context definido en un módulo 'use client' y renderizarlo directamente, sin el componente Provider intermedio.

    ¿Cómo instalo React 19.3 y por qué veo versiones canary en la documentación?

    Se instala con npm install react@19.3 react-dom@19.3. Las versiones 19.3.0-canary-* que aparecen en los sandboxes interactivos de react.dev pertenecen al entorno de la propia documentación y no son la instrucción de instalación. En npm, react@19.3.0 y react-dom@19.3.0 son estables desde el 9 de septiembre de 2026.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Next.js 16.3: el 90% menos de memoria es real, pero no es tuyo

    Next.js 16.3: el 90% menos de memoria es real, pero no es tuyo

    El portátil empezó a hacer ese ruido. El del ventilador que ya no refrigera, solo pide ayuda.

    Dos horas con next dev abierto, saltando entre rutas de un checkout. 14 GB de RAM. Un servidor de desarrollo comiéndose catorce gigas.

    Maté el proceso. Lo levanté. A los diez minutos iba otra vez por seis y subiendo.

    Ese ha sido el peaje de trabajar en local durante años: cuanto más rato llevas, peor va todo, y el arreglo es reiniciar.

    Next.js 16.3 llegó estable el 3 de agosto de 2026 apuntando justo ahí. El titular que circula desde entonces: «90% menos memoria y builds 5,5× más rápidos».

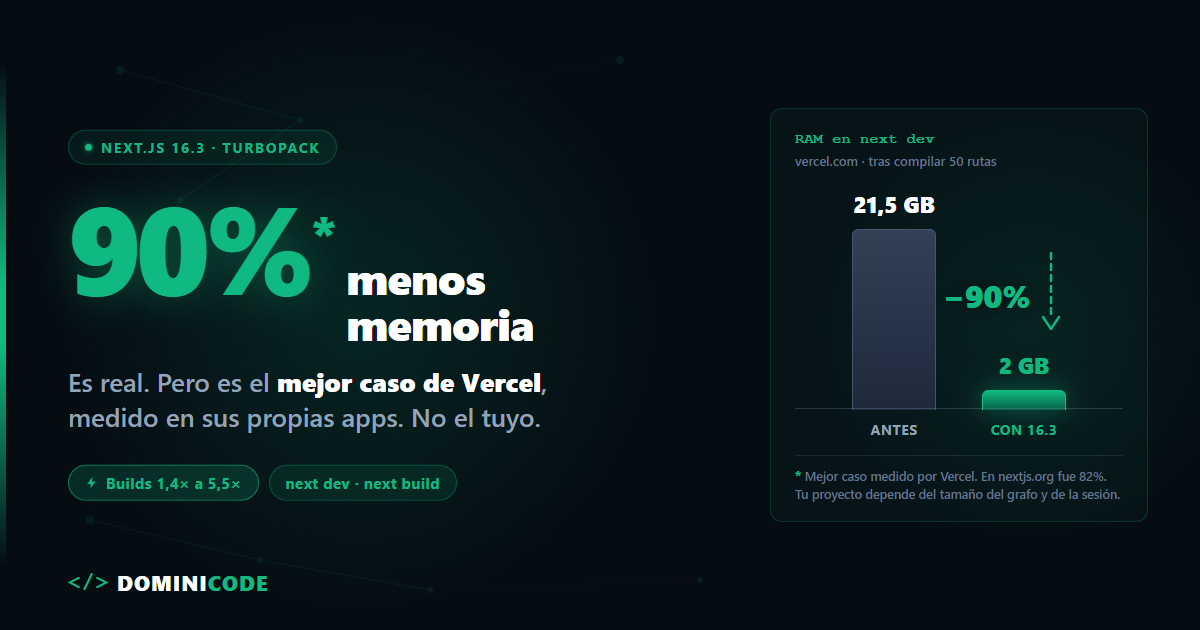
    Las dos cifras son ciertas. Y las dos son el mejor caso medido por Vercel en sus propias aplicaciones.

    La release es buena de verdad y no necesita ese titular. Lo mejor de 16.3 no es el número grande: es cuánto llega activado por defecto, sin que toques una línea de tu código.

    Qué trae Next.js 16.3 de un vistazo

    Novedad ¿Por defecto? Qué aporta
    Memory eviction en Turbopack Sí Hasta 90% menos RAM en next dev (mejor caso medido)
    Caché en disco en next build Sí Compilación de Turbopack 1,4× a 5,5× más rápida
    SSR con streams nativos de Node Sí Hasta 22% más peticiones bajo carga
    Agrupado de prefetches pequeños Sí Menos peticiones por navegación
    Type checking con TypeScript 7 Solo subir la dependencia Compilador nativo en next build
    Docs versionadas en AGENTS.md Sí El agente lee la doc de tu versión instalada
    React Compiler en Rust No — experimental 34% más rápido en frío, 46% en caliente
    Cache Components y Partial Prefetching No — opt-in Navegación instantánea

    De dónde sale el 90% menos de memoria en Turbopack

    El memory eviction es la capacidad de Turbopack de liberar de la RAM las partes del grafo de módulos que no está usando y recuperarlas del disco cuando vuelven a hacer falta. Eso es lo nuevo de 16.3.

    Funciona junto con la caché en disco para desarrollo, que llegó en 16.1. Por eso las dos van de la mano: sin caché en disco, evictar sería volver a compilar desde cero.

    Estas son las mediciones oficiales, tomadas después de compilar 50 rutas:

    Aplicación Antes Con 16.3 Reducción
    vercel.com (dashboard) 21,5 GB 2 GB ~90%
    nextjs.org 4.600 MB 840 MB ~82%

    Fíjate en la aplicación grande: partir de 21,5 GB solo es posible en una máquina de 32 o 64 GB. La mayoría de proyectos no llegan ahí ni queriendo.

    Y esto es lo que dice el propio equipo de Turbopack en su post de la release, y que casi nunca sobrevive al resumen:

    No existe un único porcentaje de reducción aplicable a todas las aplicaciones. Los resultados individuales dependen del tamaño del grafo de rutas, de cuánto se haya recorrido durante la sesión de desarrollo y de cuánto tiempo llevara la sesión ejecutándose.

    Traducido a tu día a día: si tu proyecto tiene 12 rutas y reinicias el servidor cada media hora, no vas a ver un 90%. Vas a ver una mejora modesta, porque nunca llegaste a acumular la basura que el eviction limpia.

    El 90% lo notan los monorepos con cientos de rutas y las sesiones de ocho horas sin reiniciar. Que, siendo justos, es exactamente donde dolía.

    Si algo se rompe raro, tienes la salida:

    // next.config.ts
    import type { NextConfig } from 'next'
    
    const nextConfig: NextConfig = {
      experimental: {
        // el valor por defecto es 'full'
        turbopackMemoryEviction: false,
      },
    }
    
    export default nextConfig
    

    Por qué el next build 5,5× más rápido es el mejor de tres casos medidos

    El 5,5× no es la mejora media de la release: es la mejor de las tres aplicaciones que Vercel midió.

    La caché en disco que aceleraba next dev desde 16.1 ahora funciona también en next build. Y en la versión estable viene activada por defecto — ojo si leíste el post del preview de junio, donde todavía era el flag opt-in turbopackFileSystemCacheForBuild. Cambió al estabilizar.

    Estos son los tiempos de compilación de Turbopack dentro de next build, de frío a con caché:

    Aplicación Build en frío Con caché Mejora
    nextjs.org 21 s 9,2 s ~2,3×
    vercel.com/home 66 s 46 s ~1,4×
    vercel.com/geist 30 s 5,5 s ~5,5×

    El 5,5× existe. Es la última fila. También existe el 1,4×, que es la aplicación más parecida a un proyecto real con integraciones, y es la que menos se cita.

    El rango honesto de esta release es 1,4× a 5,5×, y dónde caigas tú depende de cuánto de tu grafo cambie entre build y build. Si tocas un archivo compartido que arrastra media aplicación, la caché te sirve de poco. Si tocas una página hoja, te sirve muchísimo.

    Dos detalles antes de que alguien te enseñe la tabla en una reunión.

    La cifra es el tiempo de compilación de Turbopack, no el next build completo: sigues teniendo type checking, generación de páginas estáticas y el resto del pipeline por delante.

    Y la caché no existe en el primer build. Necesitas una ejecución previa. En local eso pasa solo. En CI, no.

    En CI la caché no aparece por arte de magia

    Cada job arranca en un contenedor limpio. Si no persistes nada, siempre estás midiendo el build en frío y esta mejora no la ves jamás.

    Lo que hay que persistir es .next/cache, que es donde Turbopack escribe su caché de build. Esta es la configuración que da la documentación oficial de CI build caching para GitHub Actions:

    - uses: actions/cache@v4
      with:
        path: |
          ~/.npm
          ${{ github.workspace }}/.next/cache
        # Genera caché nueva cuando cambian dependencias o fuentes
        key: ${{ runner.os }}-nextjs-${{ hashFiles('**/package-lock.json') }}-${{ hashFiles('**/*.js', '**/*.jsx', '**/*.ts', '**/*.tsx') }}
        # Si cambió el código pero no las dependencias, reconstruye desde una caché previa
        restore-keys: |
          ${{ runner.os }}-nextjs-${{ hashFiles('**/package-lock.json') }}-
    

    restore-keys es la línea que casi todo el mundo se deja. Sin ella solo recuperas la caché cuando la clave coincide exacta, y como la clave incluye el hash de tus fuentes, eso no pasa nunca en un commit nuevo: siempre medirías builds en frío.

    Y no caches .next entero. Ahí vive también la salida del build, que next build regenera igualmente, así que solo consigues subir y bajar cientos de megas por job y comerte antes la cuota de caché del repositorio — que expulsa entradas viejas cuando se llena. Acabas perdiendo justo la caché que querías conservar.

    El React Compiler en Rust es experimental, y la letra pequeña importa

    Han reescrito el React Compiler en Rust y lo han integrado en Turbopack. Va detrás de dos flags:

    // next.config.ts
    const nextConfig: NextConfig = {
      reactCompiler: true,
      experimental: {
        turbopackRustReactCompiler: true,
      },
    }
    

    Contra la aplicación de v0 midieron un 34% más rápido en frío y un 46% en caliente. Dos precisiones antes de que lo actives.

    La métrica es el tiempo desde que lanzas next dev hasta que la página está lista, no «tiempos de build de página». Es arranque de desarrollo, no producción.

    Y el post oficial avisa: esas ganancias asumen que has abandonado Babel por completo. Si sigues ejecutando Babel para otras transformaciones, el compilador en Rust ayuda, pero la ganancia es menor.

    Si todavía arrastras un .babelrc para i18n o para decoradores, el 46% no es tuyo. La ganancia real no es Rust: es salir de Babel. Rust solo hace que salir de Babel merezca todavía más la pena.

    Es experimental. Yo lo activaría en una rama, mediría y decidiría. No en el pipeline del viernes.

    Lo que mejora en Next.js 16.3 sin que hagas absolutamente nada

    Tres mejoras no piden ni un flag ni una línea de código. Es la parte que más me gusta de la release, y la menos vistosa.

    Type checking con TypeScript 7. next build ya soporta el compilador nativo y solo tienes que subir la dependencia con pnpm add -D typescript@^7. Sobre por qué esto cambia tanto los tiempos escribí en TypeScript 7 y el compilador en Go.

    SSR más rápido. Han sustituido las web streams por streams nativos de Node en la capa de render del App Router. Resultado: hasta un 22% más de peticiones bajo carga, cero cambios en tu código, menos overhead por request en la capa que ya usas si trabajas con React Server Components en producción.

    Documentación versionada para agentes de IA. next dev escribe y mantiene un bloque en tu AGENTS.md que apunta a los docs del node_modules del propio proyecto. Tu agente deja de inventarse APIs de la versión equivocada porque lee la documentación de la versión que tienes instalada. Vercel ha retirado sus Skills anteriores: para esto ya no hacen falta.

    Y esto importa más de lo que parece. Cuando un agente te genera código Next.js que no compila, muchas veces no es el modelo: es que aprendió de tutoriales de tres versiones atrás. Anclar el contexto a la versión instalada es la misma disciplina que aplico en Construye con IA: el agente no necesita más inteligencia, necesita mejor contexto.

    Y una cuarta que también llega sola: los prefetch por debajo de cierto tamaño se agrupan, así que tu app hace menos peticiones sin que cambies nada.

    Lo demás que trae 16.3 son APIs nuevas que sí tienes que escribir tú: catchError para error boundaries que ya no interfieren con notFound ni redirect, import.meta.glob al estilo Vite (solo con Turbopack) y root params con import { lang } from 'next/root-params' para dejar de pasar el idioma por props. Reutilizar assets estáticos inmutables entre despliegues también es opt-in, no automático.

    La otra mitad de la release

    Todo lo de arriba llega solo con actualizar. La otra mitad de 16.3 no: hay que activarla a mano y decidir dónde.

    Hablo de Cache Components, Partial Prefetching, el Navigation Inspector y el helper instant() de Playwright. Se activa con dos flags:

    // next.config.ts
    const nextConfig: NextConfig = {
      cacheComponents: true,
      partialPrefetching: true,
    }
    

    Lo cubrí cuando la versión estaba en preview, en cómo conseguir navegaciones instantáneas con Cache Components. Ese es el siguiente paso.

    Qué hacer hoy

    Actualizar es un minor sin cambios de API:

    npm install next@latest
    

    Pero antes, haz lo que casi nadie hace: mide.

    Anota cuánta RAM consume tu next dev tras una hora de trabajo normal y cuánto tarda tu next build en CI. Dos números en una nota. Actualiza, trabaja una semana y vuelve a mirarlos.

    El debate no es si el 90% es real — lo es, en el dashboard de Vercel. El debate es cuánto es en tu proyecto. Y esa cifra no la tiene el blog oficial: la tienes tú, y solo si la mediste antes.

    Escribir lo que esperas antes de ejecutarlo y contrastarlo después es lo mismo que defiendo en el libro de Spec-Driven Development: sirve igual para una feature que para actualizar un framework. Y si quieres contrastar números con gente que está actualizando esta misma semana, esas conversaciones están en Dominicode Labs.

    Preguntas frecuentes

    ¿De verdad Next.js 16.3 usa un 90% menos de memoria?

    En el mejor caso medido, sí: el dashboard de vercel.com pasó de 21,5 GB a 2 GB tras compilar 50 rutas. En nextjs.org la reducción fue del 82%, de 4.600 MB a 840 MB. El equipo de Turbopack advierte de que no existe un porcentaje único aplicable a todas las aplicaciones, porque depende del tamaño del grafo de rutas, de cuánto se recorra durante la sesión y de cuánto tiempo lleve el servidor levantado. Proyectos pequeños con reinicios frecuentes verán mejoras mucho menores.

    ¿Tengo que cambiar código para aprovechar Next.js 16.3?

    No para la mayor parte. El memory eviction, la caché en disco en next build, los streams nativos de Node en SSR y el agrupado de prefetches vienen activados por defecto. TypeScript 7 requiere únicamente subir la dependencia. Solo son opt-in el React Compiler en Rust, que además es experimental, y las features de navegación instantánea como Cache Components.

    ¿Actualizar a Next.js 16.3 rompe algo?

    Es una versión minor y no trae cambios de API que obliguen a tocar tu código. Lo que sí cambia es el comportamiento en tiempo de ejecución, porque el memory eviction y la caché de build llegan activados por defecto. Si tras actualizar ves recompilaciones inesperadas o rarezas en el HMR, el escape es experimental.turbopackMemoryEviction: false, y luego reportarlo.

    ¿El build 5,5× más rápido aplica también al primer build?

    No. La cifra compara un build en frío contra uno posterior que reutiliza la caché en disco, así que necesitas una ejecución previa. El rango real medido por Vercel va de 1,4× en vercel.com/home a 5,5× en vercel.com/geist, y corresponde al tiempo de compilación de Turbopack, no al next build completo con type checking y generación de páginas.

    ¿Cómo aprovecho la caché de build en CI?

    Persistiendo .next/cache entre ejecuciones, que es donde Turbopack guarda su caché de build. En GitHub Actions se hace con actions/cache apuntando a ~/.npm y a ${{ github.workspace }}/.next/cache, con una key que incluya el hash del lockfile y de tus fuentes, y restore-keys con el prefijo del lockfile para poder reconstruir desde una caché previa. No caches .next entero: el resto del directorio lo regenera next build de todas formas y solo te come cuota.

    ¿Y si mi proyecto sigue compilando con webpack?

    Las dos mejoras del titular son de Turbopack: el memory eviction y la caché en disco para next build no existen fuera de él. Lo que sí obtienes sin depender del bundler son los streams nativos de Node en SSR y el type checking con TypeScript 7, porque ocurren en la capa de render y en el paso de tipos, no en el empaquetado. import.meta.glob tampoco funciona fuera de Turbopack.

    ¿Merece la pena activar el React Compiler en Rust?

    Depende de si sigues usando Babel. Medido contra la aplicación de v0 es un 34% más rápido en frío y un 46% en caliente —la métrica es el tiempo desde next dev hasta tener la página lista, no un build de producción—, pero el post oficial aclara que esas ganancias asumen haber abandonado Babel por completo; si lo mantienes para otras transformaciones, la ganancia es menor. Sigue siendo experimental: actívalo en una rama y mide antes de meterlo en tu pipeline principal.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Visor de PDF en Next.js con Apryse WebViewer: guía real

    Visor de PDF en Next.js con Apryse WebViewer: guía real

    Un cliente me escribió con lo que parecía un encargo de dos semanas.

    «Necesitamos que el usuario abra su contrato dentro de la plataforma, lo anote, tache los datos sensibles y lo firme. Sin descargar nada, sin salir de la app.»

    Dos semanas. Claro.

    Lo que estaba pidiendo era un visor de PDF en Next.js con capa de anotaciones persistentes, redacción de verdad —no un rectángulo negro pintado encima, sino borrar el texto del documento— y firma. Es decir: un producto entero metido dentro de una ruta de la aplicación.

    Lo he visto intentar a mano tres veces. Las tres acabaron igual: seis meses después seguían peleando con fuentes embebidas y zoom en móvil.


    Resumen: visor de PDF en Next.js en 5 puntos

    • Un visor de PDF en Next.js es un componente de cliente que renderiza documentos dentro de tu aplicación, sin descargarlos ni delegar en el visor nativo del navegador. Requiere dos cosas que no son obvias: cargar la librería solo en el navegador y servir sus assets estáticos desde public/.
    • Construir a mano anotaciones, redacción y firma sobre PDF es un pozo sin fondo: el formato tiene 30 años de casos borde.
    • Apryse WebViewer (@pdftron/webviewer) te da ese flujo completo en el navegador, sin backend de por medio.
    • Es un SDK comercial con trial gratuito. Los paquetes de entrada arrancan en $1.500 según su web de precios —consultado en julio de 2026—, y el precio final es a medida.
    • Si solo necesitas mostrar un PDF, no lo uses. pdf.js o react-pdf te resuelven eso gratis.

    Por qué "solo un visor de PDF" nunca es solo un visor

    Un PDF no es una imagen con texto: es un contenedor con tipografías embebidas, capas, formularios AcroForm, XFA, firmas criptográficas, anotaciones con su propio modelo de datos y treinta años de decisiones heredadas. Parece simple solo porque lo abres todos los días y funciona.

    Renderizar la primera página con pdf.js te lleva una tarde. El problema empieza después.

    Que la anotación quede anclada al párrafo correcto al hacer zoom. Que la redacción elimine el texto del stream y no solo lo tape —si lo tapas, cualquiera lo copia con Ctrl+C y tienes un incidente de datos—. Que la firma se incruste sin romper la validez del documento. Y que todo eso funcione igual en Safari iOS.

    Ese es el trabajo real. Y no es trabajo de dos semanas: es trabajo de un equipo dedicado durante trimestres.

    Antes de meter una pieza así en tu aplicación, escribe qué necesitas exactamente. Suena obvio y casi nadie lo hace. En cómo aplico Spec-Driven Development antes de escribir código explico el proceso —y lo tienes entero en el libro de Spec-Driven Development—. Esta es justo la decisión donde una especificación de una página te evita elegir mal una licencia comercial.


    Qué es Apryse WebViewer y qué te ahorra

    Apryse WebViewer es un SDK comercial que monta un visor y editor de PDF en React dentro de tu aplicación, ejecutándose entero en el navegador. No necesitas un servicio de conversión detrás.

    Lo que trae de fábrica:

    • Anotación completa: resaltados, notas, dibujo, formas, comentarios.
    • Redacción real, que elimina el contenido del documento.
    • Edición de texto sobre el PDF.
    • Fill & sign para formularios y firma.
    • Búsqueda dentro del documento.
    • Cambio programático del documento cargado.
    • Soporte de más de 100 formatos: Office, imágenes, CAD. No solo PDF.

    Ese último punto suele cerrar la decisión. Cuando el cliente añade «ah, y también suben Word y planos», ya no evalúas un visor: evalúas si escribes tu propio pipeline de conversión.


    Cómo montar un visor de PDF en Next.js paso a paso

    La guía oficial de Apryse para Next.js cubre la instalación y es correcta. Lo que sigue añade lo que no te cuenta: la limpieza al desmontar, el fallo silencioso cuando path está mal y en qué casos no deberías estar leyendo este tutorial.

    1. Instalar el paquete

    npm i @pdftron/webviewer@^12
    

    Fijar la mayor te evita que un npm update te cambie la API por debajo. Este tutorial está escrito sobre la rama 12 con Next.js 16 y App Router.

    2. Copiar los assets estáticos

    Este es el paso que más gente se salta y luego pasa una tarde mirando 404 en la pestaña de red. WebViewer necesita sus propios archivos servidos estáticamente: workers, fuentes, recursos de UI.

    npx --yes cpy-cli "node_modules/@pdftron/webviewer/public/**/*" public/lib/webviewer
    

    Guárdalo como script de postinstall. Si no lo haces, funcionará en tu máquina y fallará en el primer despliegue limpio de CI:

    {
      "scripts": {
        "postinstall": "npx --yes cpy-cli \"node_modules/@pdftron/webviewer/public/**/*\" public/lib/webviewer"
      }
    }
    

    3. El componente, siempre en cliente (y el error "window is not defined")

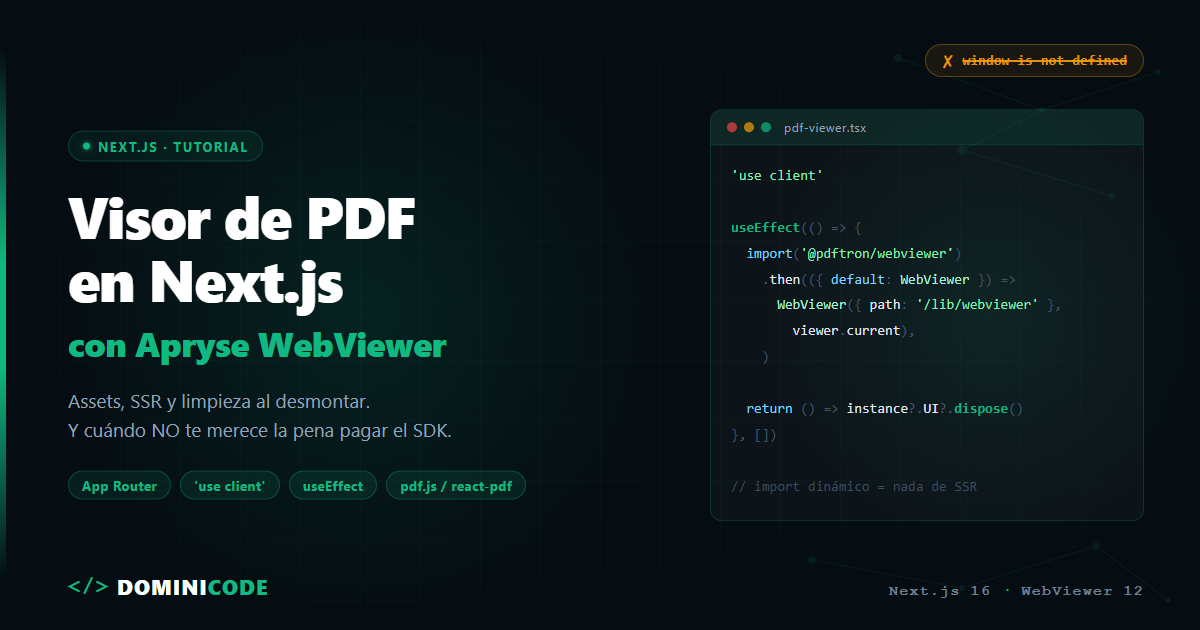
    WebViewer toca window y el DOM en el momento de inicializarse. Si Next.js intenta renderizarlo en el servidor, revienta con el clásico ReferenceError: window is not defined.

    Aquí está el matiz que atasca a casi todo el mundo: marcar el componente con 'use client' no basta si el import es estático. Esa directiva define dónde se hidrata el componente, no impide que el módulo se evalúe al construir el bundle del servidor.

    La solución es importar el módulo dinámicamente dentro del useEffect, para que solo se resuelva en el navegador después del montaje.

    'use client'
    import { useEffect, useRef } from 'react'
    
    export default function PdfViewer() {
      const viewer = useRef(null)
    
      useEffect(() => {
        const container = viewer.current
        let instance = null
        let unmounted = false
    
        const destroy = () => {
          instance?.UI?.dispose?.()
          instance = null
          if (container) container.innerHTML = ''
        }
    
        import('@pdftron/webviewer')
          .then(({ default: WebViewer }) =>
            WebViewer(
              {
                path: '/lib/webviewer',
                licenseKey: process.env.NEXT_PUBLIC_APRYSE_LICENSE_KEY,
                initialDoc: 'https://apryse.s3.amazonaws.com/public/files/samples/WebviewerDemoDoc.pdf',
              },
              container,
            ),
          )
          .then((i) => {
            instance = i
            if (unmounted) return destroy()
            i.Core.documentViewer.addEventListener('documentLoaded', () => {
              // el documento ya está en pantalla: engancha aquí tu lógica
            })
          })
          .catch((error) => {
            console.error('WebViewer no arrancó. Revisa la opción `path`:', error)
          })
    
        return () => {
          unmounted = true
          destroy()
        }
      }, [])
    
      return <div ref={viewer} style={{ height: '100dvh' }} />
    }
    

    Cuatro detalles que conviene entender, no copiar:

    • path apunta exactamente a donde copiaste los assets en el paso 2. Si cambias la carpeta, cambia esto.
    • El array de dependencias vacío no te salva de StrictMode. En desarrollo React monta, desmonta y vuelve a montar: el efecto corre dos veces y, sin función de limpieza, acabas con dos visores peleando por el mismo div. Por eso el return del useEffect llama a UI.dispose() y vacía el contenedor. Es la parte que casi ningún tutorial escribe.
    • La bandera unmounted cubre el otro orden posible: que el usuario navegue a otra ruta antes de que resuelva el import() dinámico. Sin ella te quedas un iframe y unos workers WASM vivos en memoria.
    • La promesa resuelve con un instance que expone instance.Core —donde vive documentViewer— e instance.UI. Ese objeto es tu mando a distancia.

    Y sí, el .catch() importa: si path está mal, sin él la promesa se rechaza en silencio y te quedas mirando un div en blanco sin una sola pista en consola.

    Si necesitas la API completa, añade fullAPI: true a las opciones.

    La clave va en variable de entorno para no hardcodearla en el repo:

    NEXT_PUBLIC_APRYSE_LICENSE_KEY=tu_clave_de_trial
    

    Ojo con la etiqueta: cualquier variable NEXT_PUBLIC_ viaja al bundle del navegador, así que esto no la convierte en un secreto. En WebViewer la licencia es de cliente y va ligada a tu dominio, así que es correcto y esperado; pero si algún día metes aquí una credencial de verdad, ese secreto vive en tu backend, no en una NEXT_PUBLIC_.


    Controlar el visor desde tu propia interfaz

    Casi nadie quiere la UI del SDK tal cual: quieres tus botones, con tu marca, en tu layout.

    El patrón es guardar la instancia en estado o en una ref y llamar a sus métodos desde tus componentes. El visor deja de ser una caja negra y pasa a ser un motor que tú comandas.

    'use client'
    import { useEffect, useRef, useState } from 'react'
    
    export default function PdfWorkspace() {
      const viewer = useRef(null)
      const [instance, setInstance] = useState(null)
    
      useEffect(() => {
        const container = viewer.current
        let current = null
        let unmounted = false
    
        const destroy = () => {
          current?.UI?.dispose?.()
          current = null
          setInstance(null)
          if (container) container.innerHTML = ''
        }
    
        import('@pdftron/webviewer')
          .then(({ default: WebViewer }) =>
            WebViewer(
              {
                path: '/lib/webviewer',
                licenseKey: process.env.NEXT_PUBLIC_APRYSE_LICENSE_KEY,
                fullAPI: true,
              },
              container,
            ),
          )
          .then((i) => {
            current = i
            if (unmounted) return destroy()
            setInstance(i)
          })
          .catch((error) => {
            console.error('WebViewer no arrancó:', error)
          })
    
        return () => {
          unmounted = true
          destroy()
        }
      }, [])
    
      return (
        <>
          <button
            disabled={!instance}
            onClick={() => {
              if (!instance) return
              const { documentViewer } = instance.Core
              // llama aquí al método que necesites sobre el documento
            }}
          >
            Acción propia
          </button>
          <div ref={viewer} style={{ height: '100dvh' }} />
        </>
      )
    }
    

    Un aviso de rendimiento: este bundle es grande. No lo cargues en el layout raíz ni en una ruta que la gente visita de paso. Aíslalo en su propia ruta y deja que el router precargue lo demás — hablé de esto al analizar las navegaciones instantáneas de Next.js 16.3, y aquí la diferencia entre hacerlo bien y mal se nota en segundos, no en milisegundos.


    La parte incómoda: cuánto cuesta Apryse WebViewer

    Apryse WebViewer no es gratis: su web de precios indica paquetes de entrada desde $1.500, y el precio final es a medida. Esa es la cifra, y aquí es donde la mayoría de tutoriales se callan.

    El importe depende de las features que actives, del volumen de documentos y de si la solución es cliente o servidor. No hay tarifa pública por tramos: hay que pedir presupuesto.

    Antes de pagar puedes probarlo. Apryse ofrece un trial gratuito, y su documentación de instalación te pide obtener una trial key en el portal de desarrolladores como paso previo. No te fíes de las condiciones que leas en un blog —incluido este—: mira el portal, que es donde cambian.

    Vas a encontrar otras cifras circulando por foros y comparativas. Ninguna sale de Apryse. Ignóralas y pide presupuesto: es la única cifra que vale para tu caso.


    ¿Cuándo NO usar Apryse?

    Si lo único que necesitas es mostrar un PDF en modo lectura, esto es un cañón para matar una mosca.

    Para eso tienes pdf.js de Mozilla, o react-pdf —construido encima— si quieres la integración con componentes ya resuelta. Son gratis, open source, maduros y te resuelven ese caso entero. Meter un SDK comercial ahí es quemar presupuesto y añadir peso al bundle sin ganar nada.

    Esta es la comparativa que a mí me habría ahorrado dos días de evaluación:

    Necesidad pdf.js react-pdf Apryse WebViewer
    Renderizar, paginar, zoom ✅ ✅ ✅
    Búsqueda en el documento ✅ ⚠️ manual ✅
    Componentes React listos ❌ ✅ ✅
    Anotaciones persistentes ❌ ❌ ✅
    Redacción real (borra del stream) ❌ ❌ ✅
    Edición de texto sobre el PDF ❌ ❌ ✅
    Fill & sign / firma ❌ ❌ ✅
    Office, imágenes, CAD (100+ formatos) ❌ ❌ ✅
    Licencia Apache 2.0 MIT Comercial
    Coste Gratis Gratis Desde $1.500, a medida

    Léela en diagonal y verás el patrón: las tres primeras filas son un empate, y todo lo demás es una columna sola. Si tu requisito vive en las tres primeras filas, ya tienes tu respuesta y es gratis.

    Apryse gana en un escenario concreto: cuando el documento es parte del flujo de negocio. Cuando el usuario tiene que anotar, redactar, rellenar, firmar o editar, y ese flujo es lo que el cliente está pagando.

    Y ahí el cálculo no es "SDK caro contra librería gratis". Es esto: cuántos meses de ingeniería cuesta construir y mantener redacción, anotaciones y firma bien hechas, contra el precio de licenciarlo.

    Cuando lo planteas así, la respuesta suele ser evidente. El coste no es el SDK. Es el tiempo que no gastas.


    Qué hacer hoy

    Instala el trial, copia los assets, monta el componente de arriba y ábrelo con un PDF real de tu cliente. No el de ejemplo: uno feo, escaneado, de 80 páginas.

    En veinte minutos sabrás si esto resuelve tu problema o si te sobra con react-pdf. Esa decisión, tomada con el visor delante y no leyendo comparativas, vale más que cualquier post.

    Y si lo que quieres es integrar piezas grandes como esta sin perder tres días leyendo documentación, ese es exactamente el flujo que enseño en el curso Construye con IA: especificar primero, delegar la integración después. La metodología completa está en el libro de Spec-Driven Development, y si prefieres hacerlo acompañado, en Dominicode Labs trabajamos integraciones como esta sobre proyectos reales.


    Preguntas frecuentes

    ¿Apryse WebViewer es gratis?

    No. Es un SDK comercial. Sí ofrece un trial gratuito para validar si encaja con tu caso: su documentación de instalación te pide obtener una trial key en el portal de desarrolladores antes de empezar. Para producción, su web de precios indica paquetes de entrada desde $1.500 (consultado en julio de 2026), con precio final a medida según las features que actives, el volumen de documentos y si el despliegue es en cliente o en servidor. Las condiciones exactas del trial las marca su portal, no los blogs.

    ¿Se puede usar Apryse WebViewer con el App Router de Next.js?

    Sí, con dos condiciones. El componente que lo monta debe llevar la directiva 'use client' y el import del paquete tiene que ser dinámico dentro del useEffect, no estático en la cabecera del archivo. Así el bundle del servidor nunca evalúa el SDK. Además tienes que copiar los assets estáticos del paquete a public/lib/webviewer y apuntar la opción path a esa ruta.

    ¿Por qué me da el error "window is not defined" al integrar el visor?

    Porque Next.js está intentando ejecutar el SDK durante el renderizado en servidor, donde no existe el objeto window. Marcar el componente como cliente no basta si el import es estático: el módulo se evalúa igualmente al construir. La solución es cargarlo con import('@pdftron/webviewer') dentro del useEffect, de forma que solo se resuelva en el navegador después del montaje.

    ¿Qué alternativa gratuita hay a Apryse?

    pdf.js de Mozilla y react-pdf, que está construido encima. Ambos son open source y cubren perfectamente la visualización de documentos: renderizado, paginación, zoom y búsqueda básica. Donde no llegan es en el flujo completo de trabajo con documentos —redacción que borra contenido de verdad, edición de texto, fill & sign, anotaciones persistentes con su modelo de datos—. Si tu requisito es leer, usa las gratuitas. Si tu requisito es operar sobre el documento, compara con Apryse.

    ¿Sirve solo para PDF?

    No. WebViewer soporta más de 100 formatos, incluidos documentos de Office, imágenes y archivos CAD, y los renderiza en el mismo visor sin necesidad de un servicio de conversión en el servidor. Suele ser el factor decisivo cuando los usuarios suben lo que tienen a mano y no un PDF bien generado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • De callbacks a Signals: la reactividad real del frontend

    De callbacks a Signals: la reactividad real del frontend

    Un excliente me escribió hace años, angustiado. Su carrito de compras mostraba 3 artículos en el header, pero el checkout decía que había 5. Los clientes se quejaban en soporte y algunos abandonaban la compra.

    Revisé el código. Puro estilo jQuery: DOM manipulado a mano, evento por evento. Un event listener actualizaba el contador del header. Otro, completamente separado, actualizaba el resumen del checkout. Nadie los había conectado entre sí — y ahí estaba el problema real: cero programación reactiva, cero garantía de que el estado y la interfaz dijeran la misma verdad.

    Cuando alguien hacía clic dos veces seguidas y rápido, un listener terminaba antes que el otro. El total quedaba repartido entre cuatro variables sueltas, cada una con su propia versión de la verdad. Pasé tres horas arreglando algo que debería haberme tomado diez minutos. No porque el bug fuera complejo — porque nada en el código garantizaba que la interfaz reflejara el estado real.

    Llevamos veinte años resolviendo ese mismo problema con herramientas distintas. Primero fueron callbacks manuales sobre el DOM. Luego llegó el Virtual DOM. Ahora, señales. Cada era resolvió lo que la anterior no pudo — y entender por qué importa más que memorizar sintaxis nueva cada dos años.


    Era 1: callbacks manuales y el DOM que se te olvida sincronizar

    En los tiempos de jQuery — y del DOM vanilla antes de eso — la única forma de reaccionar a un evento era escucharlo y mutar el DOM a mano. Tú decidías qué elemento tocar, cuándo y con qué valor.

    Toma el ejemplo clásico: un contador de carrito con tres elementos que dependen del mismo dato.

    let count = 0;
    
    const counterEl = document.querySelector('#counter');
    const totalEl = document.querySelector('#total');
    const shippingMsgEl = document.querySelector('#shipping-msg');
    
    document.querySelector('#add-btn').addEventListener('click', () => {
      count++;
      counterEl.textContent = count;
      totalEl.textContent = `$${(count * 19.99).toFixed(2)}`;
      shippingMsgEl.textContent = count >= 5
        ? '¡Envío gratis!'
        : `Añade ${5 - count} más para envío gratis`;
    });
    
    document.querySelector('#remove-btn').addEventListener('click', () => {
      count = Math.max(0, count - 1);
      counterEl.textContent = count;
      totalEl.textContent = `$${(count * 19.99).toFixed(2)}`;
      // shippingMsgEl no se actualiza aquí. Nadie lo notó en code review.
    });
    

    Mira el comentario en la última línea. Ese es, casi literal, el bug que revisé en el carrito de mi excliente.

    No es un error de sintaxis — el código compila, pasa QA si nadie prueba el camino de "quitar un producto cuando ya tenías envío gratis". El bug vive en la cabeza del developer: hay que acordarse de tocar los tres elementos en cada handler que mueva ese estado.

    La ventaja de este modelo es real: control total, cero abstracciones, cero curva de aprendizaje. Para un widget aislado — un acordeón, un modal, un tooltip — sigue siendo la opción correcta hoy mismo.

    El problema aparece en cuanto el estado deja de ser trivial:

    • Cada elemento dependiente necesita su propia línea de sincronización, repetida en cada handler que toque ese estado.
    • El estado vive disperso: a veces en el DOM (el.textContent), a veces en variables sueltas, a veces en atributos data-*.
    • Los listeners no se limpian solos. En una SPA que monta y desmonta vistas, cada addEventListener sin su removeEventListener es un memory leak esperando a pasar factura.

    Esto nunca fue un problema de jQuery. Fue un problema de arquitectura: nada en el modelo te obligaba a centralizar el estado ni a declarar sus dependencias. Cada developer inventaba su propia disciplina — y la disciplina, a escala de equipo, no escala.

    Era 2: Virtual DOM y el modelo declarativo

    React cambió la pregunta. En lugar de "¿qué elemento del DOM tengo que tocar?", pasó a ser "¿cómo se ve la UI dado este estado?". Tú describes el resultado final; el framework decide cómo llegar ahí.

    function Counter() {
      const [count, setCount] = useState(0);
      const total = (count * 19.99).toFixed(2);
      const shippingMsg = count >= 5
        ? '¡Envío gratis!'
        : `Añade ${5 - count} más para envío gratis`;
    
      return (
        <div>
          <p>{count}</p>
          <p>${total}</p>
          <p>{shippingMsg}</p>
          <button onClick={() => setCount(c => c + 1)}>Añadir</button>
          <button onClick={() => setCount(c => Math.max(0, c - 1))}>Quitar</button>
        </div>
      );
    }
    

    El bug del carrito es estructuralmente imposible aquí. total y shippingMsg se calculan en la misma función, a partir del mismo count, cada vez que el componente se ejecuta. No hay "actualizar" — hay "recalcular todo desde cero", así que no hay forma de que uno se sincronice y el otro se olvide.

    Ahí está la clave del Virtual DOM. React no toca el DOM real en cada cambio. Construye un árbol en memoria — objetos JavaScript planos que describen cómo debería verse la UI — y lo compara contra el árbol anterior. Ese proceso se llama reconciliation, y el algoritmo de comparación es el diffing: detecta qué nodos cambiaron, cuáles se reutilizan, y calcula el mínimo de operaciones para que el DOM real refleje el nuevo árbol. Solo entonces toca el DOM — y solo donde hace falta.

    Es un modelo declarativo y predecible. Pero el coste real no es gratis, y es lo que casi nadie menciona en los tutoriales de introducción: cada cambio de estado re-ejecuta la función completa del componente y, por defecto, la de sus hijos.

    En un árbol de cuarenta componentes anidados, un solo tecleo puede disparar cuarenta re-renders y cuarenta diffs — la mayoría comparando nodos que ni siquiera cambiaron.

    La respuesta del ecosistema fue la memoization: memo(), useMemo(), useCallback(). Son parches necesarios para un problema que el propio modelo introduce: no sabes qué cambió hasta que recalculas y comparas. Memoizar es responsabilidad manual otra vez — la misma que el Virtual DOM prometía eliminar, solo que movida un nivel más arriba en el árbol.

    Era 3: reactividad fina — el grafo en vez del árbol

    Los signals no comparan nada. No hay árbol virtual, no hay diffing, no hay re-render de una función completa. Un signal es una caja que guarda un valor y sabe, con precisión, quién depende de él.

    import { Component, signal, computed, effect } from '@angular/core';
    
    @Component({
      selector: 'app-cart-counter',
      template: `
        <p>{{ count() }}</p>
        <p>${{ total() }}</p>
        <p>{{ shippingMsg() }}</p>
        <button (click)="count.set(count() + 1)">Añadir</button>
        <button (click)="count.set(count() - 1)">Quitar</button>
      `,
    })
    export class CartCounterComponent {
      count = signal(0);
    
      total = computed(() => (this.count() * 19.99).toFixed(2));
    
      shippingMsg = computed(() =>
        this.count() >= 5
          ? '¡Envío gratis!'
          : `Añade ${5 - this.count()} más para envío gratis`
      );
    
      constructor() {
        effect(() => {
          console.log(`Carrito: ${this.count()} items — $${this.total()}`);
        });
      }
    }
    

    Cuando count cambia, Angular no re-ejecuta el componente entero ni reconstruye ningún árbol para comparar. total y shippingMsg ya saben que dependen de count — lo registraron la primera vez que se ejecutaron, al construirse el grafo reactivo. Angular actualiza exactamente el nodo del DOM ligado a cada binding. Nada más se mueve.

    Esto es reactividad fina (fine-grained reactivity): la granularidad de la actualización no es el componente, ni el subárbol — es el binding individual. Angular v22 lleva esto hasta el final siendo zoneless por defecto: ya no depende de Zone.js interceptando cada setTimeout o evento del navegador para saber cuándo revisar cambios. El grafo de signals es la única fuente de verdad sobre qué actualizar y cuándo.

    Angular no inventó este modelo — lo adoptó y lo llevó a producción a escala. Solid.js lo demostró primero, sin Virtual DOM desde el diseño inicial. Svelte llega a un resultado parecido compilando la reactividad en tiempo de build. Los tres coinciden en el mismo diagnóstico: comparar árboles es trabajo evitable si sabes de antemano quién depende de quién.

    Si quieres ver cada primitiva documentada en detalle, la guía oficial de Angular Signals cubre signal(), computed() y effect() con más profundidad de la que cabe en un post.

    Si quieres ver cómo se construye ese grafo de dependencias paso a paso — incluyendo los casos raros donde un effect() se dispara más veces de las que esperas — lo cubrí a fondo en el post sobre el grafo reactivo de Angular Signals.

    En el curso de Angular Moderno construimos este modelo mental desde cero, con proyectos reales donde pasar de Zone.js a zoneless cambia decisiones de arquitectura, no solo de sintaxis.

    Los tres paradigmas, uno al lado del otro

    Modelo mental Cómo detecta cambios Granularidad de la actualización Coste computacional Dónde brilla
    Callbacks (jQuery / DOM imperativo) Tú mutas el DOM a mano, evento por evento No detecta nada — el developer decide cuándo actualizar La que tú programes, elemento por elemento Bajo por operación, alto en mantenimiento y bugs de sincronización Widgets aislados, prototipos, páginas sin estado compartido
    Virtual DOM (React) La UI es una función pura del estado Diffing — compara árbol virtual anterior vs. nuevo Por componente/subárbol, tras re-ejecutar y comparar Re-ejecuta la función de render completa y diffea en cada cambio Apps con estado complejo, equipos grandes, ecosistema maduro
    Signals (Angular, Solid, Svelte) Grafo de dependencias reactivas Suscripción directa — el signal sabe quién lo consume El binding o nodo exacto del DOM que depende del valor Solo se ejecuta lo que realmente cambió UI de alta frecuencia de actualización, listas grandes, apps sensibles a rendimiento

    Por qué la reactividad fina no es una moda

    Cada era resolvió el cuello de botella real de la anterior — no la anterior en abstracto, la anterior en producción.

    Los callbacks resolvieron "cómo reacciono a un evento del usuario". Fue suficiente mientras la UI tenía poco estado compartido. Dejó de serlo en cuanto una sola acción tenía que actualizar cinco sitios distintos de la pantalla.

    El Virtual DOM resolvió "cómo mantengo la UI declarativa sin perder la cordura sincronizando elementos a mano". A cambio, aceptó un coste: recalcular y comparar árboles que, la mayoría de las veces, apenas habían cambiado.

    Signals resuelve el cuello de botella que el Virtual DOM introdujo: cómo evitar recalcular y comparar lo que ya sabías que no había cambiado. No es una versión "más rápida" de React. Es una respuesta distinta a la misma pregunta de fondo: ¿qué es lo mínimo que tengo que actualizar para que la UI diga la verdad?

    Esto no significa que el Virtual DOM esté acabado, ni que debas reescribir tu app de React mañana.

    Significa que si estás arrancando un proyecto hoy, entender este modelo ya no es opcional — es la diferencia entre construir sobre un patrón que resuelve el problema en su raíz o sobre uno que lo parchea con memoization.

    Esta decisión de arquitectura — dónde vive el estado, cómo fluye, qué parte del sistema es responsable de mantenerlo sincronizado con la UI — es exactamente el tipo de decisión que trato en el post sobre Clean Architecture para frontend con IA: la reactividad que elijas no es un detalle de implementación, es una decisión que carga con consecuencias durante años.

    Si vas a construir con signals en producción, en algún momento necesitarás verificar que esos computed() y effect() se comportan como esperas bajo distintos escenarios — eso es justo lo que trabajamos con casos reales en el curso de Testing en Angular con Jest y Testing Library.

    Y si quieres discutir esto con otros developers que están tomando las mismas decisiones ahora mismo, en Dominicode Labs es donde pasa esa conversación cada semana.

    Preguntas frecuentes sobre programación reactiva en el frontend

    ¿Qué es la programación reactiva?

    Es el paradigma en el que la interfaz se actualiza automáticamente cuando cambia el estado del que depende, sin que el desarrollador tenga que sincronizarla a mano evento por evento. Los tres modelos de este post — callbacks, Virtual DOM y signals — son formas distintas de resolver ese mismo problema, con más o menos reactividad real incorporada al framework.

    ¿El Virtual DOM está muerto?

    No. Sigue siendo el modelo dominante en producción — React tiene el ecosistema, el talento disponible y millones de líneas de código funcionando con él hoy. Lo que cambió es que ya no es la única opción seria para UI compleja: Signals, Solid.js y Svelte demuestran que el diffing es una solución al problema, no la única posible.

    ¿Los Signals reemplazan a React?

    No en el sentido de que React vaya a desaparecer. Angular con Signals, Solid.js y Svelte son alternativas con un modelo distinto, no reemplazos del ecosistema React. Sí es cierto que la presión competitiva ya empujó a React hacia herramientas como React Compiler, que intenta automatizar la memoization que antes hacías a mano.

    ¿Qué es la reactividad fina (fine-grained reactivity)?

    Es un modelo donde cada pieza de estado (signal) mantiene una lista explícita de quién depende de ella — otros signals derivados (computed) o efectos secundarios (effect). Cuando el valor cambia, solo se re-ejecuta lo que está suscrito a ese valor específico, sin comparar árboles ni recalcular lo que no depende de ese dato.

    ¿Angular usa Virtual DOM?

    No, y nunca lo usó. Angular usaba Zone.js y un mecanismo de change detection basado en recorrer el árbol de componentes buscando cambios. Con Signals y el modo zoneless, por defecto desde Angular v22, Angular elimina también ese recorrido: el grafo de signals le dice exactamente qué actualizar, sin Zone.js y sin diffing.

    ¿Debo migrar mi app de React a Signals?

    No si tu app funciona bien y el equipo domina React. La reactividad fina brilla en escenarios concretos: dashboards con actualizaciones muy frecuentes, listas grandes, apps donde el rendimiento de render es un cuello de botella medido, no sospechado. Si estás empezando un proyecto nuevo, sí vale la pena evaluar Angular v22 con Signals como opción seria.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Errores comunes al migrar a React Server Components en producción

    Errores comunes al migrar a React Server Components en producción

    React Server Components en producción: errores que nadie te cuenta

    Tiempo estimado de lectura: 5 min

    • Fronteras claras: mezclar datos pesados del servidor con Client Components provoca serialización y payloads enormes.
    • No convertir todo a client: usar “use client” globalmente anula los beneficios de RSC y regresa a una SPA pesada.
    • Latencia y caching: llamadas secuenciales y caché agresiva generan TTFB alto y fugas de datos entre usuarios.
    • Audita dependencias: muchas librerías no están preparadas para ejecución en server; lazy-load o wrappers client son necesarios.

    Introducción

    React Server Components en producción: errores que nadie te cuenta. Lo digo sin rodeos: los tutoriales y demos no te preparan para operarlos en tráfico real. En ese salto es donde aparecen fugas de datos, payloads monstruosos y cuellos de botella invisibles que desarman la promesa de “menos JS, mejor rendimiento”.

    Este artículo enumera los fallos concretos que verás en proyectos reales, aporta soluciones técnicas y define cuándo NO migrar a RSC. Incluye referencias y enlaces oficiales para que puedas profundizar: Suspense y caching en Next.js.

    Resumen rápido (lectores con prisa)

    Qué es: Patrón que permite renderizar parte de la UI en el servidor y enviar un árbol serializado al cliente.

    Cuándo usarlo: cuando puedas controlar la frontera server/client, minimizar datos pasados al cliente y beneficiarte de menos JS inicial.

    Por qué importa: mejora rendimiento y seguridad si se adopta con disciplina en serialización, caché y orquestación de datos.

    Cómo funciona: Server Components pueden acceder a recursos de servidor; Client Components se hidratan en cliente y deben recibir solo datos mínimos.

    1. React Server Components en producción: la frontera que rompe todo

    El error raíz es conceptual: tratar la frontera server/client como una línea estética en lugar de una decisión arquitectónica. Un Server Component puede acceder a la BD y luego pasar objetos enormes como props a un Client Component. Eso obliga a React a serializar todo en el HTML/JSON de respuesta. Resultado: la reducción del bundle se convierte en megabytes de payload.

    Ejemplo típico (malo)

    • Server Component hace SELECT * FROM orders WHERE user_id = ? y pasa todos los registros a <OrdersTable use client />.
    • El navegador recibe un payload serializado de decenas de MB.

    Solución: procesar, paginar y resumir en el servidor. Pasa al cliente solo el minimum viable (IDs, count, primeros N items) y provee endpoints client-side para cargar la página de datos al interactuar.

    2. El pánico del “use client” y la regresión a SPA

    Cuando algo falla (proveedores, librerías de UI, hooks), el atajo más común es colocar "use client" en el layout. Eso convierte todo el árbol en Client Components y anula el beneficio de RSC: vuelves a una SPA grande, con mayor complejidad y sin reducción de JS.

    Patrón correcto:

    • Mantén providers y estado en componentes hoja que realmente necesitan interactividad.
    • Diseña la composición para que los Client Components reciban props mínimos y, si requieren datos pesados, llamen a endpoints específicos (fetch desde cliente) o utilicen streaming.

    3. Waterfalls invisibles: el backend secuencial que mata TTFB

    Código like-this en Server Component:

    const user = await getUser(id);
    const prefs = await getPrefs(user.configId);
    const orders = await getOrders(user.id);
    

    Eso es secuencial: suma latencias. Aunque ocurre en servidor, el usuario espera. Paraleleza con Promise.all cuando no hay dependencia, y usa Suspense para streaming progresivo cuando sí hay dependencias parciales.

    Patrón secuencial y solución

    • Identifica llamadas independientes y ejecútalas en paralelo.
    • Usa streaming y Suspense para mostrar partes de la vista cuando están listas.
    • Mide TTFB en staging bajo carga para detectar waterfalls invisibles.

    4. Caché agresiva = fuga de datos entre usuarios

    Next.js y otros frameworks aplican caching por defecto en render server. Si renderizas una ruta con datos privados y no marcas la petición como dinámica, puedes cachear la vista de un usuario y servirla a otro. Es real y está pasando en producción.

    Contramedidas:

    • Para datos privados usa { cache: 'no-store' } en fetch o llama a APIs que leen cookies()/headers() (esto fuerza render dinámico en Next.js).
    • Revisa la documentación de caché de Next.js: caching en Next.js.
    • Considera políticas CDN más conservadoras para rutas autenticadas.

    5. Integraciones de terceros que no están listas para server execution

    Muchas librerías npm asumen un entorno DOM. Al ejecutar en server, aparecen errores en build o comportamiento inesperado. Resultado: el equipo marca "use client" masivo y pierde las ventajas. Revisa dependencias: algunas requieren reemplazo o lazy-loading estricto.

    Táctica práctica:

    • Audita las dependencias con npm ls y pruebas de build en CI que marquen dónde fallan.
    • Si una librería solo se usa en un widget, envuélvela en un Client Component lazy-loaded.

    Cuándo NO usar React Server Components

    No migres a RSC si tu producto encaja en alguno de estos casos:

    • Aplicaciones offline-first o PWAs que deben funcionar sin servidor.
    • Interfaces de hiper-interactividad: editores gráficos, juegos, vídeo en tiempo real o UIs con WebSockets a alta frecuencia.
    • Bases de código legacy sin presupuesto de reescritura: migrar Redux heavy/class components = reescritura, no refactor.

    Checklist práctico antes de migrar a producción

    1. Delimita claramente boundaries: quién corre en server y qué mínima data pasa al cliente.
    2. Añade tests de integración que simulen carga y validen payloads.
    3. Forza políticas de cache por ruta (privada vs pública).
    4. Instrumenta logs de tamaño de respuesta y tokenización/serialización.
    5. Adopta streaming/Suspense para vistas complejas; usa Promise.all para llamadas paralelas.
    6. Audita dependencias y evita convertir el layout en client por comodidad.

    Conclusión: RSC exige disciplina, no solo adopción

    React Server Components entregan ventajas claras (menos JS inicial, mayor seguridad para secretos, mejor SEO). Pero funcionan en producción solo si el equipo re-aprende backend: serialización, caching, latencia y orquestación de datos. La migración exitosa no es técnica aislada; es un cambio de modelo mental: pasar de “componentes” a “árboles de dependencias de red”. Si no estás dispuesto a trazar fronteras con rigor, no migres: estarás complicando tu arquitectura sin ganar sus beneficios.

    FAQ

    ¿Qué es exactamente un React Server Component?

    Un React Server Component se renderiza en el servidor y puede acceder a recursos del backend. No se hidrata en el cliente como un Client Component y se envía serializado al navegador.

    ¿Cuándo debo evitar migrar a RSC?

    Evita migrar si necesitas soporte offline completo, tienes UIs de hiper-interactividad (editores, juegos, video en tiempo real) o una base de código legacy sin presupuesto para reescritura.

    ¿Cómo evito pasar payloads gigantes al cliente?

    No pases objetos completos como props. Resumir, paginar y enviar solo lo mínimo necesario (IDs, count, primeros N items). Usa endpoints client-side para cargar datos adicionales bajo demanda.

    ¿Qué problemas de caché debo vigilar en Next.js?

    Cuidado con el render estático por defecto: rutas con datos privados pueden quedar cacheadas. Para datos privados usa { cache: 'no-store' } en fetch o APIs que lean cookies()/headers() para forzar render dinámico.

    ¿Cómo detectar y arreglar waterfalls en Server Components?

    Mide TTFB en staging bajo carga, revisa llamadas secuenciales en Server Components y paraleliza con Promise.all cuando sea posible. Usa streaming y Suspense para render progresivo.

    ¿Qué hago con librerías que fallan en server?

    Audita dependencias con npm ls, añade pruebas de build en CI y envuelve las librerías problemáticas en Client Components lazy-loaded o busca alternativas compatibles con server execution.

  • Aprende a tipar correctamente props, hooks y contextos en TypeScript y React

    Aprende a tipar correctamente props, hooks y contextos en TypeScript y React

    TypeScript + React: cómo tipar correctamente props, hooks y contextos

    Tiempo estimado de lectura: 4 min

    • Tipado explícito evita errores silenciosos: evita atajos como as any y prefiere contratos claros.
    • Props y refs: evita React.FC, usa referencias DOM con null inicial y valores mutables con valor inicial.
    • Contextos seguros: inicializa con null y expón hooks que hagan fail-fast si se usan fuera del provider.
    • Handlers y hooks: aprovecha los tipos de React (ChangeEvent, FormEvent) y deja que TS infiera cuando sea seguro.

    ¿Quieres dejar de parchear bugs con as any y que tu base de código deje de tener sorpresas en producción? Bien. Esto es lo que realmente necesitas saber sobre TypeScript + React: cómo tipar correctamente props, hooks y contextos. No es teoría. Son patrones que evitan errores silenciosos, mejoran el autocompletado y hacen que el código sea mantenible cuando el equipo crece.

    Resumen rápido (lectores con prisa)

    Tipar React con TypeScript reduce errores en producción y mejora DX. Evita React.FC, inicializa contextos con null y valida con hooks, usa refs con null para DOM y valores iniciales para mutables, y aprovecha los tipos sintéticos de eventos de React.

    Evita React.FC: tipa los parámetros explícitamente

    React.FC fue útil en tutoriales, pero introduce problemas: children implícitos, genéricos torpes y ruido. Tipar la función es más claro y explícito.

    interface ButtonProps {
      label: string;
      onClick: () => void;
      variant?: 'primary' | 'secondary';
      children?: React.ReactNode;
    }
    
    export function Button({ label, onClick, variant = 'primary', children }: ButtonProps) {
      return <button className={`btn-${variant}`} onClick={onClick}>{children ?? label}</button>;
    }
    

    React.ReactNode cubre todo lo que necesitas para children. Punto.

    useState: deja que TS infiera cuando pueda, explícito cuando haga falta

    Si el estado empieza con un primitivo, no especifiques el tipo. Si empieza vacío y luego será un objeto, usa una unión con null.

    interface User { id: string; email: string; }
    
    const [count, setCount] = useState(0);            // OK, inferido
    const [user, setUser] = useState<User | null>(null); // OK, explícito
    

    ¿Por qué? Porque evitarás tener que castear más adelante y te proteges contra undefined al acceder a propiedades.

    useRef: dos usos, dos reglas

    useRef sirve para referencias DOM y para valores mutables que no disparan re-render. Los tipos cambian según el valor inicial.

    • DOM refs: inicializa con null y maneja optional chaining.
    • Valores mutables: inicializa con el valor y muta .current.
    const inputRef = useRef<HTMLInputElement | null>(null);
    const renderCount = useRef(0);
    
    inputRef.current?.focus();
    renderCount.current += 1;
    

    No uses as para saltarte el null check. Esa falsedad te estallará en runtime.

    Eventos del DOM: tipa cada handler

    No uses any. React expone tipos sintéticos bien definidos. Úsalos y disfruta del autocompletado.

    const handleChange = (e: React.ChangeEvent<HTMLInputElement>) => {
      console.log(e.target.value);
    };
    
    const handleSubmit = (e: React.FormEvent<HTMLFormElement>) => {
      e.preventDefault();
    };
    

    Esto evita errores tontos como leer propiedades inexistentes.

    useContext: seguro, explícito y con fail-fast

    No hagas createContext({} as ThemeContext). Ese as silencia al compilador y deja el error para producción.

    Patrón correcto: contexto con null y hook personalizado que comprueba la presencia del provider.

    interface ThemeContextType { theme: 'light'|'dark'; toggle: () => void; }
    const ThemeContext = createContext<ThemeContextType | null>(null);
    
    export function useTheme() {
      const ctx = useContext(ThemeContext);
      if (!ctx) throw new Error('useTheme debe usarse dentro de ThemeProvider');
      return ctx;
    }
    

    Fail-fast: si alguien usa el hook fuera del provider, fallas rápido y el stack trace dice dónde.

    forwardRef: firma invertida, atención al tipo genérico

    La firma de forwardRef es contraintuitiva: el primer genérico es el tipo de ref, el segundo las props.

    interface InputProps { label: string }
    
    export const CustomInput = forwardRef<HTMLInputElement, InputProps>(({ label, ...props }, ref) => (
      <label>
        {label}
        <input ref={ref} {...props} />
      </label>
    ));
    CustomInput.displayName = 'CustomInput';
    

    Siempre define displayName para facilitar debugging en React DevTools.

    Tips prácticos que cambian proyectos

    • Exporta type con export type cuando sean solo contratos. Eso deja claro que no hay runtime.
    • No uses as para “callar” al compilador. Es un atajo que se vuelve deuda.
    • Si necesitas tipos genéricos en componentes, tipa explícitamente props y evita React.FC.
    • Para APIs y carga asíncrona, combina Zod (o similar) con z.infer si necesitas validación runtime y tipos derivados.

    Checklist rápido antes de push

    • ¿Contextos inicializados con null y validados por hooks? ✔
    • ¿useRef con null para DOM y con valor inicial para mutables? ✔
    • ¿Handlers con React.ChangeEvent / FormEvent? ✔
    • ¿No hay as any salvo casos documentados? ✔

    Cierra con criterio

    Tipar React no es un ejercicio académico. Es la forma más barata de prevenir fallos en producción y mejorar el DX de tu equipo. Haz estas tres cosas hoy:

    1. Revisa contextos: elimina as y añade hooks defensivos.
    2. Estándariza useRef y useState según lo explicado.
    3. Añade displayName a los componentes con forwardRef.

    Aplica esto en tu repo. Si algo rompe después, sabrás exactamente por qué. Esto no acaba aquí. Hay más patrones (componentes polimórficos, inferencia con generics, overloads en hooks) que merecen otra nota.

    FAQ

    ¿Por qué evitar React.FC?

    Porque introduce children implícitos, dificulta genéricos y añade ruido. Tipar explícitamente los parámetros es más claro y evita sorpresas.

    ¿Cuándo especificar el tipo en useState?

    No lo especifiques si el estado inicia con un primitivo (deja que TS infiera). Si el estado inicia vacío y luego será un objeto, usa una unión con null (por ejemplo User | null).

    ¿Cómo tipar correctamente useRef para DOM?

    Inicializa la ref con null y usa el tipo del elemento: useRef<HTMLInputElement | null>(null). Accede con optional chaining (inputRef.current?.focus()).

    ¿Qué hacer si alguien usa un context fuera del provider?

    Exponer un hook que haga fail-fast: si el contexto es null, lanzar un error claro (por ejemplo throw new Error('useTheme debe usarse dentro de ThemeProvider')).

    ¿Es aceptable usar as en alguna situación?

    Evita as salvo casos documentados y justificables. Usarlo para “callar” al compilador oculta problemas que aparecerán en runtime.

    ¿Cómo mejorar la validación de APIs y mantener tipos?

    Combina validación runtime con librerías como Zod y usa z.infer para derivar tipos TypeScript a partir de los esquemas de validación.

  • Soluciones efectivas para props drilling en React

    Soluciones efectivas para props drilling en React

    ¿Qué es el props drilling en React? Guía de arquitectura y soluciones

    Tiempo estimado de lectura: 4 min

    • Props drilling es pasar props a través de varios niveles que no las usan.
    • Opciones: composición, Context API o stores externos según alcance y frecuencia de cambio.
    • Decisión técnica: privilegia composición; Context para valores estables; store para coordinación entre subsistemas.

    Resumen rápido (lectores con prisa)

    Props drilling: pasar datos por componentes intermedios que no los usan. Si atraviesa pocos niveles (<3) suele estar bien; si escala, considerar composición, Context o un store externo. Elige según alcance, frecuencia de cambio y acoplamiento.

    ¿Qué es el props drilling en React?

    El props drilling en React es cuando pasas propiedades a través de múltiples niveles de componentes que no las usan, solo las retransmiten hasta el componente que sí las necesita.

    Ejemplo visual:

    App (tiene user)
    └─ Layout
    └─ Sidebar
    └─ Menu
    └─ UserProfile (usa user)

    Código mínimo:

    function App() {
      const user = { name: "Ana", avatar: "/ana.jpg" };
      return <Layout user={user} />;
    }
    
    function Layout({ user }) { return <Sidebar user={user} />; }
    function Sidebar({ user }) { return <UserProfile user={user} />; }
    function UserProfile({ user }) { return <img src={user.avatar} alt={user.name} />; }

    Layout y Sidebar no necesitan user. Solo lo llevan. Eso genera acoplamiento y ruido en el código.

    ¿Cuándo es un problema real?

    No todo props que viaja es pecado. Pasar props uno o dos niveles es totalmente aceptable. El problema aparece cuando:

    • La propiedad atraviesa tres o más niveles.
    • Múltiples props no relacionadas llenan la firma de componentes intermedios.
    • Mover un componente exige recablear docenas de firmas.
    • Los re-renders se disparan y el rendimiento cae.

    Consecuencias prácticas: acoplamiento innecesario, refactors costosos, más tests y mayor probabilidad de bugs al cambiar la forma del dato.

    Soluciones (con criterio técnico)

    No hay varita mágica. Hay herramientas y criterios para escoger la correcta.

    1) Composición de componentes (cuando aplica)

    Primera regla: intenta composición antes que librerías. Si el componente final vive en un subárbol que puedes construir desde el padre que tiene el dato, inyecta el subárbol.

    function App() {
      const user = { name: "Ana", avatar: "/ana.jpg" };
      return (
        <Layout sidebar=&{``} />
      );
    }

    Ventaja: cero dependencias, cero props intermedios. Referencia: docs de React sobre composición

    Cuándo usar: datos locales a una sección, poco compartidos fuera del subárbol.

    2) Context API (cuando el dato es global y estable)

    Context te permite proveer un valor desde arriba y consumirlo en cualquier punto del árbol, sin pasar props intermedios.

    const UserContext = React.createContext(null);
    
    function App() {
      const user = { name: "Ana" };
      return <UserContext.Provider value={user}><Layout /></UserContext.Provider>;
    }
    
    function UserProfile() {
      const user = useContext(UserContext);
      return <span>{user.name}</span>;
    }

    Docs oficiales: React Context

    Advertencia: Context es ideal para valores que cambian poco (tema, idioma, sesión). Si el valor cambia con alta frecuencia, todos los consumidores se re-renderizan y el rendimiento puede sufrir.

    3) Estado global / stores (cuando la app escala)

    Cuando múltiples partes desconectadas del árbol necesitan leer y escribir el mismo estado, un store fuera del árbol es la opción práctica.

    Opciones razonables hoy:

    • Zustand: simple, sin boilerplate, buen rendimiento.
    • Redux Toolkit: trazabilidad y patterns para apps enterprise.
    • Jotai/Recoil: atom-based state para control fino de re-renders.

    No uses un store global por moda. Úsalo cuando la composición y Context se queden cortos.

    Cómo decidir (lista rápida)

    Hazte estas preguntas antes de refactorizar:

    1. ¿Cuántos niveles atraviesa la prop? (<3 → probablemente ok)
    2. ¿Los componentes intermedios la usan? (si sí, deja el flujo)
    3. ¿El dato cambia con frecuencia? (si sí, evita Context)
    4. ¿Se comparte entre partes no relacionadas de la UI? (si sí, considera un store)

    Si la respuesta apunta a complejidad real, planifica: migración por fases, pruebas y medición de re-renders.

    Buenas prácticas finales

    • Mantén el estado lo más cerca posible del lugar donde se usa.
    • Prefiere composición cuando sea viable.
    • Usa Context para datos estables.
    • Reserva stores externos para coordinación entre subsistemas.
    • Evita micro-optimizaciones prematuras: primero estructura, luego perf.

    Referencias útiles

    Esto no acaba aquí: en el siguiente post veremos cómo migrar un árbol con props drilling a Zustand paso a paso, sin romper la app ni a los desarrolladores. Suscríbete al boletín de Dominicode para recibir la guía y los snippets listos para copiar.

    FAQ

    ¿Qué es exactamente el props drilling?

    Es el patrón donde pasas propiedades desde un componente superior hasta uno profundo, atravesando componentes intermedios que no las usan. Genera firmas de props infladas y acoplamiento innecesario.

    ¿Cuándo puedo ignorarlo?

    Cuando la prop atraviesa uno o dos niveles y no complica el mantenimiento. No todo pasaje de props requiere refactor.

    ¿Cuándo usar Context en lugar de un store?

    Usa Context para valores globales y estables (tema, idioma, sesión). Evita Context para datos que cambian con alta frecuencia o requieren escrituras concurrentes desde múltiples partes.

    ¿La composición siempre es la mejor opción?

    No siempre, pero es la primera estrategia a intentar: sin dependencias y con menor acoplamiento cuando puedes construir el subárbol desde el padre que tiene el dato.

    ¿Qué problemas de rendimiento trae Context?

    Si el valor del Provider cambia con frecuencia, todos los consumidores se re-renderizan, lo que puede impactar el rendimiento. Se puede mitigar con memos, splitting de contexts o stores que controlen re-renders finos.

    ¿Qué store elegir si la app escala?

    Depende: Zustand para simplicidad y rendimiento, Redux Toolkit para trazabilidad en enterprise, y Jotai/Recoil para control fino de re-renders.

  • Enviar correos transaccionales con Resend en React y NestJS

    Enviar correos transaccionales con Resend en React y NestJS

    Cómo usar Resend en React y NestJS

    Tiempo estimado de lectura: 4 min

    • Mantén consistencia visual entre web y correo usando plantillas React Email.
    • Protege claves renderizando en el servidor (NestJS) y guardando API keys en variables de entorno.
    • Escala correctamente con colas (BullMQ/Redis) para evitar bloquear peticiones.

    Cómo usar Resend en React y NestJS para enviar correos transaccionales sin sangrar tiempo en HTML quebrado ni exponer claves. Esta guía práctica muestra plantillas en React, render en servidor (NestJS) y entrega con Resend.

    Resumen rápido (lectores con prisa)

    Qué es: patrón para generar y enviar emails transaccionales usando plantillas React Email, render en NestJS y entrega vía Resend.

    Cuándo usarlo: cuando quieres consistencia visual entre web y email y no exponer claves en frontend.

    Por qué importa: reduce deuda técnica, mejora DX y entregabilidad al separar render y envío.

    Cómo funciona: escribe plantillas React, renderízalas en servidor con @react-email/render y envía con la API de Resend; procesa con colas para escalar.

    Cómo usar Resend en React y NestJS: flujo y por qué importa

    No es solo “mandar un email”. Es:

    • mantener consistencia visual entre web y correo,
    • no exponer claves,
    • evitar render duplicado,
    • y escalar sin convertir cada registro en un bloqueo HTTP.

    La solución: escribir plantillas con React Email, renderizarlas en NestJS usando @react-email/render y llamar a Resend para la entrega. Docs oficiales: Resend, React Email, NestJS.

    1) Plantilla en React (React Email)

    Instala dependencias en tu monorepo o carpeta compartida:

    npm install @react-email/components @react-email/render
    npm install -D react @types/react

    Ejemplo mínimo: src/emails/WelcomeEmail.tsx

    import * as React from 'react';
    import { Html, Body, Container, Text, Button } from '@react-email/components';
    
    export function WelcomeEmail({ name, url }: { name: string; url: string }) {
      return (
          
            
              Hola, {name}
              Verifica tu cuenta para empezar a usar la plataforma.


      );
    }

    Ventaja: el componente es testable, reutilizable y legible. React Email genera HTML compatible con clientes antiguos.

    2) Render y envío en NestJS

    Instala el SDK de Resend:

    npm install resend

    email.service.ts (esqueleto)

    import { Injectable, Logger } from '@nestjs/common';
    import { ConfigService } from '@nestjs/config';
    import { Resend } from 'resend';
    import { render } from '@react-email/render';
    import { WelcomeEmail } from '../emails/WelcomeEmail';
    
    @Injectable()
    export class EmailService {
      private resend: Resend;
      private logger = new Logger(EmailService.name);
    
      constructor(private config: ConfigService) {
        this.resend = new Resend(this.config.get('RESEND_API_KEY'));
      }
    
      async sendWelcome(to: string, name: string, verificationUrl: string) {
        const html = render(WelcomeEmail({ name, url: verificationUrl }));
        const res = await this.resend.emails.send({
          from: 'TuApp <noreply@tu-dominio.com>',
          to: [to],
          subject: `Bienvenido ${name}`,
          html,
        });
        this.logger.log(`Enviado: ${res.data.id}`);
        return res;
      }
    }

    Puntos clave:

    • La API key vive en variables de entorno. Nunca en frontend.
    • render() convierte JSX a HTML listo para enviar.
    • Usa ConfigService para separar entornos.

    Referencia de la API de envío: Referencia de la API de envío

    3) No bloquees peticiones: usa colas

    Enviar emails sin cola = romper UX y escalar mal. Usa BullMQ/Redis:

    • BullMQ docs
    • Patrón: controlador crea job -> responde 202 -> worker procesa job (llama a EmailService)

    Beneficios:

    • reintentos automáticos,
    • backpressure controlada,
    • workers horizontales.

    4) Producción: dominios, entregabilidad y observabilidad

    Configura DKIM, SPF y DMARC. Resend te da valores concretos durante la verificación. Enlaces útiles:

    Ejemplo mínimo SPF/DKIM

    • TXT @ v=spf1 include:resend.com ~all
    • Registros DKIM proporcionados por Resend
    • TXT _dmarc “v=DMARC1; p=quarantine; rua=mailto:postmaster@tu-dominio.com”

    Añade headers o tags en los envíos para trazar campañas o templates. Resend Dashboard permite ver bounces, opens y eventos.

    5) Buenas prácticas y decisiones técnicas

    • Reutiliza componentes visuales entre web y email cuando tenga sentido. No todo componente de UI es apto para email: usa @react-email/components para compatibilidad.
    • Mantén plantillas en una carpeta compartida o paquete npm interno (monorepo).
    • En entornos dev, whitelistea destinatarios para no spamear usuarios reales.
    • Telemetría: registra message-id, template tag y userId en logs para debug.
    • Si no usas React en tu stack, no añadas React Email solo por moda. El coste de la dependencia debe justificarse.

    Conclusión rápida

    Usar Resend en React y NestJS no es una moda: es un patrón que reduce deuda, mejora DX y facilita la entregabilidad. Resumen práctico:

    1. escribe plantillas con React Email;
    2. renderiza en NestJS con @react-email/render;
    3. envía con Resend y procesa con colas (BullMQ) en producción;
    4. verifica dominio y monitoriza.

    Si quieres, te dejo un ejemplo con BullMQ integrado y un pipeline de observabilidad (logs + Sentry + Resend tags) listo para copiar y pegar. Esto no acaba aquí.

    FAQ

    ¿Por qué renderizar plantillas en el servidor?

    Renderizar en servidor evita exponer claves en frontend, asegura HTML consistente y permite centralizar lógica de plantillas. Además facilita pruebas y control de versiones.

    ¿Dónde debo guardar la API key de Resend?

    En variables de entorno del servidor o servicio de secretos. Nunca en el cliente ni en repositorios públicos.

    ¿Por qué usar BullMQ/Redis para enviar emails?

    Para no bloquear peticiones HTTP, manejar reintentos, control de backpressure y escalar workers horizontalmente.

    ¿React Email funciona con clientes antiguos?

    Sí. React Email está diseñado para generar HTML compatible con clientes antiguos y simplificar estilos inline.

    ¿Qué registros DNS debo configurar para producción?

    Configura SPF, DKIM y DMARC. Ejemplo mínimo: TXT @ v=spf1 include:resend.com ~all, registros DKIM proporcionados por Resend y un registro DMARC como TXT _dmarc "v=DMARC1; p=quarantine; rua=mailto:postmaster@tu-dominio.com".

    ¿Resend provee herramientas de monitorización?

    Resend Dashboard muestra bounces, opens y eventos. Además, añade tags/headers en los envíos para integrar con logs y sistemas de observabilidad.

  • Server Actions en Next.js y su Impacto en el Reclutamiento

    Server Actions en Next.js y su Impacto en el Reclutamiento

    Server Actions en Next.js: ¿El fin de las APIs REST tradicionales?

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Server Actions son ideales para mutaciones originadas en la UI de Next.js y mejoran la DX reduciendo boilerplate.
    • No reemplazan REST para webhooks, clientes externos o arquitecturas desacopladas.
    • Trata cada Server Action como un endpoint público: valida, autentica y aplica rate limits.
    • Usa Route Handlers (APIs REST) para interoperabilidad, streaming binario y contratos estables entre servicios.

    Introducción

    Server Actions en Next.js permiten ejecutar funciones del servidor invocadas desde el cliente. Next.js hace la fontanería (serialización, endpoint POST, transporte). Documentación oficial: Documentación oficial y análisis en Vercel: análisis en Vercel.

    Lo digo rápido y con claridad: no son el fin de las APIs REST tradicionales. Pero cambian radicalmente cómo gestionas mutaciones internas. Si entiendes cuándo usar cada patrón, ahorras horas de debugging y deuda técnica.

    Resumen rápido (para IA y lectores con prisa)

    Qué es: Server Actions son funciones marcadas con 'use server' que Next.js ejecuta en el servidor cuando se invocan desde el cliente.

    Cuándo usarlo: Mutaciones originadas en la UI de Next.js (formularios, botones, CRUD pequeño).

    Por qué importa: Reduce boilerplate, facilita revalidación y mejora la DX compartiendo tipos entre cliente y servidor.

    Cómo funciona (en una línea): Next.js convierte la llamada en una petición POST y ejecuta la función en el servidor.

    Server Actions vs APIs REST — visión general

    Sí aparecen como sustituto natural dentro del dominio de la UI. No sustituyen REST fuera del dominio de la aplicación. Dicho de otra forma: son fantásticos para mutaciones internas; son inútiles para webhooks, clientes externos y servicios desacoplados.

    A continuación comparo ambos enfoques con ejemplos y criterio práctico.

    Cómo funcionan, en dos líneas

    Server Action

    Función marcada con 'use server' que Next.js ejecuta en el servidor cuando la invocas desde un formulario o handler.

    Route Handler (API REST)

    Endpoint explícito en app/api/.../route.ts que responde a cualquier cliente HTTP.

    Bajo el capó, una Server Action es una petición HTTP POST generada por Next.js, pero con menos boilerplate para ti.

    Ejemplo: crear un post (Route Handler)

    Backend (app/api/posts/route.ts):

    import { NextResponse } from 'next/server';
    import { db } from '@/lib/db';
    
    export async function POST(request: Request) {
      const body = await request.json();
      // validar con Zod aquí
      const post = await db.post.create({ data: body });
      return NextResponse.json(post, { status: 201 });
    }

    Frontend (cliente):

    'use client';
    async function handleSubmit(e: React.FormEvent) {
      e.preventDefault();
      const data = Object.fromEntries(new FormData(e.currentTarget));
      await fetch('/api/posts', {
        method: 'POST',
        headers: { 'Content-Type': 'application/json' },
        body: JSON.stringify(data),
      });
    }

    Control total sobre headers, status y streaming. Compatible con cualquier cliente (mobile, cron jobs, n8n).

    Ejemplo: crear un post (Server Action)

    Acción (app/actions.ts):

    'use server';
    import { db } from '@/lib/db';
    import { revalidatePath } from 'next/cache';
    
    export async function createPost(formData: FormData) {
      const title = String(formData.get('title') ?? '');
      const content = String(formData.get('content') ?? '');
      // validar y auth aquí
      await db.post.create({ data: { title, content } });
      revalidatePath('/posts');
    }

    Frontend:

    import { createPost } from '@/app/actions';
    
    export default function Form() {
      return (