Category: Angular

  • Testing en Angular con IA: tests que protegen de verdad

    Testing en Angular con IA: tests que protegen de verdad

    Le pedí a Claude que escribiera los tests de un componente de login. Me devolvió 14 tests. Todos verdes. El CI pasó sin problema.

    Dos semanas después, un bug llegó a producción. El formulario aceptaba contraseñas vacías si el campo estaba touched pero sin valor. Ninguno de esos 14 tests lo detectó.

    Los tests no fallaron porque el bug no existía para ellos. Los tests comprobaban que el componente existía, que el formulario se renderizaba, que el método onSubmit() se llamaba. No comprobaban el comportamiento. Eran tests de que el código había sido escrito, no de que el código hacía lo correcto.

    Este es el problema número uno del testing en Angular con IA: la IA genera tests que pasan, no tests que protegen.


    El problema real de los tests generados por IA

    Cuando le das a un modelo un componente Angular y le pides “escribe los tests”, le estás pidiendo que haga ingeniería inversa de tu implementación. Y eso es exactamente lo que hace.

    Lee el código. Ve que hay un loginForm con dos controles. Ve que hay un método onSubmit(). Ve que hay un AuthService. Y escribe tests que verifican que esas cosas existen y se llaman entre sí.

    El resultado son tests acoplados a la implementación, no al comportamiento. Si renombras onSubmit() a handleSubmit(), los tests fallan. Si cambias el nombre de una variable interna, los tests fallan. Pero si introduces un bug lógico — como que el formulario se envíe con campos vacíos — los tests siguen verdes.

    Esto no es un fallo del modelo. Es un fallo del prompt. Le preguntaste lo que no debías preguntar.

    Sin contexto del comportamiento esperado, la IA no tiene forma de saber qué casos importan. No sabe cuándo debería bloquearse el submit. No sabe qué errores deben mostrarse. Así que copia lo que ve: la implementación.


    El cambio de mentalidad que lo arregla todo

    No le pidas a la IA que escriba tests. Pídele que te ayude a pensar qué testear.

    Son dos tareas completamente distintas. La primera produce código. La segunda produce criterios. Y los criterios son lo que hace que un test sea útil.

    Un test útil parte de una pregunta: “¿qué debería pasar cuando X?” No de “¿qué hace este código?”

    El flujo correcto es este:

    1. Describe el comportamiento, no el código. No copies el componente en el prompt. Describe qué hace desde fuera. Qué ve el usuario. Qué espera. Qué debe pasar si hace algo incorrecto.
    2. Pídele que liste los casos de test. Solo los casos, sin código todavía.
    3. Revisa y aprueba esa lista. Añades los que faltan. Eliminas los redundantes. Este paso es el más valioso de todo el flujo — y es el que la mayoría de devs salta.
    4. Pide el código de test para cada caso. Con Jest y Testing Library, una vez que los criterios están claros.

    Ejemplo práctico con Angular 22

    Este es el componente. Un formulario de login con Reactive Forms en Angular 22:

    // login.component.ts
    import { Component, inject, signal } from '@angular/core';
    import { FormBuilder, ReactiveFormsModule, Validators } from '@angular/forms';
    import { Router } from '@angular/router';
    import { firstValueFrom } from 'rxjs';
    import { AuthService } from '../services/auth.service';
    
    @Component({
      selector: 'app-login',
      standalone: true,
      imports: [ReactiveFormsModule],
      template: `
        <form [formGroup]="form" (ngSubmit)="onSubmit()">
          <input formControlName="email" type="email" placeholder="Email" />
          <input formControlName="password" type="password" placeholder="Contraseña" />
          @if (errorMessage()) {
            <p class="error">{{ errorMessage() }}</p>
          }
          <button type="submit" [disabled]="form.invalid || isLoading()">
            {{ isLoading() ? 'Cargando...' : 'Entrar' }}
          </button>
        </form>
      `
    })
    export class LoginComponent {
      private fb = inject(FormBuilder);
      private auth = inject(AuthService);
      private router = inject(Router);
    
      form = this.fb.group({
        email: ['', [Validators.required, Validators.email]],
        password: ['', Validators.required]
      });
    
      errorMessage = signal('');
      isLoading = signal(false);
    
      async onSubmit() {
        if (this.form.invalid) return;
        this.isLoading.set(true);
        this.errorMessage.set('');
        try {
          await firstValueFrom(this.auth.login(this.form.value as { email: string; password: string }));
          this.router.navigate(['/dashboard']);
        } catch (err: any) {
          if (err.status === 401) {
            this.errorMessage.set('Credenciales incorrectas');
          }
        } finally {
          this.isLoading.set(false);
        }
      }
    }

    El prompt malo que genera tests inútiles:

    "Escribe los tests para este componente Angular."

    El prompt bueno, siguiendo el flujo de cuatro pasos:

    "Tengo un componente de login en Angular 22 con Reactive Forms.
    El comportamiento esperado es:
    - El botón está deshabilitado si el formulario es inválido o si está cargando
    - Al enviar credenciales válidas, se llama a AuthService.login()
    - Si AuthService lanza un error 401, se muestra 'Credenciales incorrectas'
    - Si tiene éxito, el router navega a /dashboard
    
    Lista primero los casos de test. Sin código todavía."

    Y estos son los tests resultantes con Jest y Testing Library para Angular:

    // login.component.spec.ts
    import { render, screen } from '@testing-library/angular';
    import userEvent from '@testing-library/user-event';
    import { LoginComponent } from './login.component';
    import { AuthService } from '../services/auth.service';
    import { provideRouter } from '@angular/router';
    import { of, throwError } from 'rxjs';
    
    describe('LoginComponent', () => {
      const mockAuthService = { login: jest.fn() };
    
      async function setup() {
        await render(LoginComponent, {
          providers: [
            { provide: AuthService, useValue: mockAuthService },
            provideRouter([{ path: 'dashboard', component: {} as any }])
          ]
        });
        return userEvent.setup();
      }
    
      beforeEach(() => jest.clearAllMocks());
    
      it('deshabilita el botón cuando el formulario está vacío', async () => {
        await setup();
        expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
      });
    
      it('deshabilita el botón con email inválido aunque haya contraseña', async () => {
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'no-es-email');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
      });
    
      it('habilita el botón con credenciales válidas', async () => {
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        expect(screen.getByRole('button', { name: /entrar/i })).not.toBeDisabled();
      });
    
      it('llama a AuthService.login al hacer submit con datos válidos', async () => {
        mockAuthService.login.mockReturnValue(of({}));
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        await user.click(screen.getByRole('button', { name: /entrar/i }));
        expect(mockAuthService.login).toHaveBeenCalledWith({
          email: 'user@test.com',
          password: '123456'
        });
      });
    
      it('muestra mensaje de error cuando el servicio responde 401', async () => {
        mockAuthService.login.mockReturnValue(throwError(() => ({ status: 401 })));
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), 'wrong');
        await user.click(screen.getByRole('button', { name: /entrar/i }));
        expect(await screen.findByText('Credenciales incorrectas')).toBeInTheDocument();
      });
    });

    La clave está en userEvent.type en lugar de fireEvent.input — con Reactive Forms en Angular, solo userEvent actualiza el FormControl correctamente en el entorno de test. Y el mock usa of({}) y throwError() de RxJS porque AuthService.login() devuelve un Observable.

    Esto es exactamente el enfoque que trabajamos en el curso de Testing en Angular con Jest y Testing Library: probar comportamiento, no implementación.


    Tests de servicios con IA: qué mockear y cómo describirlo

    Los servicios son donde más fácil es equivocarse al usar IA para testing.

    El error más común: pedirle a la IA que mockee el propio servicio para testearlo. Si mockeas AuthService en el test de AuthService, estás probando el mock, no el servicio.

    Lo que debes describirle a la IA es esto:

    "Tengo un AuthService en Angular 22 que inyecta HttpClient.
    El método login() hace POST a /api/auth/login con email y password.
    Devuelve un Observable<User>. En caso de error HTTP lo relanza tal cual.
    Escribe los tests usando provideHttpClient() + provideHttpClientTesting() y HttpTestingController.
    No mockees el servicio. Mockea solo el HttpClient."

    Con ese prompt, la IA sabe exactamente qué nivel de la pila debe sustituir:

    // auth.service.spec.ts
    import { TestBed } from '@angular/core/testing';
    import { HttpTestingController, provideHttpClientTesting } from '@angular/common/http/testing';
    import { provideHttpClient } from '@angular/common/http';
    import { AuthService } from './auth.service';
    
    describe('AuthService', () => {
      let service: AuthService;
      let httpMock: HttpTestingController;
    
      beforeEach(() => {
        TestBed.configureTestingModule({
          providers: [AuthService, provideHttpClient(), provideHttpClientTesting()]
        });
        service = TestBed.inject(AuthService);
        httpMock = TestBed.inject(HttpTestingController);
      });
    
      afterEach(() => httpMock.verify());
    
      it('hace POST a /api/auth/login con las credenciales', () => {
        const credentials = { email: 'user@test.com', password: '123456' };
        service.login(credentials).subscribe();
        const req = httpMock.expectOne('/api/auth/login');
        expect(req.request.method).toBe('POST');
        expect(req.request.body).toEqual(credentials);
        req.flush({ id: 1, email: 'user@test.com' });
      });
    
      it('devuelve el usuario cuando el servidor responde con éxito', () => {
        const mockUser = { id: 1, email: 'user@test.com' };
        let result: any;
        service.login({ email: 'user@test.com', password: '123456' })
          .subscribe(user => (result = user));
        httpMock.expectOne('/api/auth/login').flush(mockUser);
        expect(result).toEqual(mockUser);
      });
    
      it('relanza el error HTTP cuando el servidor responde 401', () => {
        let error: any;
        service.login({ email: 'user@test.com', password: 'wrong' })
          .subscribe({ error: err => (error = err) });
        httpMock.expectOne('/api/auth/login').flush(
          { message: 'Unauthorized' },
          { status: 401, statusText: 'Unauthorized' }
        );
        expect(error.status).toBe(401);
      });
    });

    La clave está en la instrucción: “mockea solo el HttpClient”. Esa precisión es lo que separa un prompt que genera tests útiles de uno que genera ruido.

    Si quieres ver cómo aplicar este patrón a servicios más complejos — con interceptores, state management y Signals — en el curso de Angular Moderno tienes la arquitectura base sobre la que todo esto encaja.


    Lo que la IA no puede hacer por ti

    La IA puede generar el código de test más rápido de lo que tú lo escribirías. No puede decirte qué casos importan en tu dominio de negocio.

    No sabe que en tu aplicación una contraseña vacía tiene un tratamiento especial. No sabe que hay un edge case cuando el usuario tiene sesión expirada y reintenta. No sabe que el botón de carga es crítico porque en producción la red va lenta y los usuarios hacen doble click.

    Ese conocimiento solo lo tienes tú. Tu trabajo es trasladarlo al prompt antes de pedir código. La IA amplifica lo que le das — si le das una descripción de comportamiento, amplifica eso. Si le das solo el código de implementación, amplifica eso.

    El flujo de cuatro pasos no es burocracia. Es el mínimo para que la IA genere tests que protejan algo.

    Si quieres llevar esta forma de trabajar más lejos — combinando especificaciones previas al código con IA para que los tests sean parte del diseño — eso es lo que construimos en el curso Construye con IA: de la Idea al Producto. Y si quieres acceso a los proyectos completos con suites de tests reales, los encontrarás en Dominicode Labs.


    FAQ

    ¿Puedo usar cualquier modelo de IA o Claude es el mejor para esto?

    El flujo de cuatro pasos funciona con cualquier modelo — Claude, GPT-4o, Gemini. La calidad del output depende mucho más de la calidad del prompt que del modelo. Dicho esto, Claude tiene ventaja en identificar casos borde cuando describes comportamientos complejos con muchas condiciones.

    ¿La IA puede generar tests TDD, es decir, antes de escribir el componente?

    Sí, y es el flujo ideal. Describes el comportamiento, pides los casos, apruebas la lista, pides el código de test — y luego le pides que implemente el componente para que esos tests pasen. Es TDD asistido por IA, y es especialmente potente para componentes nuevos.

    ¿Testing Library o Spectator para Angular?

    Testing Library porque te obliga a pensar en términos de comportamiento desde el principio. getByRole, getByPlaceholderText, findByText — todas esas queries buscan lo que el usuario ve, no lo que el código tiene internamente. Spectator facilita demasiado el acceso directo a la instancia del componente, lo que lleva a tests acoplados a implementación.

    ¿Cómo sé si un test generado por IA es bueno?

    Una heurística sencilla: introduce manualmente el bug más obvio en el componente y corre los tests. Si los tests siguen verdes, no valen nada. Por ejemplo, en el componente de login, pon if (true) return; al principio de onSubmit() — si el test de “llama a AuthService.login” sigue pasando, ese test no prueba nada. Esta técnica se llama mutation testing.

    ¿Vale la pena testear componentes de presentación puros?

    Depende de la complejidad. Un componente que solo muestra datos sin lógica condicional no necesita tests exhaustivos. Pero si tiene lógica de visualización — mostrar un badge según el estado, calcular clases CSS condicionalmente — esa lógica sí merece tests. Pregúntale a la IA: “¿qué comportamientos condicionales tiene este template que merecen ser testados?”


    *Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*
  • El grafo reactivo de Angular: cómo Signals sabe qué recalcular

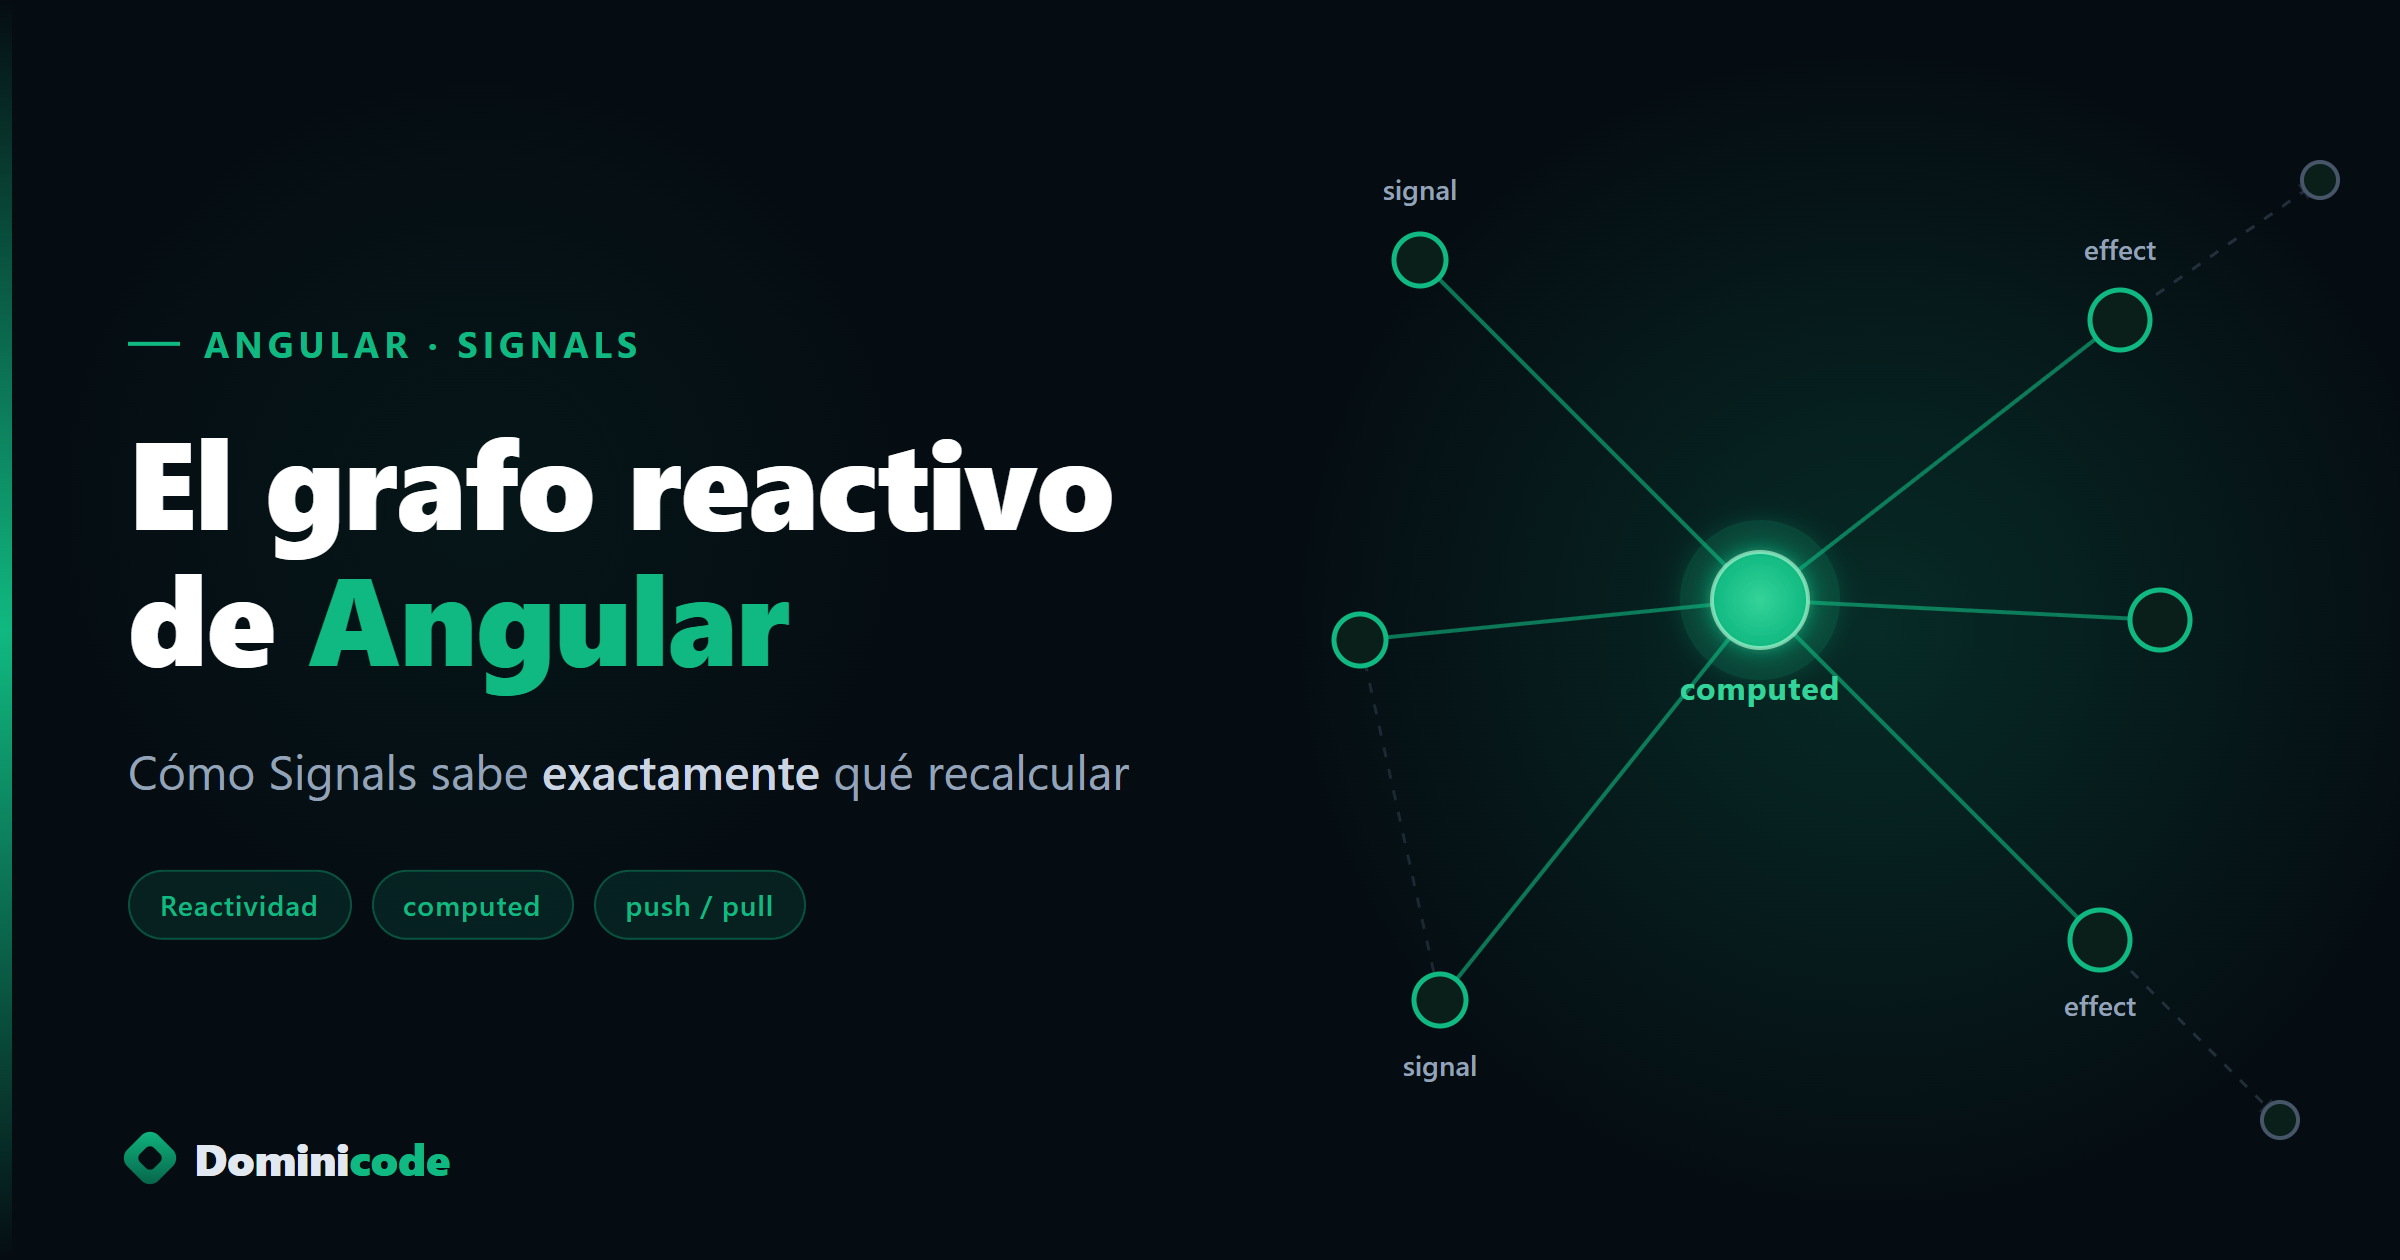
    El grafo reactivo de Angular: cómo Signals sabe qué recalcular

    Un junior del equipo me enseñó hace poco un computed() que calculaba el total de un carrito. Funcionaba. Pero me dijo una frase que lo delata todo: “le metí un console.log dentro y no se imprime cuando cambio la cantidad… hasta que abro el modal del total”.

    No estaba roto. Estaba haciendo exactamente lo que debe hacer.

    El problema no era su código. Era su modelo mental. No conocía el grafo reactivo de Angular, la estructura que decide qué se recalcula y cuándo. Pensaba que un computed() se recalcula cuando cambian sus datos. Y no. Se recalcula cuando alguien lo lee. Esa diferencia, que parece un detalle, es la puerta de entrada a entender cómo piensa Angular por dentro.

    Porque eso es justo lo que vive debajo de signal(), computed() y effect(): un grafo que casi nadie se molesta en entender, y que lo explica todo.

    ¿Qué es el grafo reactivo de Angular?

    El grafo reactivo de Angular es la estructura interna que el framework construye con su sistema de Signals para saber, en todo momento, qué valores dependen de qué otros. No es una API que tú llamas. Es el motor que se monta solo cuando declaras signals, computeds y effects, y es lo que permite que Angular recalcule únicamente lo que cambió en lugar de revisar la aplicación entera.

    Los Signals son estables desde Angular 16-17 (2023), y son la base sobre la que se apoya el modo zoneless, disponible como opción de producción a partir de Angular v20.

    Imagínalo literalmente como un grafo: nodos conectados por flechas. Los nodos son tus valores reactivos. Las flechas son las dependencias entre ellos. Cuando un valor cambia, Angular recorre esas flechas para decidir qué tocar y qué dejar en paz.

    Y la clave —la que casi nadie explica— es que esas flechas no las dibujas tú. Las descubre Angular en tiempo de ejecución.

    Vamos por partes.

    Los nodos: productores y consumidores

    Todo en el grafo es una de dos cosas (o las dos a la vez). Te lo presento como modelo conceptual, no como API pública: Angular no te expone estos nombres, pero entenderlos cambia cómo lees tu propio código.

    • Un signal() es un productor puro. Tiene un valor, otros lo leen, pero él no depende de nadie. Es una raíz del grafo.
    • Un computed() es consumidor y productor a la vez. Lee otros signals (consume) y a su vez otros lo leen a él (produce). Es un nodo intermedio.
    • Un effect() es un consumidor puro. Lee signals y reacciona, pero nadie lee a un effect. Es una hoja del grafo, el final de la cadena.
    import { signal, computed, effect } from '@angular/core';
    
    const precio = signal(100);          // productor puro (raíz)
    const cantidad = signal(2);          // productor puro (raíz)
    
    const total = computed(() =>         // consumidor (lee precio y cantidad)
      precio() * cantidad());            // + productor (otros leerán 'total')
    
    effect(() => {                       // consumidor puro (hoja)
      console.log('Total actual:', total());
    });

    El grafo aquí tiene una forma clarísima: precio y cantidad apuntan a total, y total apunta al effect. Cuatro nodos, tres flechas.

    Pero tú no escribiste ni una sola de esas flechas.

    Las aristas: tracking dinámico de dependencias

    Aquí está la primera idea que separa a quien usa signals de quien los entiende.

    Las dependencias no se declaran. Angular las descubre.

    Cuando un computed() o un effect() se ejecuta, Angular activa un registro temporal: “todo signal que se lea durante esta ejecución se anota como dependencia”. Lees precio() dentro del computed → se crea la flecha precio → total. Lees cantidad() → se crea cantidad → total. Termina la ejecución, se cierra el registro.

    Esto tiene una consecuencia preciosa: las dependencias pueden ser condicionales. Cada ejecución puede producir un conjunto distinto de aristas.

    const modoOscuro = signal(false);
    const colorClaro = signal('#ffffff');
    const colorOscuro = signal('#1a1a1a');
    
    const colorFondo = computed(() => {
      if (modoOscuro()) {
        return colorOscuro();   // solo se lee si modoOscuro es true
      }
      return colorClaro();      // solo se lee si modoOscuro es false
    });

    Cuando modoOscuro es false, este computed depende de modoOscuro y de colorClaro. No depende de colorOscuro en absoluto. Si cambias colorOscuro mientras estás en modo claro, colorFondo no se marca como sucio, no se recalcula, no pasa nada.

    Cambia modoOscuro a true y, en el siguiente recálculo, el grafo se reconfigura: ahora la flecha sale de colorOscuro y la de colorClaro desaparece.

    Esto no lo consigues gratis con RxJS combinando observables. Aquí es el comportamiento por defecto, sin esfuerzo. Es exactamente este tipo de detalle el que trabajamos a fondo en el curso de Angular Moderno, porque entender el grafo cambia cómo estructuras el estado de toda la app.

    Push y pull: por qué el computed de mi compañero no se ejecutaba

    Volvamos a la historia del principio. El console.log que no se imprimía.

    El grafo reactivo funciona con dos fases distintas, y casi todo el mundo solo conoce la primera.

    Fase push (cuando cambias un signal). Llamas a cantidad.set(5). Angular recorre el grafo hacia abajo y marca a los consumidores como “sucios” (stale). total se marca sucio. El effect que depende de total se marca sucio. Y ya. No se recalcula nada todavía. Solo se propaga una marca de “esto podría haber cambiado”.

    Fase pull (cuando alguien lee). El valor de un computed() solo se recalcula cuando alguien lo lee y está marcado sucio. Es perezoso (lazy) y memoizado: si nadie lo lee, no se ejecuta jamás.

    const a = signal(1);
    const b = signal(2);
    
    const suma = computed(() => {
      console.log('¡Calculando suma!');   // ¿cuándo se imprime esto?
      return a() + b();
    });
    
    a.set(10);
    a.set(20);
    a.set(30);
    // Hasta aquí: el log NO se ha impreso ni una vez.
    
    console.log(suma());  // AHORA imprime "¡Calculando suma!" y luego 32
    console.log(suma());  // NO vuelve a imprimir: valor memoizado

    Tres cambios en a y cero recálculos, porque nadie leyó suma. La leemos una vez y se calcula una vez. La leemos de nuevo sin cambios de por medio y devuelve el valor cacheado sin recalcular.

    Por eso el computed() del carrito “no se ejecutaba” hasta abrir el modal: ningún template estaba leyendo ese valor. En cuanto el modal lo renderizó, lo leyó, y entonces —y solo entonces— se recalculó.

    No era un bug. Era el grafo trabajando exactamente como debe: no malgastar ni un ciclo de CPU en valores que nadie está mirando.

    Consistencia glitch-free: nunca verás un estado intermedio falso

    Pregunta incómoda: ¿qué pasa cuando un nodo depende del mismo origen por dos caminos distintos?

    const base = signal(10);
    
    const doble = computed(() => base() * 2);
    const triple = computed(() => base() * 3);
    
    const resumen = computed(() => `${doble()} y ${triple()}`);

    resumen depende de doble y de triple, y ambos dependen de base. Hay dos rutas desde base hasta resumen.

    Cuando cambias base, un sistema reactivo mal diseñado podría recalcular resumen dos veces (una por cada ruta) o, peor, calcularlo con doble ya actualizado pero triple todavía viejo. Eso es un glitch: un estado intermedio que nunca debió existir.

    El grafo de Angular es glitch-free. Ante un cambio en base, resumen se recalcula una sola vez, y cuando lo hace, tanto doble como triple ya están coherentes. Nunca observas la mezcla rara. El orden de evaluación del grafo (pull bajo demanda) junto con el versionado de cada nodo garantizan que un consumidor con varias rutas hacia el mismo origen converja en un único recálculo consistente.

    Esto importa de verdad en producción. Es la diferencia entre una UI que parpadea con valores intermedios y una que actualiza limpio.

    Versiones e igualdad: la poda que ahorra renders

    Aquí entra el matiz que convierte el grafo en algo eficiente y no solo correcto.

    Cada productor lleva, conceptualmente, una versión. Cuando un consumidor está sucio y va a recalcular, primero compara: “¿la versión de mis dependencias cambió de verdad respecto a la última vez que las usé?”. Si nada cambió realmente, no recomputa.

    Y hay una segunda poda, más conocida: la función de igualdad. Por defecto, un signal usa Object.is para decidir si el nuevo valor es distinto del anterior. Si haces set con un valor igual al actual, el grafo no propaga nada aguas abajo.

    const estado = signal('activo');
    
    const etiqueta = computed(() => {
      console.log('Recalculando etiqueta');
      return estado().toUpperCase();
    });
    
    etiqueta();              // imprime "Recalculando etiqueta" → "ACTIVO"
    estado.set('activo');    // mismo valor: Object.is da true → NO propaga
    etiqueta();              // NO recalcula: el grafo nunca se marcó sucio

    Puedes personalizar esa comparación cuando trabajas con objetos:

    const usuario = signal(
      { id: 1, nombre: 'Ana' },
      { equal: (a, b) => a.id === b.id }   // igual si el id no cambia
    );

    Ahora, si emites un objeto nuevo con el mismo id, el grafo lo considera igual y corta la propagación ahí mismo. Menos recálculos, menos renders. Esta equal es tu palanca para podar el grafo a mano cuando lo necesitas.

    Effects y el scheduler: por qué no son síncronos

    Un detalle que confunde: los effect() no corren en el instante exacto en que cambias un signal.

    Cuando un signal del que depende un effect cambia, el effect se marca sucio y se agenda (scheduler). Angular lo ejecuta de forma agrupada, ligado normalmente a su ciclo de detección de cambios. Esto evita que un effect se dispare diez veces si haces diez set seguidos en la misma tarea: se ejecuta una vez, con el estado final.

    const x = signal(0);
    
    effect(() => console.log('x es', x()));
    
    x.set(1);
    x.set(2);
    x.set(3);
    // El effect NO imprime tres veces seguidas.
    // Se agenda y corre una vez, con el valor final: "x es 3"

    Si vienes de pensar en callbacks síncronos, este es el ajuste mental que necesitas. El effect reacciona, pero reacciona cuando toca, no a cada microcambio.

    El contraste que lo explica todo: grafo vs. Zone.js

    Ahora la pieza que da sentido a todo lo anterior.

    Durante años, Angular detectó cambios con Zone.js + dirty checking. El modelo era de fuerza bruta: cuando algo podía haber cambiado (un click, un timeout, una respuesta HTTP), Angular recorría todo el árbol de componentes comprobando cada binding por si acaso. Funcionaba, pero el framework no sabía qué había cambiado. Solo sabía que algo pudo cambiar, y revisaba entero por si las moscas.

    El grafo reactivo invierte el modelo. Angular ya no necesita preguntar “¿cambió algo en alguna parte?”. El propio grafo sabe exactamente qué signal cambió y qué nodos dependen de él. La actualización deja de ser una búsqueda y pasa a ser una notificación dirigida.

    Zone.js + dirty checking Grafo reactivo (Signals)
    ¿Qué sabe el framework? Que algo pudo cambiar Qué signal cambió exactamente
    Alcance de la revisión Todo el árbol de componentes Solo el nodo y sus dependientes
    Disparo Cualquier evento async (click, timeout, HTTP) El cambio concreto de un signal
    Coste Proporcional al tamaño del árbol Proporcional a lo que de verdad cambió
    Viabilidad zoneless No (necesita Zone.js) Sí (Angular puede prescindir de Zone.js)

    Esto es la base técnica de zoneless —opción de producción desde Angular v20— y de la detección de cambios granular: si todo tu estado vive en signals, Angular puede prescindir de Zone.js por completo, porque el grafo ya le dice qué refrescar. Pasas de “revisa todo el árbol por si acaso” a “actualiza este nodo y sus tres dependientes, nada más”.

    Si quieres ver dónde encaja esto en la versión actual, lo cuento en detalle en las novedades de Angular v22, y cómo este mismo grafo gobierna la carga de datos asíncrona en el post sobre la Resource API de Angular 22.

    Qué puedes hacer con esto hoy

    No necesitas memorizar internals para escribir signals. Pero con este modelo en la cabeza dejas de programar a ciegas:

    1. Mete tu lógica derivada en computed() sin miedo a la performance: si nadie lo lee, no cuesta nada.
    2. Deja de “optimizar” recálculos a mano — el grafo ya memoiza y poda por ti.
    3. Usa equal personalizado cuando trabajes con objetos y veas renders de más.
    4. Mueve estado de RxJS a signals donde la lógica sea síncrona y derivada; reserva RxJS para flujos de eventos reales.

    La próxima vez que un computed() “no se ejecute cuando esperabas”, ya no vas a pensar que está roto. Vas a saber que el grafo está esperando, perezoso y eficiente, a que alguien lea el valor.

    Si quieres dominar Signals con esta profundidad —el grafo, los effects, la migración desde RxJS y los patrones que aguantan en producción— eso es justo lo que construimos paso a paso en el curso de Angular Moderno. Y si quieres seguir afilando el modelo mental con la comunidad, te espero en Dominicode Labs.

    Preguntas frecuentes

    ¿El grafo reactivo es lo mismo que los Signals?

    No exactamente. Los Signals (signal, computed, effect) son las APIs que tú usas; el grafo reactivo es la estructura interna que Angular construye a partir de ellas para saber qué depende de qué. Tú escribes signals; Angular monta el grafo automáticamente por debajo.

    ¿Necesito entender el grafo reactivo para usar Signals?

    Para escribir código que funcione, no. Para escribir código eficiente y entender por qué un computed() se comporta como lo hace —cuándo recalcula, cuándo no, por qué no parpadea— sí. Es la diferencia entre usar signals y dominarlos.

    ¿El grafo reactivo reemplaza a RxJS?

    No lo reemplaza, lo complementa. El grafo de Signals brilla en estado síncrono y valores derivados. RxJS sigue siendo la mejor herramienta para flujos de eventos complejos, streams asíncronos y operadores como debounce o switchMap. Muchos proyectos usan ambos: signals para el estado, RxJS para los flujos.

    ¿Qué relación tiene con zoneless?

    Total. El modo zoneless elimina Zone.js, y solo es viable porque el grafo reactivo ya le dice a Angular exactamente qué cambió y qué refrescar. Sin el grafo, Angular tendría que volver a revisar todo el árbol de componentes. El grafo es la condición que hace posible zoneless.

    ¿Un computed() se ejecuta siempre que cambian sus datos?

    No. Es perezoso: se marca como “sucio” cuando cambia una dependencia, pero solo se recalcula de verdad cuando alguien lee su valor. Si nadie lo lee, no se ejecuta. Y una vez calculado, devuelve un valor memoizado hasta que cambie alguna dependencia.

    ¿Cómo evita Angular recalcular un valor dos veces ante un mismo cambio?

    Gracias a la consistencia glitch-free y al versionado de nodos. Si un consumidor depende de un mismo origen por varias rutas, el grafo lo recalcula una sola vez y con valores coherentes, sin estados intermedios falsos ni recálculos duplicados.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Novedades de Angular v22: todo lo que cambia en esta versión

    Novedades de Angular v22: todo lo que cambia en esta versión

    Un compañero me preguntó la semana pasada: “¿Merece la pena actualizar ya a Angular v22?”.

    Le respondí lo mismo que le diría a ti: las novedades de Angular v22 no son parches ni renombrados. Son APIs nuevas que reemplazan patrones que llevan años instalados en nuestra cabeza — y varias de ellas pasan a ser estables en esta versión. Si llevas tiempo esperando que Angular se parezca a lo que promete ser, v22 es esa versión.

    Afecta cómo gestionas estado asíncrono, cómo escribes formularios, cómo arranca la detección de cambios y cómo declaras componentes. Todo a la vez. En una sola versión.

    Este post es el mapa. Si quieres ir al detalle de alguna feature concreta, tienes posts específicos linkados donde corresponde.

    ¿Qué es Angular v22? Angular v22 es la versión que consolida las Signal APIs como estándar principal del framework. Introduce la Resource API estable (resource(), rxResource()), el nuevo decorator @Service(), Signal Forms experimental, y avanza en zoneless como camino recomendado para proyectos nuevos. Es la versión con más cambios de fondo desde que Angular adoptó standalone components.


    Qué cambia de raíz en Angular v22

    Antes de ver las APIs una a una, hay una idea central que explica casi todo lo que trae v22:

    Angular se está moviendo hacia un modelo completamente basado en Signals, sin Zones y sin boilerplate innecesario.

    Eso no es nuevo como dirección. Lo que es nuevo en v22 es que varias piezas de ese puzzle pasan a ser estables o por lo menos usables en producción experimental. Ya no es solo teoría.

    Patrón anterior vs equivalente en Angular v22

    Patrón anterior Equivalente en Angular v22
    HttpClient.get().subscribe() httpResource() (experimental)
    Subject + switchMap resource() / rxResource() (estables)
    new FormControl() Signal Forms formField() (experimental)
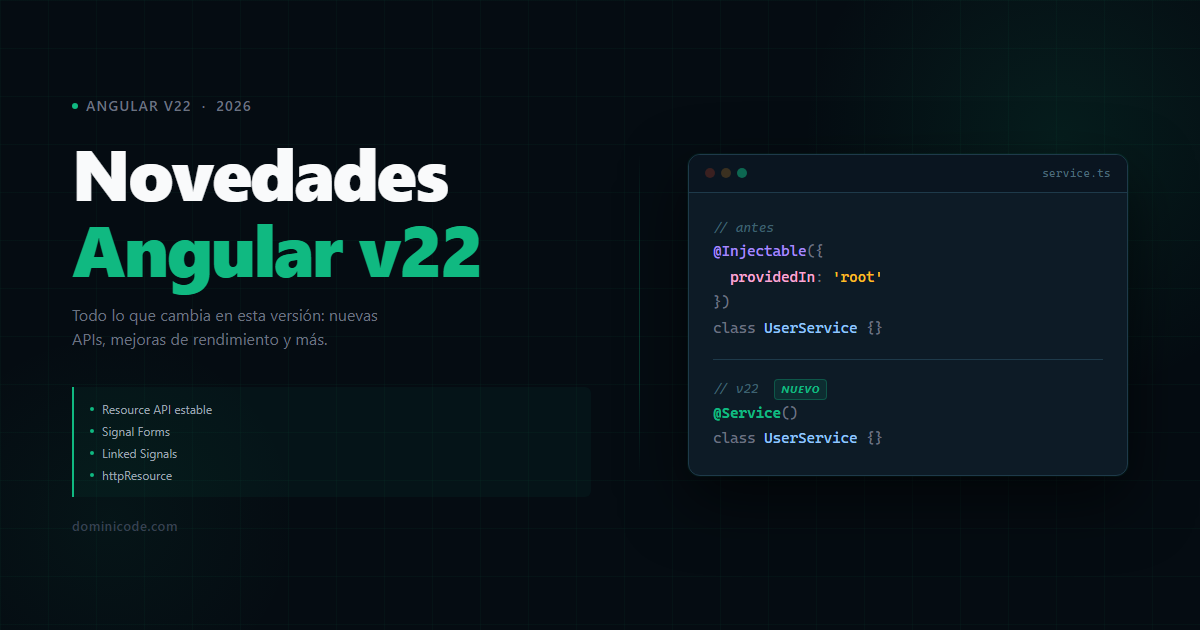
    @Injectable({ providedIn: 'root' }) @Service() (estable)
    ChangeDetectionStrategy.Default ChangeDetectionStrategy.Eager
    standalone: true explícito Default desde v22 — ya no hace falta
    allowSignalWrites: true en effect Eliminado — ya no necesario

    Resource API en Angular v22: gestión de estado asíncrono sin subscribe

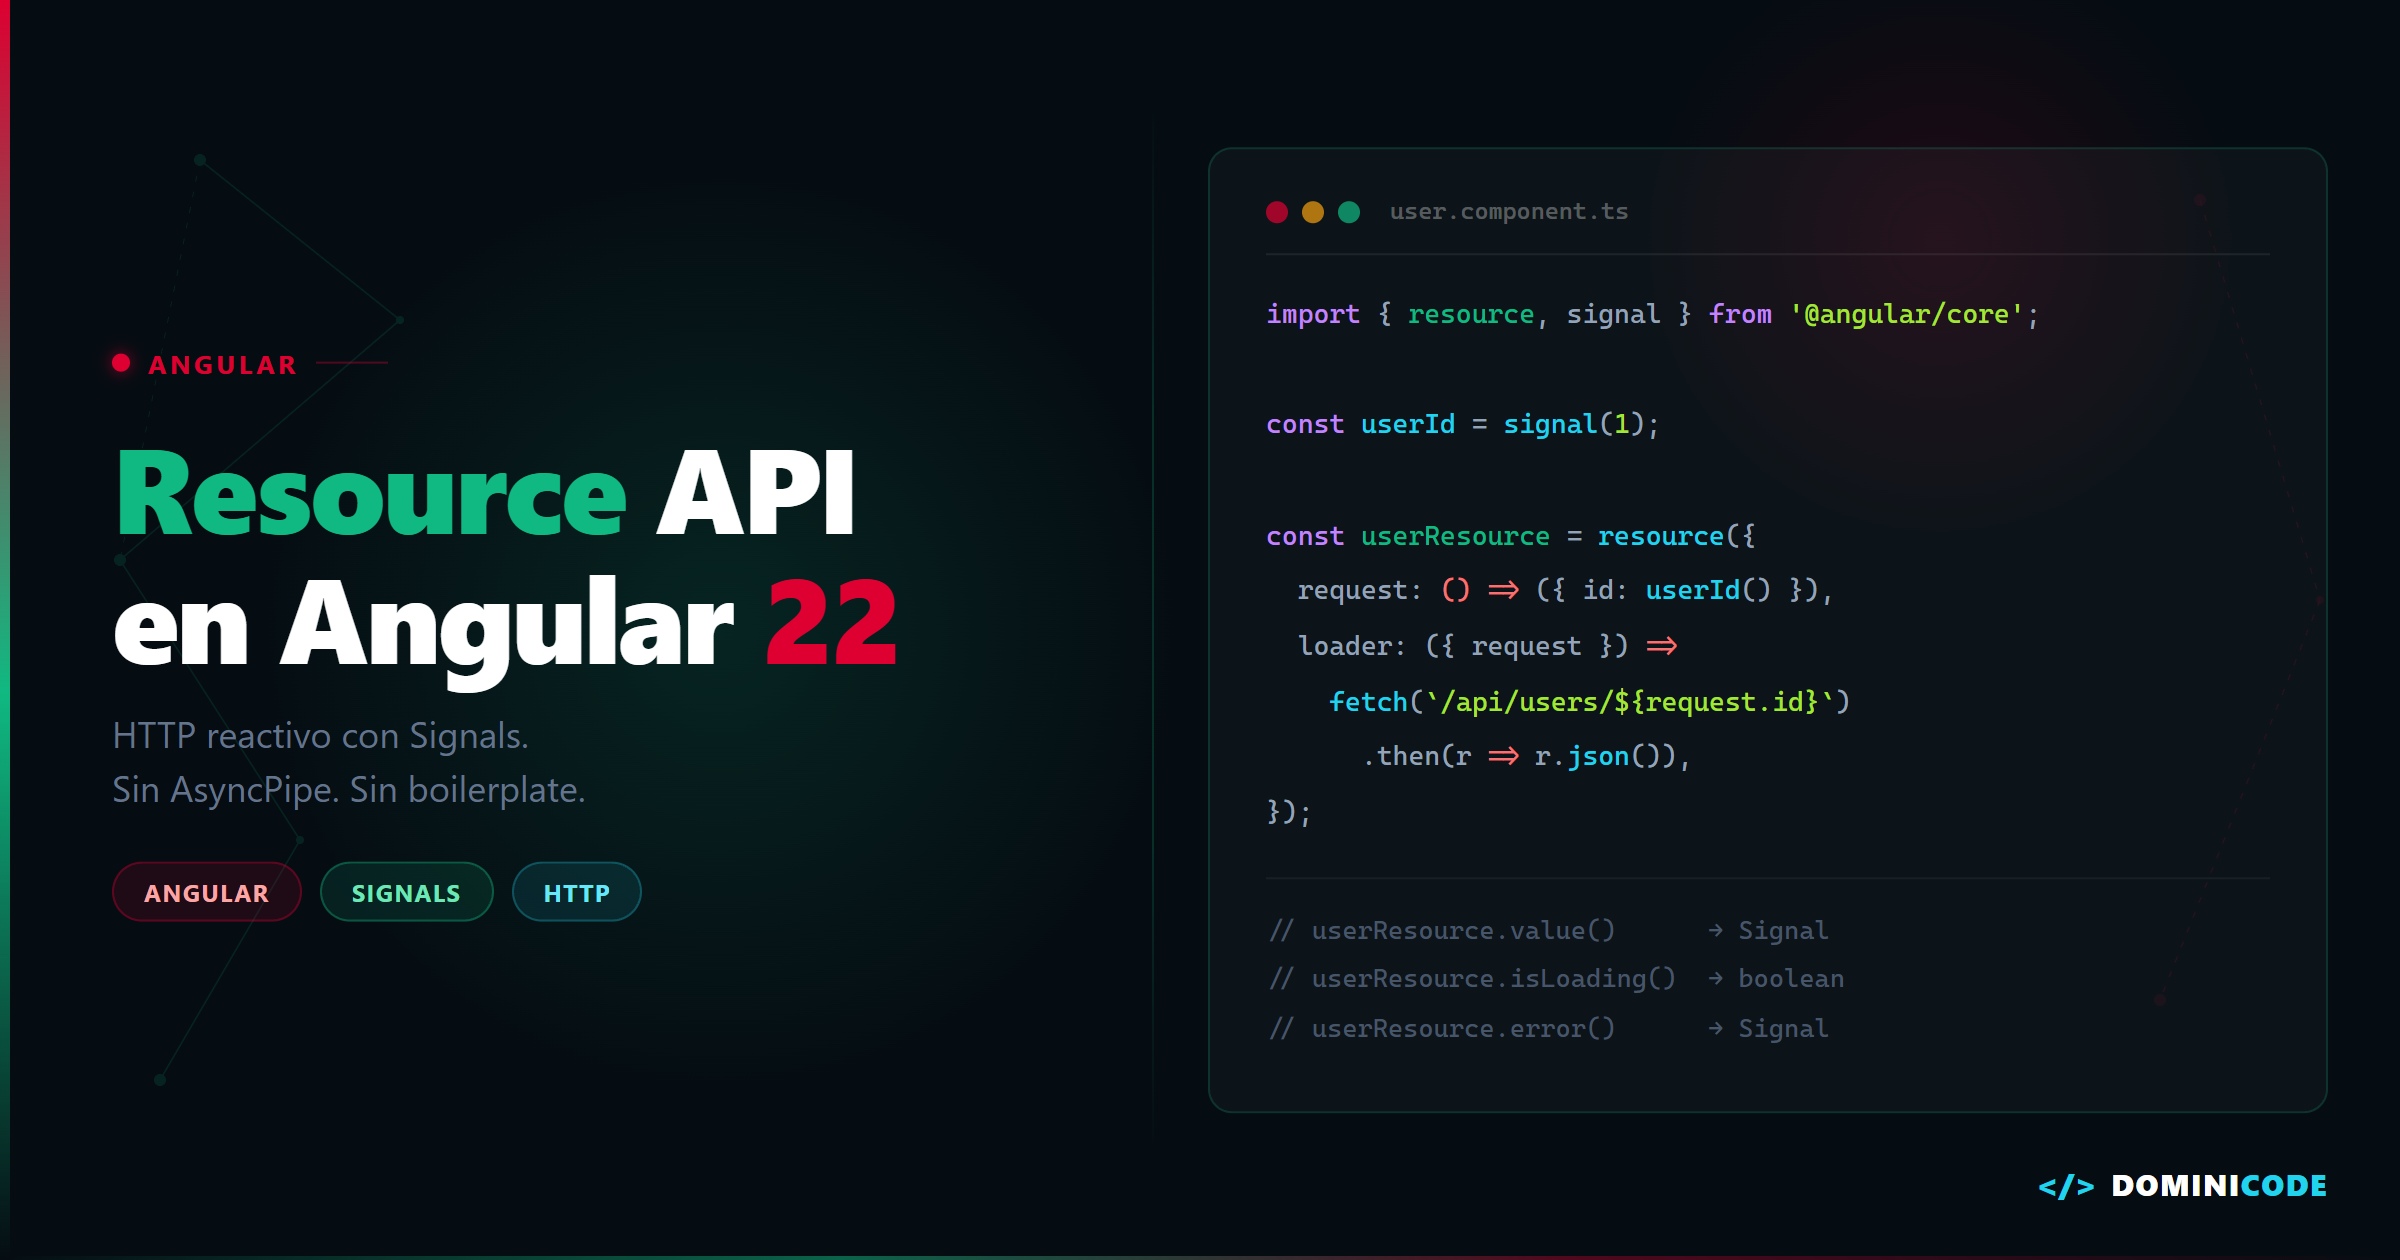
    La novedad más importante de Angular v22 en el día a día son las tres APIs de Resource. resource() y rxResource() pasan a ser estables:

    resource() — async state sin subscribe

    resource() es la forma nativa de Angular para manejar operaciones asíncronas reactivas. Defines un loader con una Promise y el framework gestiona loading, error y datos por ti.

    import { resource, signal } from '@angular/core';
    

    @Component({ ... })

    export class ProductListComponent {

    categoryId = signal(1);

    products = resource({

    request: () => this.categoryId(),

    loader: ({ request }) =>

    fetch(/api/products?category=${request}).then(r => r.json())

    });

    }

    En el template:

    @if (products.status() === 'loading') {
    

    <p>Cargando...</p>

    }

    @if (products.status() === 'resolved') {

    @for (product of products.value(); track product.id) {

    <li>{{ product.name }}</li>

    }

    }

    Los estados posibles son strings literales: 'idle', 'loading', 'reloading', 'resolved', 'error', 'local'. No hay enum. No uses ResourceStatus.Loading — no existe así.

    rxResource() — cuando el backend habla en Observables

    Si tienes servicios que devuelven Observables (la mayoría de los proyectos reales), usa rxResource(). La clave es que el parámetro se llama stream, no loader:

    import { rxResource } from '@angular/core/rxjs-interop';
    

    @Component({ ... })

    export class OrdersComponent {

    userId = signal(42);

    orders = rxResource({

    request: () => this.userId(),

    stream: ({ request }) => this.ordersService.getByUser(request)

    });

    }

    La diferencia con resource() es solo el parámetro: loader para Promises, stream para Observables. El resto del comportamiento es idéntico.

    httpResource() — HTTP reactivo sin HttpClient.get().pipe(...)

    httpResource() es la versión experimental especializada en HTTP — úsala con precaución en producción. El primer argumento siempre es una función, nunca un string directo.

    import { httpResource } from '@angular/core';
    

    @Component({ ... })

    export class UserProfileComponent {

    userId = signal(1);

    user = httpResource<User>(() => /api/users/${this.userId()});

    }

    Requiere provideHttpClient() en tu configuración. Devuelve un HttpResourceRef que expone .value(), .status(), .statusCode() y .headers() como signals.

    Si quieres profundidad en las tres APIs, tengo un post dedicado: Resource API en Angular 22: el fin del subscribe() manual.


    linkedSignal() estable: el signal derivado que puedes escribir

    linkedSignal() resuelve un problema concreto que no tenía solución limpia hasta ahora: quieres un signal que se inicialice (y se resetee) a partir de otro signal, pero que también puedas modificar manualmente.

    Ejemplo clásico: una lista de items y un item seleccionado que vuelve al primero cuando cambia la lista.

    import { signal, linkedSignal } from '@angular/core';
    

    @Component({ ... })

    export class ItemSelectorComponent {

    items = signal(['Angular', 'React', 'Vue']);

    selectedItem = linkedSignal(() => this.items()[0]);

    }

    Cuando items cambia, selectedItem vuelve automáticamente al primer elemento. Pero puedes escribir en selectedItem en cualquier momento:

    this.selectedItem.set('React'); // funciona

    Con un computed() no puedes hacer eso. Con un signal() normal perderías el vínculo con items. linkedSignal() es la pieza que faltaba entre los dos.


    debounced() experimental: búsquedas sin setTimeout manual

    debounced() es una API experimental de Angular v22 para manejar valores con delay configurable. No devuelve un Signal — devuelve un Resource, así que se lee con .value() y .status(), igual que resource().

    Es ideal para barras de búsqueda donde no quieres disparar una petición por cada tecla. Al ser experimental, la firma exacta puede cambiar antes de estabilizarse — consulta siempre la documentación oficial de angular.dev antes de usarla en producción.


    Signal Forms experimental: formularios basados en Signals

    Angular v22 introduce Signal Forms como API experimental. No reemplaza a Reactive Forms todavía — no está pensado para producción sin asumir el riesgo de breaking changes — pero marca la dirección clara hacia la que van los formularios en Angular.

    La premisa es eliminar el FormBuilder, los FormGroup y los valueChanges basados en Observables. Todo como signals.

    Es la feature que más puede cambiar antes de estabilizarse, así que úsala con precaución en proyectos reales y estate pendiente a las release notes.


    effect() ya no necesita allowSignalWrites

    Pequeño pero importante: a partir de v22, escribir en un signal dentro de un effect() está permitido por defecto. La opción allowSignalWrites está deprecada y no debes usarla.

    Antes (v21 y anteriores):

    // v21 — necesitabas esto:
    

    effect(() => {

    this.count.set(this.source() * 2);

    }, { allowSignalWrites: true });

    Ahora (v22):

    // v22 — simplemente funciona:
    

    effect(() => {

    this.count.set(this.source() * 2);

    });

    Si tienes código con allowSignalWrites: true, no se rompe todavía. Pero el compilador te avisará que está deprecated. Es uno de esos cambios que limpias en 10 minutos con un find & replace.


    ChangeDetectionStrategy.Eager y el adiós definitivo a Default

    Angular v22 introduce ChangeDetectionStrategy.Eager como el nuevo nombre para la estrategia de detección de cambios que antes se llamaba Default.

    ChangeDetectionStrategy.Default pasa a ser un alias deprecated de Eager. Si tienes componentes sin estrategia explícita, no se rompen, pero la nomenclatura oficial cambia:

    // Antes (sigue funcionando, pero deprecated el nombre):
    

    @Component({

    changeDetection: ChangeDetectionStrategy.Default

    })

    // Ahora (lo correcto en v22):

    @Component({

    changeDetection: ChangeDetectionStrategy.Eager

    })

    En la práctica, para componentes nuevos lo relevante sigue siendo usar OnPush cuando sea posible y avanzar hacia zoneless. Eager es el fallback explícito cuando necesitas el comportamiento clásico por nombre, no por omisión.


    Zoneless en Angular v22: cómo funciona y cuándo usarlo en producción

    Zone.js ha sido la pieza más criticada del runtime de Angular desde que existe. En v22 el modo zoneless avanza significativamente como alternativa estable para proyectos nuevos.

    Sin Zone.js, Angular solo ejecuta detección de cambios cuando se lo dices explícitamente: a través de signals, events, o marcando el componente como sucio manualmente. El resultado son aplicaciones más predecibles, más fáciles de depurar y más rápidas en la mayoría de los escenarios.

    Para activarlo en una app nueva:

    // main.ts
    

    bootstrapApplication(AppComponent, {

    providers: [

    provideExperimentalZonelessChangeDetection()

    ]

    });

    En el Curso de Angular Moderno cubrimos la arquitectura zoneless con Signals desde cero — actualizado a v22.


    standalone: true ya no es necesario

    A partir de v22, standalone es el default. No necesitas escribir standalone: true en ningún componente nuevo:

    // v21 y anteriores — necesitabas declararlo:
    

    @Component({

    standalone: true,

    selector: 'app-product-card',

    ...

    })

    // v22 — standalone por defecto, sin declaración:

    @Component({

    selector: 'app-product-card',

    ...

    })

    Solo necesitas standalone: false si quieres un componente que NO sea standalone — que es el caso raro ahora.


    Nuevo decorator @Service() en Angular v22: para qué sirve

    Si llevas tiempo usando inject() en lugar de constructor injection, este cambio te va a gustar.

    Angular v22 introduce @Service() como alternativa directa a @Injectable({ providedIn: 'root' }). Sin opciones, sin configuración — declaras la clase como servicio y Angular la provee en root automáticamente.

    // Antes
    

    @Injectable({ providedIn: 'root' })

    export class AuthService {

    private http = inject(HttpClient);

    }

    // Angular v22

    @Service()

    export class AuthService {

    private http = inject(HttpClient);

    }

    Un detalle importante: @Service() solo funciona con inject(). Si intentas usar constructor injection con @Service(), obtendrás un error — el decorator asume el modelo de inyección funcional. Si necesitas constructor injection o configuración avanzada como providedIn: 'platform', sigue usando @Injectable.

    Es coherente con la dirección que lleva el framework desde que inject() llegó — alejarse del constructor como único punto de entrada de dependencias.


    Angular v22: tabla completa de features estables y experimentales

    Feature Estado en v22 Para producción
    resource() Estable Sí
    rxResource() Estable Sí
    linkedSignal() Estable Sí
    @Service() Estable Sí
    standalone: true default Estable Sí
    allowSignalWrites deprecated Estable Quitar el flag
    ChangeDetectionStrategy.Eager Estable Sí
    httpResource() Experimental Con precaución
    debounced() Experimental Con precaución
    Signal Forms Experimental No recomendado aún
    Zoneless Developer preview Proyectos nuevos

    Cómo migrar a Angular v22 desde Angular 20 o 21: guía paso a paso

    No necesitas migrar todo a la vez. Esta es la secuencia que tiene más sentido:

    • Elimina allowSignalWrites: true de tus effects. Es trivial y lo haces en un PR.
    • Adopta linkedSignal() donde tengas signals que dependen de otros y se resetean. Los encontrarás fácilmente.
    • Migra a @Service() en servicios simples que ya usen inject(). La ganancia es inmediata en legibilidad.
    • Empieza a usar resource() en componentes nuevos en lugar de switchMap + HttpClient.get(). No tienes que migrar los existentes de golpe.
    • Experimenta con zoneless en un proyecto nuevo o en un módulo aislado.
    • Deja Signal Forms para más adelante hasta que estabilice.

    Si quieres ir más al fondo en cómo funciona el testing de estos nuevos patrones, tengo el Curso de Testing en Angular actualizado con Jest y Testing Library — resource() y linkedSignal() cambian cómo se escriben los tests de componentes.


    FAQ — Preguntas frecuentes sobre Angular v22

    ¿Es Angular v22 compatible con Angular v19 o v20?

    La migración de v19/v20 a v22 es incremental. Las APIs nuevas son aditivas — no rompen el código existente. standalone: true sigue funcionando aunque ya no sea necesario. ChangeDetectionStrategy.Default sigue siendo un alias válido aunque deprecated. Puedes actualizar con ng update y adoptar las nuevas APIs a tu ritmo sin necesidad de reescribir nada de golpe.

    ¿httpResource() reemplaza a HttpClient en Angular v22?

    No. HttpClient no desaparece en v22 y sigue siendo la opción recomendada para lógica HTTP compleja. httpResource() es una alternativa más ergonómica para casos concretos: cuando tienes un signal como parámetro reactivo de la petición y quieres gestionar loading/error automáticamente. Para interceptores custom, peticiones en paralelo o manejo avanzado de headers, HttpClient con RxJS sigue siendo la herramienta correcta. Además, httpResource() es experimental en v22, así que no es recomendable adoptarlo masivamente en proyectos en producción todavía.

    ¿Qué diferencia hay entre resource() y httpResource()?
    resource() es genérico: acepta cualquier función que devuelva una Promise como loader. httpResource() está especializado en HTTP y usa internamente HttpClient, por lo que respeta interceptores, el provideHttpClient() configurado y expone metadatos de la respuesta como .statusCode() y .headers(). Para llamadas HTTP simples con parámetros reactivos, httpResource() es más cómodo. Para lógica asíncrona que no sea HTTP, resource() es la opción.
    ¿Signal Forms reemplaza a Reactive Forms en v22?

    No. Signal Forms es experimental en v22 y no está pensado para reemplazar Reactive Forms todavía. Reactive Forms sigue siendo la opción estable y recomendada para formularios complejos en producción. Signal Forms marca la dirección futura del framework — formularios completamente basados en signals sin FormBuilder ni valueChanges — pero antes de considerarla lista para producción necesita que la API se estabilice, cosa que no ocurre en v22.

    ¿Puedo usar zoneless ya en producción con Angular v22?

    Depende del proyecto. Para proyectos nuevos que uses signals de forma consistente, zoneless es viable — el equipo de Angular lo recomienda como el camino a seguir. Para proyectos existentes que mezclan Zone.js con código legacy que depende del ciclo de detección de cambios automático, la migración requiere más cuidado. En v22 el modo zoneless sigue marcado como “experimental” en el nombre del provider (provideExperimentalZonelessChangeDetection()), aunque en la práctica es bastante estable para proyectos nuevos bien estructurados.

    ¿linkedSignal() es lo mismo que computed() con posibilidad de escritura?

    Conceptualmente se parecen, pero con una diferencia clave: linkedSignal() tiene dependencia reactiva sobre otro signal para su valor inicial y para resetearse automáticamente cuando ese signal cambia. computed() es de solo lectura — no puedes escribir en él. signal() es escribible pero no tiene vínculo reactivo con otros signals. linkedSignal() combina los dos comportamientos: se actualiza cuando cambia su fuente y también acepta escrituras manuales, lo que lo hace ideal para estados que tienen un “valor por defecto reactivo” pero que el usuario puede sobrescribir.

    ¿Para qué sirve @Service() y cuándo no usarlo?
    @Service() es el nuevo decorator de Angular v22 que simplifica la declaración de servicios singleton en root. Equivale a @Injectable({ providedIn: 'root' }) pero sin configuración. Solo funciona con inject() — si intentas constructor injection con @Service(), obtendrás un error. Úsalo en servicios simples que ya sigan el patrón de inject(). Si necesitas providedIn: 'platform', providedIn: 'any' u otras opciones avanzadas, sigue usando @Injectable con su configuración completa.


    Si estás construyendo con IA en tu día a día como developer, el curso Construye con IA te muestra cómo integrar Claude Code en tu flujo de trabajo real con proyectos Angular y TypeScript.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Implementando Claude Code para la automatización de desarrollo en Angular y NestJS

    Implementando Claude Code para la automatización de desarrollo en Angular y NestJS

    Claude Code como herramienta diaria de desarrollo

    Tiempo estimado de lectura: 5 min

    • Orquestación de tareas multi-archivo y ejecución de CLI para migraciones, generación de boilerplate y correcciones automáticas.
    • Requiere contexto persistente (ej. archivo CLAUDE.md) para evitar alucinaciones y errores arquitectónicos.
    • Útil para flujos repetibles y tests automatizados; no ideal para retoques UI o tareas atómicas simples.

    Resumen rápido (lectores con prisa)

    Claude Code es un agente orientado a orquestar tareas que implican múltiples archivos y ejecución de CLI. Úsalo cuando necesites migraciones, generación de boilerplate, tests y correcciones automáticas a partir de stack traces. No es la mejor opción para escribir una sola función o pulir UI.

    Por qué usar (o no) Claude Code en tu flujo diario

    Claude Code Claude Code está pensado para tareas que van más allá del autocompletado: migraciones, generación de boilerplate, tests y correcciones automáticas tras detectar fallos en la terminal. No es mejor que Copilot para escribir una función; es más útil cuando la tarea implica múltiples archivos y ejecución de CLI.

    Ventajas reales:

    • Orquestación multi-archivo y ejecución de comandos.
    • Correcciones automáticas tras leer stack traces.
    • Generación de tests y refactors repetibles.

    Limitaciones reales:

    • Consumo alto de contexto/token en sesiones largas.
    • Riesgo de sobreescritura si la instrucción es ambigua.
    • Posible bucle de corrección ante errores complejos.

    Decisión simple: úsalo para tareas de orquestación; no para retoques visuales ni diseño fino de UI.

    Preparación: cómo darle contexto al agente

    Sin contexto, el agente alucina. La práctica que funciona es tener un archivo de contexto que el agente lea antes de actuar. Crea CLAUDE.md en la raíz:

    # CLAUDE: reglas del repo
    Stack:
    - Backend: NestJS 10 (TypeScript estricto)  https://nestjs.com/
    - Frontend: Angular 17 (standalone components, Signals)  https://angular.io/
    
    Convenciones:
    - DTOs con class-validator
    - Servicios inyectados por constructor
    - Componentes standalone, sin NgModules
    - Commits en Conventional Commits
    

    Ese archivo actúa como prompt persistente. Reduce alucinaciones arquitectónicas y mejora resultados.

    Tutorial práctico: flujo real con NestJS y Angular

    Objetivo: crear recurso Products en backend (NestJS) y consumirlo desde Angular, con tests básicos.

    1) Generar recurso en NestJS

    En la carpeta del backend:

    # instrucción al agente
    claude "Lee CLAUDE.md. Genera recurso Products en NestJS: Controller, Service, DTO CreateProductDto con class-validator. Ejecuta npm run build y corrige errores."
    

    Qué hará:

    • Ejecutará nest g res products o creará manualmente los archivos.
    • Insertará DTOs con validaciones (@IsString, @IsNumber).
    • Ejecutará npm run build; si TypeScript falla, leerá el stack trace y aplicará correcciones iterativas.

    Ejemplo mínimo de DTO que el agente debe crear:

    // create-product.dto.ts
    import { IsString, IsNumber } from 'class-validator';
    export class CreateProductDto {
      @IsString()
      name: string;
    
      @IsNumber()
      price: number;
    }
    

    2) Consumir endpoint desde Angular

    En la carpeta del frontend:

    claude "Crea ProductService usando provideHttpClient y un componente ProductFormComponent standalone. Usa Signals para estado de formulario. Ejecuta ng build y corrige tipados."
    

    Qué esperar:

    • Creación de product.service.ts con funciones que llaman al endpoint.
    • ProductFormComponent standalone con Signals para isLoading y errors.
    • ng build que verifica tipado y dependencias; el agente corrige importaciones o tipos si hay fallos.

    Fragmento esperado en Angular:

    // product.service.ts (simplificado)
    import { inject } from '@angular/core';
    import { HttpClient } from '@angular/common/http';
    export const ProductService = () => {
      const http = inject(HttpClient);
      return {
        create: (payload: any) => http.post('/api/products', payload)
      };
    };
    

    3) Generar tests automatizados

    Comando recomendado:

    claude "Genera tests Jest para products.service.ts y products.controller.ts. Ejecuta npm run test y corrige mocks hasta que la suite pase."
    

    Valor: te ahorra el 70% del trabajo repetitivo de mocks y boilerplate.

    Riesgos y contramedidas operativas

    1. Trabaja siempre en una rama aislada:
      – git checkout -b feat/claude-codex
      – Nunca en main o develop.
    2. Limita la ventana de contexto:
      – Corta sesiones largas. Ejecuta tareas atómicas y revisa resultados antes de continuar.
    3. Evita permisos globales de escritura en archivos sensibles:
      – Usa .claudeignore para bloquear rutas (si la herramienta lo soporta) o un wrapper que restrinja paths.
    4. Plan para fallos en node_modules:
      – Si entra en bucle, interrumpe y ejecuta npm ci o reinstala dependencias; luego reintenta con más contexto.

    Checklist para adopción en equipo

    • [ ] CLAUDE.md con convenciones del repo.
    • [ ] Branching obligatorio para sesiones de agente.
    • [ ] Scripts de CI que validen outputs generados por el agente.
    • [ ] Monitoreo de consumo de API/tokens.
    • [ ] Política interna para revisar commits automáticos antes de merge.

    Claude Code no es una varita mágica; es una herramienta poderosa si la gobiernas. Si empiezas documentando el proyecto y limitando sus permisos, te dará horas de productividad en tareas repetitivas y orquestación. Si no, corregirás borradores y rollbacks a mano. La diferencia está en las reglas y la disciplina.

    Relacionado: visita Dominicode Labs para ver experimentos y guías sobre agentes y automatización. Esta mención encaja como continuación lógica para equipos que exploran flujos de IA aplicada y agentes.

    FAQ

    ¿Qué es Claude Code y para qué sirve?

    Claude Code es un agente diseñado para orquestar tareas que implican múltiples archivos y comandos de terminal: migraciones, generación de boilerplate, tests y correcciones automáticas tras fallos. Es especialmente útil cuando la tarea requiere ejecutar CLI y aplicar cambios iterativos.

    ¿Cuándo debería usar Claude Code en lugar de Copilot?

    Usa Claude Code cuando la tarea sea multi-archivo, requiera ejecución de comandos o correcciones a partir de stack traces. Para pequeñas funciones o autocompletado local, Copilot suele ser más eficiente.

    ¿Cómo debo preparar mi repo antes de usar el agente?

    Crea un archivo de contexto persistente (por ejemplo CLAUDE.md) con stack, convenciones y reglas del repo. Trabaja en una rama aislada y asegúrate de tener scripts de CI que validen cambios automáticos.

    ¿Qué riesgos operativos debo mitigar?

    Principales riesgos: sobreescritura de archivos, consumo excesivo de tokens en sesiones largas y bucles de corrección. Mitígalo con ramas aisladas, límites de sesión y mecanismos para restringir paths sensibles (por ejemplo .claudeignore o wrappers).

    ¿Cómo integro tests automatizados en el flujo del agente?

    Pide al agente generar tests Jest para servicios y controladores, ejecutar npm run test y corregir mocks hasta que la suite pase. Complementa con scripts de CI que validen los cambios generados antes del merge.

    ¿Qué hacer si el agente entra en bucle de correcciones?

    Interrumpe la sesión, ejecuta npm ci o reinstala dependencias, revisa el contexto y reintenta con instrucciones más atómicas y detalladas. Limitar la ventana de contexto también ayuda a evitar bucles.

  • Resource API en Angular 22: el fin del subscribe() manual

    Resource API en Angular 22: el fin del subscribe() manual

    Revisé hace poco un componente de Angular que cargaba una lista de productos. Contaba los observables con los dedos: un BehaviorSubject para la categoría seleccionada, un switchMap hacia HttpClient, un catchError para los fallos, un takeUntilDestroyed para no dejar suscripciones vivas, y al final, un async pipe en el template.

    Todo correcto. Todo necesario. Y todo código que explica exactamente lo mismo que cualquier otro componente de carga de datos en la aplicación. La Resource API de Angular 22 resuelve exactamente este problema.

    Ese patrón tiene quince años. Angular 22 tiene la respuesta definitiva.

    Qué es la Resource API y por qué existe

    La Resource API es el mecanismo nativo de Angular para gestionar operaciones asíncronas dentro del sistema de Signals. No es una librería de terceros, no es un wrapper sobre RxJS: es la pieza que faltaba para que el modelo reactivo de Angular estuviera completo.

    La idea central es sencilla: tienes un signal que representa un parámetro (un ID, un filtro, una página), y quieres que Angular haga automáticamente el fetch cuando ese parámetro cambia. Sin subscribe, sin pipe, sin gestión manual del ciclo de vida.

    En Angular 22 el ecosistema completo se compone de tres APIs:

    • resource() — fetch genérico con Promise. Estable en v22.
    • rxResource() — puente para servicios basados en Observable. Estable en v22.
    • httpResource() — wrapper declarativo sobre HttpClient. Experimental en v22.

    El matiz de los estados de estabilidad importa. resource() y rxResource() ya son API pública con garantías de compatibilidad. httpResource() sigue marcado como experimental — la API puede cambiar. Para producción crítica, ten eso en cuenta.

    resource(): el punto de entrada

    Usa resource() cuando el origen de datos es una Promise o una función fetch directa. El parámetro reactivo se define en params, y la función que carga los datos en loader.

    import { ChangeDetectionStrategy, Component, signal, resource } from '@angular/core';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @switch (productos.status()) { @case ('loading') { <p>Cargando...</p> } @case ('reloading') { <p>Actualizando...</p> } @case ('error') { <p>Error: {{ productos.error() }}</p> } @default { @if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } } } <button (click)="categoria.set(categoria() + 1)">Siguiente</button> <button (click)="productos.reload()">Recargar</button> `, }) export class CatalogoComponent { categoria = signal(1);

    productos = resource<Producto[], { cat: number }>({ params: () => ({ cat: this.categoria() }), loader: ({ params, abortSignal }) => fetch(/api/products?category=${params.cat}, { signal: abortSignal }) .then(r => r.json()), }); }

    Dos errores que verás en código antiguo o en tutoriales desactualizados:

    • El campo se llama params, no request. Eso era la API experimental anterior.
    • Los estados son strings literales: 'loading', 'reloading', 'error'… ResourceStatus no es un enum TypeScript nativo — es un objeto de constantes (as const), así que se compara con strings literales, no con ResourceStatus.Loading.

    Cuando categoria cambia, Angular cancela el fetch anterior (usando el abortSignal que recibe el loader) y lanza uno nuevo. El ciclo de vida completo, gestionado sin escribir una sola línea de cleanup.

    rxResource(): para servicios que devuelven Observables

    La mayoría de proyectos Angular tienen servicios basados en HttpClient que devuelven Observable. Migrar todo a fetch puro no es viable ni deseable.

    rxResource() es el puente. En lugar de loader, usa stream, que devuelve un Observable.

    import { ChangeDetectionStrategy, Component, signal, inject } from '@angular/core';
    import { rxResource } from '@angular/core/rxjs-interop';
    import { HttpClient } from '@angular/common/http';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo-rx', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (productos.isLoading()) { <p>Cargando...</p> } @else if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } `, }) export class CatalogoRxComponent { private http = inject(HttpClient); categoria = signal(1);

    productos = rxResource({ params: () => ({ cat: this.categoria() }), stream: ({ params }) => this.http.get<Producto[]>(/api/products?category=${params.cat}), }); }

    Dos puntos que generan confusión frecuente:

    • El import correcto es @angular/core/rxjs-interop, no @angular/core.
    • El método se llama stream, no loader. Los ejemplos de versiones experimentales anteriores usaban loader, de ahí la confusión.

    httpResource(): la opción declarativa

    httpResource() va un paso más allá: elimina la necesidad de declarar un servicio intermedio para casos de fetching simple. Lo declaras directamente en el componente.

    import { ChangeDetectionStrategy, Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    

    interface User { id: number; name: string; }

    @Component({ selector: 'app-user-profile', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (user.isLoading()) { <p>Cargando...</p> } @else if (user.error()) { <p>Error al cargar el perfil</p> } @else if (user.hasValue()) { <p>{{ user.value()?.name }}</p> } `, }) export class UserProfileComponent { userId = signal(1);

    user = httpResource<User>(() => /api/user/${this.userId()}); }

    httpResource() expone dos signals exclusivos que no tienen resource() ni rxResource():

    • .statusCode() — el código HTTP de la respuesta (200, 404, 500…)
    • .headers() — las cabeceras de la respuesta

    Ambas son señales independientes de .status(), que sigue siendo el estado del ciclo de vida del recurso. Confundir .status() con .statusCode() es el error más frecuente al empezar con esta API.

    Para respuestas que no son JSON:

    // Texto plano
    const readme = httpResource.text(() => /docs/readme.md);
    

    // Binario const avatar = httpResource.blob(() => /api/user/${this.userId()}/avatar);

    Requiere provideHttpClient() en el bootstrap. Usa HttpClient e interceptores por debajo, así que tus interceptores de autenticación siguen funcionando sin cambiar nada.

    Recuerda que httpResource() sigue marcado como experimental en v22. Para proyectos con requisitos estrictos de estabilidad de API, usa rxResource() con tu servicio HttpClient habitual hasta que se estabilice.

    Cuándo usar cada uno

    No es una decisión complicada si tienes claros los criterios:

    | Situación | API recomendada | |—|—| | Fetch puro o API externa directa | resource() | | Tienes servicios con Observable existentes | rxResource() | | Fetching simple sin servicio intermedio (experimental) | httpResource() | | Necesitas el status code HTTP como signal | httpResource() |

    Las tres APIs comparten la misma superficie de lectura: .value(), .isLoading(), .error(), .hasValue(), .status(), .reload(). Cambiar de una a otra es mínimamente invasivo.

    Validación del dato en runtime

    El genérico de TypeScript solo existe en tiempo de compilación. Si el backend devuelve algo inesperado, httpResource() no lanzará ningún error — simplemente tendrás un objeto mal tipado en runtime.

    La opción parse existe exactamente para este caso:

    import { z } from 'zod';
    

    const UserSchema = z.object({ id: z.number(), name: z.string(), });

    user = httpResource( () => /api/user/${this.userId()}, { parse: UserSchema.parse } );

    Si el dato del backend no cumple el schema, el resource entra en estado 'error' automáticamente. Sin try/catch manual, sin runtime silencioso. Si quieres profundizar en cómo construir schemas robustos con Zod para este tipo de validación, el curso de Zod para TypeScript cubre exactamente estos patrones de producción.

    Lo que cambia en tu arquitectura

    La Resource API no elimina los servicios Angular — los reorganiza. Sigues necesitando servicios para encapsular lógica de negocio compleja, componer múltiples endpoints, o compartir estado entre componentes. Lo que elimina es el boilerplate de gestión de ciclo de vida en los componentes que simplemente cargan y muestran datos.

    Un componente que antes necesitaba un servicio, tres operadores RxJS y un takeUntilDestroyed ahora expresa la misma intención en diez líneas. La lógica no desaparece — se mueve al lugar correcto.

    Si quieres el cuadro completo — Signals, Resource API, Signal Forms, Zoneless y todo lo que llegó en v22 — el curso Angular Moderno tiene el módulo M10 dedicado íntegramente a Resource API con ejemplos sobre el proyecto ShopFlow.

    Qué hacer hoy

    Identifica en tu proyecto los componentes que tienen este patrón: signal o BehaviorSubject como parámetro, switchMap hacia HttpClient, y async pipe en el template.

    Esos son tus candidatos para migrar a rxResource(). No necesitas reescribir los servicios. Solo cambias la forma en que el componente consume el Observable.

    Empieza por un componente de solo lectura — uno que carga datos y no tiene formularios complejos. Comprueba que .status() en el template te da todo lo que necesitabas del loading$ que tenías antes.

    Si funciona ahí, tienes el patrón. El resto de la migración es repetirlo.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre resource() y httpResource() en Angular 22? resource() acepta cualquier función que devuelva una Promise — puedes usarlo con fetch, con SDKs externos, o con cualquier operación asíncrona. httpResource() es un wrapper declarativo sobre HttpClient que además expone el status code HTTP y las cabeceras como signals independientes. La diferencia clave: httpResource() sigue siendo experimental en v22; resource() es API estable.

    ¿Puedo usar rxResource() si tengo servicios que devuelven Observables? Sí. rxResource() está diseñado exactamente para ese caso. En lugar de loader, defines un stream que devuelve un Observable. Tus servicios existentes no cambian — solo cambia cómo el componente los consume.

    ¿La Resource API reemplaza completamente RxJS en Angular? No. RxJS sigue siendo útil para transformaciones complejas de streams, operadores avanzados y casos donde necesitas combinar múltiples fuentes. La Resource API reemplaza el patrón subscribe/unsubscribe para carga de datos HTTP en componentes — no todos los casos de uso reactivo.

    ¿Qué ocurre con los datos en caché cuando cambia el signal de parámetros? Cuando el signal de params cambia, el resource entra en estado 'reloading' (no 'loading'). El valor anterior sigue disponible en .value() durante la recarga. Esto permite mostrar datos obsoletos mientras llegan los nuevos, en lugar de mostrar un spinner que vacía la UI. Es el comportamiento por defecto — no necesitas configurarlo.

    ¿Funciona la Resource API con Angular SSR? Sí. httpResource() usa HttpClient internamente, que ya tiene soporte de transferencia de estado para SSR. Con resource() y rxResource() necesitas gestionar tú mismo la transferencia de estado si el servidor precarga datos. La integración más limpia con SSR actualmente es a través de httpResource() o rxResource() con un servicio que use TransferState.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode. Ha migrado proyectos Angular en producción desde v2 hasta v22.

    Sources:

  • Cómo funcionan los Signals en Angular 22 y React 19

    Cómo funcionan los Signals en Angular 22 y React 19

    Signals en Angular 22 y React 19: el nuevo modelo de reactividad

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Reactividad de grano fino actualiza solo los nodos del DOM que dependen de un valor.
    • Angular 22 introduce Signals explícitos, elimina Zone.js y ofrece formularios sincronizados basados en Signals.
    • React 19 apuesta por optimizaciones vía compilador y el hook use() en lugar de un primitivo signal.
    • Elegir entre ambos depende de control/depurabilidad (Angular) vs. fricción y compatibilidad con código existente (React).

    Tabla de contenidos

    Signals en Angular 22 y React 19: el nuevo modelo de reactividad es la discusión que está redefiniendo cómo pensamos la UI: menos trozos de árbol reevaluados, más actualizaciones puntuales y menos sorpresas en producción. Si tu equipo decide entre control explícito o automatización por compilador, este artículo te da criterios prácticos y ejemplos reales para elegir con criterio.

    Resumen rápido (lectores con prisa)

    Fine-grained reactivity actualiza solo dependencias directas. Angular 22 introduce Signals (signal(), computed(), effect()) y formulas sin Zone.js. React 19 usa el React Compiler para inferir memoización y añade use() para leer Promises/recursos en render. Ambos mejoran escalabilidad; Angular es explícito y más trazable, React reduce fricción de adopción.

    Signals en Angular 22 y React 19: el nuevo modelo de reactividad (explicación rápida)

    La reactividad de grano fino significa actualizar únicamente el nodo del DOM que depende de un valor concreto. Angular 22 lo hace declarando Signals (signal(), computed(), effect()), eliminando Zone.js y ofreciendo formularios basados en Signals. React 19 opta por no añadir un primitivo signal; en su lugar usa el React Compiler para inferir memoización y añade el hook use() para leer Promises/recursos en render. Documentación oficial Angular. Blog oficial React 19.

    ¿Por qué importa la reactividad de grano fino?

    Los problemas reales aparecen en aplicaciones con alta densidad de datos:

    • Dashboards financieros con cientos de celdas que actualizan simultáneamente.
    • Formularios complejos con validaciones cruzadas y campos dependientes.
    • UIs que requieren latencia mínima y CPU predecible en clientes de bajo rendimiento.

    La solución tradicional (Virtual DOM diffs o Zone.js) escala mal: consumes CPU revisando cosas que no cambiaron. Fine-grained reactivity evita ese trabajo inútil.

    Angular 22: Zoneless, Signals y formularios sincronizados

    Angular reescribió su motor de detección. Resultado práctico:

    • Renderizado Zoneless: sin interceptar microtasks; si no cambia un Signal, no hay re-render.
    • Signals explícitos: control total sobre qué es reactivo y cuándo muta.
    • Signal-based Forms: lectura síncrona del estado del formulario, menos RxJS, menos suscripciones que se filtran.

    Ejemplo Angular

    import { signal } from '@angular/core';
    
    const count = signal(0);
    count.set(count() + 1); // solo actualiza los lectores de `count`

    Para convivir con código existente, Angular ofrece utilidades toSignal() / toObservable(), facilitando migraciones incrementales. Guía.

    Ventajas concretas: trazabilidad, depuración directa (sabes qué mutó), rendimiento determinista. Coste: curva de aprendizaje y refactor en bases de código grandes.

    React 19: Reactividad inferida vía compilador y hook use()

    React evita imponer nuevos primitivos. Estrategia:

    • React Compiler: analiza en build y genera memos/mecanismos de actualización automáticos.
    • use(): permite consumir Promises o recursos directamente en render, funcionando con <Suspense> para carga declarativa.
    • Server Actions / useActionState: reduce boilerplate del ciclo formulario → servidor → feedback.

    Ejemplo React

    function Product({ id }) {
      const product = use(fetchProduct(id)); // Suspense maneja loading
      return <div>{product.name}</div>;
    }

    Ventajas: baja fricción de adopción; equipo no reescribe mentalmente la app. Coste: optimizaciones «invisibles» por el compilador que pueden complicar diagnóstico fino; depuración menos directa que en Angular.

    React Suspense referencia

    Comparativa práctica (qué esperar en producción)

    • Performance pura: ambos escalan mucho mejor que modelos antiguos. Angular da mayor predictibilidad por su modelo explícito; React consigue grandes ganancias sin romper DX.
    • Depuración: Angular facilita trazar el origen del update; en React necesitas entender qué transformó el compilador.
    • Migración: Angular exige trabajo incremental (conversión de formularios y algunos patrones de RxJS). React permite migración más suave, porque el compilador optimiza el código existente.
    • Formularios complejos: Angular gana por tipado y sincronía; React compensa con Server Actions para patrones CRUD.

    Recomendaciones prácticas para equipos

    1. Haz un piloto con módulos concretos. No migres todo de golpe.
    2. Para UIs de alta densidad de datos, prioriza Angular 22 si necesitas control y trazabilidad estricta.
    3. Si tu stack ya es Next.js / SSR y quieres mejorar rendimiento sin reeducar al equipo, React 19 es opción pragmática.
    4. Añade pruebas de rendimiento (microbenchmarks) y observabilidad: mide renders por segundo, tamaño de paint y memoria.
    5. Documenta patrones: en Angular, establece cómo y cuándo crear Signals; en React, especifica cómo instrumentar y auditar transformaciones del compilador.

    Conclusión práctica

    Signals en Angular 22 y React 19 solucionan el mismo problema con filosofías distintas: Angular te da el control explícito; React te lo facilita automáticamente. No hay «mejor» universal: hay mejor para tu equipo. Si quieres predictibilidad y depurabilidad en sistemas críticos, apuesta por Angular 22. Si prefieres un camino de menor fricción y eres heavy-SSR, React 19 acelera el time-to-market. Dominar fin-grained reactivity es ahora requisito, no lujo.

    FAQ

    ¿Qué es reactividad de grano fino?

    La reactividad de grano fino actualiza solo los nodos del DOM que dependen de un valor específico, en lugar de reevaluar grandes porciones del árbol. Reduce trabajo innecesario de CPU y mejora latencia en UIs densas.

    ¿Cómo difiere Angular 22 del modelo anterior con Zone.js?

    Angular 22 elimina la dependencia de Zone.js y usa Signals declarativos. En lugar de interceptar microtasks para detectar cambios, los Signals notifican solo a sus lectores cuando cambian, proporcionando renders deterministas.

    ¿React 19 añade un primitivo signal?

    No: React 19 no introduce un primitivo signal. Usa el React Compiler para inferir memoización y optimizaciones, y añade use() para consumo de Promises/recursos en render.

    ¿Qué ventajas ofrecen los Signal-based Forms?

    Los Signal-based Forms permiten lectura síncrona del estado del formulario, reducen la necesidad de RxJS y evitan suscripciones filtradas. Mejoran trazabilidad y simplifican validaciones dependientes.

    ¿Cómo evaluar cuál elegir para mi equipo?

    Haz un piloto. Si necesitas control y trazabilidad estricta para sistemas críticos, Angular 22 es preferible. Si buscas mínima fricción y tu stack ya usa SSR/Next.js, React 19 reduce fricción de adopción.

    ¿Es migración a Signals retrocompatible?

    Parcialmente. Angular ofrece utilidades como toSignal() / toObservable() para migraciones incrementales, pero adaptar formularios y patrones RxJS puede requerir refactor. React 19 suele permitir migración más suave gracias al compilador.

  • Angular 22: Implicaciones técnicas y coste real de migrar en 2026

    Angular 22: Implicaciones técnicas y coste real de migrar en 2026

    Angular 22 vs el resto: lo que nadie te dice sobre migrar en 2026

    Tiempo estimado de lectura: 4 min

    • Modernización estructural: Zoneless por defecto, Signals y Control Flow nativo cambian la forma de detectar cambios y escribir templates.
    • Contextos de ventaja: Angular 22 aporta coherencia en equipos grandes y proyectos de larga vida útil; no es la opción por defecto para prototipado rápido.
    • Coste real de migración: incluye trabajo manual de refactor y coste de formación; planifica recursos y tiempo (ej. 3–6 meses para monorepos medianos).
    • Testing y despliegue: migrar a Jest + Angular Testing Library es parte crítica del plan; usa despliegues canarios y métricas para validar.

    Buscar Angular 22 vs el resto: lo que nadie te dice sobre migrar en 2026 no es una charla de café. Es una decisión de arquitectura con consecuencias inmediatas en costes, ritmo de desarrollo y mantenimiento. Angular 22 ya no es el framework “pesado” que recuerdas. Pero esa modernización trae costes de migración reales y decisiones estratégicas que no aparecen en la documentación oficial.

    Resumen rápido (lectores con prisa)

    Angular 22 introduce Zoneless por defecto, Signals y Control Flow nativo en templates. Mejora TTI y reduce renders innecesarios. Es una buena opción para equipos grandes y proyectos de larga duración; la migración requiere refactor y formación. Incluye la migración del stack de testing a Jest + Angular Testing Library como parte del plan.

    Angular 22 vs el resto: lo que cambia y por qué importa

    Zoneless por defecto

    Se abandona Zone.js. La detección de cambios pasa de ser global e impulsiva a ser controlada y granular. Resultado: TTI más bajo y menos renders innecesarios.

    Signals como primitivo de reactividad

    Reactividad sin subscriptions masivas. Signals reduce la boilerplate de RxJS para estado local y mejora predictibilidad.

    Control Flow nativo en templates (@if, @for)

    El compilador procesa control de flujo a nivel de AST, lo que incrementa rendimiento y legibilidad.

    Traducido: Angular ya compite en métricas de rendimiento con frameworks “reactivos” como Solid o con Vue, pero manteniendo un conjunto de herramientas integradas (DI, routing, forms) que otros frameworks dejan al ecosistema.

    Comparativa honesta: cuándo Angular gana y cuándo no

    Angular no es la mejor opción por defecto. Es la mejor opción para ciertos contextos.

    • Si ganas con opinión y consistencia: equipos de >10 devs, código con vida útil >3 años, requisitos de accesibilidad y compliance, Angular aporta coherencia y reduce decisiones ad-hoc.
    • Si priorizas libertad y prototipado rápido: React o Vue siguen siendo más ágiles. Next.js / Nuxt dominan en SSR/Server Components y experiencia híbrida contenido-aplicación.

    Arquitectura

    Angular = opinado; React = flexible; Vue = progresivo.

    Reactividad

    Angular = Signals; React = Hooks/Virtual DOM; Vue = Composition API.

    SSR y SEO

    Next.js/Nuxt > Angular Universal (mejora pero no centro de innovación).

    Mantenimiento en equipos grandes

    Angular > React (por la opinión y patrones forzados).

    Lo que nadie te cuenta sobre el coste real de migrar

    Hay dos costes que muchos subestiman.

    1) Coste técnico (trabajo manual)

    Actualizar con el CLI es el viaje fácil. El trabajo duro es refactorizar: pasar de NgModules a Standalone Components, reescribir flujos con Signals, adaptar templates a Control Flow nativo. Eso no se hace con sed. Es trabajo de diseño con pruebas y revisiones de arquitectura.

    2) Coste de conocimiento (formación)

    Si tu equipo maneja Angular 8–12 y nunca siguió la evolución, la migración se convierte en un proceso de aprendizaje. No es solo código; es cambiar patrones mentales.

    Estimación práctica: para un monorepo mediano (~50–100 paquetes) con Angular legacy, planifica entre 3–6 meses de esfuerzo de ingeniería + formación (una squad dedicada en paralelo). Para apps pequeñas, 2–4 semanas si controlas las dependencias.

    Testing: la parte que obliga a modernizar

    Karma y Jasmine están oficialmente deprecados. Seguir con ellos en 2026 equivale a cargar deuda técnica que ralentiza CI. El estándar actual es Jest + Angular Testing Library: tests por comportamiento, más rápidos y menos frágiles ante refactors.

    Si vas a migrar, incluye la migración del stack de testing en el plan. No lo dejes para “después”; las pruebas son el talón de Aquiles de cualquier transición grande.

    Plan de migración (práctico y priorizado)

    1. Auditoría de superficie: identifica paquetes que usan NgModules, transformadores de compilador o dependencias tightly-coupled.
    2. Formación y pilot: entrena 2–3 leads en Standalone + Signals. Ejecuta un pilot migrando un módulo crítico.
    3. Reescritura incremental: migrar componentes a Standalone, adaptar servicios a nuevo DI y sustituir RxJS local por Signals donde aplique.
    4. Testing first: antes de cambiar templates, adapta tests a Jest + Testing Library.
    5. Despliegue canario: canary en producción para un subset de usuarios. Monitorea TTI, errores y coste de CI.
    6. Feedback loop: métricas + sesiones de code review para homogeneizar patrones.

    Formación recomendada (práctica)

    Si tu equipo necesita acelerar la adopción, dos recursos útiles y prácticos:

    Ambos cubren desde conceptos arquitectónicos hasta patrones aplicables en migraciones reales.

    Conclusión: criterio para decidir en 2026

    Angular 22 es una opción sólida cuando necesitas previsibilidad, escalabilidad y uniformidad. No es una moda; es una apuesta por la ingeniería predecible. Pero la migración exige plan, formación y disciplina. Si tu prioridad es velocidad de lanzamiento inmediata y equipo pequeño, otras opciones siguen siendo más prácticas. Si en cambio trabajas en dominios donde la UI es infraestructura con vida útil larga —migrar a Angular 22 tiene sentido y trae beneficios tangibles: menos renders innecesarios, menos deuda y mejores métricas de rendimiento.

    Migrar no es solo actualizar dependencias. Es reescribir la forma en que piensas la UI. Hazlo con criterio.

    FAQ

    ¿Qué es Zoneless en Angular 22?

    Zoneless significa que Angular deja de depender de Zone.js para la detección de cambios. La detección se vuelve más controlada y granular, lo que reduce renders innecesarios y mejora TTI.

    ¿Qué son Signals y cuándo conviene usarlos?

    Signals son un primitivo de reactividad que permiten manejar estado local sin la sobrecarga de subscriptions masivas. Conviene usarlos para reducir boilerplate y mejorar la predictibilidad del estado local.

    ¿Cuánto tiempo toma migrar un monorepo mediano?

    Estimación práctica indicada en el artículo: para un monorepo mediano (~50–100 paquetes) planifica entre 3–6 meses de esfuerzo de ingeniería + formación con una squad dedicada en paralelo.

    ¿Por qué migrar el stack de testing ahora?

    Karma y Jasmine están deprecados; mantenerlos añade deuda técnica y ralentiza CI. Migrar a Jest + Angular Testing Library hace los tests más rápidos y menos frágiles ante refactors, y debe formar parte del plan de migración.

    ¿Qué partes deben pilotearse primero?

    Pilotear un módulo crítico con leads formados en Standalone + Signals es la recomendación: forma 2–3 leads y ejecuta un pilot antes de reescrituras a gran escala.

    ¿Angular 22 mejora SEO comparado con Next.js?

    En SSR y SEO Next.js/Nuxt suelen ofrecer una experiencia más avanzada; Angular Universal ha mejorado pero no es el centro de innovación en este espacio.

  • Implementación de formularios y validación en Angular 22

    Implementación de formularios y validación en Angular 22

    El stack completo del dev Angular en 2026: formularios, validación y tests

    Tiempo estimado de lectura: 3 min

    • Angular 22: reactividad con Signals y formularios con tipado estricto para detectar incompatibilidades en compilación.
    • Zod: esquema único TypeScript-first que centraliza reglas de negocio y evita duplicidad entre frontend y backend.
    • Jest + Testing Library: tests centrados en la experiencia del usuario, rápidos y resistentes a refactors.
    • Arquitectura en capas (presentador + servicios + esquemas) reduce bugs y facilita refactors.

    El stack completo del dev Angular en 2026: formularios, validación y tests es una realidad técnica: Angular 22 aporta reactividad y tipado estricto; Zod centraliza las reglas de negocio como esquemas TypeScript-first; y Jest + Testing Library aseguran pruebas resilientes desde la perspectiva del usuario. Si quieres construir formularios que no se rompan con el primer refactor, este es el flujo que realmente funciona en producción.

    Resumen rápido (lectores con prisa)

    Qué es: Un stack que combina Angular 22, Zod y Jest + Testing Library para formularios tipados, validación centralizada y tests orientados a usuario.

    Cuándo usarlo: Formularios complejos que requieren reglas de negocio compartidas entre cliente y servidor y tests resistentes a refactors.

    Por qué importa: Reduce duplicidad de reglas, mantiene tipos sincronizados y mejora la estabilidad de tests y CI.

    Cómo funciona: Angular gestiona la UI y tipos, Zod define esquemas TypeScript-first, y Jest + Testing Library validan comportamiento visible.

    Angular 22: Signals, Standalone y formularios tipados

    Angular 22 cambia el contrato de diseño.

    • Standalone Components reduce acoplamiento: cada componente declara exactamente lo que necesita.
    • Signals ofrece reactividad fina sin Zone.js, lo que hace la detección de cambios predecible.
    • Reactive Forms con tipado estricto (FormControl<string>, FormGroup<{ email: FormControl<string> }>), detectan incompatibilidades en compilación.

    Patrón recomendado

    El componente actúa como presentador; la lógica y las transformaciones residen en servicios inyectados con inject(). Evita colocar reglas de negocio dentro del template o del componente.

    Ejemplo de estructura mínima

    • registration.component.ts (Standalone, Signals para estado local)
    • registration.service.ts (transformaciones, llamadas API)
    • schema/registration.schema.ts (esquema Zod, ver sección siguiente)

    Si quieres dominar esta arquitectura de base y aprender patrones aplicados con Angular 22, apúntate al curso Angular Moderno: El curso definitivo.

    Zod: la fuente de la verdad para validación y tipos

    La duplicidad de reglas (validators en frontend, validadores en backend, DTOs sueltos) es la causa número uno de bugs en formularios complejos. Zod soluciona esto al declarar esquemas que sirven como contrato único.

    Flujo práctico

    1. Declara el esquema en un archivo compartido (si usas monorepo o paquete npm interno).
    2. Infieres tipos con z.infer<> para usar en servicios y repositorios.
    3. Conecta un validador que mapea schema.safeParse(form.value) a errores del FormGroup.

    Ejemplo (schema)

    // registration.schema.ts
    import { z } from "zod";
    
    export const RegistrationSchema = z.object({
      email: z.string().email("Email inválido"),
      password: z.string().min(8, "Mínimo 8 caracteres"),
      acceptTerms: z.literal(true, { errorMap: () => ({ message: "Debes aceptar los términos" }) })
    });
    
    export type Registration = z.infer<typeof RegistrationSchema>;
    

    Mapeo simple de errores a controles

    – Ejecuta const result = RegistrationSchema.safeParse(formGroup.value).

    – Si !result.success, itera result.error.formErrors.fieldErrors y asigna control.setErrors({ zod: mensaje }).

    Ventaja: el mismo esquema puede usarse en backend Node.js, evitando divergencias. Además TipScript siempre estará sincronizado con la validación.

    Aprende integraciones, refinements y transformaciones avanzadas con Zod en el curso Zod: Validación y Transformación de datos con TypeScript.

    Tests que importan: Jest + Angular Testing Library

    Los tests deben medir la experiencia del usuario, no detalles internos. Eso implica dos decisiones técnicas:

    1. Migrar a Jest por velocidad y fiabilidad en CI (usa jest-preset-angular).
    2. Usar Angular Testing Library para consultas semánticas y eventos reales (userEvent).

    Ejemplo de test resiliente

    it("muestra error cuando el email es inválido", async () => {
      render(RegistrationFormComponent);
      await userEvent.type(screen.getByLabelText("Email"), "no-es-email");
      await userEvent.tab();
      expect(screen.getByText("Email inválido")).toBeInTheDocument();
    });
    

    Razón: este test no depende de component.isSubmitted ni de variables privadas. Si cambias la implementación interna, mientras el comportamiento visible sea el mismo, el test sigue válido.

    Configuración mínima

    • Instala: npm i -D jest @types/jest jest-preset-angular @testing-library/angular @testing-library/user-event.
    • Ajusta jest.config.ts y prepara setup-jest.ts para Angular.
    • Mantén tests rápidos, aislados y con pocos mocks; mockea solo dependencias externas (APIs, storage).

    Si quieres configurar Jest, migrar desde Karma y escribir tests que sobrevivan a refactors, revisa Testing en Angular con Jest y Testing Library.

    Arquitectura y criterio: por qué esto funciona

    Las tres capas forman un sistema coherente:

    • Angular 22 define la superficie y el flujo de datos con tipos seguros.
    • Zod centraliza reglas de negocio y mantiene tipos sincronizados entre cliente y servidor.
    • Jest + Testing Library validan el comportamiento visible del usuario, no la implementación.

    Beneficios reales: menos bugs por desincronía, tests más estables, tiempo en CI reducido y una base de código que soporta refactors sin miedo. No es moda; es ingeniería.

    Si quieres implementar este stack de forma práctica y con ejemplos reales, empieza por los tres cursos enlazados arriba: aprendizaje dirigido, ejercicios aplicados y casos reales que aceleran pasar de teoría a producción.

    FAQ

    ¿Por qué usar Zod en lugar de validadores sueltos?

    Porque Zod permite declarar esquemas TypeScript-first que sirven como contrato único entre cliente y servidor, evitando duplicidad de reglas y divergencias que generan bugs en formularios complejos.

    ¿Qué aporta Signals frente a la reactividad clásica de Angular?

    Signals ofrece reactividad fina sin Zone.js, lo que hace la detección de cambios más predecible y permite optimizar renders sin depender del sistema de zones tradicional.

    ¿Por qué migrar a Jest desde Karma?

    Jest es más rápido y fiable en CI; combinado con jest-preset-angular reduce tiempos y fragilidad en pipelines de integración continua.

    ¿Cómo mapear errores de Zod a un FormGroup?

    Ejecuta RegistrationSchema.safeParse(formGroup.value). Si el parse falla, itera result.error.formErrors.fieldErrors y asigna errores a cada control con control.setErrors({ zod: mensaje }).

    ¿Qué pruebas debe cubrir Testing Library?

    Pruebas que midan la experiencia del usuario: consultas semánticas, interacción real con userEvent y aserciones sobre el comportamiento visible, no sobre variables internas.

    ¿Dónde colocar la lógica de negocio en esta arquitectura?

    La lógica y transformaciones deben residir en servicios inyectados (por ejemplo en registration.service.ts), mientras el componente actúa como presentador y coordina el estado local.

  • Implementación efectiva de Angular Aria para accesibilidad en UI

    Implementación efectiva de Angular Aria para accesibilidad en UI

    Angular Aria — nueva librería de accesibilidad

    Tiempo estimado de lectura: 4 min

    • Ideas clave:
    • Angular Aria ofrece primitivas “headless” que implementan patrones APG para teclado, foco y lectores de pantalla.
    • Diferencia con Material y CDK: Material provee UI completa, CDK utilidades low‑level, Aria patrones sin estilo.
    • Beneficios: reduce deuda técnica, mejora consistencia y facilita cumplimiento de auditorías WCAG.
    • Riesgos: API inicial puede cambiar; requiere disciplina de integración con el Design System.

    Introducción

    Angular Aria — nueva librería de accesibilidad llega para resolver lo que suele hacerse mal una y otra vez: la lógica de interacción accesible. En las primeras líneas: no es un tema de añadir atributos; es una capa de comportamiento (gestión de foco, navegación por teclado, anuncios a lectores de pantalla) que ahora Angular ofrece como primitivas headless, complementando Angular Material y el CDK.

    Resumen rápido (lectores con prisa)

    Qué es: Colección de patrones UI headless que implementan prácticas APG para accesibilidad.

    Cuándo usarlo: Cuando necesitas control visual propio y comportamiento accesible consistente.

    Por qué importa: Reduce errores de interacción al estandarizar foco, teclado y anuncios a lectores de pantalla.

    Cómo encaja: Primitivas headless que exponen estado y handlers; tú aplicas estilos desde tu Design System.

    Qué es Angular Aria — nueva librería de accesibilidad y por qué importa

    Angular Aria es una colección de patrones de UI “headless” diseñada para implementar las prácticas recomendadas de WAI-ARIA (APG) sin imponer estilos. La idea es separar semántica y comportamiento de la capa visual: tú pones los estilos, Angular Aria se encarga de que el componente responda correctamente a teclado, foco y tecnologías asistivas.

    Documentación relevante:

    ¿Por qué importa? Porque los errores de accesibilidad no son solo reputacionales ni legales: son errores de interacción. Un Combobox mal implementado deja fuera a usuarios con teclado o lectores de pantalla. La complejidad real no está en el atributo aria-label; está en coordinar foco, roles, aria-live, y atajos de teclado en todas las plataformas.

    Diferencias claras: Angular Material vs CDK vs Angular Aria

    Angular Material

    Componentes completos con estilo y accesibilidad integrada. Ideal si aceptas Material Design y quieres velocidad.

    Docs: Docs

    Angular CDK

    Utilidades de bajo nivel (Overlays, FocusMonitor, LiveAnnouncer). Es la caja de herramientas para construir componentes.

    CDK a11y: CDK a11y

    Angular Aria

    Patrones de componentes sin estilo (Accordion, Dialog, Combobox, Menu, etc.) con semántica ARIA y gestión de interacción resuelta. Tú aplicas CSS.

    Piensa en Aria como la “implementación canónica” de las APG para Angular: reduce la deuda técnica y la variabilidad entre implementaciones de distintos equipos.

    Ejemplo conceptual (cómo encaja en un Design System)

    No entraré a nombrar APIs finales —las convenciones pueden evolucionar—, pero un flujo habitual sería:

    1. Importas la primitiva headless (p. ej. DialogBehavior).
    2. Montas el markup semántico y enlazas directivas/servicios que exponen estado y handlers.
    3. Aplicas estilos desde tu sistema (Tailwind, Sass, CSS Modules).

    Pseudocódigo conceptual:

    <app-dialog *ariaDialog>
      <div ariaDialogTrigger>Abrir diálogo</div>
      <div ariaDialogContent>
        <!-- foco gestionado, escape cierra, roles y aria-hidden se aplican automáticamente -->
      </div>
    </app-dialog>

    Resultado: el comportamiento accesible ya está cubierto; el equipo sólo diseña la apariencia.

    Impacto en equipos y auditorías de accesibilidad

    • Time to Market: menor, porque no rehaces la lógica de interacción en cada componente.
    • Consistencia: menos variaciones entre módulos y menos fallos en auditorías WCAG 2.1 AA.
    • Mantenibilidad: actualizaciones de patrones centralizadas en la librería oficial reducen riesgo técnico.

    Si tu organización debe pasar auditorías (WCAG, EN 301 549), Angular Aria reduce la superficie de riesgo técnico al ofrecer implementaciones alineadas con APG.

    Riesgos, limitaciones y puntos de decisión

    • Estabilidad de API: siendo lanzamiento reciente, algunas APIs pueden cambiar. Revisa changelogs antes de adopciones masivas.
    • Superposición con CDK a11y: es probable que parte del CDK siga existiendo como utilidades de bajo nivel; Aria levantará patrones completos.
    • Integración visual: necesitas disciplina en el Design System para unir las primitivas headless con tokens y utilidades de estilos.

    Criterio técnico para la adopción (resumen accionable)

    Adopta Angular Aria si:

    • Estás construyendo un Design System white‑label o con identidad visual propia.
    • Tu equipo usa CSS utilitario (Tailwind) o quiere control total sobre la apariencia.
    • Tienes requisitos normativos o usuarios con necesidades de accesibilidad.

    No es prioritaria si:

    • Estás plenamente integrado con Angular Material y aceptas su estética.
    • Tu proyecto es un prototipo o MVP donde la prioridad es velocidad visual sin personalización.

    Checklist de integración mínima:

    • Añade pruebas de accesibilidad automatizadas (axe, Pa11y) en CI.
    • Mantén lockfiles y revisa cambios en dependencias a nivel de PR.
    • Planifica migración por componentes: empezar por Dialogs/Comboboxes reduce riesgo.

    Conclusión

    Angular Aria no es “otro paquete” más; es la pieza que permite a Angular competir en el terreno del Headless UI con garantías de accesibilidad. Para equipos que construyen componentes a medida, representa una inversión de tiempo recuperable en forma de consistencia, cumplimiento y reducción de deuda técnica. Implementa pruebas y políticas de adopción por fases, y usa Aria para que la accesibilidad deje de ser un añadido y pase a ser la base del comportamiento de tus interfaces.

    FAQ

    ¿Qué es Angular Aria?

    Una colección de patrones UI headless para implementar prácticas WAI-ARIA (APG) en Angular, separando comportamiento accesible de la capa visual.

    ¿En qué se diferencia de Angular Material?

    Material ofrece componentes completos con estilo; Angular Aria ofrece patrones sin estilo que gestionan interacción y semántica accesible.

    ¿Tengo que dejar de usar CDK a11y?

    No necesariamente. CDK seguirá siendo útil como utilidades de bajo nivel; Angular Aria ofrece patrones completos construidos sobre prácticas APG.

    ¿Qué beneficios trae para auditorías WCAG?

    Reduce la superficie de riesgo técnico al proporcionar implementaciones alineadas con APG, lo que ayuda a pasar auditorías WCAG 2.1 AA y otras normativas.

    ¿Cuáles son los riesgos al adoptar Angular Aria ahora?

    La API puede cambiar en etapas tempranas; es recomendable revisar changelogs y planificar migraciones por componentes para mitigar riesgo.

    ¿Dónde puedo leer las prácticas y ejemplos relacionados?

    Revisa la WAI-ARIA Authoring Practices Guide y la documentación oficial de Angular. También hay ejemplos en React Aria y Radix UI.

  • Implementación de Hexagonal Architecture en Angular para una mejor estructura

    Implementación de Hexagonal Architecture en Angular para una mejor estructura

    Hexagonal Architecture con Angular: Guía práctica y criterio técnico

    Hexagonal Architecture con Angular no es una moda bonita para poner en un README. Es la forma de evitar que tu aplicación se convierta en un Frankenstein atado al framework. Aquí te explico por qué, cómo y cuándo aplicarla sin volverte un fanático de la abstracción.

    Tiempo estimado de lectura: 3 min

    • Aislamiento claro: separa la lógica de negocio (TypeScript puro) de Angular y la infraestructura usando puertos y adaptadores.
    • Pruebas fiables: casos de uso sin TestBed permiten tests rápidos y menos fragilidad en CI.
    • Control del cambio: abstrae donde hay probable evolución; evita sobreingeniería y abuso de interfaces.
    • Arquitectura práctica: estructura por responsabilidad para facilitar reemplazos de adaptadores (Http, WebSocket, NgRx).

    ¿Qué es, en una línea? Aislar la lógica de negocio (TypeScript puro) del mundo exterior (Angular, Http, storage), usando puertos (contratos) y adaptadores (implementaciones).

    Resumen rápido (lectores con prisa)

    Patrón que separa dominio, aplicación e infraestructura para mantener la lógica de negocio independiente del framework. Útil cuando hay lógica cliente significativa y se busca testeo rápido. Implementación con puertos (contratos) y adaptadores (implementaciones concretas).

    Hexagonal Architecture con Angular: las capas y el contrato de dependencia

    Dominio (core)

    Entidades y reglas. Nada de Angular, nada de RxJS. Tipo puro.

    Aplicación

    Casos de uso y puertos. Orquestan el dominio y definen contratos (interfaces o clases abstractas).

    Infraestructura

    Adaptadores concretos (HttpClient, NgRx, components). Aquí vive Angular.

    Regla de oro: las capas exteriores conocen a las interiores; las interiores no conocen a las exteriores.

    Referencia conceptual: Alistair Cockburn — Ports and Adapters (hexagonal)

    Ejemplo mínimo y realista

    Dominio puro

    // domain/user.entity.ts
    export class User {
      constructor(public id: string, public email: string, public role: 'admin' | 'user') {}
      isAdmin() { return this.role === 'admin'; }
    }
      

    Puerto (aplicación)

    // application/ports/user.repository.port.ts
    export abstract class UserRepositoryPort {
      abstract findById(id: string): Promise;
      abstract save(user: User): Promise;
    }
      

    Adaptador (infraestructura – Angular)

    // infrastructure/adapters/http-user.repository.ts
    @Injectable()
    export class HttpUserRepository implements UserRepositoryPort {
      constructor(private http: HttpClient) {}
      findById(id: string) { return firstValueFrom(this.http.get(`/api/users/${id}`)); }
      save(user: User) { return firstValueFrom(this.http.post('/api/users', user)); }
    }
      

    Inyección con Angular (config)

    // app.config.ts
    providers: [
      { provide: UserRepositoryPort, useClass: HttpUserRepository },
      GetUserUseCase
    ]
      

    Angular DI hace el puente. Más sobre DI en la doc oficial: Angular Dependency Injection

    Testing: la ganancia real

    Cuando los casos de uso son TypeScript puro, los tests son instantáneos y sin TestBed. No más correr un microclima Angular solo para comprobar una regla de negocio.

    it('devuelve usuario por id', async () => {
      const mockRepo = { findById: jest.fn().mockResolvedValue(fakeUser) };
      const useCase = new GetUserUseCase(mockRepo as any);
      expect(await useCase.execute('123')).toEqual(fakeUser);
    });
      

    Resultado: CI más rápido, menos fragilidad y menos magia negra en los tests.

    Estructura recomendada (simple y práctica)

    Mantén carpetas por responsabilidad, no por tecnología:

    src/
    ├── domain/
    ├── application/
    │   ├── ports/
    │   └── use-cases/
    └── infrastructure/
        ├── adapters/
        └── ui/
      

    Esto hace que mover o substituir adaptadores (pasar de Http a WebSocket, o de NgRx a Signals) sea una tarea controlada, no una reescritura.

    Cuándo aplicarla (criterio técnico)

    Aplica Hexagonal Architecture con Angular si:

    • Tienes lógica importante en cliente (cálculos, reglas offline, validaciones complejas).
    • Quieres tests rápidos y confiables.
    • El producto vive años y el equipo crece.
    • Necesitas desarrollar en paralelo con mocks estables.

    No la apliques si

    • Es un CRUD simple que solo pinta el backend.
    • La prioridad es lanzar rápido con un equipo pequeño.
    • El dominio todavía está cambiando cada sprint (prototipado extremo).

    El patrón no te hace bueno; te sirve si resuelves un problema claro. Forzarlo es sobreingeniería.

    Puntos de atención y antipatterns

    • No conviertas cada función en una interfaz por paranoia. Aplica abstracción donde hay cambio probable.
    • Evita traer RxJS al dominio para “beneficiarte” del stream — eso es acoplamiento. Usa adaptadores para transformar observables a promesas o tipos puros.
    • No escondas lógica en componentes; los componentes deben orquestar, no contener reglas.

    Cierre con acción

    Si quieres, en el próximo artículo preparo:

    • Un scaffold de proyecto Angular con carpeta hexagonal lista.
    • Un checklist de decisiones (qué abstraer, cuándo usar InjectionToken vs clase abstracta).

    Apúntate al newsletter de Dominicode para recibirlo y el starter con ejemplos de tests en Jest.

    Esto no termina aquí. Si tu código se está volviendo difícil de probar o de migrar, la arquitectura es la palanca—y saber cuándo usarla es criterio.

    FAQ

    ¿Qué es Hexagonal Architecture?

    Patrón que aísla la lógica de negocio en el centro y separa las dependencias externas mediante puertos (contratos) y adaptadores (implementaciones concretas).

    ¿Por qué aplicarla con Angular?

    Permite mantener TypeScript puro en el dominio, reducir acoplamiento al framework y facilitar tests rápidos y menos frágiles.

    ¿Cómo se implementan los puertos y adaptadores?

    Los puertos son interfaces o clases abstractas en la capa de aplicación; los adaptadores son implementaciones concretas en infraestructura (por ejemplo, un repositorio HTTP usando HttpClient).

    ¿Cómo mejora el testing?

    Los casos de uso escritos en TypeScript puro no requieren TestBed ni dependencias Angular para ejecutarlos, lo que hace los tests más rápidos y confiables.

    ¿Cuándo no debería aplicarse?

    No conviene para CRUDs simples, equipos pequeños que priorizan velocidad de entrega, o durante prototipado extremo donde el dominio cambia constantemente.

    ¿Dónde encontrar referencias adicionales?

    Referencia conceptual: Alistair Cockburn — Ports and Adapters (hexagonal). Para DI en Angular: Angular Dependency Injection.