Category: AI

  • El Agentic Harness: Por qué un LLM por sí solo no es un producto

    El Agentic Harness: Por qué un LLM por sí solo no es un producto

    Cuando ves la demostración de un brazo robótico industrial realizando una tarea de precisión milimétrica, te quedas maravillado con la tecnología. Sin embargo, ninguna fábrica en su sano juicio dejaría que ese brazo operase de forma autónoma en su línea de montaje si solo consistiera en el motor mecánico.

    Necesita sensores de proximidad, sistemas de parada de emergencia, un software de control de límites y un operario humano supervisando la consola.

    El brazo aporta la fuerza y el movimiento bruto; pero la seguridad, consistencia y utilidad real de la operación dependen del soporte que lo rodea.

    En la inteligencia artificial moderna ocurre exactamente lo mismo. Un modelo de lenguaje (como Claude 3.5 Sonnet o GPT-4o) por sí solo es como ese brazo sin sensores. Para que solucione problemas reales en tu empresa, necesitas envolverlo en un Agentic Harness (Arnés Agéntico).

    Hoy te quiero explicar en qué consiste este concepto arquitectónico y por qué el diseño del arnés es lo que realmente convierte a la IA en un producto de negocio viable.


    El modelo es solo la "inteligencia"

    Existe una falsa creencia de que para automatizar un proceso basta con comprar tokens de API del modelo más grande de la nube y empezar a enviarle instrucciones conversacionales.

    Los LLMs son motores de predicción de texto extraordinarios, pero sufren de carencias críticas que les impiden operar en producción de forma directa:

    1. Carecen de estado: No recuerdan lo que pasó hace cinco minutos a menos que les reenvíes todo el historial (lo que satura el contexto y encarece la consulta).
    2. No controlan su ejecución: Pueden proponer una consulta SQL brillante, pero no tienen la capacidad física de conectarse a tu base de datos para ejecutarla y leer los resultados.
    3. Alucinan bajo presión: Si una herramienta externa les devuelve un error inesperado, el modelo suele inventar un parche absurdo en lugar de detenerse y pedir ayuda.

    Aquí es donde entra el Agentic Harness. El arnés es la infraestructura de software que envuelve al modelo para convertirlo en un agente autónomo, seguro y con memoria persistente.


    Las 4 patas de un Agentic Harness de Producción

    Para que tu arnés agéntico sea robusto y scalables, debe estructurar cuatro capas de soporte bien definidas alrededor de la API del LLM:

    ┌────────────────────────────────────────────────────────┐
    │                    AGENTIC HARNESS                     │
    ├───────────────┬────────────────┬───────────────┬───────┤
    │ Orquestación  │  Persistencia  │  Sandboxing   │ Evals │
    │ y Flujo (Loop)│   y Memoria    │ de Ejecución  │   y   │
    │               │ (SQLite/FTS5)  │    (Docker)   │ Control│
    └───────────────┴────────────────┴───────────────┴───────┘
                                    ▲
                                    │ (Inferencia)
                         [ API de Inferencia LLM ]
    

    1. Orquestación y Control (El Bucle de Decisiones)

    Es el motor lógico que gestiona el ciclo de vida del agente. Se encarga de parsear las peticiones del usuario, construir el prompt de entrada estructurado, llamar al modelo y mapear las respuestas de este hacia herramientas ejecutables. Si la llamada de la herramienta devuelve un error, el loop se encarga de re-intentarlo o alterar el plan de forma autónoma.

    2. Persistencia y Memoria (El Almacén de Estado)

    Evita la amnesia del agente. El arnés debe persistir el estado de la conversación y las variables en una base de datos local (como SQLite con soporte WAL). Si el servidor se apaga o el contenedor de Railway se actualiza por Git-Ops, el agente puede recuperar su memoria y reanudar el flujo en el punto exacto donde se quedó.

    3. Sandboxing de Ejecución (La Seguridad Física)

    Un arnés seguro nunca permite que la IA ejecute código de forma directa en el servidor principal. Como vimos en nuestro post sobre Docker Sandboxing en producción, el aislamiento es la clave. El arnés debe levantar contenedores efímeros cerrados de Docker para que el agente pruebe sus scripts de diagnóstico o compile programas sin poner en riesgo la estabilidad del VPS.

    4. Gobernanza y Evals (El Control Humano)

    El arnés define las fronteras éticas y operativas. Registra logs estructurados para auditorías, escanea prompts entrantes contra inyecciones y, lo más importante, implementa sistemas de autorización (Human-in-the-loop). Si el agente quiere realizar una acción crítica (como eliminar datos o transferir fondos), el arnés congela la ejecución y solicita confirmación al administrador por Telegram.


    Hermes Agent: Un Arnés Agéntico Open-Source

    El framework de Hermes Agent de Nous Research es un excelente ejemplo de un Agentic Harness de producción. No es un modelo de IA; es el andamiaje técnico que te proporciona la persistencia en SQLite, el aislamiento en Docker sandboxes y la interfaz de MCP listos para usar de forma nativa.

    Entender la IA como un sistema completo y no como una simple consulta a una API es la base que enseñamos en el curso de Construye con IA para desarrollar productos robustos. Además, es la arquitectura de infraestructura que implementamos de principio a fin en el nuevo curso de Agentes IA Autónomos en Producción con Hermes Agent.


    Conclusión: Deja de comprar modelos, diseña tu arnés

    Los modelos de lenguaje seguirán bajando de precio y haciéndose más inteligentes cada mes. Son un commodity. El verdadero valor y la propiedad intelectual de tu negocio radican en el diseño de tu Agentic Harness. Al construir un arnés modular, seguro y persistente, garantizas que cualquier modelo (local o en la nube) pueda operar con consistencia para resolver las tareas operativas de tu empresa.

    Si estás estructurando el arnés agéntico para tu negocio y quieres discutir decisiones de arquitectura o seguridad con otros desarrolladores senior de nuestra comunidad, te espero en Dominicode Labs.


    Todo esto descansa sobre una distinción que conviene no dar por sabida: la definición operativa de agente de IA, la que se puede verificar mirando tu código en vez de la etiqueta del producto.

    Preguntas Frecuentes (FAQ)

    ¿Cuál es la diferencia entre LangChain y un Agentic Harness completo?

    ¿Cuál es la diferencia entre LangChain y un Agentic Harness completo? LangChain o LlamaIndex son librerías de software y componentes que te ayudan a estructurar flujos de datos e integraciones. Un Agentic Harness es el sistema en ejecución completo en producción (la arquitectura de servidores, bases de datos de estado, sandboxes aislados de Docker y gateways de mensajería) que aloja y opera al agente de forma continua.

    ¿Por qué la base de datos de persistencia es crítica en el arnés?

    Porque las APIs de inferencia en la nube no guardan historial de conversación real; son totalmente stateless. Sin una base de datos local sólida en el arnés que registre el estado de las sesiones y variables ante cualquier reinicio de servidor, tu agente sufrirá de amnesia agéntica, perdiendo el hilo de su tarea en curso.

    ¿Se pueden integrar políticas de seguridad en el arnés?

    Sí, de hecho es el lugar ideal para hacerlo. Al centralizar el control de ejecución en el arnés, puedes añadir filtros de censura de salida, restringir accesos a carpetas mediante permisos del sistema de archivos y bloquear comandos de consola peligrosos mediante aprobaciones manuales del usuario.

    ¿El arnés agéntico depende de un modelo específico?

    No. Un arnés bien diseñado debe estar totalmente desacoplado del backend de inferencia. Al utilizar APIs compatibles con la interfaz de OpenAI o Anthropic, puedes conectar tu arnés a un servidor local de oMLX en Mac, a Ollama en local, o a modelos propietarios en la nube (como Claude 3.5 o GPT-4) sin reescribir la lógica operativa de tu sistema.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Guía de Modelos: Los mejores LLMs para correr en local

    Guía de Modelos: Los mejores LLMs para correr en local

    La primera vez que abres Hugging Face, te abrumas. Hay cientos de miles de modelos subidos. Nombres crípticos como Qwen2.5-Coder-7B-Instruct-Q4_K_M.gguf o DeepSeek-R1-Distill-Llama-8B llenan la pantalla de descargas.

    ¿Cuál de todos ellos deberías bajar?

    Si descargas el equivocado, tu ordenador tardará diez segundos en responder cada palabra o, peor aún, la IA empezará a alucinar código absurdo. Correr modelos de IA en local de forma eficiente requiere elegir el modelo adecuado para tu hardware. Como vimos en nuestro post anterior, configurar tu entorno de hardware para LLMs locales es el paso inicial antes de elegir tu modelo de uso diario.

    Hoy te quiero enseñar la guía definitiva con las mejores familias de modelos libres que puedes ejecutar hoy mismo localmente, en qué tareas destaca cada uno y cómo dimensionar su tamaño según tu memoria RAM.


    Las 5 mejores familias de modelos locales

    A día de hoy, el ecosistema de código abierto se ha consolidado en torno a cinco grandes opciones que cubren todas las necesidades de desarrollo y automatización:

    1. Qwen 2.5 Coder (7B y 32B) — El Rey de la Programación

    Desarrollado por Alibaba, es el mejor modelo del mundo para desarrollo de software local en 2026. Su variante de 7B parámetros es tan rápida y precisa que puede correr en cualquier portátil, mientras que el modelo de 32B rivaliza directamente con GPT-4o en generación de código.

    • Ideal para: Autocompletado en IDEs (Cursor/VS Code), refactorizaciones de código y escritura de scripts.

    2. Llama 3 (8B y 70B) — El estándar multipropósito

    El modelo de Meta es la base del ecosistema. Cuenta con un excelente soporte para múltiples idiomas, sigue instrucciones complejas con mucha precisión y está altamente integrado en todos los frameworks de desarrollo.

    • Ideal para: Chatbots generales, análisis de texto, tareas RAG (búsqueda sobre tus documentos locales) y soporte al cliente.

    3. DeepSeek-R1 Distilled (8B y 32B) — Razonamiento avanzado (o1/o3-style)

    Estos modelos han sido entrenados para "pensar antes de hablar". Muestran su cadena de razonamiento y son excepcionales resolviendo problemas lógicos complejos, matemáticas y planificación de arquitectura.

    • Ideal para: Resolver bugs difíciles, planificar especificaciones funcionales y analizar flujos lógicos en bucle.

    4. Mistral & Nemo (7B y 12B) — Ligero y compatible con Herramientas

    La empresa francesa Mistral AI destaca por crear modelos extremadamente compactos con un excelente soporte para la llamada de funciones (Tool Calling).

    • Ideal para: Agentes autónomos (como Hermes Agent) que necesitan interactuar con APIs externas y ejecutar comandos de consola de forma rápida y segura.

    5. Gemma 2 (2B y 9B) — La opción eficiente de Google

    Google ha diseñado una arquitectura muy eficiente que exprime la memoria al máximo. Su modelo de 2B parámetros es perfecto para dispositivos móviles o portátiles antiguos, mientras que la versión de 9B destaca en fluidez de redacción.

    • Ideal para: Dispositivos con recursos limitados (computadores de 16GB de RAM o menos).

    El Secreto del Rendimiento Local: La Cuantización

    No puedes descargar un modelo en su formato original de flotantes (FP16) y esperar que corra en tu ordenador. Ocuparía demasiada memoria. Un modelo de 7B parámetros sin optimizar requeriría más de 14GB de VRAM solo para cargarse en memoria.

    Para solucionar esto, utilizamos cuantización.

    La cuantización consiste en comprimir los pesos del modelo (reduciendo la precisión matemática de 16 bits a 4 u 8 bits).

    El sweet spot indiscutible para la mayoría de desarrolladores es el formato Q4_K_M (cuantización a 4 bits). Reduce el peso en disco del modelo en un 70% (un modelo de 7B pasa de pesar 14GB a ocupar solo 4.5GB en disco) a cambio de una pérdida de precisión matemática prácticamente imperceptible para el usuario.


    Guía rápida de Sizing de memoria RAM/VRAM

    Antes de iniciar cualquier descarga, verifica este mapa de recursos para saber qué modelo puede digerir tu máquina:

    • 16GB de RAM/VRAM: Puedes correr de forma fluida modelos cuantizados de 7B u 8B parámetros (como Qwen 2.5 Coder 7B o Llama 3 8B).
    • 32GB de RAM/VRAM: El entorno perfecto para modelos medianos de 12B a 14B parámetros, o versiones muy optimizadas de modelos de 32B.
    • 64GB de RAM/VRAM o superior: Puedes correr modelos masivos de 32B y 70B parámetros (como Qwen 32B o Llama 70B) que te darán respuestas al nivel de las mejores IAs de pago de la nube.

    Esta lógica de calibración de hardware y selección de modelos locales es la base de las infraestructuras de desarrollo que montamos en el curso de Construye con IA y que llevamos a su máximo rendimiento en el nuevo curso de Hermes Agent.


    Conclusión: Descarga con estrategia

    No descargues el modelo más grande solo porque tiene mejores números en los benchmarks. Un modelo de 7B corriendo a 50 tokens por segundo en tu GPU local siempre te dará una mejor experiencia de desarrollo que un modelo de 70B que satura tu memoria y responde a 1 token por segundo. Encuentra tu equilibrio de hardware, aplica cuantización a 4 bits y monta un entorno de IA local eficiente.

    Si quieres compartir benchmarks de rendimiento de modelos locales en tu propia máquina y conocer qué setups usa nuestra comunidad, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué significa el sufijo "Instruct" en los modelos de Hugging Face?

    Los modelos marcados como "Instruct" han sido entrenados específicamente para seguir instrucciones de los usuarios y mantener conversaciones. Los modelos "Base" o nativos solo sirven para completar texto y no son aptos para interfaces de chat o asistentes de código directo.

    ¿Cuál es la diferencia entre los formatos GGUF y safetensors?

    GGUF es un formato contenedor diseñado por el ecosistema de llama.cpp para correr modelos en CPU y GPU locales compartiendo la memoria RAM de forma eficiente. Safetensors es el formato nativo utilizado principalmente por runtimes de Python (como PyTorch o Hugging Face transformers) para entrenamiento e inferencia en tarjetas gráficas dedicadas.

    ¿Se pueden mezclar modelos locales con APIs en la nube?

    Sí. Herramientas de orquestación como Hermes Agent permiten configurar setups híbridos. Puedes configurar tu agente para que use un modelo de código local ultra-rápido (como Qwen 2.5 Coder 7B) para autocompletados y delegue las tareas de planificación complejas a APIs externas como Claude 3.5 Sonnet.

    ¿Los modelos locales pueden dañar mi hardware?

    No. Correr modelos locales consumirá el 100% de los recursos de tu GPU/CPU durante la inferencia, lo que aumentará la temperatura de los componentes y activará los ventiladores de tu máquina. Es un comportamiento totalmente normal bajo cargas de trabajo pesadas de computación.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cómo crear una skill con Claude Code que tu agente realmente use

    Cómo crear una skill con Claude Code que tu agente realmente use

    1. Detecta el último tag con git describe --tags --abbrev=0.
      Si no hay tags, usa el primer commit del repo (git rev-list --max-parents=0 HEAD).

    2. Lista los commits desde ese punto:
      git log <tag>..HEAD --pretty=format:"%s|%h|%an"

      Si el repo tiene el script scripts/parse-commits.sh, úsalo en su lugar —
      ya devuelve los commits agrupados por tipo.

    3. Clasifica cada commit por su prefijo (Conventional Commits):

      • feat: → Added
      • fix: → Fixed
      • refactor:, perf:, chore: → Changed
      • Cualquier otro → Otros cambios (inclúyelo, no lo descartes)
    4. Redacta cada línea en español, orientada al usuario final, no al código.
      "feat: add retry logic to http client" se convierte en
      "El cliente HTTP ahora reintenta automáticamente las peticiones fallidas."

    5. Genera la sección nueva del changelog:

      [Sin publicar] – AAAA-MM-DD

      Added

      • …

      Fixed

      • …

      Changed

      • …
    6. CHECKPOINT — antes de tocar el archivo, muéstrame la sección generada
      en el chat y espera mi confirmación explícita. Este paso es obligatorio:
      CHANGELOG.md está versionado y no quiero sorpresas.

    7. Si confirmo, inserta la sección arriba de la última entrada en
      CHANGELOG.md. Si pido cambios, ajusta y vuelve al paso 6.

    8. No hagas commit ni push. Termina mostrando el diff del archivo.

    
    Y el script de soporte, `scripts/parse-commits.sh` — opcional, pero le ahorra a Claude tener que interpretar el output crudo de `git log`:
    
    ```bash
    #!/usr/bin/env bash
    set -euo pipefail
    
    TAG=$(git describe --tags --abbrev=0 2>/dev/null || git rev-list --max-parents=0 HEAD)
    
    git log "${TAG}..HEAD" --pretty=format:'%s' | while read -r line; do
      case "$line" in
        feat:*)     echo "ADDED|${line#feat: }" ;;
        fix:*)      echo "FIXED|${line#fix: }" ;;
        refactor:*) echo "CHANGED|${line#refactor: }" ;;
        chore:*)    echo "CHANGED|${line#chore: }" ;;
        *)          echo "OTHER|${line}" ;;
      esac
    done
    

    Con esto guardado, escribo en el chat "prepara las notas de la release" y Claude Code hace el resto: detecta la skill por la description, corre el script, clasifica, redacta, y me para en seco antes de tocar un archivo versionado.

    Buenas prácticas que aprendí a la fuerza

    Pon checkpoints en todo lo irreversible. Escribir un archivo, hacer push, mandar un mensaje a Slack, borrar algo — cualquier paso caro de deshacer necesita una confirmación explícita en medio de la skill, no al final. Es la diferencia entre revisar un preview y descubrir el desastre ya en producción.

    Deja que la skill delegue en un subagente cuando el trabajo es pesado. Si un paso implica investigar, leer decenas de archivos o generar contenido largo, no lo hagas inline: invoca un subagente especializado para esa parte. Mantiene limpio el contexto de la conversación principal y evita que la skill se vuelva un monstruo de 300 líneas.

    Prueba la skill en conversación real antes de darla por terminada. Escribe la description, úsala tres o cuatro veces con frases distintas y fíjate en cuándo se activa y cuándo no. Ajusta el texto según lo que veas, no según lo que creas que debería pasar. Es la misma lógica de iteración que enseño en el curso Construye con IA: no escribes la spec perfecta a la primera, la afinas contra el comportamiento real del agente.

    Hay un nivel más adelante: agentes que escriben sus propias skills en caliente cuando se topan con un problema nuevo, sin que tú definas nada de antemano. Así funciona el Self-Improving Loop de Hermes Agent — pero esa es una capa distinta a la que cubrimos hoy, donde eres tú quien define el proceso.

    Skills, comandos y subagentes: cuándo usar cada uno

    Herramienta Quién la invoca Contexto Úsala para
    Comando slash Tú, explícitamente (/nombre) El mismo de la conversación Acciones puntuales que disparas a propósito
    Skill Claude, solo, según la description El mismo de la conversación Procesos y conocimiento que se deben aplicar siempre, sin pedirlo cada vez
    Subagente Claude o tú, delegando Ventana aislada, propia Tareas largas o ruidosas que ensuciarían el contexto principal

    No son excluyentes. Mi skill del changelog podría, en un paso intermedio, delegar en un subagente que revise el tono de cada línea antes de mostrarme el preview. Se combinan.

    Qué hacer con esto hoy

    Abre un proyecto donde repitas algo cada semana. Escribe el SKILL.md con una description que incluya las frases exactas que usarías para pedirlo, y un "NO la uses para" explícito. Pruébala tres veces antes de confiar en ella.

    Si el proceso involucra tocar código, escribir archivos o correr comandos, mete un checkpoint. Siempre. La skill que no para a preguntar es la skill que un día te rompe algo en silencio.

    Si quieres ver más skills reales que uso en producción — no solo la del changelog — las voy soltando en Dominicode Labs. Y si prefieres verlo en pantalla en vez de leerlo, en el canal de YouTube tengo el mismo flujo grabado de principio a fin.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre una skill y un subagente en Claude Code?

    Una skill inyecta sus instrucciones en la conversación que ya tienes abierta — no aísla nada. Un subagente corre en una ventana de contexto separada, con su propio system prompt y su propio set de herramientas. Usas una skill para aplicar un proceso o conocimiento de forma consistente; usas un subagente para delegar una tarea larga o ruidosa que ensuciaría el contexto principal. Y una skill puede invocar a un subagente dentro de sus propios pasos — no son excluyentes.

    ¿En qué se diferencia una skill de un comando slash en Claude Code?

    En quién decide invocarla. Un comando slash (.claude/commands/*.md) lo disparas tú a propósito, escribiendo /nombre-del-comando. Una skill la dispara Claude solo, cuando el contexto de la conversación coincide con lo que describe su description en el frontmatter. Si necesitas control total sobre cuándo se ejecuta algo, usa un comando. Si quieres que el agente aplique un proceso sin que se lo tengas que pedir cada vez, crea una skill.

    ¿Dónde debo guardar mis skills, en el proyecto o de forma global?

    Si la skill depende de convenciones específicas de un repo — como el formato exacto del changelog de ese proyecto — guárdala en .claude/skills/ dentro del repo. Si es un proceso que repites en todos tus proyectos (auditar accesibilidad, generar tests, revisar una spec), ponla en ~/.claude/skills/ para que esté disponible en cualquier sesión.

    ¿Cómo sé si Claude realmente activó mi skill y no está improvisando?

    Claude Code indica cuándo carga una skill durante la conversación. Si pides algo que debería activarla y no ves esa señal, es casi siempre un problema de description: o es demasiado vaga, o compite con otra skill que describe algo parecido.

    ¿Puedo tener dos skills que se superpongan en tema sin que se pisen?

    Puedes, pero no deberías. Si dos descriptions cubren un terreno similar, Claude tiene que decidir entre ambas y a veces se equivoca. Es mejor una sola skill bien delimitada que dos que compiten por el mismo trigger.

    ¿Una skill puede invocar a un subagente dentro de sus instrucciones?

    Sí. Puedes escribir un paso que diga explícitamente "delega esta parte en el subagente X" y Claude lo hace como parte del flujo de la skill. Es la combinación que uso cuando un paso requiere investigación o generación larga sin ensuciar el contexto principal.

    ¿Las skills reemplazan al archivo CLAUDE.md del proyecto?

    No. CLAUDE.md es contexto general que Claude lee siempre — arquitectura, convenciones, comandos del proyecto. Una skill es un proceso puntual que se activa solo cuando aplica. Uno da contexto permanente, la otra ejecuta un flujo específico. Se complementan, no se sustituyen.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Claude Code: Ahorra 90% en tokens con este truco

    Claude Code: Ahorra 90% en tokens con este truco

    Ayer estaba revisando la factura de mi cuenta de Anthropic. Estaba utilizando la nueva CLI de Claude Code para refactorizar un proyecto local y noté que los costes se estaban disparando de forma absurda. Cada pequeña pregunta rápida de "sí" o "no" me estaba costando miles de tokens de entrada completos.

    ¿Cómo era posible? El sistema de Prompt Caching de Anthropic promete ahorrar hasta un 90% de los costes en contextos de conversación repetidos y largos.

    Al investigar la consola de depuración por debajo, descubrí al culpable. Un comportamiento por defecto en el diseño de Claude Code que destruye el caché en cada turno.

    Hoy te quiero explicar el truco de la bandera exclude-dynamic-system-prompt-sections, cómo configurarla en tu máquina y por qué te ahorrará cientos de dólares en tu factura de API de Claude.


    Por qué Claude Code rompe el Prompt Caching por defecto

    Para que el caché de prompts de Claude funcione, la IA necesita que los primeros bloques de texto de tu conversación (el System Prompt y los primeros archivos cargados) sean exactamente idénticos entre una llamada y la siguiente. Si cambia una sola letra o espacio en el System Prompt, el motor de Anthropic invalida el caché y tiene que volver a leer y procesar toda la conversación desde cero, cobrándote la tarifa completa.

    Por defecto, Claude Code intenta ser extremadamente inteligente. Cada vez que le haces una pregunta en la terminal, el CLI inyecta datos dinámicos de tu entorno directamente dentro del System Prompt:

    • La fecha y hora exacta actual (cambia cada segundo).
    • Tu directorio de trabajo actual (cambia si navegas carpetas).
    • El estado de tu repositorio de Git (cambia con cada commit o archivo modificado).

    Como esta información varía constantemente, tu System Prompt es distinto en cada interacción. El resultado: un 0% de efectividad de caché y una factura inflada de tokens de entrada.


    La Solución: Excluir las Secciones Dinámicas

    Para solucionar este desperdicio de tokens, Anthropic introdujo la bandera --exclude-dynamic-system-prompt-sections.

    Cuando ejecutas Claude Code con este parámetro, el CLI modifica su comportamiento arquitectónico: extrae toda la información dinámica y variable (fecha, git status, directorio) del System Prompt y la inyecta al final del User Message (el mensaje que tú escribes).

    De este modo:

    1. El System Prompt queda estático y congelado en la memoria de la API de Anthropic.
    2. Tu tasa de acierto de caché de prompts sube a prácticamente el 100%.
    3. Tus respuestas locales tardan milisegundos en lugar de segundos porque el modelo no tiene que volver a re-procesar los archivos del repositorio en cada turno.

    Cómo configurarlo en tu entorno de desarrollo

    Tienes dos formas de aplicar este hack de ahorro de costes según tu preferencia:

    Opción 1: Ejecución manual en consola

    Simplemente añade la bandera al arrancar la herramienta en tu terminal:

    claude --exclude-dynamic-system-prompt-sections
    

    Opción 2: Configuración persistente (Recomendado)

    Para no tener que escribir la bandera en cada sesión, puedes configurarla por defecto en tu archivo de preferencias global de Claude Code ubicado en ~/.claude/settings.json (o crearlo si no existe):

    {
      "excludeDynamicSystemPromptSections": true
    }
    

    Este tipo de optimizaciones de costes de API a bajo nivel y sintonía fina de prompts es la que enseñamos a dominar en el curso de Construye con IA para evitar sorpresas en facturación. Como vimos en nuestro post sobre desarrollo con IA y Loop Engineering, optimizar las APIs es crucial para mantener un runtime agéntico económico en producción, técnica que aplicamos a fondo en el nuevo curso de Hermes Agent.


    Conclusión: Controla tus llamadas

    Las herramientas agénticas de consola son increíblemente productivas, pero delegar el control de la API sin vigilar cómo se consumen los tokens es un error costoso. Al aplicar la exclusión de prompts dinámicos, garantizas un flujo de desarrollo veloz, económico y optimizado bajo los estándares de caché nativos de Anthropic.

    Si estás utilizando Claude Code en tu día a día y quieres compartir trucos de optimización de costes y automatización con otros desarrolladores senior de nuestra comunidad, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Perderá capacidad Claude Code al quitar esta información del System Prompt?

    No. El modelo sigue recibiendo exactamente la misma información (tu directorio actual, la fecha y el estado de git). La única diferencia es el lugar donde se inyecta esa información dentro del JSON de la llamada a la API. Al estar en el mensaje del usuario, no interfiere con el bloque de caché superior.

    ¿Cuánto dinero real puedo ahorrar con este ajuste?

    En repositorios medianos a grandes (donde el contexto inicial de archivos y reglas de código puede ocupar más de 20.000 tokens), el ahorro puede superar el 80% o 90% en tokens de entrada. En lugar de pagar por procesar 20.000 tokens en cada pregunta, solo pagarás una pequeña tarifa de lectura inicial y céntimos de uso de caché en los turnos posteriores.

    ¿Por qué Claude Code no tiene esta opción activada por defecto?

    Porque prioriza la experiencia de usuario inicial sobre el coste de API. Inyectar metadatos en el System Prompt garantiza que la IA entienda el contexto del sistema de archivos desde la primera palabra de forma muy estricta, aunque resulte ineficiente a nivel financiero para el desarrollador.

    ¿Se puede usar este truco en otros editores como Cursor?

    Cursor gestiona su propio sistema de prompt caching y almacenamiento de contexto de forma interna mediante indexación de archivos (embeddings). Este ajuste es exclusivo de la interfaz de consola de Claude Code (CLI oficial de Anthropic).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • OpenRouter: Qué es, para qué sirve y por qué lo necesitas

    OpenRouter: Qué es, para qué sirve y por qué lo necesitas

    Si estás construyendo una aplicación o un agente autónomo de IA, tu archivo de configuración de claves de API probablemente se parezca a una pesadilla. Tienes un token de facturación para OpenAI, otro para Anthropic, otro para los modelos de Google, y quizás una cuenta en un hosting de GPUs externas para los modelos de código abierto.

    Facturas fragmentadas, SDKs de código distintos y un dolor de cabeza constante cada vez que un proveedor sube los precios o sufre una caída de servicio.

    Hay una forma mucho más inteligente de gestionar esto.

    Hoy te quiero explicar qué es openrouter y para qué sirve, y por qué se ha convertido en la herramienta de backend indispensable para cualquier desarrollador de inteligencia artificial moderna.


    ¿Qué es OpenRouter?

    OpenRouter (disponible en openrouter.ai) es un enrutador y pasarela de API unificada para modelos de lenguaje. Actúa como un intermediario o agregador: tú te conectas a OpenRouter con una única clave de API y, a cambio, ellos te dan acceso a cientos de modelos distintos de múltiples proveedores de forma instantánea.

    En lugar de registrarte en Anthropic, OpenAI, Google Cloud, Meta y DeepSeek por separado, solo te registras en OpenRouter, cargas saldo en una sola cuenta y consumes los modelos que necesites pagando estrictamente por el uso de tokens.


    ¿Para qué sirve OpenRouter en el día a día?

    Si eres desarrollador de software o integras IA en tus flujos de negocio, OpenRouter resuelve cuatro problemas de infraestructura masivos:

    1. Unificación de SDKs (API compatible con OpenAI)

    No necesitas aprender a usar la librería de Anthropic o los formatos específicos de Google. OpenRouter utiliza el formato estándar de la API de OpenAI. Para cambiar de modelo, solo tienes que cambiar una string de texto en tu llamada, sin tocar una sola línea de código. Como vimos en nuestro análisis de Qwen 3.7 y OpenRouter, esto te permite cambiar de modelo en caliente para aprovechar el contexto extendido y las capacidades de razonamiento.

    2. Acceso a Modelos Propietarios y Open-Source

    En la misma plataforma conviven los gigantes de pago (como GPT-4o o Gemini 1.5 Pro) junto con las versiones de código abierto servidas a alta velocidad (como Qwen 2.5 Coder o DeepSeek-R1). Esto te permite experimentar con docenas de variantes en segundos.

    3. Redundancia y Fallbacks

    Si la API oficial de Anthropic se cae o sufre congestión, puedes configurar tu código para que OpenRouter derive la petición automáticamente a un modelo equivalente (como GPT-4o) de forma transparente para el usuario final, garantizando que tu aplicación nunca deje de responder.

    4. Control de Costes y Estadísticas

    La plataforma ofrece un panel visual increíblemente detallado que te muestra qué modelos están consumiendo más recursos, cuántos tokens envías en la fase de contexto y la latencia promedio de cada proveedor.


    Cómo implementarlo en tus Agentes Autónomos

    Integrar OpenRouter en frameworks agénticos como Hermes es sumamente sencillo. Al ser compatible con la especificación de OpenAI, basta con apuntar el base_url del cliente al endpoint unificado:

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: "https://openrouter.ai/api/v1",
      apiKey: "tu_token_de_openrouter_aqui",
    });
    
    async function main() {
      const completion = await client.chat.completions.create({
        model: "anthropic/claude-3.5-sonnet", // Cambia a "qwen/qwen-2.5-coder-32b" cuando quieras
        messages: [
          { role: "user", content: "Escribe una función de ordenamiento en TypeScript." }
        ],
      });
    
      console.log(completion.choices[0].message.content);
    }
    main();
    

    Este enfoque híbrido y unificado es la infraestructura de base que montamos en el curso de Construye con IA para desarrollar productos escalables, y el que explotamos en producción para conectar canales de comunicación automatizados en el nuevo curso de Hermes Agent.


    Conclusión: La API definitiva para Developers

    No pierdas el tiempo gestionando contratos de facturación individuales ni peleando con diferentes SDKs. Al adoptar OpenRouter en tus desarrollos de inteligencia artificial, simplificas tu código a una única conexión, blindas tu aplicación contra caídas de proveedores y tienes la libertad de elegir el modelo idóneo para cada tarea con un solo cambio de configuración.

    Si estás utilizando OpenRouter en producción y quieres optimizar el consumo de tus tokens en tareas agénticas complejas, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿OpenRouter cobra alguna comisión por encima del precio del modelo?

    No. OpenRouter ofrece los modelos a los precios de coste oficiales de los proveedores (e incluso más baratos en algunos modelos de código abierto debido a acuerdos de volumen con servidores de hosting de inferencia como Together o Fireworks). Su modelo de negocio se basa en la agregación y volumen de tráfico.

    ¿Qué sucede con la privacidad de mis datos al usar OpenRouter?

    OpenRouter actúa como un proxy de transporte. Tus prompts viajan encriptados a través de su API hacia el proveedor del modelo seleccionado. La plataforma no almacena las conversaciones de tus usuarios a menos que actives explícitamente los logs en tu panel de configuración para depuración de errores.

    ¿Se pueden usar herramientas (Tool Calling) a través de OpenRouter?

    Sí. OpenRouter soporta el paso de herramientas (tools) y la llamada de funciones nativas para todos los modelos que lo admitan de forma nativa en su arquitectura (como las familias de Claude, GPT, Llama y Qwen).

    ¿Es seguro usar OpenRouter para aplicaciones de producción masivas?

    Sí, es una infraestructura robusta utilizada por miles de aplicaciones y startups en producción a nivel global. Al contar con endpoints optimizados y soporte para conmutación por error (fallbacks), suele ofrecer una estabilidad incluso superior a la de conectarse directamente a un único proveedor.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Qué es un agente de IA (y qué no): guía para subir de nivel

    Qué es un agente de IA (y qué no): guía para subir de nivel

    Hace tres semanas un suscriptor me pasó el repositorio de su primer agente. Orgulloso, y con motivos: cuatrocientas líneas limpias, herramientas declaradas, tool calling funcionando.

    Le hice una sola pregunta. ¿Cuántas veces llama al modelo cuando lo ejecutas?

    Siempre tres. Las mismas tres, en el mismo orden, pasara lo que pasara.

    Eso no era un agente. Era un pipeline con tres llamadas a un LLM dentro. Y funcionaba perfectamente, que es lo que vuelve incómoda la conversación. Porque la respuesta habitual a qué es un agente de IA —"un sistema autónomo que usa herramientas para cumplir un objetivo"— describe igual de bien su script que Claude Code.

    Y no son la misma categoría de software.

    La diferencia no es semántica: decide qué tienes que instrumentar antes de dejarlo suelto y qué ocurre el día que se equivoca a las tres de la mañana.

    Aquí va la definición operativa que uso: un test que aplicas a tu código en dos minutos, la anatomía real, los grados de autonomía y —lo más importante— cuándo no deberías montar un agente.


    Resumen rápido

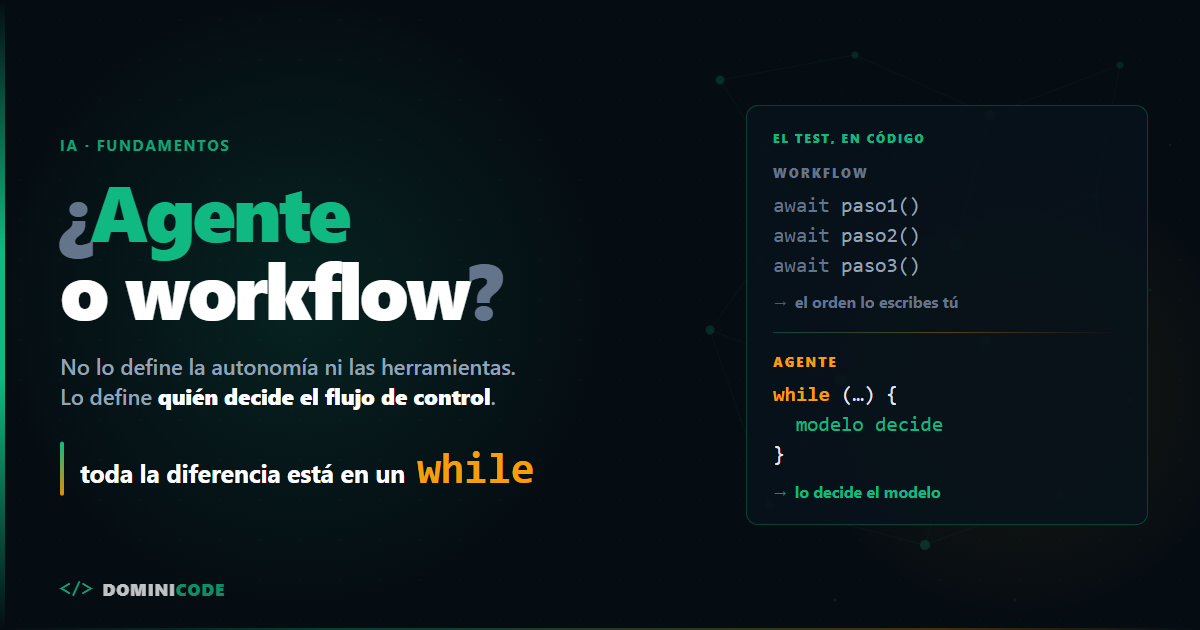
    • Un agente de IA es un sistema donde el modelo decide el flujo de control: qué acción viene después y cuántas. No lo define la autonomía ni el uso de herramientas.
    • El test: si el número de llamadas al modelo es fijo y puedes dibujar el camino antes de ejecutar, es un workflow con un LLM dentro. Y suele ser la opción correcta.
    • La anatomía real son cinco piezas: objetivo, política de decisión, herramientas, contexto y verificador con criterio de parada. La quinta es la que casi nadie monta.
    • Un límite de iteraciones no es un criterio de parada. Es un timeout.
    • Cruzar la línea es binario; lo que hay al otro lado, no. Hay grados de autonomía, y cada grado exige instrumentación distinta. Los incidentes suelen ser un grado 3 con instrumentación de grado 1.
    • No son agentes: un chatbot con herramientas, un pipeline determinista con un nodo de IA, un RAG clásico.

    Qué es un agente de IA: la definición que sí se puede verificar

    Un agente de IA es un sistema en el que el modelo decide el flujo de control: qué acción se ejecuta a continuación, con qué argumentos y cuándo parar. No lo define la autonomía ni el uso de herramientas, sino quién elige el siguiente paso.

    No es el que usa herramientas. No es el que parece inteligente. Es el que decide qué pasa después.

    La definición de marketing —"autónomo", "usa herramientas", "cumple objetivos"— es inútil precisamente porque no excluye nada: bajo ese paraguas cabe un cron con un prompt dentro.

    Anthropic lo formuló bien en Building effective agents (diciembre de 2024): los workflows son "sistemas donde los LLM y las herramientas se orquestan mediante caminos de código predefinidos"; los agentes, "sistemas donde los LLM dirigen dinámicamente sus propios procesos y su uso de herramientas, manteniendo el control sobre cómo realizan las tareas".

    Traducido a algo que puedas usar hoy: el diagrama de flujo de un workflow existe antes de ejecutarlo. El de un agente no existe hasta que termina.

    Si puedes dibujar en una pizarra todo lo que va a pasar, no has construido un agente. Has construido un programa que llama a un modelo. Que, insisto, suele ser mejor decisión.


    El test: ¿agente o workflow con un LLM dentro?

    Tres preguntas. Se contestan mirando tu código, no leyendo documentación.

    1. ¿El número de llamadas al modelo es fijo? Si siempre son tres, es un workflow.
    2. ¿La salida de una herramienta cambia cuál se llama después? Si el orden lo escribiste tú, es un workflow.
    3. ¿Hay un bucle del que el modelo puede decidir no salir? Si no hay bucle, no hay agente.

    Abre el archivo, busca la llamada al modelo y mira qué tiene alrededor. Esto es un workflow:

    // Workflow: el camino está escrito. Siempre estos tres pasos, en este orden.
    const intencion = await modelo.clasificar(email)
    const resumen = await modelo.resumir(email)
    const respuesta = await modelo.redactar(intencion, resumen)
    
    await enviar(respuesta)
    

    Y esto es un agente:

    // Agente: el modelo elige la siguiente acción con lo que acaba de observar.
    const mensajes: Mensaje[] = [{ role: 'user', content: objetivo }]
    let pasos = 0
    
    while (pasos++ < LIMITE) { // LIMITE es un timeout, no un criterio de parada
      const decision = await modelo.responder({ mensajes, tools })
    
      if (decision.tipo === 'final') break // ojo: aquí para el modelo, no un verificador
    
      const observacion = await ejecutar(decision.tool, decision.args)
      mensajes.push(decision, observacion) // lo observado entra en la siguiente decisión
    }
    

    Toda la diferencia está en una palabra: while. En el primero, un await va detrás de otro y el orden lo pusiste tú. En el segundo hay un bucle, y dentro del bucle el que elige es el modelo.

    Fíjate en los dos comentarios que he dejado en el segundo bloque, porque ese ejemplo todavía está incompleto a propósito: para cuando el modelo dice que ha terminado, y eso no es un criterio de parada. Volvemos a ello en la anatomía.

    Si en tu repositorio no aparece ese bucle —ni explícito, ni dentro de la librería que uses—, no tienes un agente. Y si el while solo reintenta la misma llamada cuando falla la red, tampoco: eso es un retry.

    Ese bucle tiene nombre propio, fases y modos de fallo documentados: lo desmonté pieza a pieza en Agentic loop: el mecanismo detrás de los agentes de IA.


    La anatomía real: cinco piezas, y casi nadie monta la quinta

    Un agente de IA se compone de cinco piezas: objetivo, política de decisión, herramientas, contexto y verificador con criterio de parada. Las cuatro primeras salen en cualquier tutorial. La quinta es la que separa una demo de un sistema.

    Pieza Qué es Qué pasa si falta
    Objetivo El resultado esperado, no la instrucción Optimiza para parecer útil, no para terminar
    Política de decisión El modelo eligiendo la siguiente acción No hay agente: hay script
    Herramientas La superficie de acción sobre el mundo real Razona precioso y no cambia nada
    Contexto Lo que sabe en cada iteración Repite trabajo hecho y se contradice
    Verificador y criterio de parada La señal que dice si el trabajo está bien Para cuando cree que ha acabado

    Estas cinco son las piezas del agente. El andamiaje que lo envuelve —registro de herramientas, guardrails, gestión de contexto— es otra capa distinta, y la desglosé en qué es un agent harness.

    Las herramientas son donde más gente se pasa de frenada: doce tools disponibles, descripciones ambiguas y un modelo eligiendo mal. No es fallo del modelo, es fallo de diseño, y lo desarrollé en cómo evitar que los agentes elijan mal sus herramientas.

    El contexto arruina ejecuciones largas en silencio. Qué recuerda entre iteraciones, qué recuerda entre sesiones y qué debe olvidar es arquitectura, no implementación: las cuatro capas del modelo CoALA están en implementación de memoria en agentes de IA.

    Y llegamos a la quinta, que es donde está el problema de verdad.

    Un límite de iteraciones no es un criterio de parada

    Casi todo el mundo cree que tiene verificador porque ha escrito esto:

    while (pasos < 10) { /* ... */ }
    

    Eso es un timeout. Dice cuándo dejar de gastar dinero. No dice nada sobre si el trabajo está bien hecho.

    El criterio de parada es un comando o una función que responde sí o no sin que intervenga tu criterio. Los tests en verde. El typecheck limpio. Un eval puntuado contra casos conocidos. Un schema que valida la salida.

    Y aquí se resuelve la tensión que quizá te haya chirriado antes: dije que el modelo decide cuándo parar, y ahora digo que el criterio tiene que ser externo. Las dos cosas. El modelo propone que ha terminado; el verificador confirma o lo devuelve al bucle. Un agente que se autoevalúa no tiene criterio de parada: tiene una opinión.

    La diferencia se nota el día que el agente sale del bucle en la iteración 4 y te devuelve algo roto. Salió porque el modelo dijo "listo", y el modelo dijo "listo" porque no había nada delante que le llevara la contraria.

    Un agente sin verificador no es autónomo. Es no supervisado, que es otra cosa. Montar esa señal es lo que separa una demo de un sistema, y está en evaluaciones automatizadas para agentes de IA.

    El verificador tiene un hermano que se olvida igual de rápido: el perímetro. Contenedor aislado, rama nueva, credenciales de solo lectura. Nunca ejecución de código generado sobre el servidor real. Cuanta más autonomía das, más estrecho tiene que ser el perímetro, no al revés.


    Los grados de autonomía: cuánto decide el modelo

    El test de arriba te dice si has cruzado la línea. No te dice cuánto la has cruzado, y eso es exactamente lo que decide qué tienes que montar debajo. Hay cinco grados, del 0 al 4, y cada uno exige una instrumentación distinta.

    La escala que viene es mía, no un estándar de la industria. La uso para decidir qué instrumentación exige cada salto antes de darlo. Si te sirve, róbala; si no, calibra la tuya y quédate con la última columna.

    Grado Lo decide tu código Lo decide el modelo Ejemplo típico Mínimo que exige
    Grado 0 El flujo y la ejecución completa El texto que devuelve Chat, autocompletado Nada. El bucle eres tú
    Grado 1 Qué acciones existen y cuándo se ejecutan Cuál encaja en este caso Tool calling de un salto, routing Validación de argumentos
    Grado 2 El catálogo y el permiso de cada acción El orden y cuántas hacen falta Agente con aprobación por acción Un humano revisando cada acción antes de ejecutarla, no el resumen final
    Grado 3 El perímetro y el criterio de parada El plan completo dentro del perímetro Un agente arreglando un test en CI Verificador automático, sandbox y trazas
    Grado 4 Solo el perímetro El plan y sus propias herramientas Self-improving loop Todo lo anterior más evals de regresión

    La línea del test está entre el grado 1 y el grado 2. Por debajo, el orden lo escribiste tú: workflow. Del grado 2 hacia arriba, el orden lo decide el modelo, y ahí empieza el agente. Ser agente es sí o no. Cuánta cuerda le das, no.

    Mira solo la última columna. Es la única que importa de verdad.

    Subir de grado no es cambiar de modelo ni instalar un framework con la palabra "agent" en el nombre. Es tener montado lo que ese grado exige antes de subir.

    El incidente típico no lo provoca un agente malo. Lo provoca un grado 3 corriendo con instrumentación de grado 1: sin trazas para reconstruir qué decidió, sin sandbox y sin señal automática de si aquello estaba bien. Qué capturar de cada ejecución para poder auditarla está en cómo monitorear agentes de IA en producción.

    El grado 4 es el techo actual y el más malinterpretado. Un agente que escribe sus propias herramientas al detectar una tarea que no sabe hacer no es magia: es un bucle que compila, testea en aislamiento y solo incorpora la habilidad si los tests pasan. Lo tienes entero en Self-Improving Loop.

    Una vez sabes que has cruzado la línea, la pregunta útil ya no es "¿esto es un agente?". Es "¿en qué grado corre y qué he puesto debajo?"


    Qué no es un agente, aunque lo llamen así

    Un chatbot con herramientas. Buscar en la web y devolverte el resultado sigue siendo un salto único. La prueba es si puede reintentar por su cuenta a partir de lo que acaba de observar. Si no puede, es un chat con herramientas conectadas.

    Un pipeline determinista con un nodo de IA. Un flujo de n8n, Zapier o Make con una caja que dice "AI" es un workflow: el camino está dibujado en el canvas y el modelo rellena huecos. Cuando un paso falla, el flujo se rompe; no reformula la estrategia.

    Un RAG clásico. Recuperar, inyectar en el prompt, responder. Camino fijo, una llamada. Se vuelve agéntico solo cuando el modelo decide si vuelve a buscar, con qué query y cuándo parar. Ese "decide" es toda la diferencia.

    Y una que se ha puesto de moda: más agentes no es más agente. Cinco LLM encadenados suelen ser un workflow caro con pérdida de contexto en cada salto. Cuándo compensa y cuándo es autolesión lo analicé en cuándo usar multi-agente sin orquestador.

    Ninguna de las cuatro es peor que un agente. Suelen ser mejores: más baratas, más rápidas y depurables. Cuando un workflow falla, sabes en qué paso.


    Cuándo NO deberías montar un agente

    Para que compense tienen que darse tres condiciones. Las tres. No dos de tres.

    Que exista una señal automática de si el trabajo está bien. Si el único verificador eres tú leyendo el resultado, no has delegado el bucle: lo has movido a tu bandeja de entrada.

    Que el camino no sea siempre el mismo. Esta es la que más se ignora. Si el flujo es idéntico en el 95% de las ejecuciones, estás pagando a un modelo por redescubrir cada vez un orden que ya conoces. Escríbelo en código. Anthropic, en el artículo que cité arriba, recomienda buscar siempre la solución más simple posible y añade que eso "puede significar no construir sistemas agénticos en absoluto".

    Y si tu duda de fondo es cuál de tus tareas merece un agente y cuál no, esa clasificación —tarea por tarea— está en cómo clasificar tareas de desarrollo para delegarlas a la IA y, con los números de coste al lado, en IA generativa vs IA agéntica.

    Que el error sea reversible dentro del perímetro. Migraciones sobre datos de producción, borrados, despliegues sin rollback, correos a clientes reales. Ahí no se sube a grado 3: ahí el modelo propone y tú apruebas, que es para lo que existe el grado 2.

    Falla una de las tres y la respuesta correcta es un workflow. No es una derrota: es ingeniería.


    La ruta: por dónde empezar y cómo subir de nivel

    Con esto claro, aprender agentes deja de ser una lista de herramientas y pasa a ser una progresión de grados.

    Etapa 1 — Usa un agente antes de construir uno (grados 0-1)

    Trabaja unas semanas con un harness ya hecho —Claude Code, Codex CLI, el que prefieras— sobre tu repositorio real. No para aprender la herramienta: para ver de primera mano dónde decide mal y qué información le faltaba cuando lo hizo. Eso es lo que después no sabrás diseñar si nunca lo has sufrido.

    Y haz dos cosas desde el primer día, porque cambian el resultado más que el modelo que elijas.

    Escribe el contrato: un CLAUDE.md en la raíz convierte al agente de invitado que improvisa en ejecutor con reglas explícitas, y cómo redactarlo está en CLAUDE.md: el contrato entre tú y el agente.

    Y especifica antes de dejarle editar, porque un agente al que le pides que programe a ciegas rellena con invención todo lo que no escribiste. La metodología está en Spec-Driven Development: evita el caos de la IA, y completa, con plantillas y flujo de trabajo, en el libro de Spec-Driven Development.

    Etapa 2 — Construye uno pequeño de verdad (grado 2)

    No un framework: un bucle. Un objetivo, dos herramientas, argumentos validados y un criterio de parada que no sea un contador. Doscientas líneas enseñan más que cualquier tutorial, porque ves dónde se rompe.

    Valida los argumentos con un schema desde la primera línea: la frontera entre el texto probabilístico del modelo y tus tipos tiene que ser explícita, y es lo que enseño en el curso de Zod. El stack mínimo completo —SDK, Zod y un bucle explícito— está en construye un agente de IA en TypeScript.

    Cuando quieras que esas herramientas dejen de estar acopladas a tu código y las consuma cualquier cliente compatible, entra MCP: el recorrido completo, servidor y agente incluidos, está en cómo construir un agente de IA y su MCP server paso a paso.

    Si prefieres hacer este salto acompañado y llegar de la idea a un producto funcionando, es el camino del curso Construye con IA.

    Etapa 3 — Sube al grado 3 con la instrumentación por delante

    Aquí se separa el proyecto de fin de semana del sistema que corre solo. Ya sabes qué exige el grado 3, así que la pregunta no es cuáles son las piezas: es en qué orden se montan. Va este, y el orden importa.

    Primero el sandbox. Es la única que te protege del peor día, y es la más barata de todas: un contenedor y una rama nueva. Montarla la última es como ponerse el cinturón al llegar.

    Después las trazas. Sin ellas no puedes depurar nada de lo que viene después, porque no sabrás qué decidió el agente ni con qué información.

    Luego el verificador. Ahora sí puedes construirlo, porque las trazas te enseñan en qué se equivoca de verdad y contra qué merece la pena verificar.

    Y por último los evals. Son el verificador aplicado a un conjunto de casos conocidos, así que llegan cuando ya tienes uno.

    La memoria persistente no está en esa lista a propósito: es una optimización de coste y de continuidad, no una condición de seguridad. Se monta cuando el agente ya corre bien, no antes. Ese error de orden —memoria elegante y cero trazas— lo he visto más veces de las que me gustaría, y es también el que describo en loop engineering.

    Y cuando quieras montar esto como disciplina profesional y no como proyecto suelto, el roadmap de carrera está en qué es un Agentic Engineer y cómo convertirte en uno.


    Lo único que tienes que hacer hoy

    Abre el repositorio de eso que llamas agente y busca la llamada al modelo.

    Si alrededor no hay un bucle donde la salida de una herramienta cambia la siguiente decisión, tienes un workflow. Deja de intentar convertirlo en agente y hazlo mejor workflow: será más barato y no te despertará de madrugada.

    Si sí lo hay, contesta la segunda pregunta: ¿qué señal automática le dice que ha terminado? Si la respuesta es un número de iteraciones, acabas de encontrar el trabajo de esta semana. Y es el que más te va a rentar.

    Si quieres el esqueleto ya montado para no empezar de cero —bucle, herramientas y criterio de parada—, lo he empaquetado gratis en el Hermes Agent Kit.

    Y si prefieres discutir arquitecturas concretas con gente que ya tiene agentes corriendo en producción, te espero en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es un agente de IA exactamente?

    Un agente de IA es un sistema en el que el modelo decide el flujo de control: qué acción se ejecuta a continuación, con qué argumentos y cuándo detenerse. No lo define la autonomía ni el uso de herramientas, sino quién elige el siguiente paso. Si el orden de las acciones está escrito en tu código, tienes un workflow con un LLM dentro. Si ese orden se decide en tiempo de ejecución a partir de lo que el sistema acaba de observar, tienes un agente.

    ¿Cuál es la diferencia entre un agente de IA y un workflow con un LLM?

    El diagrama de flujo. El de un workflow existe antes de ejecutarlo, porque los caminos están predefinidos en código; el de un agente no existe hasta que la ejecución termina. Se comprueba con dos señales: si el número de llamadas al modelo es fijo, es un workflow; si la salida de una herramienta puede cambiar cuál se llama después, es un agente. El workflow no es una versión inferior: es más barato, más rápido y más fácil de depurar.

    ¿Un chatbot con herramientas es un agente de IA?

    No mientras no cierre el bucle. Un chatbot que busca en la web y te devuelve el resultado ejecuta un salto único: no comprueba si lo que obtuvo resuelve el objetivo ni cambia de estrategia cuando no lo resuelve. La prueba está en el código, no en la interfaz: si no existe una iteración en la que la observación de una herramienta determine cuál se llama después, tienes un chat con herramientas conectadas.

    ¿ChatGPT o Claude son agentes de IA?

    Por sí solos no: son modelos servidos tras una interfaz de chat, y ahí el bucle lo cierras tú al leer la respuesta y escribir la siguiente instrucción. Se convierten en la política de decisión de un agente cuando los envuelves en un sistema que ejecuta sus llamadas a herramientas y le devuelve el resultado para que decida el siguiente paso: eso es lo que hacen Claude Code o Codex CLI. El agente no es el modelo; es el modelo más el bucle, las herramientas y el criterio de parada.

    ¿Qué ejemplos reales de agentes de IA hay hoy?

    Los más maduros en 2026 son los agentes de programación que corren sobre un repositorio: Claude Code, Codex CLI de OpenAI, Cursor en modo agente y Gemini CLI. Todos comparten la misma estructura: un bucle que lee ficheros, ejecuta comandos, observa la salida y decide la siguiente acción, con los tests como criterio de parada. Fuera del código, los casos que funcionan son los que tienen verificación automática: triaje de incidencias, migraciones de datos validadas contra un schema y control de calidad de contenido.

    ¿Necesito LangChain o un framework de agentes para construir el mío?

    No. El núcleo de un agente son unas doscientas líneas: un bucle, un catálogo de herramientas con argumentos validados, el historial de observaciones y un criterio de parada. Escribirlo a mano una vez enseña más que LangChain, Mastra o el Vercel AI SDK juntos, porque ves exactamente dónde se rompe. El framework empieza a compensar después: cuando necesitas persistencia entre ejecuciones, orquestación de varios procesos o trazabilidad estándar.

    ¿Por qué un límite de iteraciones no sirve como criterio de parada?

    Porque es un timeout: evita que el agente gaste tokens sin fin, pero no dice nada sobre la calidad del resultado. El criterio de parada es una señal externa al modelo que responde sí o no sobre si el objetivo está cumplido: tests en verde, typecheck limpio, un schema que valida la salida o un eval puntuado. Sin esa señal, el agente termina cuando cree que ha terminado, y esa creencia no se puede auditar.

    ¿Cuándo no conviene usar un agente de IA?

    Cuando falla alguna de estas tres condiciones. Que exista una señal automática capaz de decir si el trabajo está bien hecho sin que lo revises tú. Que el camino no sea siempre el mismo, porque si el flujo es idéntico en casi todas las ejecuciones estás pagando por redescubrir un orden que ya conoces. Y que el error sea reversible: sobre datos de producción, borrados o despliegues sin rollback, el modelo propone y tú apruebas.

    ¿Es lo mismo un agente de IA que un sistema multi-agente?

    No, y encadenar varios modelos no hace el sistema "más agéntico". Un sistema multi-agente reparte el trabajo entre varias instancias con roles distintos, y cada salto pierde contexto, suma latencia y multiplica el coste. Muchas veces lo que se ha modelado como un segundo agente debería haber sido una herramienta del primero. Empieza con un solo agente y varias herramientas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Clasificar tareas con IA: guía de supervivencia para developers

    Clasificar tareas con IA: guía de supervivencia para developers


    status: borrador
    title: "Clasificar tareas con IA: guía de supervivencia para developers"
    slug: clasificar-tareas-con-ia-desarrollo-software
    excerpt: "Aprende a clasificar tareas con IA en desarrollo de software. Descubre cómo dividir tareas seriales y paralelas para programar de forma profesional sin bugs."
    keywords:

    • clasificar tareas con IA
    • tareas seriales vs paralelas software
    • desarrollo guiado por IA
    • agentes de inteligencia artificial

    El martes pasado perdí cuatro horas intentando que Claude Code (v0.2.0, corriendo con el modelo Claude 3.5 Sonnet) reescribiera un módulo de pagos entero de un solo golpe. El resultado fue un bucle infinito de errores de tipado en TypeScript que me enseñó la importancia de clasificar tareas con IA antes de ponerme a tirar código.

    Si tratas a un LLM como a un junior todoterreno sin entender qué puede resolver en paralelo y qué requiere tu intervención directa, vas a perder más tiempo depurando que programando. Para construir software real con inteligencia artificial, necesitas dividir tu backlog bajo un criterio muy simple: estructura mental vs. ejecución de código.

    Aprender a clasificar tareas con IA es lo que separa a los programadores que sufren de "vibe coding hangover" de los que construyen aplicaciones mantenibles y escalables en producción.


    ¿Por qué debes clasificar tareas con IA?

    Cuando automatizas flujos con agentes, la mayoría de los desarrolladores cometen el error de meter todo en una gran cadena secuencial. No entienden cómo fluyen los datos y la memoria dentro de un modelo de lenguaje.

    Los LLMs tienen una ventana de contexto limitada y, a medida que la conversación se alarga, sufren de pérdida de atención. Si el modelo comete un pequeño error en el paso 1 y continúas la secuencia sin corregirlo, ese error se propaga y amplifica en los pasos 2, 3 y 4.

    Por eso, separar las tareas no es una cuestión de organización escolar: es una necesidad de arquitectura técnica para evitar que el contexto del modelo se contamine.


    Tareas seriales vs. paralelas: El cuello de botella del contexto

    Para delegar a la IA de forma óptima, debes entender la diferencia entre dos tipos de flujos de trabajo:

    A. Tareas Seriales (Secuenciales)

    Son aquellas donde cada paso depende estrictamente del resultado del paso anterior. No puedes avanzar si el paso previo no está validado.

    • Ejemplo: Diseñar un backend con NestJS. No puedes escribir los controladores ni los queries del ORM hasta que la estructura de tablas SQL esté completamente definida y validada.
    • Workflow: Exigen pasos secuenciales cortos con validaciones humanas intermedias. Necesitas un modelo integrado en tu IDE (como Cursor o Claude Code) operando con supervisión activa. Tú guías el flujo, pruebas cada paso en local y decides el siguiente movimiento.

    B. Tareas Paralelas (Independientes)

    Son tareas independientes que no comparten estado entre sí y se pueden ejecutar en entornos aislados de forma simultánea.

    • Ejemplo: Traducir archivos i18n de traducción, documentar funciones utilitarias independientes o escribir tests unitarios de Jest para componentes que no tienen acoplamiento entre sí.
    • Workflow: Este es el territorio ideal de los agentes autónomos que corren en segundo plano. Puedes lanzar múltiples llamadas paralelas a la API y resolver el backlog en segundos mientras tú te enfocas en diseñar la lógica del negocio.

    A continuación, puedes ver una comparativa clara de cómo enfocar cada tipo de tarea:

    Característica Tareas Seriales (Secuenciales) Tareas Paralelas (Independientes)
    Dependencia Alta (Paso B necesita el output de A) Nula o muy baja (Módulos aislados)
    Workflow de IA Interactivo (Human-in-the-loop) Agentes autónomos en background
    Ejemplo práctico Depuración de bugs complejos, diseño de APIs Escribir tests unitarios, documentación
    Riesgo de desvío Alto (los errores de contexto se acumulan) Bajo (tareas acotadas y repetitivas)
    Intervención humana Constante (validación paso a paso) Al inicio (spec) y al final (code review)

    Cómo clasificar tareas con IA: lo que delegas y lo que no

    La IA es un ejecutor brutal de especificaciones cerradas. Si le das reglas claras y un entorno acotado, escribirá código mejor y más rápido que tú. Esto es lo que llamamos el "desarrollo guiado por IA".

    Para flujos secuenciales complejos, la clave está en fragmentar el código. No le pidas al modelo "escribe el endpoint de cobro con Stripe entero". En su lugar, fragméntalo en una secuencia controlada:

    // Paso 1: Pídele que defina la interfaz de datos estrictamente
    interface PaymentPayload {
      amount: number;
      currency: 'USD' | 'EUR';
      token: string;
    }
    
    // Paso 2: Una vez validada la interfaz, pídele implementar el validador
    function validatePayment(payload: PaymentPayload): boolean {
      return payload.amount > 0 && payload.token.length > 0;
    }
    

    Qué delegar a la IA (Ejecución y Boilerplate)

    • Scaffolding: Configuración de herramientas, setup de linters, inicialización de módulos.
    • Refactoring menor: Traducir funciones, migrar código JavaScript legacy a TypeScript clásico.
    • Tests y Documentación: Tareas repetitivas que consumen tiempo y tienen baja ambigüedad.

    Qué NUNCA debes delegar al modelo (Criterio y Dirección)

    • Decisiones de arquitectura: Decidir si tu base de datos debe ser relacional, si necesitas microservicios, o qué abstracción introducir hoy para no bloquear el desarrollo en 6 meses. La IA optimiza a nivel local, pero no ve a largo plazo.
    • Comprensión del negocio: Qué le importa realmente al usuario y qué tradeoffs valen la pena asumir.

    Para evitar que tu proyecto se desvíe, yo utilizo una metodología de diseño de especificaciones antes de tocar código. En el Libro SDD (Leanpub) explico cómo escribir especificaciones claras que los modelos de lenguaje entienden a la perfección y ejecutan a la primera.


    El loop humano: Tú eres el compilador final

    La automatización no significa que el programador desaparezca. Al contrario, la evolución natural del programador tradicional, como vimos en nuestro post sobre loop engineering y la evolución de la IA, exige que pases de escribir código a orquestar sistemas que escriben código.

    Tu rol ya no es picar código sin parar. Tu trabajo es diseñar la especificación, configurar los límites de los agentes (como las directivas en la documentación de Claude Code de Anthropic), y actuar como el control de calidad senior que decide qué entra a producción y qué se descarta.

    Esto es parte de lo que explico en mi artículo sobre el stack de IA agentica en 2026, donde analizamos cómo los ingenieros senior multiplican su productividad manejando subagentes independientes para tareas aisladas.

    Si quieres dominar este flujo y aprender a estructurar proyectos reales que funcionen con agentes y Claude Code, te recomiendo revisar el Curso "Construye con IA" en Udemy. Es el paso a paso exacto que yo sigo para lanzar productos sin perder la cabeza con bugs infinitos.

    Empieza hoy por lo básico: abre tu backlog y etiqueta cada tarea pendiente. Sabrás exactamente cuándo colaborar en vivo, cuándo lanzar un agente en background y cuándo apagar la pantalla y pensar tú solo.

    También puedes unirte a Dominicode Labs para acceder a herramientas, experimentos y una comunidad de desarrolladores seniors que están construyendo el futuro del software con inteligencia artificial aplicada de verdad.


    Preguntas frecuentes

    ¿Cómo clasificar tareas con IA en seriales o paralelas?

    Pregúntate si el output de un paso es obligatorio para que el siguiente empiece a procesarse. Si la respuesta es sí (como definir el esquema SQL antes de escribir el ORM), la tarea es serial y secuencial. Si las tareas pueden ejecutarse en entornos independientes sin afectarse mutuamente (como escribir tests de archivos diferentes), son paralelas.

    ¿Por qué los modelos de IA fallan en las tareas seriales largas?

    A medida que el prompt y la conversación se alargan, el modelo sufre de pérdida de atención (needle in a haystack) y alucinaciones. Si el paso 1 tiene un pequeño error de interpretación, ese error se arrastra y amplifica en los pasos siguientes, destruyendo el resultado final. La clave es fragmentar el proceso en prompts individuales.

    ¿Se puede automatizar al 100% el desarrollo de software con agentes de IA?

    No en aplicaciones de producción complejas. Los agentes actuales destacan implementando código bajo especificaciones acotadas. Sin embargo, la toma de decisiones de negocio, el diseño de la arquitectura general y la integración de APIs de terceros siguen requiriendo la supervisión y validación de un programador humano experimentado.

    ¿Qué herramientas son mejores para ejecutar tareas paralelas con LLMs?

    Para flujos paralelos de volumen (como traducción o análisis de código masivo), las APIs de Claude o OpenAI conectadas a scripts locales son la opción más rápida y económica. Para desarrollo interactivo en local y tareas seriales complejas que requieren explorar el workspace, herramientas como Claude Code o entornos basados en agentes autónomos son ideales.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Hermes Agent + oMLX: Inferencia local en Apple Silicon

    Hermes Agent + oMLX: Inferencia local en Apple Silicon

    Cuando buscas privacidad absoluta al construir tus herramientas y automatizaciones agénticas, la respuesta siempre es correr todo en tu propia máquina. Sin embargo, en macOS, levantar un agente de IA y conectarlo a un modelo local suele traducirse en dos problemas: o el modelo responde de forma desesperantemente lenta, o devora toda la memoria unificada y tu Mac se congele. Como vimos en nuestra guía de hardware y modelos para LLMs locales, correr modelos de gran escala exige un balance fino de memoria.

    La solución requiere un matrimonio arquitectónico perfecto.

    Hoy te quiero enseñar cómo configurar Hermes Agent con oMLX, combinando el mejor plano de control agéntico con el servidor de inferencia nativo más rápido y eficiente para los procesadores Apple Silicon.


    El Plano de Control se une al Plano de Inferencia

    Como analizamos en nuestra guía de las 4 capas de la IA local, un agente autónomo no debe cargar los pesos del modelo por su cuenta. Necesita un servidor especializado que le sirva las respuestas.

    Para un desarrollador en macOS, la combinación de Hermes Agent y oMLX es el estándar de oro actual:

    • Hermes Agent como Plano de Control: Aporta el bucle de auto-aprendizaje, la persistencia de conversaciones en SQLite, la ejecución de herramientas seguras en contenedores y las integraciones multicanal (Telegram, Notion, Slack).
    • oMLX como Plano de Inferencia: Aporta velocidad bruta de generación Metal-accelerated, continuous batching (para procesar llamadas concurrentes de múltiples sub-agentes) y un sistema de caché de contexto optimizado.

    Al estar desacoplados, tu agente interactúa con oMLX de forma transparente utilizando la API estándar compatible con OpenAI.


    Paso 1: Levantar el Servidor oMLX en macOS

    oMLX requiere Apple Silicon (M1 o posterior) y macOS 15+. Puedes instalar la cómoda aplicación de barra de menú notarizada o levantar el servidor de consola desde el repositorio oficial de oMLX clonado.

    Para inicializar oMLX en producción local con soporte de caché SSD y concurrencia optimizada, ejecuta el siguiente comando en tu terminal:

    omlx serve \
      --model-dir ~/models \
      --paged-ssd-cache-dir ~/.omlx/cache \
      --hot-cache-max-size 20% \
      --max-concurrent-requests 8 \
      --api-key local-dev-key
    

    Este servidor arrancará de forma local en http://127.0.0.1:8000/v1 y expondrá tu modelo (por ejemplo, Mistral-7B-Instruct-MLX-4bit) listo para ser consumido.


    Paso 2: Configurar Hermes Agent para apuntar a oMLX

    Para conectar Hermes a tu servidor oMLX, puedes usar el asistente interactivo ejecutando hermes model en tu consola y seleccionando la opción Custom endpoint.

    O si lo prefieres, puedes editar directamente tu archivo de configuración en ~/.hermes/config.yaml:

    model:
      default: Mistral-7B-Instruct-MLX-4bit
      provider: custom
      base_url: http://127.0.0.1:8000/v1
      context_length: 128000
    
    custom_providers:
      - name: local-omlx
        base_url: http://127.0.0.1:8000/v1
        models:
          Mistral-7B-Instruct-MLX-4bit:
            context_length: 128000
    
    terminal:
      backend: local
      timeout: 180
    

    Configuración de seguridad ante pre-procesamientos largos:

    Cuando utilizas contextos masivos de código en local, el servidor de inferencia puede tomarse algunos minutos para procesar todo el prompt inicial (fase de prefill).

    Para evitar que Hermes corte la conexión por timeout mientras oMLX está procesando el contexto largo, asegúrate de configurar estas variables en tu archivo ~/.hermes/.env:

    HERMES_STREAM_READ_TIMEOUT=1800
    HERMES_API_TIMEOUT=1800
    

    Este nivel de sintonía fina técnica es el que te permite correr flujos de trabajo profesionales sin caídas de red, y es el estándar de infraestructura que enseñamos en profundidad tanto en el curso de Construye con IA como en el nuevo curso de Hermes Agent.


    Conclusión: Privacidad real a la velocidad del silicio

    Al orquestar tus tareas autónomas con Hermes Agent y procesar toda la inferencia local con oMLX bajo la GPU de tu Mac, consigues una soberanía de datos absoluta. Tus contraseñas, código propietario y conversaciones nunca viajan a servidores de terceros, y disfrutas de la máxima aceleración de hardware que Apple Silicon puede ofrecer.

    Si quieres compartir tus configuraciones de hardware locales y ver cómo conectamos estos agentes locales a integraciones web de producción, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Por qué la combinación Hermes + oMLX es más rápida que usar Ollama en Mac?

    Ollama utiliza llama.cpp como motor por debajo, el cual es excelente en optimizar el tiempo hasta el primer token (TTFT) para chats cortos. Sin embargo, oMLX utiliza el framework nativo de Apple (MLX) que aprovecha la arquitectura de memoria unificada al máximo, ofreciendo una velocidad de generación sostenida mucho mayor en contextos largos y procesamiento de código.

    ¿Qué hace el parámetro –hot-cache-max-size 20% en oMLX?

    Indica al servidor qué porcentaje de la memoria RAM unificada de tu Mac puede reservarse para mantener en caliente los tokens de contexto de conversaciones recientes. El resto de contextos inactivos se moverán automáticamente al disco de estado sólido (SSD) para liberar espacio físico de GPU.

    ¿Puedo utilizar llamadas a herramientas (Tool Calling) en local?

    Sí. oMLX implementa parsers de herramientas nativos para las familias de modelos más populares (Qwen, Llama y Mistral). La condición clave es que el chat template del modelo descargado de Hugging Face sea compatible con el paso de la variable tools.

    ¿Cómo sé si mi Mac es compatible con esta configuración?

    Requiere un ordenador Mac con procesador Apple Silicon (M1, M2, M3, M4 o sus variantes Pro/Max/Ultra) y sistema operativo macOS 15 o posterior. Se recomienda contar con un mínimo de 16GB de memoria unificada, siendo el sweet spot para modelos grandes contar con 32GB o 64GB de RAM.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Spec-Driven Development (SDD): Evita el caos de la IA

    Spec-Driven Development (SDD): Evita el caos de la IA

    Hace unos meses un cliente me llamó desesperado. Habían decidido usar Cursor y Claude Code para acelerar el desarrollo de su nueva aplicación. El primer día escribieron 5.000 líneas de código y estaban maravillados con la velocidad.

    El segundo día, nada compilaba.

    El tercer día, la IA empezó a sobreescribir funciones previas, a alucinar APIs inexistentes y a meter bugs en bucle. Habían creado un monstruo de código spaghetti en tiempo récord.

    El problema no era la IA. El problema era que nadie le había dicho exactamente qué construir.

    Hoy te quiero explicar qué es Spec-Driven Development (SDD), la metodología de diseño que utilizo a diario para dar directrices claras a las IAs y evitar el caos en el código.


    El peligro de programar por "vibe coding"

    Cuando te sientas ante un editor como Cursor y le tiras prompts rápidos tipo "añade autenticación" o "agrega este formulario", estás haciendo vibe coding. La IA asume la arquitectura por su cuenta, inventa nombres de variables y adivina el modelo de datos.

    Esto funciona para landing pages sencillas, pero en proyectos reales produce tres efectos desastrosos:

    1. Código redundante: La IA vuelve a escribir funciones que ya existían porque no sabe dónde encontrarlas.
    2. APIs rotas: Se inventa endpoints que no coinciden con tu backend.
    3. Pérdida de control: El desarrollador deja de entender cómo funciona el sistema, convirtiéndose en un espectador pasivo.

    La solución no es dar mejores prompts conversacionales. La solución es dar especificaciones estructuradas.


    La regla de oro de SDD: Diseña antes de codificar

    La metodología Spec-Driven Development (SDD) establece que nunca debes dejar que un agente de IA escriba código hasta que haya aprobado un documento de diseño claro.

    Antes de tocar el teclado, debes estructurar tres archivos en la carpeta de especificaciones de tu proyecto:

    1. spec.md (La Especificación)

    Define la visión del producto, las reglas de negocio, los casos de uso y la arquitectura de datos. Responde al QUÉ se va a construir.

    2. plan.md (El Plan Técnico)

    Detalla la estrategia técnica paso a paso. Divide el desarrollo en fases incrementales y lógicas (por ejemplo, definir primero el esquema de base de datos antes de hacer la UI). Responde al CÓMO se va a construir.

    3. tasks.md (La Lista de Tareas)

    Una lista TODO detallada con tareas unitarias y autocontenidas. Cada tarea debe ser tan pequeña que la IA pueda completarla en una sola iteración y validarla con un test.


    El Flujo de Trabajo con tu Copiloto

    Una vez que tienes estos archivos, tu rol cambia de programador interactivo a director técnico:

    1. Le entregas el spec.md y el plan.md al agente de IA (ej: Claude Code).
    2. Le pides que lea las especificaciones y empiece a resolver la primera tarea del tasks.md.
    3. El agente implementa la tarea, corre los tests correspondientes y te avisa cuando está lista.
    4. Marcas la tarea como completada y pasas a la siguiente.

    Con este flujo, la IA no tiene que adivinar nada. Trabaja con un contrato de éxito claro y documentado.

    Este enfoque de ingeniería de software es el que trato en profundidad en mi libro de SDD: Spec-Driven Development, indispensable para cualquier desarrollador que quiera escalar sus desarrollos con IA en bucles agénticos u organizados. Además, es la metodología de base que aplicamos en todas las lecciones del curso de Construye con IA.


    Conclusión: La IA es el ejecutor, tú eres el arquitecto

    Delegar la escritura de código es seguro, pero delegar la arquitectura es un suicidio técnico. Al adoptar Spec-Driven Development, mantienes el control absoluto del diseño de tu software, reduces las alucinaciones de la IA a cero y multiplicas tu velocidad de desarrollo real.

    Si quieres aprender a estructurar tus specs y debatir sobre metodologías de ingeniería agéntica con otros desarrolladores senior, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué diferencia hay entre SDD y TDD?

    TDD (Test-Driven Development) se enfoca en escribir los tests unitarios antes que el código para guiar la implementación. SDD (Spec-Driven Development) va un paso más allá y exige redactar la especificación funcional y el plan técnico arquitectónico antes de escribir los tests o el código. Ambas metodologías se complementan perfectamente.

    ¿Por qué las especificaciones reducen las alucinaciones de la IA?

    Los LLMs tienden a alucinar cuando no tienen suficiente contexto o cuando las instrucciones son ambiguas. Un documento spec.md acota el espacio de decisiones que la IA debe tomar, forzándola a ceñirse a las reglas de negocio y arquitecturas declaradas en el archivo.

    ¿Cuánto tiempo toma escribir las especificaciones?

    Escribir un spec.md básico para una nueva feature suele tomar entre 15 y 30 minutos. Aunque parece un paso extra, te ahorra horas de depuración de código spaghetti mal estructurado por la IA en fases posteriores.

    ¿Se puede aplicar SDD a proyectos legacy o ya existentes?

    Sí. Al trabajar con código legacy, el primer paso es documentar el estado actual del componente afectado en un archivo de contexto (context.md) y redactar el spec.md detallando únicamente los cambios y adiciones a realizar, guiando a la IA sobre la base ya existente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • oMLX: El servidor de inferencia definitivo para Apple Silicon

    oMLX: El servidor de inferencia definitivo para Apple Silicon

    Comprar un Mac con memoria unificada de Apple Silicon para correr modelos locales es una de las mejores inversiones que puede hacer un desarrollador hoy en día. Sin embargo, resulta frustrante ver cómo gran parte de esa memoria se satura de inmediato al cargar contextos masivos de código en tu IDE o al ejecutar agentes autónomos de forma continuada.

    El problema no es de tu Mac. Es de la capa de servicio de inferencia.

    Llama.cpp y Ollama son herramientas excelentes y versátiles, pero no están diseñadas para exprimir al 100% las capacidades específicas del silicio de Apple a nivel de gestión de memoria profunda.

    Hoy te quiero explicar cómo configurar oMLX en Mac, un servidor de inferencia de código abierto diseñado exclusivamente para Apple Silicon que promete cambiar las reglas del juego de la IA local mediante técnicas avanzadas de cache de contexto y rendimiento óptimo.


    ¿Qué es oMLX y por qué importa en Mac?

    oMLX (disponible en su web oficial omlx.ai) es una capa de servicio de inferencia de alto rendimiento construida directamente sobre MLX, el framework de aprendizaje automático de código abierto desarrollado por Apple para aceleración de Metal.

    A diferencia de usar scripts de Python directos de MLX o de usar loaders tradicionales, oMLX funciona como un servicio robusto en segundo plano (con una cómoda interfaz en la barra de menús de macOS) que expone APIs totalmente compatibles con OpenAI y Anthropic.

    Pero su verdadero valor diferencial radica en cómo soluciona el cuello de botella de la memoria mediante el Tiered KV Caching (Caché de Claves-Valores en Dos Niveles).


    La magia del Tiered KV Caching

    Cuando utilizas un agente de IA (como tu IDE con autocompletado o un bot autónomo), el modelo pasa la mayor parte del tiempo procesando el mismo contexto repetidamente (los archivos de tu proyecto, el historial de la conversación, etc.). Esto llena la memoria VRAM de claves y valores (KV Cache).

    Si tu contexto es de 32k tokens, una gran parte de tu valiosa memoria unificada se consume únicamente en recordar la conversación, dejándote sin espacio para correr modelos más grandes de 14B o 32B parámetros.

    Como vimos en nuestra guía de hardware y modelos para LLMs locales en 2026, la velocidad y capacidad están limitadas por la VRAM. oMLX soluciona esto de forma brillante:

    • Caché Caliente (RAM): Mantiene los tokens de contexto más recientes y activos en la memoria ultrarrápida del sistema.
    • Caché Frío (SSD): Mueve los prefijos y contextos más antiguos o inactivos a tu disco de estado sólido (SSD) local.

    Cuando vuelves a interactuar con el agente en el mismo contexto, oMLX restaura la caché del SSD al instante sin necesidad de que la GPU tenga que re-computar todo el prompt desde cero. Esto reduce la latencia de respuesta (Time to First Token) a prácticamente cero y libera Gigabytes de memoria unificada.


    Características clave para Desarrolladores

    Si estás construyendo tus propios agentes o quieres optimizar tus herramientas locales, oMLX aporta ventajas que Ollama o Llama.cpp aún no implementan de forma tan integrada para Apple Silicon:

    1. Continuous Batching (Procesamiento continuo por lotes): Permite procesar múltiples peticiones entrantes de forma paralela en la GPU sin bloquear los hilos. Es ideal si tienes varios sub-agentes trabajando en segundo plano.
    2. API Dual Compatible: Expone endpoints idénticos a los de OpenAI y Anthropic. Puedes cambiar tu proveedor del SDK de Claude o GPT apuntándolo a tu servidor local de oMLX y todo seguirá funcionando sin tocar una línea de código.
    3. Gestión Visual: La aplicación nativa de macOS te permite monitorizar el uso de memoria Metal en tiempo real, descargar modelos directamente desde Hugging Face y gestionar logs sin tocar la terminal.

    Cómo conectar tus Agentes a oMLX

    Para empezar a utilizarlo en tus pipelines de desarrollo, solo debes seguir estos pasos:

    1. Instala el servidor descargando la app de oMLX en GitHub o vía Homebrew.
    2. Descarga tu modelo de código preferido (ejemplo: Qwen/Qwen2.5-Coder-7B-Instruct-MLX).
    3. El servidor web local se iniciará automáticamente expuesto en el puerto http://localhost:8000.

    A partir de ahí, puedes integrarlo en cualquier framework agéntico o en tu propio entorno local de desarrollo. Esta es exactamente la filosofía que discutimos y ponemos en práctica en el curso de Construye con IA para maximizar la velocidad de ejecución y minimizar costes.


    Conclusión: Diseña para el Hardware Local

    Correr IA local no es solo cuestión de descargar modelos, sino de entender cómo interactúan con el silicio de tu máquina. Al aprovechar herramientas optimizadas como oMLX, transformas tu Mac en un nodo de procesamiento de alta velocidad capaz de gestionar agentes autónomos multitarea sin pestañear.

    Si estás experimentando con oMLX y quieres optimizar la configuración de tus modelos locales de desarrollo en macOS, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Cuál es la diferencia entre MLX y oMLX?

    MLX es el framework de operaciones matemáticas y deep learning desarrollado por Apple (equivalente a PyTorch o TensorFlow). oMLX es un servidor de inferencia de producción y una interfaz de usuario construida encima de MLX para que puedas servir modelos y comsumirlos a través de APIs web sin necesidad de escribir scripts de consola.

    ¿Qué modelos son compatibles con oMLX?

    oMLX es compatible con cualquier modelo disponible en formato MLX (que suelen publicarse en Hugging Face bajo cuentas como mlx-community). Esto incluye familias populares como Llama 3, Qwen 2.5 Coder, Mistral y Phi-3.

    ¿Cómo ayuda el Tiered KV Caching a los agentes de IA?

    Los agentes de IA envían constantemente todo el contexto de sus herramientas y el historial en cada petición. oMLX guarda este contexto inactivo en el SSD de tu Mac y solo carga en la RAM el contexto activo actual. Al no tener que volver a procesar miles de palabras previas en la GPU, la respuesta del agente es inmediata y consume mucha menos memoria.

    ¿Se puede usar oMLX en Windows o Linux?

    No. oMLX está construido específicamente sobre el framework MLX de Apple, el cual utiliza la API de Metal y la arquitectura de memoria unificada exclusiva de los procesadores Apple Silicon (M1, M2, M3, M4, etc.). Para Windows o Linux con GPUs Nvidia o AMD, debes seguir utilizando herramientas como Ollama o vLLM.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.