Category: Agentic Harness

  • Verificar código generado por IA sin leer todo: 4 técnicas

    Verificar código generado por IA sin leer todo: 4 técnicas

    Hace unas semanas aprobé un pull request generado por un agente que arreglaba el cálculo de un descuento por antigüedad. Para verificar código generado por IA hice lo que hacemos casi todos: los tests pasaban en verde, el type checker no se quejó, el diff tenía 40 líneas legibles con nombres razonables.

    Le di merge.

    Dos días después, un usuario premium con 14 meses de antigüedad reportó un descuento del 10% en vez del 20%. El código funcionaba. Hacía exactamente lo que decía que hacía — solo que eso no era lo que yo había pedido. La condición antiguedad > 12 estaba invertida en un if, y ni el compilador ni los tests que el propio agente había escrito lo detectaron.

    (Esta anécdota es ilustrativa del tipo de fallo que describo aquí — no es un incidente puntual verificable con fecha exacta, es el patrón que se repite.)

    Esto no es una historia sobre un mal agente. Es sobre un mal proceso: mi "verificación" fue leer por encima y confiar en dos gates que no estaban hechos para atrapar ese error. Leer por encima no escala cuando el agente te entrega cinco PRs al día.

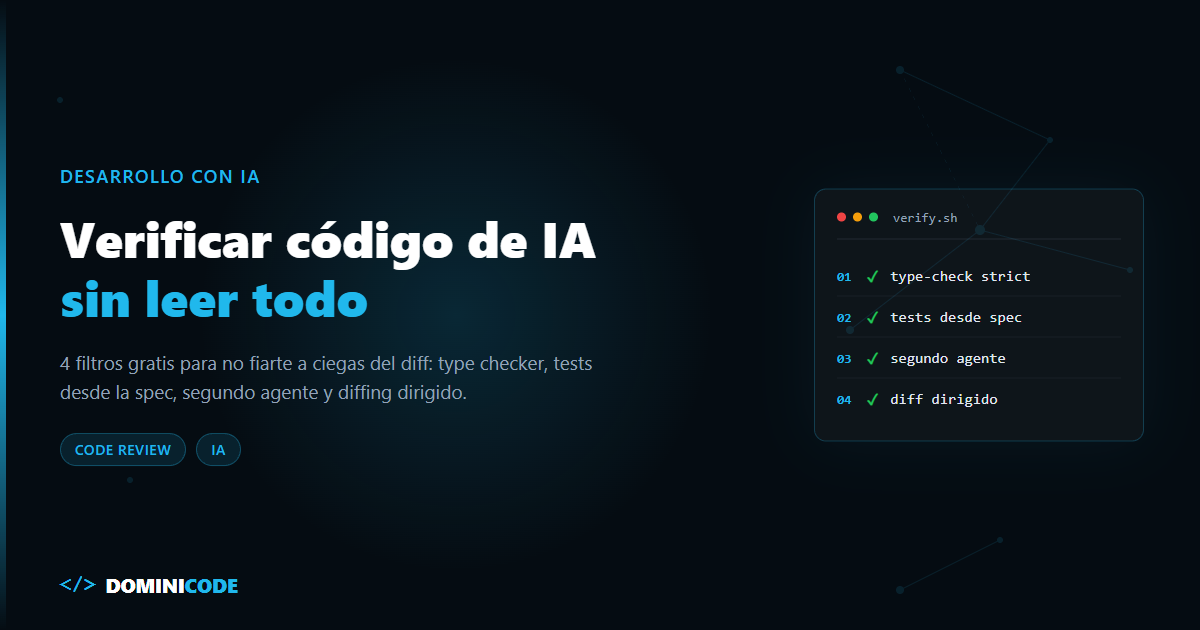
    En corto: verificar código generado por IA sin leer cada línea es posible con cuatro filtros baratos: deja que el type checker haga de primer gate, pide los tests desde la especificación antes de enseñarle el código al agente, usa un segundo agente con un prompt distinto como revisor, y concentra tu lectura manual en las líneas que tocan auth, dinero o validación de input. Ninguno sustituye un sistema completo — son parches rápidos que aplicas hoy, sin instalar nada.

    ¿Qué es un gate de verificación (y por qué no es lo mismo que "revisar")?

    Un gate de verificación es un chequeo binario que pasa o falla sin que tengas que interpretarlo — no depende de tu criterio ni de tu concentración a las 11 de la noche. "Revisar" es leer código y juzgar si parece correcto. Un gate ejecuta algo que responde sí o no, con evidencia. "Leí el diff y se veía bien" no es un gate, es una opinión — y las opiniones fallan justo cuando el código está bien escrito y hace lo contrario de lo que pide la spec.

    Eso importa porque el código de un agente está optimizado para parecer correcto: nombres claros, formato limpio, estructura familiar. Tu ojo entrenado para detectar "código feo" falla exactamente cuando el código es bonito y está mal.

    El problema real: el código pasa la vista y falla en producción

    No soy el único con esta fricción. En un hilo de Hacker News con 298 comentarios titulado "When AI writes the software, who verifies it?", el usuario roadbuster lo describe así (traducido del inglés):

    "El LLM genera felizmente tests que simplemente refuerzan el comportamiento existente del código. En ningún momento nadie se detiene a preguntar si el código generado implementa el comportamiento funcional deseado."

    Es lo que me pasó con el descuento: el agente escribió el código y luego tests que confirmaban que ese código hacía lo que hacía — no lo que yo había pedido. El test nunca falla porque nació del mismo malentendido que la implementación.

    En el mismo hilo, Karrot_Kream admite el punto incómodo: sigue auditando a mano los tests que genera la IA, aunque reconoce que es "la parte de programar que menos le gusta". Nadie quiere hacer esta parte. Por eso casi nadie la hace bien.

    4 técnicas que puedes aplicar hoy, sin instalar nada nuevo

    Ninguna requiere adoptar un framework, escribir un AGENTS.md o cambiar tu flujo. Son filtros que añades a lo que ya haces.

    Técnica Qué detecta Qué NO detecta Esfuerzo
    Type checker en modo estricto Tipos incompatibles, propiedades inexistentes, APIs alucinadas, nulls sin manejar Lógica de negocio incorrecta que tipa perfectamente bien Ninguno extra — actívalo en strict
    Tests desde la spec, antes de ver el código Que el comportamiento coincida con lo pedido, no con lo que el agente decidió escribir Casos que la spec no contempló; spec vaga produce tests vagos Bajo — un prompt aparte, antes de la implementación
    Segunda pasada con otro agente/prompt como revisor Inconsistencias entre spec y código, casos límite obvios, errores sin manejar Puede repetir el sesgo del primero si comparte el mismo chat Medio — exige prompt adversarial, en sesión nueva
    Diffing dirigido a zonas críticas (auth, dinero, validación) Regresiones graves justo donde más caro sale que fallen Todo lo que quede fuera del filtro — no es lectura completa Bajo — un comando de git, pero exige definir bien qué es "crítico"

    1. Deja que el type checker sea tu primer filtro

    TypeScript, mypy o el compilador que uses no mienten ni se cansan. Si el agente alucina una propiedad, el gate lo para antes de tu revisión:

    function getDiscount(user: User): number {
      if (user.subscription.tier === 'premium') {
        return user.subscription.discountRate; // no existe en el tipo
      }
      return 0;
    }
    
    error TS2339: Property 'discountRate' does not exist on type 'Subscription'.
    

    Esto no habría parado mi bug del descuento invertido — el tipo estaba bien, la lógica no. Pero sí para buena parte de las alucinaciones típicas: APIs inventadas, campos que no existen, nulls sin manejar. Es gratis y ya lo tienes. Actívalo en modo estricto si no lo has hecho.

    2. Pide los tests desde la spec, antes de enseñarle el código

    Esta es la técnica que me habría salvado del bug del descuento. En vez de pedir código y luego tests, invierte el orden:

    Esta es la especificación (no hay código todavía):
    
    "calcularDescuento(usuario) devuelve 20% si el usuario es premium
    y lleva más de 12 meses activo, 10% si es premium con menos de
    12 meses, y 0% en cualquier otro caso."
    
    Escribe los tests de aceptación en Vitest. Todavía no has visto
    ninguna implementación.
    

    Cuando el agente escribe primero el código y luego "sus" tests, el test hereda cualquier malentendido de la spec. Cuando nace de la spec en una pasada separada, se convierte en un juez independiente que detecta el error porque no lo comparte.

    3. Usa un segundo agente con un prompt distinto como revisor

    No el mismo chat. Una sesión nueva, sin el contexto de cómo se escribió el código, con un prompt deliberadamente escéptico:

    Eres un revisor senior, escéptico por defecto. No escribiste este código
    y no asumes que está bien solo porque compila y pasa los tests actuales.
    
    Busca: casos límite no cubiertos, lógica que no coincide con la
    especificación, manejo de errores ausente, datos sensibles sin validar.
    
    Especificación: [pegar]
    Código: [pegar diff]
    
    No digas "se ve bien". Señala línea y motivo, o di qué revisaste
    y por qué no encontraste problema ahí.
    

    Este patrón de usar un agente distinto para tareas que exigen otro punto de vista es parte de lo que enseño paso a paso en Construye con IA: montar flujos con varios agentes que se corrigen entre sí, no uno solo que se audita a sí mismo.

    4. Diffing dirigido: lee solo lo que puede doler de verdad

    No leas las 340 líneas del PR. Filtra por lo que toca zonas donde un error sale caro:

    git diff --stat main...feature/discount-calc
    
    git diff main...feature/discount-calc -- '**/auth/**' '**/payment/**' '**/*valida*' '**/*schema*'
    

    El criterio de qué es "crítico" no es intuición — es cuánto cuesta que falle y qué tan rápido te enteras.

    Mi criterio, sin "depende"

    El type checker en estricto y el diffing dirigido van siempre, en cualquier PR — son gratis. Los tests desde la spec los reservo para lógica de negocio real, no para un CRUD trivial. El segundo agente como revisor solo cuando ya tengo un flujo agéntico corriendo — si no, revisarlo yo mismo es más rápido.

    Si solo añades una cosa hoy, que sea el type checker en strict más el diffing dirigido: eliminan la categoría de bugs más tonta sin coste de configuración extra.

    Lo que estas técnicas no te van a coger

    Sé honesto contigo mismo, porque yo no lo fui con el descuento: estos cuatro filtros no son un sistema, son parches.

    No dejan rastro. Dentro de tres meses no hay ningún documento que diga qué se verificó, con qué criterio, y quién lo aprobó — repites el proceso de memoria, y la memoria falla en el PR número 40 de la semana.

    Dependen de que definas bien qué es "crítico" o qué pide realmente la spec. Si tu filtro de diffing no incluye la carpeta correcta, o tu spec es ambigua, el agujero sigue ahí y nadie te avisa — el chequeo "pasó" porque nunca miró donde tenía que mirar.

    Y el segundo agente como revisor puede convertirse en un espejo del primero si comparte contexto o sesgo. Un revisor que piensa igual que quien escribió el código no es un revisor — es una segunda opinión de la misma persona.

    Si tu proyecto mueve dinero real, datos de usuarios o decisiones irreversibles, estas cuatro técnicas son el piso mínimo, no el techo. El post Revisar código generado por IA: el método Revisión por Contrato explica el sistema completo que sí deja rastro: qué se construye, por dónde no puede salirse el agente, y quién dice que está bien, con un AGENTS.md real. Si además quieres el sistema montado con harness de verificación end-to-end, el workshop SDD + Agentic Engineering cubre eso paso a paso.

    Qué puedes hacer hoy

    Abre tu tsconfig.json o tu mypy.ini ahora mismo y confirma que estás en modo estricto. Es la línea más barata que vas a escribir esta semana.

    Después, la próxima vez que le pidas código a un agente, invierte el orden: pide primero los tests desde la especificación, en una pasada separada, antes de pedir la implementación. Esa sola inversión habría parado mi bug del descuento.

    Estas cuatro técnicas son la entrada. Cuando el proyecto crezca lo suficiente como para que un parche ya no alcance, el siguiente paso es un sistema real de verificación — contrato, carril y veredicto — que dejo completo, con ejemplos y el AGENTS.md entero, en Revisar código generado por IA: el método Revisión por Contrato. Y si quieres ver cómo aplico esto semana a semana en proyectos reales, en Dominicode Labs comparto el detalle con la comunidad.

    Preguntas frecuentes

    ¿El type checker es suficiente para confiar en código generado por IA?

    No. Detecta que las piezas encajan en forma — tipos correctos, propiedades que existen, nulls manejados. No detecta que la lógica de negocio sea la que pediste. Mi bug del descuento invertido tipaba perfectamente bien: es un filtro necesario y gratuito, no una prueba de corrección.

    ¿Qué diferencia hay entre pedir tests antes o después de ver la implementación?

    Cuando el mismo agente escribe primero el código y luego los tests, estos heredan cualquier malentendido de la spec, porque nacen de la misma lectura equivocada. Generados en una pasada separada, se convierten en un juez independiente que detecta el error porque no lo comparte.

    ¿Puedo usar el mismo agente que escribió el código para revisarlo después?

    Puedes, pero pierdes gran parte del valor: en el mismo chat, con el mismo contexto, el agente tiende a justificar sus decisiones en vez de cuestionarlas. Usa una sesión nueva y un prompt explícitamente escéptico para que la segunda pasada aporte un punto de vista distinto, no un eco del primero.

    ¿Estas técnicas sirven si mi proyecto no tiene tests todavía?

    El type checker y el diffing dirigido sí, sin cambios — no dependen de una suite existente. Los tests desde la spec además te dan una forma barata de empezar a construirla: cada vez que le pides código a un agente, generas primero el test de aceptación, y en unos meses tienes cobertura real sin haber dedicado un sprint a escribirla.

    ¿Cuándo necesito algo más que estas 4 técnicas?

    Cuando el error de un agente puede costarte dinero real, datos de usuarios, o algo que no se deshace con un revert. Ahí un parche puntual no basta — necesitas un sistema que deje rastro de qué se verificó y con qué criterio, que es justo lo que cubre el método de Revisión por Contrato.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Programar con IA: el cuello de botella es verificar, no escribir

    Programar con IA: el cuello de botella es verificar, no escribir

    Hace un año le pedía una feature al agente y me devolvía doscientas líneas.

    Hoy me devuelve ochocientas, y tarda menos.

    Mi ritmo de entrega es exactamente el mismo.

    El cuello de botella dejó de ser escribir código. Ahora es verificarlo — y eso lo sigo haciendo yo, a mano.

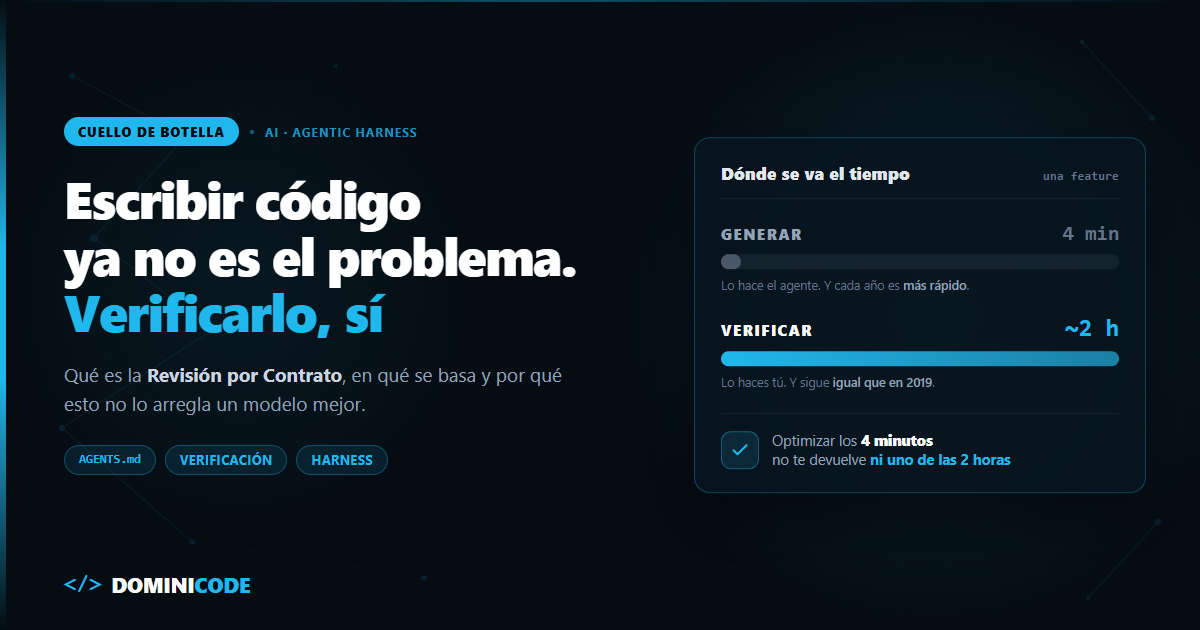
    Durante meses lo achaqué a cosas mías: mala semana, tarea rara, repo complicado. Hasta que hice el cálculo aburrido de cuánto tiempo pasaba generando y cuánto verificando código generado por IA. Generar: cuatro minutos. Verificar: casi dos horas.

    Cuadruplicar la velocidad de los cuatro minutos no me iba a devolver ni un minuto de las dos horas.

    Goldratt lo dejó escrito en La Meta, en 1984, y sigue siendo la frase más útil que conozco para esto: una hora ganada donde no está el cuello de botella es un espejismo. Toda la industria lleva tres años ganando horas justo ahí.

    El cuello de botella se movió y nadie avisó

    El cuello de botella del desarrollo con IA se movió de escribir código a verificarlo. Los datos van en la misma dirección que la anécdota.

    El informe DORA de 2024 midió algo que a mucha gente le sentó fatal: por cada 25% de aumento en la adopción de IA en una organización, el throughput de entrega bajaba un 1,5% estimado y la estabilidad un 7,2%. Más código, menos entrega, y bastante menos tranquilidad.

    Lo interesante es lo que pasó después. En la edición de 2025 el throughput ya sale positivo: aprendimos a mover el código generado hasta producción sin atascarnos tanto. Pero la relación con la estabilidad sigue siendo negativa.

    Traducido: arreglamos la velocidad. No arreglamos la confianza.

    Y no es raro, porque entre el código que sale del agente y producción hay un paso que no ha mejorado nada en tres años: alguien tiene que decidir si eso es correcto. Ese alguien eres tú, con el mismo cerebro de 2019 y menos horas de sueño.

    Es el único componente del sistema que no escala, y es el que recibe todo lo que los demás producen más rápido.

    Por eso un modelo mejor no lo arregla. Un modelo mejor te da código correcto más a menudo — te sube el porcentaje de aciertos, no te quita la obligación de comprobar. Y como no sabes de antemano cuál de las ochocientas líneas es la que falla, sigues teniendo que mirarlas todas.

    Un modelo con un 97% de acierto sobre ochocientas líneas te deja veinticuatro líneas malas escondidas y ninguna pista de dónde.

    Qué es la Revisión por Contrato

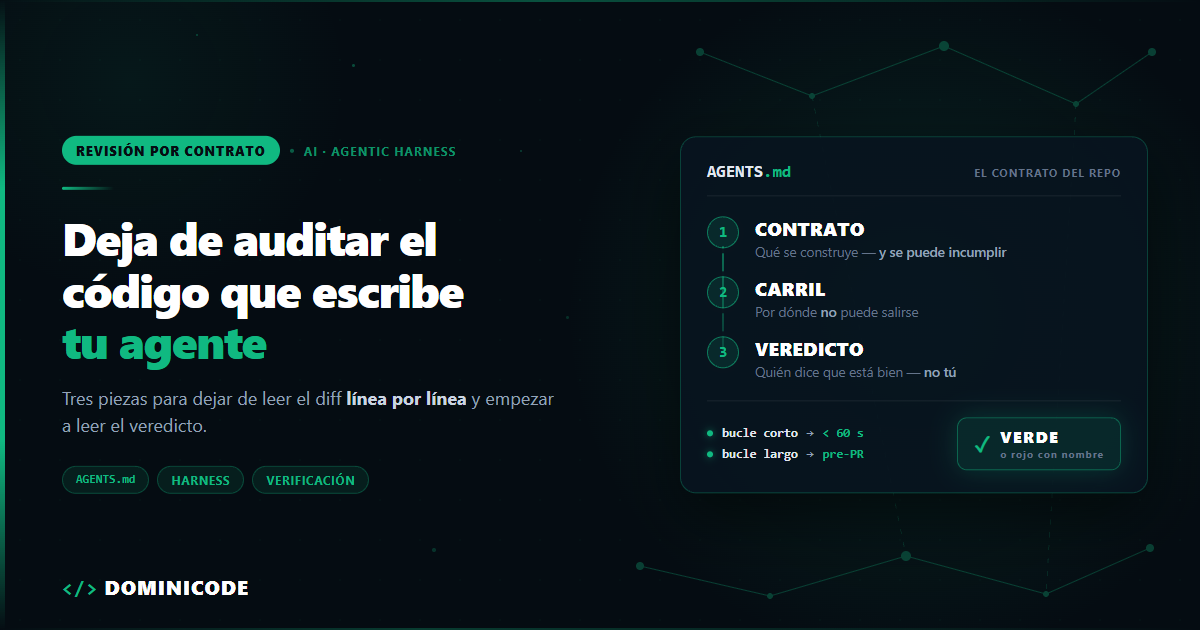
    Revisión por Contrato es un método para verificar código generado por IA sin leerlo entero, moviendo la verificación de tu cabeza a procesos que se ejecutan solos. Son tres piezas, en este orden:

    Contrato. Lo que se construye, escrito de forma que una máquina pueda rechazarlo. No "el endpoint debe ser rápido", sino "p95 por debajo de 200 ms en el test de carga del CI". Vive en dos sitios: el AGENTS.md para lo permanente del repositorio, la spec para lo que nace y muere con esta tarea.

    Carril. Por dónde el agente no puede salirse. Qué ficheros no toca, qué no instala, qué asserts existentes no modifica. Porque la mayoría de los desastres de un agente no son de lógica: son de alcance.

    Veredicto. Quién dice que está bien. Un conjunto de comandos con dos estados posibles y ninguno más: build, tipos, lint, tests y — la que casi nadie tiene — un comando detrás de cada criterio de aceptación.

    Pieza Qué declara Quién la hace cumplir
    Contrato Lo que se construye, en cláusulas que una máquina puede rechazar AGENTS.md para lo permanente del repo + la spec de la tarea
    Carril Por dónde el agente no puede salirse: qué no toca, qué no instala, qué asserts no modifica Límites de escritura declarados por escrito
    Veredicto Si está bien o no, en dos estados y ninguno más El harness de verificación: build, tipos, lint, tests y un comando por criterio de aceptación

    Lo que revisas después no es el diff. Es el veredicto y el contrato.

    Cómo se monta cada pieza, con el AGENTS.md entero y los dos bucles de verificación, lo tengo desarrollado en el post del método. Aquí me interesa lo otro: por qué esto funciona.

    En qué se basa el método para verificar código generado por IA

    Nada de esto lo he inventado yo. Son tres ideas viejas que la IA no rompió, solo hizo urgentes.

    1. Una especificación que no puede fallar es un comentario

    En 1986 Bertrand Meyer metió los contratos dentro del lenguaje Eiffel: precondiciones, postcondiciones, invariantes. La idea era que la especificación de una función dejara de vivir en un documento y pasara a vivir en el código, con una propiedad nueva — que el programa revienta cuando se incumple.

    Esa es la línea que separa documentar de obligar. La misma que ya conoces entre un README que pide formatear antes de commitear y un hook que no te deja commitear sin formatear.

    Tu spec para el agente está casi entera del lado equivocado de esa línea. Coge la última que escribiste y cuenta cuántas de sus líneas podría rechazar una máquina. Suelen ser tres de veinte. Las otras diecisiete son intenciones: orientan al modelo, no rechazan nada, y por eso tu spec no te frenó ni un bug.

    Un contrato no es una spec mejor escrita. Es una spec que puede decir que no.

    Esa conversión —coger tu spec y pasar sus líneas a cláusulas que se pueden incumplir— la tienes entera en el ebook gratuito de Revisión por Contrato, con el código puesto para que lo copies.

    2. Quien produce no puede ser quien juzga

    En cualquier oficio donde el resultado importa, esto es tan obvio que ni se discute. El que lleva las cuentas no es el que las audita. El que escribe el paper no es quien lo revisa.

    En tu repo lleva meses pasando lo contrario y no lo has mirado: el agente tiene permiso de escritura sobre la cosa que lo verifica.

    Los tests son ficheros. El linter se configura con un fichero. El workflow de CI es un fichero. Todo está dentro de su radio de acción. Y cuando le pides que los tests pasen, tocar el assert es un camino perfectamente válido hacia lo que pediste — más corto que arreglar el código, de hecho.

    No hace trampas. Cumple el objetivo por la ruta más barata, que es exactamente para lo que está optimizado.

    Si el verificado puede editar al verificador, no tienes verificación. Tienes teatro. Y de ahí sale el carril, que no es una regla de buenas maneras: es la separación de poderes de tu repositorio.

    3. Llevamos cuarenta años sacando comprobaciones de la cabeza del humano

    El compilador quitó una clase entera de errores que antes se cazaban leyendo. El type checker quitó otra. El linter quitó las discusiones de estilo de las revisiones de código. El CI quitó el "en mi máquina funciona".

    Cada salto de productividad real de esta profesión ha sido el mismo movimiento: coger una comprobación que hacía una persona cansada y dársela a un proceso que no se cansa.

    La Revisión por Contrato no es una idea nueva. Es ese mismo movimiento aplicado al último sitio donde todavía no lo habíamos hecho: comprobar que el código generado hace lo que se pidió.

    Y aquí está el error de época, el que veo en casi todos los equipos: creer que la IA también puede hacer esa parte. Poner un segundo agente a revisar al primero se siente productivo, pero un modelo probabilístico revisando a otro modelo probabilístico no te da un veredicto — te da una segunda opinión, más larga y con la misma naturaleza. La IA genera. Verificar lo hace algo determinista, que sale con código cero o distinto de cero.

    Por qué esto sí resuelve el cuello de botella

    Tres razones, y la tercera es la que me convenció.

    Tu revisión deja de escalar con el tamaño del diff. Hoy revisas ochocientas líneas porque el agente escribió ochocientas. Con contrato revisas cuarenta líneas de contrato y un veredicto, y esas cuarenta líneas no crecen cuando el agente escribe el doble. Rompes el vínculo entre lo que produce la máquina y lo que consume tu atención, que es literalmente la definición de desatascar un cuello de botella.

    El error cambia de sitio y de dueño. Un fallo que detecta el bucle corto a los veintiocho segundos lo arregla el agente, casi siempre solo, y no te enteras. El mismo fallo dentro de una pull request cuesta tu contexto, tu tarde y a veces tu fin de semana. No es que haya menos errores: es que dejan de ser tuyos.

    Y es la única pieza que mejora cuando el modelo mejora. Esta es la buena. Sin verificación, un agente el doble de rápido te dobla la cola de revisión — la mejora del proveedor se convierte en trabajo tuyo. Con verificación, un agente el doble de rápido entrega el doble, porque el harness absorbe el aumento sin pedirte más atención. Es la diferencia entre que los próximos dos años de avances te lleguen como regalo o como factura.

    Lo que no resuelve

    Sería raro que te vendiera esto sin decirte dónde se acaba.

    El contrato comprueba que el código hace lo que pediste. No tiene ni idea de si pediste lo correcto.

    Tampoco te dice si el nombre de ese servicio encaja con el lenguaje del dominio, si la solución es proporcionada al problema, o si acabas de meter la tercera forma distinta de hacer lo mismo en el mismo repo. Eso sigue siendo trabajo humano y lo va a seguir siendo.

    Lo cual, si lo piensas, es una noticia excelente. Ese trabajo — decidir qué se construye y si tiene sentido — siempre fue el nuestro. Lo que nos habíamos autoimpuesto era el otro: leer ochocientas líneas buscando un null.

    La prueba de una línea

    Si quieres saber en treinta segundos si tienes un contrato o un deseo, coge el último criterio de aceptación que escribiste y hazte esta pregunta:

    ¿Puedo escribir algo que compruebe esto sin mí?

    Si la respuesta es sí, es una cláusula. Si es no, es una intención. Y tu tiempo de revisión es, casi exactamente, la suma de tus intenciones.

    Empieza por ahí. Una sola línea de una sola spec, convertida en un comando que devuelve cero o distinto de cero. Es media hora y ya lo notas en la siguiente tarea.

    Cuando quieras el sistema completo — las cinco secciones del AGENTS.md, los dos bucles y los límites, con el porqué de cada línea — está en el ebook gratuito de Revisión por Contrato. Treinta páginas, sin coste.

    Si lo que quieres es montarlo entero de una sentada, sobre un Issue de verdad y hasta la pull request verificada, ese camino completo es el workshop de SDD + Agentic Engineering. Tres horas on-demand, nueve módulos, y sales con tu harness montado en tu repo, no con apuntes.

    Y si prefieres verlo antes de leer nada, esto lo monto en directo cada cierto tiempo: webinar de Revisión por Contrato. Cincuenta y cinco minutos sobre una feature real — el agente entrega, la verificación falla, y en pantalla se ve qué cláusula rompió. Gratis, y la próxima fecha está en la página.

    La parte de cómo se escribe la spec de cada tarea, con más profundidad, la tienes en el libro de Spec-Driven Development.

    El cuello de botella no se mueve solo. Pero se mueve.

    Preguntas frecuentes

    ¿Qué es exactamente la Revisión por Contrato?

    Un método para verificar código generado por IA sin leerlo entero. Tiene tres piezas: un contrato con cláusulas que una máquina puede rechazar (no "debe ser rápido", sino "p95 < 200 ms en el CI"), un carril que declara por escrito dónde el agente no puede escribir, y un veredicto emitido por comandos ejecutables con dos estados posibles. Lo que revisa la persona después es el veredicto y el contrato, no el diff completo.

    ¿Por qué un modelo mejor no te ahorra verificar código generado por IA?

    Porque un modelo mejor sube el porcentaje de aciertos, no elimina la obligación de comprobar. Con un 97% de acierto sobre ochocientas líneas te quedan veinticuatro líneas malas y ninguna indicación de cuáles son, así que sigues teniendo que revisarlas todas.

    ¿No puedo poner otro agente a revisar el código del primero?

    Ayuda como segunda opinión, no como veredicto. Un modelo probabilístico revisando a otro modelo probabilístico produce texto plausible, no un resultado binario y reproducible. La verificación tiene que apoyarse en algo determinista — build, tipos, lint, tests, criterios de aceptación con un comando detrás — precisamente porque no cambia según cómo venga el día.

    ¿Qué relación tiene la Revisión por Contrato con Design by Contract?

    Es la misma idea de Bertrand Meyer (Eiffel, 1986) sacada de la función y aplicada al agente. Design by Contract mete precondiciones, postcondiciones e invariantes dentro del lenguaje para que el programa reviente cuando se incumplen. La Revisión por Contrato hace lo mismo un nivel por encima: escribe los criterios de aceptación de la tarea en cláusulas que un comando puede rechazar, para que el fallo lo cace el harness de verificación y no tus ojos a las once de la noche.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Revisar código generado por IA: el método Revisión por Contrato

    Revisar código generado por IA: el método Revisión por Contrato

    Una noche estuve casi dos horas revisando una pull request.

    No la escribí yo. La escribió el agente, en dos minutos.

    Y ahí me quedé, con el diff abierto a las tantas, leyendo línea por línea un código que no había escrito, buscando el fallo que sabía que estaba en alguna parte.

    Dos minutos de generación. Ciento diez de revisión.

    Revisar código generado por IA se había comido entero el tiempo que la IA me iba a ahorrar.

    Nos vendieron que la IA nos iba a quitar trabajo, y es verdad a medias, que es la peor forma de ser verdad. Te quitó el trabajo de escribir. Te dio el trabajo de auditar.

    Antes escribías cuatrocientas líneas en dos horas. Ahora las lees en dos horas.

    Por qué revisar código generado por IA cansa más que escribirlo

    Revisar código generado por IA cansa más que escribirlo porque no sigues un razonamiento: verificas cuatrocientas afirmaciones independientes, una a una, sin ningún hilo que las sostenga.

    Cuando escribes esas cuatrocientas líneas, el modelo mental se construye contigo. Entender es un subproducto gratis de haberlas escrito.

    Cuando las revisas, tienes que reconstruir ese modelo desde fuera, deduciendo la intención a partir del resultado. Y ahí está el detalle:

    Del otro lado no había ningún modelo mental.

    Tu compañero, cuando escribió aquella función rara, tenía un motivo. Malo o bueno, pero un motivo, y podías preguntárselo. El agente produjo el token más probable dadas las circunstancias. Estás reconstruyendo una intención que nunca existió.

    Por eso cansa distinto, y por eso no mejora con la práctica: no hay nada que aprender, solo cuatrocientas comprobaciones que hacer.

    Y lo peor no es el tiempo. Es que nunca sabes del todo si se te ha colado algo, porque en la línea 230 aflojaste y lo sabes. O lo lees entero con la misma atención en la 400 que en la 12, o lo mergeas con el nudo en el estómago. No hay tercera.

    Y ya sabes cuál de las dos gana casi siempre: en cinco proyectos de gran escala, el 64,7% de las pull requests se aprueba sin un solo comentario.

    El problema no era el agente

    Yo estuve meses culpando al modelo. Cambié de herramienta tres veces y escribí prompts cada vez más largos, con más reglas, más ejemplos y más mayúsculas.

    Mejoraba un poco. Nunca lo suficiente.

    Hasta que caí en lo que estaba delante desde el principio: el problema no era el agente, era que yo era la única verificación del sistema. Entre el código generado y producción no había nada más que mis ojos cansados.

    Eso no lo arregla un modelo mejor. Un modelo mejor te da código correcto más a menudo, pero no cambia quién tiene que comprobarlo.

    De hecho, cada mejora en la velocidad de generación empeora tu situación. Si el agente pasa de cuatrocientas líneas a ochocientas en el mismo rato, tú no has ganado nada: has doblado la cola de revisión. La única parte del proceso que no escala eres tú, y todo el mundo está optimizando las otras.

    Por qué tu spec no lo arregló

    Aquí es donde la mayoría me dice que ya probó lo de escribir specs y lo dejó.

    Yo también. Y no es que las specs sean inútiles: es que escribiste la spec para el agente, no para la verificación.

    Mira tus criterios de aceptación de la última vez. “El endpoint debe ser rápido.” “Maneja bien los errores.” “No rompas nada.” Frases que ninguna máquina puede rechazar. Una spec que nadie comprueba es documentación, y la documentación no ha frenado un bug en la historia de esta profesión.

    Un contrato es una especificación contra la que algo puede fallar. Fallar de verdad: salir con código distinto de cero, poner el CI en rojo, parar la cosa antes de que llegue a ti.

    Es la misma diferencia que ya conoces entre un README que dice “recuerda formatear antes de commitear” y un hook que no te deja commitear sin formatear. Los dos expresan la misma norma. Uno confía en que alguien se acuerde.

    Tu spec era un README muy bien escrito. Lo que necesitas es el hook.

    Así que coge cualquier línea de cualquier spec tuya y pregúntate esto:

    ¿Puedo escribir algo que compruebe esto sin mí?

    Si la respuesta es sí, tienes una cláusula. Si es no, tienes una intención. Las intenciones no se tiran —orientan al agente y algo aportan—, pero no cuentan: no van a rechazar nada y no puedes apoyarte en ellas para dejar de leer el diff entero.

    Cuando pasas tu spec entera por esa pregunta suele salir algo incómodo: de veinte líneas, diecisiete eran intenciones.

    Si al hacer el recuento te sale un número parecido, el problema no es que escribas mal specs: son los siete fallos típicos que hacen que una spec no aguante delante de un agente, y casi todos se arreglan con la misma pregunta.

    Ahí está tu tiempo de revisión. Y convertir esas diecisiete es lo que llamo Revisión por Contrato: tres piezas en un orden que importa.

    La Revisión por Contrato es un método para revisar código generado por IA sin leer el diff entero. Consta de tres piezas: conviertes las intenciones de tu spec en cláusulas que una máquina puede rechazar (contrato), declaras por escrito dónde el agente no puede escribir (carril) y dejas que un conjunto de comandos ejecutables emita el resultado (veredicto). Lo que tú revisas después es el veredicto y el contrato, no las cuatrocientas líneas.

    1. Contrato: qué se construye

    La conversión desde tu spec actual es bastante mecánica:

    Spec (describe) Contrato (se puede incumplir)
    “El endpoint debe ser rápido” p95 < 200 ms en el test de carga del CI
    “Maneja bien los errores” Todo path de error devuelve un tipo del enum AppError
    “No rompas nada” La suite existente pasa sin cambios en sus asserts
    “Sigue las convenciones” lint y typecheck en verde, sin excepciones nuevas

    Hay dos contratos, y confundirlos es el error más común. El AGENTS.md es el contrato permanente del repositorio: lo que es cierto para cualquier tarea que se haga aquí. La spec es el contrato de esta tarea concreta, nace con el issue y muere con la pull request. Si metes lo de la tarea en el AGENTS.md, envejece fatal y en dos meses nadie se fía de lo que dice.

    Para la parte de la tarea tengo publicada la skill que uso yo, sdd-creator: obliga al agente a escribir spec.md, plan.md y tasks.md antes de tocar código, y funciona igual en Claude Code, Codex, Cursor o Gemini.

    Aquí vamos con el AGENTS.md, que es el que más rinde por línea escrita. Esta es la primera mitad:

    # AGENTS.md
    
    API de facturación interna. Emite y consulta facturas para el equipo de
    operaciones. No es público: todo el tráfico entra por el gateway.
    
    ## Stack
    
    - **Lenguaje:** TypeScript 7, Node 24 LTS
    - **Framework:** Fastify 5
    - **Gestor de paquetes:** pnpm — derivado de `pnpm-lock.yaml`. No uses otro.
    
    ## Convenciones
    
    - Los handlers no hablan con Prisma. Pasan por un servicio en `src/services/`.
    - Todo error de dominio es un `AppError`. No se lanzan strings ni `Error` pelado.
    - Los tests van junto al fichero que prueban, como `*.test.ts`.
    
    ## Definición de terminado
    
    Una tarea está terminada cuando:
    
    1. El bucle corto pasa en verde.
    2. El bucle largo pasa en verde.
    3. Cada criterio de aceptación de la spec tiene evidencia: qué comando lo
       demuestra y cuál fue su salida.
    4. El diff no contiene nada que la spec no pidiera.
    

    Las convenciones no las inventes: ábrete tres ficheros del repo y escribe lo que ya se hace. Una convención impuesta desde fuera que el código existente incumple es la peor línea que puedes meter ahí, porque el agente la seguirá y su código no se parecerá a nada de lo que hay alrededor.

    Y el punto 4 merece párrafo propio, porque es el que casi nadie escribe y el que más caro sale.

    Le pides al agente que arregle un bug del IVA. Arregla el bug. Y de paso renombra dos variables, extrae un helper, actualiza un comentario y reordena los imports de tres ficheros. Puede que hasta sean mejoras, pero ninguna de esas líneas está cubierta por ningún contrato: nadie las pidió, nadie definió cuándo estarían bien, y ahora están en tu diff obligándote a leerlas.

    Código de más es código sin contrato. Esa línea sola recorta el diff medio de una forma que se nota la primera semana.

    2. Carril: por dónde no puede salirse

    Piensa en la última vez que un agente te dejó algo raro. Ajustó el assert de un test que fallaba. Añadió una dependencia entera para no escribir tres líneas. Metió un as any. Marcó un test lento como skip. Tocó un fichero de despliegue.

    Ninguno de esos es un fallo de razonamiento. En todos entendió perfectamente lo que le pediste.

    La mayoría de los desastres que te va a dar un agente no son de lógica. Son de alcance.

    No hace trampas: hace lo que le pediste por el camino más corto que encontró. Le pediste que los tests pasaran. No le pediste que el código funcionara. Casi siempre coinciden, por eso vivimos tranquilos. Cuando dejan de coincidir, el camino corto es tocar el test.

    Y de aquí sale lo que de verdad importa:

    Si el agente puede modificar la cosa que lo comprueba, no tienes verificación. Tienes teatro.

    Los tests, el linter, el CI — todo eso son ficheros del repositorio, dentro de su radio de acción. Salvo que digas lo contrario, el que recibe el veredicto tiene permiso de escritura sobre quien lo emite. Ningún juzgado funcionaría así.

    ## Límites
    
    Sin permiso explícito, el agente no toca:
    
    - `prisma/migrations/` ni el esquema. Una migración se revisa a mano, siempre.
    - `.github/workflows/`, `Dockerfile` ni nada de despliegue.
    - `package.json`: no se añaden ni se actualizan dependencias. Si hace falta
      una, para y pregunta.
    - `.env`, `.env.*` ni ningún fichero con credenciales.
    - Los asserts de los tests que ya existen. Añadir tests nuevos, sí. Cambiar
      los que ya estaban, no.
    - `src/lib/money.ts`. Es aritmética de céntimos y ya nos ha mordido dos veces.
    

    El “para y pregunta” es una salida y hace falta: un límite sin salida se convierte en un agente bloqueado o, peor, en un agente que se lo salta.

    La línea de los asserts es la que protege al verificador. No prohíbe tocar los tests: prohíbe cambiar los que ya estaban. Añadir cobertura nueva puede y debe; aflojar la existente para que su trabajo pase, no.

    Y la última línea es la que hace creíbles a todas las demás. money.ts no está ahí por una regla general, sino porque ese fichero ya mordió dos veces. Las cuatro primeras las copias de cualquier plantilla; esa la escribes tú. Tu repo tiene dos o tres. Ya sabes cuáles son.

    Ahí está el cambio de postura que ordena todo lo demás: dejas de pedirle al agente que se porte bien y montas un sitio donde portarse mal se detecta solo. Un prompt es una petición y depende de que el modelo esté teniendo un buen día. Un límite es una propiedad del sitio donde trabaja.

    Eso sí, sé honesto con lo que es un fichero markdown: una señal, no una valla. Los límites de verdad viven en tres capas — declarado (el AGENTS.md), impedido (permisos y hooks que rechazan escrituras fuera del alcance) y detectado (CI y protección de rama). La primera cuesta diez minutos y quita la inmensa mayoría de las desviaciones. Si alguien te vende que un markdown le pone puertas a un proceso con acceso de escritura a tu disco, desconfía.

    3. Veredicto: quién dice que está bien

    Un veredicto no es una opinión. Una opinión es lo que da un linter cuando sugiere, o lo que das tú a las once de la noche cuando dices “bueno, tiene buena pinta”.

    Un veredicto es un proceso que termina en dos estados y ninguno más. No admite matices y no cambia según lo cansado que estés.

    Y no lo emite una cosa. Lo emiten cinco:

    Capa Pregunta que responde
    Build ¿Esto compila?
    Tipos ¿Las piezas encajan entre sí?
    Lint ¿Se parece al resto del código de esta casa?
    Tests ¿El comportamiento sigue siendo el que era?
    Criterios de aceptación ¿Hace lo que la spec pidió?

    Las cuatro primeras ya las tienes: están en tu repo desde antes de que existieran los agentes. La quinta es la que casi nadie tiene, y es la que convierte un montón de comandos sueltos en un harness, porque conecta el contrato con algo que se ejecuta.

    Un aviso sobre la palabra “harness”, que se usa para dos cosas distintas: aquí es el conjunto de comandos que verifica el código que tu agente escribe. Si lo que quieres es probar el agente en sí —tools falsas, presupuesto de tokens, trazas reproducibles en CI—, eso es otro montaje y lo explico en el test harness para agentes de IA.

    Esa quinta capa es la que tengo automatizada en ai-workflow-kit —v2.5.0 en npm a septiembre de 2026—, que se instala con npx ai-workflow-kit. El plan de la tarea lleva una casilla por paso, y cada casilla lleva detrás el comando que la demuestra: verify la marca solo cuando ese comando sale con código cero. Lo que queda escrito en el fichero es lo que se demostró, no lo que el agente dijo que había hecho.

    El harness tiene dos velocidades, y esa decisión que parece técnica es la que decide si el sistema se usa o se abandona. El bucle corto lo ejecuta el agente después de cada cambio y tiene que bajar de sesenta segundos; si tarda más, hace tandas más largas entre comprobaciones y cuando algo falla ya no sabes cuál de los quince cambios lo rompió. El bucle largo se ejecuta una vez, antes de abrir la PR.

    Y no, no puedes meterlo todo en el corto por si acaso. Un bucle corto de ocho minutos no es exhaustivo: es un bucle que nadie ejecuta. Los sesenta segundos son el umbral por debajo del cual la gente no busca la forma de esquivarlo.

    ## Verificación
    
    Estos comandos están ejecutados y comprobados. Son el harness: si uno falla,
    el trabajo no está hecho.
    
    ### Bucle corto — después de cada cambio
    
        pnpm typecheck      # 4s
        pnpm lint           # 6s
        pnpm test:unit      # 18s
    
    ### Bucle largo — antes de abrir la PR
    
        pnpm build          # 40s
        pnpm test           # 2m 10s
        pnpm test:e2e       # 3m 30s
    
    ### Rojos conocidos
    
    - `pnpm test:e2e` falla 2 de 34 en `emision-factura.e2e.ts` desde el cambio
      del proveedor de firma. Es anterior al agente. Si falla cualquier otro,
      lo rompiste tú.
    

    Si te llevas una sola línea técnica de este post, que sea esta: nunca metas en el harness un comando que no hayas ejecutado.

    El agente lee el fichero, ve pnpm test:integration, lo lanza, el comando no existe, el error es raro y decide seguir adelante. Él cree que está verificado. Tú crees que está verificado. Nadie ha comprobado nada. Has empeorado tu punto de partida y encima duermes mejor.

    Los tiempos anotados al lado de cada comando tampoco son decoración: son lo que te permite saber dentro de seis meses si el bucle corto sigue siendo corto. Los harness no se rompen de golpe, se degradan un comando cada vez.

    Y los rojos conocidos son lo que más me costó aceptar. ¿Qué haces con un comando importante que hoy falla? La tentación es dejarlo fuera hasta arreglarlo. No lo hagas: ponlo y documenta que está en rojo. Un harness honesto con dos rojos vale más que uno verde de mentira. Además, si el agente sabe qué estaba roto antes de empezar, distingue lo que rompió él de lo que ya estaba roto, en vez de ponerse a investigarlo y a veces a “arreglarlo”.

    Qué cambia el martes por la mañana

    Le pides una feature y el agente rompe el contrato — pongamos que dos tests existentes fallan.

    Sin harness, eso te llega como una PR de cuatrocientas líneas y tú descubriéndolo en el minuto cuarenta. O peor, no descubriéndolo.

    Con harness, el bucle corto se pone rojo a los veintiocho segundos y el agente sabe exactamente qué rompió, porque el rojo tiene nombre y no está en la lista de rojos conocidos. La mayoría de las veces lo arregla solo. Y cuando no puede, lo que te llega no es un diff: es una frase — no puedo cumplir esta cláusula sin tocar lo que dijiste que no tocara.

    Mi tiempo medio de revisión pasó de una hora cincuenta a veinte minutos. A cuatro PRs por semana son seis horas a la semana. No lo redondeo a “cinco veces más rápido” porque los porcentajes bonitos son lo primero que hace desconfiar: es un número mío, medido en mi repo. Tú tendrás el tuyo.

    Pero los veinte minutos siguen ahí, y aquí es donde muchos esperan que diga “y ya no revisas nada”. Lo que cambió es en qué se te van:

    1. Miras el veredicto. Qué pasó, qué falló, qué se saltó. Treinta segundos.
    2. Lees el contrato, no la implementación. Cuarenta líneas. Y la pregunta ya no es “¿está bien este código?” sino “¿pedí lo correcto?”, que es muchísimo mejor pregunta y que solo puedes responder tú.
    3. Lees el diff, pero apuntando a las zonas donde el contrato no llega: si el nombre encaja con el dominio, si la solución es la adecuada para este proyecto. Ahí es donde viven los fallos que un code review no puede ver —N+1, fugas de recursos, race conditions—, y por eso ese tercer paso no lo puedes borrar del proceso.

    Ese tercer punto es tu trabajo de verdad, y es el que la IA no te va a quitar. Nunca fue leer cuatrocientas líneas buscando un null. Era decidir si lo que se construyó tenía sentido.

    Qué hacer hoy

    Cuatro cosas, por orden. Ninguna te lleva más de una tarde.

    1. Pasa tu última spec por la prueba de una línea. Cuenta cláusulas e intenciones. Ese número explica tu tiempo de revisión mejor que cualquier otra cosa.
    2. Ejecuta tus comandos de verificación, uno a uno, apuntando lo que tarda cada uno. De ahí salen tu bucle corto, tu bucle largo y tus rojos conocidos.
    3. Escribe el AGENTS.md con esas secciones: stack, convenciones, definición de terminado, límites y verificación. Media página. El punto 4 de la definición de terminado no te lo saltes.
    4. Añade una línea de carril que sea tuya. El fichero que ya te mordió. Esa es la que hace creíbles a las otras cinco.

    El AGENTS.md no hace falta que lo escribas mirando a una pantalla en blanco: lo tienes entero, con las cinco secciones y los comentarios de por qué está cada línea, en el ebook gratuito de El método Revisión por Contrato. Treinta páginas, sin coste.

    Si prefieres ver el AGENTS.md, el harness y los límites montados sobre un proyecto real en vez de partir de una plantilla, ese es justo el recorrido de Construye con IA: de la idea al producto con Claude Code.

    Un apunte que te ahorra una tarde: AGENTS.md es un estándar abierto, no algo que traigan todas las herramientas. En su lista de compatibilidad, consultada el 6 de septiembre de 2026, están Codex, Cursor, el agente de codificación de Copilot, Gemini CLI o Zed. Claude Code es la excepción, y conviene saberlo porque es de las más usadas: lee CLAUDE.md. Se arregla con un fichero de una línea que importe el otro con @AGENTS.md. Compruébalo en tu versión, que esto es de lo poco aquí que puede cambiar en tres meses.

    Si quieres el marco completo alrededor de esto —cómo se escribe la spec de la tarea, no solo el contrato del repo— lo desarrollo en el libro de Spec-Driven Development, en papel o en ebook.

    Empieza por el punto 2. Es el más aburrido de los cuatro y es el que sostiene los otros tres.

    Preguntas frecuentes

    ¿Cómo se revisa código generado por IA sin leer todo el diff?

    Necesitas tres cosas antes de que la pull request llegue a ti: un contrato con cláusulas que una máquina pueda rechazar, límites escritos sobre qué ficheros el agente no toca, y un harness de comandos ejecutables que emita un veredicto binario. Con eso, tu revisión se reduce a tres pasos: mirar el veredicto (treinta segundos), leer el contrato para comprobar que pediste lo correcto (unas cuarenta líneas) y leer el diff solo en las zonas que el contrato no cubre —nombres, encaje con el dominio, si la solución es la adecuada para este proyecto—. En mi repo eso bajó el tiempo medio de revisión de una hora cincuenta a veinte minutos.

    ¿Esto no es simplemente tener buenos tests?

    Los tests son una de las cinco capas, no el mecanismo. Puedes tener una suite excelente y seguir revisando cuatrocientas líneas a mano, porque los tests responden “¿el comportamiento sigue siendo el que era?” y no responden “¿esto hace lo que la spec pidió?” ni “¿el agente se salió de su terreno?”. La pieza que casi nadie tiene es la quinta: criterios de aceptación con un comando detrás. Y si quieres que el test defina el contrato antes de que el agente escriba nada, eso es TDD con IA y encaja encima de esto, no en su lugar.

    Mi repo no tiene tests. ¿Esto me sirve de algo?

    Sí, y probablemente más. Empieza por lo que ya existe aunque no lo llames harness: el build, el type checker y el linter ya emiten veredictos hoy. Escribe el AGENTS.md con esos tres comandos y los límites, y añade tests después, uno por tarea. La alternativa —esperar a tener cobertura para empezar— es como la gente se queda un año sin hacer nada.

    ¿No es más fácil poner todo esto en el prompt?

    Funciona. Casi siempre. El problema es el casi. El prompt vive en una conversación y muere con ella. El fichero vive en el repositorio: se escribe una vez y se aplica a todas las tareas que vengan detrás, incluidas las que lance otra herramienta o cualquiera que entre al repo después de ti.

    ¿Esto no ralentiza al agente?

    Al contrario, aunque el bucle corto sume segundos. Sin verificación el agente entrega rápido y falso, y el coste aparece luego en tu revisión y en los arreglos. Con verificación, el error llega a los veintiocho segundos, con nombre, y lo arregla él. La velocidad que importa no es la de generar código: es la de llegar a algo que se pueda mergear.

    ¿Sirve si mi stack no es TypeScript?

    La estructura es la misma en Python, Go o Java — stack, convenciones, definición de terminado, límites y verificación. Lo que cambian son los comandos concretos, y esos salen de tu proyecto, no de un ejemplo. Copia la forma y rellénala con lo tuyo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo monitorear efectivamente agentes de IA en producción

    Cómo monitorear efectivamente agentes de IA en producción

    Cómo monitorear tus agentes de IA en producción

    Tiempo estimado de lectura: 5 min

    Ideas clave

    • Instrumentación desde el día 0: traces y spans que representen sesiones completas y decisiones individuales.
    • Métricas triples: rendimiento (TTFT, percentiles), coste (tokens/coste por span/sesión) y calidad (feedback y señales automáticas).
    • Elegir plataforma según arquitectura: LangSmith para stacks centrados en LangChain; Langfuse (+ ClickHouse) para portabilidad y escala.
    • Cultura operacional: versionado de prompts, tests de regresión y despliegue progresivo son obligatorios.

    Cómo monitorear tus agentes de IA en producción debería ser la primera conversación del equipo antes de lanzar una beta. Si no instrumentas traces, spans, costes y calidad desde el día 0, tu siguiente sprint será apagar fuegos y explicar facturas inexplicables.

    Este artículo explica el diseño mínimo de observabilidad para agentes (LLM Observability), las métricas que importan y las decisiones tecnológicas prácticas entre plataformas como Langfuse y LangSmith. Incluye enlaces directos a recursos: Langfuse, LangSmith y ClickHouse.

    Resumen rápido (lectores con prisa)

    Qué es: Observabilidad para agentes de IA: traces distribuidos y spans que capturan prompts, llamadas a LLM, búsquedas vectoriales y tool calls.

    Cuándo usarlo: desde el día 0 en cualquier beta u ambiente productivo que use agentes/LLMs.

    Por qué importa: APMs tradicionales no detectan fallos semánticos ni picos de coste por tokens.

    Cómo funciona (resumen): instrumenta spans por acción, mide rendimiento/coste/calidad, y almacena traces para query analítica y alertas.

    Principio: los APM tradicionales no son suficientes

    APM como Datadog o Prometheus miden latencia HTTP, errores y consumo de CPU. Perfecto para servicios deterministas. Un agente de IA devuelve HTTP 200 y puede a la vez fabricar información falsa, ejecutar llamadas externas y disparar costes por token. En ese escenario, el APM dice “todo bien” mientras tu soporte recibe tickets.

    Necesitas telemetría diseñada para flujos probabilísticos: rastreo distribuido con traces que representen sesiones completas y spans que documenten cada decisión y llamada (LLM, búsqueda vectorial, tool calls, llamadas externas).

    Traces y spans: la unidad mínima de diagnóstico

    Diseña cada interacción como un trace. Cada acción —prompts, retrievals, llamadas a herramientas, transformaciones— es un span con metadata.

    Trace: session_42
    ├─ Span 1: receive_prompt (userId=42, promptHash=…)
    ├─ Span 2: vector_search (index=kb_v1, hits=3, latency=320ms)
    ├─ Span 3: LLM_call (model=gpt-4o, tokens_in=1800, tokens_out=120, cost=$0.012)
    └─ Span 4: synthesize_response (format=short-answer)

    Con esto puedes responder rápido: ¿por qué tardó 12s? ¿qué span generó el mayor coste? ¿qué prompts producen más fallos semánticos?

    Métricas imprescindibles (no negociables)

    Rendimiento

    • Time to First Token (TTFT): impacto directo en la UX.
    • Latencia por span y percentiles: p50 / p95 / p99 por tipo de span.

    Coste

    • Tokens y coste por span: calcular coste por span y por session/userId.
    • Coste acumulado por workflow: agente que llama al LLM varias veces debe sumar costes por workflow.
    • Alertas de coste: activar alertas cuando una sesión supera un umbral definido.

    Calidad

    • Feedback explícito: thumbs up/down ligado al trace.
    • Señales implícitas: tiempo de interacción, copias realizadas.
    • LLM-as-a-judge: usar un modelo más económico para evaluar respuestas automáticamente como señal de calidad (no como veredicto absoluto).

    Langfuse vs LangSmith: criterio técnico para elegir

    LangSmith es excelente si tu stack está centrado en LangChain/LangGraph: integración out-of-the-box, datasets de evaluación y UI lista para depurar agentes complejos. El coste es acoplamiento: extraer datos o migrar a otro sistema será costoso.

    Langfuse es agnóstico y open source; se integra con llamadas directas a APIs, Vercel AI SDK, n8n, etc. La reciente incorporación de ClickHouse al ecosistema refuerza su escalabilidad analítica: consultas sobre millones de traces con latencias bajas y análisis de coste en tiempo real. Si prevés escala o necesitas evitar vendor lock-in, Langfuse+ClickHouse es una apuesta sólida.

    Decisión práctica

    • Si dependes de LangChain → LangSmith.
    • Si buscas portabilidad, alto throughput analítico y autoalojamiento → Langfuse (+ ClickHouse).

    Implementación práctica: checklist mínimo viable

    1. Wrap de llamadas al LLM: envuelve cada llamada con un SDK de observabilidad (Langfuse/LangSmith) que capture prompt, model, tokens, cost y versión del prompt.
    2. Correlación: adjunta userId, sessionId y deployment/version tags a cada trace.
    3. Ignorar ruido: no envíes node_modules, logs grandes o secretos. Usa reglas de exclusión (.lfignore / .langsmith-ignore).
    4. Costeo por sesión: suma tokens y coste por sessionId y expón dashboards con coste por feature o cliente.
    5. Evaluación automatizada: configura un pipeline de “LLM-as-a-judge” para marcar respuestas sospechosas y crear datasets de retraining.
    6. Sandboxing y alertas: ejecuta tool calls en entornos aislados y genera alertas cuando spans ejecutan operaciones potencialmente destructivas.
    7. Auditoría y retenimiento: guarda prompts y respuestas (con enmascarado si hay datos sensibles) para reproducibilidad y cumplimiento.

    Operación y cultura: monitoreo como contrato

    No es sólo técnica: es proceso. Cada cambio en prompts o pipelines debe ir acompañado de: etiquetas de versión, tests de regresión en datasets de evaluación y despliegue progresivo (canary). Sin estos pasos, la observabilidad será un registro pasivo en lugar de un control activo.

    La regla final es simple: ningún agente a producción sin traces, coste por session y un mecanismo automático de evaluación. Si ignoras eso, no estás operando IA; estás apostando.

    Implementa observabilidad desde el primer sprint, usa Langfuse o LangSmith según tu arquitectura y organiza tus dashboards en rendimiento, coste y calidad. La visibilidad no es un lujo: es la única forma de mantener agentes de IA útiles, seguros y rentables en producción.

    Para equipos que construyen flujos, agentes o automatizaciones, una referencia práctica y recursos adicionales están disponibles en Dominicode Labs. Es una continuidad natural para explorar integración, pipelines de evaluación y despliegue controlado en proyectos de IA aplicada.

    FAQ

    ¿Por qué los APM tradicionales no detectan problemas de agentes de IA?

    Porque miden señales infraestructurales (HTTP, CPU, errores) pero no la veracidad semántica ni el consumo de tokens. Un agente puede devolver HTTP 200 y producir contenido incorrecto o costoso.

    ¿Qué debe contener un span para ser útil?

    Metadata mínima: tipo de acción (prompt, search, tool call), timestamps, latencia, modelo, tokens_in/tokens_out, coste estimado, userId/sessionId y versión del prompt.

    ¿Cómo calcular el coste por sesión?

    Suma los tokens y el coste asociado de todos los spans pertenecientes al mismo sessionId. Agrupa por workflow o por cliente para dashboards y alertas.

    ¿Cuándo elegir LangSmith sobre Langfuse?

    Elige LangSmith si tu stack está fuertemente integrado con LangChain/LangGraph y aprecias integración out-of-the-box. Evita si necesitas portabilidad o evitar vendor lock-in.

    ¿Qué es LLM-as-a-judge y para qué sirve?

    Es usar un modelo más económico para evaluar respuestas automáticamente como señal de calidad. Sirve para priorizar revisiones humanas y construir datasets de retraining, pero no debe ser el veredicto final.

    ¿Qué datos debo enmascarar al guardar prompts?

    Enmascara datos sensibles: PII, credenciales, secretos y cualquier información regulada. Guarda versiones y hashes cuando sea posible para reproducibilidad sin exposición directa.

  • Aprende a convertirte en AI Engineer en 2026

    Aprende a convertirte en AI Engineer en 2026

    De dev a AI Engineer: qué necesitas aprender en 2026

    Tiempo estimado de lectura: 3 min

    Ideas clave

    • Prompt Engineering como contrato tipado y versionable para reducir alucinaciones.
    • Tool Calling y agentes: definir herramientas con responsabilidades únicas y schemas JSON.
    • RAG en producción usando embeddings, chunking y pgvector para memoria privada eficiente.
    • LLMOps con tracing y LLM-evaluadores para medir costes y alucinaciones.

    Introducción

    Buscar De dev a AI Engineer: qué necesitas aprender en 2026 ya no es curiosidad de fin de semana; es una decisión profesional con impacto directo en tu carrera. Si vienes de React, Angular o NestJS, tienes la base técnica. Lo que falta es reaprender cómo estructurar sistemas cuando la lógica principal es probabilística y depende de modelos externos.

    En las siguientes líneas encontrarás un roadmap concreto, orientado a ingenieros web/backend, con prioridades prácticas, enlaces a documentación útil y criterios para decidir qué aprender primero.

    Resumen rápido (lectores con prisa)

    Prompt Engineering: diseñar prompts como artefactos versionables que produzcan salidas tipadas y validables.

    Tool Calling / Agentes: definir herramientas con schemas JSON y orquestar invocaciones desde un Agent Loop.

    RAG: almacenar embeddings por chunk (pgvector), recuperar top-k y re-rankear antes de inyectar contexto.

    LLMOps: traza sesiones, registra tokens y usa un LLM evaluador para medir pertinencia y alucinaciones.

    De dev a AI Engineer: qué necesitas aprender en 2026 (roadmap concreto)

    No te doy una lista genérica. Te doy cuatro pilares con tareas prácticas y recursos.

    1) Prompt Engineering estructurado — De texto a contrato

    • Qué aprender: diseñar prompts como artefactos versionables: system prompts, ejemplos (few-shot), y salidas tipadas.
    • Práctica concreta: escribe prompts que devuelvan JSON con un esquema Zod; automatiza tests que validen esos esquemas en CI.
    • Por qué importa: reduce alucinaciones y permite integrar respuestas en pipelines sin parsing frágil.
    • Recurso: Vercel AI SDK para integrar outputs tipados en TypeScript.

    2) Tool Calling y diseño de agentes — Orquesta, no suplentes

    • Qué aprender: definir herramientas (APIs) como JSON-schema que el LLM puede invocar (function/tool calling).
    • Práctica concreta: implementa un Agent Loop mínimo en NestJS:
      • Enviar mensaje + herramientas (schemas) al LLM.
      • Si respuesta indica tool_use, validar args y ejecutar el Service correspondiente.
      • Devolver tool_result y repetir hasta end_turn.
    • Criterio: cada herramienta = responsabilidad única (no “herramienta dios”).
    • Recurso: Anthropic Tool Use

    3) RAG (Retrieval-Augmented Generation) avanzado — Memoria privada usable

    • Qué aprender: embeddings, chunking semántico, re-ranking y vectores en producción.
    • Práctica concreta: usa pgvector sobre PostgreSQL para empezar; implementa pipeline:
      • Normaliza y chunkea documentos.
      • Genera embeddings por chunk.
      • Recupera top-k por similitud y re-rankea por señal de negocio antes de inyectar al prompt.
    • Criterio: prioriza latencia y coste. Evita enviar “todo” en cada petición.
    • Recurso: pgvector

    4) LLMOps y Evaluaciones — Operar lo no determinista

    • Qué aprender: tracing por sesión, LLM-as-a-judge y métricas de negocio.
    • Práctica concreta: registra cada interacción (tokens, latencia, tools invocadas). Configura un job que use un LLM evaluador para puntuar respuestas por pertinencia y alucinaciones.
    • Herramientas: Langfuse para trazabilidad, LangSmith para visualización.
    • Métricas clave: coste por sesión, iteraciones por solicitud, p95 latencia por tool, tasa de fallos por tool.

    Stack técnico recomendado (práctico y defendible)

    Si trabajas en TypeScript, prioriza estos componentes (con orden de adopción):

    1. SDKs oficiales

    Recomendación: Anthropic/OpenAI — aprende sus modelos, límites y formatos de tool-calling.

    2. Backend

    Recomendación: NestJS — implementa providers para LLM, ToolRegistry y AgentService.

    3. Vector DB inicial

    Recomendación: pgvector + PostgreSQL; escala a Pinecone/Qdrant si el volumen lo exige.

    4. Orquestación y workflows

    Recomendación: n8n para pipelines asíncronos y conectores empresariales.

    5. Observabilidad

    Recomendación: Langfuse o LangSmith para tracing y análisis de coste.

    Evita caer en frameworks que abstraen demasiado al principio. Aprende la API real: sabes más cuanto menos le pidas al framework que haga por ti.

    Errores que vas a cometer (y cómo evitarlos)

    • No versionar prompts: guarda prompts junto al código y pruébalos.
    • Herramientas multifunción: separa responsabilidades y aplica autorización por herramienta.
    • No medir tokens: integra métricas de coste desde el primer día.
    • Tests ausentes: mockea LLMs y valida esquemas de salida en CI.

    Prioridad de aprendizaje (3 pasos rápidos)

    1. Practica Tool Calling con un mini-proyecto en NestJS: define 4 herramientas y un Agent Loop.
    2. Implementa RAG con pgvector para un dominio de 100 documentos. Mide latencia y coste.
    3. Añade tracing (Langfuse) y un evaluador LLM que puntúe respuestas en lotes.

    Conclusión

    Convertirse en AI Engineer en 2026 no implica abandonar lo que ya sabes. Implica extender tu disciplina: convertir prompts en contratos, convertir respuestas probabilísticas en flujos controlados y operar sistemas con métricas reales. Si dominas eso, liderarás la integración de IA en producto, no sólo la experimentación.

    Dominicode Labs

    Para equipos que implementan agentes, RAG y pipelines de observabilidad, un siguiente paso natural es consolidar prácticas en proyectos pilotos y reproducibles. Una opción para explorar experimentos y plantillas es Dominicode Labs, que puede servir como repositorio de referencia para workflows y pruebas de concepto.

    FAQ

    ¿Qué es Prompt Engineering estructurado?

    Diseñar prompts como artefactos versionables que incluyan system prompts, ejemplos (few-shot) y produzcan salidas tipadas. El objetivo es generar respuestas que se puedan validar automáticamente (por ejemplo, JSON con esquema Zod).

    ¿Cómo funciona Tool Calling y por qué usarlo?

    Se definen herramientas con schemas JSON que el LLM puede invocar. Un Agent Loop envía mensajes y herramientas al LLM; si el LLM indica uso de herramienta, se validan los argumentos, se ejecuta el servicio y se devuelve el resultado, repitiendo hasta finalizar.

    ¿Por qué usar pgvector para RAG?

    pgvector sobre PostgreSQL permite comenzar con una solución integrada para embeddings y búsquedas vectoriales. Es práctica para dominios iniciales antes de escalar a Pinecone o Qdrant.

    ¿Qué incluye LLMOps en producción?

    Tracing por sesión, registrar tokens, latencia y tools invocadas; configurar jobs que usen un LLM evaluador para puntuar respuestas por pertinencia y alucinaciones; y medir métricas como coste por sesión y p95 latencia por tool.

    ¿Qué stack priorizar si trabajo en TypeScript?

    Prioriza SDKs oficiales (Anthropic/OpenAI), backend en NestJS, pgvector + PostgreSQL, orquestación con n8n y observabilidad con Langfuse o LangSmith.

    ¿Cuáles son los primeros proyectos prácticos recomendados?

    Tres pasos rápidos: (1) mini-proyecto en NestJS para Tool Calling con 4 herramientas y un Agent Loop; (2) implementar RAG con pgvector para ~100 documentos; (3) añadir tracing y un evaluador LLM para puntuar respuestas.

  • Implementación del Agentic Harness para Agentes Autónomos

    Implementación del Agentic Harness para Agentes Autónomos

    Qué es el Agentic Harness y cómo aplicarlo?

    Tiempo estimado de lectura: 5 min

    • Idea clave: Un Agentic Harness es la infraestructura que transforma agentes autónomos experimentales en software operable y seguro.
    • Idea clave: Sus componentes mínimos: sandboxing, mocking de herramientas, trazabilidad y guardrails automatizados.
    • Idea clave: Integrarlo en CI/CD y usar un LLM-judge reduce riesgos antes de dar acceso a producción.

    El Agentic Harness es la infraestructura que convierte agents autónomos experimentales en piezas de software operables y seguras. Si un agente entra en producción sin un harness, no es cuestión de “si” fallará: es cuestión de “cuándo” y con qué coste. Entender qué es el Agentic Harness y cómo aplicarlo es obligado para Tech Leads y equipos que despliegan agentes que actúan sobre sistemas reales.

    Los LLM son probabilísticos. Un agente no devuelve solo un output: planifica, encadena herramientas y decide. Un Agentic Harness controla ese actor: lo aísla, lo simula, lo rastrea y lo limita antes de darle acceso al mundo real.

    Resumen rápido (lectores con prisa)

    Agentic Harness: infraestructura que aísla, simula y limita agentes que razonan. Úsalo siempre que un agente pueda modificar sistemas reales o acceder a datos sensibles. Importa porque reduce riesgos operativos y legales. Funciona combinando sandboxing, mocks, trazabilidad y guardrails automatizados.

    Qué es el Agentic Harness y cómo aplicarlo en la práctica

    Un Agentic Harness hereda la idea del test harness tradicional y la adapta a agentes que razonan. Su objetivo no es solo verificar resultados; es auditar trayectorias de ejecución, interceptar efectos secundarios y bloquear comportamientos peligrosos. Sus componentes mínimos son:

    1) Diseño del sandbox

    • Ejecuta cada run del agente en un contenedor efímero o microVM sin acceso de salida (egress blocked).
    • Monta datasets de prueba y mocks en el filesystem; destruye el entorno al terminar.
    • No expongas secretos ni claves reales: usa vaults de test que devuelvan credenciales ficticias.

    Referencias: Docker, Firecracker.

    2) Mocking y simulación de tools

    • Intercepta function-calls y reemplázalas por mocks que:
      • Regresen respuestas realistas.
      • Generen métricas: latencia simulada, tasa de errores, costes.
      • Registren parámetros y contexto.
    • Ejemplo: delete_user(user_id) devuelve {status: "mocked", user_id} y queda registrado en trazas.

    Referencia: OpenAI Function Calling docs.

    3) Trazabilidad de la trayectoria (traces)

    • Registra: prompts, respuestas intermedias, herramientas invocadas, embeddings consultados, scores de retrieval.
    • Guarda trazas en un formato navegable (JSONL) y con versión del modelo.
    • Integra una capa de observabilidad para análisis post-mortem: Langfuse u otros servicios de tracing. También se puede integrar con herramientas como LangChain/observability.

    4) Guardrails cuantitativos y evaluadores automáticos

    • Umbrales automáticos que abortan la ejecución:
      • Límite de tokens por run (ej. 50k tokens).
      • Límite de coste por evaluación.
      • Número máximo de llamadas a herramientas (ej. 10).
    • Métricas de seguridad: intentos de acceso a APIs prohibidas, intentos de exfiltración.
    • LLM-as-a-Judge: usa un segundo modelo con temperature=0 para revisar la coherencia y seguridad de la trayectoria (evaluación estructurada: PASS/WARN/FAIL).

    5) Integración en CI/CD

    • Cada PR que incluya cambios en agentes debe disparar pipelines del harness.
    • No permitir merge si el harness devuelve FAIL en criterios críticos (seguridad, uso de herramientas prohibidas, loops).
    • Generar reportes legibles: timeline de decisiones, evidencia de mocks, recomendación humana para escalado.

    Ejemplo real (simplificado)

    Objetivo: “Optimizar consultas SQL lentas”.

    • Sin harness: el agente propone eliminar tablas, lo ejecuta y rompe el servicio.
    • Con harness: delete_table está mockeado; el agent llama la herramienta, el harness registra la decisión y el LLM-judge marca la acción como destructiva → FAIL. Equipo revisa prompt y reglas antes de permitir acción real.

    Riesgos, limitaciones y gobernanza

    • No existe aún un estándar único; la industria arma soluciones híbridas (Docker + observabilidad + LLM-judge).
    • El harness reduce riesgos, no los elimina: necesita gobernanza humana sobre qué decisiones puede automatizar el agente.
    • Monitorización continua: el harness debe seguir en producción en modo controlado (shadow runs, canary) incluso después del rollout.

    Checklist mínimo antes de dar acceso real

    • Contenedor sandbox probado y reproducible.
    • Todas las herramientas mockeadas disponibles en harness.
    • Trazas completas y auditable por humanos.
    • Umbrales configurados (tokens, coste, llamadas).
    • LLM-judge integrado y reglas de CI/CD que bloqueen merges.

    Dominicode Labs

    Para equipos que construyen infra de agentes y harnesses, explorar investigaciones y plantillas operativas puede acelerar la adopción segura. Una continuación lógica para experimentar con setups híbridos y pipelines de observabilidad es Dominicode Labs.

    FAQ

    Respuesta: ¿Qué es exactamente un Agentic Harness?

    Es la infraestructura que aísla, simula, traza y limita la ejecución de agentes autónomos para que puedan evaluarse y auditarse antes de interactuar con sistemas reales.

    Respuesta: ¿Cuándo debo usar un harness?

    Cuando un agente pueda modificar sistemas, acceder a datos sensibles o ejecutar acciones con impacto operativo. Es obligatorio antes de dar acceso a producción.

    Respuesta: ¿Qué herramientas necesito para empezar?

    Componentes básicos: sandbox (p. ej. Docker o Firecracker), mocks de APIs, sistema de trazas (JSONL) e integración con una herramienta de observabilidad como Langfuse.

    Respuesta: ¿Cómo funciona el LLM-judge?

    Un segundo modelo con temperatura cero revisa la trayectoria del agente (prompts, herramientas, decisiones) y emite una evaluación estructurada (PASS/WARN/FAIL) basada en reglas predefinidas.

    Respuesta: ¿El harness evita la gobernanza humana?

    No. El harness reduce riesgos operativos y automatiza controles, pero requiere gobernanza humana para decidir qué acciones se delegan y qué reglas son aceptables.

    Respuesta: ¿Dónde guardo las trazas y cómo las analizo?

    Guarda trazas en formato navegable (por ejemplo JSONL) con versión del modelo y métadatos. Analiza con una capa de observabilidad o herramientas de tracing para post-mortem y auditoría.